Kursus
Analisis Deret Waktu dengan Python
4 jam
70.9K
Sebagian besar konten online langsung membahas ARIMA dan memberikan bagian AR hanya satu baris penjelasan, kalaupun ada. Padahal AR adalah fondasi modelnya. Jika Anda tidak memahaminya, bagian ARIMA lainnya juga tidak akan masuk akal.
Secara sederhana, model autoregresif memprediksi nilai masa depan dari sebuah deret waktu berdasarkan nilai-nilai masa lalunya sendiri. Anda akan menemukannya di bidang ekonomi, keuangan, pemrosesan sinyal, dan data iklim. Ini pada dasarnya adalah model regresi, sehingga menghubungkan apa yang sudah Anda ketahui tentang regresi dengan peramalan deret waktu, dan menjadi dasar yang digunakan ARIMA.
Dalam artikel ini, saya akan memandu Anda memahami cara kerja model autoregresif, cara memasangnya di Python dengan statsmodels, dan cara memilih orde lag yang tepat.
Model autoregresif memprediksi nilai berikutnya dari deret waktu dari jumlah berbobot nilai-nilai sebelumnya.
Dalam namanya, "auto" berarti diri sendiri, dan "regresi" berarti Anda memprediksi satu variabel dari variabel lain. Jadi model autoregresif adalah regresi suatu deret terhadap masa lalunya sendiri.
Misalnya Anda ingin memprediksi permintaan listrik besok. Permintaan hari ini adalah titik awal yang bagus, dan permintaan kemarin menambah sedikit informasi lagi. Model autoregresif mengubah intuisi tersebut menjadi rumus, dan bobotnya dipelajari dari data Anda.
Model AR ditulis sebagai AR(p), di mana p adalah orde model. Orde memberi tahu berapa banyak nilai masa lalu yang digunakan model:
p nilai sebelumnyaOrde yang lebih tinggi tidak serta-merta berarti model yang lebih baik. Saya akan menunjukkan cara memilih p nanti di artikel.
Berikut bentuk umum model AR(p):
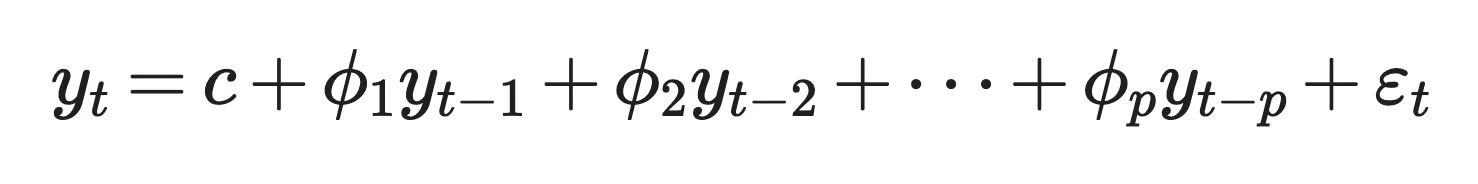
Model AR(p) umum
Berikut peran tiap komponennya
y_t: Nilai deret pada waktu t, yaitu nilai yang ingin Anda prediksi
c: Sebuah konstanta yang, bersama koefisien, menentukan rerata jangka panjang deret
phi_1 hingga phi_p: Koefisien yang memberi tahu seberapa besar setiap nilai masa lalu berkontribusi pada prediksi
y_t-1 hingga y_t-p: Nilai berlag, di mana "lag" berarti berapa banyak langkah ke belakang yang Anda lihat
epsilon_t: Derau putih, yaitu galat acak dengan rerata nol, varians konstan, dan tanpa korelasi seiring waktu
Secara sederhana, model mengalikan masing-masing dari p nilai terakhir dengan bobotnya sendiri dan menambahkan konstanta. Sisanya adalah derau, bagian dari y_t yang tidak dapat dijelaskan masa lalu.
AR(1) adalah versi paling sederhana:
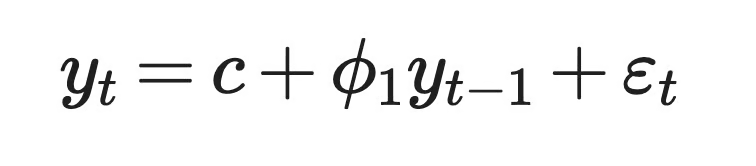
Model AR(1)
Nilai phi_1 mengendalikan seberapa besar pengaruh hari ini terhadap besok.
Misalkan c = 2 dan phi_1 = 0.8. Jika nilai hari ini 15, model memprediksi 2 + 0.8 x 15 = 14 untuk besok. Prediksi berikutnya adalah 2 + 0.8 x 14 = 13.2. Setiap langkah membuat deret mendekati 10, yaitu rerata jangka panjangnya, c / (1 - phi_1).
Jika phi_1 bernilai negatif, deret melompat di atas dan di bawah rerata dari satu langkah ke langkah berikutnya.
AR(2) menambahkan lag kedua:
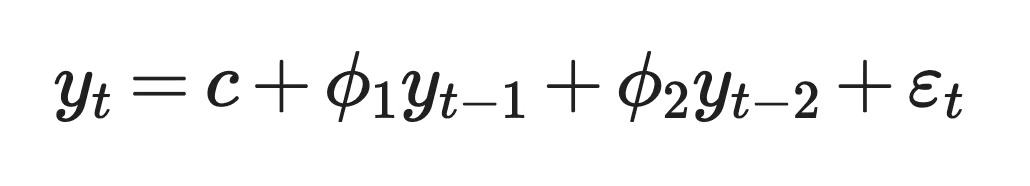
Model AR(2)
Dengan dua lag, model dapat menggambarkan pola yang tidak bisa dilakukan AR(1), seperti siklus. Misalnya, phi_1 positif dengan phi_2 negatif dapat menghasilkan deret yang naik turun bergelombang, mirip siklus bisnis.
Jadi setiap model AR bermuara pada dua pilihan — berapa banyak lag yang digunakan, dan bobot apa yang diberikan.
Model AR hanya bekerja ketika dua hal benar pada data Anda. Nilai masa lalu harus berkaitan dengan nilai masa depan, dan deret harus berperilaku sama dari waktu ke waktu. Yang pertama disebut autokorelasi, dan yang kedua disebut stasioneritas.
Autokorelasi adalah korelasi antara deret waktu dan salinannya yang digeser (lagged).
Inilah alasan model AR ada. Jika nilai hari ini tidak memberi tahu apa pun tentang besok, model tidak punya apa-apa untuk dipelajari dari nilai masa lalu.
Dalam kode, Anda mengambil satu kolom nilai, menyalinnya, dan menggeser salinan itu turun satu baris. Kini setiap baris memasangkan satu nilai dengan nilai sebelumnya. Korelasi antara dua kolom adalah autokorelasi lag-1. Saat Anda menggeser dua baris, Anda mendapatkan autokorelasi lag-2.
Berikut tampilannya di pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))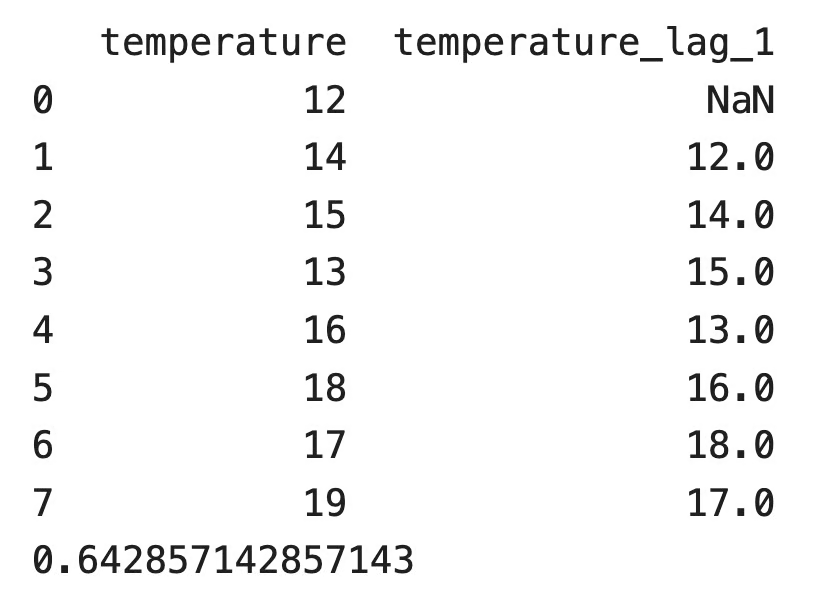
DataFrame dengan kolom temperature dan salinan lag-1
Baris pertama kolom berlag kosong karena tidak ada pembacaan sebelum yang pertama. pandas melewati baris itu dan mengembalikan autokorelasi lag-1 sebesar 0.643. Hari-hari hangat cenderung diikuti hari-hari hangat pada deret ini.
Tanda autokorelasi mengubah bagaimana deret berperilaku:
Autokorelasi yang mendekati nol berarti masa lalu tidak membantu. Dalam kasus itu, model AR tidak akan jauh lebih baik daripada memprediksi rerata.
Model AR memerlukan deret waktu yang stasioner.
Deret stasioner memiliki rerata yang sama, varians yang sama, dan autokorelasi pada lag tertentu yang sama, tidak peduli bagian mana dari deret yang Anda lihat. Ahli statistik menyebutnya stasioneritas dalam arti lemah (weak-sense).
Ini penting karena model mengestimasi satu set koefisien tetap. Jika rerata deret bergeser dari waktu ke waktu, koefisien yang dipelajari dari data lama tidak akan menggambarkan data baru. Harga saham adalah contoh umum deret non-stasioner karena cenderung naik dari tahun ke tahun. Return harian jauh lebih dekat ke stasioner.
Koefisien itu sendiri yang menentukan apakah suatu proses AR stasioner. Untuk AR(1), aturannya sederhana: phi_1 harus antara -1 dan 1.
abs(phi_1) < 1: Guncangan memudar seiring waktu, dan deret kembali ke reratanya
phi_1 = 1: Deret menjadi random walk, dan guncangan tidak pernah memudar
abs(phi_1) > 1: Setiap guncangan makin membesar, dan deret meledak
AR(2) membutuhkan tiga kondisi sekaligus: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1, dan abs(phi_2) < 1.
Setelah dua lag, Anda memerlukan aturan umum. Setiap model AR(p) memiliki polinomial karakteristik:
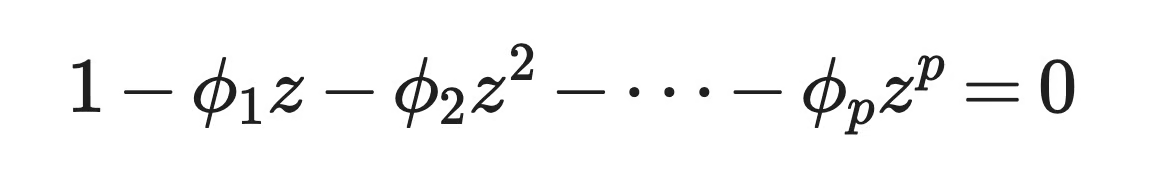
Polinomial karakteristik
Proses bersifat stasioner dalam arti lemah ketika semua akar polinomial ini berada di luar lingkaran satuan, yang berarti setiap akar z memiliki nilai absolut lebih besar dari 1. Akar dapat berupa bilangan kompleks, itulah mengapa batasnya berupa lingkaran pada bidang kompleks, bukan garis.
Anda bisa memeriksanya dengan AR(1). Polinomialnya adalah 1 - phi_1 z = 0, sehingga akarnya z = 1 / phi_1. Akar tersebut berada di luar lingkaran satuan hanya ketika abs(phi_1) < 1, yang merupakan aturan yang sama seperti sebelumnya.
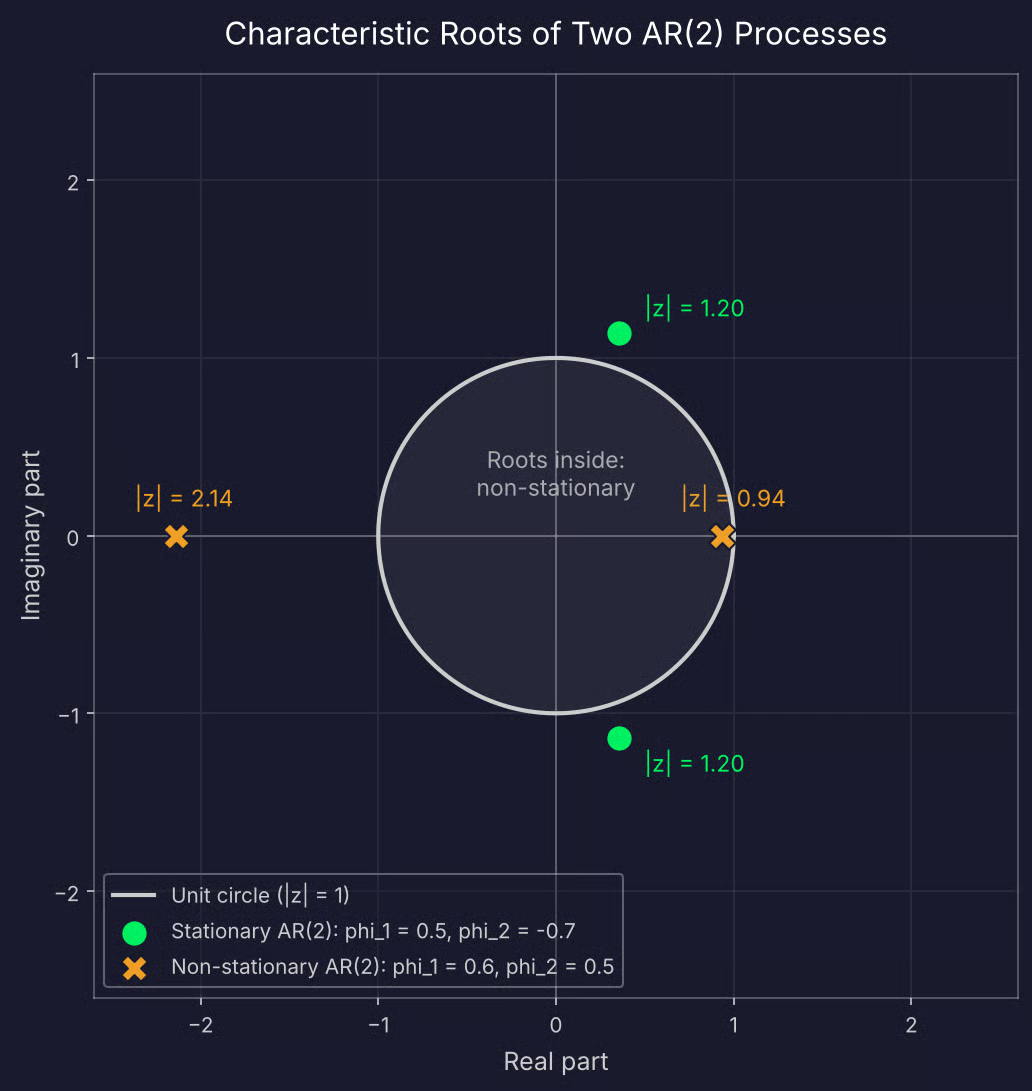
Akar dari proses AR(2) yang stasioner dan non-stasioner
Anda tidak akan menghitung akar-akar ini secara manual. statsmodels mengembalikannya setelah Anda memasang model, dan saya akan menunjukkan cara menguji data itu sendiri untuk stasioneritas di bagian Python.
Jika deret Anda tidak stasioner, Anda bisa melakukan differencing — mengurangkan setiap nilai dari nilai berikutnya — dan memodelkan selisihnya. Itulah arti huruf "I" dalam model ARIMA.
Setiap model AR memiliki persamaan yang sama. Yang berubah dari satu jenis ke jenis lain adalah orde p, yaitu berapa banyak nilai masa lalu yang digunakan model.
AR(1) hanya menggunakan nilai sebelumnya untuk memprediksi nilai berikutnya.
Jika terdengar seperti regresi linear, memang begitu. Ketika Anda menempatkan y_t-1 pada sumbu x dan y_t pada sumbu y, AR(1) menyesuaikan garis lurus melalui titik-titik. Konstanta c adalah intersep, dan phi_1 adalah kemiringan. Jika Anda memahami regresi linear sederhana, Anda sudah tahu bagaimana AR(1) diestimasi.
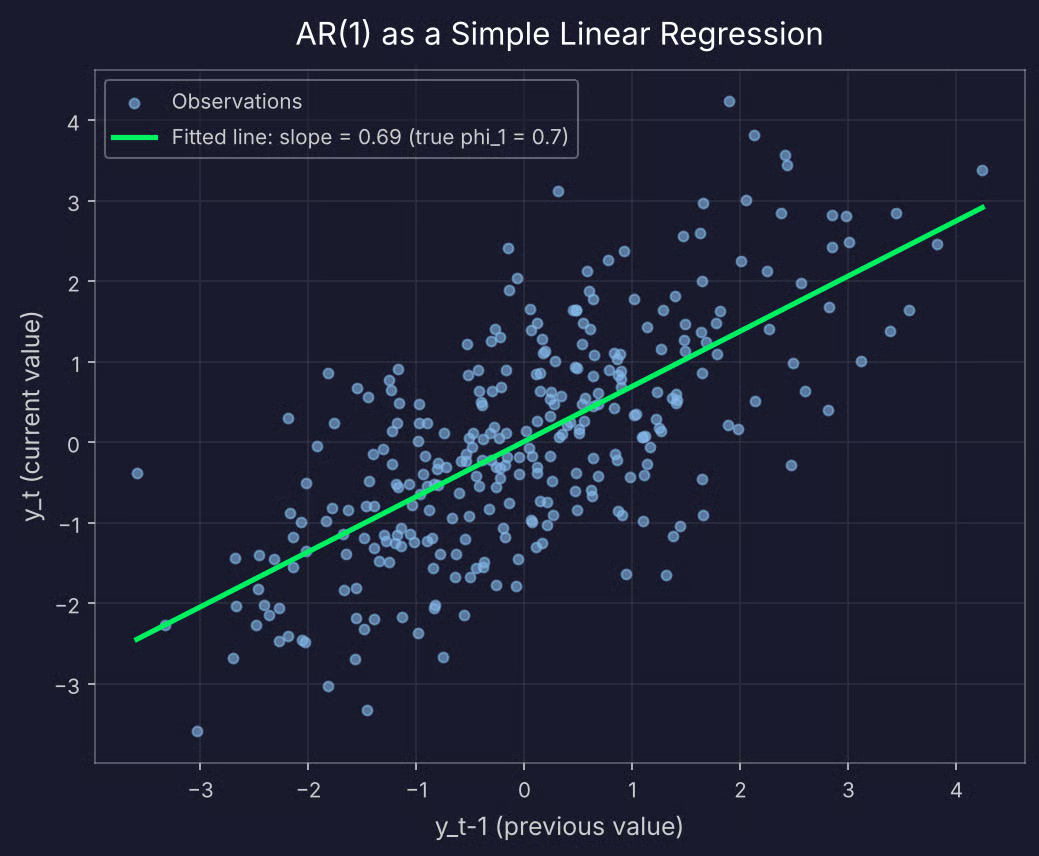
Plot sebar y_t terhadap y_t-1 untuk AR(1)
Namun ada satu perbedaan. Dalam regresi standar, prediktor dan target adalah variabel terpisah. Dalam AR(1), prediktornya adalah deret yang sama namun digeser satu langkah. Itulah mengapa Anda tidak bisa mengacak baris atau memakai pembagian train/test acak — urutan data merupakan bagian dari model.
Nilai phi_1 mengubah tampilan deret:
phi_1 = 0.3: Deret terlihat hampir seperti derau acak, karena tiap nilai membawa sedikit informasi tentang nilai berikutnya
phi_1 = 0.9: Deret bergerak dalam ayunan panjang dan mulus serta membutuhkan waktu untuk kembali ke reratanya
phi_1 = -0.8: Deret bergerak zigzag di atas dan di bawah rerata hampir setiap langkah
phi_1 = 1: Deret menjadi random walk dan melayang tanpa rerata untuk kembali, yang merupakan kasus non-stasioner dari bagian sebelumnya
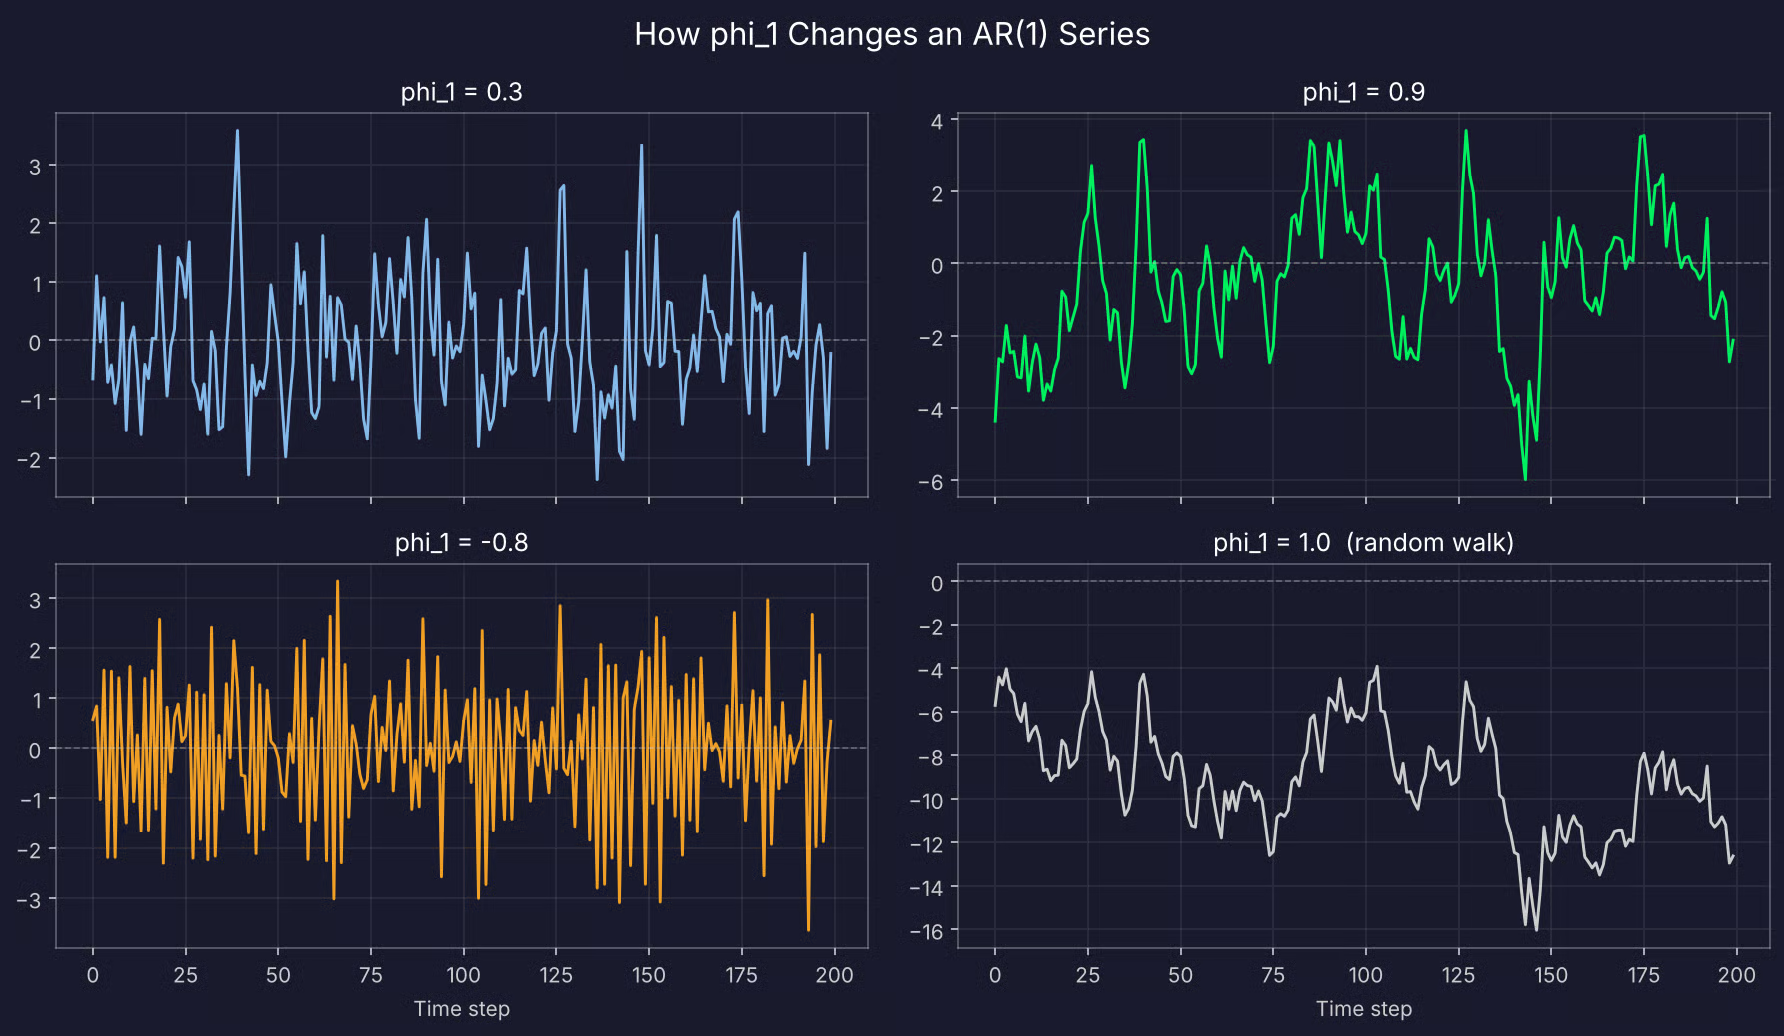
Empat deret AR(1) simulasi
Semakin dekat phi_1 ke 1 atau -1, semakin lama satu guncangan memengaruhi deret.
AR(2) menggunakan dua nilai sebelumnya. Lag kedua memungkinkan model menghasilkan pola yang tidak bisa dilakukan AR(1), terutama siklus.
Berikut perbandingan dua set koefisien:
phi_1 = 0.5, phi_2 = 0.3: Kedua lag mendorong ke arah yang sama, sehingga deret terlihat seperti AR(1) dengan ayunan yang lebih panjang dan mulus
phi_1 = 0.5, phi_2 = -0.7: Lag kedua bekerja berlawanan dengan yang pertama, dan deret naik turun bergelombang yang berulang kira-kira setiap lima langkah
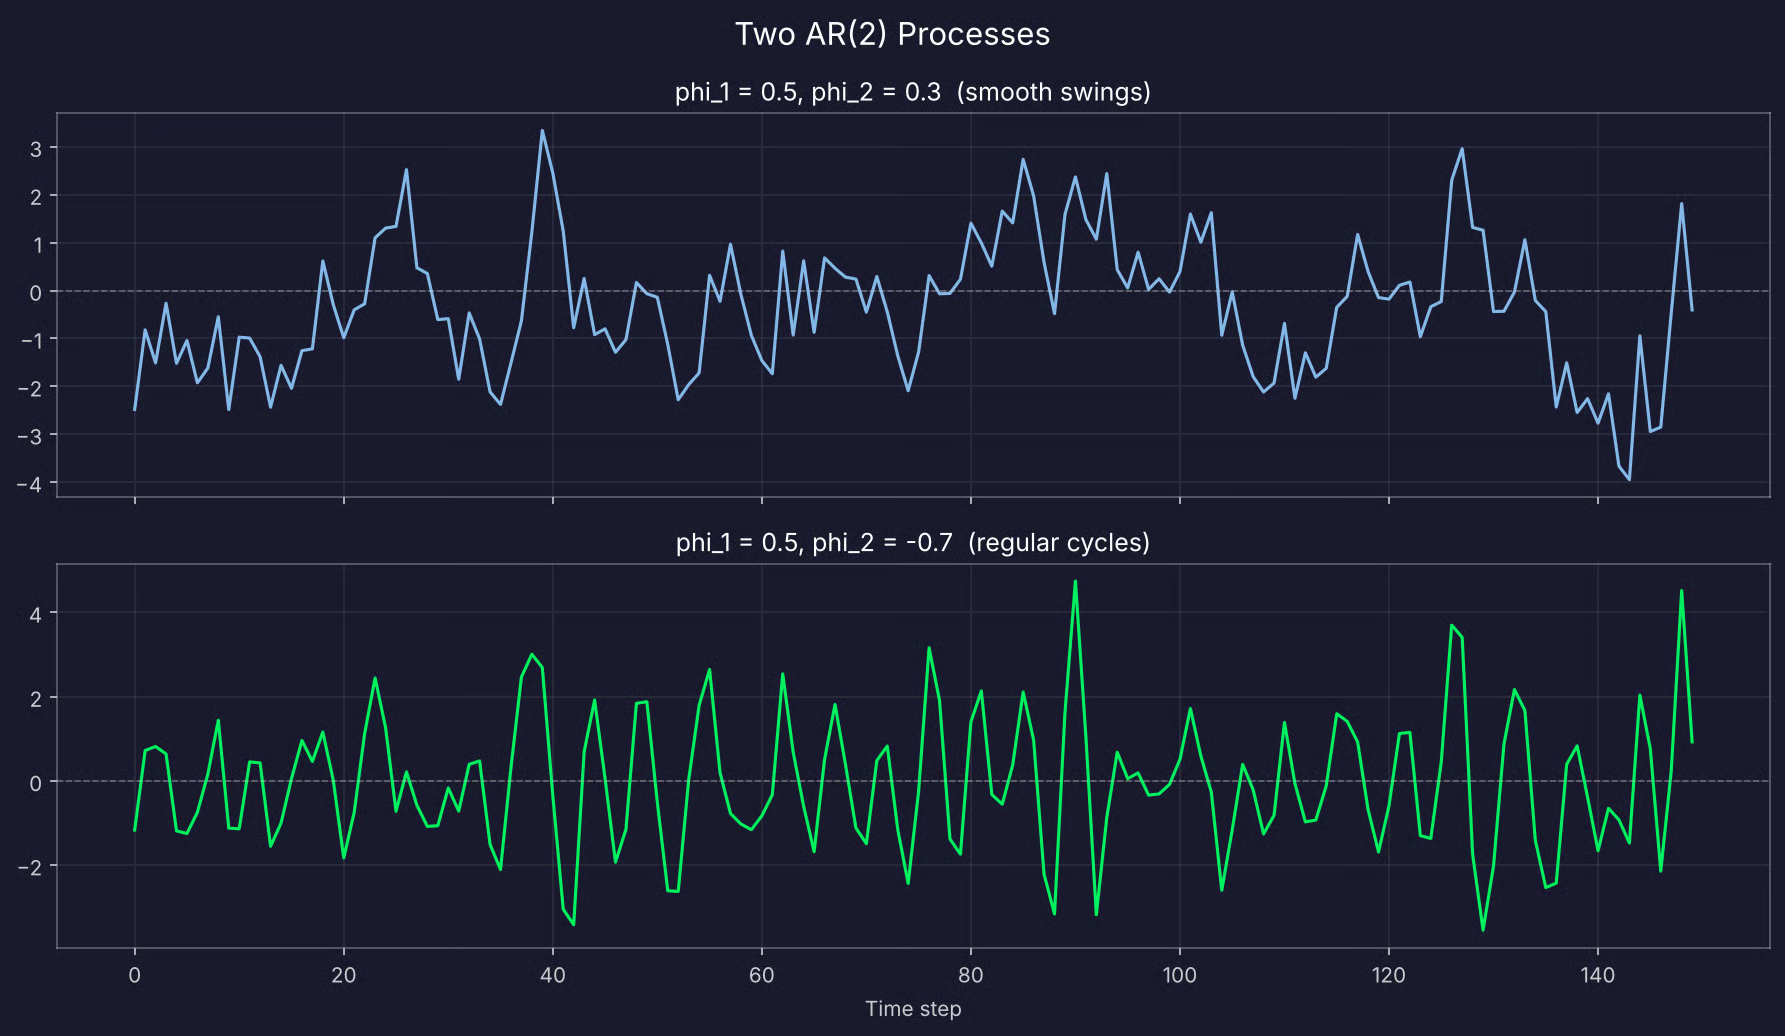
Dua deret AR(2) simulasi
AR(3), AR(4), dan seterusnya menambah satu lag setiap kali. Anda membutuhkannya ketika nilai yang lebih jauh ke belakang membawa informasi yang tidak dimiliki nilai yang lebih baru.
Misalkan Anda memodelkan penjualan bulanan, dan bulan yang sama tahun lalu memprediksi bulan ini dengan baik. Model AR(12) mencakup lag 12 bulan itu, bersama 11 lag di antaranya.
Setiap lag tambahan menambah satu koefisien untuk diestimasi. Artinya Anda memerlukan lebih banyak data, dan risiko overfitting meningkat. Koefisien juga makin sulit dibaca — dengan 12 koefisien, Anda tidak bisa melihat angka-angkanya lalu langsung tahu apa yang akan terjadi pada deret. Anda memeriksa akarnya sebagai gantinya.
Saya akan menunjukkan cara memilih orde yang tepat dengan PACF dan AIC di bagian Python.
Model AR muncul di mana pun data disimpan berurutan dan masa lalu yang dekat mengatakan sesuatu tentang masa depan dekat.
Sebagian besar penggunaan jatuh ke dalam empat kelompok:
Yang terakhir sering mengejutkan banyak orang karena istilah di balik chatbot masa kini berasal dari statistik yang sedang Anda baca di sini.
Di bagian ini, saya akan memasang model autoregresif di Python dengan statsmodels, dari data mentah hingga ramalan yang dapat dievaluasi.
Anda memerlukan pandas dan NumPy untuk data, statsmodels untuk model dan pengujian, serta scikit-learn untuk metrik galat:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorSaya akan mensimulasikan dua tahun permintaan listrik harian dari proses AR(2).
Saya memutuskan menggunakan data simulasi karena Anda mengetahui koefisien sebenarnya di awal. Dengan begitu, Anda dapat memeriksa apakah model menemukannya, dan apakah alat pemilihan lag menunjuk ke orde yang benar.
Prosesnya memiliki c = 15, phi_1 = 0.6, dan phi_2 = 0.25, yang menempatkan rerata jangka panjang di 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()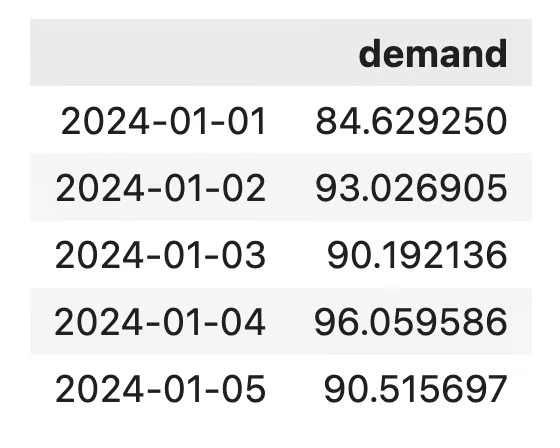
Dataset permintaan listrik harian
100 hari simulasi pertama dihapus karena periode burn-in memberi waktu bagi deret untuk stabil ke perilaku normalnya sebelum mulai digunakan.
Berikut tampilan deret lengkapnya:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()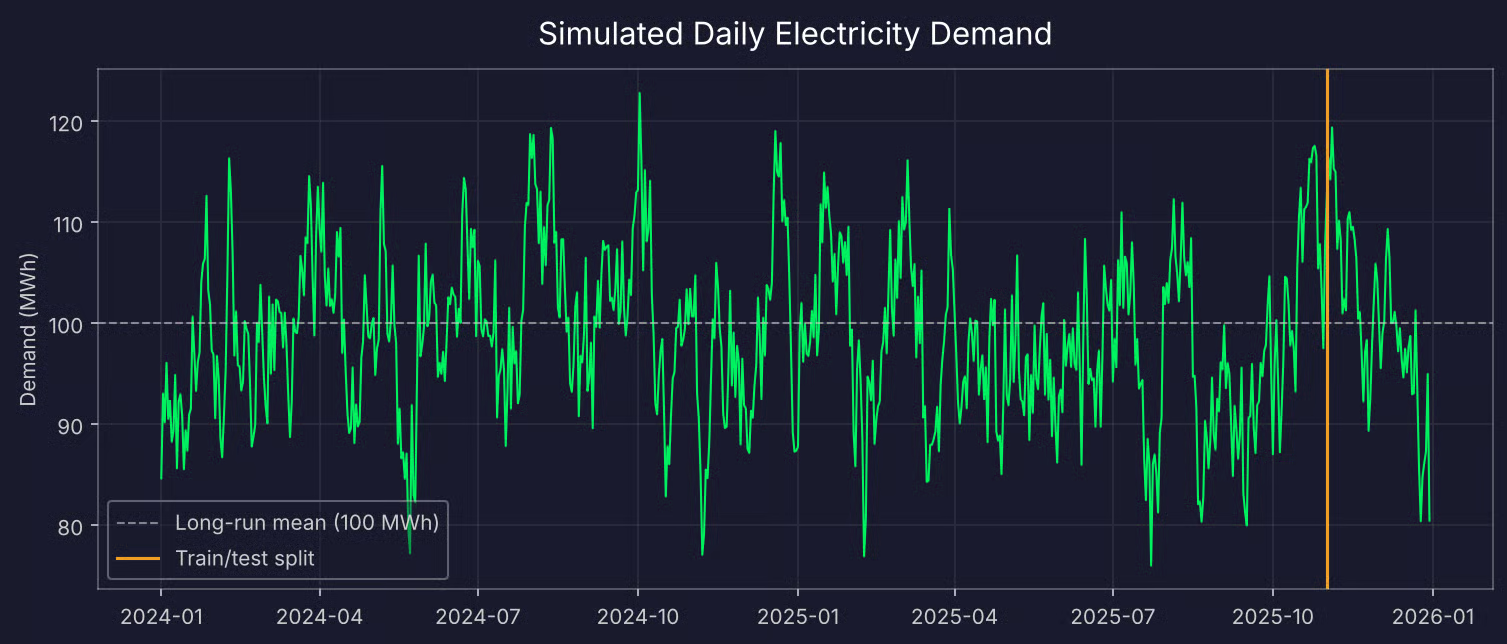
Dua tahun permintaan listrik harian simulasi
Deret bergerak naik turun di sekitar 100 tanpa tren, seperti yang seharusnya pada deret stasioner. Namun pemeriksaan visual bukan bukti.
Uji augmented Dickey-Fuller (ADF) memeriksa apakah suatu deret stasioner. Hipotesis nolnya adalah deret tidak stasioner, jadi p-value kecil yang Anda inginkan:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")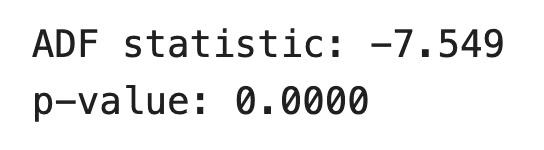
Hasil uji ADF
p-value jauh di bawah 0,05, sehingga Anda dapat menolak hipotesis nol dan memperlakukan deret sebagai stasioner.
Jika data Anda sendiri gagal dalam uji ini, lakukan differencing dengan df["demand"].diff().dropna() dan jalankan uji lagi.
Data deret waktu tidak boleh diacak, sehingga set pengujian harus berasal dari akhir deret. Saya akan menyisihkan 60 hari terakhir untuk pengujian:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Itu menyisakan 670 hari untuk pelatihan dan 60 untuk pengujian.
Ini adalah langkah yang menentukan seberapa baik model bekerja. Jika Anda memilih terlalu sedikit lag, model melewatkan pola dalam data. Namun jika terlalu banyak, model menyesuaikan derau pada data latih yang tidak akan terulang di masa depan.
Anda memiliki dua alat untuk itu.
Yang pertama adalah fungsi autokorelasi parsial (PACF). Ini menunjukkan korelasi antara deret dan setiap lag setelah menghapus pengaruh semua lag yang lebih pendek. Untuk proses AR(p), PACF memiliki lonjakan signifikan hingga lag p dan turun mendekati nol setelahnya:
plot_pacf(train, lags=20, method="ywm")
plt.show()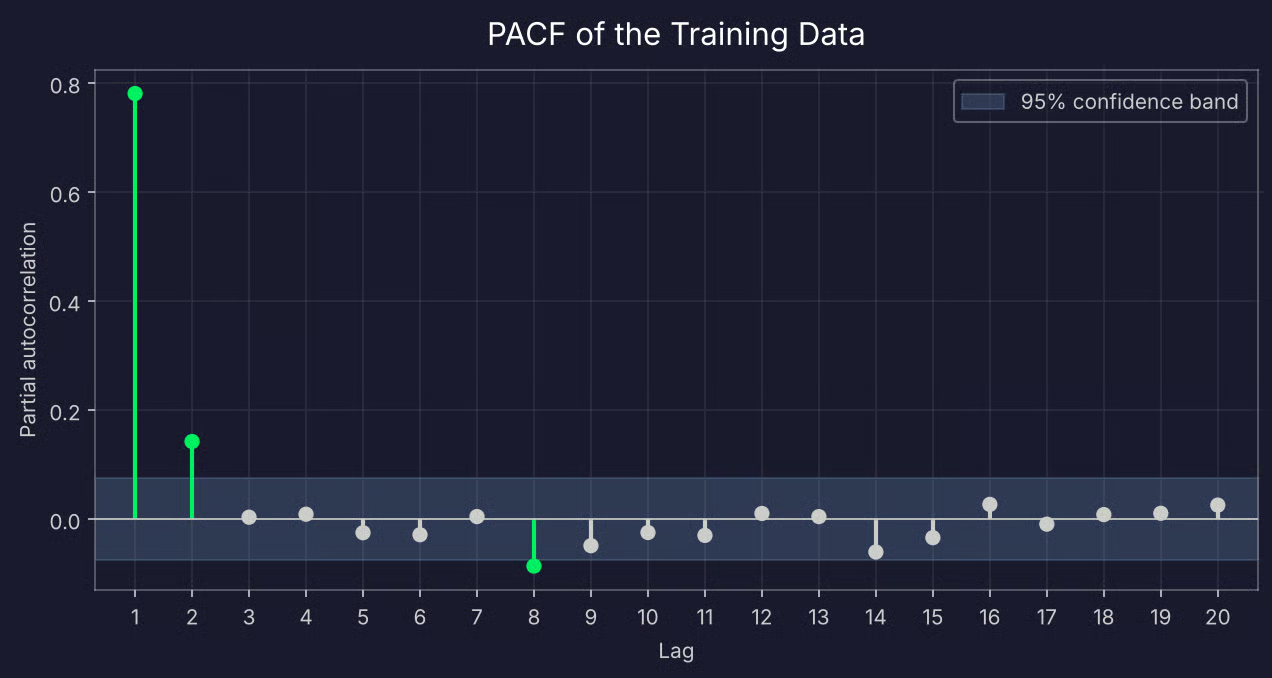
PACF data pelatihan
Lag 1 dan 2 jauh di luar pita kepercayaan, dan lag 3 turun mendekati nol. Itu mengarah ke AR(2).
Ada juga lonjakan kecil pada lag 8, tepat melewati tepi pita. Jangan terlalu memaknainya. Pita digambar pada kepercayaan 95%, jadi dengan 20 lag, Anda memang berharap sekitar satu di antaranya melampaui pita secara kebetulan.
Alat kedua adalah kriteria informasi. AIC dan BIC sama-sama memberi penghargaan pada model yang pas dengan data dan memberi penalti untuk setiap parameter tambahan. BIC menerapkan penalti yang lebih besar, sehingga cenderung memilih model yang lebih kecil. statsmodels dapat menguji setiap orde hingga maksimum dan mengembalikan yang terbaik:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")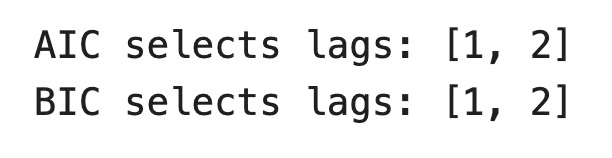
Pemilihan lag AIC/BIC
Kedua kriteria setuju dengan PACF. Dalam praktik, Anda sering melihat AIC memilih model yang sedikit lebih besar daripada BIC. Jika itu terjadi, mulailah dengan yang lebih kecil.
Dengan orde yang dipilih, memasang model hanya butuh dua baris kode:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")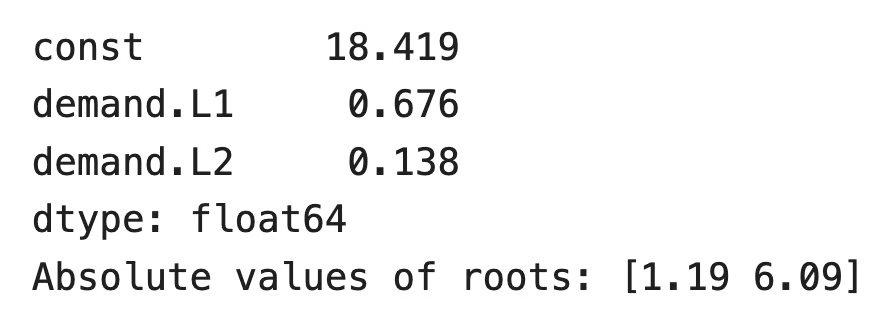
Parameter model AR(2)
Nilai sebenarnya adalah 0.6 dan 0.25. Model memberi bobot sedikit lebih besar pada lag pertama dan lebih kecil pada lag kedua, tetapi jumlah kedua koefisiennya mendekati — 0.81 versus 0.85. Dengan 670 titik data, Anda tidak akan mendapatkan nilai persisnya.
Kedua akar memiliki modulus lebih besar dari 1, jadi model terpasang bersifat stasioner. Anda bisa memanggil results.summary() jika menginginkan standar error, p-value, dan tabel akar lengkap.
Ada dua cara meramalkan periode uji, dan keduanya menjawab pertanyaan yang berbeda:
Ramalan multi-langkah berasal langsung dari hasil yang terpasang. Untuk ramalan satu langkah, Anda menerapkan koefisien terlatih ke seluruh deret:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")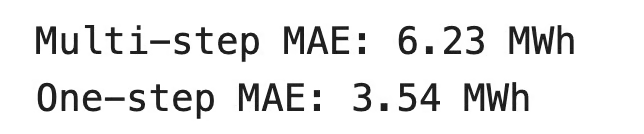
Hasil ramalan
Mean absolute error (MAE) adalah rata-rata selisih absolut antara prediksi dan nilai aktual. Satuan ukurannya sama dengan data, sehingga Anda bisa membacanya secara langsung. Ramalan satu langkah meleset rata-rata 3,54 MWh.
Berikut perbandingan kedua ramalan dengan nilai aktual:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()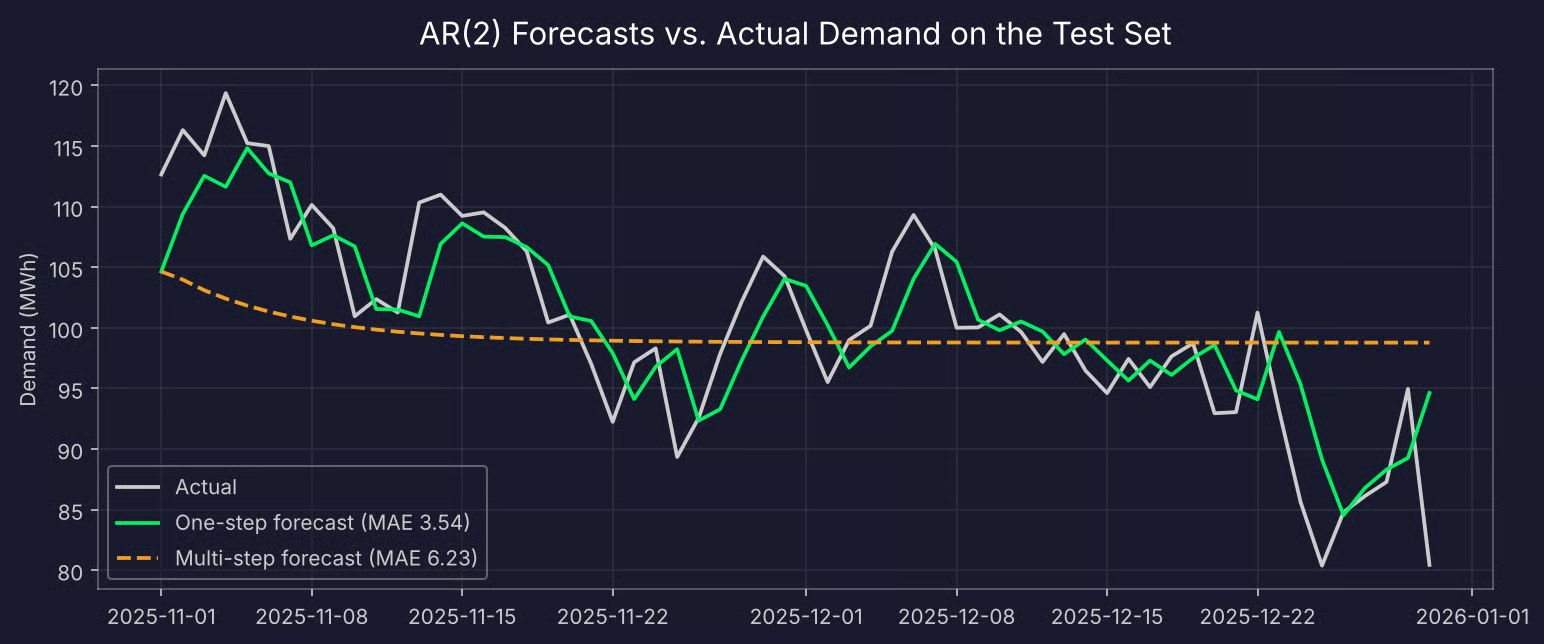
Ramalan AR(2) satu langkah dan multi-langkah dibandingkan permintaan aktual
Ramalan satu langkah mengikuti nilai aktual dengan cukup dekat, sekitar satu hari tertinggal. Ramalan multi-langkah dimulai pada nilai terakhir yang diketahui lalu mendatar mendekati rerata dalam sekitar tiga minggu.
Beginilah perilaku setiap model AR yang stasioner — semakin jauh Anda meramalkan, semakin sedikit masa lalu yang memberi tahu, dan tebakan terbaik menjadi rerata jangka panjang. Inilah mengapa model AR paling cocok untuk ramalan jangka pendek.
Mudah berasumsi bahwa lebih banyak riwayat berarti prediksi lebih baik. Mari uji dengan memasang model dengan jumlah lag yang meningkat dan membandingkan MAE satu langkahnya:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")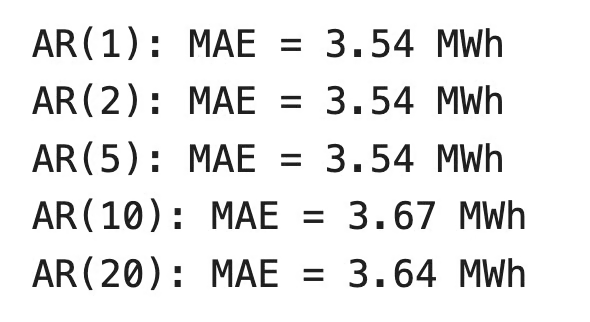
MAE dengan lebih banyak lag
Galat tidak membaik setelah AR(2), dan menjadi lebih buruk pada AR(10) dan AR(20). Koefisien tambahan tersebut menyesuaikan derau pada data latih.
Anda juga akan melihat AR(1) berkinerja sama baiknya dengan AR(2) di sini. Koefisien kedua yang diestimasi kecil, sehingga sedikit menambah nilai pada set uji ini. Ketika dua model berkinerja sama, yang lebih sederhana lebih mudah dijelaskan dan lebih kecil kemungkinannya gagal pada data baru.
Ada sisi biaya juga. AR(20) mengestimasi 21 parameter alih-alih 3.
Intinya, biarkan PACF dan kriteria informasi menyarankan orde, lalu konfirmasikan pada set uji.
Model AR cocok untuk banyak masalah peramalan, tetapi tidak semuanya. Berikut di mana mereka bekerja dan tidak, serta bagaimana perbandingannya dengan model yang dibangun di atasnya.
Model AR memiliki dua manfaat utama:
Mereka juga memiliki dua keterbatasan utama:
Ada satu masalah lagi. Nilai berlag saling berkorelasi karena berasal dari deret yang sama. Pada data permintaan, korelasi antara y_t-1 dan y_t-2 adalah 0,78.
Ini disebut multikolinearitas, dan itu mempengaruhi model regresi apa pun. Ketika dua prediktor bergerak bersama, model kesulitan mengetahui mana yang bertanggung jawab. Koefisien menjadi kurang stabil, dan standar error-nya naik.
Itu menjelaskan apa yang Anda lihat sebelumnya. Model mengestimasi 0.676 dan 0.138 alih-alih 0.6 dan 0.25 — ia memindahkan bobot dari satu lag ke lag lainnya, tetapi jumlahnya tetap mendekati. Prediksi tidak terlalu terdampak oleh hal ini, namun Anda tidak bisa terlalu mempercayai koefisien individual. Setiap lag tambahan memperburuk masalah.
AR adalah salah satu dari tiga blok bangunan peramalan deret waktu klasik. Dua lainnya adalah model moving average (MA) dan ARIMA, yang menggabungkannya.
Model AR memprediksi dari nilai masa lalu. Model MA memprediksi dari galat masa lalu:
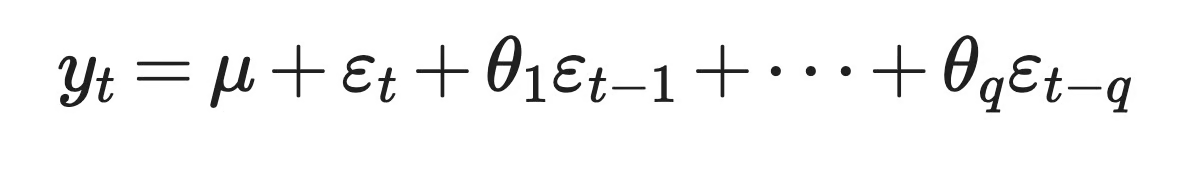
Model ARMA
Di sini, mu adalah rerata deret, theta_1 hingga theta_q adalah koefisien, dan epsilon_t-1 hingga epsilon_t-q adalah guncangan acak dari langkah sebelumnya. Jangan bingungkan dengan moving average dalam arti rerata bergerak. Namanya sama, tetapi modelnya berbeda.
Kedua model bereaksi terhadap guncangan dengan cara berbeda. Dalam model MA(q), guncangan memengaruhi deret tepat selama q langkah. Dalam model AR, guncangan memudar seiring waktu tetapi tidak pernah benar-benar nol. Perbedaan ini juga menjadi alasan Anda menggunakan alat berbeda untuk memilih orde — PACF terputus setelah lag p untuk model AR, dan ACF terputus setelah lag q untuk model MA.
ARIMA menyatukan semuanya. ARIMA(p, d, q) memiliki tiga bagian:
Ini berarti AR adalah kasus khusus dari ARIMA. Jika Anda menetapkan d dan q ke nol, Anda mendapatkan model AR. Anda bisa memeriksanya dengan data permintaan:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))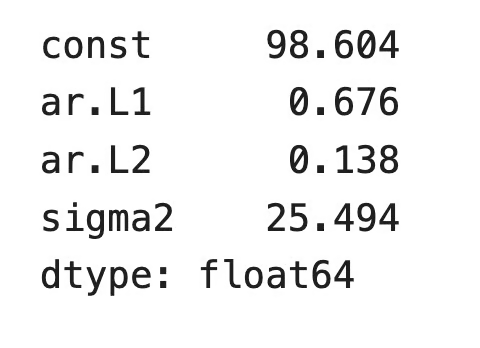
Model ARIMA dengan orde integrasi dan moving average 0
Koefisien AR cocok dengan yang dari AutoReg. Konstanta berbeda karena ARIMA melaporkan rerata deret, sedangkan AutoReg melaporkan intersep c.
Sekarang mari lihat sejauh mana ARIMA melangkah. Misalkan kota berkembang, dan permintaan listrik meningkat sedikit setiap hari. Deret kini memiliki tren, sehingga uji ADF gagal, dan model AR tidak lagi bisa langsung bekerja dengan deret tersebut.
Namun model ARIMA(2, 1, 0) bisa. Ia melakukan differencing sekali, sehingga model bekerja dengan perubahan harian permintaan alih-alih nilai mentah, lalu memasang AR(2) pada perubahan tersebut. Jika guncangan seperti gelombang panas juga memengaruhi permintaan hari berikutnya, Anda bisa menambahkan komponen MA dan mendapatkan ARIMA(2, 1, 1).
Bagian AR melakukan pekerjaan yang sama dalam setiap kasus. ARIMA hanya menyiapkan data untuknya dan memodelkan sisanya. Jika Anda ingin mendalami, kursus ARIMA Models in R membahas proses lengkapnya.
Model autoregresif memprediksi nilai berikutnya dari suatu deret dari masa lalunya sendiri. Ini adalah regresi linear di mana prediktornya adalah salinan berlag dari target, dan itu menjadikannya salah satu model deret waktu yang paling mudah dipahami.
Anda akan melihatnya di ekonomi, pengodean ucapan, analisis EEG, dan bahkan pada nama model bahasa saat ini. Anda juga telah melihat di mana ini bukan opsi terbaik, karena membutuhkan data stasioner, bergantung pada orde lag yang tepat, dan lag yang berkorelasi membuat koefisien individual kurang andal.
Jika Anda memahami model AR, sisanya dari peramalan klasik menjadi jauh lebih mudah. ARIMA adalah langkah berikutnya yang alami, dan tutorial ARIMA kami menunjukkan bagaimana differencing dan komponen MA memperluas apa yang telah Anda pelajari di sini. Untuk jalur praktik langsung, coba kursus ARIMA Models in Python kami.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



