Curs
Analiza seriilor de timp în Python
4 ore
70.9K
Majoritatea conținutului online trece direct la ARIMA și acordă părții AR o singură propoziție de explicație, dacă o face. Dar AR este fundația modelului. Dacă nu o înțelegi, restul din ARIMA nu va avea sens.
Pe scurt, un model autoregresiv prezice valorile viitoare ale unei serii temporale din propriile valori trecute. Îl vei întâlni în economie, finanțe, procesarea semnalelor și date climatice. În esență este un model de regresie, așa că leagă ceea ce știi deja despre regresie de prognoza seriilor temporale, și este baza pe care e construit ARIMA.
În acest articol, te ghidez prin modul în care funcționează un model autoregresiv, cum să îl potrivești în Python cu statsmodels și cum să alegi ordinul corect al întârzierii.
Un model autoregresiv prezice următoarea valoare a unei serii temporale dintr-o sumă ponderată a valorilor sale anterioare.
În denumire, „auto” înseamnă sine, iar „regresie” înseamnă că prezici o variabilă din altele. Așadar, un model autoregresiv este o regresie a unei serii pe propriul său trecut.
Să zicem că vrei să prezici cererea de electricitate de mâine. Cererea de azi e un punct de plecare bun, iar cea de ieri adaugă puțină informație în plus. Un model autoregresiv transformă această intuiție într-o formulă și învață ponderile din datele tale.
Modelele AR se scriu ca AR(p), unde p este ordinul modelului. Ordinul îți spune câte valori trecute folosește modelul:
p valoriUn ordin mai mare nu înseamnă automat un model mai bun. Îți voi arăta cum să alegi p mai târziu în articol.
Iată forma generală a unui model AR(p):
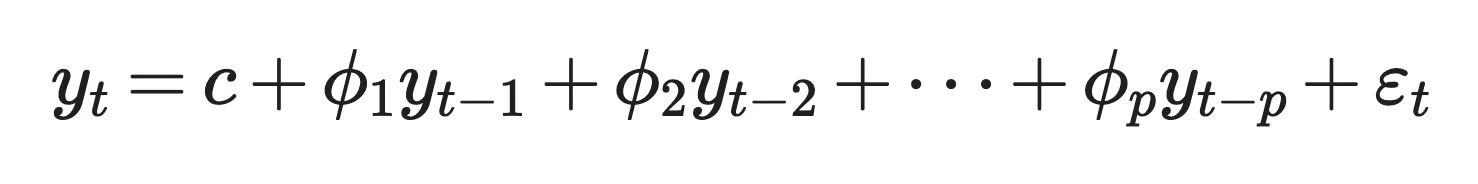
Modelul AR(p) general
Ce înseamnă fiecare termen
y_t: Valoarea seriei la momentul t, adică valoarea pe care vrei să o prezici
c: O constantă care, împreună cu coeficienții, stabilește media pe termen lung a seriei
phi_1 până la phi_p: Coeficienții, care îți spun cât contribuie fiecare valoare trecută la predicție
y_t-1 până la y_t-p: Valorile întârziate, unde „întârziere” înseamnă cu câți pași în urmă te uiți
epsilon_t: Zgomot alb, adică o eroare aleatoare cu media zero, varianță constantă și fără corelație în timp
Pe scurt, modelul înmulțește fiecare dintre ultimele p valori cu propria pondere și adaugă constanta. Ce rămâne este zgomotul, partea din y_t pe care trecutul nu o poate explica.
AR(1) este cea mai simplă versiune:
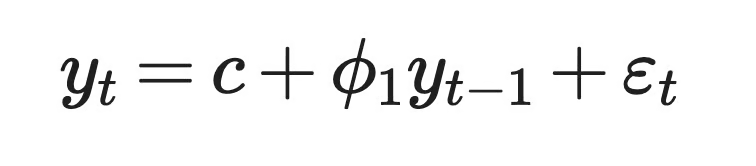
Modelul AR(1)
Valoarea lui phi_1 controlează cât de mult influențează ziua de azi ziua de mâine.
Să zicem că c = 2 și phi_1 = 0.8. Dacă valoarea de azi este 15, modelul prezice 2 + 0.8 x 15 = 14 pentru mâine. Următoarea predicție este 2 + 0.8 x 14 = 13.2. Fiecare pas aduce seria mai aproape de 10, care este media pe termen lung, c / (1 - phi_1).
Dacă phi_1 este negativ, seria sare deasupra și sub medie de la un pas la altul.
AR(2) adaugă o a doua întârziere:
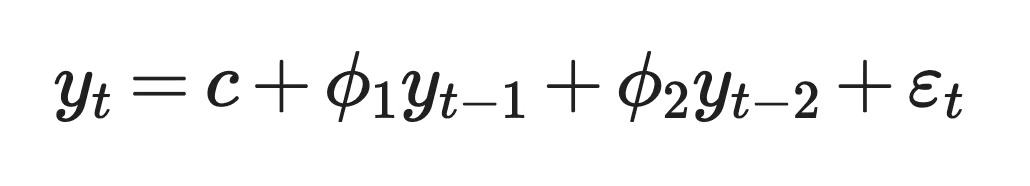
Modelul AR(2)
Cu două întârzieri, modelul poate descrie tipare pe care AR(1) nu le poate, precum ciclurile. De exemplu, un phi_1 pozitiv cu un phi_2 negativ poate produce o serie care urcă și coboară în valuri, similar unui ciclu economic.
Așadar, orice model AR se reduce la două alegeri — câte întârzieri să folosești și ce ponderi să le atribui.
Un model AR funcționează doar când două lucruri sunt adevărate despre datele tale. Valorile trecute trebuie să fie legate de valorile viitoare, iar seria trebuie să se comporte la fel în timp. Prima se numește autocorelație, iar a doua staționaritate.
Autocorelația este corelația dintre o serie temporală și o copie întârziată a acesteia.
Este motivul pentru care există modelele AR. Dacă valoarea de azi nu îți spune nimic despre cea de mâine, modelul nu are ce învăța din valorile trecute.
În cod, iei o coloană de valori, o copiezi și deplasezi copia în jos cu un rând. Acum fiecare rând asociază o valoare cu valoarea anterioară. Corelația dintre cele două coloane este autocorelația de ordin 1. Când deplasezi cu două rânduri, obții autocorelația de ordin 2.
Iată cum arată în pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))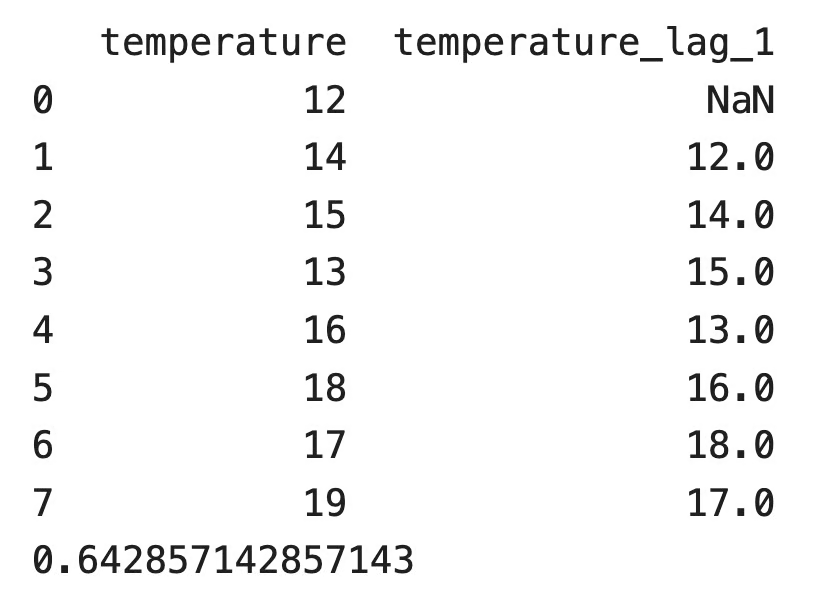
DataFrame cu coloana temperature și copia sa întârziată de ordin 1
Primul rând al coloanei întârziate este gol pentru că nu există o citire înainte de prima. pandas sare peste acel rând și returnează o autocorelație de ordin 1 de 0,643. Zilele calde tind să urmeze zilelor calde în această serie.
Semnul autocorelației schimbă comportamentul seriei:
O autocorelație aproape de zero înseamnă că trecutul nu ajută. În acest caz, un model AR nu va face mult mai bine decât să prezică media.
Modelele AR au nevoie de o serie temporală staționară.
O serie staționară are aceeași medie, aceeași varianță și aceeași autocorelație la un anumit ordin, indiferent de ce parte a seriei privești. Statisticienii numesc asta staționaritate în sens slab.
Contează pentru că modelul estimează un set fix de coeficienți. Dacă media seriei derivă în timp, coeficienții învățați din date mai vechi nu vor descrie datele mai noi. Prețurile acțiunilor sunt un exemplu obișnuit de serie nestoționară, pentru că au trend de-a lungul anilor. Randamentele zilnice sunt mult mai aproape de staționare.
Chiar coeficienții decid dacă un proces AR este staționar. Pentru AR(1), regula e simplă: phi_1 trebuie să fie între -1 și 1.
abs(phi_1) < 1: Șocurile se estompează în timp, iar seria revine la medie
phi_1 = 1: Seria devine un mers aleator (random walk), iar șocurile nu se estompează niciodată
abs(phi_1) > 1: Fiecare șoc crește, iar seria „explodează”
AR(2) are nevoie de trei condiții simultan: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 și abs(phi_2) < 1.
După două întârzieri, ai nevoie de o regulă generală. Fiecare model AR(p) are un polinom caracteristic:
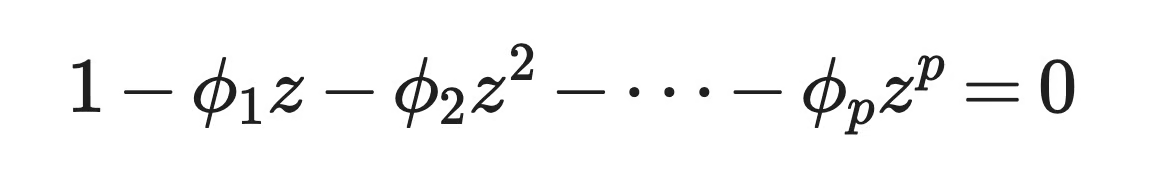
Polinom caracteristic
Procesul este staționar în sens slab când toate rădăcinile acestui polinom sunt în afara cercului unitate, adică fiecare rădăcină z are valoarea absolută mai mare decât 1. Rădăcinile pot fi numere complexe, de aceea frontiera este un cerc în planul complex, nu o linie.
Poți verifica asta cu AR(1). Polinomul este 1 - phi_1 z = 0, deci rădăcina e z = 1 / phi_1. Acea rădăcină e în afara cercului unitate doar când abs(phi_1) < 1, ceea ce este aceeași regulă ca înainte.
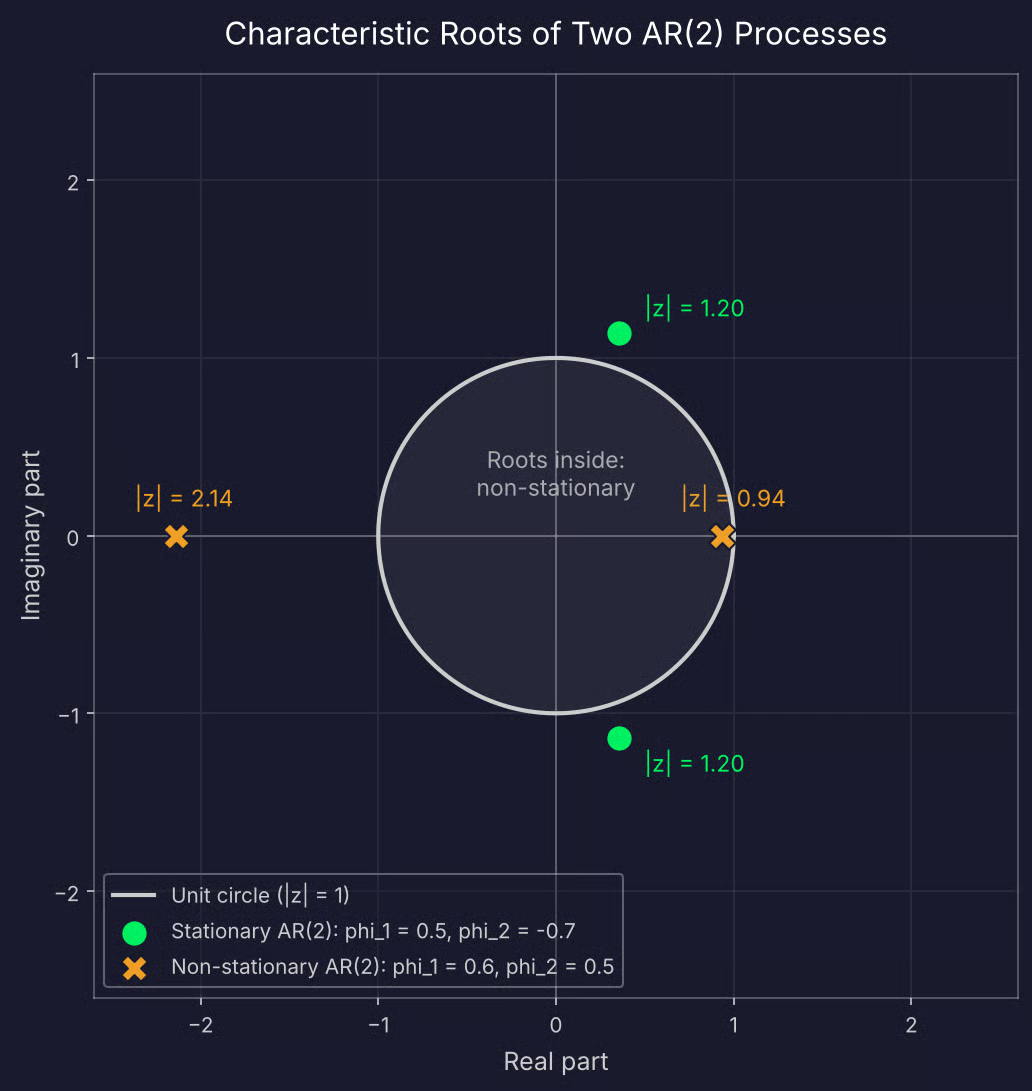
Rădăcinile unui proces AR(2) staționar și nestoționar
Nu vei calcula aceste rădăcini manual. statsmodels le returnează după ce potrivești un model, iar în secțiunea de Python îți voi arăta cum să testezi chiar datele pentru staționaritate.
Dacă seria ta nu e staționară, o poți diferenția — scazi fiecare valoare din următoarea — și modelezi diferențele. Asta înseamnă „I”-ul din modelele ARIMA.
Fiecare model AR are aceeași ecuație. Ce se schimbă de la un tip la altul este ordinul p, adică câte valori trecute folosește modelul.
AR(1) folosește doar valoarea precedentă pentru a o prezice pe următoarea.
Dacă sună ca regresia liniară, e pentru că este. Când pui y_t-1 pe axa x și y_t pe axa y, AR(1) potrivește o linie dreaptă prin puncte. Constanta c este interceptul, iar phi_1 este panta. Dacă știi regresie liniară simplă, deja știi cum se estimează AR(1).
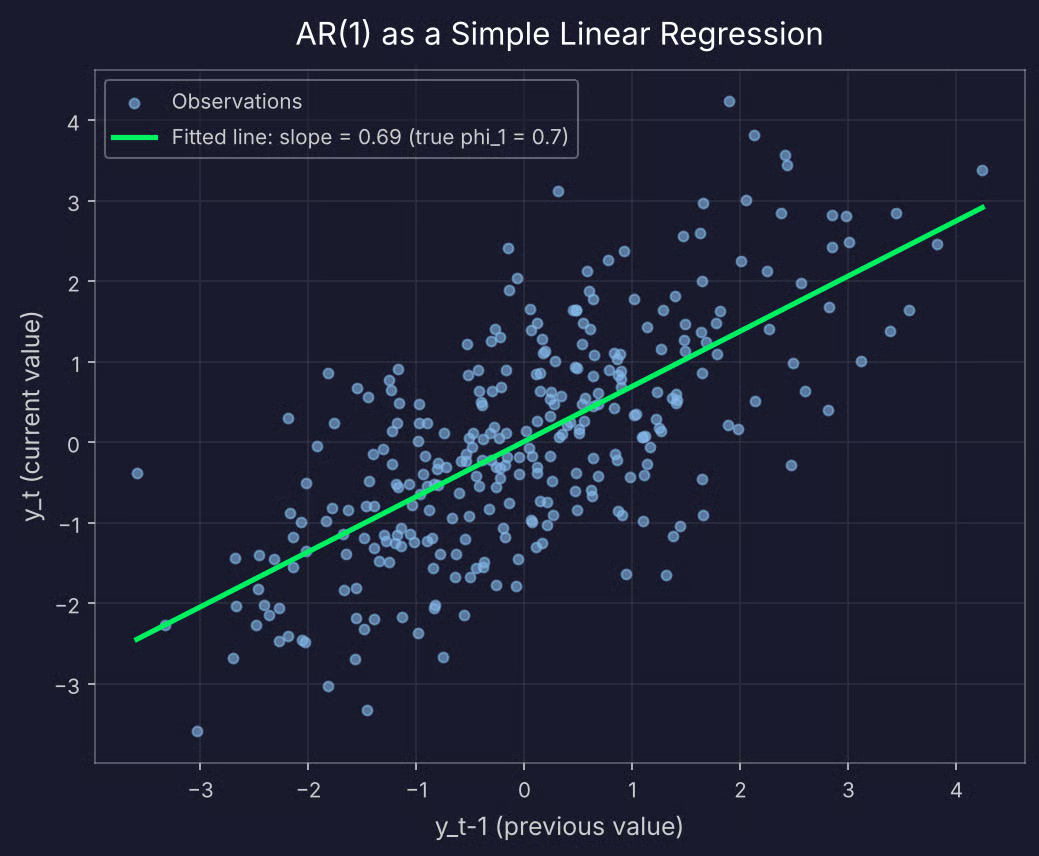
Diagrafmă scatter a lui y_t față de y_t-1 pentru AR(1)
Dar există o diferență. Într-o regresie standard, predictorul și ținta sunt variabile separate. În AR(1), predictorul este aceeași serie deplasată cu un pas. De aceea nu poți amesteca rândurile sau folosi un split aleator train/test — ordinea datelor face parte din model.
Valoarea lui phi_1 schimbă aspectul seriei:
phi_1 = 0.3: Seria arată aproape ca un zgomot aleator, deoarece fiecare valoare poartă puțină informație despre următoarea
phi_1 = 0.9: Seria se mișcă în oscilații lungi și line și îi ia timp să revină la medie
phi_1 = -0.8: Seria „zigzaghează” deasupra și sub medie la aproape fiecare pas
phi_1 = 1: Seria devine un mers aleator și derivă fără o medie la care să revină, ceea ce este cazul nestoționar din secțiunea anterioară
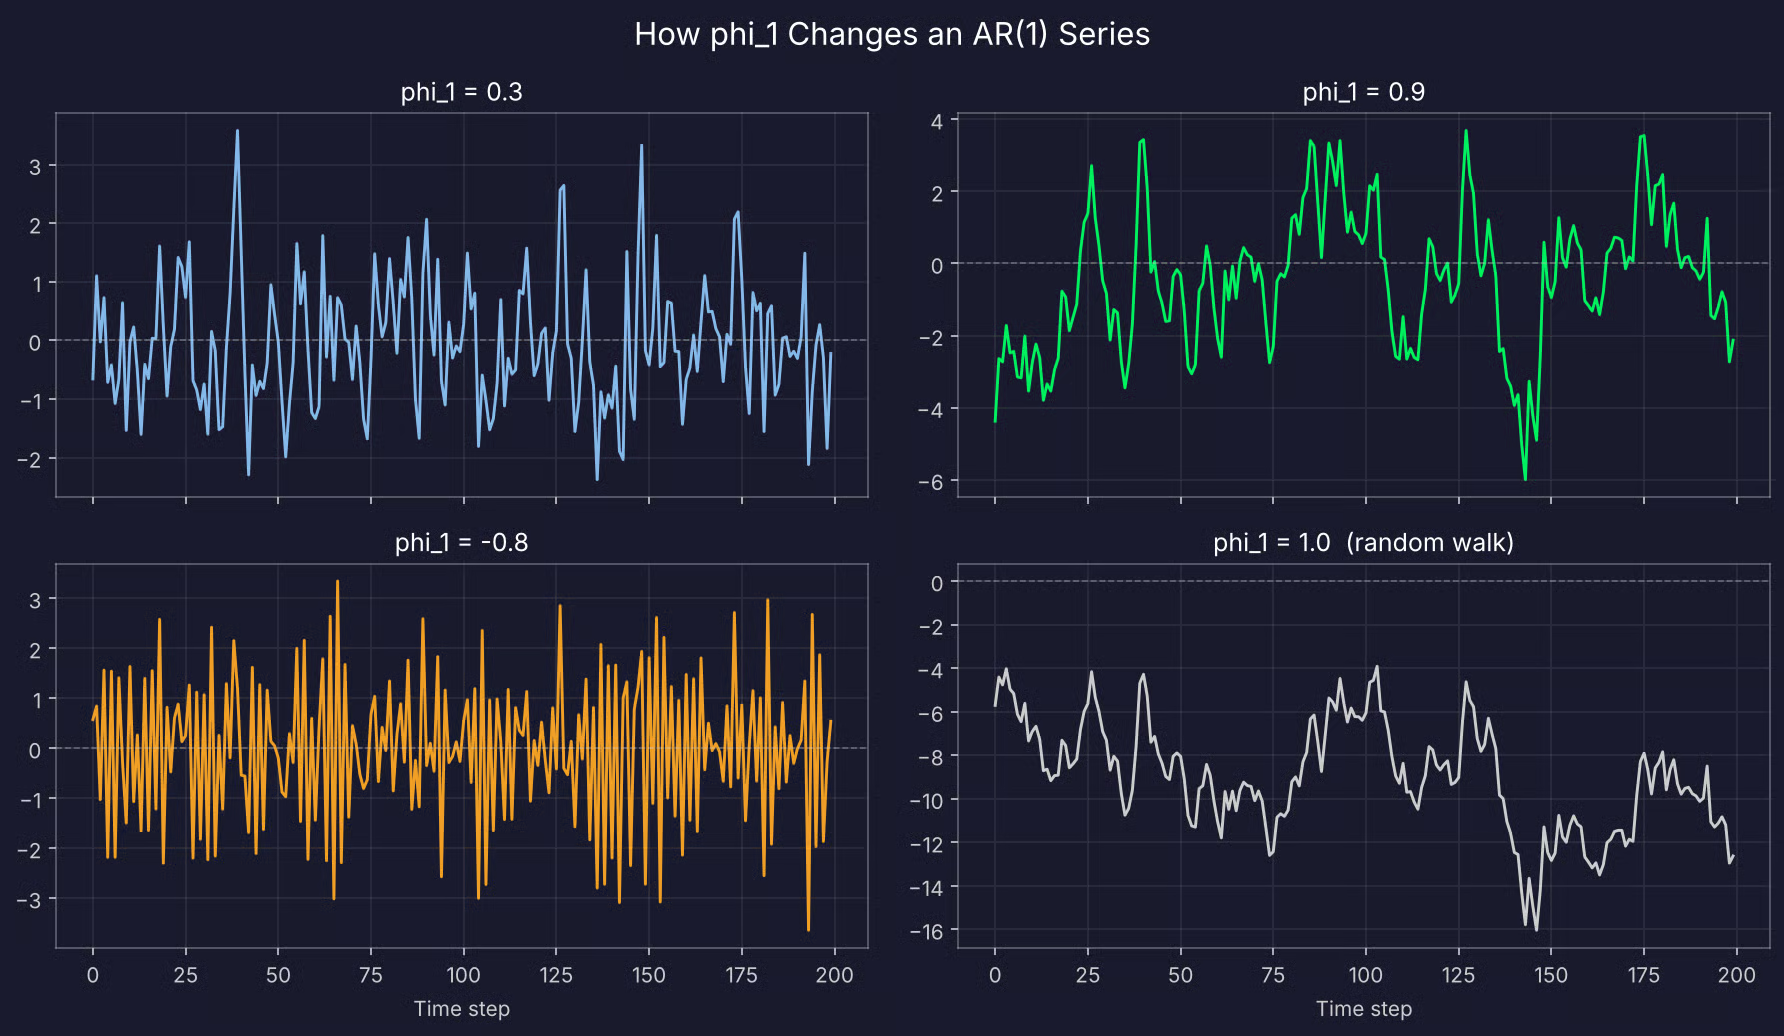
Patru serii AR(1) simulate
Cu cât phi_1 se apropie mai mult de 1 sau -1, cu atât un singur șoc afectează seria mai mult timp.
AR(2) folosește precedentele două valori. A doua întârziere permite modelului să producă tipare pe care AR(1) nu le poate, în principal cicluri.
Iată cum se compară două seturi de coeficienți:
phi_1 = 0.5, phi_2 = 0.3: Ambele întârzieri împing în aceeași direcție, așa că seria arată ca un AR(1) cu oscilații mai lungi și mai line
phi_1 = 0.5, phi_2 = -0.7: A doua întârziere lucrează împotriva primeia, iar seria urcă și coboară în valuri care se repetă aproximativ la fiecare cinci pași
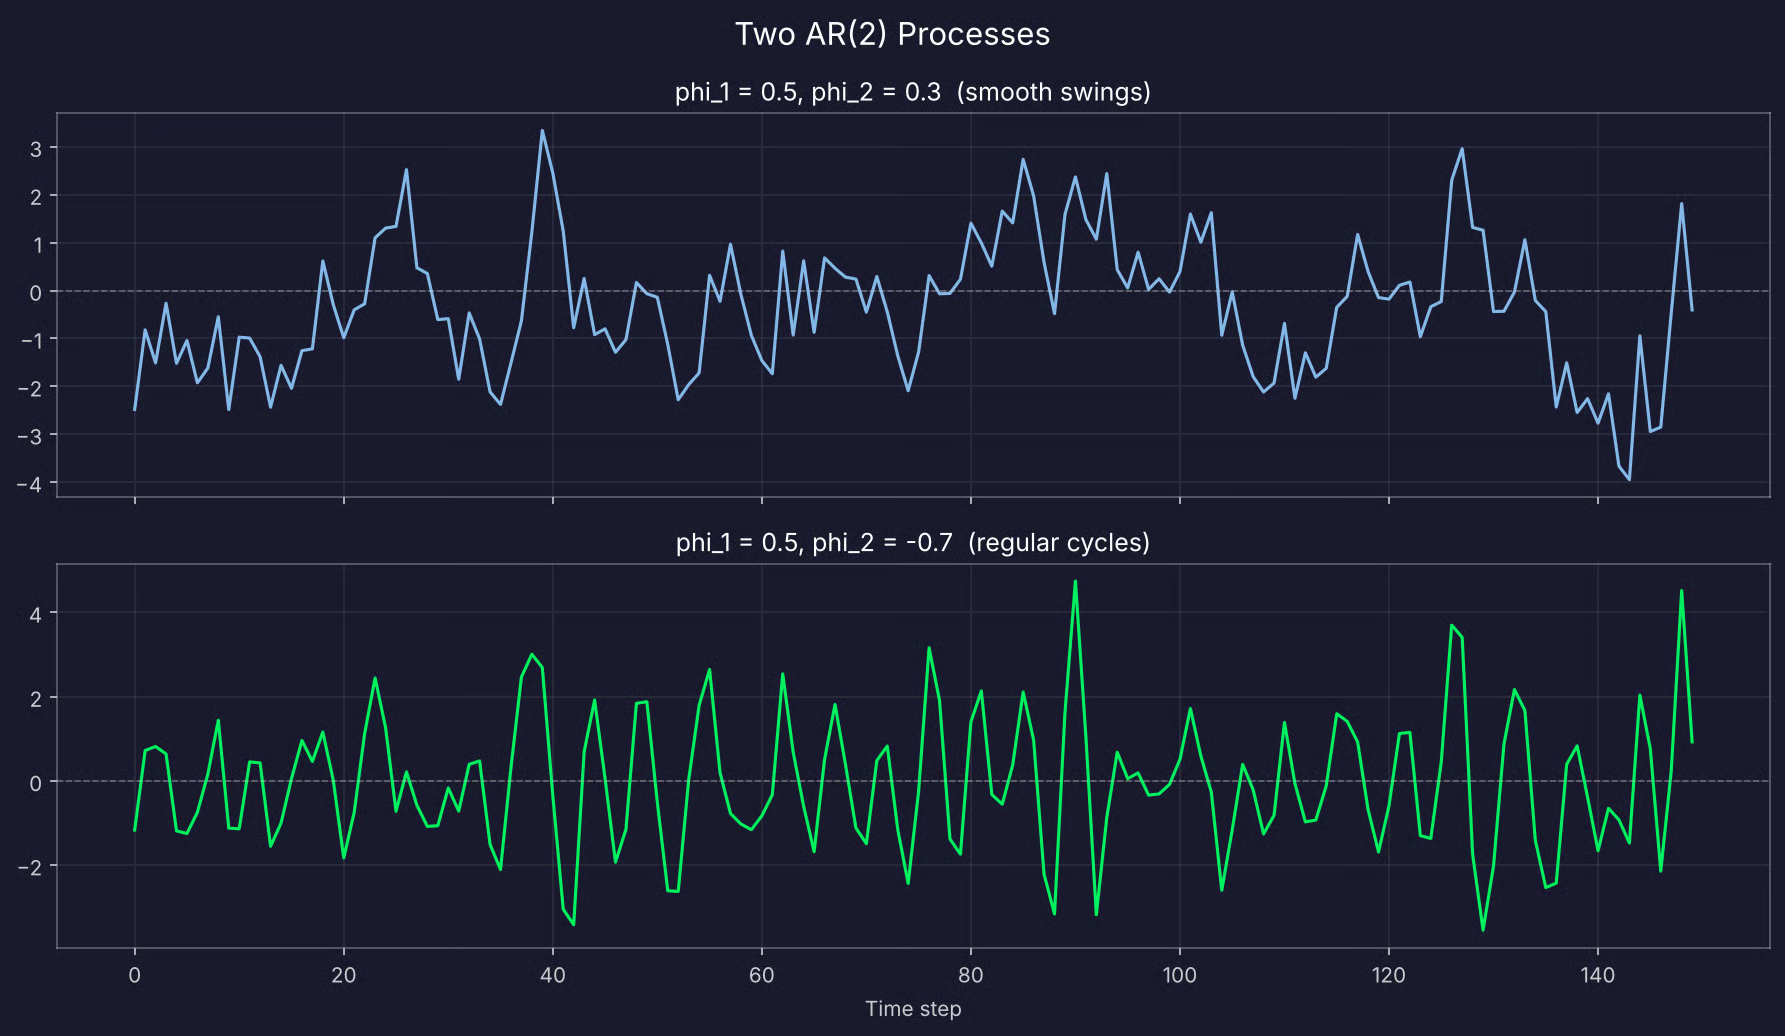
Două serii AR(2) simulate
AR(3), AR(4) și mai departe adaugă câte o întârziere pe rând. Ai nevoie de ele când valorile mai îndepărtate în timp poartă informație pe care cele recente nu o au.
Să zicem că modelezi vânzări lunare, iar aceeași lună de anul trecut prezice bine luna aceasta. Un model AR(12) include acea întârziere de 12 luni, împreună cu cele 11 întârzieri dintre ele.
Fiecare întârziere în plus adaugă un coeficient de estimat. Asta înseamnă că ai nevoie de mai multe date, iar riscul de supraînvățare crește. Coeficienții devin și mai greu de interpretat — cu 12 dintre ei, nu poți privi numerele și spune ce va face seria. Verifici în schimb rădăcinile.
Îți voi arăta cum să alegi ordinul corect cu PACF și AIC în secțiunea de Python.
Modelele AR apar oriunde datele sunt stocate în ordine și trecutul recent spune ceva despre viitorul apropiat.
Majoritatea utilizărilor se încadrează în patru grupe:
Ultima îi surprinde pe mulți, pentru că termenul din spatele chatbot-urilor de azi vine din aceeași statistică despre care citești aici.
În această secțiune, voi potrivi un model autoregresiv în Python cu statsmodels, de la date brute până la o prognoză pe care o poți evalua.
Ai nevoie de pandas și NumPy pentru date, statsmodels pentru model și teste, și scikit-learn pentru metrica de eroare:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorVoi simula doi ani de cerere zilnică de electricitate dintr-un proces AR(2).
Am ales date simulate pentru că știi coeficienții reali din start. Astfel poți verifica dacă modelul îi găsește și dacă instrumentele de selecție a întârzierilor indică ordinul corect.
Procesul are c = 15, phi_1 = 0.6 și phi_2 = 0.25, ceea ce plasează media pe termen lung la 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()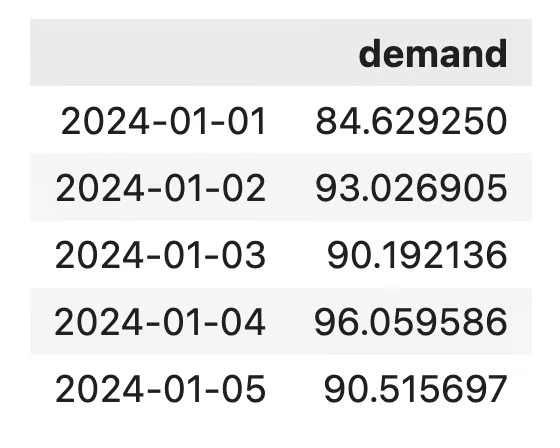
Setul de date cu cererea zilnică de electricitate
Primele 100 de zile simulate sunt eliminate pentru că acea perioadă de „burn-in” oferă seriei timp să intre în comportamentul ei normal înainte să începi să o folosești.
Iată cum arată seria completă:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()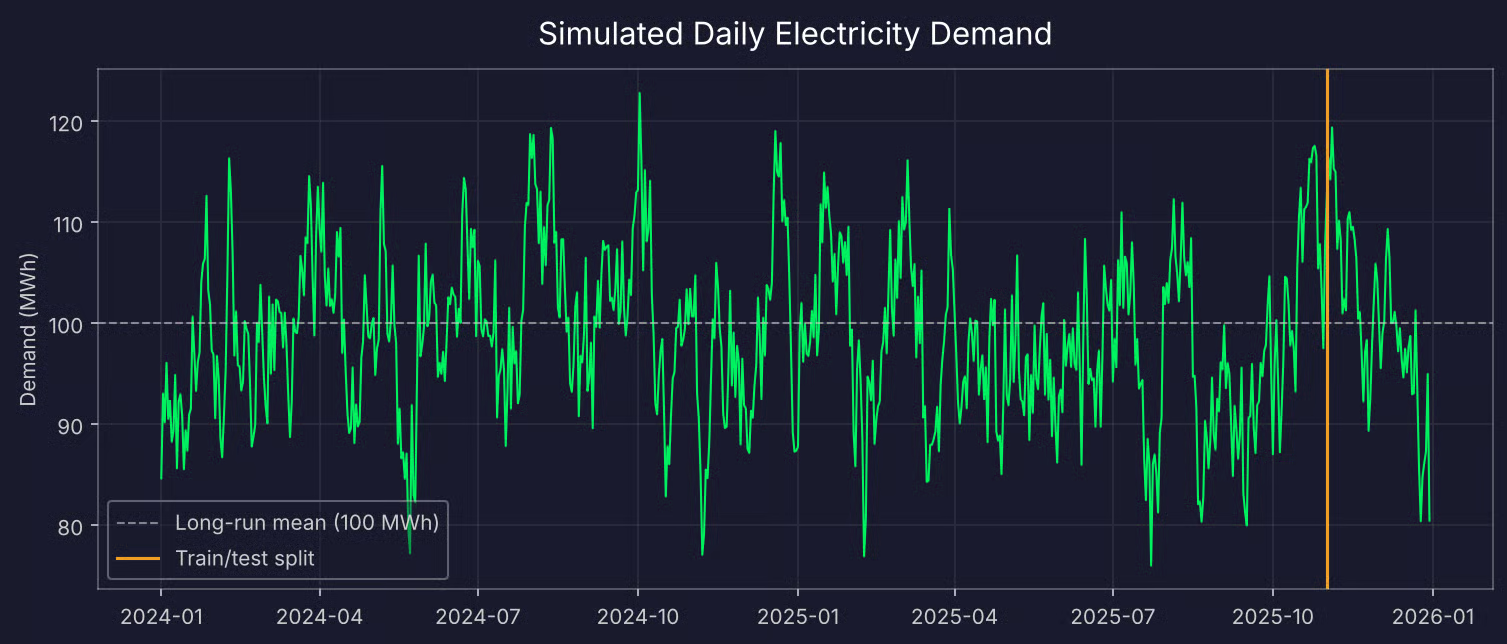
Doi ani de cerere zilnică de electricitate simulată
Seria urcă și coboară în jurul valorii 100 fără trend, ceea ce ar trebui să arate o serie staționară. Dar o verificare vizuală nu e o dovadă.
Testul Dickey-Fuller augmentat (ADF) verifică dacă o serie este staționară. Ipoteza lui nulă este că seria nu e staționară, deci o valoare p mică este ceea ce vrei:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")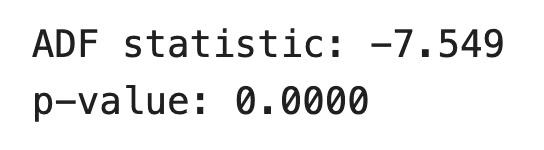
Rezultatele testului ADF
Valoarea p este mult sub 0,05, deci poți respinge ipoteza nulă și trata seria ca staționară.
Dacă propriile tale date pică acest test, diferențiază-le cu df["demand"].diff().dropna() și rulează din nou testul.
Datele de tip serie temporală nu pot fi amestecate, deci setul de testare trebuie să provină din finalul seriei. Voi păstra ultimele 60 de zile pentru testare:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Rămân 670 de zile pentru antrenare și 60 pentru testare.
Acesta este pasul care decide cât de bine funcționează modelul. Dacă alegi prea puține întârzieri, modelul ratează tipare din date. Dar dacă alegi prea multe, potrivește zgomot din datele de antrenament care nu se va repeta în viitor.
Ai două instrumente pentru asta.
Primul este funcția de autocorelație parțială (PACF). Aceasta arată corelația dintre serie și fiecare întârziere după ce elimină efectul tuturor întârzierilor mai scurte. Pentru un proces AR(p), PACF are vârfuri semnificative până la întârzierea p și scade spre zero după aceea:
plot_pacf(train, lags=20, method="ywm")
plt.show()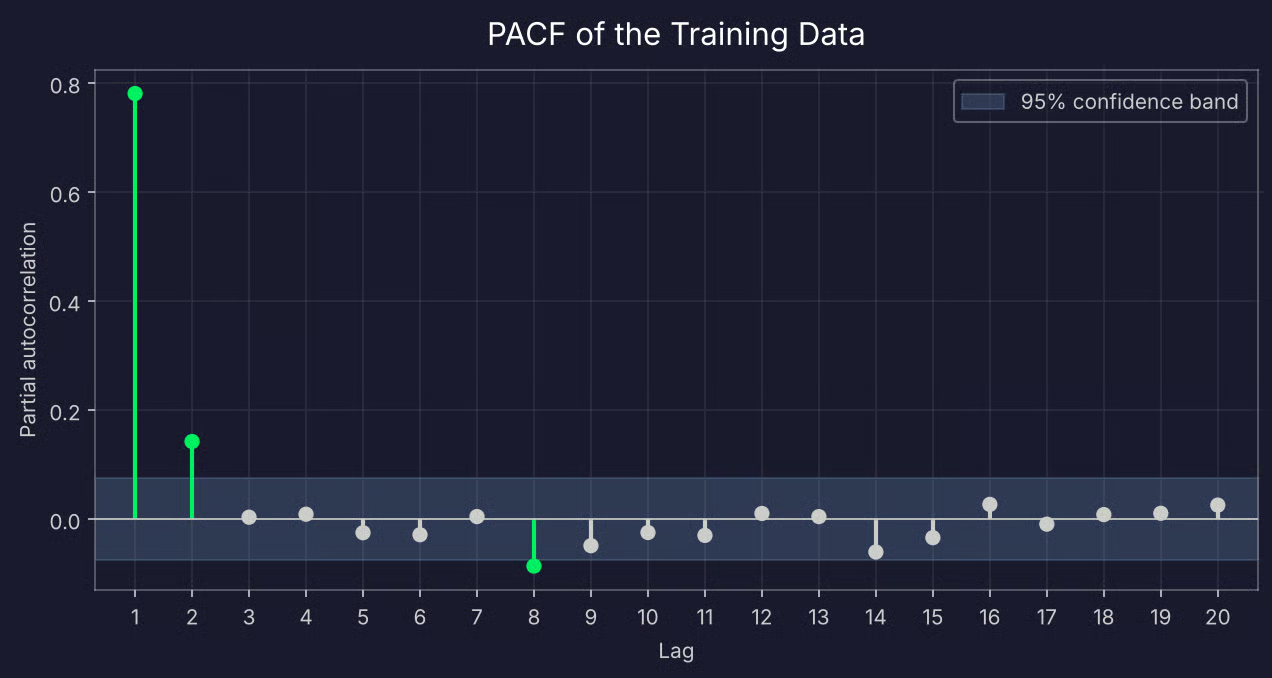
PACF pentru datele de antrenament
Întârzierile 1 și 2 sunt mult în afara benzii de încredere, iar întârzierea 3 scade aproape de zero. Asta indică AR(2).
Există și un mic vârf la întârzierea 8, chiar dincolo de marginea benzii. Nu-l interpreta prea mult. Banda este trasată la o încredere de 95%, așa că, cu 20 de întârzieri, te-ai aștepta ca aproximativ una să o depășească din întâmplare.
Al doilea instrument este criteriile informaționale. AIC și BIC răsplătesc un model pentru potrivirea bună a datelor și îl penalizează pentru fiecare parametru în plus. BIC aplică o penalizare mai mare, deci tinde să aleagă modele mai mici. statsmodels poate testa fiecare ordin până la un maxim și îl returnează pe cel mai bun:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")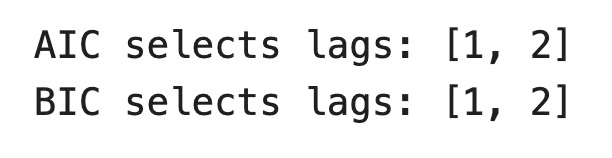
Selecția întârzierilor cu AIC/BIC
Ambele criterii sunt de acord cu PACF. În practică, vei vedea adesea AIC alegând un model puțin mai mare decât BIC. Dacă se întâmplă asta, începe cu cel mai mic.
Cu ordinul ales, potrivirea modelului necesită două linii de cod:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")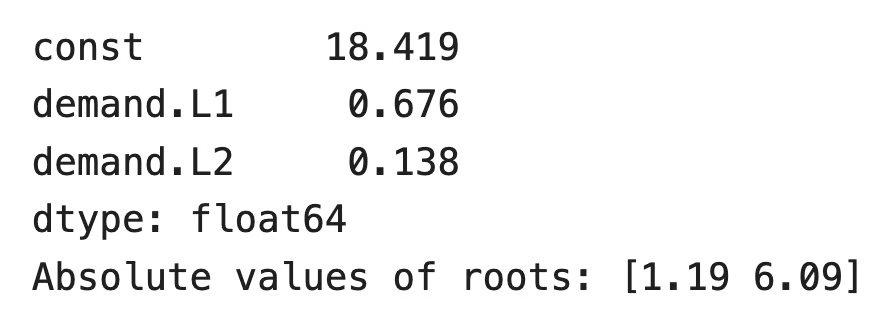
Parametrii modelului AR(2)
Valorile reale sunt 0,6 și 0,25. Modelul dă puțin mai multă greutate primei întârzieri și mai puțină celei de-a doua, dar suma celor doi coeficienți este apropiată — 0,81 față de 0,85. Cu 670 de puncte de date, nu vei recupera valorile exacte.
Ambele rădăcini au modulul mai mare decât 1, deci modelul potrivit este staționar. Poți apela results.summary() dacă vrei erori standard, valori p și tabelul complet al rădăcinilor.
Există două moduri de a prognoza perioada de test, iar ele răspund la întrebări diferite:
Prognozele multi-pas vin direct din rezultatele potrivite. Pentru prognozele un pas înainte, aplici coeficienții antrenați la seria completă:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")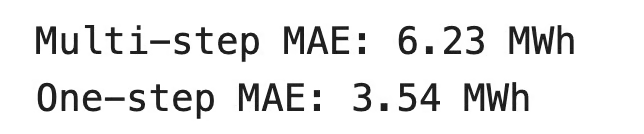
Rezultatele prognozei
Mean absolute error (MAE) este diferența absolută medie dintre predicții și valorile reale. Este în aceeași unitate ca datele, deci o poți citi direct. Prognoza un pas înainte greșește în medie cu 3,54 MWh.
Iată cum se compară ambele prognoze cu valorile reale:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()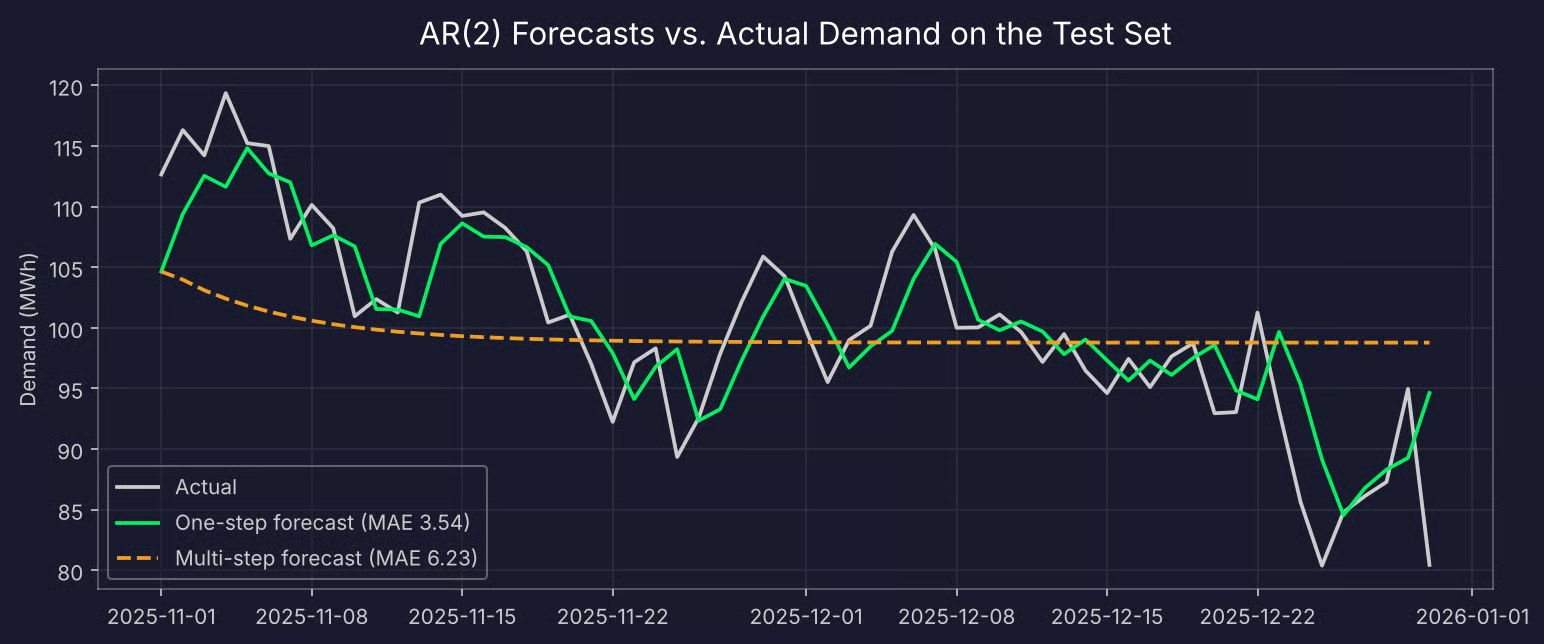
Prognoze AR(2) un pas și multi-pas comparate cu cererea reală
Prognoza un pas înainte urmărește îndeaproape valorile reale, la aproximativ o zi în urmă. Prognoza multi-pas pornește de la ultima valoare cunoscută și apoi se aplatizează aproape de medie în circa trei săptămâni.
Așa se comportă orice model AR staționar — cu cât prognozezi mai departe, cu atât trecutul îți spune mai puțin, iar cea mai bună estimare devine media pe termen lung. De aceea modelele AR funcționează cel mai bine pentru prognoze pe termen scurt.
E ușor să presupui că mai mult istoric înseamnă predicții mai bune. Hai să testăm, potrivind modele cu un număr crescător de întârzieri și comparând MAE la un pas înainte:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")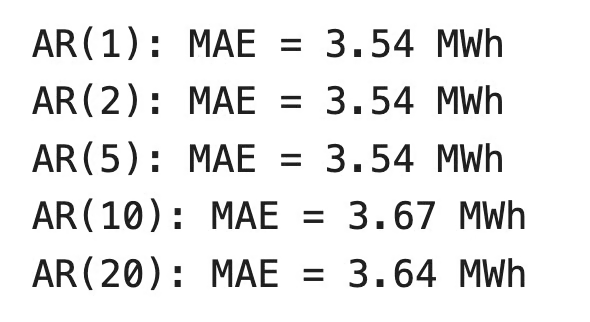
MAE cu mai multe întârzieri
Eroarea nu se îmbunătățește după AR(2) și devine mai mare la AR(10) și AR(20). Acei coeficienți în plus potrivesc zgomot din datele de antrenament.
Vei observa și că AR(1) se descurcă la fel de bine ca AR(2) aici. Al doilea coeficient estimat este mic, deci adaugă puțin pe acest set de test. Când două modele performează la fel, cel mai simplu e mai ușor de explicat și mai puțin probabil să cedeze pe date noi.
Există și un cost. AR(20) estimează 21 de parametri în loc de 3.
Pe scurt, lasă PACF și criteriile informaționale să sugereze ordinul, apoi confirmă-l pe un set de test.
Modelele AR sunt potrivite pentru multe probleme de prognoză, dar nu pentru toate. Iată unde funcționează și unde nu, și cum se compară cu modelele construite peste ele.
Modelele AR au două beneficii principale:
Au și două limitări principale:
Mai există o problemă. Valorile întârziate sunt corelate între ele pentru că provin din aceeași serie. În datele de cerere, corelația dintre y_t-1 și y_t-2 este 0,78.
Aceasta se numește multicoliniaritate, și afectează orice model de regresie. Când doi predictori se mișcă împreună, modelul are dificultăți în a stabili care este „responsabil”. Coeficienții devin mai puțin stabili, iar erorile standard cresc.
Asta explică ce ai văzut mai devreme. Modelul a estimat 0,676 și 0,138 în loc de 0,6 și 0,25 — a mutat greutate de la o întârziere la alta, dar suma a rămas apropiată. Predicțiile nu suferă prea mult din asta, dar nu te poți baza la fel de mult pe coeficienții individuali. Fiecare întârziere în plus agravează problema.
AR este una dintre cele trei cărămizi de bază ale prognozei clasice a seriilor temporale. Celelalte două sunt modelele de medie mobilă (MA) și ARIMA, care le combină.
Un model AR prezice din valori trecute. Un model MA prezice din erori trecute:
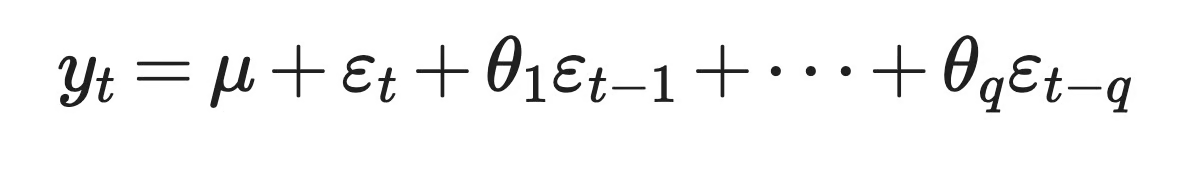
Modelul ARMA
Aici, mu este media seriei, theta_1 până la theta_q sunt coeficienții, iar epsilon_t-1 până la epsilon_t-q sunt șocurile aleatoare din pașii anteriori. Nu îl confunda cu o medie mobilă în sensul mediei glisante. Numele este același, dar modelul e diferit.
Cele două modele reacționează diferit la șocuri. Într-un model MA(q), un șoc afectează seria exact q pași. Într-un model AR, un șoc se estompează în timp, dar nu scade niciodată complet la zero. Această diferență explică și de ce folosești instrumente diferite pentru a alege ordinul — PACF se „taie” după întârzierea p pentru modelele AR, iar ACF se „taie” după întârzierea q pentru modelele MA.
ARIMA le pune laolaltă. ARIMA(p, d, q) are trei părți:
Asta înseamnă că AR este un caz particular de ARIMA. Dacă setezi d și q la zero, obții un model AR. Poți verifica asta cu datele de cerere:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))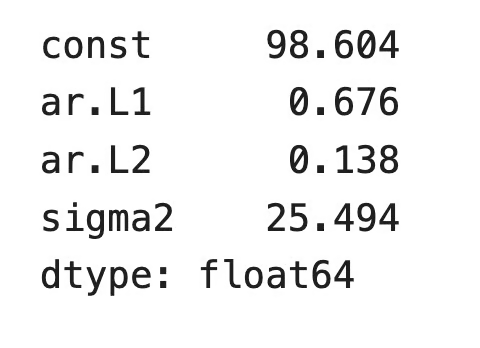
Model ARIMA cu ordin de integrare și medie mobilă 0
Coeficienții AR se potrivesc cu cei din AutoReg. Constanta este diferită pentru că ARIMA raportează media seriei, în timp ce AutoReg raportează interceptul c.
Hai să vedem unde merge mai departe ARIMA. Să zicem că orașul crește și cererea de electricitate urcă puțin în fiecare zi. Seria are acum un trend, deci testul ADF eșuează, iar un model AR nu mai poate lucra direct cu seria.
Dar modelul ARIMA(2, 1, 0) poate. Diferențiază seria o dată, astfel încât modelul lucrează cu schimbările zilnice ale cererii în loc de valorile brute, apoi potrivește AR(2) pe acele schimbări. Dacă un șoc precum un val de căldură afectează și cererea din ziua următoare, poți adăuga un termen MA și obții ARIMA(2, 1, 1).
Partea AR face același lucru în fiecare caz. ARIMA doar pregătește datele pentru ea și modelează ce rămâne. Dacă vrei să mergi mai adânc, cursul ARIMA Models in R acoperă întregul proces.
Un model autoregresiv prezice următoarea valoare a unei serii din propriul trecut. Este o regresie liniară în care predictorii sunt copii întârziate ale țintei, și asta îl face unul dintre cele mai ușor de înțeles modele de serie temporală.
Îl vei vedea în economie, codarea vorbirii, analiza EEG și chiar în numele modelelor de limbaj de azi. Ai văzut și unde nu e cea mai bună opțiune, deoarece are nevoie de date staționare, depinde de ordinul corect al întârzierii, iar întârzierile corelate fac coeficienții individuali mai puțin de încredere.
Dacă înțelegi modelele AR, restul prognozei clasice devine mult mai ușor. ARIMA este următorul pas firesc, iar tutorialul nostru ARIMA îți arată cum diferențierea și termenii MA extind ceea ce ai învățat aici. Pentru o abordare practică, încearcă cursul nostru ARIMA Models in Python.
Învăță cu DataCamp
Curs
Curs
Curs