Curso
Análisis de series temporales en Python
4 h
70.9K
La mayoría del contenido online va directo a ARIMA y, con suerte, dedica una línea a explicar la parte AR. Pero AR es la base del modelo. Si no lo entiendes, el resto de ARIMA tampoco tendrá sentido.
En pocas palabras, un modelo autorregresivo predice valores futuros de una serie temporal a partir de sus propios valores pasados. Lo verás en economía, finanzas, procesamiento de señales y datos climáticos. Es básicamente un modelo de regresión, así que conecta lo que ya sabes sobre regresión con la predicción de series temporales, y es la base sobre la que se construye ARIMA.
En este artículo, te explico cómo funciona un modelo autorregresivo, cómo ajustarlo en Python con statsmodels y cómo elegir el orden de rezago adecuado.
Un modelo autorregresivo predice el siguiente valor de una serie temporal a partir de una suma ponderada de sus valores anteriores.
En el nombre, «auto» significa propio, y «regresión» significa predecir una variable a partir de otras. Así que un modelo autorregresivo es una regresión de una serie sobre su propio pasado.
Imagina que quieres predecir la demanda eléctrica de mañana. La demanda de hoy es un buen punto de partida, y la de ayer añade algo más de información. Un modelo autorregresivo convierte esa intuición en una fórmula y aprende los pesos a partir de tus datos.
Los modelos AR se escriben como AR(p), donde p es el orden del modelo. El orden indica cuántos valores pasados usa el modelo:
p valores previosUn orden más alto no implica automáticamente un mejor modelo. Más adelante te muestro cómo elegir p.
Esta es la forma general de un modelo AR(p):
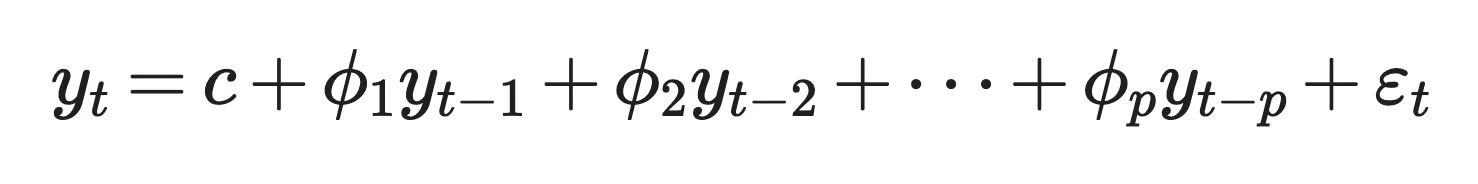
Modelo AR(p) general
Qué hace cada término
y_t: El valor de la serie en el tiempo t, que es el valor que quieres predecir
c: Una constante que, junto con los coeficientes, fija la media de largo plazo de la serie
phi_1 a phi_p: Los coeficientes, que indican cuánto aporta cada valor pasado a la predicción
y_t-1 a y_t-p: Los valores rezagados, donde «rezago» es cuántos pasos hacia atrás miras
epsilon_t: Ruido blanco, un error aleatorio con media cero, varianza constante y sin correlación en el tiempo
En sencillo, el modelo multiplica cada uno de los últimos p valores por su peso y añade la constante. Lo que sobra es ruido, la parte de y_t que el pasado no puede explicar.
AR(1) es la versión más sencilla:
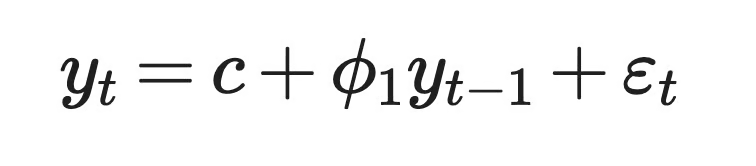
Modelo AR(1)
El valor de phi_1 controla cuánto impacta hoy en mañana.
Supón que c = 2 y phi_1 = 0.8. Si el valor de hoy es 15, el modelo predice 2 + 0.8 x 15 = 14 para mañana. La siguiente predicción es 2 + 0.8 x 14 = 13.2. Cada paso acerca la serie a 10, que es su media de largo plazo, c / (1 - phi_1).
Si phi_1 es negativo, la serie salta por encima y por debajo de la media de un paso a otro.
AR(2) añade un segundo rezago:
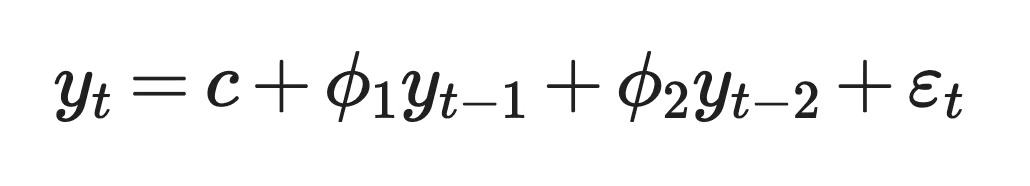
Modelo AR(2)
Con dos rezagos, el modelo puede describir patrones que AR(1) no capta, como ciclos. Por ejemplo, un phi_1 positivo con phi_2 negativo puede generar una serie que sube y baja en ondas, similar a un ciclo económico.
Así que todo modelo AR se reduce a dos decisiones: cuántos rezagos usar y qué pesos asignarles.
Un modelo AR funciona solo cuando se cumplen dos condiciones en tus datos. Los valores pasados deben estar relacionados con los futuros, y la serie debe comportarse igual a lo largo del tiempo. A lo primero se le llama autocorrelación y a lo segundo, estacionariedad.
La autocorrelación es la correlación entre una serie temporal y una copia rezagada de sí misma.
Es la razón de ser de los modelos AR. Si el valor de hoy no te dice nada sobre el de mañana, el modelo no tiene de qué aprender del pasado.
En código, tomas una columna de valores, la copias y desplazas la copia una fila hacia abajo. Ahora cada fila empareja un valor con el anterior. La correlación entre ambas columnas es la autocorrelación de rezago 1. Si desplazas dos filas, obtienes la autocorrelación de rezago 2.
Así se ve en pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))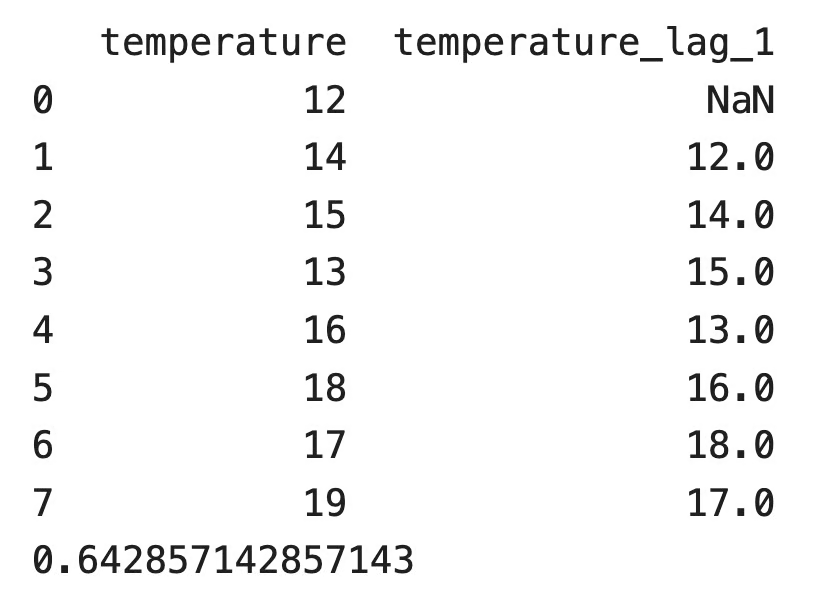
DataFrame con la columna de temperatura y su copia de rezago 1
La primera fila de la columna rezagada aparece vacía porque no hay lectura anterior a la primera. pandas omite esa fila y devuelve una autocorrelación de rezago 1 de 0.643. En esta serie, los días cálidos tienden a seguir a días cálidos.
El signo de la autocorrelación cambia cómo se comporta la serie:
Una autocorrelación cercana a cero significa que el pasado no ayuda. En ese caso, un modelo AR no hará mucho más que predecir la media.
Los modelos AR necesitan una serie temporal estacionaria.
Una serie estacionaria tiene la misma media, la misma varianza y la misma autocorrelación a un rezago dado, independientemente del tramo que mires. A esto se le llama estacionariedad en sentido débil.
Importa porque el modelo estima un conjunto fijo de coeficientes. Si la media de la serie deriva con el tiempo, los coeficientes aprendidos con datos antiguos no describirán los datos más recientes. Los precios de acciones son un ejemplo típico de serie no estacionaria porque presentan tendencia a lo largo de los años. Los rendimientos diarios son mucho más cercanos a estacionarios.
Los propios coeficientes determinan si un proceso AR es estacionario. Para AR(1), la regla es simple: phi_1 debe estar entre -1 y 1.
abs(phi_1) < 1: Los choques se desvanecen con el tiempo y la serie vuelve a su media
phi_1 = 1: La serie se convierte en un paseo aleatorio y los choques no se desvanecen
abs(phi_1) > 1: Cada choque crece y la serie explota
AR(2) necesita tres condiciones a la vez: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 y abs(phi_2) < 1.
A partir de dos rezagos, necesitas una regla general. Todo modelo AR(p) tiene un polinomio característico:
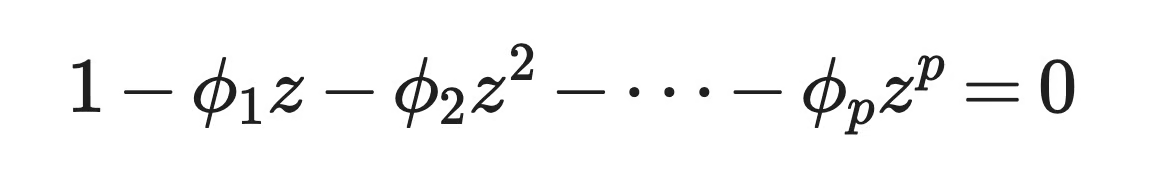
Polinomio característico
El proceso es estacionario en sentido débil cuando todas las raíces de este polinomio están fuera del círculo unitario, es decir, cada raíz z tiene un valor absoluto mayor que 1. Las raíces pueden ser complejas, por eso la frontera es un círculo en el plano complejo y no una línea.
Puedes comprobarlo con AR(1). El polinomio es 1 - phi_1 z = 0, así que la raíz es z = 1 / phi_1. Esa raíz está fuera del círculo unitario solo cuando abs(phi_1) < 1, la misma regla de antes.
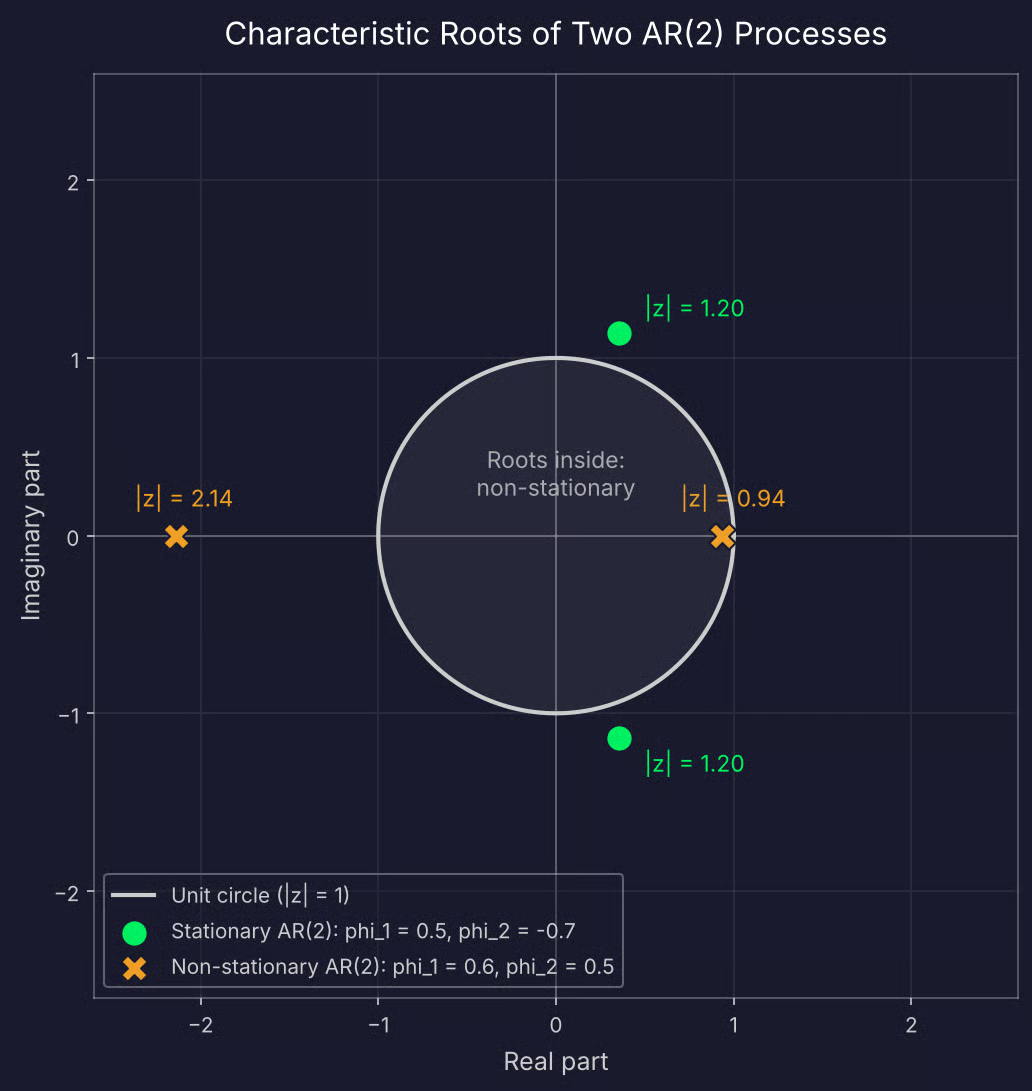
Raíces de un proceso AR(2) estacionario y no estacionario
No vas a calcular estas raíces a mano. statsmodels las devuelve tras ajustar un modelo, y en la sección de Python te muestro cómo probar la estacionariedad de los datos.
Si tu serie no es estacionaria, puedes diferenciarla —restar cada valor del siguiente— y modelar las diferencias. Eso es lo que significa la «I» en los modelos ARIMA.
Todos los modelos AR comparten la misma ecuación. Lo que cambia entre tipos es el orden p, es decir, cuántos valores pasados usa el modelo.
AR(1) usa solo el valor anterior para predecir el siguiente.
Si te suena a regresión lineal, es porque lo es. Si pones y_t-1 en el eje x y y_t en el eje y, AR(1) ajusta una recta a los puntos. La constante c es la intersección y phi_1 la pendiente. Si conoces la regresión lineal simple, ya sabes cómo se estima AR(1).
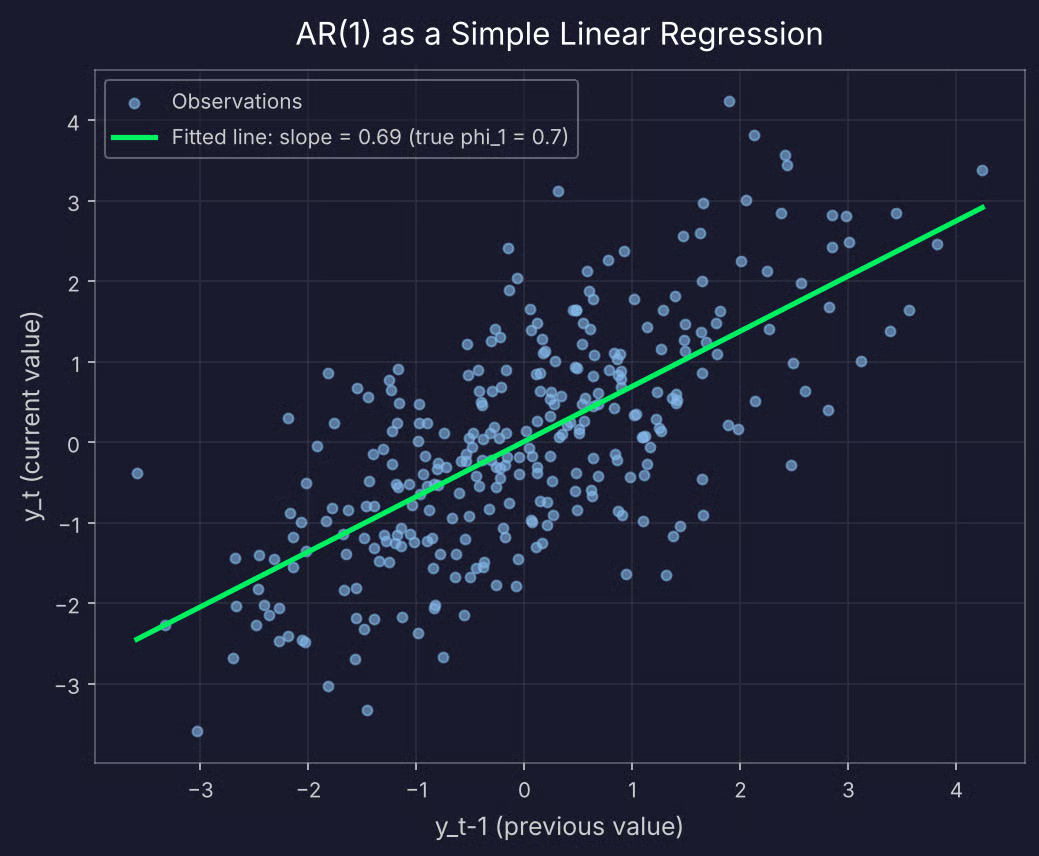
Diagrama de dispersión de y_t frente a y_t-1 para AR(1)
Pero hay una diferencia. En una regresión estándar, el predictor y el objetivo son variables distintas. En AR(1), el predictor es la misma serie desplazada un paso. Por eso no puedes barajar las filas ni usar una partición aleatoria de train/test: el orden de los datos forma parte del modelo.
El valor de phi_1 cambia el aspecto de la serie:
phi_1 = 0.3: La serie parece casi ruido aleatorio, ya que cada valor aporta poca información sobre el siguiente
phi_1 = 0.9: La serie se mueve en oscilaciones largas y suaves y tarda en volver a su media
phi_1 = -0.8: La serie zigzaguea por encima y por debajo de la media casi en cada paso
phi_1 = 1: La serie se convierte en un paseo aleatorio y deriva sin media a la que volver: el caso no estacionario de la sección anterior
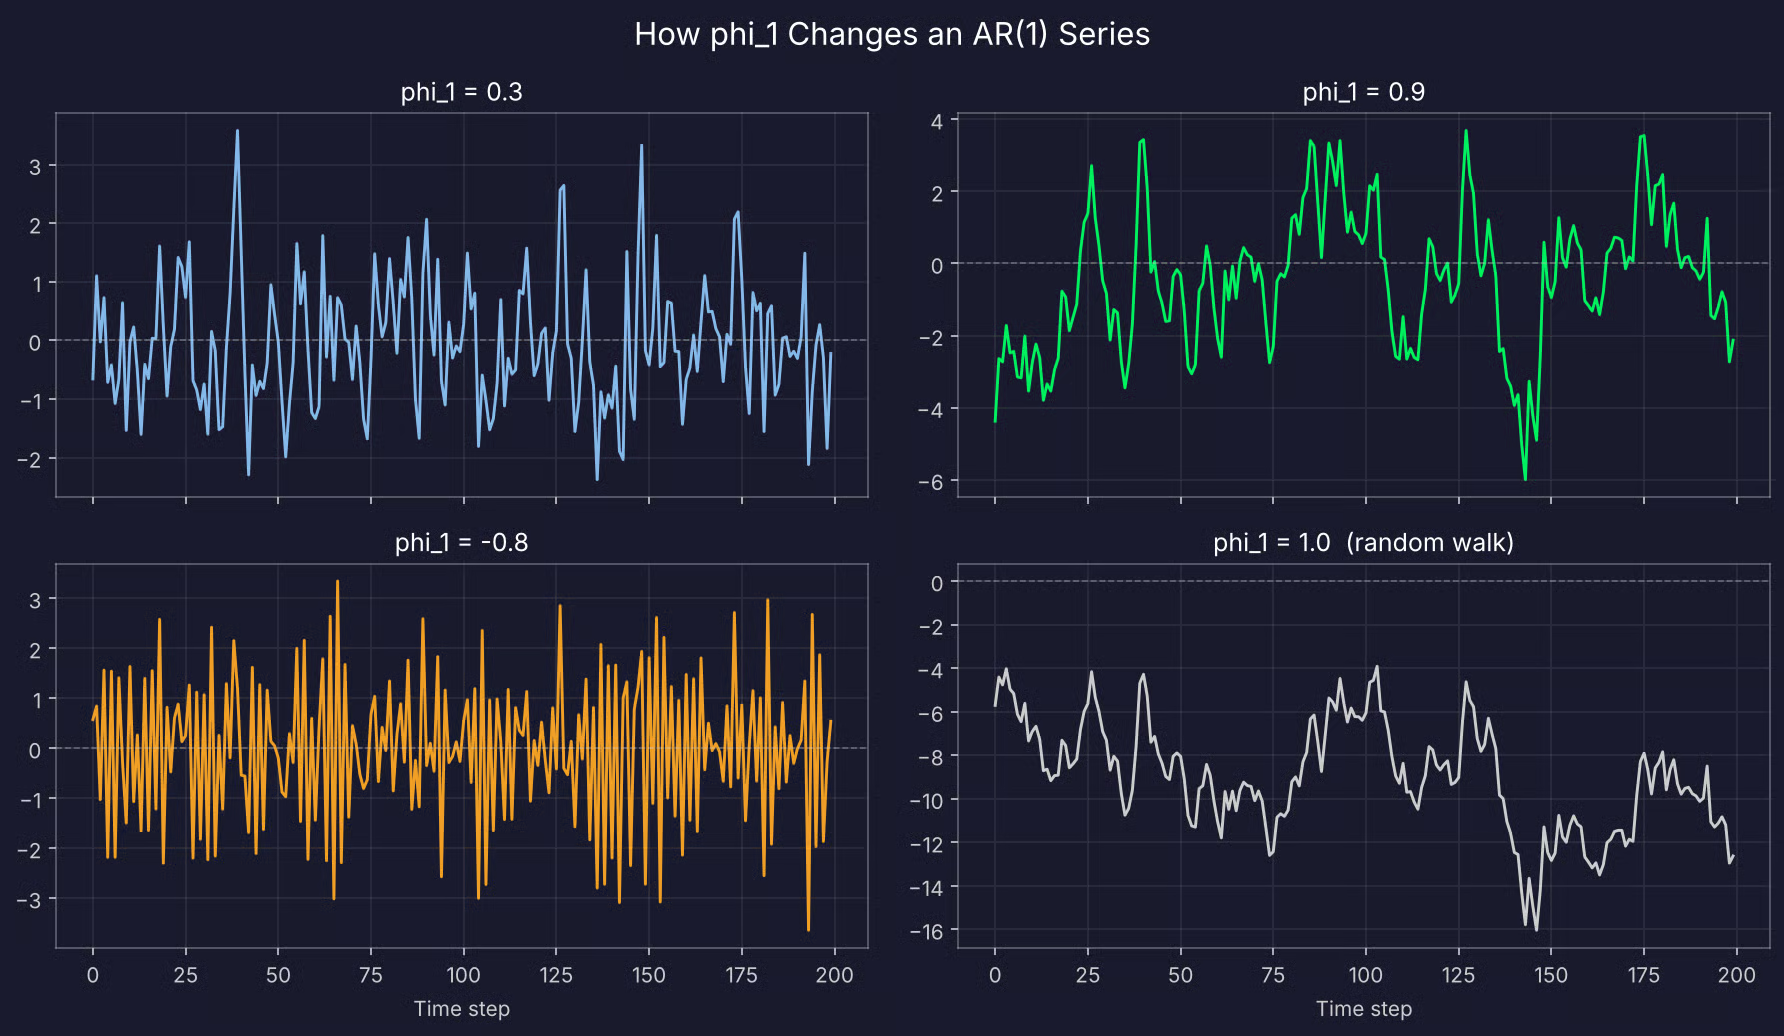
Cuatro series AR(1) simuladas
Cuanto más se acerca phi_1 a 1 o -1, más tiempo afecta un único choque a la serie.
AR(2) usa los dos valores anteriores. El segundo rezago permite generar patrones que AR(1) no puede, sobre todo ciclos.
Así se comparan dos conjuntos de coeficientes:
phi_1 = 0.5, phi_2 = 0.3: Ambos rezagos empujan en la misma dirección, así que la serie se parece a un AR(1) con oscilaciones más largas y suaves
phi_1 = 0.5, phi_2 = -0.7: El segundo rezago trabaja contra el primero y la serie sube y baja en ondas que se repiten aproximadamente cada cinco pasos
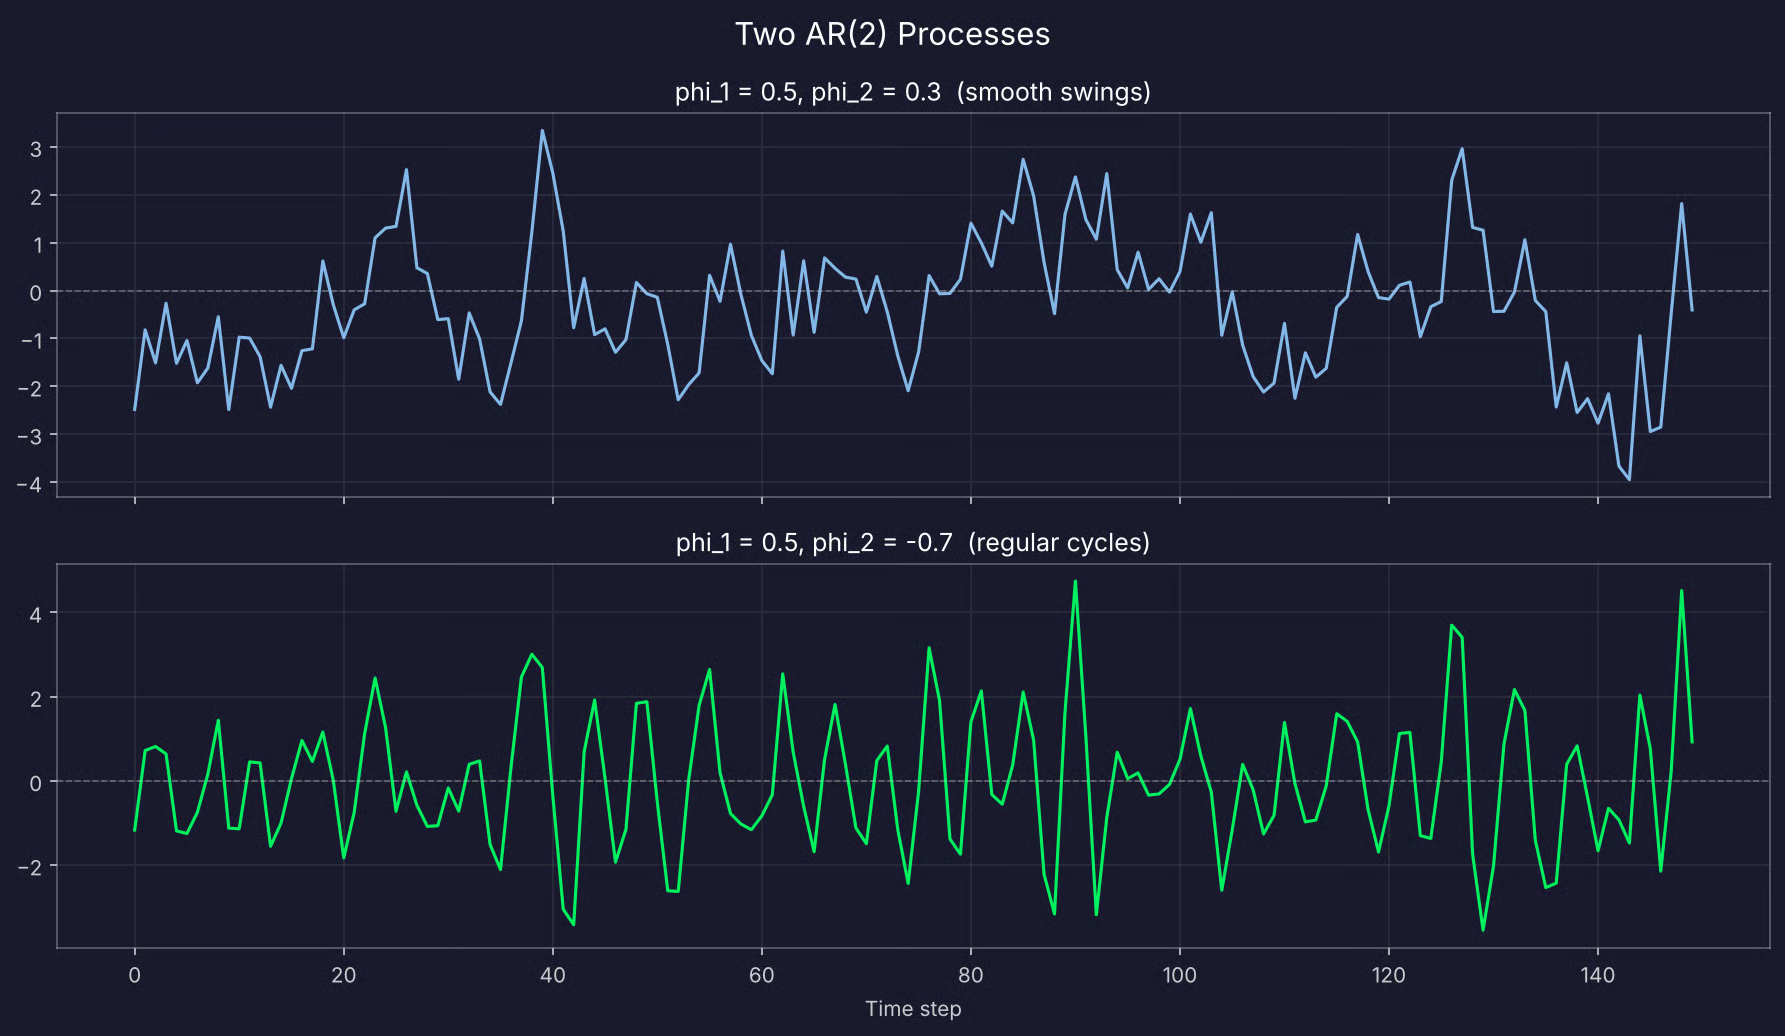
Dos series AR(2) simuladas
AR(3), AR(4) y siguientes añaden un rezago cada vez. Los necesitas cuando valores más lejanos aportan información que los recientes no tienen.
Imagina que modelas ventas mensuales y el mismo mes del año pasado predice bien el mes actual. Un modelo AR(12) incluye ese rezago de 12 meses, junto con los 11 intermedios.
Cada rezago extra añade un coeficiente a estimar. Necesitas más datos y aumenta el riesgo de sobreajuste. Además, los coeficientes se vuelven más difíciles de interpretar: con 12 no puedes mirar los números y prever el comportamiento de la serie. En su lugar, compruebas las raíces.
En la sección de Python te muestro cómo elegir el orden con PACF y AIC.
Los modelos AR aparecen siempre que los datos están ordenados y el pasado reciente dice algo sobre el futuro cercano.
La mayoría de usos encajan en cuatro grupos:
El último punto sorprende a mucha gente porque el término detrás de los chatbots actuales viene de la misma estadística de la que estás leyendo aquí.
En esta sección, ajustaré un modelo autorregresivo en Python con statsmodels, desde los datos en bruto hasta un pronóstico evaluable.
Necesitas pandas y NumPy para los datos, statsmodels para el modelo y las pruebas, y scikit-learn para la métrica de error:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorSimularé dos años de demanda eléctrica diaria a partir de un proceso AR(2).
Uso datos simulados porque conoces los coeficientes reales de antemano. Así puedes comprobar si el modelo los recupera y si las herramientas de selección de rezagos apuntan al orden correcto.
El proceso tiene c = 15, phi_1 = 0.6 y phi_2 = 0.25, lo que sitúa la media de largo plazo en 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()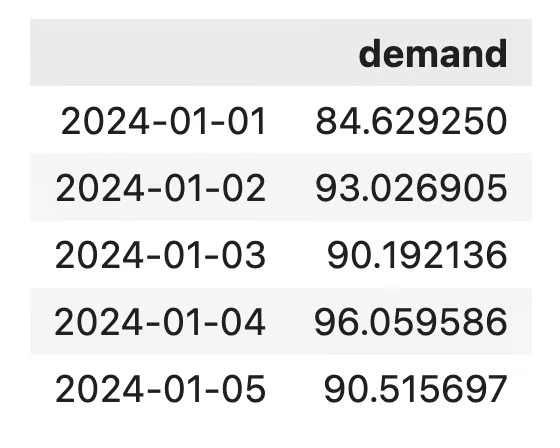
El conjunto de datos de demanda eléctrica diaria
Se eliminan los primeros 100 días simulados porque ese periodo de calentamiento permite que la serie se estabilice antes de empezar a usarla.
Así se ve la serie completa:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()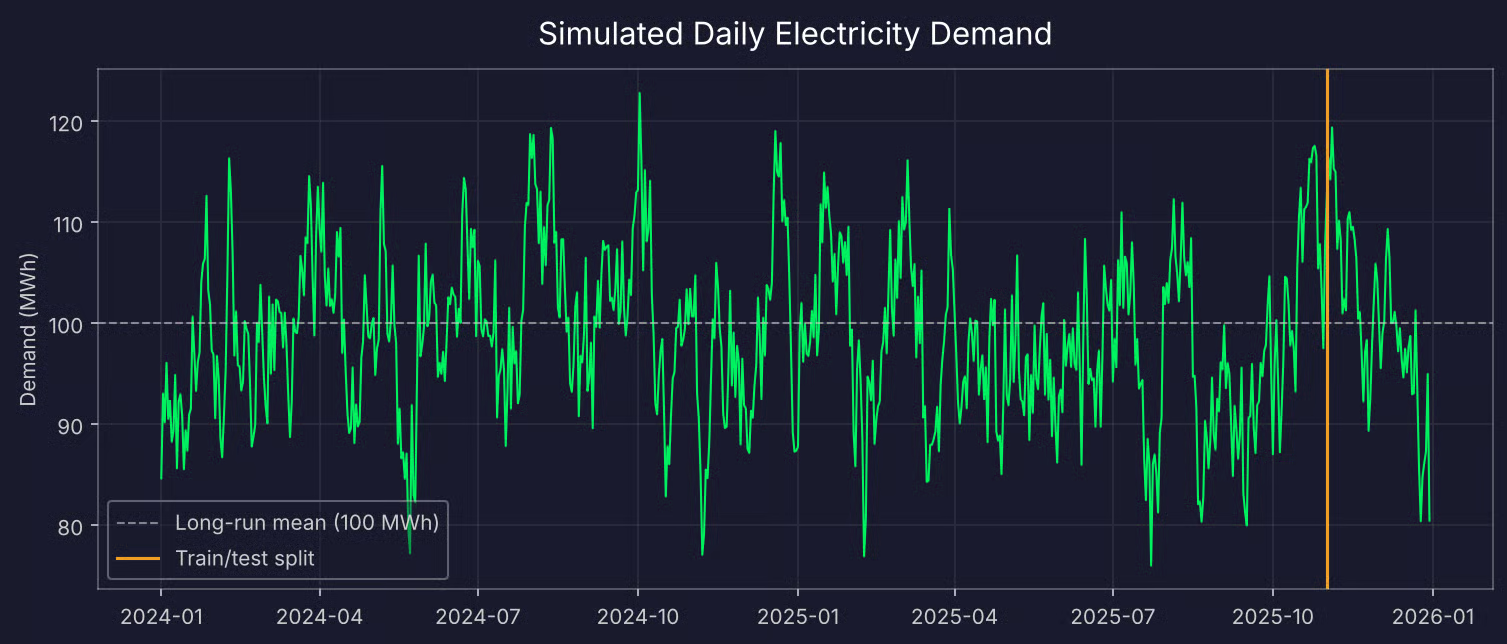
Dos años de demanda eléctrica diaria simulada
La serie oscila en torno a 100 sin tendencia, que es el aspecto esperado de una serie estacionaria. Pero una inspección visual no es una prueba.
La prueba aumentada de Dickey-Fuller (ADF) comprueba si una serie es estacionaria. Su hipótesis nula es que la serie no es estacionaria, así que lo que buscas es un p-valor pequeño:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")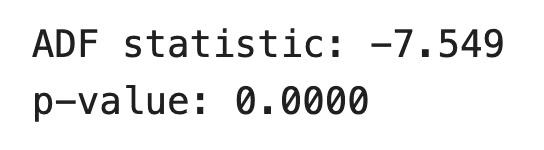
Resultados de la prueba ADF
El p-valor está muy por debajo de 0.05, así que puedes rechazar la hipótesis nula y tratar la serie como estacionaria.
Si tus datos no superan esta prueba, diferéncialos con df["demand"].diff().dropna() y vuelve a ejecutar la prueba.
Los datos de series temporales no se pueden barajar, así que el conjunto de test debe salir del final de la serie. Reservaré los últimos 60 días para test:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Quedan 670 días para entrenamiento y 60 para prueba.
Este paso determina gran parte del rendimiento del modelo. Si eliges pocos rezagos, el modelo se pierde patrones de los datos. Si eliges demasiados, ajusta ruido del entrenamiento que no se repetirá en el futuro.
Tienes dos herramientas para ello.
La primera es la función de autocorrelación parcial (PACF). Muestra la correlación entre la serie y cada rezago tras eliminar el efecto de todos los rezagos más cortos. Para un proceso AR(p), la PACF tiene picos significativos hasta el rezago p y cae cerca de cero a partir de ahí:
plot_pacf(train, lags=20, method="ywm")
plt.show()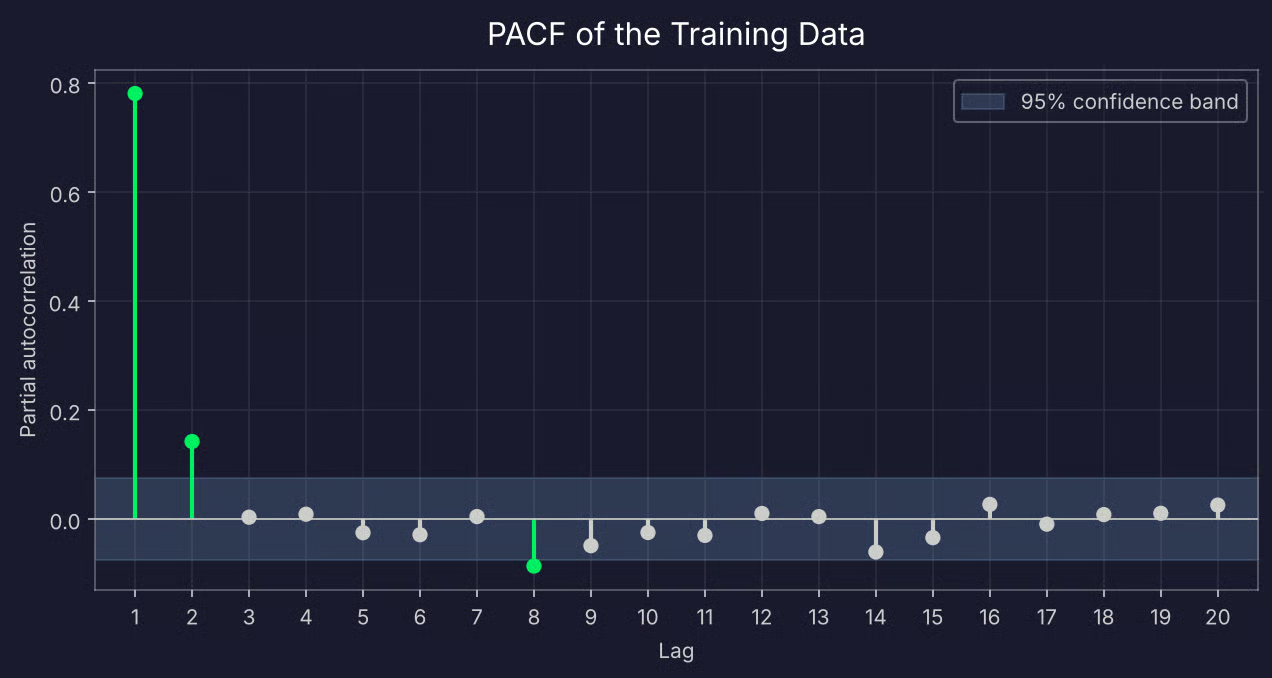
PACF de los datos de entrenamiento
Los rezagos 1 y 2 quedan muy fuera de la banda de confianza, y el rezago 3 cae cerca de cero. Esto apunta a AR(2).
También hay un pequeño pico en el rezago 8, justo por encima del borde de la banda. No le des demasiada importancia. La banda está al 95% de confianza, así que con 20 rezagos es esperable que uno cruce por azar.
La segunda herramienta son los criterios de información. AIC y BIC premian al modelo por ajustar bien los datos y lo penalizan por cada parámetro extra. BIC penaliza más, por lo que suele elegir modelos más pequeños. statsmodels puede probar todos los órdenes hasta un máximo y devolver el mejor:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")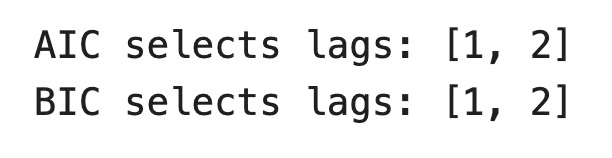
Selección de rezagos con AIC/BIC
Ambos criterios coinciden con la PACF. En la práctica, a menudo verás que AIC elige un modelo algo mayor que BIC. Si pasa, empieza por el más pequeño.
Con el orden elegido, ajustar el modelo lleva dos líneas:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")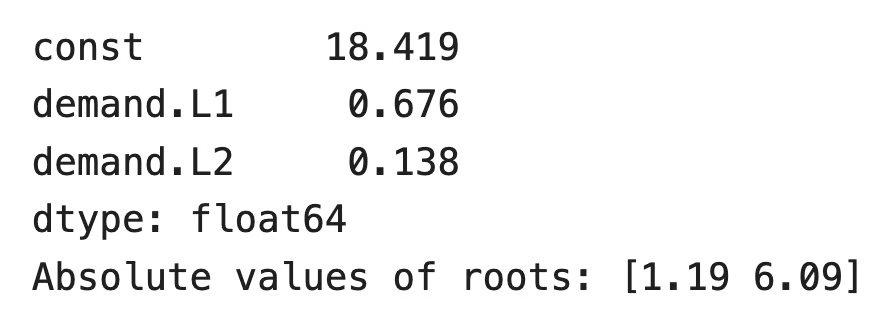
Parámetros del modelo AR(2)
Los valores reales son 0.6 y 0.25. El modelo da algo más de peso al primer rezago y menos al segundo, pero la suma de ambos coeficientes es similar: 0.81 frente a 0.85. Con 670 puntos de datos no recuperarás exactamente los valores verdaderos.
Ambas raíces tienen módulo mayor que 1, así que el modelo ajustado es estacionario. Puedes llamar a results.summary() si quieres errores estándar, p-valores y la tabla completa de raíces.
Hay dos formas de pronosticar el periodo de test, y responden a preguntas distintas:
Los pronósticos multi-paso salen directamente de los resultados ajustados. Para los de un paso, aplicas los coeficientes entrenados a la serie completa:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")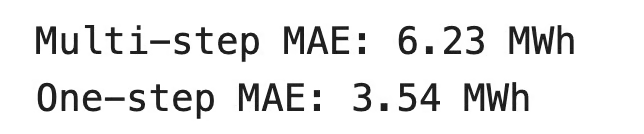
Resultados del pronóstico
El error absoluto medio (MAE) es la diferencia absoluta media entre las predicciones y los valores reales. Está en la misma unidad que los datos, así que se lee directamente. El pronóstico a un paso falla por 3.54 MWh de media.
Así se comparan ambos pronósticos con los valores reales:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()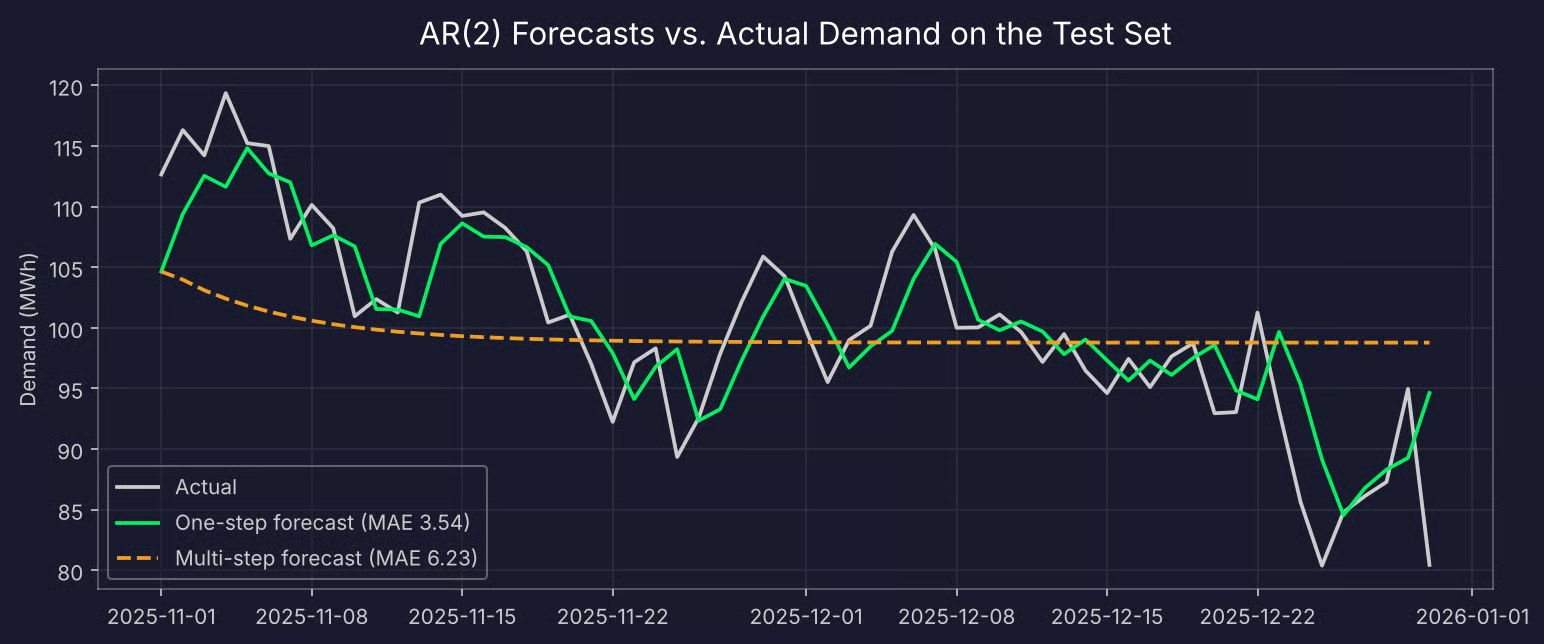
Pronósticos AR(2) a un paso y multi-paso frente a la demanda real
El pronóstico a un paso sigue de cerca los valores reales, con un desfase de alrededor de un día. El multi-paso parte del último valor conocido y luego se aplana cerca de la media en unas tres semanas.
Así se comporta todo AR estacionario: cuanto más lejos pronosticas, menos te dice el pasado y la mejor apuesta pasa a ser la media de largo plazo. Por eso los modelos AR funcionan mejor en horizontes cortos.
Es fácil asumir que más historia implica mejores predicciones. Probémoslo ajustando modelos con un número creciente de rezagos y comparando su MAE a un paso:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")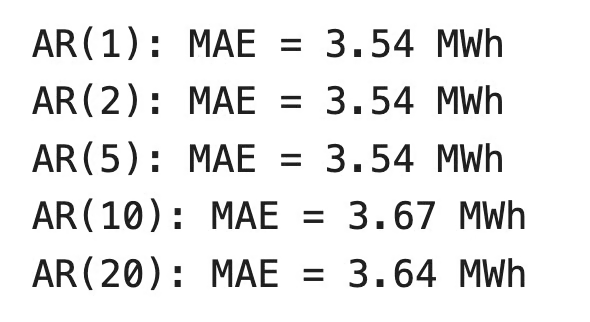
MAE con más rezagos
El error no mejora más allá de AR(2) y empeora en AR(10) y AR(20). Esos coeficientes extra ajustan ruido del entrenamiento.
También verás que AR(1) rinde tan bien como AR(2) aquí. El segundo coeficiente estimado es pequeño, así que aporta poco en este conjunto de test. Cuando dos modelos rinden igual, el más simple es más fácil de explicar y menos propenso a fallar en datos nuevos.
Además, AR(20) estima 21 parámetros en lugar de 3.
En resumen, deja que la PACF y los criterios de información sugieran el orden y confírmalo en un conjunto de prueba.
Los modelos AR encajan bien en muchos problemas de pronóstico, pero no en todos. Veamos dónde funcionan, dónde no y cómo se comparan con los modelos que se construyen sobre ellos.
Los modelos AR tienen dos ventajas principales:
También tienen dos limitaciones principales:
Hay un problema más. Los valores rezagados están correlacionados entre sí porque vienen de la misma serie. En los datos de demanda, la correlación entre y_t-1 y y_t-2 es 0.78.
Esto se llama multicolinealidad, y afecta a cualquier modelo de regresión. Cuando dos predictores se mueven juntos, al modelo le cuesta distinguir cuál es responsable. Los coeficientes se vuelven menos estables y sus errores estándar aumentan.
Eso explica lo que viste antes. El modelo estimó 0.676 y 0.138 en lugar de 0.6 y 0.25: movió peso de un rezago a otro, pero la suma se mantuvo similar. Las predicciones no sufren mucho por ello, pero no conviene confiar tanto en coeficientes individuales. Cada rezago extra agrava el problema.
AR es uno de los tres bloques básicos del pronóstico clásico de series temporales. Los otros dos son los modelos de media móvil (MA) y ARIMA, que los combina.
Un modelo AR predice a partir de valores pasados. Un MA predice a partir de errores pasados:
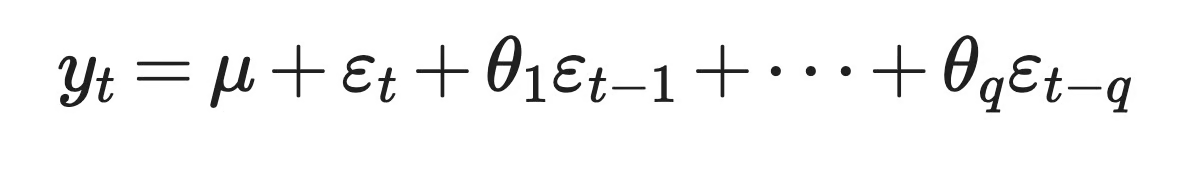
Modelo ARMA
Aquí, mu es la media de la serie, theta_1 a theta_q son los coeficientes y epsilon_t-1 a epsilon_t-q son los choques aleatorios de pasos anteriores. No lo confundas con una media móvil en el sentido de media rodante. El nombre es el mismo, pero el modelo es distinto.
Ambos modelos reaccionan de forma distinta a los choques. En un MA(q), un choque afecta a la serie exactamente q pasos. En un AR, un choque se desvanece con el tiempo pero nunca cae del todo a cero. Por esta diferencia también usas herramientas distintas para elegir el orden: la PACF se corta tras el rezago p para modelos AR y la ACF se corta tras el rezago q para modelos MA.
ARIMA lo reúne todo. ARIMA(p, d, q) tiene tres partes:
Esto implica que AR es un caso particular de ARIMA. Si fijas d y q a cero, obtienes un AR. Puedes comprobarlo con los datos de demanda:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))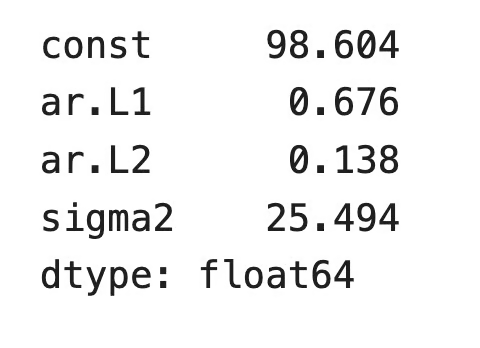
Modelo ARIMA con orden de integración y de media móvil igual a 0
Los coeficientes AR coinciden con los de AutoReg. La constante difiere porque ARIMA informa la media de la serie, mientras que AutoReg informa el intercepto c.
Ahora veamos hasta dónde llega ARIMA. Supón que la ciudad crece y la demanda eléctrica sube un poco cada día. La serie ahora tiene tendencia, la prueba ADF falla y un AR ya no puede trabajar directamente con la serie.
Pero un ARIMA(2, 1, 0) sí. Diferencia la serie una vez, así que el modelo trabaja con cambios diarios en la demanda en lugar de valores brutos, y luego ajusta AR(2) sobre esos cambios. Si un choque como una ola de calor también afecta a la demanda del día siguiente, puedes añadir un término MA y obtener ARIMA(2, 1, 1).
La parte AR hace el mismo trabajo en todos los casos. ARIMA simplemente prepara los datos y modela lo que queda. Si quieres profundizar, el curso ARIMA Models in R cubre el proceso completo.
Un modelo autorregresivo predice el siguiente valor de una serie a partir de su propio pasado. Es una regresión lineal donde los predictores son copias rezagadas del objetivo, lo que lo convierte en uno de los modelos de series temporales más fáciles de entender.
Lo verás en economía, codificación de voz, análisis de EEG e incluso en el nombre de los modelos de lenguaje actuales. También has visto dónde no es la mejor opción: necesita datos estacionarios, depende del orden de rezago adecuado y los rezagos correlacionados hacen menos fiables los coeficientes individuales.
Si entiendes los modelos AR, el resto del pronóstico clásico se vuelve mucho más sencillo. ARIMA es el siguiente paso natural y nuestro tutorial de ARIMA te muestra cómo las diferencias y los términos MA amplían lo que has aprendido aquí. Para un enfoque práctico, prueba nuestro curso ARIMA Models in Python.
Aprende con DataCamp
Curso
Curso
Curso
Tutorial
Thushan Ganegedara
15 min
Tutorial
Moez Ali
9 min
Tutorial
DataCamp Team
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Josef Waples
8 min


