कोर्स
Python में Time Series Analysis
4 घंटा
70.9K
ज़्यादातर ऑनलाइन सामग्री सीधे ARIMA पर चली जाती है और AR हिस्से को अगर कुछ मिलता भी है तो बस एक पंक्ति में समझा देती है। लेकिन AR ही मॉडल की बुनियाद है। यदि आप इसे नहीं समझते, तो ARIMA का बाकी हिस्सा भी समझ नहीं आएगा।
साधारण शब्दों में, ऑटोरिग्रेसिव मॉडल किसी टाइम सीरीज़ के भविष्य के मानों का अनुमान उसी के पिछले मानों से लगाता है। इसे अर्थशास्त्र, वित्त, सिग्नल प्रोसेसिंग और जलवायु डेटा में देखते हैं। यह मूल रूप से एक रिग्रेशन मॉडल है, इसलिए यह रिग्रेशन के बारे में आपकी जानकारी को टाइम सीरीज़ पूर्वानुमान से जोड़ता है, और ARIMA इसी पर बना है।
इस लेख में, मैं आपको बताऊंगा कि ऑटोरिग्रेसिव मॉडल कैसे काम करता है, Python में statsmodels के साथ इसे कैसे फिट करते हैं, और सही लैग क्रम कैसे चुनते हैं।
ऑटोरिग्रेसिव मॉडल किसी टाइम सीरीज़ के अगले मान का अनुमान उसके पिछले मानों के वेटेड सम से लगाता है।
नाम में, "auto" का मतलब self और "regression" का मतलब अन्य चरों से एक चर का पूर्वानुमान लगाना है। तो ऑटोरिग्रेसिव मॉडल अपने ही अतीत पर आधारित किसी सीरीज़ का रिग्रेशन है।
मान लें आप कल की बिजली मांग का अनुमान लगाना चाहते हैं। आज की मांग एक अच्छा शुरुआती बिंदु है, और कल की मांग थोड़ी और जानकारी देती है। ऑटोरिग्रेसिव मॉडल उस सहज समझ को सूत्र में बदलता है और आपके डेटा से वेट्स सीखता है।
AR मॉडलों को AR(p) के रूप में लिखा जाता है, जहाँ p मॉडल का क्रम है। क्रम बताता है कि मॉडल कितने पिछले मानों का उपयोग करता है:
p मानों का उपयोग करता हैउच्च क्रम अपने-आप बेहतर मॉडल का मतलब नहीं होता। आगे लेख में मैं आपको p चुनना दिखाऊंगा।
यह रहा AR(p) मॉडल का सामान्य रूप:
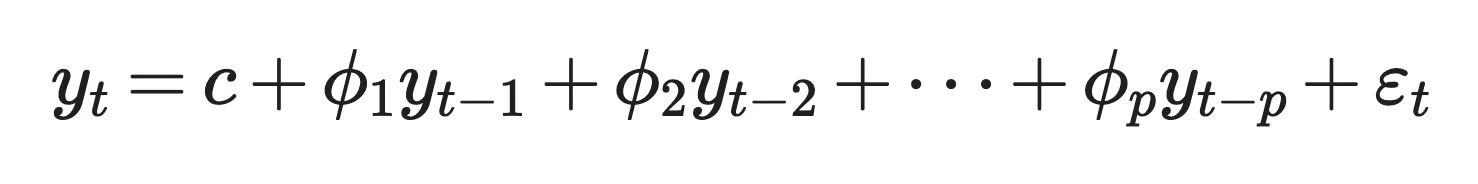
AR(p) मॉडल का सामान्य रूप
हर पद क्या करता है:
y_t: समय t पर सीरीज़ का मान, यानी जिसे आप भविष्यवाणी करना चाहते हैं
c: एक नियतांक जो गुणांकों के साथ मिलकर सीरीज़ का दीर्घकालिक औसत सेट करता है
phi_1 से phi_p: गुणांक, जो बताते हैं कि हर पिछला मान भविष्यवाणी में कितना योगदान देता है
y_t-1 से y_t-p: लैग्ड मान, जहाँ "lag" का मतलब है आप कितने कदम पीछे देखते हैं
epsilon_t: व्हाइट नॉइज़, जो शून्य औसत, स्थिर वैरिएंस और समय के साथ बिना सहसम्बंध वाला रैंडम त्रुटि पद है
सरल शब्दों में, मॉडल पिछले p मानों में से हर एक को उसके वेट से गुणा करता है और नियतांक जोड़ता है। जो शेष बचता है वह नॉइज़ है — y_t का वह हिस्सा जिसे अतीत समझा नहीं पाता।
AR(1) सबसे सरल संस्करण है:
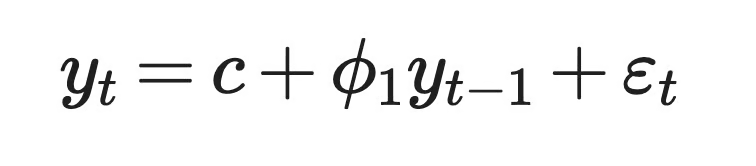
AR(1) मॉडल
phi_1 का मान नियंत्रित करता है कि आज का कितना असर कल पर पड़ता है।
मान लें c = 2 और phi_1 = 0.8। यदि आज का मान 15 है, तो मॉडल कल के लिए 2 + 0.8 x 15 = 14 की भविष्यवाणी करता है। अगला पूर्वानुमान 2 + 0.8 x 14 = 13.2 होगा। हर कदम सीरीज़ को 10 के करीब ले जाता है, जो इसका दीर्घकालिक औसत है, c / (1 - phi_1)।
यदि phi_1 नकारात्मक है, तो सीरीज़ एक कदम से अगले कदम में औसत के ऊपर और नीचे उछलती रहती है।
AR(2) एक दूसरा लैग जोड़ता है:
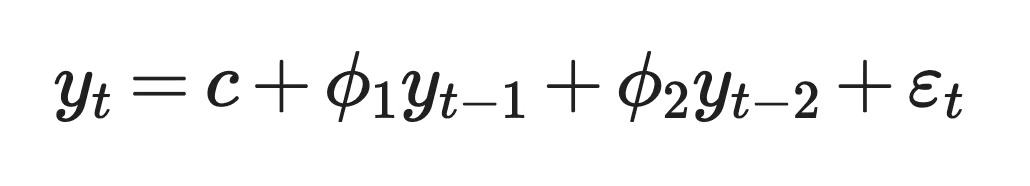
AR(2) मॉडल
दो लैग के साथ, मॉडल ऐसे पैटर्न का वर्णन कर सकता है जो AR(1) नहीं कर सकता, जैसे चक्र। उदाहरण के लिए, सकारात्मक phi_1 और नकारात्मक phi_2 एक ऐसी सीरीज़ बना सकते हैं जो तरंगों में ऊपर-नीचे होती है, जैसा कि व्यापार चक्र में दिखता है।
तो हर AR मॉडल अंततः दो चुनावों पर आता है — कितने लैग इस्तेमाल करने हैं, और उन्हें क्या वेट्स देने हैं।
AR मॉडल तभी काम करते हैं जब आपके डेटा में दो बातें सही हों। पिछले मानों का भविष्य से संबंध होना चाहिए, और सीरीज़ का व्यवहार समय के साथ एक-सा होना चाहिए। पहले को ऑटोकॉरिलेशन कहते हैं, और दूसरे को स्टेशनेरिटी।
ऑटोकॉरिलेशन एक टाइम सीरीज़ और उसके लैग्ड प्रति-प्रतिरूप के बीच सहसम्बंध है।
यही वजह है कि AR मॉडल मौजूद हैं। यदि आज का मान आपको कल के बारे में कुछ नहीं बताता, तो मॉडल के पास पिछले मानों से सीखने के लिए कुछ नहीं है।
कोड में, आप मानों का एक कॉलम लेते हैं, उसकी एक प्रति बनाते हैं, और प्रति को एक पंक्ति नीचे शिफ्ट करते हैं। अब हर पंक्ति एक मान को उसके पिछले मान से जोड़ती है। इन दो कॉलमों के बीच सहसम्बंध लैग-1 ऑटोकॉरिलेशन है। जब आप दो पंक्तियाँ शिफ्ट करते हैं, तो लैग-2 ऑटोकॉरिलेशन मिलता है।
pandas में यह ऐसे दिखता है:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))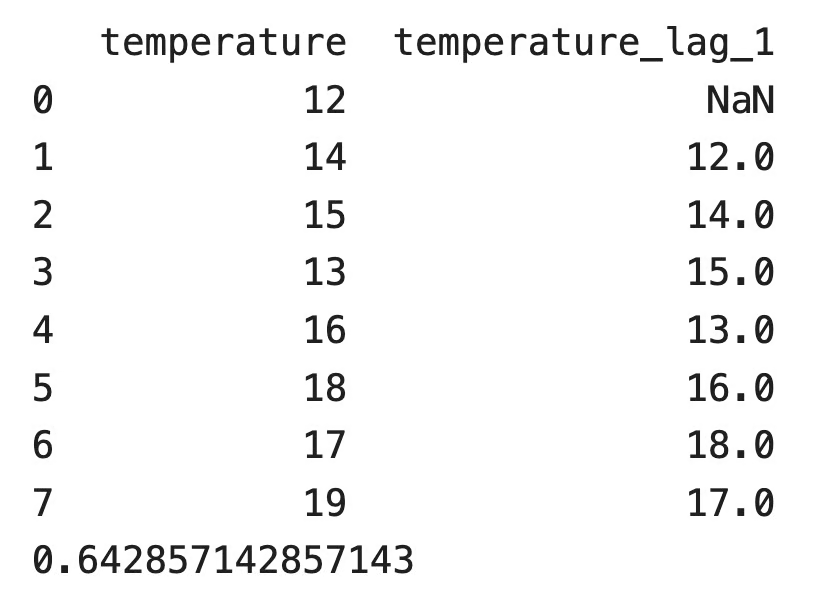
टेम्परेचर कॉलम और उसकी लैग-1 प्रति वाला DataFrame
लैग्ड कॉलम की पहली पंक्ति खाली है क्योंकि पहले रीडिंग से पहले कोई रीडिंग नहीं है। pandas उस पंक्ति को छोड़ देता है और 0.643 का लैग-1 ऑटोकॉरिलेशन देता है। इस सीरीज़ में गर्म दिनों के बाद गर्म दिन आने की प्रवृत्ति है।
ऑटोकॉरिलेशन का चिन्ह सीरीज़ के व्यवहार को बदलता है:
ऑटोकॉरिलेशन शून्य के पास होने का मतलब है कि अतीत मदद नहीं करता। ऐसे में, AR मॉडल औसत का अनुमान लगाने से बहुत बेहतर नहीं करेगा।
AR मॉडलों को स्टेशनरी टाइम सीरीज़ चाहिए।
स्टेशनरी सीरीज़ का औसत, वैरिएंस, और दिए गए लैग पर ऑटोकॉरिलेशन — सीरीज़ के किसी भी हिस्से में — एक-सा रहता है। सांख्यिकीविद इसे कमजोर-अर्थ (weak-sense) स्टेशनेरिटी कहते हैं।
यह इसलिए मायने रखता है क्योंकि मॉडल एक तय सेट के गुणांक का अनुमान लगाता है। यदि सीरीज़ का औसत समय के साथ बहकता है, तो पुराने डेटा से सीखे गुणांक नए डेटा का वर्णन नहीं करेंगे। स्टॉक कीमतें गैर-स्टेशनरी सीरीज़ का आम उदाहरण हैं क्योंकि वे वर्षों में ट्रेंड करती हैं। दैनिक रिटर्न कहीं ज़्यादा स्टेशनरी होते हैं।
गुणांक स्वयं तय करते हैं कि कोई AR प्रक्रिया स्टेशनरी है या नहीं। AR(1) के लिए नियम सरल है: phi_1 -1 और 1 के बीच होना चाहिए।
abs(phi_1) < 1: झटकों का असर समय के साथ घटता है, और सीरीज़ अपने औसत पर लौट आती है
phi_1 = 1: सीरीज़ रैंडम वॉक बन जाती है, और झटकों का असर कभी खत्म नहीं होता
abs(phi_1) > 1: हर झटका बड़ा होता जाता है, और सीरीज़ फट पड़ती है
AR(2) को तीन शर्तें एक साथ चाहिए: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1, और abs(phi_2) < 1।
दो लैग के बाद, आपको एक सामान्य नियम चाहिए। हर AR(p) मॉडल का एक characteristic polynomial होता है:
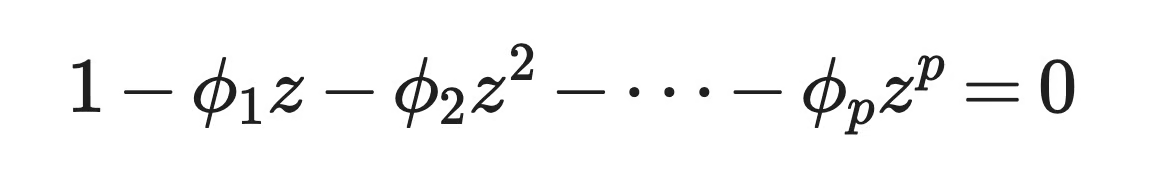
कैरेक्टरिस्टिक बहुपद
प्रक्रिया तब weak-sense स्टेशनरी होती है जब इस बहुपद की सभी जड़ें यूनिट सर्कल के बाहर हों, यानी हर जड़ z का परिमाण 1 से बड़ा हो। जड़ें कॉम्प्लेक्स संख्या हो सकती हैं, इसलिए सीमा कॉम्प्लेक्स प्लेन पर एक वृत्त है, रेखा नहीं।
आप इसे AR(1) से जाँच सकते हैं। बहुपद है 1 - phi_1 z = 0, तो जड़ है z = 1 / phi_1। यह जड़ तभी यूनिट सर्कल के बाहर होगी जब abs(phi_1) < 1, जो पहले वाला ही नियम है।
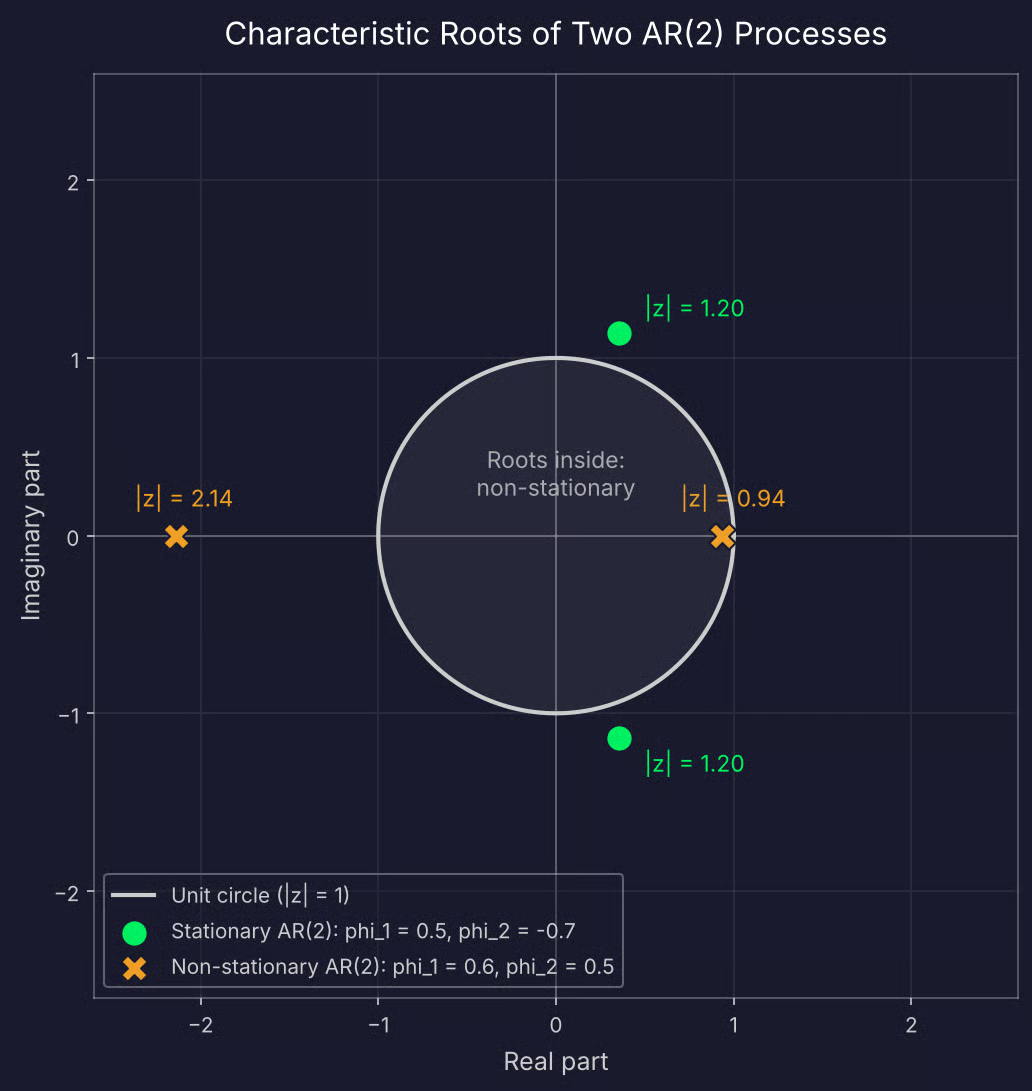
स्टेशनरी और नॉन-स्टेशनरी AR(2) प्रक्रिया की जड़ें
आप इन जड़ों की गणना हाथ से नहीं करेंगे। statsmodels मॉडल फिट करने के बाद इन्हें लौटाता है, और Python सेक्शन में मैं डेटा पर स्टेशनेरिटी जाँचने का तरीका दिखाऊंगा।
यदि आपकी सीरीज़ स्टेशनरी नहीं है, तो आप उसे differencing कर सकते हैं — हर मान को अगले से घटाएँ — और अंतरों को मॉडल करें। यही ARIMA मॉडलों में "I" का अर्थ है।
हर AR मॉडल का समीकरण एक जैसा होता है। जो बदलता है वह क्रम p है — यानी मॉडल कितने पिछले मानों का उपयोग करता है।
AR(1) केवल पिछले मान का उपयोग अगले मान का अनुमान लगाने के लिए करता है।
यदि यह रैखिक रिग्रेशन जैसा लगता है, तो इसलिए कि यह वही है। जब आप y_t-1 को x-अक्ष पर और y_t को y-अक्ष पर रखते हैं, तो AR(1) बिंदुओं के बीच एक सीधी रेखा फिट करता है। नियतांक c इंटरसेप्ट है, और phi_1 ढलान। अगर आप सिंपल लीनियर रिग्रेशन जानते हैं, तो आप पहले से जानते हैं कि AR(1) का आकलन कैसे होता है।
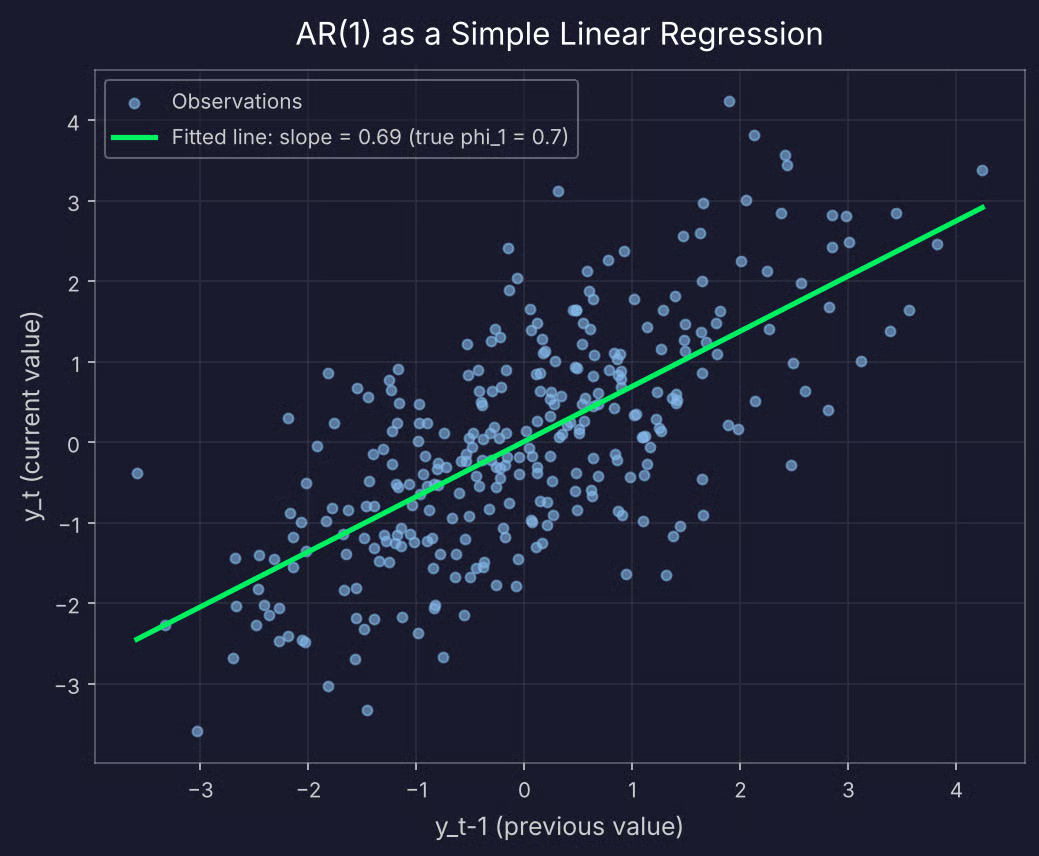
AR(1) के लिए y_t बनाम y_t-1 का स्कैटर प्लॉट
लेकिन एक फर्क है। मानक रिग्रेशन में, प्रेडिक्टर और टार्गेट अलग-अलग चर होते हैं। AR(1) में, प्रेडिक्टर वही सीरीज़ है जिसे एक कदम पीछे शिफ्ट किया गया है। यही वजह है कि आप पंक्तियों को शफल नहीं कर सकते या रैंडम ट्रेन/टेस्ट स्प्लिट नहीं कर सकते — डेटा का क्रम ही मॉडल का हिस्सा है।
phi_1 का मान सीरीज़ का रूप बदलता है:
phi_1 = 0.3: सीरीज़ लगभग रैंडम नॉइज़ जैसी दिखती है, क्योंकि हर मान अगले के बारे में बहुत कम जानकारी देता है
phi_1 = 0.9: सीरीज़ लंबे, स्मूद झूलों में चलती है और अपने औसत पर लौटने में समय लेती है
phi_1 = -0.8: सीरीज़ लगभग हर कदम पर औसत के ऊपर-नीचे जिगज़ैग करती है
phi_1 = 1: सीरीज़ रैंडम वॉक बन जाती है और बिना किसी औसत पर लौटे बहकती रहती है — यह पिछले सेक्शन का नॉन-स्टेशनरी मामला है
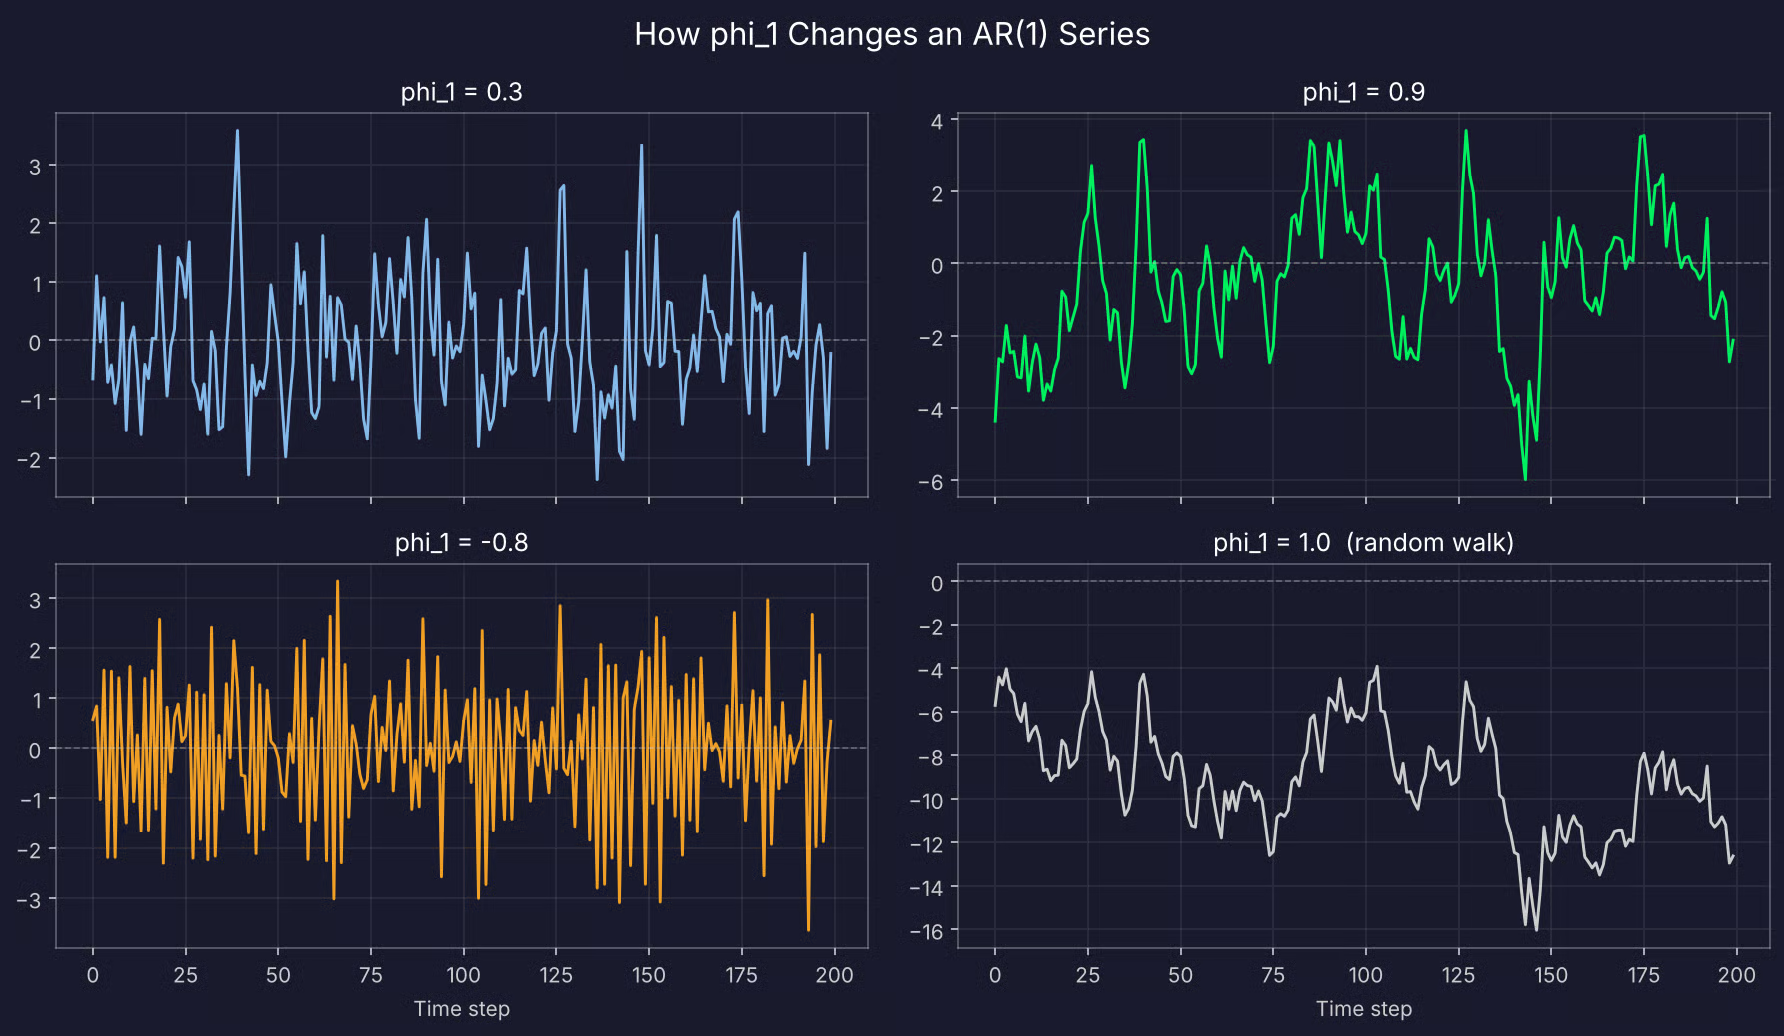
चार सिम्युलेटेड AR(1) सीरीज़
जितना phi_1 1 या -1 के करीब आता है, किसी एक झटके का असर उतना ही लंबे समय तक रहता है।
AR(2) पिछले दो मानों का उपयोग करता है। दूसरा लैग मॉडल को वे पैटर्न देने देता है जो AR(1) नहीं दे सकता, खासकर चक्रीयता।
गुणांकों के दो सेट ऐसे तुलना करते हैं:
phi_1 = 0.5, phi_2 = 0.3: दोनों लैग एक ही दिशा में धक्का देते हैं, इसलिए सीरीज़ AR(1) जैसी दिखती है लेकिन और लंबे, स्मूद झूलों के साथ
phi_1 = 0.5, phi_2 = -0.7: दूसरा लैग पहले के खिलाफ काम करता है, और सीरीज़ लगभग हर पाँच कदम पर दोहराती हुई तरंगों में ऊपर-नीचे होती है
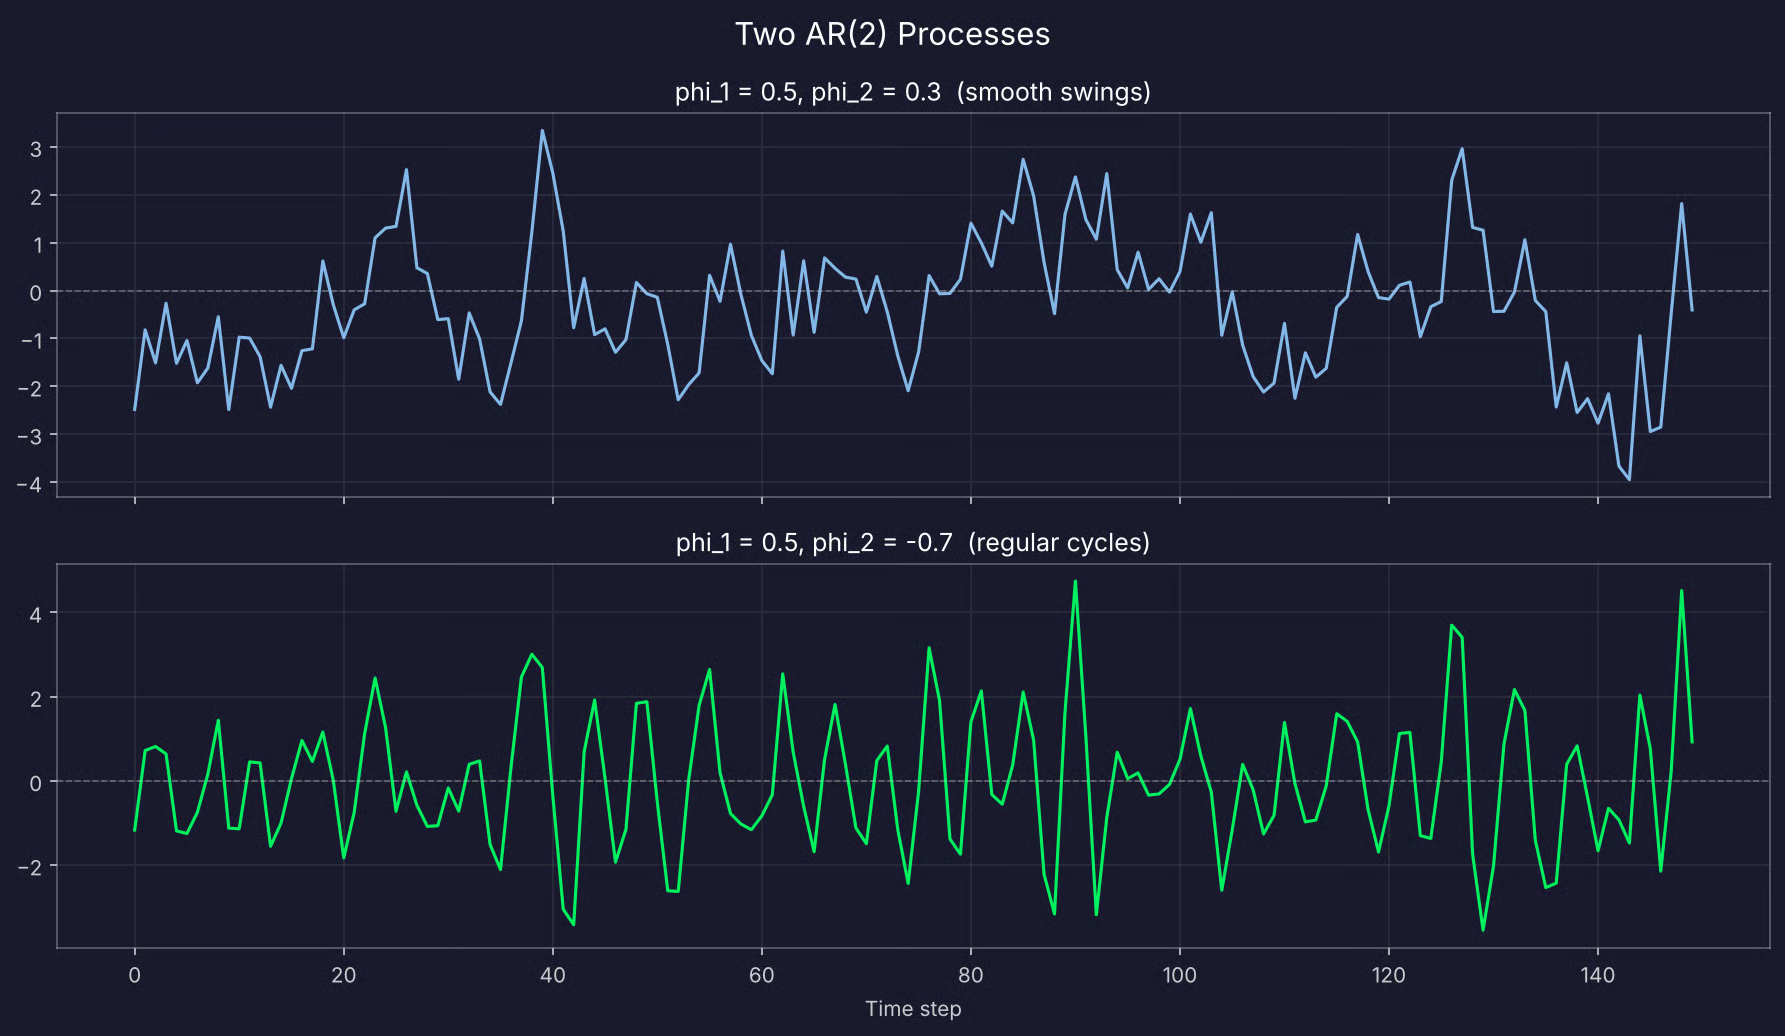
दो सिम्युलेटेड AR(2) सीरीज़
AR(3), AR(4), और आगे हर बार एक लैग जोड़ते हैं। इनकी जरूरत तब पड़ती है जब और पीछे के मान ऐसी जानकारी रखते हैं जो हाल के मान नहीं रखते।
मान लें आप मासिक बिक्री का मॉडल बना रहे हैं, और पिछले साल का वही महीना इस महीने का अच्छा प्रेडिक्टर है। AR(12) मॉडल उस 12-महीने के लैग के साथ-साथ बीच के 11 लैग भी शामिल करता है।
हर अतिरिक्त लैग एक गुणांक जोड़ता है जिसका अनुमान लगाना होता है। यानी आपको ज़्यादा डेटा चाहिए, और ओवरफिटिंग का जोखिम बढ़ता है। गुणांक पढ़ना भी कठिन हो जाता है — 12 गुणांकों के साथ, आप केवल संख्याएँ देखकर नहीं बता पाएँगे कि सीरीज़ क्या करेगी। तब आप जड़ों की जाँच करते हैं।
Python सेक्शन में मैं PACF और AIC से सही क्रम चुनना दिखाऊंगा।
AR मॉडल वहाँ दिखते हैं जहाँ डेटा क्रम में संग्रहीत होता है और हाल का अतीत निकट भविष्य के बारे में कुछ बताता है।
अधिकांश उपयोग चार समूहों में आते हैं:
आखिरी बिंदु बहुतों को चौंकाता है क्योंकि आज के चैटबॉट्स के पीछे का शब्द उसी सांख्यिकी से आता है जिसके बारे में आप यहाँ पढ़ रहे हैं।
इस सेक्शन में, मैं Python में statsmodels के साथ एक ऑटोरिग्रेसिव मॉडल फिट करूँगा — कच्चे डेटा से लेकर ऐसे पूर्वानुमान तक जिनका आप मूल्यांकन कर सकें।
डेटा के लिए आपको pandas और NumPy चाहिए, मॉडल और टेस्ट के लिए statsmodels, और एरर मीट्रिक के लिए scikit-learn:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorमैं AR(2) प्रक्रिया से दो वर्षों की दैनिक बिजली मांग सिम्युलेट करूँगा।
मैंने सिम्युलेटेड डेटा इसलिए चुना है क्योंकि आप असली गुणांक पहले से जानते हैं। इस तरह, आप देख सकते हैं कि मॉडल उन्हें पाता है या नहीं, और क्या लैग-चयन टूल्स सही क्रम की ओर इशारा करते हैं।
प्रक्रिया में c = 15, phi_1 = 0.6, और phi_2 = 0.25 हैं, जो दीर्घकालिक औसत को 100 MWh पर रखते हैं:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()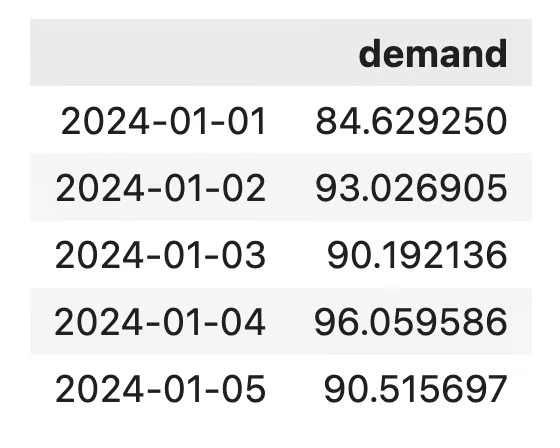
दैनिक बिजली मांग का डेटासेट
पहले 100 सिम्युलेटेड दिन हटाए गए हैं क्योंकि वह burn-in अवधि सीरीज़ को अपने सामान्य व्यवहार में आने का समय देती है, इससे पहले कि आप इसका उपयोग शुरू करें।
पूरी सीरीज़ कुछ यूँ दिखती है:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()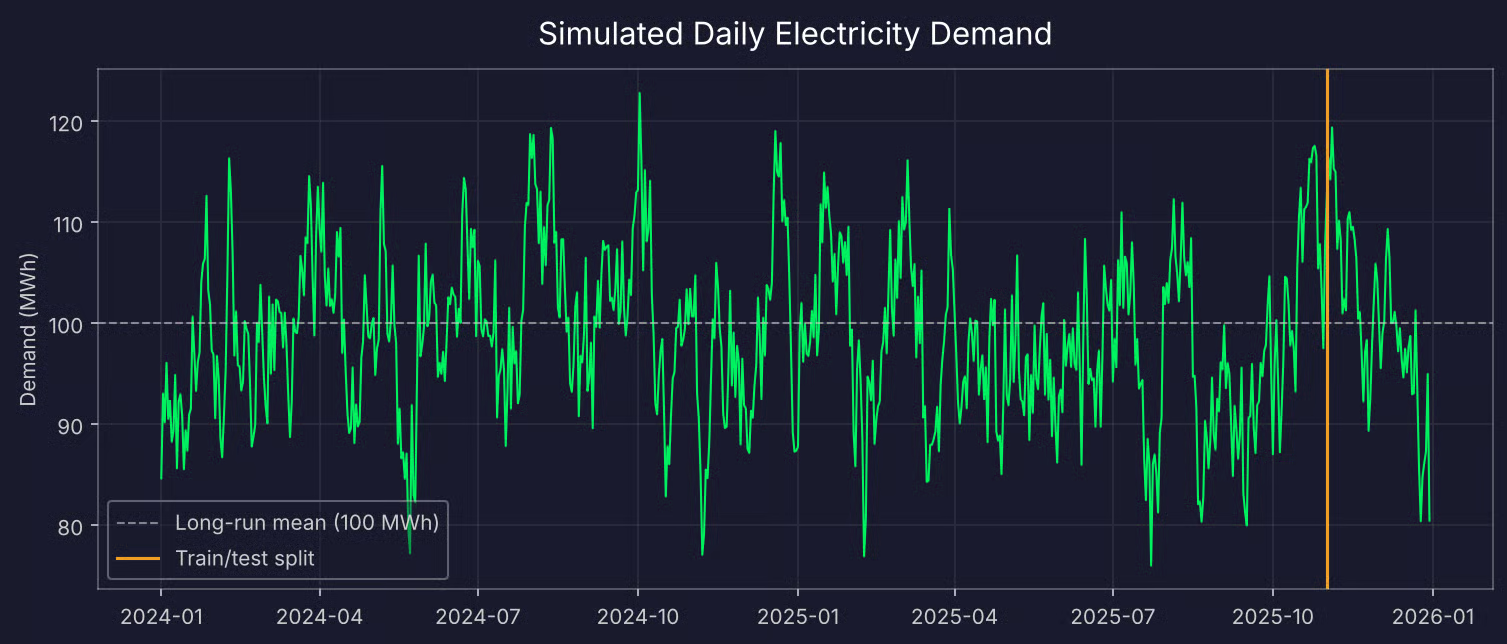
दो वर्षों की सिम्युलेटेड दैनिक बिजली मांग
सीरीज़ 100 के आसपास बिना ट्रेंड के ऊपर-नीचे चलती है, जैसा कि एक स्टेशनरी सीरीज़ को दिखना चाहिए। लेकिन केवल नजर से देखना सबूत नहीं है।
ऑगमेंटेड डिकी-फुलर (ADF) टेस्ट जाँचता है कि कोई सीरीज़ स्टेशनरी है या नहीं। इसका शून्य परिकल्पना यह है कि सीरीज़ स्टेशनरी नहीं है, इसलिए छोटा p-value वांछित है:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")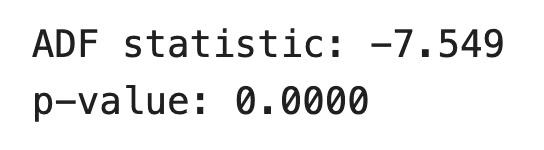
ADF टेस्ट के परिणाम
p-value 0.05 से काफी कम है, इसलिए आप शून्य परिकल्पना को खारिज कर सकते हैं और सीरीज़ को स्टेशनरी मान सकते हैं।
यदि आपका अपना डेटा यह टेस्ट फेल करता है, तो df["demand"].diff().dropna() से differencing करें और टेस्ट फिर चलाएँ।
टाइम सीरीज़ डेटा को शफल नहीं किया जा सकता, इसलिए टेस्ट सेट सीरीज़ के अंत से आना चाहिए। मैं आखिरी 60 दिन टेस्ट के लिए रखूँगा:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
इससे 670 दिन ट्रेनिंग के लिए और 60 दिन टेस्टिंग के लिए बचते हैं।
यही कदम तय करता है कि मॉडल कितना अच्छा काम करेगा। यदि आप बहुत कम लैग चुनते हैं, तो मॉडल डेटा के पैटर्न मिस कर देगा। लेकिन अगर बहुत ज़्यादा चुनते हैं, तो यह ट्रेनिंग डेटा के नॉइज़ को फिट कर देगा जो भविष्य में दोहराएगा नहीं।
आपके पास इसके लिए दो टूल हैं।
पहला है पार्शियल ऑटोकॉरिलेशन फंक्शन (PACF)। यह सीरीज़ और हर लैग के बीच का सहसम्बंध दिखाता है, सभी छोटे लैग के प्रभाव निकाल देने के बाद। AR(p) प्रक्रिया के लिए, PACF में लैग p तक महत्वपूर्ण स्पाइक्स होते हैं और उसके बाद यह शून्य के आसपास गिर जाता है:
plot_pacf(train, lags=20, method="ywm")
plt.show()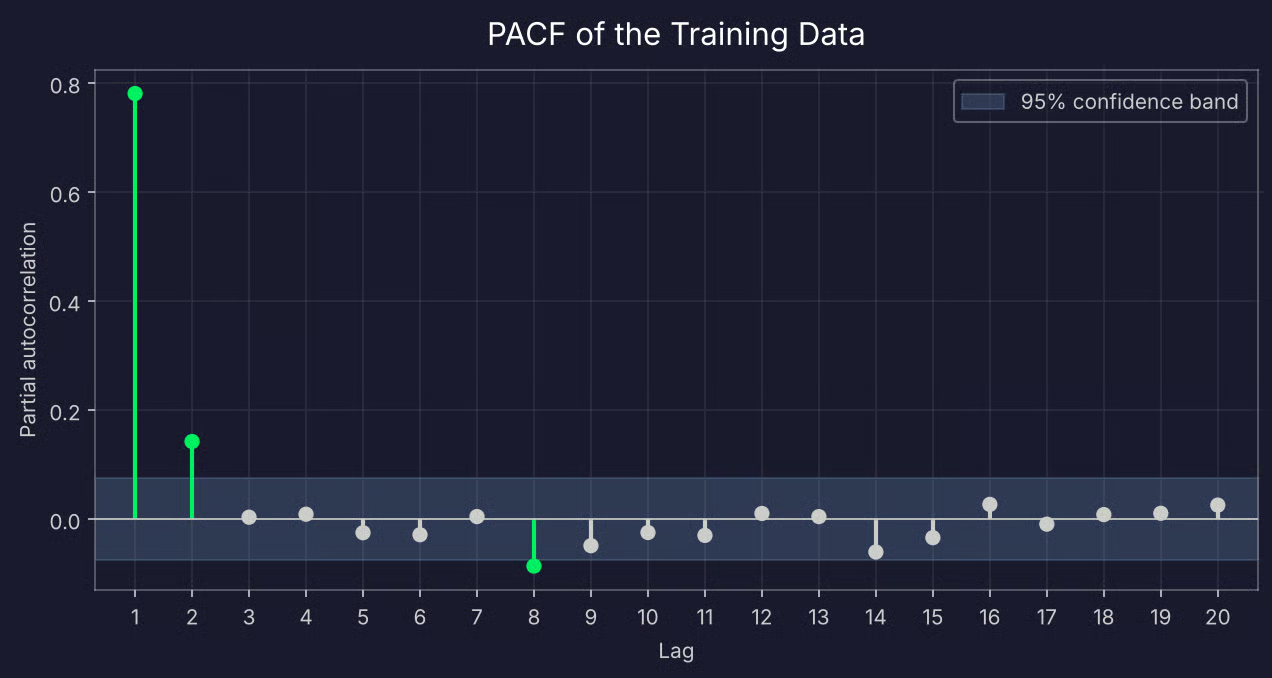
ट्रेनिंग डेटा का PACF
लैग 1 और 2 भरोसे के बैंड से काफी बाहर हैं, और लैग 3 शून्य के करीब आ जाता है। यह AR(2) की ओर इशारा करता है।
लैग 8 पर एक छोटा स्पाइक भी है, जो बैंड की सीमा से थोड़ा बाहर है। इसे ज़्यादा मत पढ़ें। बैंड 95% भरोसे पर खींचा गया है, तो 20 लैग के साथ, आप उम्मीद करेंगे कि लगभग एक तो संयोग से इसे पार करेगा ही।
दूसरा टूल है इन्फॉर्मेशन क्राइटेरिया। AIC और BIC दोनों मॉडल को डेटा को अच्छी तरह फिट करने पर पुरस्कृत करते हैं और हर अतिरिक्त पैरामीटर पर पेनल्टी लगाते हैं। BIC बड़ी पेनल्टी लगाता है, इसलिए यह छोटे मॉडल चुनने की प्रवृत्ति रखता है। statsmodels अधिकतम तक हर क्रम को जाँच सकता है और सर्वश्रेष्ठ लौटा सकता है:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")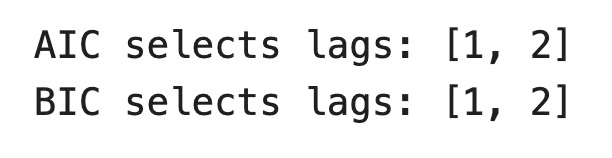
AIC/BIC लैग चयन
दोनों मानदंड PACF से सहमत हैं। व्यवहार में, आप अक्सर देखते हैं कि AIC BIC से थोड़ा बड़ा मॉडल चुनता है। ऐसा हो तो छोटे वाले से शुरू करें।
क्रम चुन लेने के बाद, मॉडल फिट करना दो पंक्तियों का काम है:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")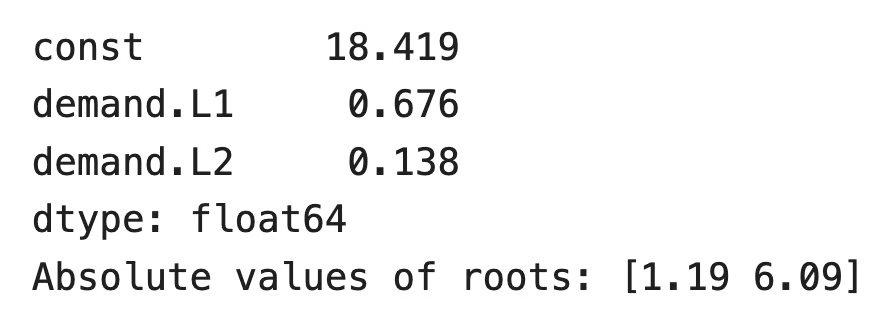
AR(2) मॉडल के पैरामीटर
वास्तविक मान 0.6 और 0.25 हैं। मॉडल पहले लैग को थोड़ा ज़्यादा और दूसरे को कम वेट देता है, लेकिन दोनों गुणांकों का योग पास-पास है — 0.81 बनाम 0.85। 670 डेटा बिंदुओं के साथ, आप ठीक-ठीक मान रिकवर नहीं करेंगे।
दोनों जड़ों का परिमाण 1 से बड़ा है, इसलिए फिट किया गया मॉडल स्टेशनरी है। यदि आपको मानक त्रुटियाँ, p-value, और पूरी जड़ों की तालिका चाहिए तो results.summary() कॉल कर सकते हैं।
टेस्ट अवधि का पूर्वानुमान लगाने के दो तरीके हैं, और वे अलग प्रश्नों का उत्तर देते हैं:
मल्टी-स्टेप पूर्वानुमान सीधे फिट किए गए परिणामों से आते हैं। वन-स्टेप पूर्वानुमान के लिए, आप प्रशिक्षित गुणांकों को पूरी सीरीज़ पर लगाते हैं:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")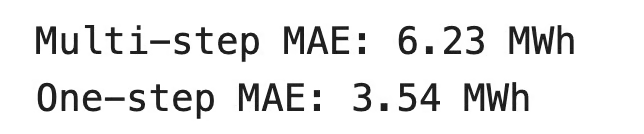
पूर्वानुमान के परिणाम
मीन एब्सोल्यूट एरर (MAE) पूर्वानुमानों और वास्तविक मानों के बीच औसत निरपेक्ष अंतर है। यह डेटा की ही इकाई में होता है, इसलिए आप इसे सीधे पढ़ सकते हैं। वन-स्टेप पूर्वानुमान औसतन 3.54 MWh से चूकता है।
दोनों पूर्वानुमान वास्तविक मानों की तुलना में ऐसे दिखते हैं:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()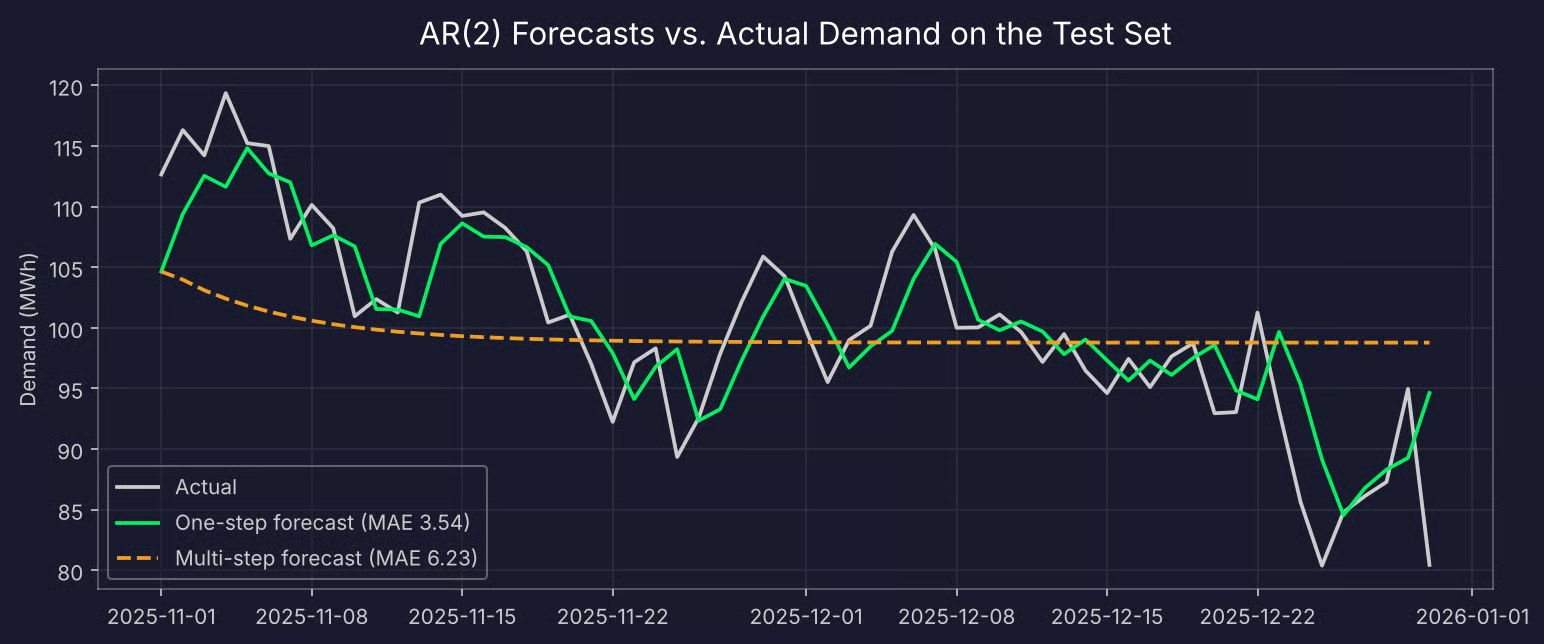
वास्तविक मांग की तुलना में वन-स्टेप और मल्टी-स्टेप AR(2) पूर्वानुमान
वन-स्टेप पूर्वानुमान वास्तविक मानों का क़रीब-क़रीब पीछा करता है, लगभग एक दिन पीछे। मल्टी-स्टेप पूर्वानुमान आखिरी ज्ञात मान से शुरू होता है और फिर लगभग तीन सप्ताह में औसत के पास सपाट हो जाता है।
हर स्टेशनरी AR मॉडल ऐसा ही करता है — जितना आगे आप पूर्वानुमान लगाते हैं, अतीत उतना ही कम बताता है, और सबसे अच्छा अनुमान दीर्घकालिक औसत बन जाता है। यही कारण है कि AR मॉडल अल्पकालिक पूर्वानुमानों के लिए सबसे अच्छे काम करते हैं।
यह मान लेना आसान है कि ज़्यादा इतिहास का मतलब बेहतर पूर्वानुमान है। आइए बढ़ते हुए लैग की संख्या वाले मॉडलों को फिट करके और उनके वन-स्टेप MAE की तुलना करके इसे परखें:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")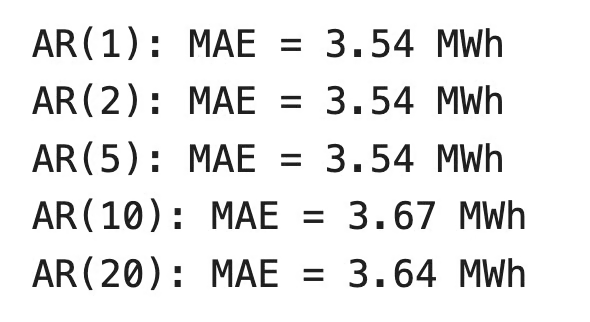
ज़्यादा लैग के साथ MAE
त्रुटि AR(2) के बाद बेहतर नहीं होती, और AR(10) व AR(20) पर बदतर हो जाती है। वे अतिरिक्त गुणांक ट्रेनिंग डेटा के नॉइज़ को फिट करते हैं।
आप यह भी नोट करेंगे कि यहाँ AR(1) ने AR(2) जितना ही अच्छा किया। अनुमानित दूसरा गुणांक छोटा है, इसलिए इस टेस्ट सेट पर वह बहुत कम जोड़ता है। जब दो मॉडल एक जैसा प्रदर्शन करते हैं, तो सरल मॉडल समझाना आसान होता है और नए डेटा पर टूटने की संभावना कम होती है।
लागत पक्ष भी है। AR(20) 3 की जगह 21 पैरामीटर का अनुमान लगाता है।
निचोड़ यह कि PACF और इन्फॉर्मेशन क्राइटेरिया को क्रम सुझाने दें, और फिर बस उसे टेस्ट सेट पर कन्फर्म करें।
AR मॉडल कई पूर्वानुमान समस्याओं के लिए उपयुक्त हैं, लेकिन सभी के लिए नहीं। यहाँ देखें वे कहाँ काम करते हैं, कहाँ नहीं, और उनके ऊपर बने मॉडलों से उनकी तुलना।
AR मॉडलों के दो मुख्य लाभ हैं:
इनकी दो मुख्य सीमाएँ भी हैं:
एक और समस्या है। लैग्ड मान एक-दूसरे से सहसम्बद्ध होते हैं क्योंकि वे एक ही सीरीज़ से आते हैं। मांग डेटा में, y_t-1 और y_t-2 के बीच सहसम्बंध 0.78 है।
इसे मल्टीकोलिनियरिटी कहा जाता है, और यह किसी भी रिग्रेशन मॉडल को प्रभावित करती है। जब दो प्रेडिक्टर साथ-साथ चलते हैं, तो मॉडल के लिए बताना मुश्किल होता है कि जिम्मेदार कौन है। गुणांक कम स्थिर हो जाते हैं, और उनकी मानक त्रुटियाँ बढ़ जाती हैं।
यही बात आपने पहले देखी। मॉडल ने 0.6 और 0.25 के बजाय 0.676 और 0.138 का अनुमान लगाया — इसने वेट एक लैग से दूसरे में शिफ्ट कर दिए, लेकिन योग क़रीब-क़रीब वही रहा। पूर्वानुमानों पर इसका बहुत असर नहीं पड़ता, पर आप व्यक्तिगत गुणांकों पर उतना भरोसा नहीं कर सकते। हर अतिरिक्त लैग समस्या बढ़ाता है।
AR पारंपरिक टाइम सीरीज़ पूर्वानुमान के तीन बिल्डिंग ब्लॉक्स में से एक है। बाकी दो हैं मूविंग एवरेज (MA) मॉडल और ARIMA, जो इन्हें जोड़ता है।
AR मॉडल पिछले मानों से पूर्वानुमान लगाता है। MA मॉडल पिछले त्रुटियों से पूर्वानुमान लगाता है:
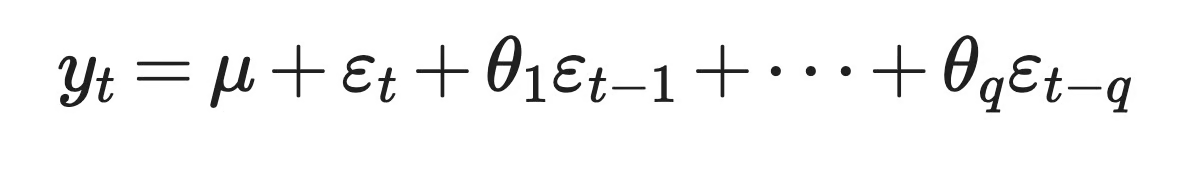
ARMA मॉडल
यहाँ, mu सीरीज़ का औसत है, theta_1 से theta_q तक गुणांक हैं, और epsilon_t-1 से epsilon_t-q तक पिछले कदमों के रैंडम शॉक हैं। इसे रोलिंग-औसत वाले मूविंग एवरेज से भ्रमित न करें। नाम एक-सा है, पर मॉडल अलग है।
दोनों मॉडल झटकों पर अलग तरह से प्रतिक्रिया देते हैं। MA(q) मॉडल में, कोई झटका ठीक q कदमों तक सीरीज़ को प्रभावित करता है। AR मॉडल में, झटका समय के साथ धुंधला होता है पर कभी पूरी तरह शून्य तक नहीं गिरता। यही फर्क यह भी बताता है कि आप क्रम चुनने के लिए अलग टूल्स क्यों इस्तेमाल करते हैं — AR मॉडलों के लिए PACF लैग p के बाद कट जाता है, और MA मॉडलों के लिए ACF लैग q के बाद कट जाता है।
ARIMA सबको साथ लाता है। ARIMA(p, d, q) के तीन हिस्से होते हैं:
मतलब AR, ARIMA का विशेष मामला है। यदि आप d और q को शून्य पर सेट करें, तो आपको AR मॉडल मिलता है। आप इसे मांग डेटा से जाँच सकते हैं:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))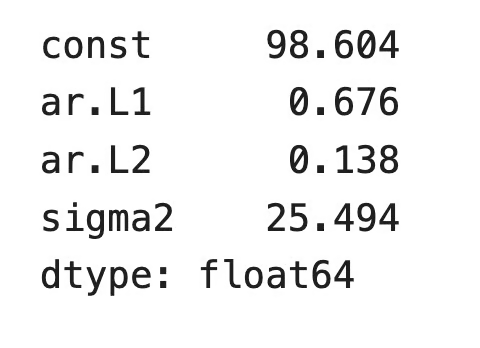
0 इंटिग्रेशन और मूविंग एवरेज क्रम वाला ARIMA मॉडल
AR गुणांक AutoReg वाले से मेल खाते हैं। नियतांक अलग है क्योंकि ARIMA सीरीज़ का औसत रिपोर्ट करता है, जबकि AutoReg इंटरसेप्ट c रिपोर्ट करता है।
अब देखें कि ARIMA कहाँ आगे जाता है। मान लें शहर बढ़ता है, और बिजली की मांग हर दिन थोड़ी-थोड़ी बढ़ती है। अब सीरीज़ में ट्रेंड है, इसलिए ADF टेस्ट फेल होता है, और AR मॉडल सीधे इस सीरीज़ पर काम नहीं कर सकता।
पर ARIMA(2, 1, 0) कर सकता है। यह सीरीज़ को एक बार differencing करता है, यानी मॉडल कच्चे मानों की जगह मांग में दैनिक बदलावों के साथ काम करता है, और फिर उन बदलावों पर AR(2) फिट करता है। यदि हीट वेव जैसा कोई झटका अगले दिन की मांग को भी प्रभावित करता है, तो आप MA पद जोड़ सकते हैं और ARIMA(2, 1, 1) पा सकते हैं।
हर मामले में AR हिस्सा वही काम करता है। ARIMA बस उसके लिए डेटा तैयार करता है और जो बचता है, उसे मॉडल करता है। यदि आप और गहराई में जाना चाहते हैं, तो ARIMA Models in R कोर्स पूरे प्रोसेस को कवर करता है।
ऑटोरिग्रेसिव मॉडल किसी सीरीज़ के अगले मान का अनुमान उसके अतीत से लगाता है। यह एक रैखिक रिग्रेशन है जहाँ प्रेडिक्टर टार्गेट के लैग्ड प्रतिरूप होते हैं, और इसी से यह सबसे आसान टाइम सीरीज़ मॉडलों में से एक बनता है।
आप इसे अर्थशास्त्र, स्पीच कोडिंग, EEG विश्लेषण में — और आज के भाषा मॉडलों के नाम में भी — देखेंगे। आपने यह भी देखा कि कहाँ यह सबसे अच्छा विकल्प नहीं है, क्योंकि इसे स्टेशनरी डेटा चाहिए, यह सही लैग क्रम पर निर्भर करता है, और सहसम्बद्ध लैग व्यक्तिगत गुणांकों को कम विश्वसनीय बनाते हैं।
यदि आप AR मॉडल समझते हैं, तो पारंपरिक पूर्वानुमान का बाकी हिस्सा बहुत आसान हो जाता है। ARIMA अगला स्वाभाविक कदम है, और हमारा ARIMA ट्यूटोरियल दिखाता है कि differencing और MA पद यहाँ सीखी बातों का कैसे विस्तार करते हैं। अभ्यास के लिए, हमारा ARIMA Models in Python कोर्स आज़माएँ।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स