Kurs
Tidsserieanalys i Python
4 tim
70.9K
Det mesta innehållet online går direkt till ARIMA och ger AR-delen en rad förklaring, om ens det. Men AR är modellens grund. Om du inte förstår den kommer resten av ARIMA inte heller att vara logiskt.
På enkel svenska förutspår en autoregressiv modell framtida värden i en tidsserie utifrån dess egna tidigare värden. Du ser den i ekonomi, finans, signalbehandling och klimatdata. Den är i grunden en regressionsmodell, så den knyter ihop det du redan kan om regression med prognoser för tidsserier, och den är basen som ARIMA byggs på.
I den här artikeln går jag igenom hur en autoregressiv modell fungerar, hur du anpassar en i Python med statsmodels och hur du väljer rätt laggordning.
En autoregressiv modell förutspår nästa värde i en tidsserie från en viktad summa av dess tidigare värden.
I namnet betyder "auto" själv, och "regression" innebär att du förutspår en variabel från andra. Så en autoregressiv modell är en regression av en serie på dess egen historia.
Säg att du vill förutspå morgondagens elförbrukning. Dagens förbrukning är en bra start, och gårdagens lägger till lite mer information. En autoregressiv modell gör den intuitionen till en formel och lär sig vikterna från dina data.
AR-modeller skrivs som AR(p), där p är modellens ordning. Ordningen talar om hur många tidigare värden modellen använder:
p värdenaEn högre ordning betyder inte automatiskt en bättre modell. Jag visar hur du väljer p senare i artikeln.
Här är den generella formen för en AR(p)-modell:
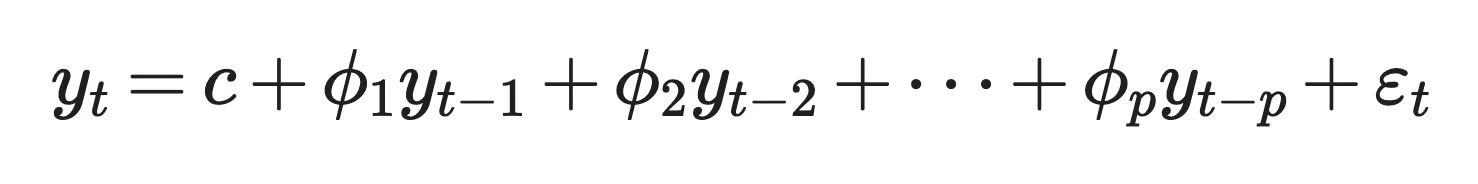
Den generella AR(p)-modellen
Så här gör varje term
y_t: Värdet på serien vid tidpunkt t, vilket är värdet du vill förutspå
c: En konstant som, tillsammans med koefficienterna, sätter seriens långsiktiga medelvärde
phi_1 till phi_p: Koefficienterna, som talar om hur mycket varje tidigare värde bidrar till prognosen
y_t-1 till y_t-p: De förskjutna värdena, där "lagg" betyder hur många steg bakåt du tittar
epsilon_t: Vitt brus, vilket är ett slumpfel med medelvärde noll, konstant varians och ingen tidsmässig korrelation
Enkelt uttryckt multiplicerar modellen var och en av de senaste p värdena med sin egen vikt och adderar konstanten. Det som blir över är brus, den del av y_t som det förflutna inte kan förklara.
AR(1) är den enklaste versionen:
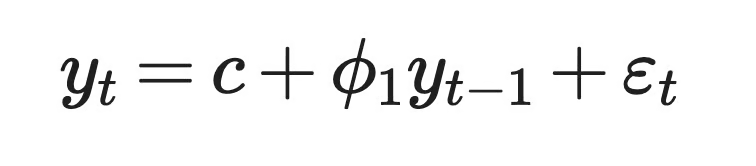
AR(1)-modell
Värdet på phi_1 styr hur mycket av idag som påverkar morgondagen.
Säg att c = 2 och phi_1 = 0.8. Om dagens värde är 15 förutspår modellen 2 + 0,8 x 15 = 14 för imorgon. Nästa prognos är 2 + 0,8 x 14 = 13,2. Varje steg för serien närmare 10, som är dess långsiktiga medelvärde, c / (1 - phi_1).
Om phi_1 är negativ hoppar serien över och under medelvärdet från ett steg till nästa.
AR(2) lägger till ett andra lagg:
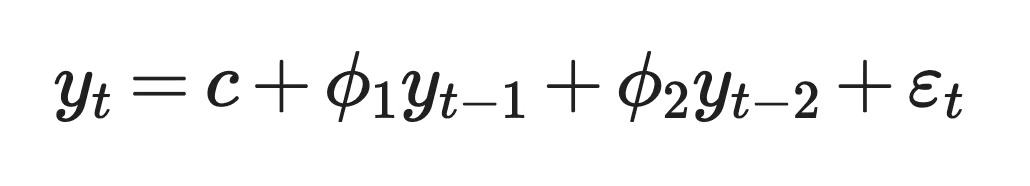
AR(2)-modell
Med två lagg kan modellen beskriva mönster som AR(1) inte kan, som cykler. Till exempel kan ett positivt phi_1 med ett negativt phi_2 ge en serie som stiger och faller i vågor, likt en konjunkturcykel.
Så varje AR-modell kokar ner till två val – hur många lagg som ska användas och vilka vikter de ska få.
En AR-modell fungerar bara när två saker är sanna om dina data. Tidigare värden måste hänga ihop med framtida värden, och serien måste bete sig likadant över tid. Det första kallas autokorrelation och det andra stationaritet.
Autokorrelation är korrelationen mellan en tidsserie och en förskjuten kopia av den själv.
Det är orsaken till att AR-modeller finns. Om dagens värde inte säger något om morgondagens har modellen inget att lära av det förflutna.
I kod tar du en kolumn med värden, kopierar den och flyttar kopian ned en rad. Nu parar varje rad ihop ett värde med värdet före. Korrelationen mellan de två kolumnerna är lagg-1-autokorrelationen. När du flyttar med två rader får du lagg-2-autokorrelationen.
Så här ser det ut i pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))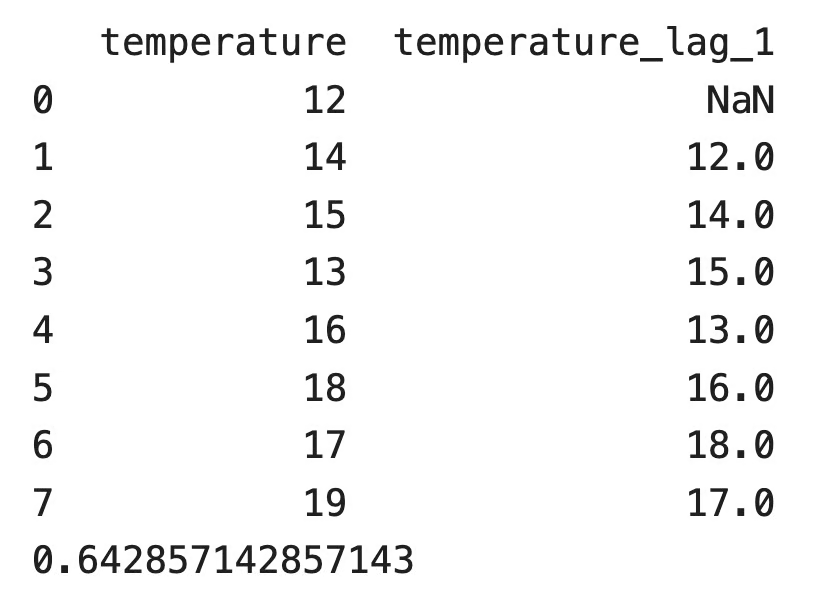
DataFrame med temperaturkolumnen och dess lagg-1-kopia
Den första raden i den förskjutna kolumnen är tom eftersom det inte finns någon avläsning före den första. pandas hoppar över den raden och returnerar en lagg-1-autokorrelation på 0,643. Varma dagar tenderar att följas av varma dagar i den här serien.
Tecknet på autokorrelationen ändrar hur serien beter sig:
En autokorrelation nära noll betyder att det förflutna inte hjälper. I så fall gör en AR-modell inte mycket bättre än att förutspå medelvärdet.
AR-modeller behöver en stationär tidsserie.
En stationär serie har samma medelvärde, samma varians och samma autokorrelation vid en given lagg, oavsett vilken del av serien du tittar på. Statistiker kallar detta svag stationaritet.
Det spelar roll eftersom modellen skattar en fast uppsättning koefficienter. Om seriens medelvärde driver över tid kommer koefficienter som lärts på äldre data inte att beskriva nyare data. Aktiekurser är ett vanligt exempel på en icke-stationär serie eftersom de trendar över åren. Dagliga avkastningar är betydligt mer stationära.
Koefficienterna själva avgör om en AR-process är stationär. För AR(1) är regeln enkel: phi_1 måste ligga mellan -1 och 1.
abs(phi_1) < 1: Störningar klingar av över tid och serien återgår till sitt medelvärde
phi_1 = 1: Serien blir en slumpvandring och störningar klingar aldrig av
abs(phi_1) > 1: Varje störning växer och serien exploderar
AR(2) behöver tre villkor samtidigt: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 och abs(phi_2) < 1.
Efter två lagg behöver du en generell regel. Varje AR(p)-modell har ett karaktäristiskt polynom:
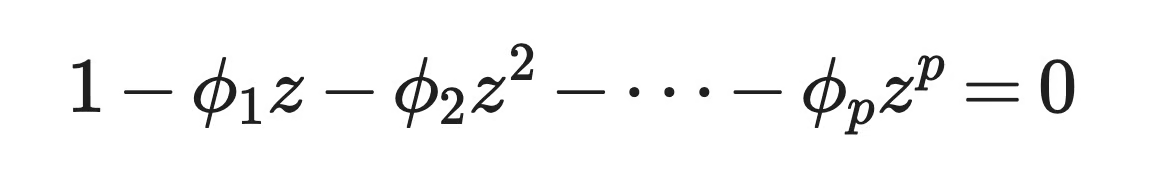
Karaktäristiskt polynom
Processen är svagt stationär när alla rötter till detta polynom ligger utanför enhetscirkeln, vilket betyder att varje rot z har ett absolutvärde större än 1. Rötterna kan vara komplexa tal, vilket är varför gränsen är en cirkel i det komplexa planet och inte en linje.
Du kan kontrollera detta med AR(1). Polynomet är 1 - phi_1 z = 0, så roten är z = 1 / phi_1. Den roten ligger utanför enhetscirkeln bara när abs(phi_1) < 1, vilket är samma regel som tidigare.
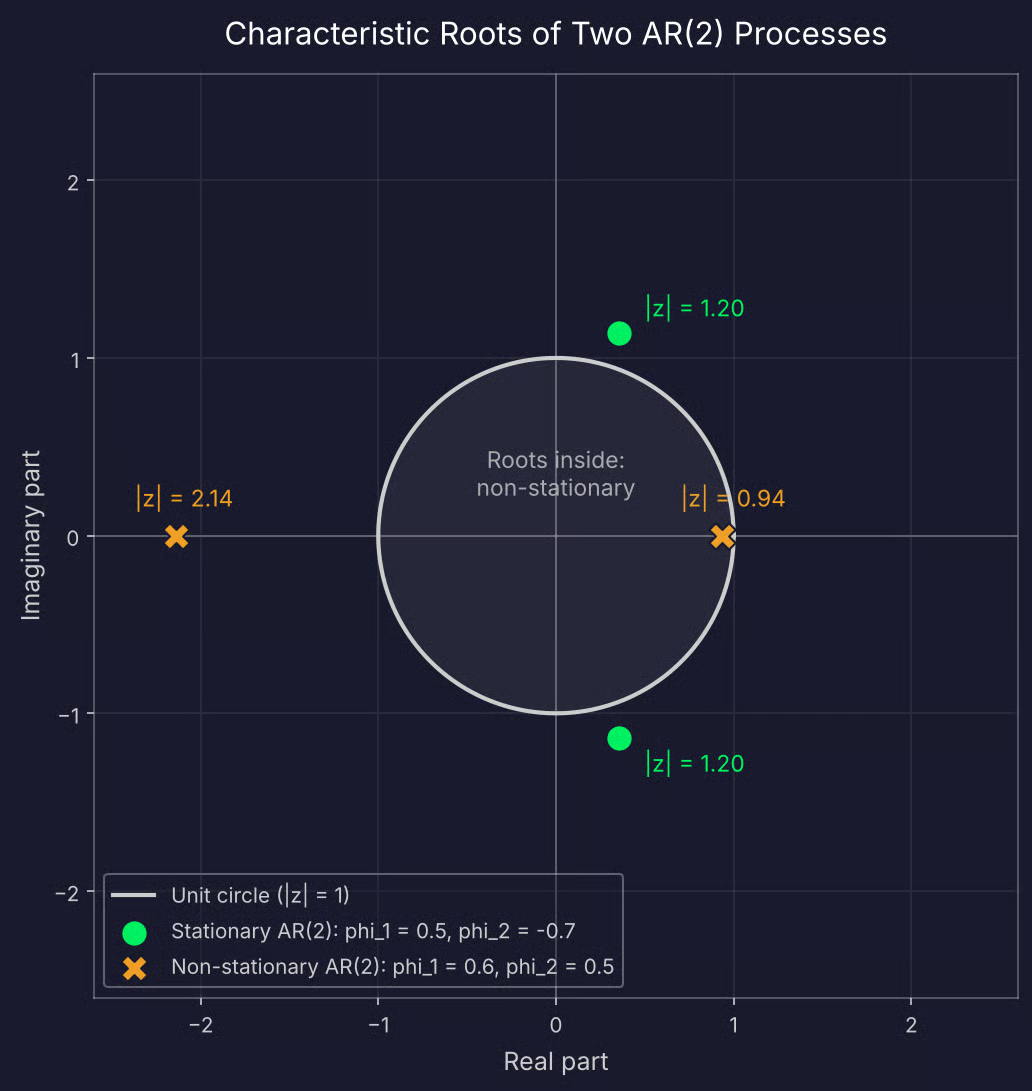
Rötter för en stationär och en icke-stationär AR(2)-process
Du kommer inte att räkna ut dessa rötter för hand. statsmodels returnerar dem efter att du har anpassat en modell, och jag visar hur du testar själva data för stationaritet i Python-avsnittet.
Om din serie inte är stationär kan du differensera den – subtrahera varje värde från nästa – och modellera differenserna. Det är vad "I" i ARIMA-modeller står för.
Varje AR-modell har samma ekvation. Det som ändras från en typ till nästa är ordningen p, alltså hur många tidigare värden modellen använder.
AR(1) använder bara föregående värde för att förutspå nästa.
Låter det som linjär regression? Det är för att det är det. När du placerar y_t-1 på x-axeln och y_t på y-axeln passar AR(1) en rak linje genom punkterna. Konstanten c är interceptet och phi_1 är lutningen. Om du kan enkel linjär regression, kan du redan hur AR(1) skattas.
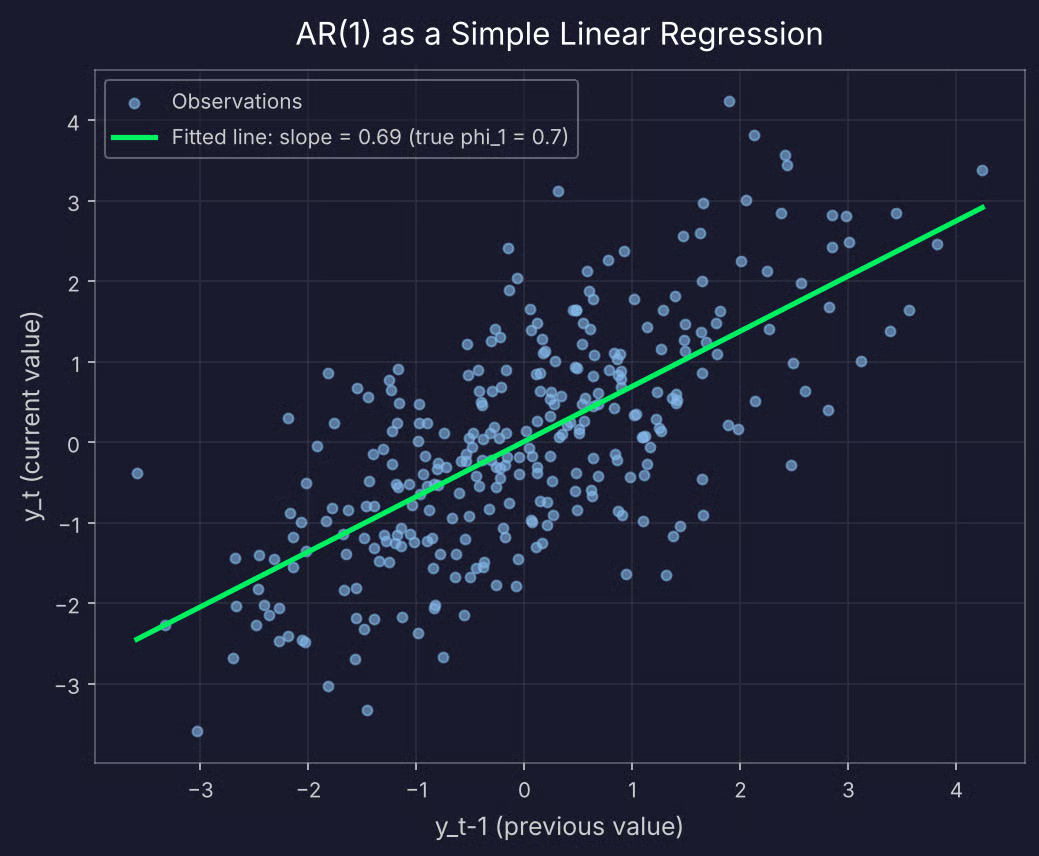
Spridningsdiagram av y_t mot y_t-1 för AR(1)
Men det finns en skillnad. I en standardregression är prediktorn och målet separata variabler. I AR(1) är prediktorn samma serie förskjuten ett steg. Därför kan du inte slumpa raderna eller använda en slumpmässig train/test-uppdelning – ordningen i datan är en del av modellen.
Värdet på phi_1 ändrar hur serien ser ut:
phi_1 = 0.3: Serien ser nästan ut som slumpbrus, eftersom varje värde bär lite information om nästa
phi_1 = 0.9: Serien rör sig i långa, mjuka svängningar och tar tid att återgå till sitt medelvärde
phi_1 = -0.8: Serien sicksackar över och under medelvärdet nästan varje steg
phi_1 = 1: Serien blir en slumpvandring och driver utan ett medelvärde att återgå till, vilket är det icke-stationära fallet från föregående avsnitt
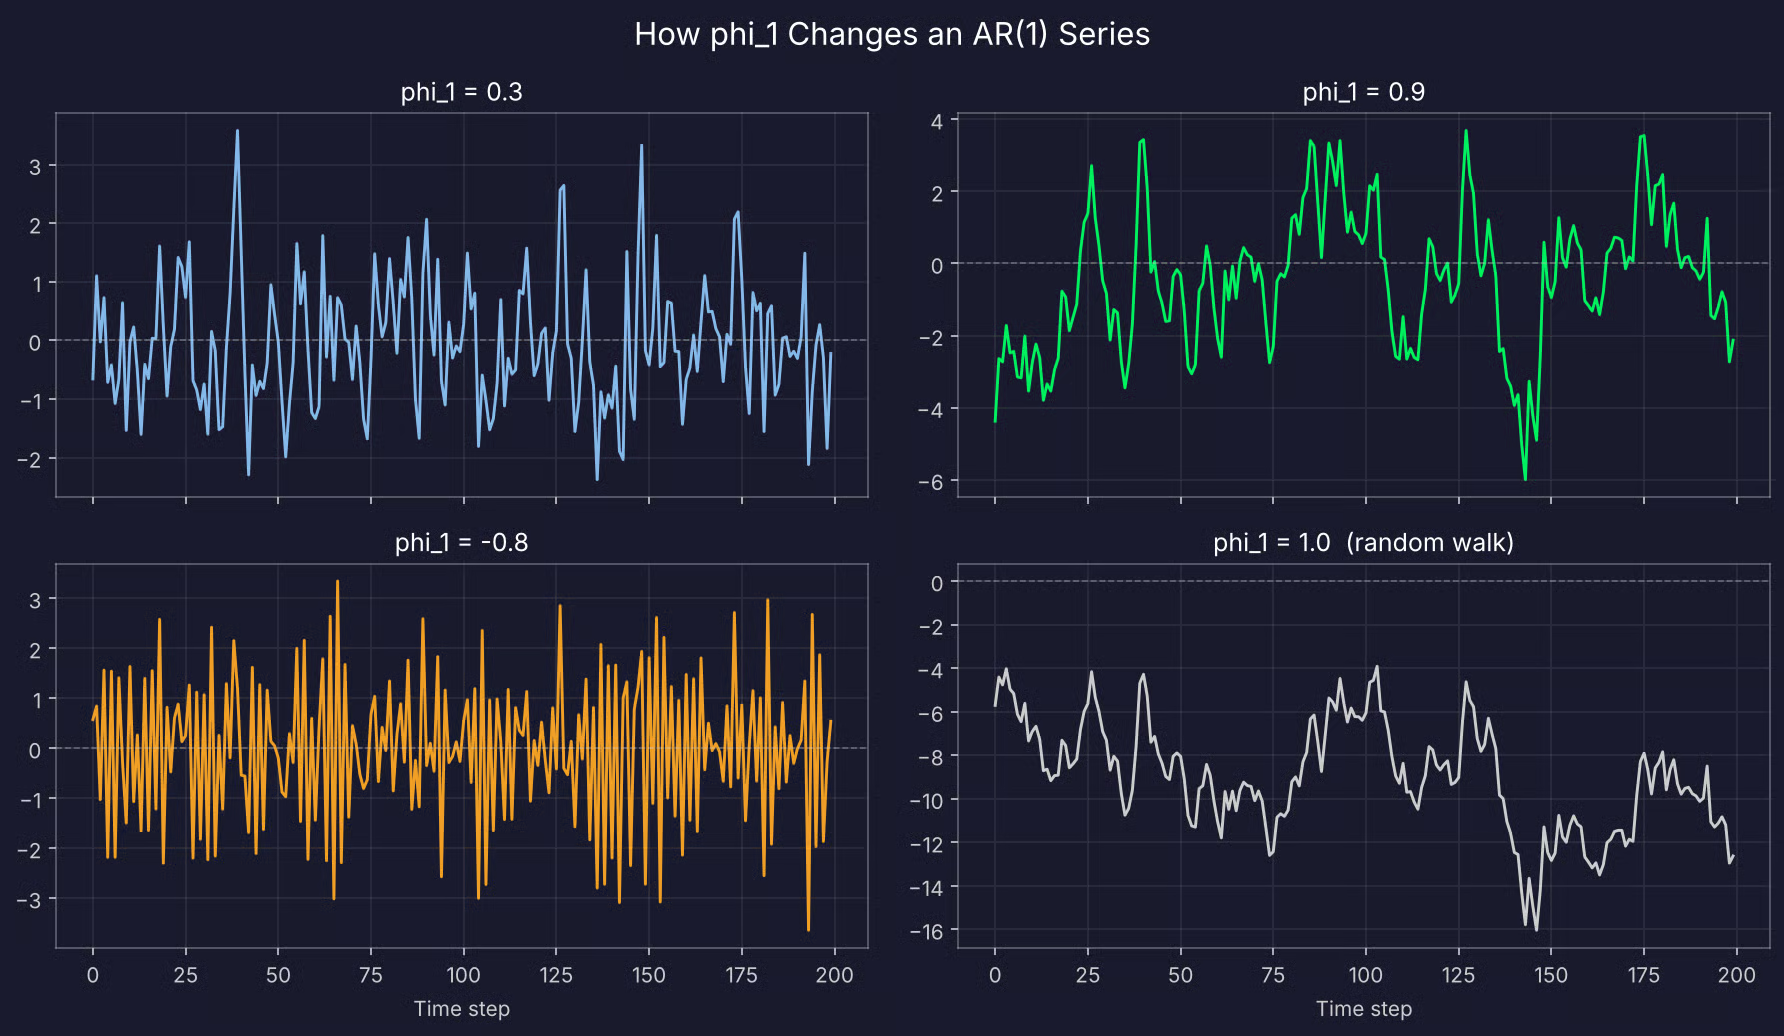
Fyra simulerade AR(1)-serier
Ju närmare phi_1 kommer 1 eller -1, desto längre påverkar en enskild störning serien.
AR(2) använder de två föregående värdena. Det andra lagget gör att modellen kan ge mönster som AR(1) inte kan, främst cykler.
Så här jämförs två uppsättningar koefficienter:
phi_1 = 0.5, phi_2 = 0.3: Båda laggen trycker åt samma håll, så serien ser ut som en AR(1) med längre, mjukare svängningar
phi_1 = 0.5, phi_2 = -0.7: Det andra lagget motverkar det första, och serien stiger och faller i vågor som upprepar sig ungefär var femte steg
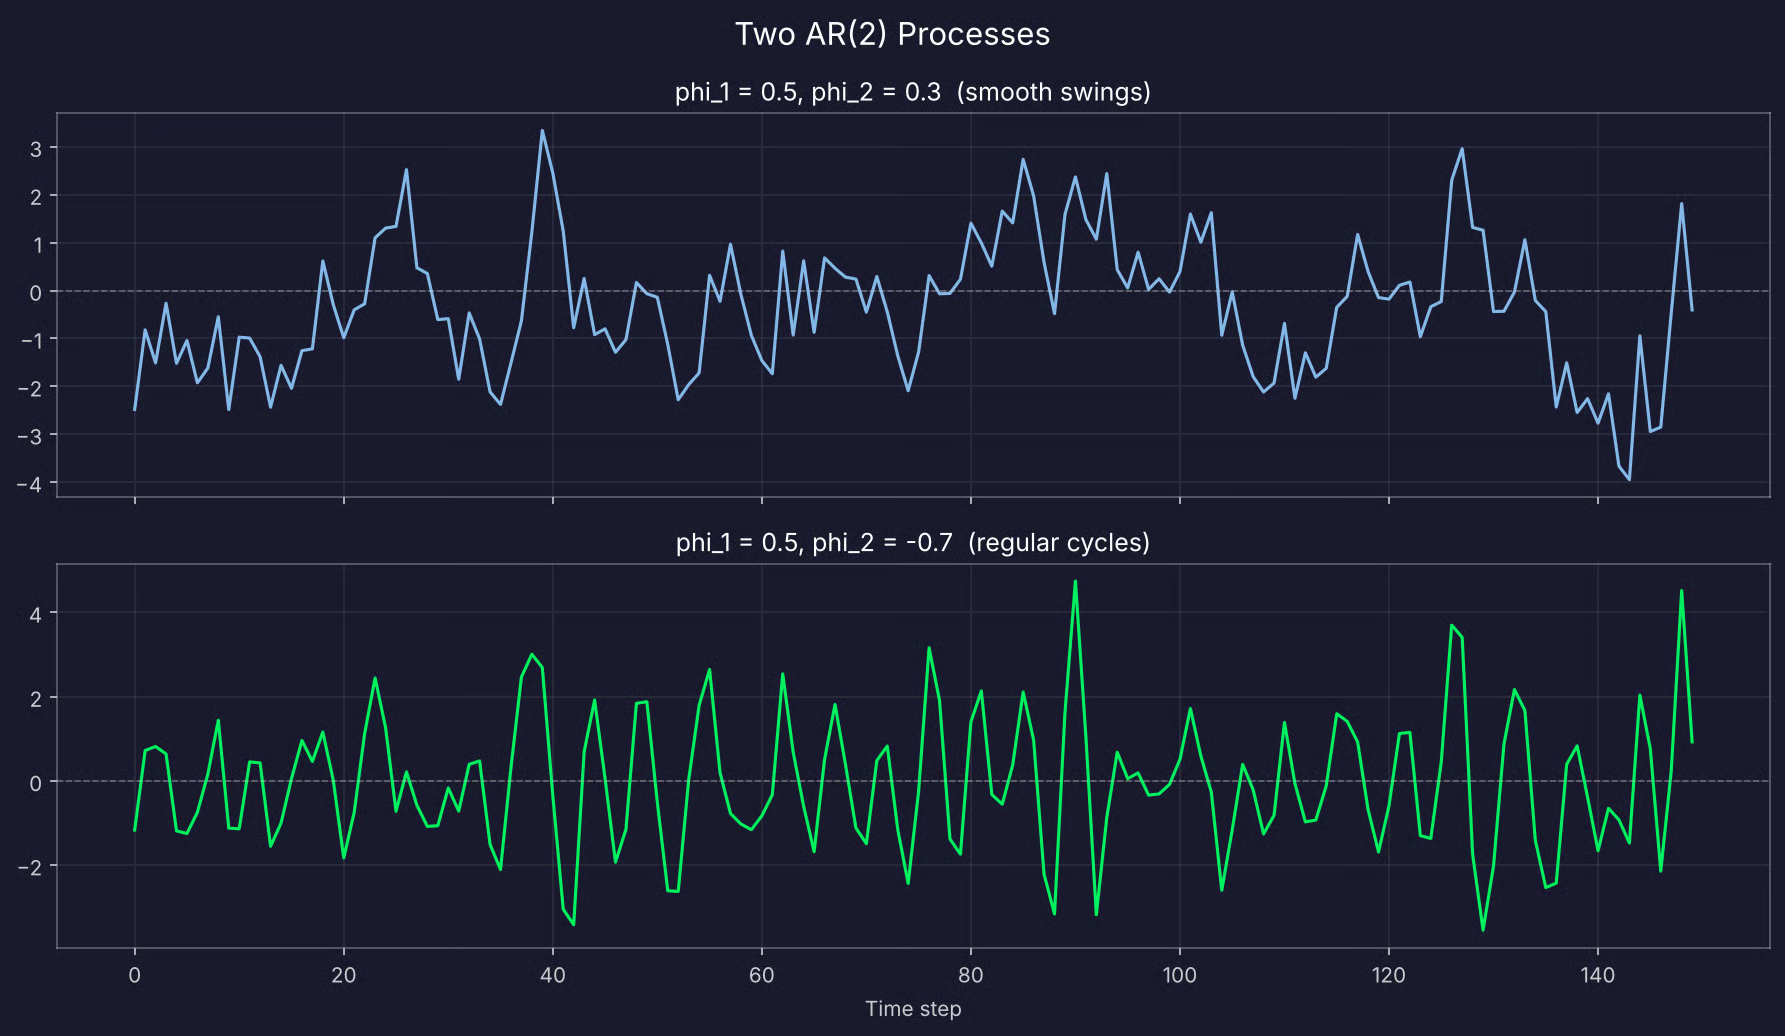
Två simulerade AR(2)-serier
AR(3), AR(4) och vidare lägger till ett lagg i taget. Du behöver dem när värden längre bak bär information som de senaste inte gör.
Säg att du modellerar månatlig försäljning och samma månad förra året förutspår denna månad väl. En AR(12)-modell inkluderar det 12-månaders lagget, tillsammans med de 11 laggen däremellan.
Varje extra lagg lägger till en koefficient att skatta. Det betyder att du behöver mer data och att risken för överanpassning ökar. Koefficienterna blir också svårare att läsa – med 12 stycken kan du inte se på siffrorna och säga vad serien kommer att göra. Du kontrollerar rötterna i stället.
Jag visar hur du väljer rätt ordning med PACF och AIC i Python-avsnittet.
AR-modeller dyker upp varhelst data lagras i ordning och den närmaste historien säger något om den nära framtiden.
De flesta användningsfall faller i en av fyra grupper:
Den sista förvånar många eftersom termen bakom dagens chattrobotar kommer från samma statistik du läser om här.
I det här avsnittet anpassar jag en autoregressiv modell i Python med statsmodels, från rådata till en prognos du kan utvärdera.
Du behöver pandas och NumPy för datan, statsmodels för modellen och testerna, och scikit-learn för felmåttet:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorJag simulerar två år av daglig elförbrukning från en AR(2)-process.
Jag valde simulerad data eftersom du känner de sanna koefficienterna i förväg. På så sätt kan du kontrollera om modellen hittar dem och om verktygen för laggval pekar på rätt ordning.
Processen har c = 15, phi_1 = 0.6 och phi_2 = 0.25, vilket ger ett långsiktigt medelvärde på 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()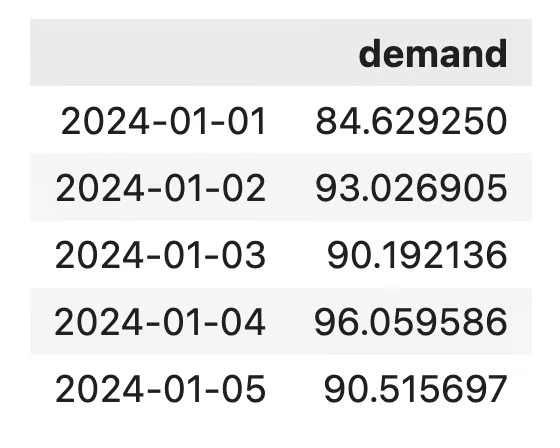
Datasetet med daglig elförbrukning
De första 100 simulerade dagarna tas bort eftersom den uppvärmningsperioden ger serien tid att komma in i sitt normala beteende innan du börjar använda den.
Så här ser hela serien ut:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()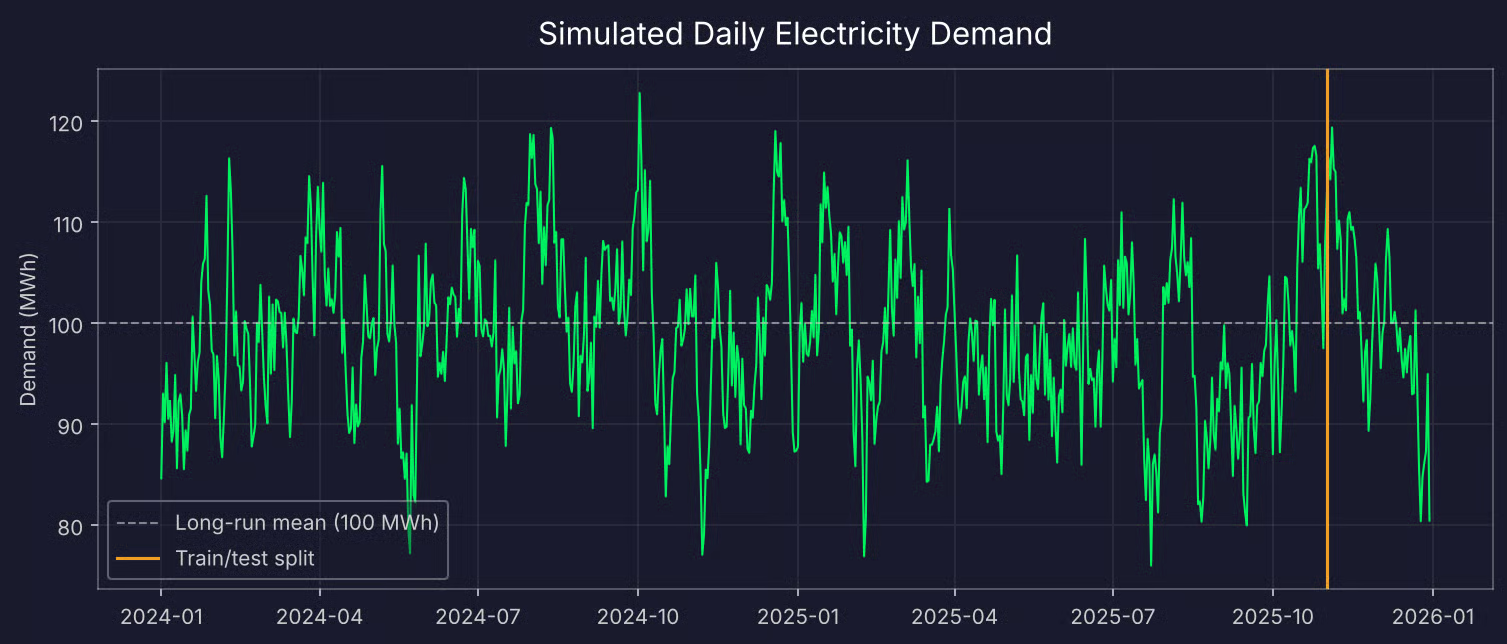
Två år av simulerad daglig elförbrukning
Serien rör sig upp och ner runt 100 utan trend, vilket är hur en stationär serie ska se ut. Men en visuell kontroll är inget bevis.
Det utökade Dickey–Fuller-testet (ADF) kontrollerar om en serie är stationär. Nollhypotesen är att serien inte är stationär, så ett litet p-värde är vad du vill ha:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")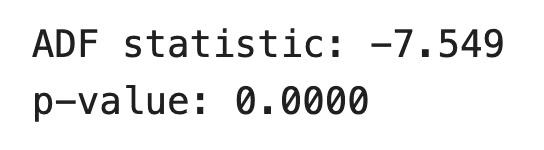
Resultat från ADF-test
p-värdet är långt under 0,05, så du kan förkasta nollhypotesen och betrakta serien som stationär.
Om dina egna data misslyckas med detta test, differensera med df["demand"].diff().dropna() och kör testet igen.
Tidsseriedata kan inte slumpas, så testmängden måste komma från slutet av serien. Jag sparar de sista 60 dagarna för test:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Det lämnar 670 dagar för träning och 60 för test.
Detta är steget som avgör hur väl modellen fungerar. Om du väljer för få lagg missar modellen mönster i datan. Men om du väljer för många, anpassar den brus i träningsdatan som inte upprepas i framtiden.
Du har två verktyg för det.
Det första är partiell autokorrelationsfunktion (PACF). Den visar korrelationen mellan serien och varje lagg efter att effekten av alla kortare lagg tagits bort. För en AR(p)-process har PACF tydliga spikar upp till lagg p och faller till runt noll därefter:
plot_pacf(train, lags=20, method="ywm")
plt.show()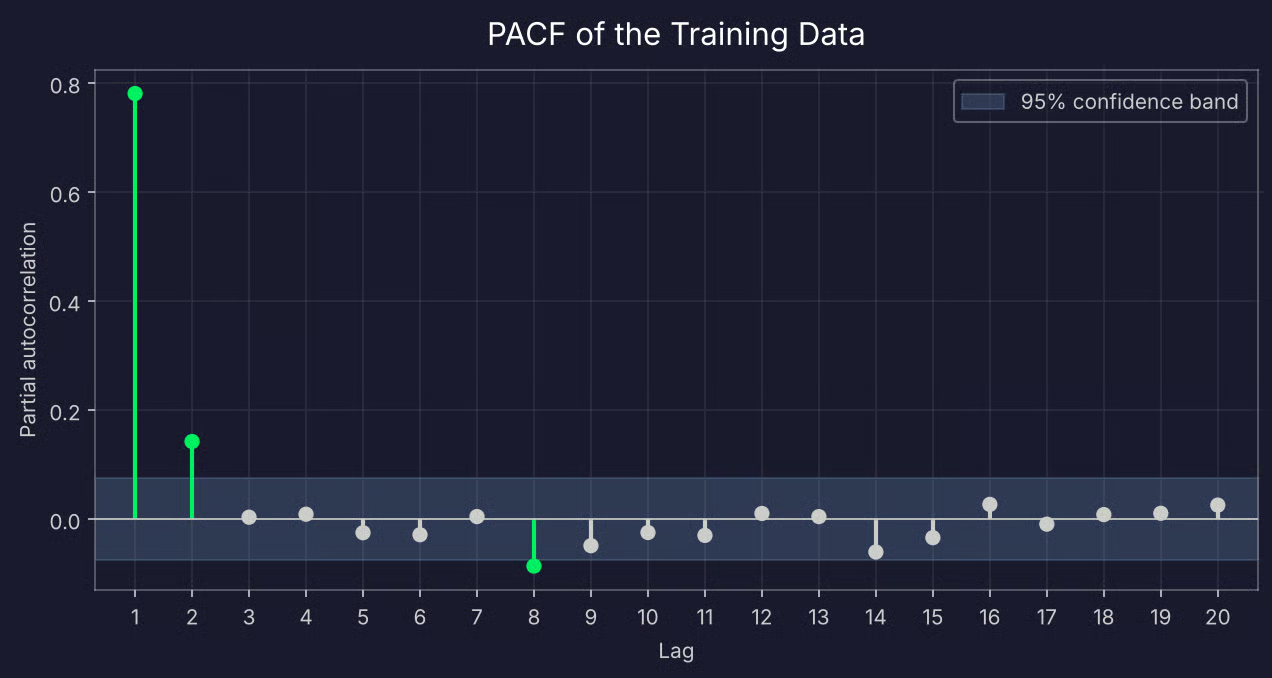
PACF för träningsdatan
Lagg 1 och 2 ligger långt utanför konfidensbandet och lagg 3 faller nära noll. Det pekar på AR(2).
Det finns också en liten spik vid lagg 8, precis utanför bandets kant. Läs inte in för mycket i det. Bandet ritas vid 95% konfidens, så med 20 lagg kan du förvänta dig att ungefär ett av dem korsar det av en slump.
Det andra verktyget är informationskriterier. AIC och BIC belönar båda en modell för att passa datan väl och straffar den för varje extra parameter. BIC ger större straff, så den tenderar att välja mindre modeller. statsmodels kan testa varje ordning upp till ett maximum och returnera den bästa:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")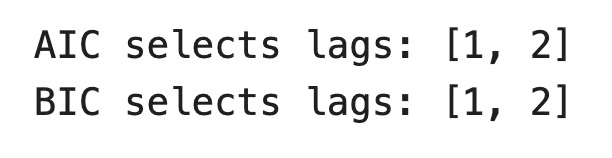
Laggval med AIC/BIC
Båda kriterierna håller med PACF. I praktiken ser du ofta att AIC väljer en något större modell än BIC. Om det händer, börja med den mindre.
Med ordningen vald tar det två rader kod att anpassa modellen:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")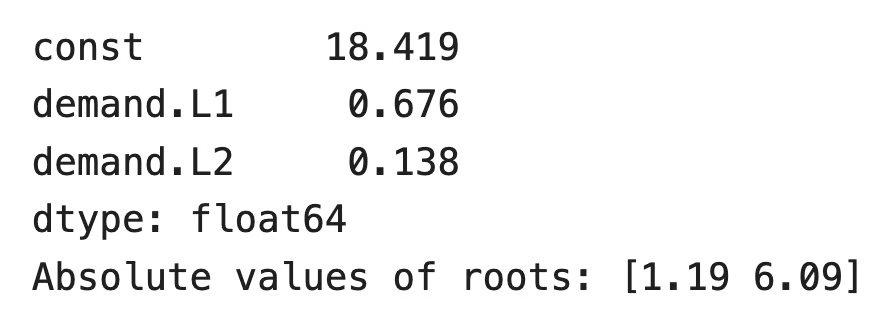
Parametrar för AR(2)-modellen
De sanna värdena är 0,6 och 0,25. Modellen ger lite mer vikt åt det första lagget och mindre åt det andra, men summan av de två koefficienterna är nära – 0,81 mot 0,85. Med 670 datapunkter kommer du inte att återfinna de exakta värdena.
Båda rötterna har ett absolutvärde större än 1, så den anpassade modellen är stationär. Du kan anropa results.summary() om du vill ha standardfel, p-värden och hela rot-tabellen.
Det finns två sätt att prognostisera testperioden, och de besvarar olika frågor:
Flerstegsprognoser kommer direkt från de anpassade resultaten. För enstegsprognoser applicerar du de tränade koefficienterna på hela serien:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")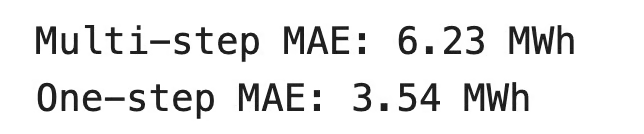
Prognosresultat
Medelabsolutfel (MAE) är den genomsnittliga absoluta skillnaden mellan prognoserna och de faktiska värdena. Det har samma enhet som datan, så du kan läsa det direkt. Enstegsprognosen missar i genomsnitt med 3,54 MWh.
Så här jämförs båda prognoserna med de faktiska värdena:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()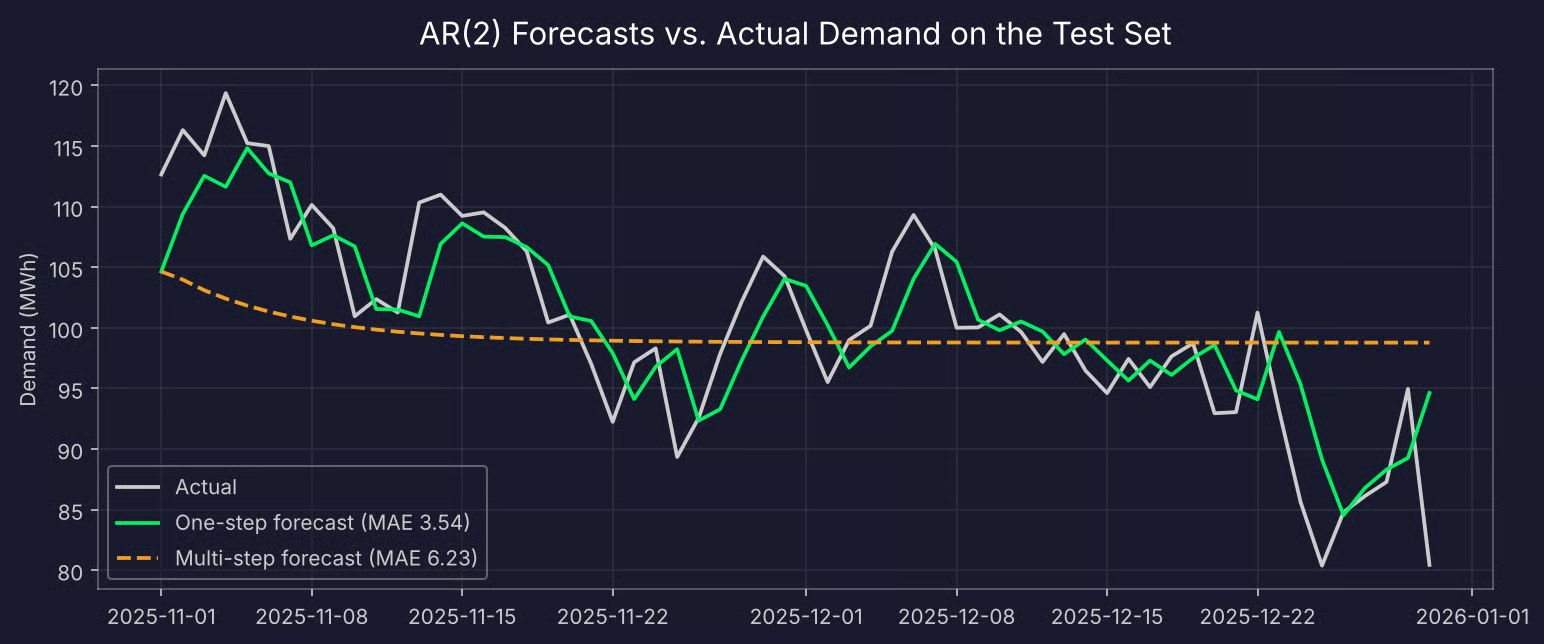
Enstegs- och flerstegs-AR(2)-prognoser jämfört med faktisk efterfrågan
Enstegsprognosen följer de faktiska värdena nära, ungefär en dag efter. Flerstegsprognosen börjar vid det senast kända värdet och planar sedan ut nära medelvärdet inom cirka tre veckor.
Så här beter sig varje stationär AR-modell – ju längre fram du prognostiserar, desto mindre säger det förflutna, och den bästa gissningen blir det långsiktiga medelvärdet. Det är därför AR-modeller fungerar bäst för kortsiktiga prognoser.
Det är lätt att anta att mer historik betyder bättre prognoser. Låt oss testa det genom att anpassa modeller med ett växande antal lagg och jämföra deras enstegs-MAE:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")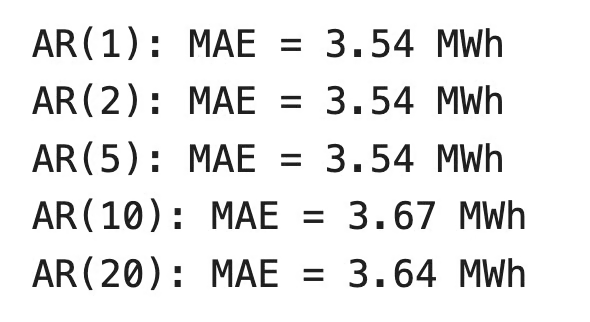
MAE med fler lagg
Felet förbättras inte efter AR(2), och det blir sämre vid AR(10) och AR(20). Dessa extra koefficienter anpassar brus i träningsdatan.
Du märker också att AR(1) fungerar lika bra som AR(2) här. Den skattade andra koefficienten är liten, så den tillför lite på detta test. När två modeller presterar lika är den enklare lättare att förklara och mindre benägen att brista på ny data.
Det finns också en kostnadssida. AR(20) skattar 21 parametrar i stället för 3.
Slutsats: låt PACF och informationskriterier föreslå ordningen och bekräfta den sedan bara på ett testset.
AR-modeller passar många prognosproblem, men inte alla. Här är var de fungerar och var de inte gör det, och hur de jämförs med modellerna som byggs ovanpå dem.
AR-modeller har två huvudsakliga fördelar:
De har också två huvudsakliga begränsningar:
Det finns ytterligare ett problem. Förskjutna värden är korrelerade med varandra eftersom de kommer från samma serie. I efterfrågedatan är korrelationen mellan y_t-1 och y_t-2 0,78.
Detta kallas multikollinearitet, och det påverkar alla regressionsmodeller. När två prediktorer rör sig tillsammans har modellen svårt att avgöra vilken som ansvarar. Koefficienterna blir mindre stabila och deras standardfel ökar.
Det förklarar det du såg tidigare. Modellen skattade 0,676 och 0,138 i stället för 0,6 och 0,25 – den flyttade vikt från ett lagg till det andra, men summan förblev nära. Prognoser lider inte mycket av detta, men du kan inte lita lika mycket på enskilda koefficienter. Varje extra lagg förvärrar problemet.
AR är en av tre byggstenar i klassisk tidsserieprognostik. De andra två är glidande medelvärdesmodeller (MA) och ARIMA, som kombinerar dem.
En AR-modell förutspår från tidigare värden. En MA-modell förutspår från tidigare fel:
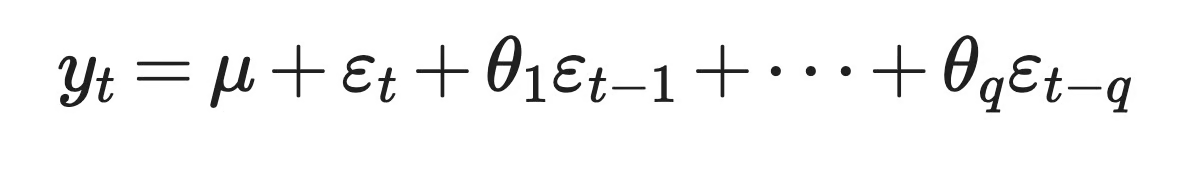
ARMA-modell
Här är mu seriens medelvärde, theta_1 till theta_q är koefficienterna, och epsilon_t-1 till epsilon_t-q är slumpstörningarna från tidigare steg. Förväxla det inte med ett glidande medelvärde i rullande-medel-sense. Namnet är detsamma, men modellen är annorlunda.
De två modellerna reagerar olika på störningar. I en MA(q)-modell påverkar en störning serien i exakt q steg. I en AR-modell klingar en störning av över tid men går aldrig helt till noll. Denna skillnad är också varför du använder olika verktyg för att välja ordning – PACF klipper av efter lagg p för AR-modeller, och ACF klipper av efter lagg q för MA-modeller.
ARIMA sätter ihop allt. ARIMA(p, d, q) har tre delar:
Detta betyder att AR är ett specialfall av ARIMA. Om du sätter d och q till noll får du en AR-modell. Du kan kontrollera detta med efterfrågedatan:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))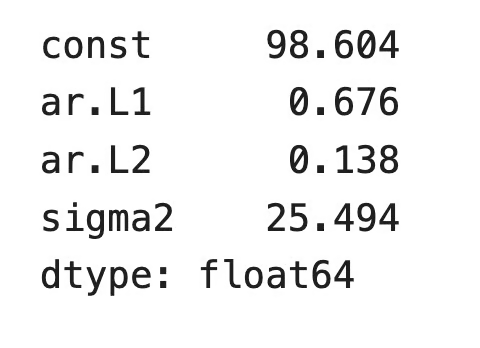
ARIMA-modell med 0 i differens- och glidande medelvärdesordning
AR-koefficienterna matchar dem från AutoReg. Konstanten är annorlunda eftersom ARIMA rapporterar seriens medelvärde, medan AutoReg rapporterar interceptet c.
Nu ser vi var ARIMA går längre. Anta att staden växer och elförbrukningen stiger lite varje dag. Serien har nu en trend, så ADF-testet misslyckas och en AR-modell kan inte längre arbeta direkt med serien.
Men ARIMA(2, 1, 0) kan. Den differensierar serien en gång, så modellen arbetar med dagliga förändringar i efterfrågan i stället för råvärdena, och anpassar sedan AR(2) på dessa förändringar. Om en störning som en värmebölja också påverkar nästa dags efterfrågan kan du lägga till en MA-term och få ARIMA(2, 1, 1).
AR-delen gör samma jobb i varje fall. ARIMA förbereder bara datan för den och modellerar det som blir över. Om du vill fördjupa dig täcker kursen ARIMA Models in R hela processen.
En autoregressiv modell förutspår nästa värde i en serie från dess eget förflutna. Det är en linjär regression där prediktorerna är förskjutna kopior av målet, och det gör den till en av de enklaste tidsseriemodellerna att förstå.
Du ser den i ekonomi, tal-kodning, EEG-analys och till och med i namnet på dagens språkmodeller. Du har också sett var den inte är det bästa alternativet, eftersom den kräver stationära data, beror på rätt laggordning och korrelerade lagg gör enskilda koefficienter mindre tillförlitliga.
Om du förstår AR-modeller blir resten av klassisk prognostik mycket lättare. ARIMA är det naturliga nästa steget, och vår ARIMA-guide visar hur differenser och MA-termer utvidgar det du lärt dig här. För en praktisk väg, prova vår kurs ARIMA Models in Python.
Lär dig med DataCamp
Kurs
Kurs
Kurs