Corso
Analisi delle serie temporali in Python
4 ore
70.9K
Gran parte dei contenuti online passa subito ad ARIMA e dedica all’AR una riga di spiegazione, se va bene. Ma l’AR è la base del modello. Se non lo capisci, anche il resto di ARIMA non avrà senso.
In parole semplici, un modello autoregressivo prevede i valori futuri di una serie temporale a partire dai suoi stessi valori passati. Lo troverai in economia, finanza, elaborazione dei segnali e dati climatici. È sostanzialmente un modello di regressione, quindi collega ciò che già sai sulla regressione alla previsione di serie temporali, ed è la base su cui è costruito ARIMA.
In questo articolo ti mostrerò come funziona un modello autoregressivo, come adattarlo in Python con statsmodels e come scegliere il giusto ordine dei lag.
Un modello autoregressivo prevede il valore successivo di una serie temporale come somma pesata dei suoi valori precedenti.
Nel nome, "auto" significa sé stesso e "regressione" significa prevedere una variabile a partire da altre. Quindi un modello autoregressivo è una regressione di una serie sui propri valori passati.
Poniamo che tu voglia prevedere la domanda di elettricità di domani. La domanda di oggi è un buon punto di partenza e quella di ieri aggiunge un po’ di informazione. Un modello autoregressivo trasforma quell’intuizione in una formula e apprende i pesi dai tuoi dati.
I modelli AR si scrivono come AR(p), dove p è l’ordine del modello. L’ordine indica quanti valori passati usa il modello:
p valoriUn ordine più alto non significa automaticamente un modello migliore. Ti mostrerò come scegliere p più avanti nell’articolo.
Ecco la forma generale di un modello AR(p):
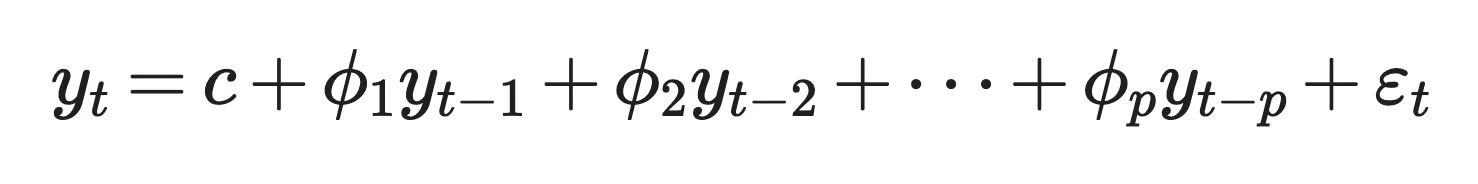
Il modello AR(p) generale
Ecco cosa fa ogni termine
y_t: Il valore della serie al tempo t, cioè il valore che vuoi prevedere
c: Una costante che, insieme ai coefficienti, determina la media di lungo periodo della serie
phi_1 a phi_p: I coefficienti, che indicano quanto ciascun valore passato contribuisce alla previsione
y_t-1 a y_t-p: I valori ritardati, dove "lag" indica di quanti passi indietro guardi
epsilon_t: Rumore bianco, ossia un errore casuale con media zero, varianza costante e nessuna correlazione nel tempo
In termini semplici, il modello moltiplica ciascuno degli ultimi p valori per il suo peso e aggiunge la costante. Quel che resta è il rumore, la parte di y_t che il passato non può spiegare.
AR(1) è la versione più semplice:
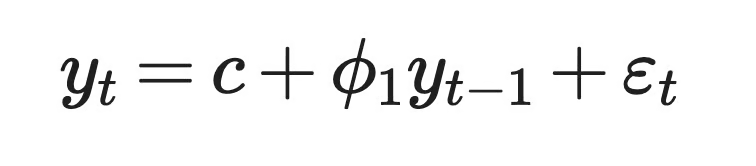
Modello AR(1)
Il valore di phi_1 controlla quanto l’oggi influenza il domani.
Supponiamo c = 2 e phi_1 = 0.8. Se il valore di oggi è 15, il modello prevede 2 + 0,8 x 15 = 14 per domani. La previsione successiva è 2 + 0,8 x 14 = 13,2. Ogni passo avvicina la serie a 10, che è la sua media di lungo periodo, c / (1 - phi_1).
Se phi_1 è negativo, la serie salta sopra e sotto la media da un passo all’altro.
AR(2) aggiunge un secondo lag:
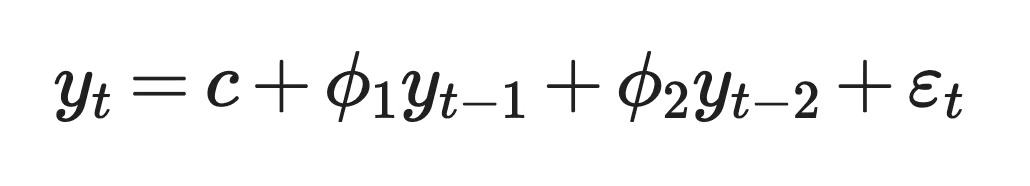
Modello AR(2)
Con due lag, il modello può descrivere schemi che AR(1) non riesce a cogliere, come i cicli. Per esempio, un phi_1 positivo con un phi_2 negativo può produrre una serie che sale e scende a onde, simile a un ciclo economico.
Quindi ogni modello AR si riduce a due scelte: quanti lag usare e quali pesi assegnarli.
Un modello AR funziona solo quando due cose sono vere sui tuoi dati. I valori passati devono essere correlati ai futuri e la serie deve comportarsi allo stesso modo nel tempo. La prima si chiama autocorrelazione, la seconda stazionarietà.
L’autocorrelazione è la correlazione tra una serie temporale e una sua copia ritardata.
È il motivo per cui esistono i modelli AR. Se il valore di oggi non dice nulla su quello di domani, il modello non ha nulla da imparare dai valori passati.
In codice, prendi una colonna di valori, la copi e sposti la copia in basso di una riga. Ora ogni riga accoppia un valore con quello precedente. La correlazione tra le due colonne è la autocorrelazione al lag 1. Quando sposti di due righe, ottieni l’autocorrelazione al lag 2.
Ecco come appare in pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))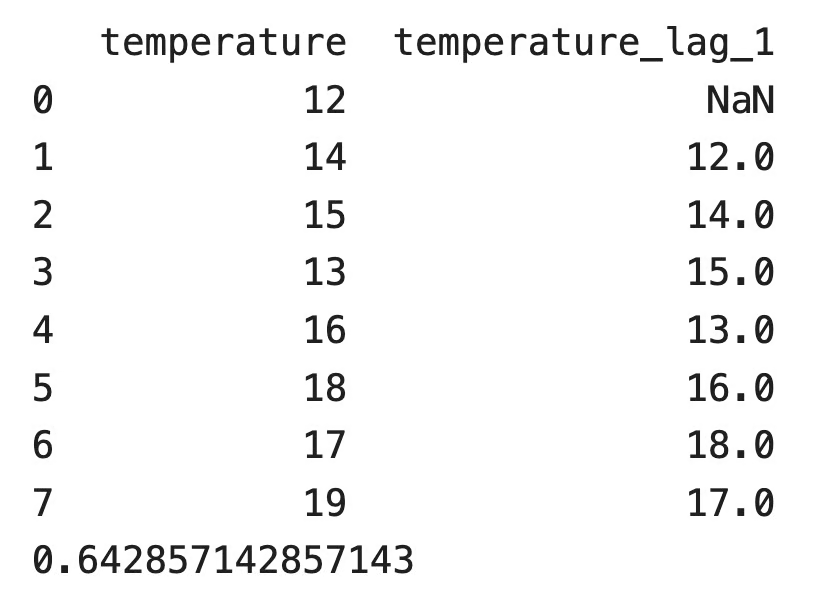
DataFrame con la colonna della temperatura e la sua copia al lag 1
La prima riga della colonna ritardata è vuota perché non c’è una lettura prima della prima. pandas salta quella riga e restituisce un’autocorrelazione al lag 1 di 0,643. In questa serie, le giornate calde tendono a seguire giornate calde.
Il segno dell’autocorrelazione cambia il comportamento della serie:
Un’autocorrelazione vicina a zero significa che il passato non aiuta. In tal caso, un modello AR non farà molto meglio di una previsione della media.
I modelli AR richiedono una serie temporale stazionaria.
Una serie stazionaria ha la stessa media, la stessa varianza e la stessa autocorrelazione a un dato lag, indipendentemente dalla porzione di serie che osservi. Gli statistici chiamano questo proprietà di stazionarietà in senso debole.
Conta perché il modello stima un unico set di coefficienti. Se la media della serie deriva nel tempo, i coefficienti appresi dai dati più vecchi non descriveranno i dati più recenti. I prezzi azionari sono un esempio comune di serie non stazionaria perché tendono nel corso degli anni. I rendimenti giornalieri sono molto più vicini alla stazionarietà.
Sono i coefficienti stessi a determinare se un processo AR è stazionario. Per AR(1), la regola è semplice: phi_1 deve essere compreso tra -1 e 1.
abs(phi_1) < 1: Gli shock svaniscono nel tempo e la serie torna alla sua media
phi_1 = 1: La serie diventa un random walk e gli shock non svaniscono mai
abs(phi_1) > 1: Ogni shock cresce e la serie esplode
AR(2) richiede tre condizioni contemporaneamente: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 e abs(phi_2) < 1.
Dopo due lag, serve una regola generale. Ogni modello AR(p) ha un polinomio caratteristico:
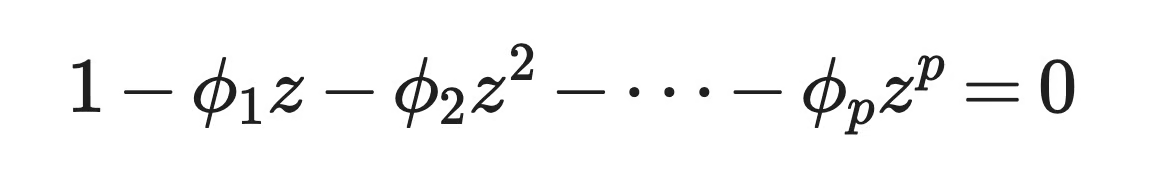
Polinomio caratteristico
Il processo è stazionario in senso debole quando tutte le radici di questo polinomio sono fuori dal cerchio unitario, cioè quando ogni radice z ha valore assoluto maggiore di 1. Le radici possono essere complesse, motivo per cui il confine è un cerchio sul piano complesso e non una linea.
Puoi verificarlo con AR(1). Il polinomio è 1 - phi_1 z = 0, quindi la radice è z = 1 / phi_1. Quella radice è fuori dal cerchio unitario solo quando abs(phi_1) < 1, che è la stessa regola di prima.
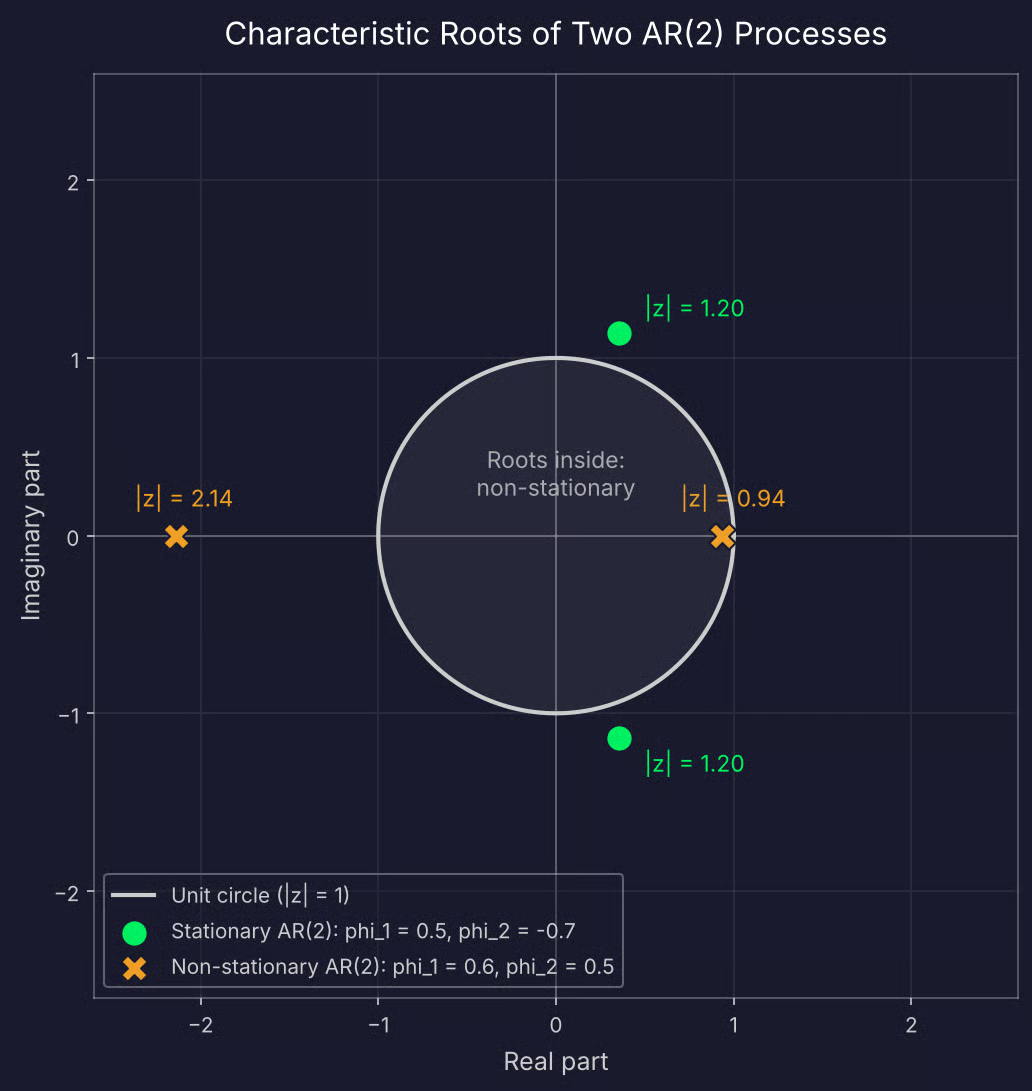
Radici di un processo AR(2) stazionario e non stazionario
Non calcolerai queste radici a mano. statsmodels le restituisce dopo l’adattamento del modello e ti mostrerò come testare la stazionarietà dei dati stessi nella sezione Python.
Se la tua serie non è stazionaria, puoi differenziarla — sottrarre ciascun valore dal successivo — e modellare le differenze. È ciò che indica la "I" nei modelli ARIMA.
Ogni modello AR ha la stessa equazione. Ciò che cambia da un tipo all’altro è l’ordine p, cioè quanti valori passati usa il modello.
AR(1) usa solo il valore precedente per prevedere il successivo.
Se ti sembra una regressione lineare, è perché lo è. Quando metti y_t-1 sull’asse x e y_t sull’asse y, AR(1) adatta una retta ai punti. La costante c è l’intercetta e phi_1 è la pendenza. Se conosci la regressione lineare semplice, sai già come si stima AR(1).
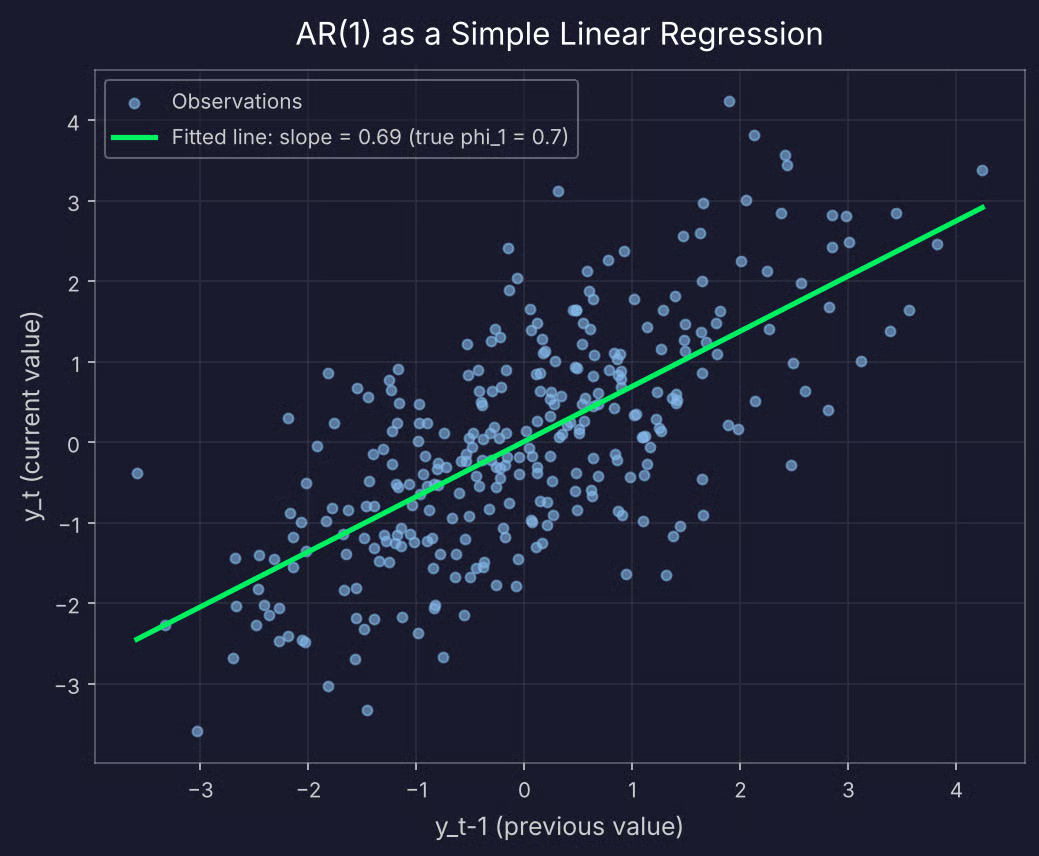
Scatter plot di y_t contro y_t-1 per AR(1)
Ma c’è una differenza. In una regressione standard, il predittore e il target sono variabili separate. In AR(1), il predittore è la stessa serie spostata di un passo. Ecco perché non puoi mescolare le righe o usare uno split casuale train/test: l’ordine dei dati fa parte del modello.
Il valore di phi_1 cambia l’aspetto della serie:
phi_1 = 0.3: La serie sembra quasi rumore casuale, perché ogni valore porta poca informazione su quello successivo
phi_1 = 0.9: La serie si muove in ampie oscillazioni e impiega tempo a tornare alla media
phi_1 = -0.8: La serie zigzaga sopra e sotto la media quasi a ogni passo
phi_1 = 1: La serie diventa un random walk e derapa senza una media a cui tornare, cioè il caso non stazionario visto nella sezione precedente
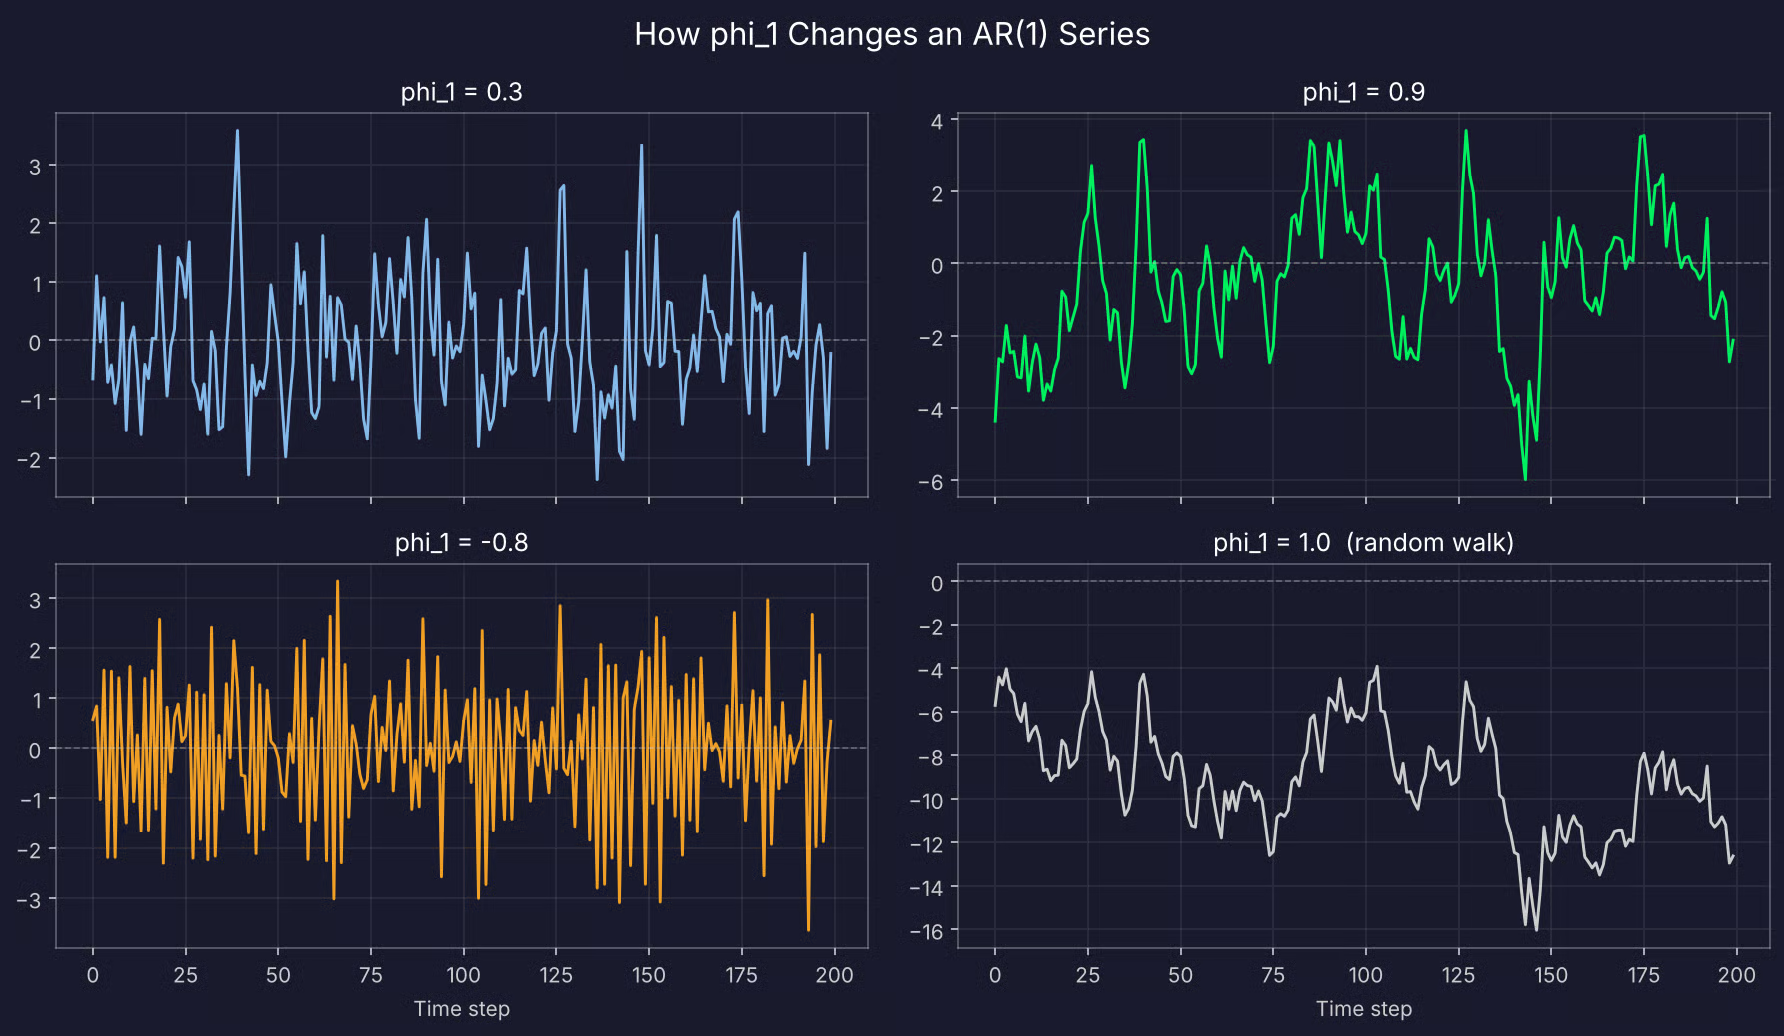
Quattro serie AR(1) simulate
Più phi_1 si avvicina a 1 o -1, più a lungo un singolo shock influenza la serie.
AR(2) usa i due valori precedenti. Il secondo lag consente al modello di generare schemi che AR(1) non può, principalmente cicli.
Ecco come si confrontano due set di coefficienti:
phi_1 = 0.5, phi_2 = 0.3: Entrambi i lag spingono nella stessa direzione, quindi la serie somiglia a un AR(1) con oscillazioni più lunghe e regolari
phi_1 = 0.5, phi_2 = -0.7: Il secondo lag contrasta il primo e la serie sale e scende a onde che si ripetono circa ogni cinque passi
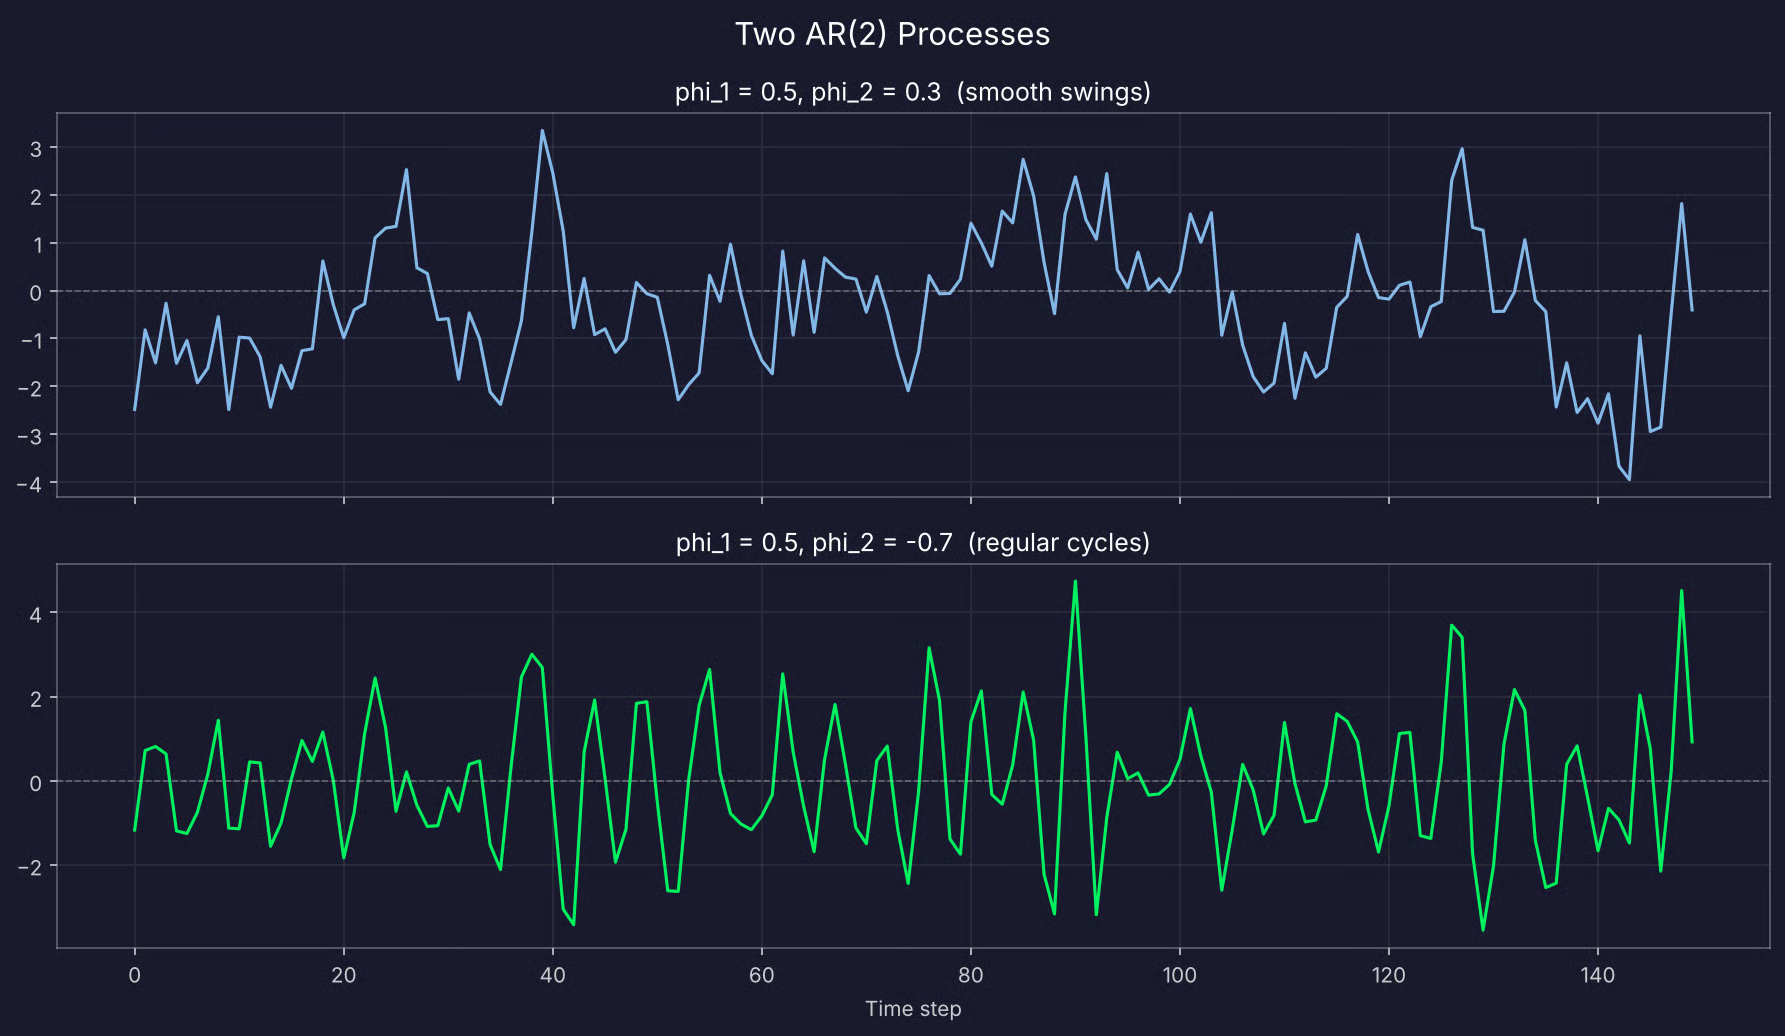
Due serie AR(2) simulate
AR(3), AR(4) e oltre aggiungono un lag alla volta. Servono quando i valori più indietro contengono informazioni che quelli recenti non hanno.
Mettiamo che tu modelli vendite mensili e che lo stesso mese dell’anno scorso predica bene questo mese. Un modello AR(12) include quel lag di 12 mesi, oltre agli 11 lag intermedi.
Ogni lag extra aggiunge un coefficiente da stimare. Questo significa che servono più dati e aumenta il rischio di overfitting. Inoltre i coefficienti diventano più difficili da interpretare: con 12 non puoi guardare i numeri e capire cosa farà la serie. In quel caso si guardano le radici.
Ti mostrerò come scegliere l’ordine giusto con PACF e AIC nella sezione Python.
I modelli AR compaiono ovunque i dati siano memorizzati in ordine e il passato recente dica qualcosa sul prossimo futuro.
La maggior parte degli usi rientra in quattro gruppi:
L’ultimo punto sorprende molti, perché il termine dietro ai chatbot di oggi viene dalla stessa statistica di cui stai leggendo qui.
In questa sezione adatterò un modello autoregressivo in Python con statsmodels, dai dati grezzi a una previsione che puoi valutare.
Ti servono pandas e NumPy per i dati, statsmodels per il modello e i test, e scikit-learn per la metrica di errore:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorSimulerò due anni di domanda giornaliera di elettricità da un processo AR(2).
Ho deciso di usare dati simulati perché conosci i veri coefficienti in partenza. In questo modo puoi verificare se il modello li ritrova e se gli strumenti di selezione dei lag puntano all’ordine giusto.
Il processo ha c = 15, phi_1 = 0.6 e phi_2 = 0.25, che pone la media di lungo periodo a 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()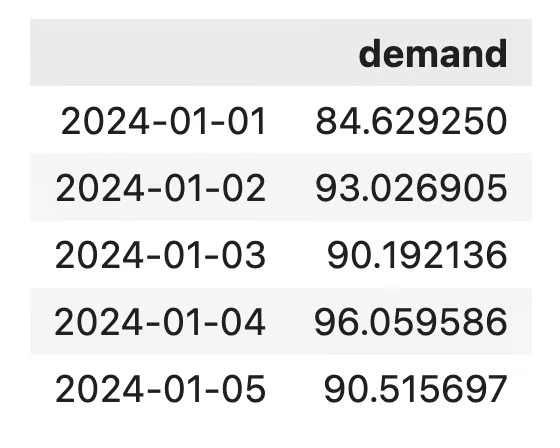
Il dataset della domanda giornaliera di elettricità
I primi 100 giorni simulati sono rimossi perché quel periodo di burn-in dà alla serie il tempo di assestarsi nel suo comportamento normale prima di usarla.
Ecco come appare la serie completa:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()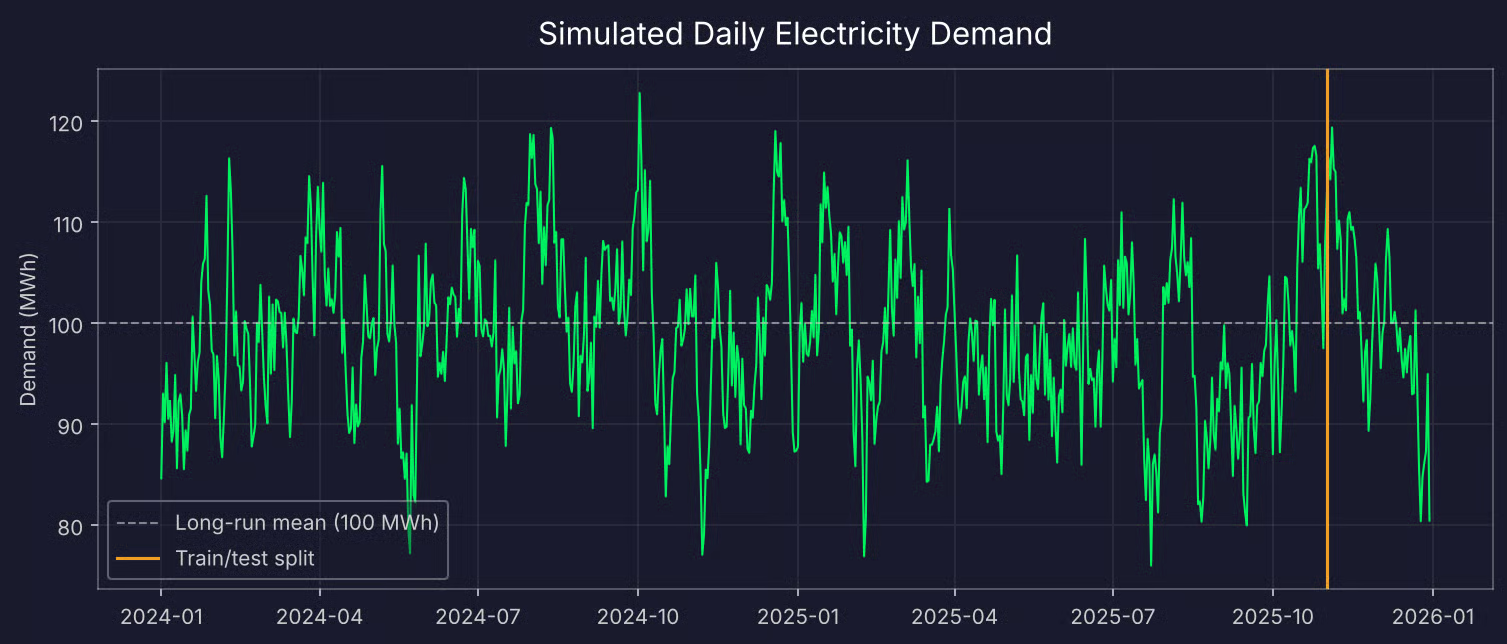
Due anni di domanda giornaliera simulata di elettricità
La serie oscilla attorno a 100 senza trend, che è come dovrebbe apparire una serie stazionaria. Ma un controllo visivo non è una prova.
Il test di Dickey-Fuller aumentato (ADF) controlla se una serie è stazionaria. La sua ipotesi nulla è che la serie non sia stazionaria, quindi un p-value piccolo è ciò che vuoi:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")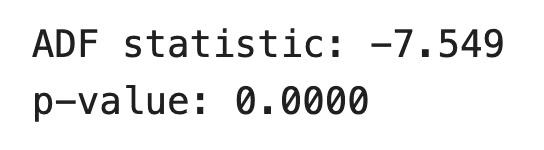
Risultati del test ADF
Il p-value è ben al di sotto di 0,05, quindi puoi rifiutare l’ipotesi nulla e trattare la serie come stazionaria.
Se i tuoi dati non superano questo test, differenziali con df["demand"].diff().dropna() ed esegui di nuovo il test.
I dati di serie temporali non possono essere mescolati, quindi il set di test deve provenire dalla fine della serie. Terrò gli ultimi 60 giorni per il test:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Restano 670 giorni per il training e 60 per il test.
Questo è il passaggio che determina quanto bene funzionerà il modello. Se scegli troppo pochi lag, il modello perde schemi nei dati. Ma se ne scegli troppi, adatta il rumore nei dati di training che non si ripeterà in futuro.
Hai due strumenti per farlo.
Il primo è la funzione di autocorrelazione parziale (PACF). Mostra la correlazione tra la serie e ciascun lag dopo aver rimosso l’effetto di tutti i lag più brevi. Per un processo AR(p), la PACF ha picchi significativi fino al lag p e scende intorno a zero dopo:
plot_pacf(train, lags=20, method="ywm")
plt.show()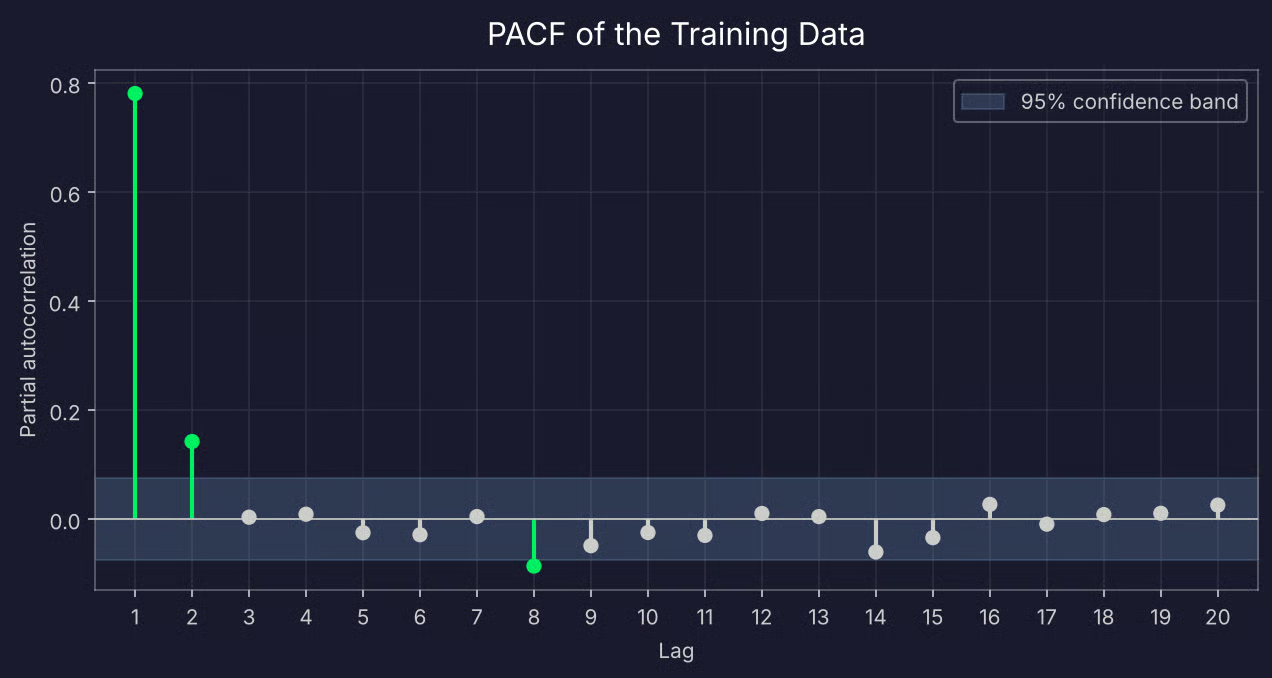
PACF dei dati di training
I lag 1 e 2 sono ben fuori dalla banda di confidenza e il lag 3 scende vicino a zero. Questo indica AR(2).
C’è anche un piccolo picco al lag 8, appena oltre il bordo della banda. Non dargli troppo peso. La banda è tracciata al 95% di confidenza, quindi con 20 lag è normale che circa uno la superi per caso.
Il secondo strumento sono i criteri informativi. AIC e BIC premiano un modello per come adatta i dati e lo penalizzano per ogni parametro extra. BIC applica la penalizzazione maggiore, quindi tende a scegliere modelli più piccoli. statsmodels può testare ogni ordine fino a un massimo e restituire il migliore:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")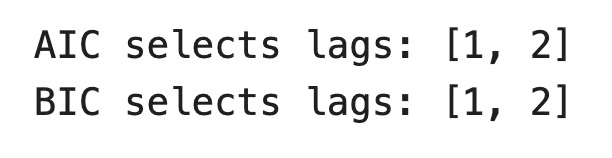
Selezione dei lag con AIC/BIC
Entrambi i criteri concordano con la PACF. In pratica, spesso vedrai l’AIC scegliere un modello leggermente più grande del BIC. Se succede, parti da quello più piccolo.
Scelto l’ordine, adattare il modello richiede due righe di codice:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")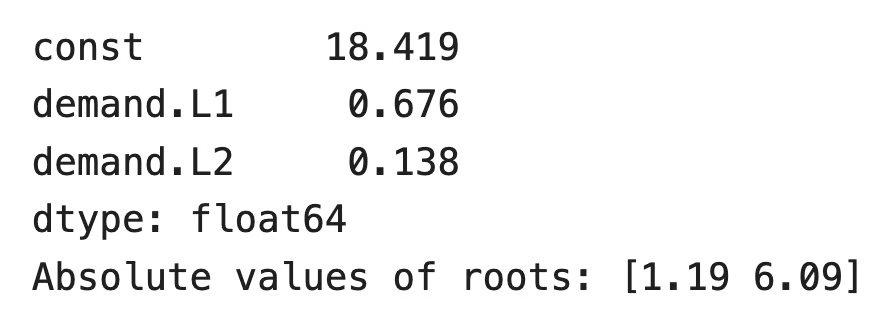
Parametri del modello AR(2)
I valori veri sono 0,6 e 0,25. Il modello dà un po’ più peso al primo lag e meno al secondo, ma la somma dei due coefficienti è vicina: 0,81 contro 0,85. Con 670 punti dati, non recupererai i valori esatti.
Entrambe le radici hanno modulo maggiore di 1, quindi il modello adattato è stazionario. Puoi chiamare results.summary() se vuoi errori standard, p-value e la tabella completa delle radici.
Ci sono due modi per prevedere il periodo di test e rispondono a domande diverse:
Le previsioni multi-step derivano direttamente dai risultati adattati. Per le previsioni one-step, applichi i coefficienti addestrati all’intera serie:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")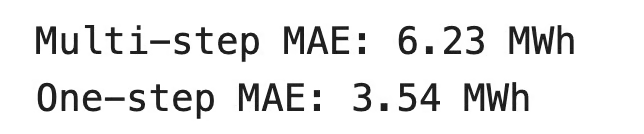
Risultati delle previsioni
La mean absolute error (MAE) è la differenza assoluta media tra le previsioni e i valori reali. È nella stessa unità dei dati, quindi si legge direttamente. La previsione one-step sbaglia in media di 3,54 MWh.
Ecco come entrambe le previsioni si confrontano con i valori reali:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()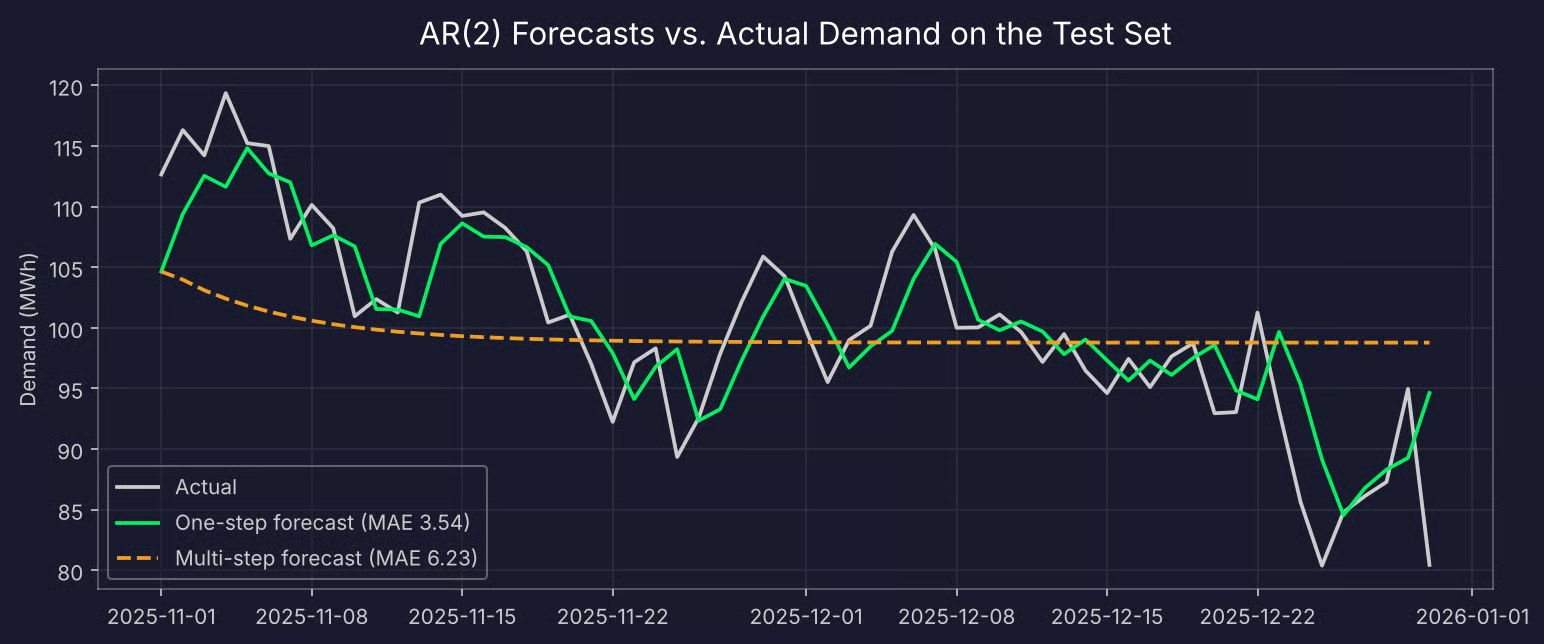
Previsioni AR(2) one-step e multi-step confrontate con la domanda reale
La previsione one-step segue da vicino i valori reali, con circa un giorno di ritardo. La previsione multi-step parte dall’ultimo valore noto e poi si appiattisce vicino alla media in circa tre settimane.
Questo è il comportamento di ogni modello AR stazionario: più lontano prevedi, meno il passato ti dice, e la stima migliore diventa la media di lungo periodo. Ecco perché i modelli AR funzionano meglio per previsioni di breve termine.
È facile supporre che più storico significhi previsioni migliori. Verifichiamolo adattando modelli con un numero crescente di lag e confrontando il loro MAE one-step:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")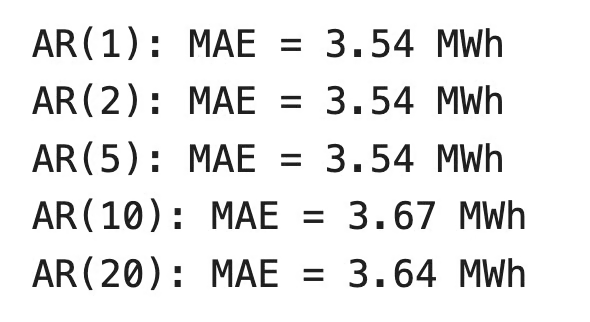
MAE con più lag
L’errore non migliora oltre AR(2) e peggiora con AR(10) e AR(20). Quei coefficienti extra adattano il rumore nei dati di training.
Noterai anche che AR(1) qui fa bene quanto AR(2). Il secondo coefficiente stimato è piccolo, quindi aggiunge poco su questo set di test. Quando due modelli performano allo stesso modo, quello più semplice è più facile da spiegare e meno incline a rompersi su nuovi dati.
C’è anche un costo: AR(20) stima 21 parametri invece di 3.
In sintesi, lascia che PACF e i criteri informativi suggeriscano l’ordine e poi confermalo su un set di test.
I modelli AR sono adatti a molti problemi di forecasting, ma non a tutti. Ecco dove funzionano e dove no, e come si confrontano con i modelli costruiti su di essi.
I modelli AR hanno due principali vantaggi:
Hanno anche due limiti principali:
C’è un altro problema. I valori ritardati sono correlati tra loro perché provengono dalla stessa serie. Nei dati di domanda, la correlazione tra y_t-1 e y_t-2 è 0,78.
Questo sis chiama multicollinearità, e influenza qualsiasi modello di regressione. Quando due predittori si muovono insieme, il modello fa fatica a capire quale sia il responsabile. I coefficienti diventano meno stabili e i loro errori standard aumentano.
Spiega ciò che hai visto prima. Il modello ha stimato 0,676 e 0,138 invece di 0,6 e 0,25: ha spostato peso da un lag all’altro, ma la somma è rimasta vicina. Le previsioni non ne risentono molto, ma non puoi fidarti troppo dei singoli coefficienti. Ogni lag extra peggiora il problema.
AR è uno dei tre mattoni della previsione classica di serie temporali. Gli altri due sono i modelli a media mobile (MA) e ARIMA, che li combina.
Un modello AR prevede a partire dai valori passati. Un modello MA prevede a partire dagli errori passati:
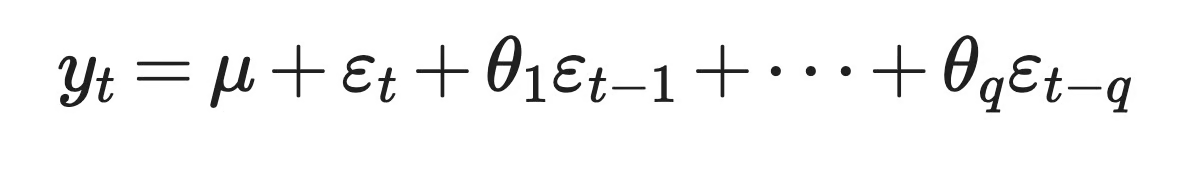
Modello ARMA
Qui, mu è la media della serie, theta_1 a theta_q sono i coefficienti e epsilon_t-1 a epsilon_t-q sono gli shock casuali dei passi precedenti. Non confonderlo con una media mobile nel senso della media scorrevole. Il nome è lo stesso, ma il modello è diverso.
I due modelli reagiscono in modo diverso agli shock. In un modello MA(q), uno shock influenza la serie per esattamente q passi. In un modello AR, uno shock svanisce nel tempo ma non scende mai del tutto a zero. Questa differenza è anche il motivo per cui usi strumenti diversi per scegliere l’ordine: la PACF si tronca dopo il lag p per i modelli AR, e l’ACF si tronca dopo il lag q per i modelli MA.
ARIMA mette tutto insieme. ARIMA(p, d, q) ha tre parti:
Questo significa che AR è un caso particolare di ARIMA. Se imposti d e q a zero, ottieni un modello AR. Puoi verificarlo con i dati di domanda:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))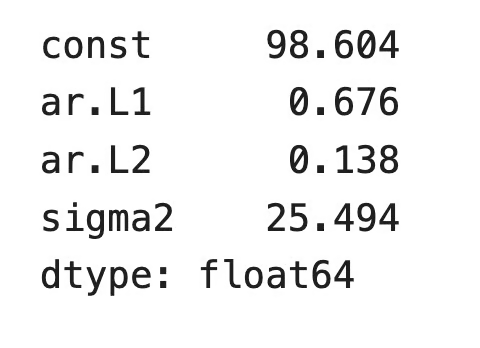
Modello ARIMA con ordine di integrazione e media mobile pari a 0
I coefficienti AR coincidono con quelli di AutoReg. La costante è diversa perché ARIMA riporta la media della serie, mentre AutoReg riporta l’intercetta c.
Ora vediamo dove ARIMA va oltre. Supponiamo che la città cresca e la domanda di elettricità aumenti un po’ ogni giorno. La serie ora ha un trend, quindi il test ADF fallisce e un modello AR non può più lavorare direttamente con la serie.
Ma un modello ARIMA(2, 1, 0) può. Differenzia la serie una volta, quindi il modello lavora con i cambiamenti giornalieri della domanda invece che con i valori grezzi, e poi adatta AR(2) su quei cambiamenti. Se uno shock come un’ondata di caldo influisce anche sulla domanda del giorno successivo, puoi aggiungere un termine MA e ottenere ARIMA(2, 1, 1).
La parte AR fa lo stesso lavoro in ogni caso. ARIMA si occupa solo di preparare i dati e di modellare ciò che resta. Se vuoi approfondire, il corso ARIMA Models in R copre l’intero processo.
Un modello autoregressivo prevede il valore successivo di una serie a partire dal suo passato. È una regressione lineare in cui i predittori sono copie ritardate del target, e questo lo rende uno dei modelli di serie temporali più facili da capire.
Lo vedrai in economia, nei codec vocali, nell’analisi EEG e persino nel nome dei modelli linguistici di oggi. Hai anche visto dove non è l’opzione migliore, perché richiede dati stazionari, dipende dal giusto ordine dei lag e lag correlati rendono meno affidabili i singoli coefficienti.
Se capisci i modelli AR, il resto della previsione classica diventa molto più semplice. ARIMA è il passo successivo naturale e il nostro tutorial su ARIMA ti mostra come la differenziazione e i termini MA estendono ciò che hai imparato qui. Per un percorso pratico, prova il corso ARIMA Models in Python.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



