课程
Python 中的时间序列分析
4 小时
70.9K
网上的大多数内容一上来就讲 ARIMA,至多用一句话交代 AR 的部分。但 AR 是整个模型的基石。如果您没弄明白它,ARIMA 的其余部分也很难讲得通。
通俗地说,自回归模型用时间序列自身的历史值来预测未来值。您会在经济学、金融、信号处理和气候数据中见到它。本质上它就是一个回归模型,因此能把您对回归的既有理解连接到时间序列预测,也是ARIMA 建立的基础。
本文将带您了解自回归模型的工作原理、如何在 Python 中用 statsmodels 拟合模型,以及如何选择合适的滞后阶数。
自回归模型通过以往数值的加权和来预测时间序列的下一个值。
名称中的 "auto" 表示“自身”,"regression" 表示用其他变量预测一个变量。所以自回归模型就是把序列回归到它自己的过去。
假设您要预测明天的用电需求。今天的需求是一个不错的起点,昨天的需求又能补充一些信息。自回归模型把这种直觉写成公式,并从数据中学习这些权重。
AR 模型写作 AR(p),其中 p 是模型的阶数。阶数表示模型使用多少个过去的值:
p 个值更高的阶数并不自动意味着更好的模型。本文后面会介绍如何选择 p。
AR(p) 模型的一般形式如下:
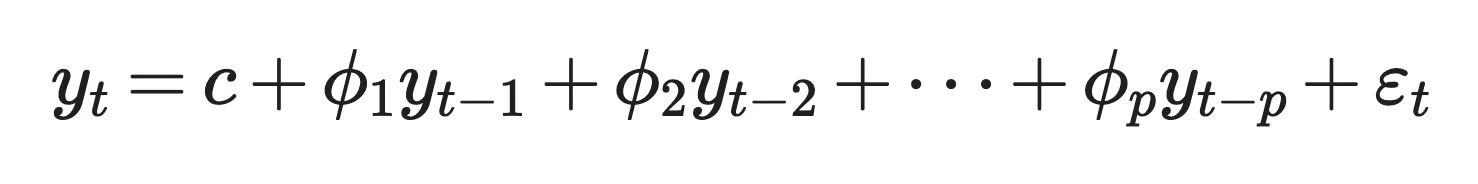
AR(p) 模型的一般形式
各个项的含义如下:
y_t: 时刻 t 的序列值,也就是您要预测的值
c: 常数项,与系数一起决定序列的长期均值
phi_1 到 phi_p: 系数,表示各个过去值对预测的贡献程度
y_t-1 到 y_t-p: 滞后值,其中“滞后”表示向前回看多少步
epsilon_t: 白噪声,即均值为 0、方差恒定且时间上不相关的随机误差
简单来说,模型将最近的 p 个值分别乘以其权重后再加上常数。剩下解释不了的部分就是噪声,也就是过去无法解释的 y_t 的那一部分。
AR(1) 是最简单的版本:
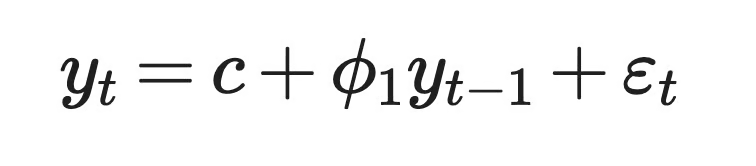
AR(1) 模型
系数 phi_1 的取值决定了“今天”对“明天”的影响程度。
例如,c = 2 且 phi_1 = 0.8。如果今天的值是 15,模型预测明天为 2 + 0.8 × 15 = 14。下一次预测为 2 + 0.8 × 14 = 13.2。每一步都把序列拉向 10,即长期均值 c / (1 - phi_1)。
如果 phi_1 为负,序列会在均值之上和之下跳跃前进。
AR(2) 则加入第二个滞后项:
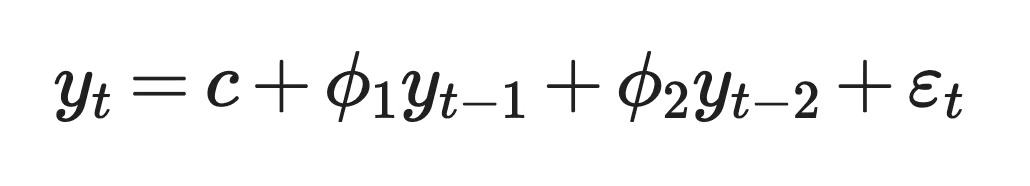
AR(2) 模型
有两个滞后项后,模型能描述 AR(1) 无法捕捉的模式,例如周期。比如 phi_1 为正而 phi_2 为负时,序列会呈现类似商业周期的波动起伏。
因此,每个 AR 模型都归结为两个选择——用多少个滞后,给它们多大的权重。
AR 模型只有在您的数据满足两个条件时才有效。过去的值必须与未来的值相关,且序列随时间表现应保持一致。前者称为自相关,后者称为平稳性。
自相关是时间序列与其滞后副本之间的相关性。
这正是 AR 模型存在的原因。如果今天的数值对明天毫无启示,模型就无从从历史值中学习。
在代码中,您取一列数值,复制一份,并将副本向下移动一行。这样每一行就把一个值与它的前一个值配对。两列之间的相关性就是一阶滞后自相关。向下移动两行则得到二阶滞后自相关。
在 pandas 中看起来是这样:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))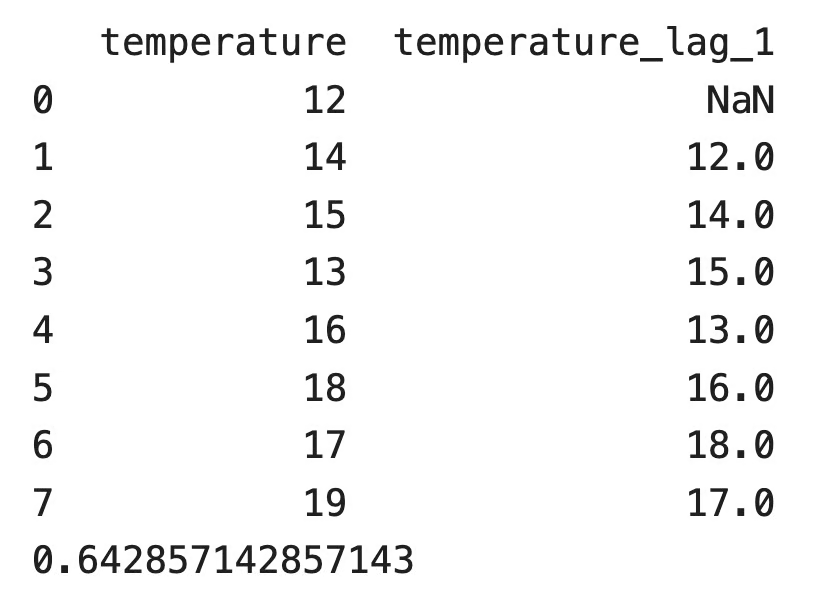
包含温度列及其一阶滞后副本的 DataFrame
滞后列的第一行为空,因为在第一条记录之前没有读数。pandas 会跳过该行,并返回 0.643 的一阶滞后自相关。在该序列中,暖和的日子往往接着暖和的日子。
自相关的正负会改变序列的行为方式:
自相关接近零意味着历史并无帮助。在这种情况下,AR 模型的效果不会比预测平均值好太多。
AR 模型需要平稳的时间序列。
平稳序列在任何片段上,都具有相同的均值、相同的方差,以及在给定滞后下相同的自相关。统计学上称为弱平稳(弱意义平稳)。
这点很重要,因为模型会估计一组固定系数。如果序列的均值随时间漂移,用旧数据学到的系数将无法描述新数据。股票价格是非平稳序列的常见例子,因为它们多年间呈趋势性变化。日收益率则更接近平稳。
系数本身决定了 AR 过程是否平稳。对 AR(1) 而言,规则很简单:phi_1 必须在 -1 与 1 之间。
abs(phi_1) < 1: 冲击会随时间衰减,序列回到其均值
phi_1 = 1: 序列成为随机游走,冲击永不衰减
abs(phi_1) > 1: 每次冲击都会放大,序列发散
AR(2) 同时需要三个条件:phi_1 + phi_2 < 1、phi_2 - phi_1 < 1,以及 abs(phi_2) < 1。
超过两个滞后后,需要一个通用规则。每个 AR(p) 模型都有一个特征多项式:
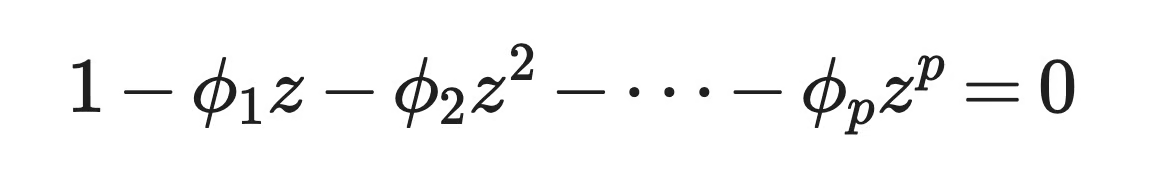
特征多项式
当该多项式的所有根都在单位圆之外时,该过程是弱平稳的,这意味着每个根 z 的绝对值大于 1。根可以是复数,这也是为什么边界是在复平面上的一个圆而不是一条直线。
您可以用 AR(1) 来检验。多项式是 1 - phi_1 z = 0,因此根为 z = 1 / phi_1。只有当 abs(phi_1) < 1 时该根才在单位圆之外,这与前面的规则一致。
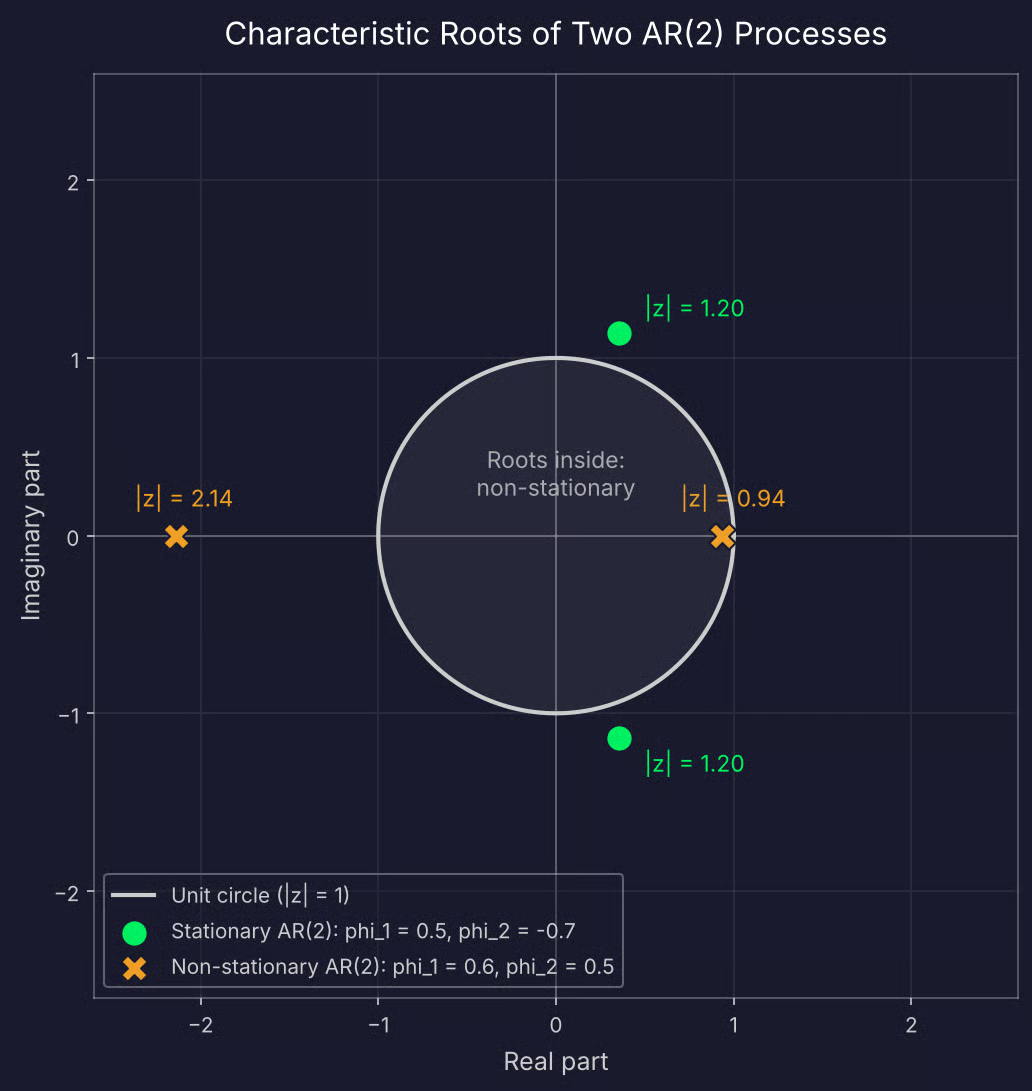
平稳与非平稳 AR(2) 过程的根
您不需要手算这些根。statsmodels 会在拟合模型后返回它们,我也会在 Python 部分演示如何检验数据本身的平稳性。
如果您的序列不平稳,可以进行差分——用后一项减去前一项——并对差分序列建模。这就是ARIMA 模型中“I”的含义。
所有 AR 模型方程相同。不同类型之间变化的是阶数 p,即模型使用多少个过去的值。
AR(1) 仅使用前一个值来预测下一个值。
如果这听起来像线性回归,那是因为本质确实如此。把 y_t-1 放在 x 轴、y_t 放在 y 轴,AR(1) 就是在这些点上拟合一条直线。常数 c 是截距,phi_1 是斜率。如果您了解简单线性回归,您已经知道 AR(1) 如何估计了。
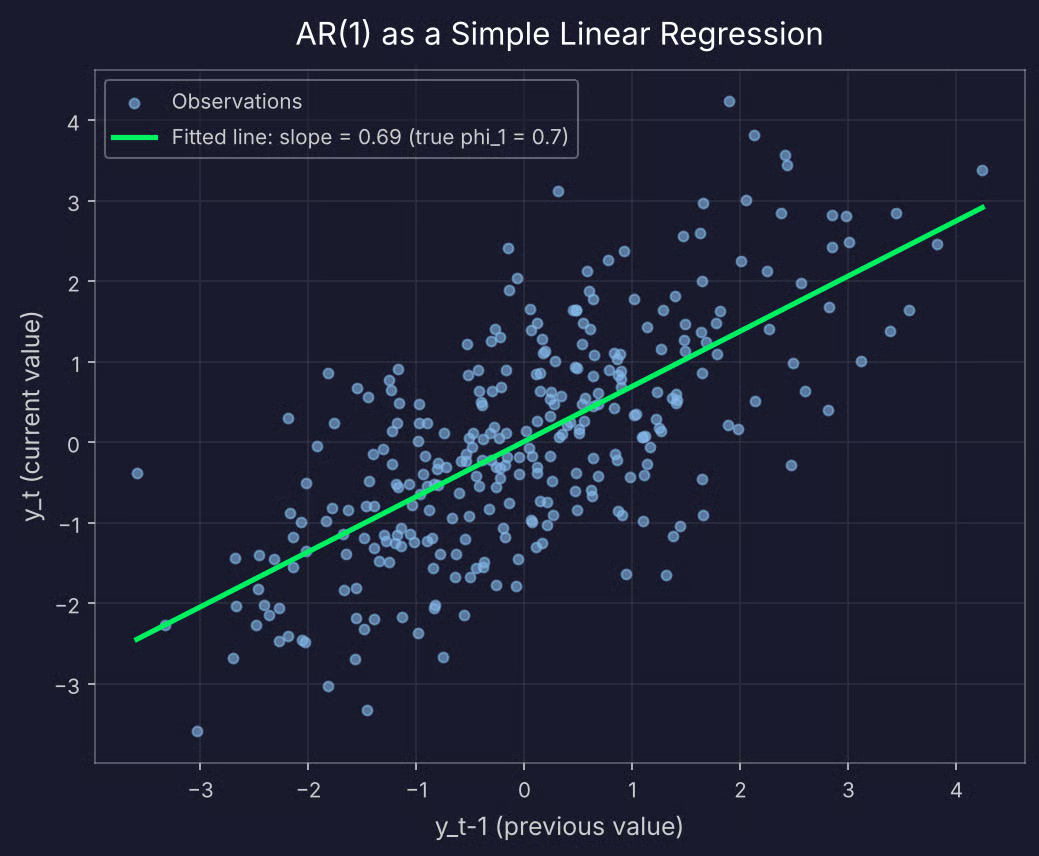
AR(1) 的 y_t 对 y_t-1 散点图
但有一个不同点。在标准回归中,特征与目标是不同的变量;而在 AR(1) 中,特征是同一个序列向后移一位。因此不能打乱行顺序或随机划分训练/测试集——数据的顺序本身就是模型的一部分。
phi_1 的取值会改变序列的外观:
phi_1 = 0.3: 序列几乎像随机噪声,因为每个值对下一个值的信息量很小
phi_1 = 0.9: 序列呈现长而平滑的摆动,回归均值需要更久
phi_1 = -0.8: 序列几乎每一步都在均值上下交替锯齿形波动
phi_1 = 1: 序列成为随机游走并漂移,没有可回归的均值,即上一节所述的非平稳情形
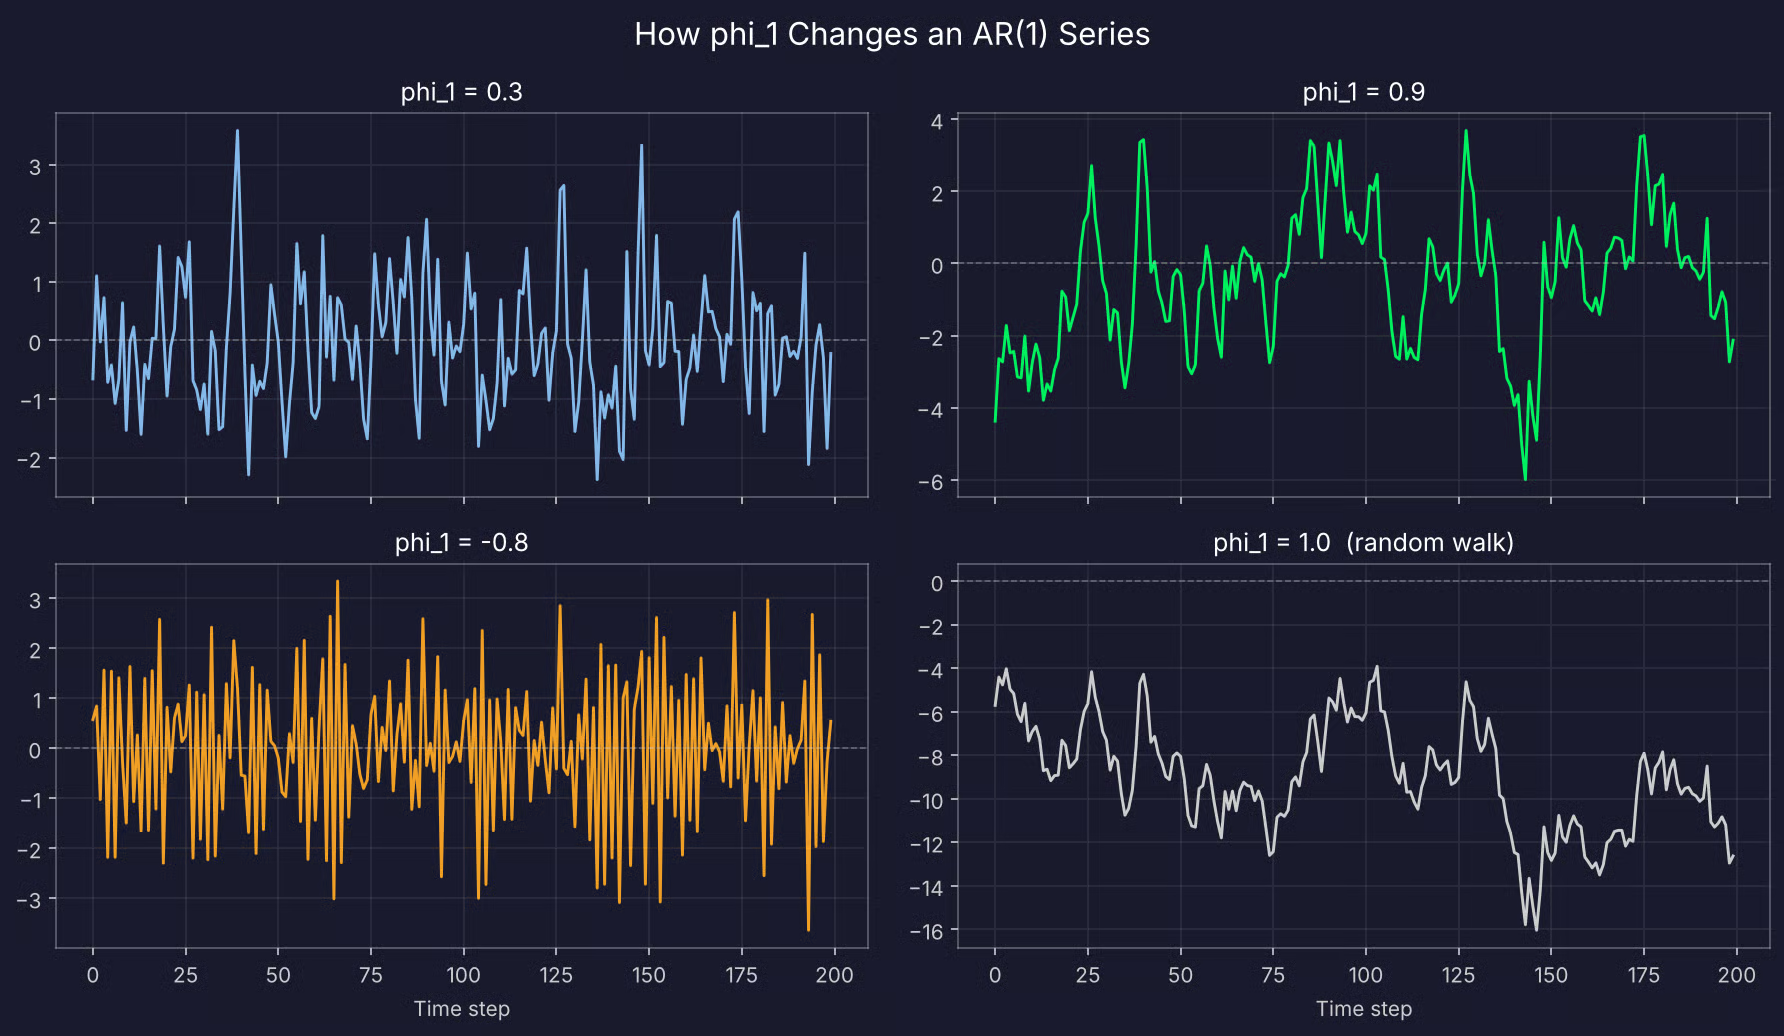
四组模拟的 AR(1) 序列
phi_1 越接近 1 或 -1,单次冲击对序列的影响持续越久。
AR(2) 使用前两个值。第二个滞后项让模型能产生 AR(1) 无法产生的模式,尤其是周期。
下面是两组系数的对比:
phi_1 = 0.5,phi_2 = 0.3: 两个滞后同向推动,序列看起来像滞后更长、更平滑的 AR(1)
phi_1 = 0.5,phi_2 = -0.7: 第二个滞后与第一个对抗,序列呈现大约每五步重复一次的波浪式起伏
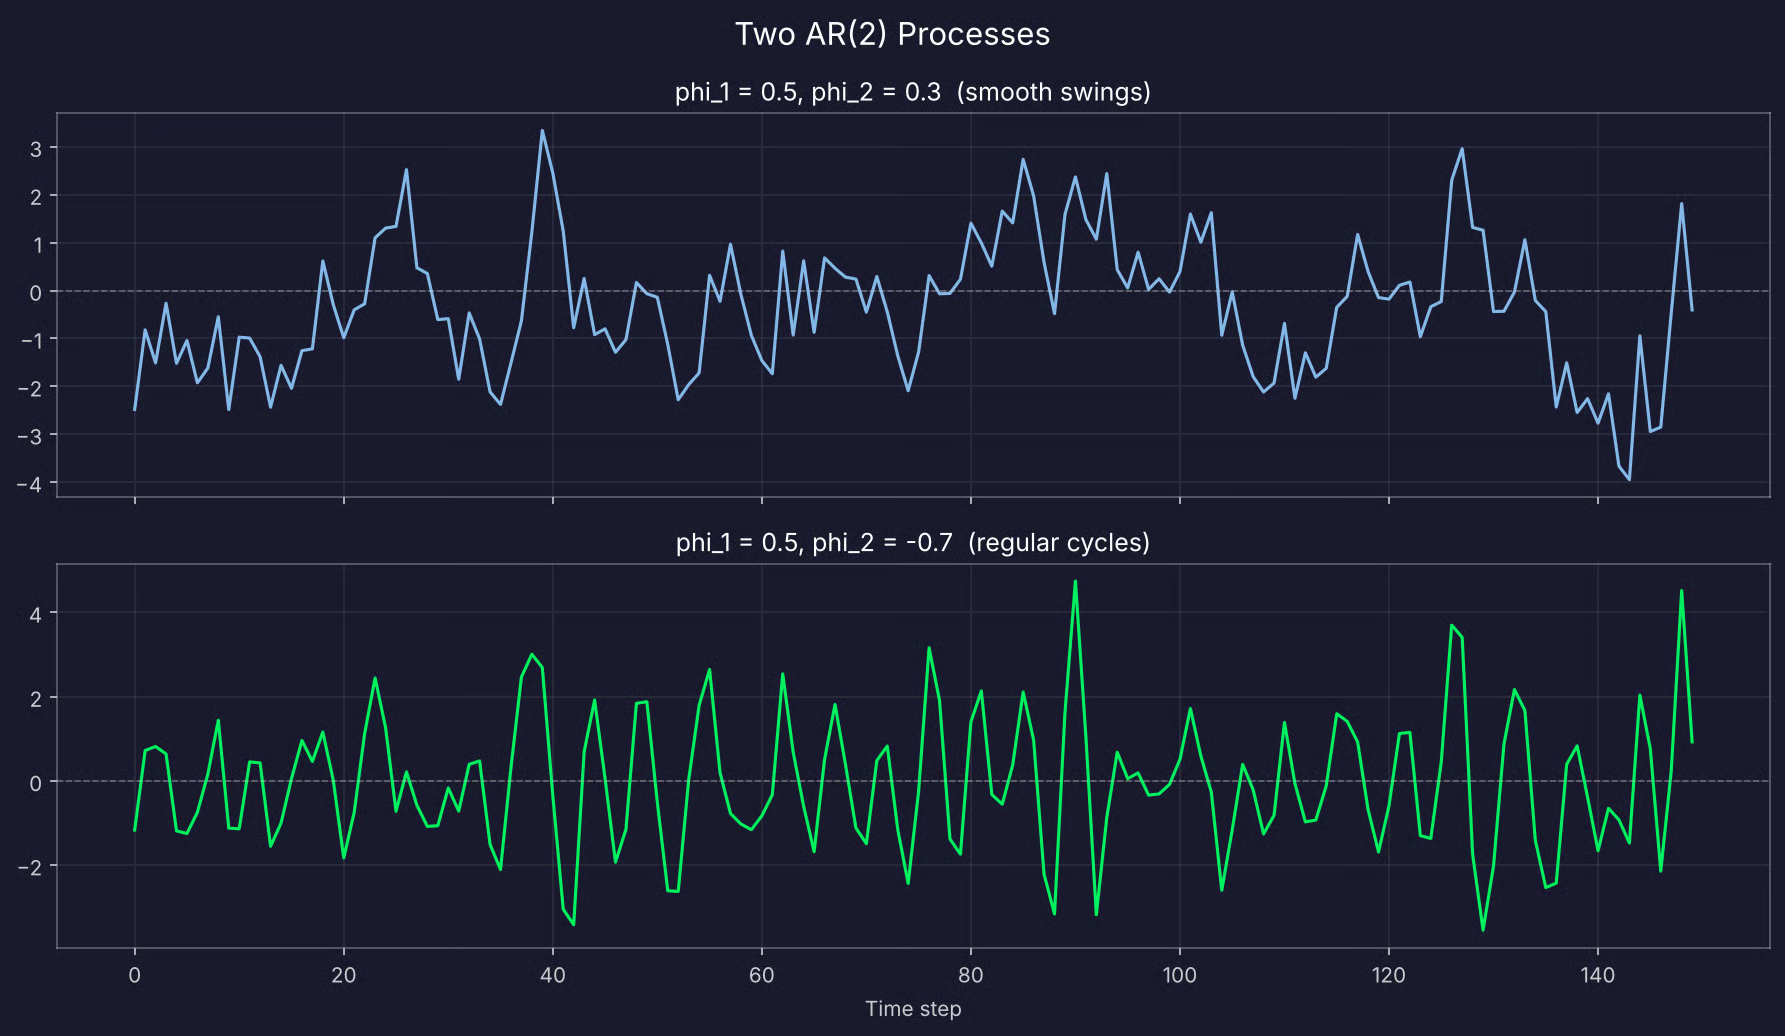
两组模拟的 AR(2) 序列
AR(3)、AR(4) 等依次每次增加一个滞后项。当更早期的数值携带了近期未包含的信息时需要它们。
比如您建模月度销量,去年的同月能很好预测本月。AR(12) 模型会包含 12 期滞后,以及中间 11 个滞后。
每增加一个滞后,都会多一个待估计的系数。这意味着需要更多数据,且过拟合风险上升。系数也更难解读——多达 12 个时,您很难凭数字判断序列会怎么走。这时应查看特征根。
在 Python 部分我会用 PACF 和 AIC 演示如何选择合适的阶数。
凡是数据按顺序存储且近期历史对不远的未来有启示的场景,都会出现 AR 模型。
大多数用途可归为四类:
最后一类常让人惊讶,因为当下聊天机器人背后的术语正源自您此刻读到的统计学。
本节将用 Python 的 statsmodels 从原始数据开始拟合自回归模型,直到得到可评估的预测。
数据处理用 pandas 和 NumPy,建模与检验用 statsmodels,误差度量用 scikit-learn:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_error我们将从 AR(2) 过程中模拟两年的每日用电需求。
选择模拟数据是因为您一开始就知道真实系数。这样就能检验模型是否找到了它们,以及滞后选择工具是否指向了正确的阶数。
该过程的 c = 15、phi_1 = 0.6、phi_2 = 0.25,长期均值为 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()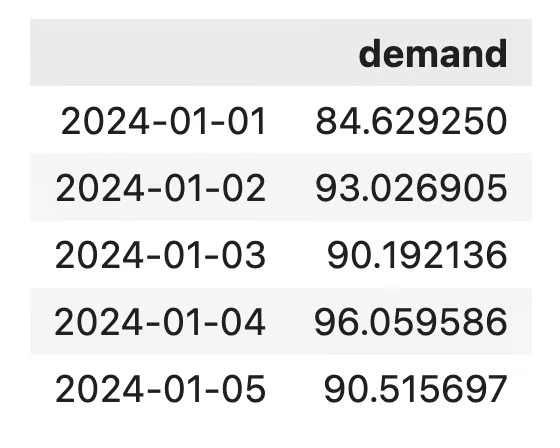
每日用电需求数据集
前 100 天的模拟数据被移除,是因为预热期能让序列在开始使用前先进入正常行为模式。
以下是完整序列的样子:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()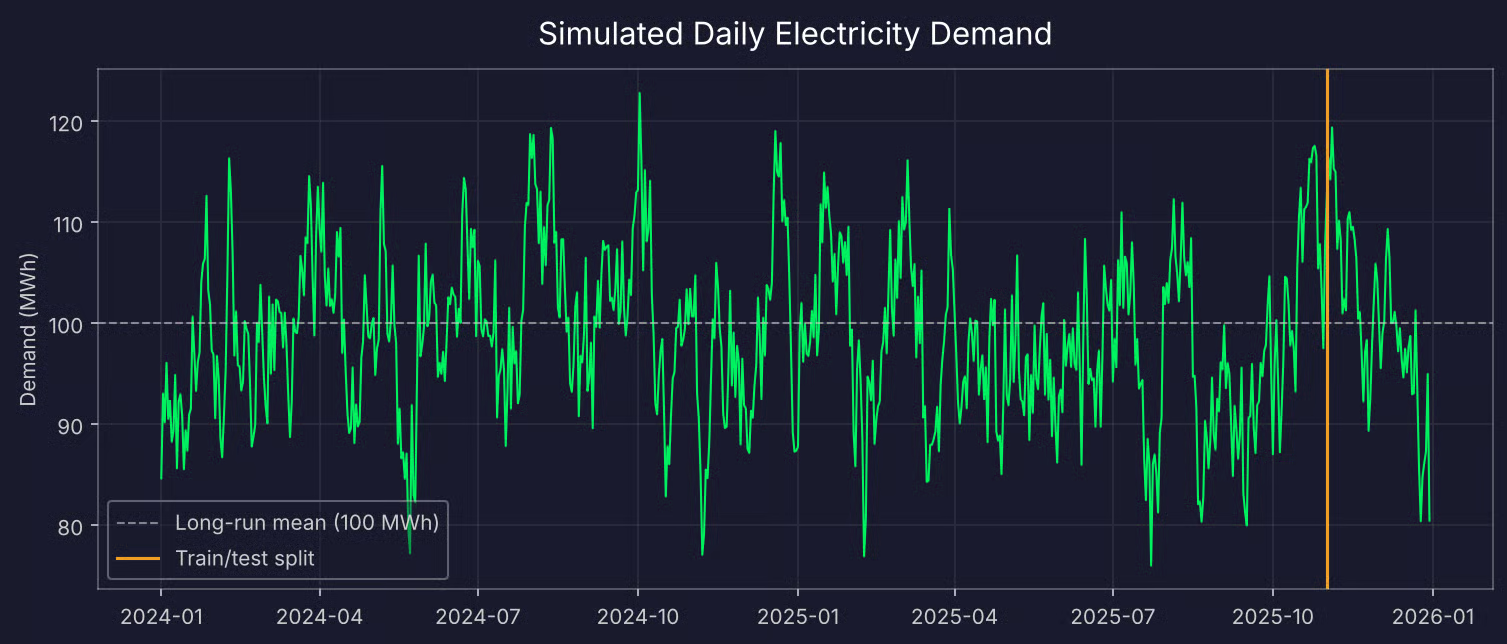
两年模拟的每日用电需求
序列在 100 附近上下波动,没有趋势,这正是平稳序列应有的样子。但目测并非证据。
增广迪基-福勒(ADF)检验用于判断序列是否平稳。其原假设为序列不平稳,因此较小的 p 值才是您想要的:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")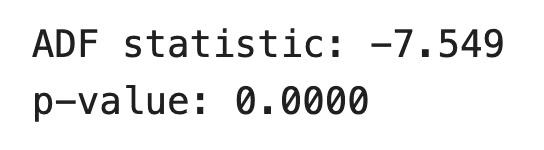
ADF 检验结果
p 值远低于 0.05,因此可以拒绝原假设,将该序列视为平稳。
如果您的数据未通过检验,可用 df["demand"].diff().dropna() 做一次差分,然后再做检验。
时间序列数据不能打乱,因此测试集必须来自序列末尾。这里将最后 60 天留作测试:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
这样训练集为 670 天,测试集为 60 天。
这是决定模型效果的关键一步。滞后太少会漏掉数据中的模式,滞后太多又会拟合训练数据中的噪声,导致未来无法复现。
您可以用两个工具。
第一个是偏自相关函数(PACF)。它展示了在剔除所有更短滞后影响后,序列与各个滞后的相关性。对于 AR(p) 过程,PACF 会在滞后 p 以内有显著尖峰,之后降至接近零:
plot_pacf(train, lags=20, method="ywm")
plt.show()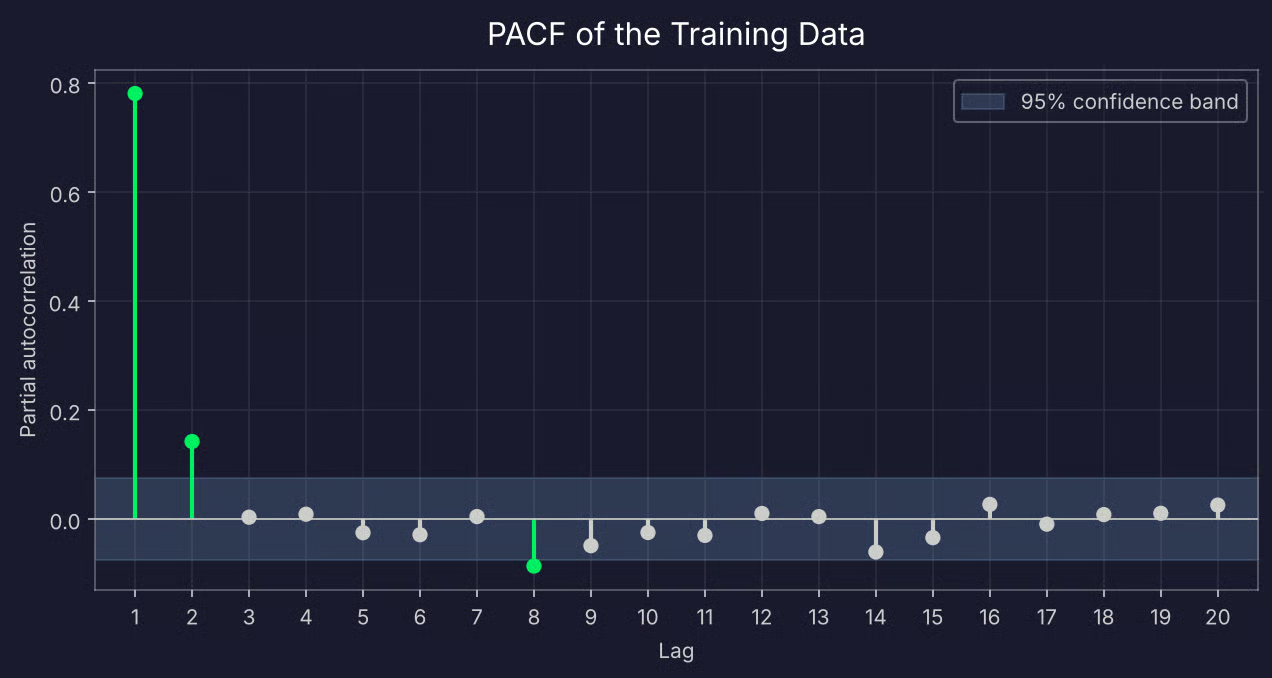
训练数据的 PACF
滞后 1 和 2 明显超出置信带,滞后 3 降至接近零,指向 AR(2)。
滞后 8 也有一个小尖峰,刚好越过置信带边缘。别过度解读。置信带按 95% 置信绘制,因此在 20 个滞后里,约有一个越界是偶然现象。
第二个工具是信息准则。AIC 和 BIC 都会奖励模型拟合得好,并对每个额外参数进行惩罚。BIC 的惩罚更大,因此倾向于选择更小的模型。statsmodels 能在给定最大阶数内逐一测试并返回最优阶数:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")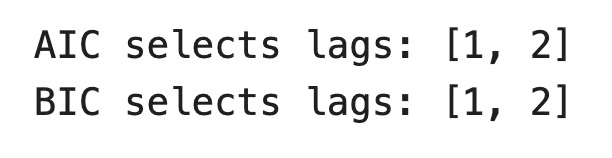
AIC/BIC 的滞后选择
两个准则与 PACF 给出的结论一致。实践中常见 AIC 选择比 BIC 略大的模型。如果发生这种情况,从较小的那个开始。
确定阶数后,拟合模型只需两行代码:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")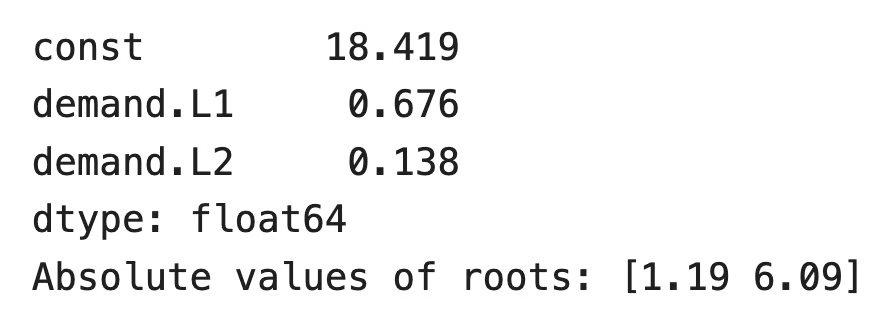
AR(2) 模型参数
真实值为 0.6 和 0.25。模型对第一个滞后赋予了更多权重、对第二个更少,但两者之和很接近——0.81 对 0.85。用 670 个数据点很难精确恢复真实值。
两个根的模都大于 1,因此拟合的模型是平稳的。如果需要标准误、p 值和完整根表,可调用 results.summary()。
预测测试期有两种方式,它们回答不同的问题:
多步预测可直接从拟合结果得到。对一步预测,您将训练得到的系数应用到完整序列:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")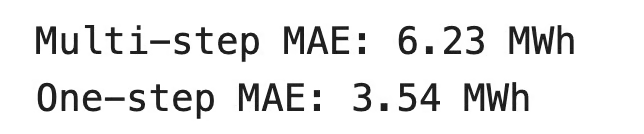
预测结果
平均绝对误差(MAE)是预测值与真实值的平均绝对差。它与数据单位相同,便于直接解读。一步预测平均相差 3.54 MWh。
以下展示两种预测与真实值的对比:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()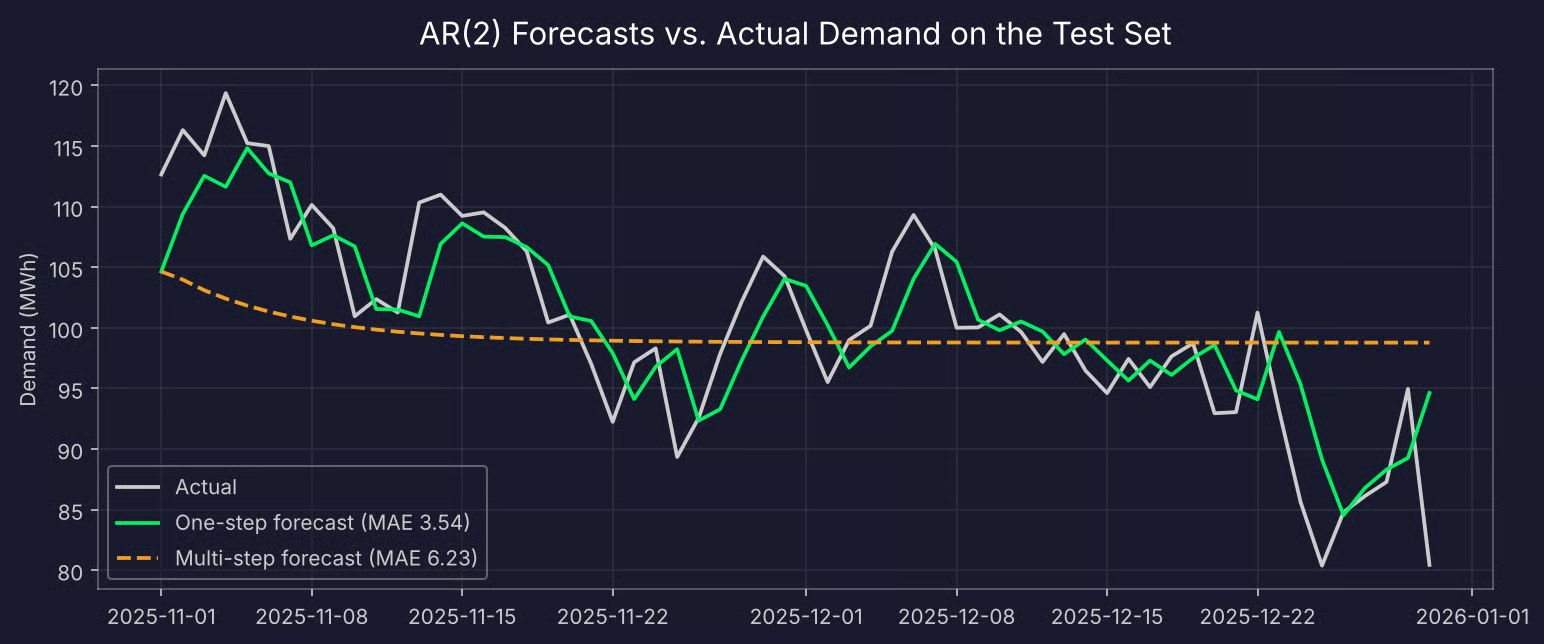
一步与多步 AR(2) 预测对比真实需求
一步预测紧跟真实值,基本滞后一日。多步预测从最后一个已知值出发,约三周内逐渐趋近平均值。
每个平稳 AR 模型都是如此——预测步数越远,历史能提供的信息越少,最佳猜测就越接近长期均值。这也是 AR 模型更适合短期预测的原因。
我们很容易想当然地认为,历史越多预测越好。下面通过逐步增加滞后数拟合模型,并比较它们的一步 MAE 来验证这一点:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")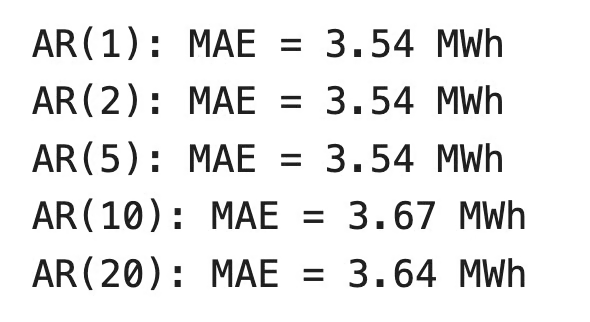
更多滞后下的 MAE
误差并未优于 AR(2),在 AR(10) 和 AR(20) 下还更糟。这些额外系数在训练数据中拟合了噪声。
您也会注意到此处 AR(1) 与 AR(2) 表现相当。估计得到的第二个系数很小,因此在此测试集上贡献不大。当两个模型表现相同,较简单者更易解释,也更不容易在新数据上失效。
成本方面也有差异。AR(20) 需要估计 21 个参数,而不是 3 个。
总之,让 PACF 和信息准则给出阶数建议,然后在测试集上加以确认即可。
AR 模型适合许多预测问题,但并非万能。下面介绍它的适用与不适用之处,以及与在其基础上构建的模型的比较。
AR 模型有两大优势:
它也有两大局限:
还有一个问题。滞后值彼此相关,因为它们都来自同一序列。在需求数据中,y_t-1 与 y_t-2 的相关系数为 0.78。
这被称为多重共线性,它会影响任何回归模型。当两个特征一起变化,模型难以判断究竟是谁在起作用。系数会不够稳定,标准误会上升。
这解释了先前看到的现象。模型估计出 0.676 和 0.138,而不是真实的 0.6 和 0.25——它把权重从一个滞后挪到了另一个,但总和接近。预测本身受影响不大,但单个系数的可信度降低。每多一个滞后,问题就更严重。
AR 是经典时间序列预测的三大基石之一,另外两个是移动平均(MA)模型和将二者结合的 ARIMA。
AR 模型用过去的值做预测,MA 模型用过去的误差做预测:
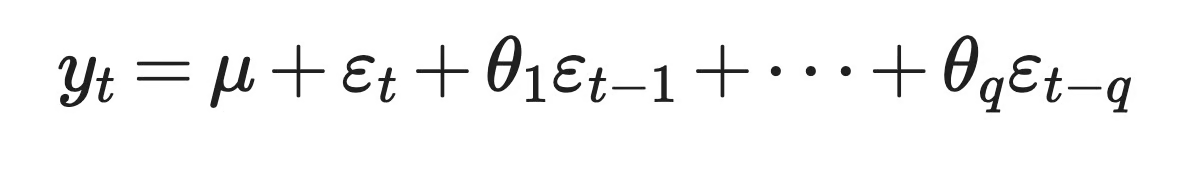
ARMA 模型
其中,mu 是序列的均值,theta_1 到 theta_q 为系数,epsilon_t-1 到 epsilon_t-q 是前几步的随机冲击。不要把它与滑动平均(滚动均值)混淆。名称相同,但模型不同。
两种模型对冲击的响应不同。在 MA(q) 模型中,一次冲击恰好影响 q 个步骤;在 AR 模型中,冲击会随时间衰减,但从不完全归零。这一差异也解释了为何选择阶数时所用工具不同——对 AR 模型,PACF 在滞后 p 后截断;对 MA 模型,ACF 在滞后 q 后截断。
ARIMA 将它们整合起来。ARIMA(p, d, q) 包含三部分:
这意味着 AR 是 ARIMA 的特例。把 d 和 q 设为 0,就得到 AR 模型。我们可以用需求数据来验证:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))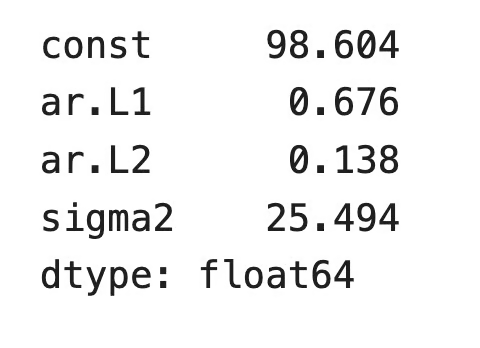
差分阶与移动平均阶均为 0 的 ARIMA 模型
AR 系数与 AutoReg 的结果一致。常数不同,因为 ARIMA 报告的是序列的均值,而 AutoReg 报告的是截距 c。
现在看看 ARIMA 的进一步能力。假设城市在增长,每天的用电需求略有上升。序列出现趋势,ADF 检验不再通过,AR 模型也无法直接用于该序列。
但 ARIMA(2, 1, 0) 可以。它对序列做一次差分,因此模型针对日度需求变化(而非原始值)进行建模,然后在这些变化上拟合 AR(2)。如果像热浪这样的冲击还会影响到次日的需求,您可以加入 MA 项,得到 ARIMA(2, 1, 1)。
AR 部分在所有情形中做的是同一件事。ARIMA 只是先为它准备好数据,并建模剩余部分。如果您想更深入,可参考 ARIMA Models in R 课程,涵盖完整流程。
自回归模型用序列自身的过去来预测下一个值。它是把目标的滞后副本作为特征的线性回归,因此是最容易理解的时间序列模型之一。
您会在经济学、语音编码、EEG 分析,甚至当今语言模型的名称中见到它。文中也展示了它不适用的情形:需要平稳数据、依赖正确的滞后阶数,且相关的滞后会降低单个系数的可靠性。
理解 AR 模型会让经典预测的其余部分容易许多。ARIMA 是顺理成章的下一步,我们的 ARIMA 教程展示了差分和 MA 项如何扩展您在此学到的内容。若想上手实践,可试试我们的 ARIMA Models in Python 课程。
与 DataCamp 一起学习
课程
课程
课程