Cours
Analyse des séries temporelles en Python
4 h
70.9K
La plupart des contenus en ligne passent directement à ARIMA et ne consacrent qu’une ligne, au mieux, à la composante AR. Pourtant, AR est le socle du modèle. Si vous ne le maîtrisez pas, le reste d’ARIMA ne sera pas plus clair.
En termes simples, un modèle autorégressif prédit les valeurs futures d’une série temporelle à partir de ses propres valeurs passées. On le rencontre en économie, en finance, en traitement du signal et dans les données climatiques. C’est en essence un modèle de régression, donc il fait le lien entre ce que vous savez déjà de la régression et les prévisions de séries temporelles, et il constitue la base sur laquelle est construit ARIMA.
Dans cet article, je vous montre comment fonctionne un modèle autorégressif, comment l’ajuster en Python avec statsmodels et comment choisir le bon ordre de retard.
Un modèle autorégressif prédit la prochaine valeur d’une série à partir d’une somme pondérée de ses valeurs précédentes.
Dans ce nom, « auto » signifie soi-même et « régression » signifie prédire une variable à partir d’autres. Un modèle autorégressif est donc une régression d’une série sur son propre passé.
Supposons que vous souhaitiez prédire la demande d’électricité de demain. La demande d’aujourd’hui est un bon point de départ, et celle d’hier ajoute un peu d’information. Un modèle autorégressif formalise cette intuition et apprend les poids à partir de vos données.
Les modèles AR s’écrivent AR(p), où p est l’ordre du modèle. L’ordre indique combien de valeurs passées le modèle utilise :
p valeurs précédentesUn ordre plus élevé n’implique pas automatiquement un meilleur modèle. Je vous montrerai comment choisir p plus loin dans l’article.
Voici la forme générale d’un modèle AR(p) :
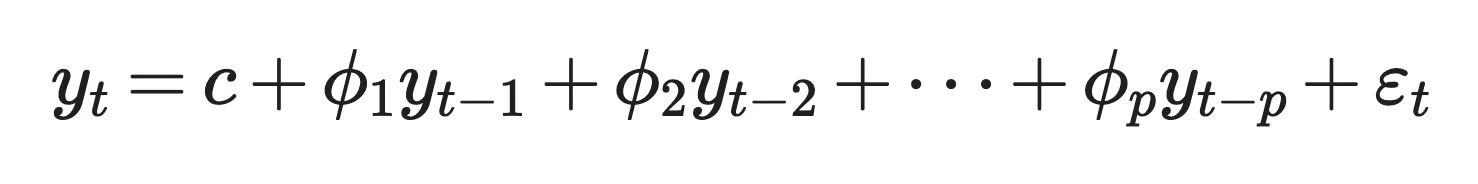
Le modèle AR(p) général
Rôle de chaque terme :
y_t : la valeur de la série au temps t, c’est-à-dire celle que vous voulez prédire
c : une constante qui, avec les coefficients, fixe la moyenne de long terme de la série
phi_1 à phi_p : les coefficients qui indiquent la contribution de chaque valeur passée à la prédiction
y_t-1 à y_t-p : les valeurs retardées ; « retard » désigne le nombre de pas en arrière considérés
epsilon_t : un bruit blanc, erreur aléatoire de moyenne nulle, variance constante et sans autocorrélation
En bref, le modèle multiplie chacune des p dernières valeurs par son poids et ajoute la constante. Le reste est du bruit : la part de y_t que le passé n’explique pas.
AR(1) est la version la plus simple :
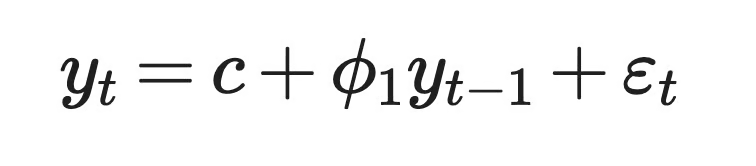
Modèle AR(1)
La valeur de phi_1 détermine l’influence d’aujourd’hui sur demain.
Supposons c = 2 et phi_1 = 0.8. Si la valeur d’aujourd’hui est 15, le modèle prévoit 2 + 0,8 × 15 = 14 pour demain. La suivante est 2 + 0,8 × 14 = 13,2. À chaque pas, la série se rapproche de 10, sa moyenne de long terme, c / (1 - phi_1).
Si phi_1 est négatif, la série oscille au-dessus et en dessous de la moyenne d’un pas à l’autre.
AR(2) ajoute un deuxième retard :
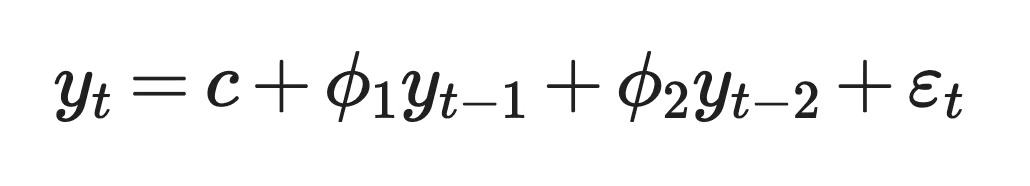
Modèle AR(2)
Avec deux retards, le modèle peut décrire des motifs qu’AR(1) ne capture pas, comme des cycles. Par exemple, un phi_1 positif et un phi_2 négatif peuvent produire une série en vagues, proche d’un cycle économique.
Tout modèle AR revient donc à deux choix : combien de retards utiliser et quels poids leur attribuer.
Un modèle AR fonctionne si deux conditions sont réunies. Les valeurs passées doivent être liées aux futures, et la série doit se comporter de la même manière dans le temps. La première s’appelle l’autocorrélation, la seconde la stationnarité.
L’autocorrélation est la corrélation entre une série temporelle et une copie retardée d’elle-même.
C’est la raison d’être des modèles AR. Si la valeur d’aujourd’hui ne dit rien sur celle de demain, le modèle n’a rien à apprendre des valeurs passées.
En code, vous prenez une colonne de valeurs, vous la copiez et vous décalez la copie d’une ligne vers le bas. Chaque ligne associe alors une valeur à celle qui la précède. La corrélation entre les deux colonnes est l’autocorrélation de retard 1. Avec deux lignes de décalage, vous obtenez l’autocorrélation de retard 2.
Voici à quoi cela ressemble avec pandas :
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))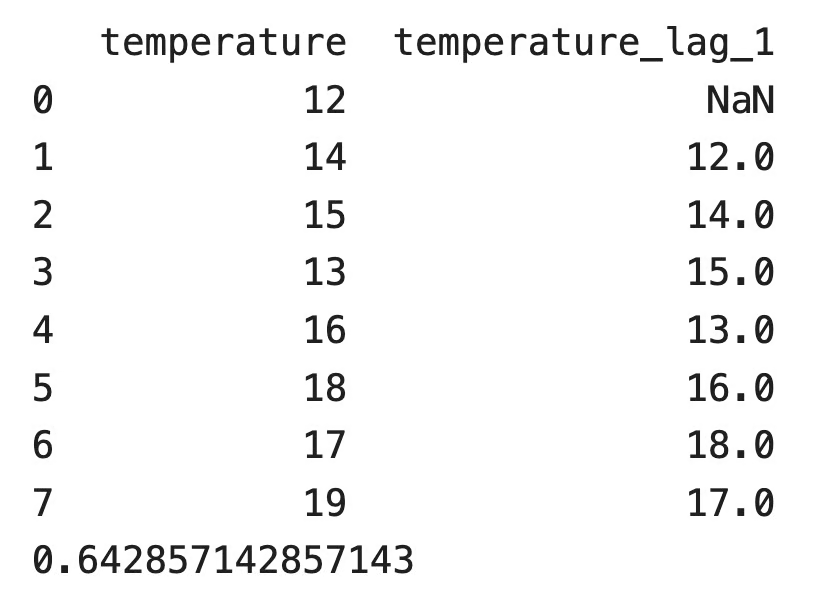
DataFrame avec la colonne température et sa copie à retard 1
La première ligne de la colonne retardée est vide, faute de valeur précédente. pandas ignore cette ligne et renvoie une autocorrélation de retard 1 de 0,643. Dans cette série, les journées chaudes tendent à se suivre.
Le signe de l’autocorrélation influe sur le comportement de la série :
Une autocorrélation proche de zéro signifie que le passé n’aide pas. Dans ce cas, un modèle AR ne fera guère mieux que prévoir la moyenne.
Les modèles AR exigent une série stationnaire.
Une série stationnaire présente la même moyenne, la même variance et la même autocorrélation à un retard donné, quelle que soit la période observée. Les statisticiens parlent de stationnarité au sens faible.
C’est important car le modèle estime un jeu fixe de coefficients. Si la moyenne de la série dérive dans le temps, des coefficients appris sur d’anciennes données ne décriront pas les plus récentes. Les prix boursiers sont un exemple classique de série non stationnaire car ils suivent une tendance sur les années. Les rendements quotidiens sont bien plus proches d’une série stationnaire.
Les coefficients eux-mêmes déterminent si un processus AR est stationnaire. Pour AR(1), la règle est simple : phi_1 doit être compris entre -1 et 1.
abs(phi_1) < 1 : les chocs s’estompent et la série revient vers sa moyenne
phi_1 = 1 : la série devient une marche aléatoire et les chocs ne s’estompent jamais
abs(phi_1) > 1 : chaque choc s’amplifie et la série explose
AR(2) requiert trois conditions simultanées : phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 et abs(phi_2) < 1.
Au-delà de deux retards, il faut une règle générale. Chaque modèle AR(p) possède un polynôme caractéristique :
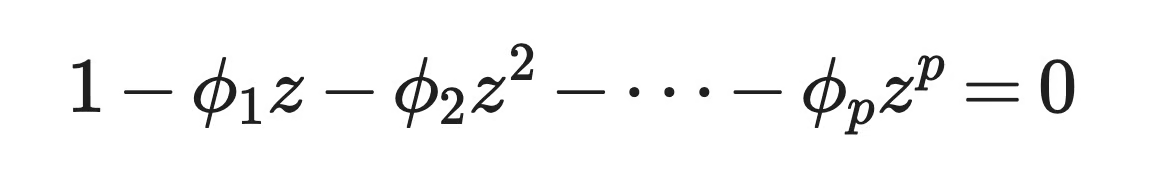
Polynôme caractéristique
Le processus est stationnaire au sens faible lorsque toutes les racines de ce polynôme sont à l’extérieur du cercle unité, c’est-à-dire lorsque chaque racine z a une valeur absolue supérieure à 1. Les racines pouvant être complexes, la frontière est un cercle dans le plan complexe et non une droite.
Vous pouvez le vérifier avec AR(1). Le polynôme est 1 - phi_1 z = 0, donc la racine est z = 1 / phi_1. Cette racine est hors du cercle unité seulement si abs(phi_1) < 1, ce qui rejoint la règle précédente.
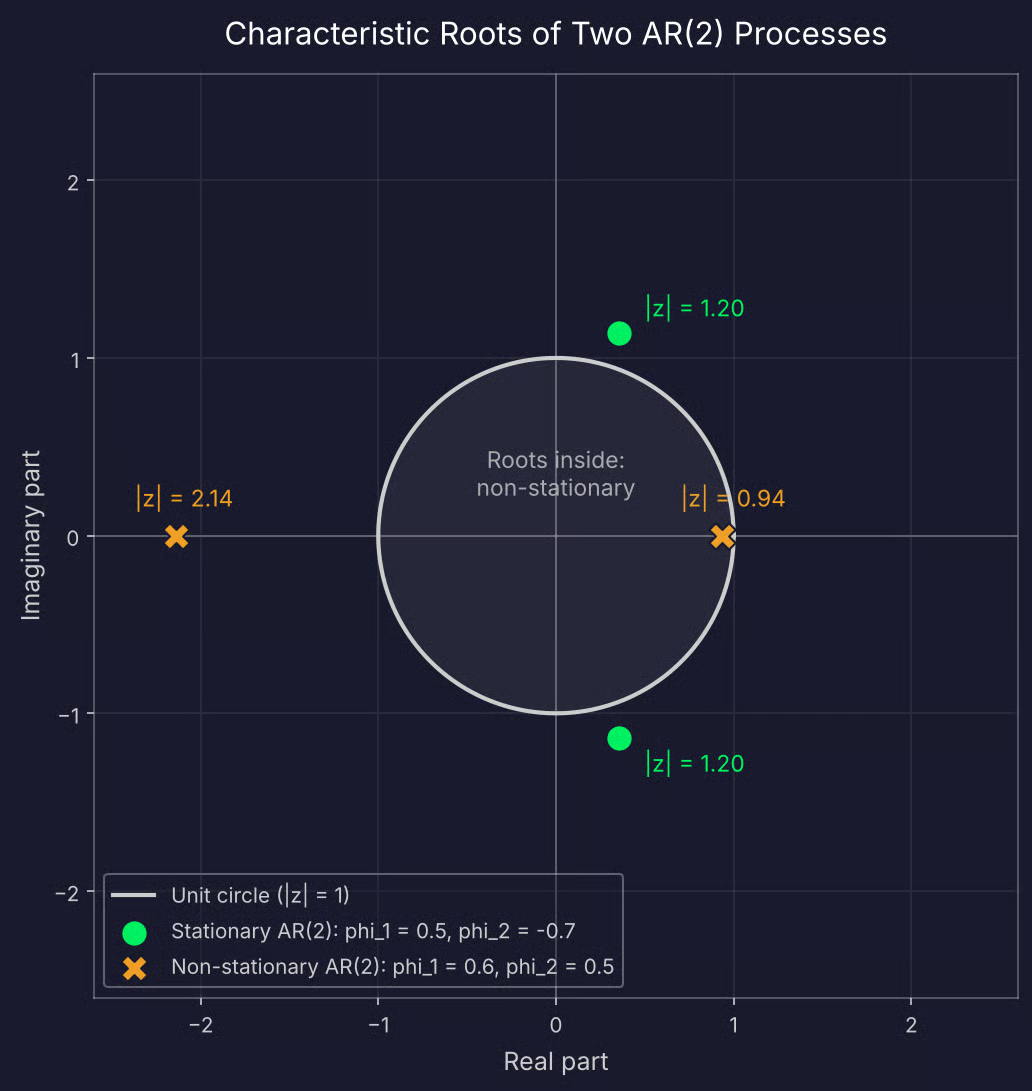
Racines d’un processus AR(2) stationnaire et non stationnaire
Vous ne calculerez pas ces racines à la main. statsmodels les renvoie après l’ajustement du modèle, et je vous montrerai comment tester la stationnarité des données elles-mêmes dans la section Python.
Si votre série n’est pas stationnaire, vous pouvez la différencier — soustraire chaque valeur de la suivante — puis modéliser les différences. C’est le sens du « I » dans les modèles ARIMA.
Tous les modèles AR partagent la même équation. Ce qui change d’un type à l’autre, c’est l’ordre p, c’est-à-dire le nombre de valeurs passées utilisées.
AR(1) n’utilise que la valeur précédente pour prédire la suivante.
Si cela vous rappelle la régression linéaire, c’est normal. En plaçant y_t-1 en abscisse et y_t en ordonnée, AR(1) ajuste une droite aux points. La constante c est l’ordonnée à l’origine et phi_1 la pente. Si vous connaissez la régression linéaire simple, vous savez déjà comment on estime AR(1).
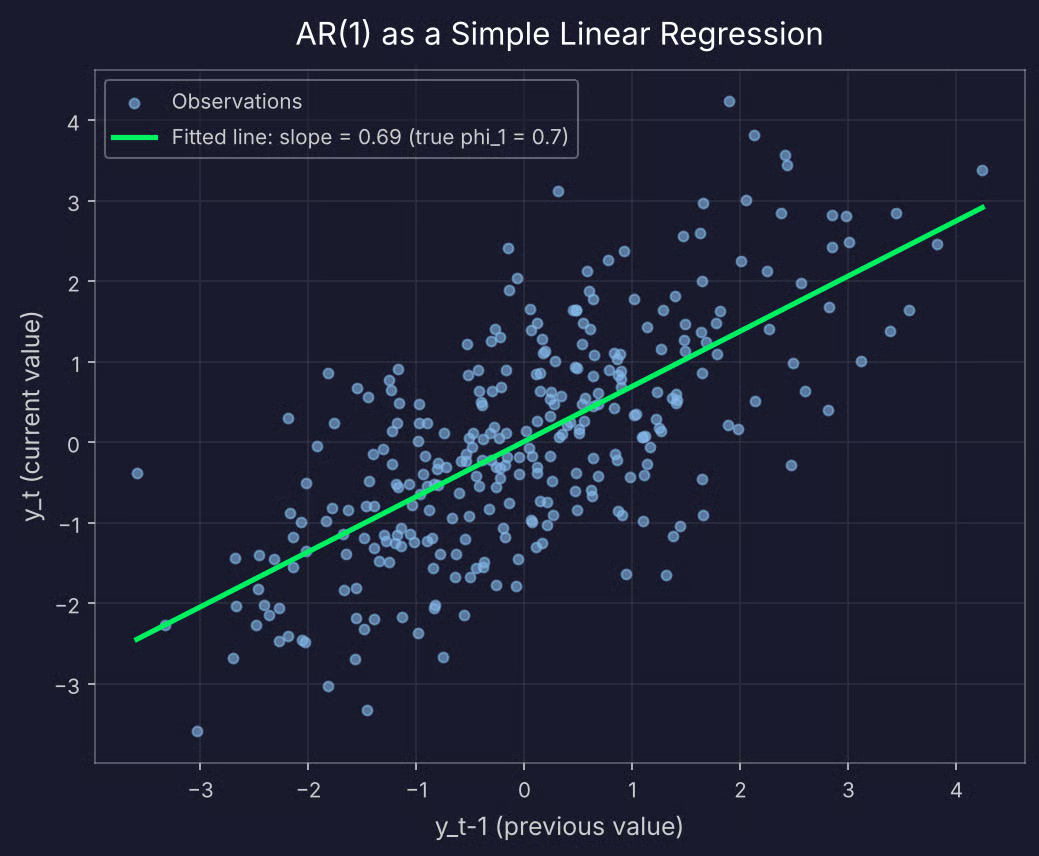
Nuage de points de y_t contre y_t-1 pour AR(1)
Mais il y a une différence : en régression standard, le prédicteur et la cible sont deux variables distinctes. Dans AR(1), le prédicteur est la même série décalée d’un pas. C’est pourquoi vous ne pouvez ni mélanger les lignes ni faire de séparation aléatoire train/test : l’ordre des données fait partie du modèle.
La valeur de phi_1 modifie l’aspect de la série :
phi_1 = 0,3 : la série ressemble presque à du bruit aléatoire, chaque valeur apportant peu d’information à la suivante
phi_1 = 0,9 : la série évolue par longues oscillations et met du temps à revenir vers sa moyenne
phi_1 = -0,8 : la série zigzague au-dessus et en dessous de la moyenne presque à chaque pas
phi_1 = 1 : la série devient une marche aléatoire et dérive sans moyenne de retour ; c’est le cas non stationnaire évoqué plus haut
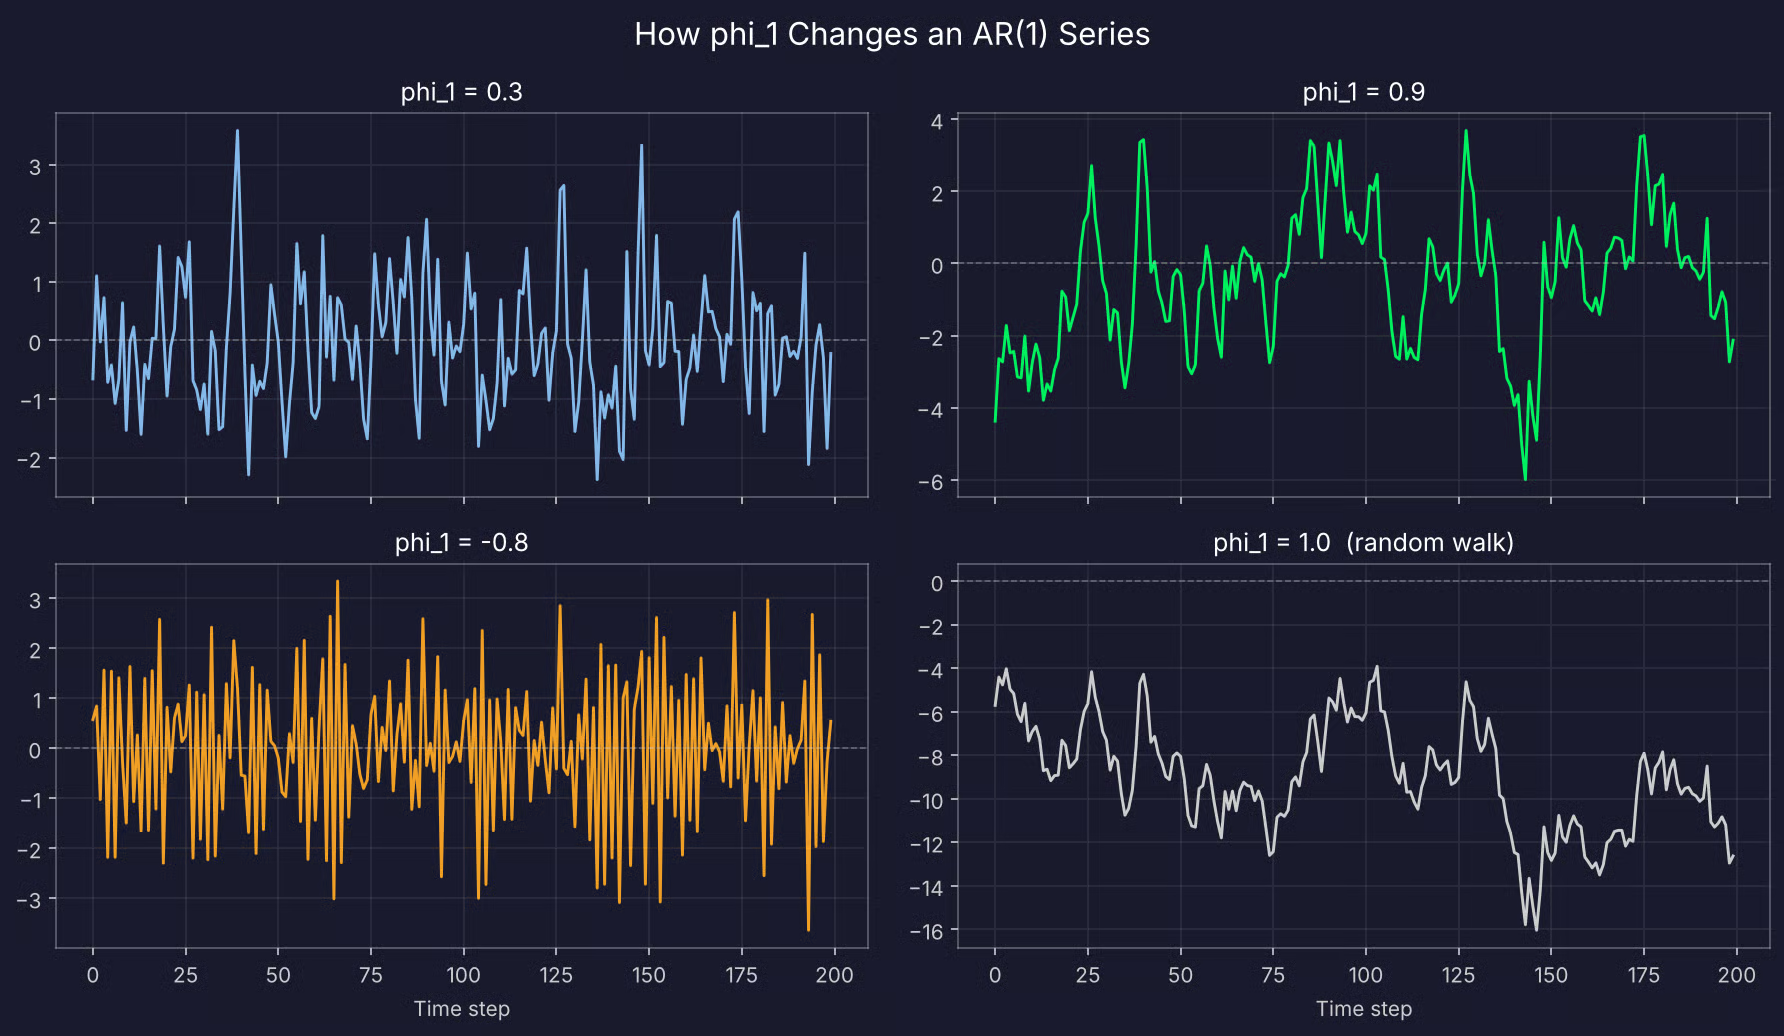
Quatre séries AR(1) simulées
Plus phi_1 se rapproche de 1 ou de -1, plus un choc unique influence longtemps la série.
AR(2) utilise les deux valeurs précédentes. Le deuxième retard permet de générer des motifs qu’AR(1) ne peut pas, principalement des cycles.
Voici la comparaison de deux jeux de coefficients :
phi_1 = 0,5, phi_2 = 0,3 : les deux retards tirent dans le même sens ; la série ressemble à une AR(1) aux oscillations plus longues et plus lisses
phi_1 = 0,5, phi_2 = -0,7 : le second retard contrecarre le premier ; la série monte et descend en vagues qui se répètent environ tous les cinq pas
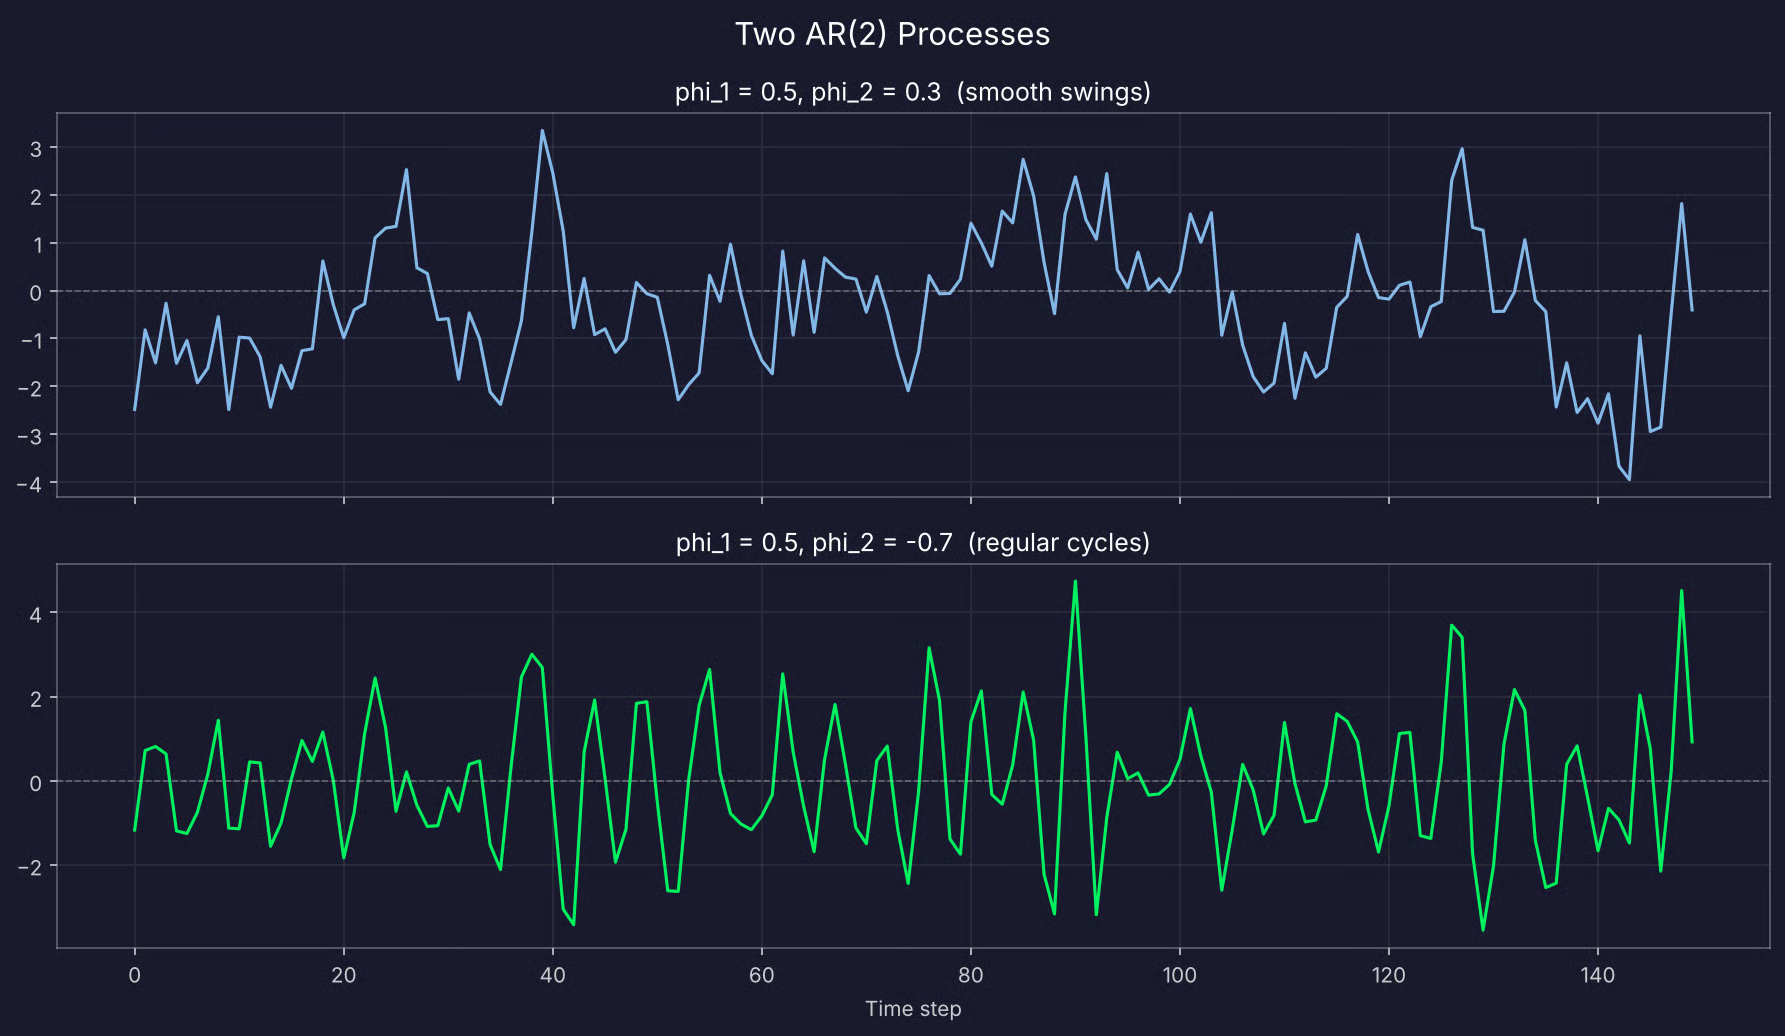
Deux séries AR(2) simulées
AR(3), AR(4), et au-delà ajoutent un retard à la fois. Ils sont utiles quand des valeurs plus éloignées contiennent une information que les plus récentes n’ont pas.
Par exemple, vous modélisez des ventes mensuelles, et le même mois de l’année précédente prédit bien ce mois-ci. Un modèle AR(12) inclut ce retard de 12 mois, ainsi que les 11 retards intermédiaires.
Chaque retard supplémentaire ajoute un coefficient à estimer. Il faut donc plus de données, et le risque de surapprentissage augmente. Les coefficients deviennent aussi plus difficiles à interpréter : avec 12, il est impossible d’anticiper l’allure de la série en lisant simplement les nombres. On examine plutôt les racines.
Je vous montrerai comment choisir le bon ordre avec la PACF et l’AIC dans la section Python.
On retrouve les modèles AR partout où les données sont ordonnées et où le passé récent dit quelque chose sur le proche avenir.
La plupart des usages entrent dans l’un de ces quatre groupes :
Le dernier point surprend souvent : le terme derrière les chatbots d’aujourd’hui vient des mêmes statistiques dont il est question ici.
Dans cette section, j’ajuste un modèle autorégressif en Python avec statsmodels, des données brutes jusqu’à une prévision que vous pouvez évaluer.
Vous avez besoin de pandas et NumPy pour les données, de statsmodels pour le modèle et les tests, et de scikit-learn pour la métrique d’erreur :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorJe vais simuler deux ans de demande d’électricité quotidienne à partir d’un processus AR(2).
J’opte pour des données simulées afin de connaître les coefficients vrais dès le départ. Vous pouvez ainsi vérifier si le modèle les retrouve et si les outils de sélection des retards pointent vers le bon ordre.
Le processus a c = 15, phi_1 = 0,6 et phi_2 = 0,25, ce qui place la moyenne de long terme à 100 MWh :
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()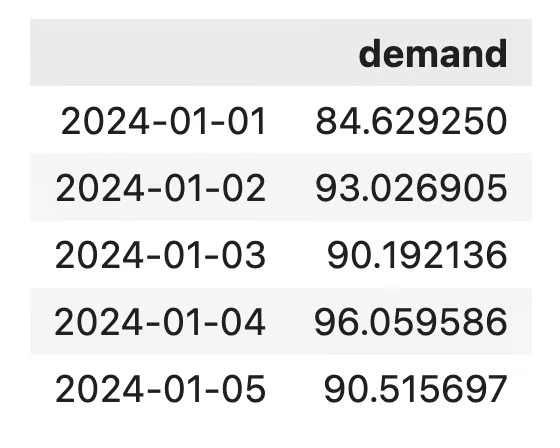
Le jeu de données de demande d’électricité quotidienne
Les 100 premiers jours simulés sont supprimés : cette période de chauffe permet à la série d’adopter son comportement normal avant usage.
Voici l’allure de la série complète :
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()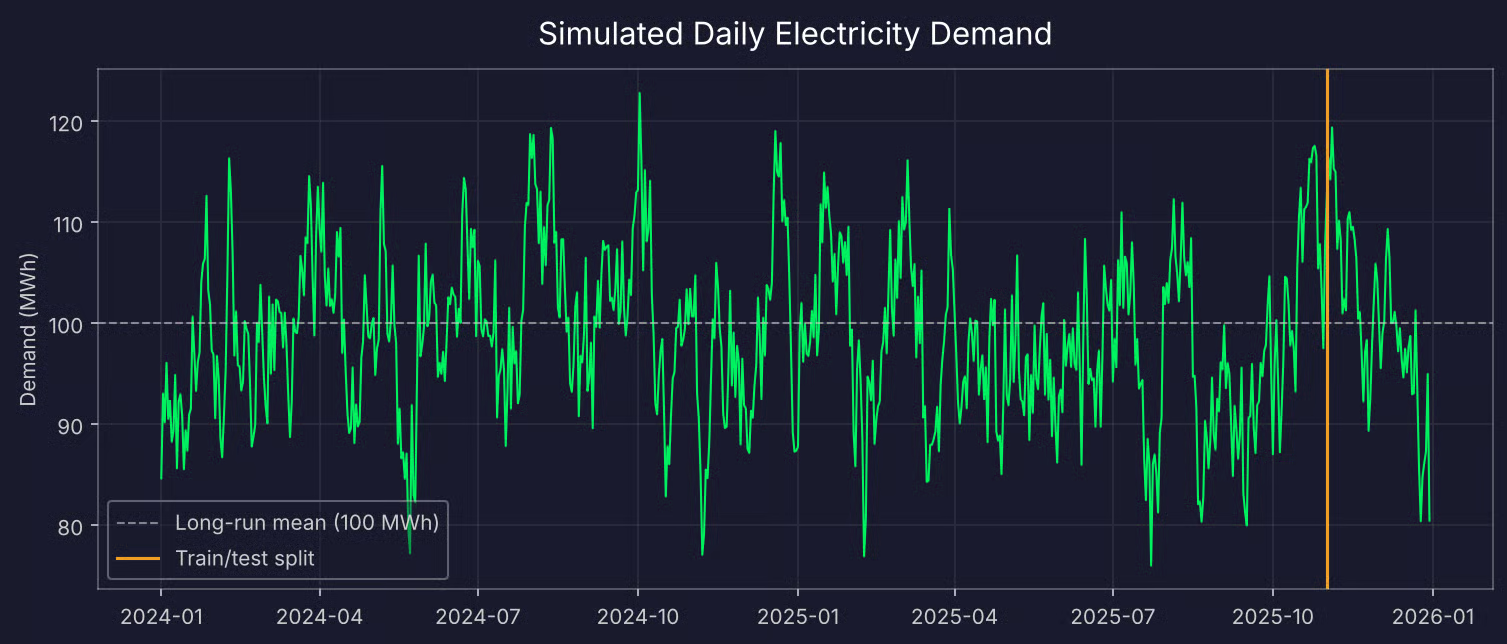
Deux ans de demande d’électricité quotidienne simulée
La série oscille autour de 100 sans tendance, ce qui correspond à une série stationnaire. Mais un simple coup d’œil ne suffit pas.
Le test de Dickey-Fuller augmenté (ADF) vérifie si une série est stationnaire. Son hypothèse nulle est que la série ne l’est pas ; vous recherchez donc une petite p-valeur :
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")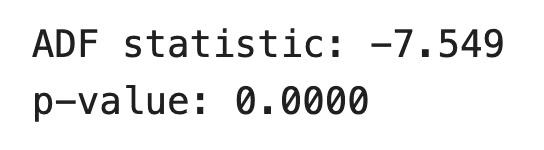
Résultats du test ADF
La p-valeur est nettement inférieure à 0,05 ; vous pouvez rejeter l’hypothèse nulle et considérer la série comme stationnaire.
Si vos données échouent à ce test, différenciez-les avec df["demand"].diff().dropna() puis relancez le test.
Les séries temporelles ne se mélangent pas : l’ensemble de test doit provenir de la fin de la série. Je conserve les 60 derniers jours pour le test :
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Il reste 670 jours pour l’entraînement et 60 pour le test.
C’est l’étape qui conditionne la performance. Trop peu de retards et le modèle rate des motifs ; trop de retards et il ajuste le bruit de l’entraînement qui ne se répétera pas.
Deux outils vous aident.
Le premier est la fonction d’autocorrélation partielle (PACF). Elle montre la corrélation entre la série et chaque retard après avoir retiré l’effet des retards plus courts. Pour un processus AR(p), la PACF présente des pics significatifs jusqu’au retard p et retombe autour de zéro ensuite :
plot_pacf(train, lags=20, method="ywm")
plt.show()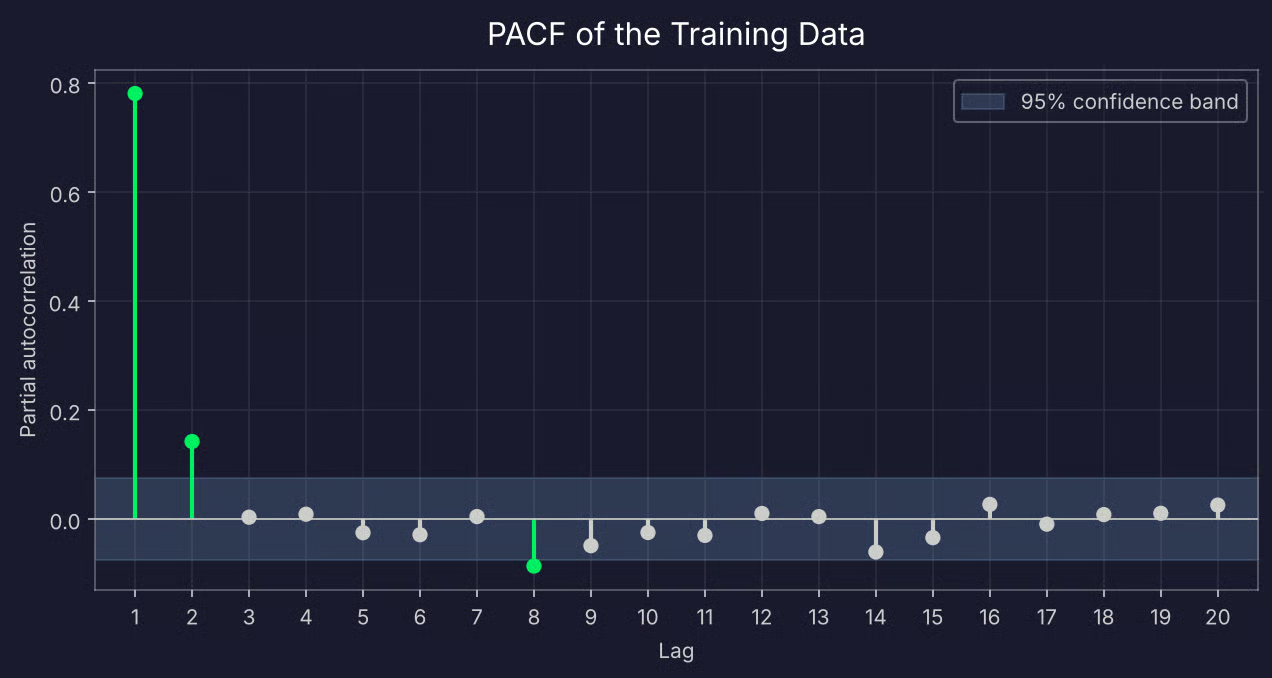
PACF des données d’entraînement
Les retards 1 et 2 dépassent largement la bande de confiance ; le retard 3 retombe près de zéro. Cela pointe vers AR(2).
On voit aussi un petit pic au retard 8, juste au-delà de la bande. N’en concluez pas trop : la bande est à 95 % de confiance, donc avec 20 retards, il est normal qu’environ l’un d’eux la franchisse par hasard.
Le deuxième outil est constitué des critères d’information. AIC et BIC récompensent un bon ajustement mais pénalisent chaque paramètre supplémentaire. BIC pénalise davantage et tend à choisir des modèles plus petits. statsmodels peut tester tous les ordres jusqu’à un maximum et renvoyer le meilleur :
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")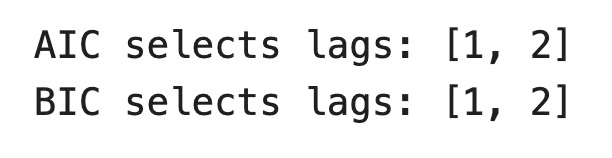
Sélection des retards par AIC/BIC
Les deux critères confirment la PACF. En pratique, AIC choisit souvent un modèle un peu plus grand que BIC. Si cela arrive, commencez par le plus simple.
Une fois l’ordre choisi, l’ajustement tient en deux lignes :
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")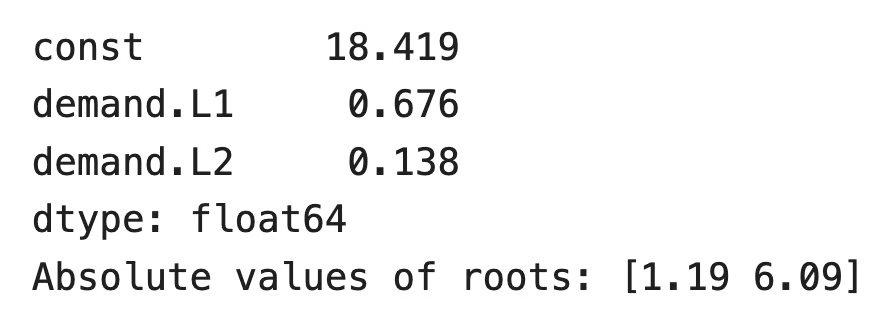
Paramètres du modèle AR(2)
Les valeurs vraies sont 0,6 et 0,25. Le modèle accorde un peu plus de poids au premier retard et moins au second, mais la somme des deux est proche : 0,81 contre 0,85. Avec 670 points, vous ne retrouverez pas exactement les valeurs vraies.
Les deux racines ont un module supérieur à 1 : le modèle ajusté est stationnaire. Vous pouvez appeler results.summary() pour les erreurs standards, p-valeurs et le tableau complet des racines.
Deux approches permettent de prévoir la période de test, et elles répondent à des questions différentes :
Les prévisions multi-pas proviennent directement des résultats ajustés. Pour la prévision à un pas, vous appliquez les coefficients appris à la série complète :
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")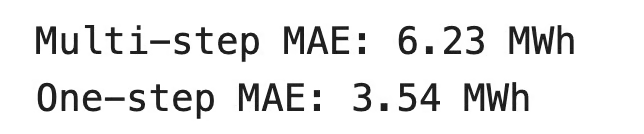
Résultats des prévisions
L’erreur absolue moyenne (MAE) est la différence absolue moyenne entre les prévisions et les valeurs réelles. Elle est exprimée dans la même unité que les données, donc directement lisible. La prévision à un pas se trompe en moyenne de 3,54 MWh.
Voici la comparaison des deux prévisions aux valeurs réelles :
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()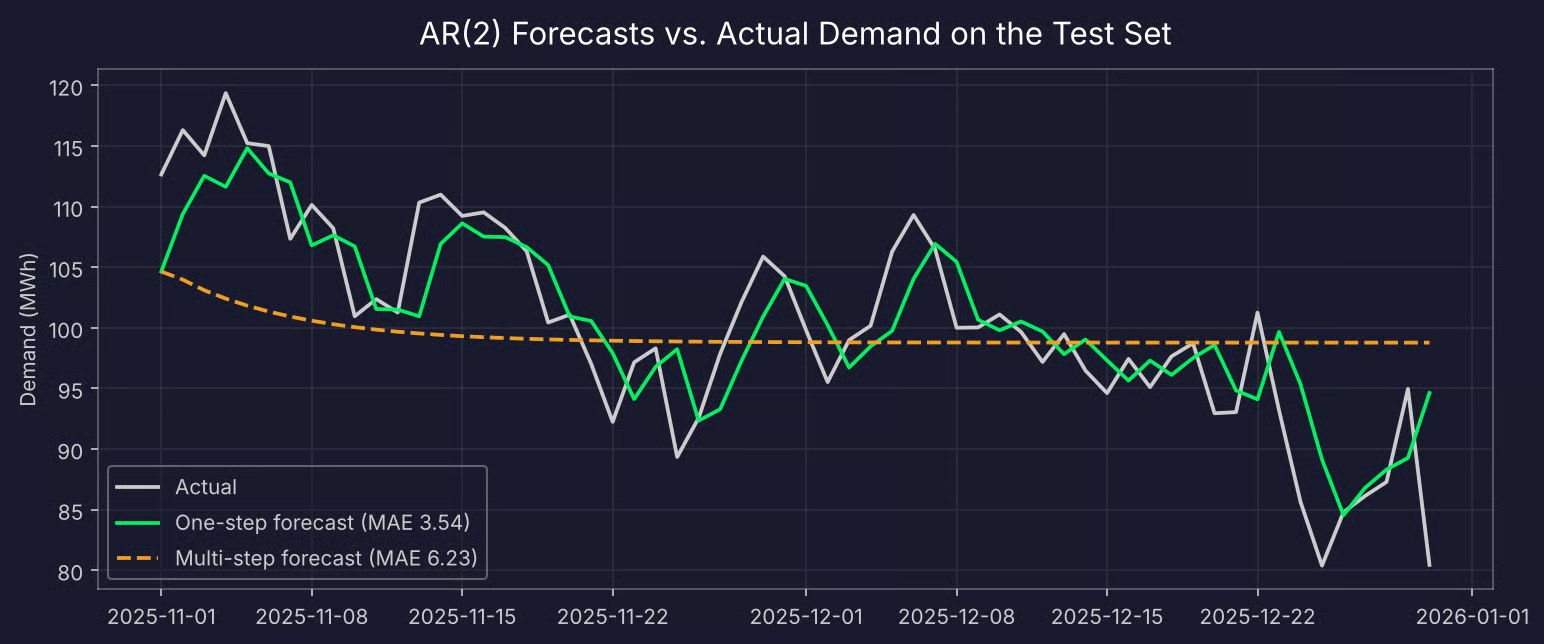
Prévisions AR(2) à un pas et multi-pas vs demande réelle
La prévision à un pas suit de près les valeurs réelles, avec un décalage d’environ un jour. La prévision multi-pas part de la dernière valeur connue puis se tasse vers la moyenne en environ trois semaines.
Tout modèle AR stationnaire se comporte ainsi : plus l’horizon s’allonge, moins le passé aide, et la meilleure estimation devient la moyenne de long terme. Les modèles AR excellent donc sur les horizons courts.
On pourrait croire que plus d’historique donne de meilleures prévisions. Testons-le en ajustant des modèles avec un nombre croissant de retards et en comparant leur MAE à un pas :
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")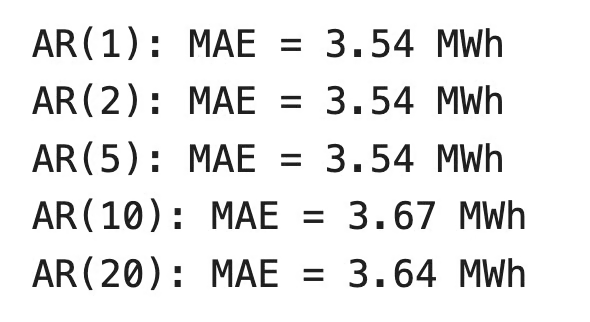
MAE avec davantage de retards
L’erreur ne s’améliore pas au-delà d’AR(2) et se dégrade avec AR(10) et AR(20). Ces coefficients supplémentaires ajustent le bruit des données d’entraînement.
Vous noterez aussi qu’AR(1) fait aussi bien qu’AR(2) ici. Le second coefficient estimé est faible, il apporte donc peu sur ce jeu de test. Quand deux modèles performent pareil, préférez le plus simple : il est plus explicable et moins susceptible de se dégrader sur de nouvelles données.
Il y a aussi un coût : AR(20) estime 21 paramètres contre 3.
En résumé, laissez la PACF et les critères d’information suggérer l’ordre, puis confirmez-le simplement sur un ensemble de test.
Les modèles AR conviennent à de nombreux problèmes de prévision, mais pas à tous. Voici où ils excellent, où ils pêchent et comment ils se comparent aux modèles qui les prolongent.
Les modèles AR ont deux principaux atouts :
Ils ont aussi deux limites majeures :
Il existe un autre écueil : les valeurs retardées sont corrélées entre elles car elles proviennent de la même série. Dans les données de demande, la corrélation entre y_t-1 et y_t-2 vaut 0,78.
Cela s’appelle la multicolinéarité, et cela affecte tout modèle de régression. Quand deux prédicteurs évoluent ensemble, le modèle peine à attribuer la responsabilité. Les coefficients deviennent moins stables et leurs erreurs standard augmentent.
C’est ce qui explique l’observation précédente : le modèle a estimé 0,676 et 0,138 au lieu de 0,6 et 0,25 — il a déplacé du poids d’un retard vers l’autre, mais la somme est restée proche. Les prédictions en pâtissent peu, mais il faut être prudent avec les coefficients pris isolément. Chaque retard ajouté aggrave le problème.
AR est l’un des trois piliers de la prévision classique de séries temporelles. Les deux autres sont les modèles à moyenne mobile (MA) et ARIMA, qui les combine.
Un modèle AR prédit à partir des valeurs passées. Un modèle MA prédit à partir des erreurs passées :
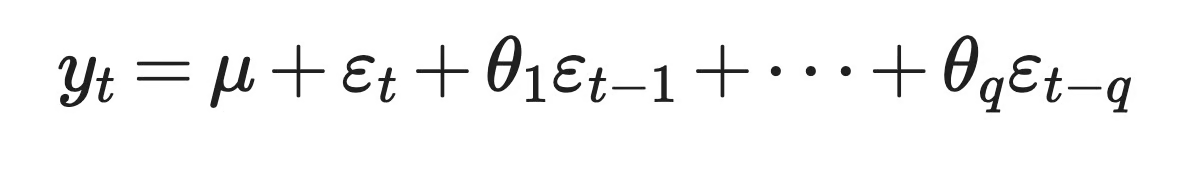
Modèle ARMA
Ici, mu est la moyenne de la série, theta_1 à theta_q sont les coefficients et epsilon_t-1 à epsilon_t-q les chocs aléatoires des pas précédents. À ne pas confondre avec la moyenne mobile au sens de moyenne glissante : le nom est identique, le modèle non.
Les deux réagissent différemment aux chocs. Dans un MA(q), un choc affecte la série pendant exactement q pas. Dans un AR, un choc s’estompe dans le temps sans jamais tomber strictement à zéro. Cette différence explique aussi pourquoi l’on choisit l’ordre différemment : la PACF s’annule après le retard p pour les AR, tandis que l’ACF s’annule après le retard q pour les MA.
ARIMA réunit le tout. ARIMA(p, d, q) comporte trois volets :
AR est donc un cas particulier d’ARIMA. Si vous fixez d et q à zéro, vous obtenez un AR. Vous pouvez le vérifier avec les données de demande :
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))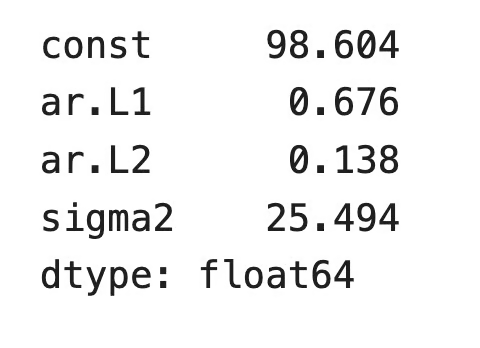
Modèle ARIMA avec ordre d’intégration et de moyenne mobile nuls
Les coefficients AR correspondent à ceux d’AutoReg. La constante diffère car ARIMA rapporte la moyenne de la série, tandis qu’AutoReg rapporte l’ordonnée à l’origine c.
Voyons maintenant ce qu’ARIMA permet en plus. Supposons que la ville grandisse et que la demande d’électricité augmente un peu chaque jour. La série présente une tendance : le test ADF échoue et un modèle AR ne peut plus travailler directement sur la série.
Mais un ARIMA(2, 1, 0) le peut. Il différencie la série une fois ; le modèle travaille donc sur les variations quotidiennes plutôt que sur les valeurs brutes, puis ajuste un AR(2) sur ces variations. Si un choc (comme une canicule) influe aussi sur le lendemain, vous pouvez ajouter un terme MA et obtenir ARIMA(2, 1, 1).
La partie AR remplit le même rôle dans tous les cas. ARIMA prépare les données pour elle et modélise le reste. Pour aller plus loin, le cours ARIMA Models in R couvre l’ensemble du processus.
Un modèle autorégressif prédit la valeur suivante d’une série à partir de son propre passé. C’est une régression linéaire où les prédicteurs sont des copies retardées de la cible, ce qui en fait l’un des modèles de séries temporelles les plus faciles à comprendre.
On le retrouve en économie, dans le codage de la parole, l’analyse EEG, et même dans le nom des modèles de langage actuels. Vous avez aussi vu ses limites : besoin de données stationnaires, dépendance au bon ordre de retard, et des retards corrélés rendent les coefficients individuels moins fiables.
Si vous comprenez les modèles AR, le reste de la prévision classique devient beaucoup plus accessible. ARIMA est l’étape logique suivante, et notre tutoriel ARIMA vous montre comment la différenciation et les termes MA prolongent ce que vous avez appris ici. Pour une approche pratique, essayez notre cours ARIMA Models in Python.
Apprenez avec DataCamp
Cours
Cours
Cours
Tutoriel
Josef Waples
8 min
Tutoriel
Laiba Siddiqui
6 min
Tutoriel
Dr Ana Rojo-Echeburúa
12 min
Tutoriel
Aditya Sharma
5 min
Tutoriel
DataCamp Team
2 min
Tutoriel
Stephen Gruppetta
12 min