Curso
Análise de séries temporais em Python
4 h
70.9K
Grande parte do conteúdo online vai direto para ARIMA e, quando muito, dá uma linha para explicar a parte AR. Mas AR é a base do modelo. Se você não entender AR, o resto do ARIMA também não vai fazer sentido.
Em termos simples, um modelo autorregressivo prevê valores futuros de uma série temporal a partir dos seus próprios valores passados. Você vai vê-lo em economia, finanças, processamento de sinais e dados climáticos. É basicamente um modelo de regressão, então conecta o que você já sabe sobre regressão à previsão de séries temporais, e é a base sobre a qual o ARIMA é construído.
Neste artigo, vou mostrar como um modelo autorregressivo funciona, como ajustar um no Python com statsmodels e como escolher a ordem de defasagem ideal.
Um modelo autorregressivo prevê o próximo valor de uma série temporal a partir de uma soma ponderada dos seus valores anteriores.
No nome, "auto" significa próprio, e "regressão" significa prever uma variável a partir de outras. Então um modelo autorregressivo é uma regressão da série sobre o seu próprio passado.
Digamos que você queira prever a demanda de eletricidade de amanhã. A demanda de hoje é um bom ponto de partida, e a de ontem acrescenta um pouco mais de informação. Um modelo autorregressivo transforma essa intuição em fórmula e aprende os pesos com seus dados.
Os modelos AR são escritos como AR(p), onde p é a ordem do modelo. A ordem diz quantos valores passados o modelo usa:
p valoresUma ordem mais alta não significa automaticamente um modelo melhor. Vou mostrar como escolher p mais adiante.
Veja a forma geral de um modelo AR(p):
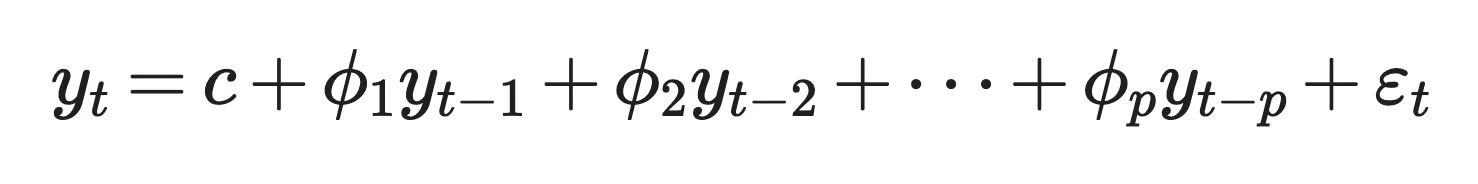
O modelo AR(p) geral
O que cada termo faz
y_t: O valor da série no tempo t, que é o valor que você quer prever
c: Uma constante que, junto com os coeficientes, define a média de longo prazo da série
phi_1 a phi_p: Os coeficientes, que indicam quanto cada valor passado contribui para a previsão
y_t-1 a y_t-p: Os valores defasados, onde "defasagem" indica quantos passos para trás você olha
epsilon_t: Ruído branco, um erro aleatório com média zero, variância constante e sem correlação temporal
Em termos simples, o modelo multiplica cada um dos últimos p valores pelo seu peso e soma a constante. O que sobrar é ruído, a parte de y_t que o passado não explica.
AR(1) é a versão mais simples:
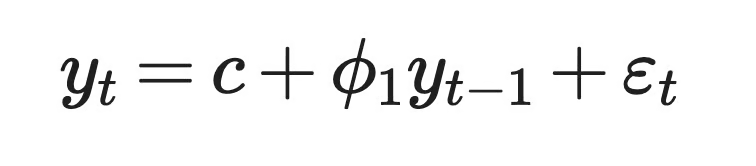
Modelo AR(1)
O valor de phi_1 controla quanto do hoje impacta o amanhã.
Suponha c = 2 e phi_1 = 0.8. Se o valor de hoje é 15, o modelo prevê 2 + 0,8 x 15 = 14 para amanhã. A próxima previsão é 2 + 0,8 x 14 = 13,2. A cada passo, a série se aproxima de 10, que é sua média de longo prazo, c / (1 - phi_1).
Se phi_1 for negativo, a série salta acima e abaixo da média de um passo para o outro.
AR(2) adiciona uma segunda defasagem:
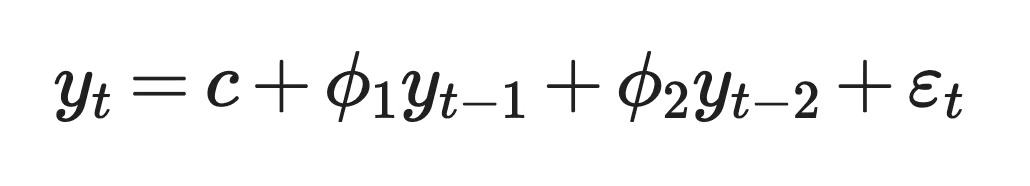
Modelo AR(2)
Com duas defasagens, o modelo descreve padrões que AR(1) não consegue, como ciclos. Por exemplo, phi_1 positivo com phi_2 negativo pode gerar uma série que sobe e desce em ondas, semelhante a um ciclo econômico.
Então todo modelo AR se resume a duas escolhas: quantas defasagens usar e quais pesos atribuir a elas.
Um modelo AR funciona apenas quando duas coisas são verdadeiras sobre seus dados. Os valores passados precisam estar relacionados aos futuros, e a série precisa se comportar da mesma forma ao longo do tempo. A primeira é chamada de autocorrelação, e a segunda de estacionariedade.
Autocorrelação é a correlação entre uma série temporal e uma cópia defasada dela mesma.
É o motivo de os modelos AR existirem. Se o valor de hoje não disser nada sobre o de amanhã, o modelo não tem o que aprender com os valores passados.
Em código, você pega uma coluna de valores, copia e desloca a cópia uma linha para baixo. Agora cada linha emparelha um valor com o valor anterior. A correlação entre as duas colunas é a autocorrelação de defasagem 1. Quando você desloca duas linhas, obtém a autocorrelação de defasagem 2.
Veja como isso fica em pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))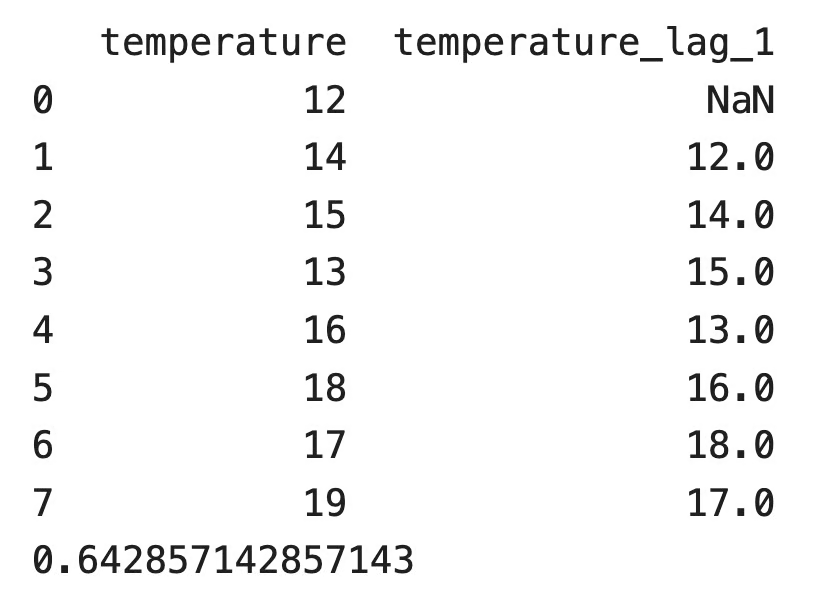
DataFrame com a coluna de temperatura e sua cópia defasada em 1
A primeira linha da coluna defasada fica vazia porque não há leitura anterior à primeira. O pandas ignora essa linha e retorna autocorrelação de defasagem 1 igual a 0,643. Dias quentes tendem a seguir dias quentes nesta série.
O sinal da autocorrelação muda como a série se comporta:
Uma autocorrelação próxima de zero significa que o passado não ajuda. Nesse caso, um modelo AR não fará muito melhor do que prever a média.
Modelos AR precisam de uma série temporal estacionária.
Uma série estacionária tem a mesma média, a mesma variância e a mesma autocorrelação em uma dada defasagem, independentemente da parte da série que você observa. Estatísticos chamam isso de estacionariedade em sentido fraco.
Isso importa porque o modelo estima um único conjunto de coeficientes. Se a média da série deriva ao longo do tempo, coeficientes aprendidos com dados antigos não descrevem os dados novos. Preços de ações são um exemplo comum de série não estacionária porque tendem ao longo dos anos. Retornos diários são bem mais próximos de estacionários.
Os próprios coeficientes determinam se um processo AR é estacionário. Para AR(1), a regra é simples: phi_1 precisa estar entre -1 e 1.
abs(phi_1) < 1: Choques se dissipam ao longo do tempo e a série volta à sua média
phi_1 = 1: A série vira um passeio aleatório, e choques nunca se dissipam
abs(phi_1) > 1: Cada choque cresce mais e a série explode
AR(2) precisa de três condições ao mesmo tempo: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 e abs(phi_2) < 1.
A partir de duas defasagens, você precisa de uma regra geral. Todo modelo AR(p) tem um polinômio característico:
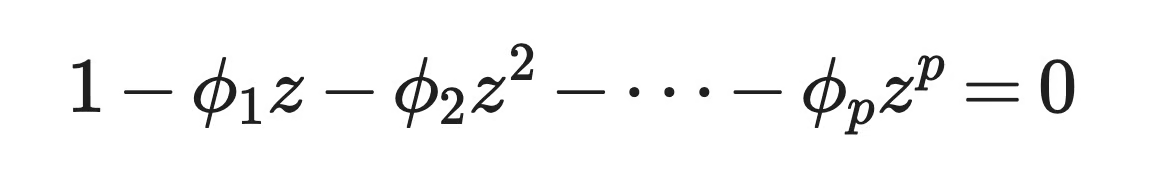
Polinômio característico
O processo é estacionário em sentido fraco quando todas as raízes desse polinômio estão fora do círculo unitário, ou seja, cada raiz z tem valor absoluto maior que 1. As raízes podem ser complexas, por isso a fronteira é um círculo no plano complexo e não uma linha.
Você pode checar isso com AR(1). O polinômio é 1 - phi_1 z = 0, então a raiz é z = 1 / phi_1. Essa raiz está fora do círculo unitário somente quando abs(phi_1) < 1, a mesma regra de antes.
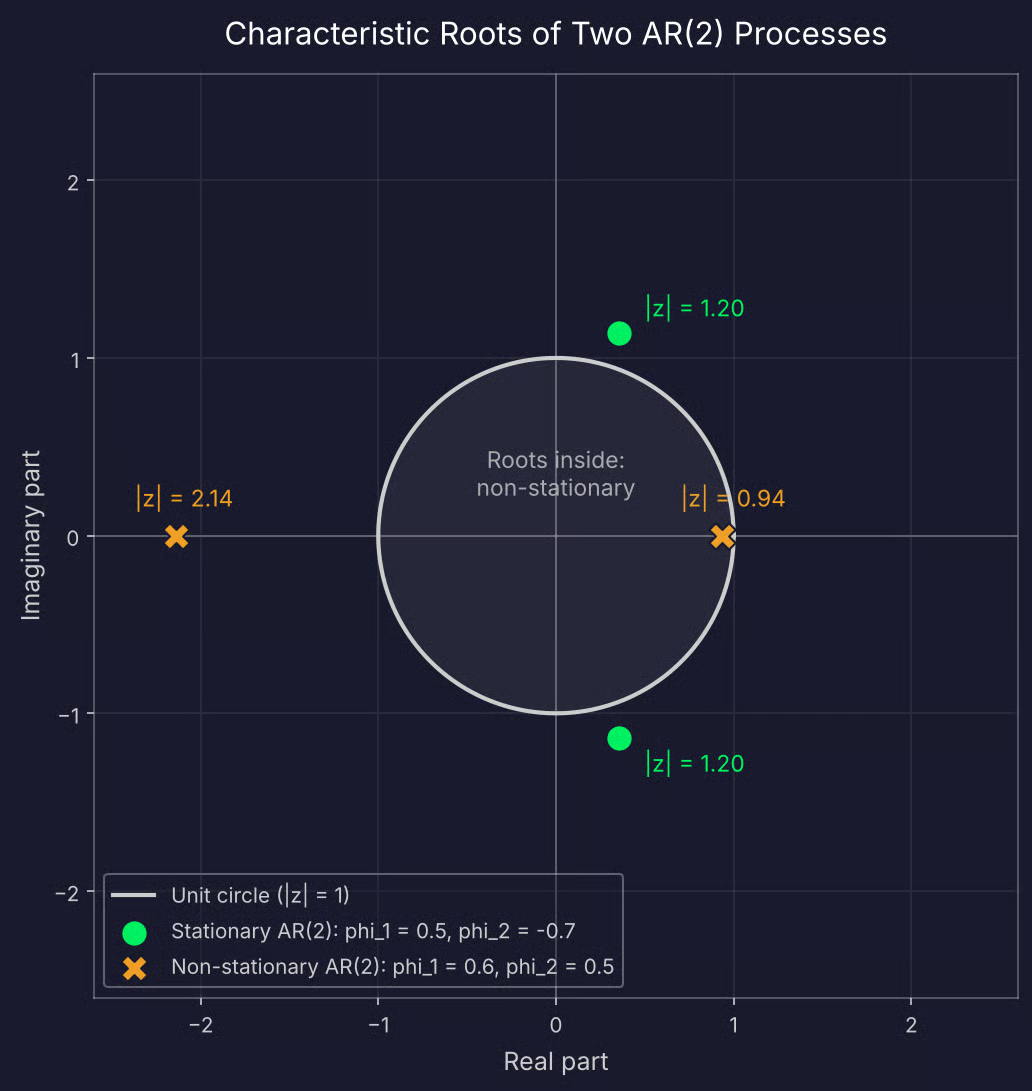
Raízes de um processo AR(2) estacionário e não estacionário
Você não vai calcular essas raízes na mão. O statsmodels retorna após o ajuste do modelo, e vou mostrar como testar a própria série para estacionariedade na seção de Python.
Se sua série não for estacionária, você pode diferenciá-la — subtrair cada valor do próximo — e modelar as diferenças. É isso que o "I" em modelos ARIMA significa.
Todo modelo AR tem a mesma equação. O que muda de um tipo para outro é a ordem p, ou seja, quantos valores passados o modelo usa.
AR(1) usa apenas o valor anterior para prever o próximo.
Se isso parece regressão linear, é porque é. Quando você coloca y_t-1 no eixo x e y_t no eixo y, AR(1) ajusta uma linha reta pelos pontos. A constante c é o intercepto, e phi_1 é o coeficiente angular. Se você conhece regressão linear simples, você já sabe como AR(1) é estimado.
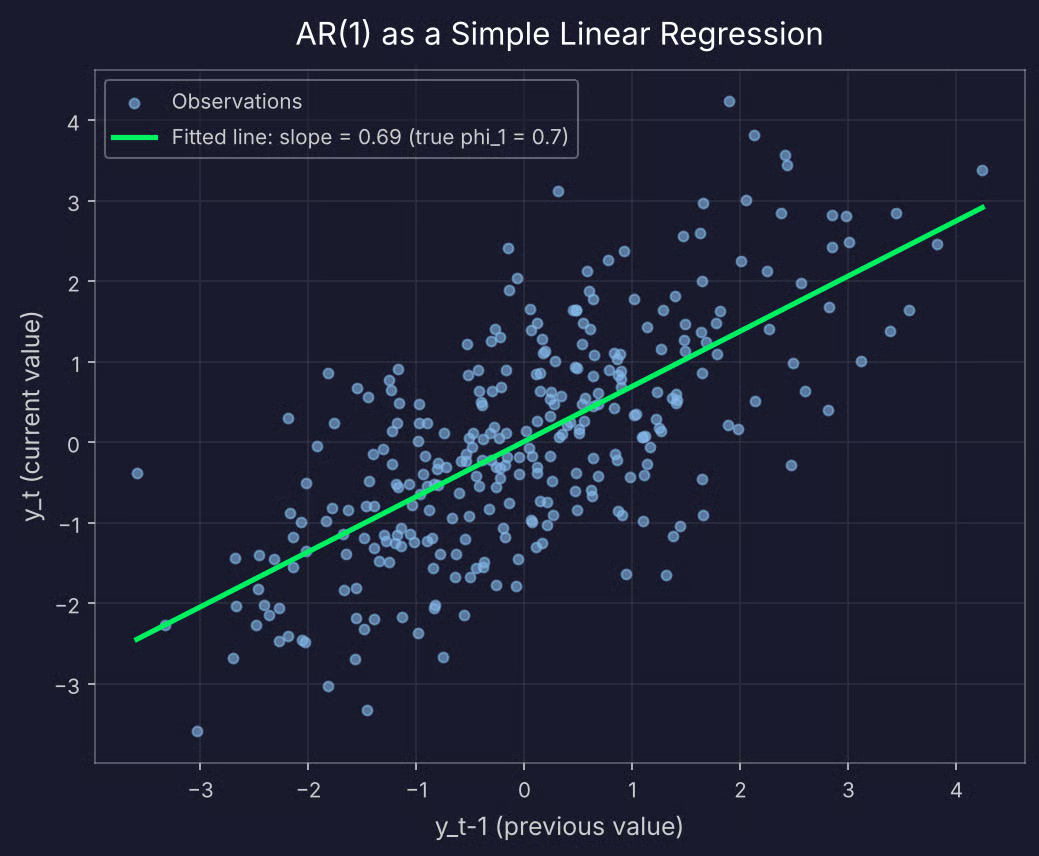
Gráfico de dispersão de y_t contra y_t-1 para AR(1)
Mas há uma diferença. Em uma regressão padrão, o preditor e o alvo são variáveis separadas. Em AR(1), o preditor é a mesma série deslocada em um passo. É por isso que você não pode embaralhar as linhas ou usar uma divisão aleatória de treino/teste — a ordem dos dados faz parte do modelo.
O valor de phi_1 muda a cara da série:
phi_1 = 0.3: A série parece quase ruído aleatório, já que cada valor carrega pouca informação sobre o próximo
phi_1 = 0.9: A série se move em oscilações longas e suaves e demora a voltar à média
phi_1 = -0.8: A série ziguezagueia acima e abaixo da média em quase todo passo
phi_1 = 1: A série vira um passeio aleatório e deriva sem média para retornar, que é o caso não estacionário da seção anterior
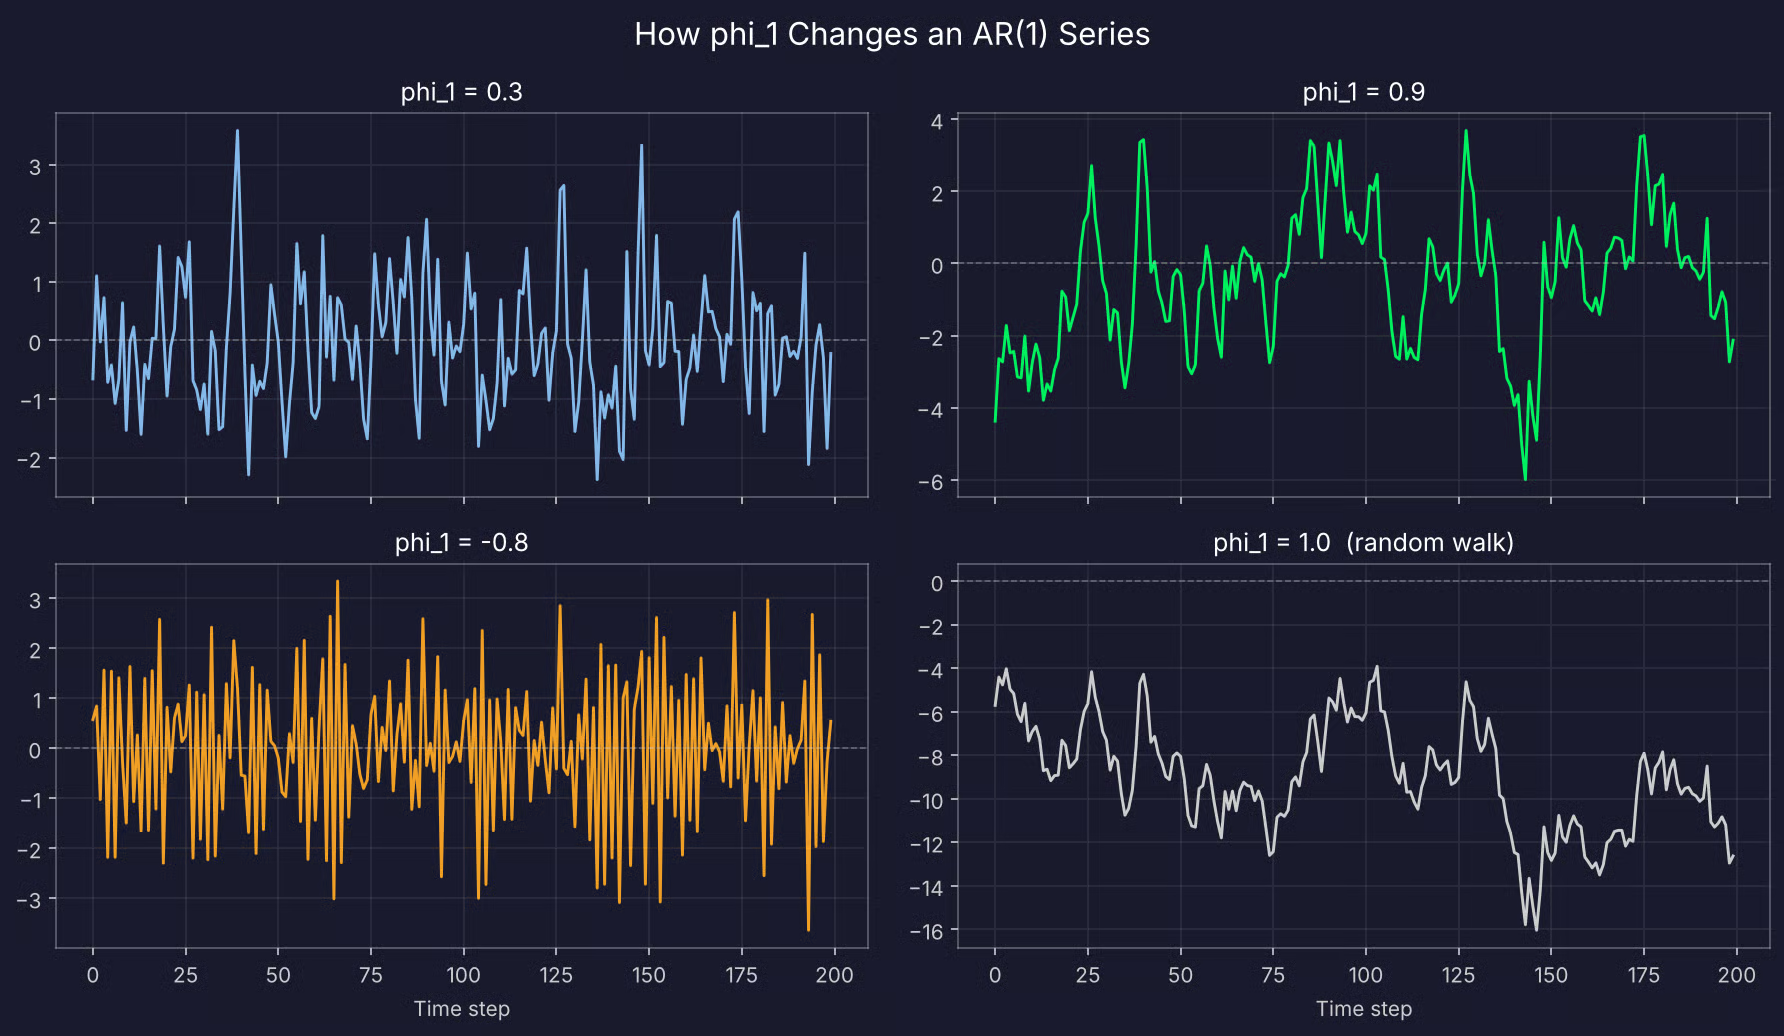
Quatro séries AR(1) simuladas
Quanto mais phi_1 se aproxima de 1 ou -1, mais tempo um único choque afeta a série.
AR(2) usa os dois valores anteriores. A segunda defasagem permite padrões que AR(1) não produz, principalmente ciclos.
Veja como dois conjuntos de coeficientes se comparam:
phi_1 = 0.5, phi_2 = 0.3: Ambas as defasagens empurram na mesma direção, então a série parece um AR(1) com oscilações mais longas e suaves
phi_1 = 0.5, phi_2 = -0.7: A segunda defasagem trabalha contra a primeira, e a série sobe e desce em ondas que se repetem aproximadamente a cada cinco passos
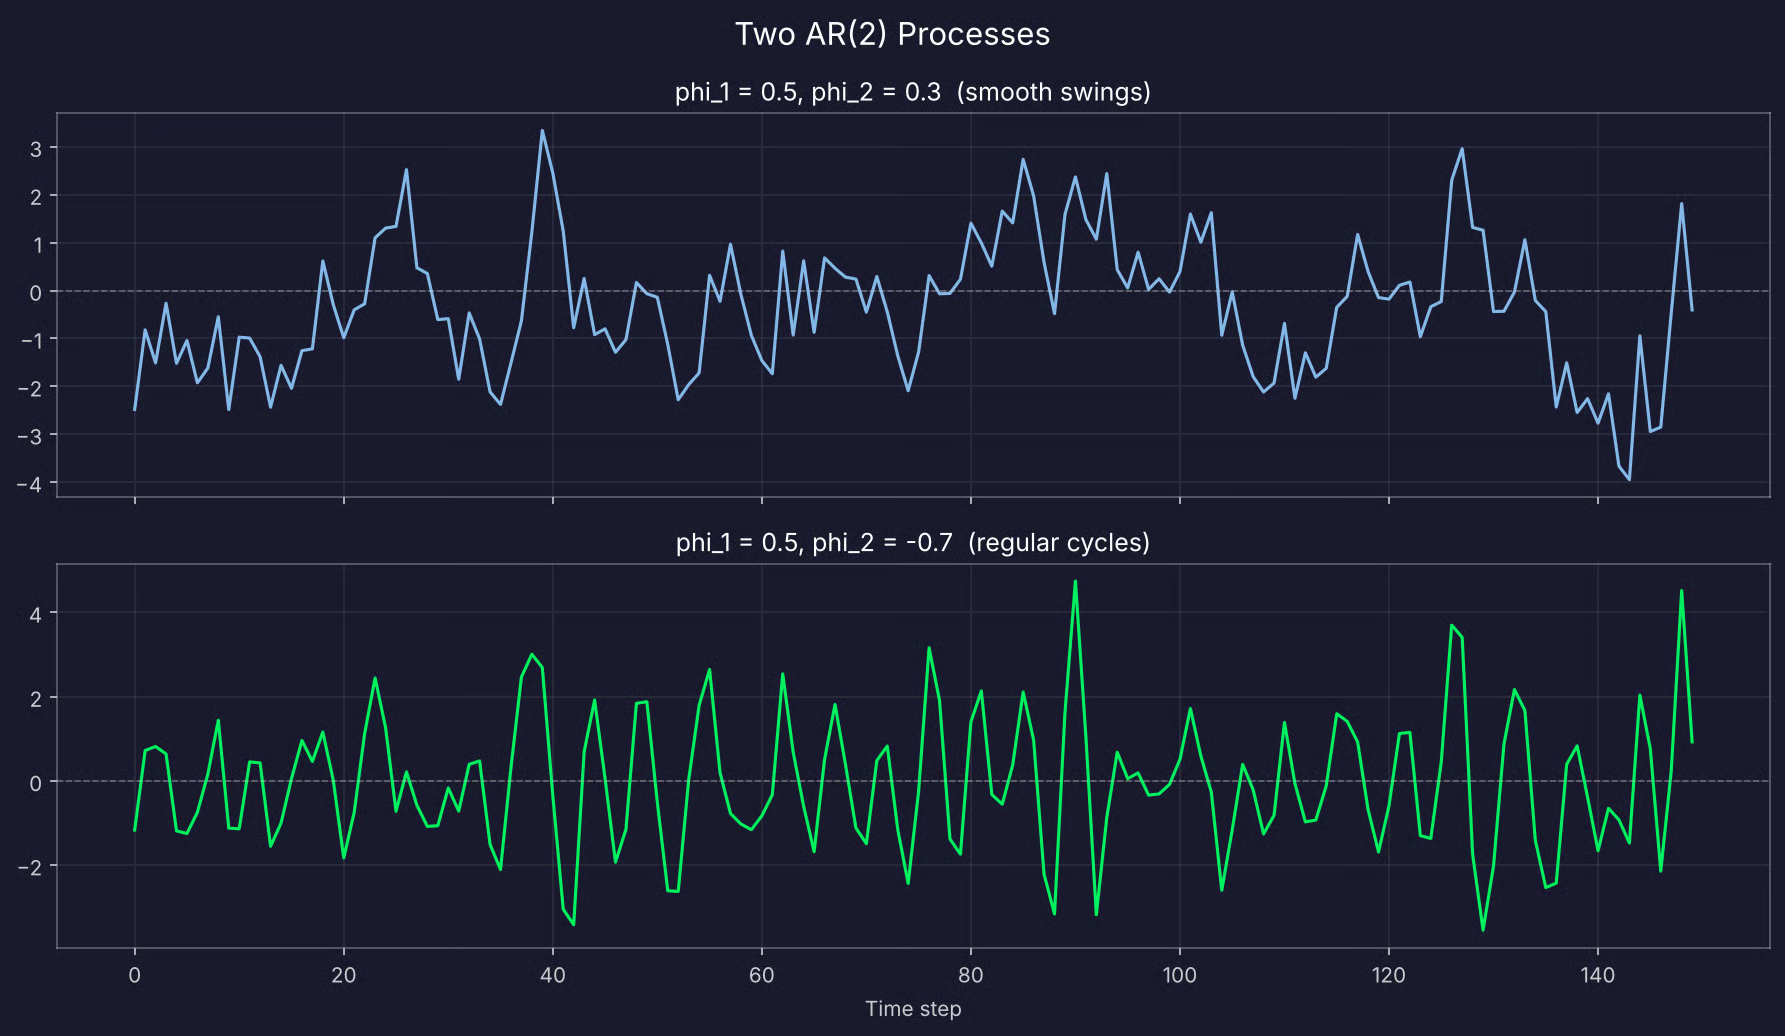
Duas séries AR(2) simuladas
AR(3), AR(4) e adiante adicionam uma defasagem por vez. Você precisa deles quando valores mais distantes carregam informação que os recentes não trazem.
Suponha que você modele vendas mensais e o mesmo mês do ano passado seja um bom preditor deste mês. Um AR(12) inclui essa defasagem de 12 meses, junto com as 11 intermediárias.
Cada defasagem extra adiciona um coeficiente a estimar. Isso exige mais dados e aumenta o risco de overfitting. Os coeficientes também ficam mais difíceis de interpretar — com 12 deles, você não consegue olhar os números e dizer o que a série fará. Você passa a checar as raízes.
Vou mostrar como escolher a ordem certa com PACF e AIC na seção de Python.
Modelos AR aparecem onde os dados têm ordem e o passado recente diz algo sobre o futuro próximo.
A maioria dos usos cai em quatro grupos:
O último surpreende muita gente, porque o termo por trás dos chatbots de hoje vem da mesma estatística de que estamos falando aqui.
Nesta seção, vou ajustar um modelo autorregressivo no Python com statsmodels, do dado bruto até uma previsão que você pode avaliar.
Você precisa de pandas e NumPy para os dados, statsmodels para o modelo e testes, e scikit-learn para a métrica de erro:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorVou simular dois anos de demanda diária de eletricidade a partir de um processo AR(2).
Optei por dados simulados porque você conhece os coeficientes verdadeiros de antemão. Assim, dá para verificar se o modelo os encontra e se as ferramentas de seleção de defasagens apontam a ordem correta.
O processo tem c = 15, phi_1 = 0,6 e phi_2 = 0,25, o que coloca a média de longo prazo em 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()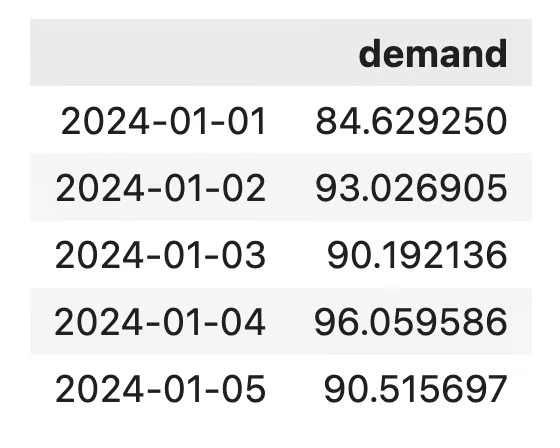
O dataset de demanda diária de eletricidade
Os primeiros 100 dias simulados são removidos porque esse período de aquecimento dá tempo para a série se estabilizar antes de começar a usá-la.
Veja como a série completa fica:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()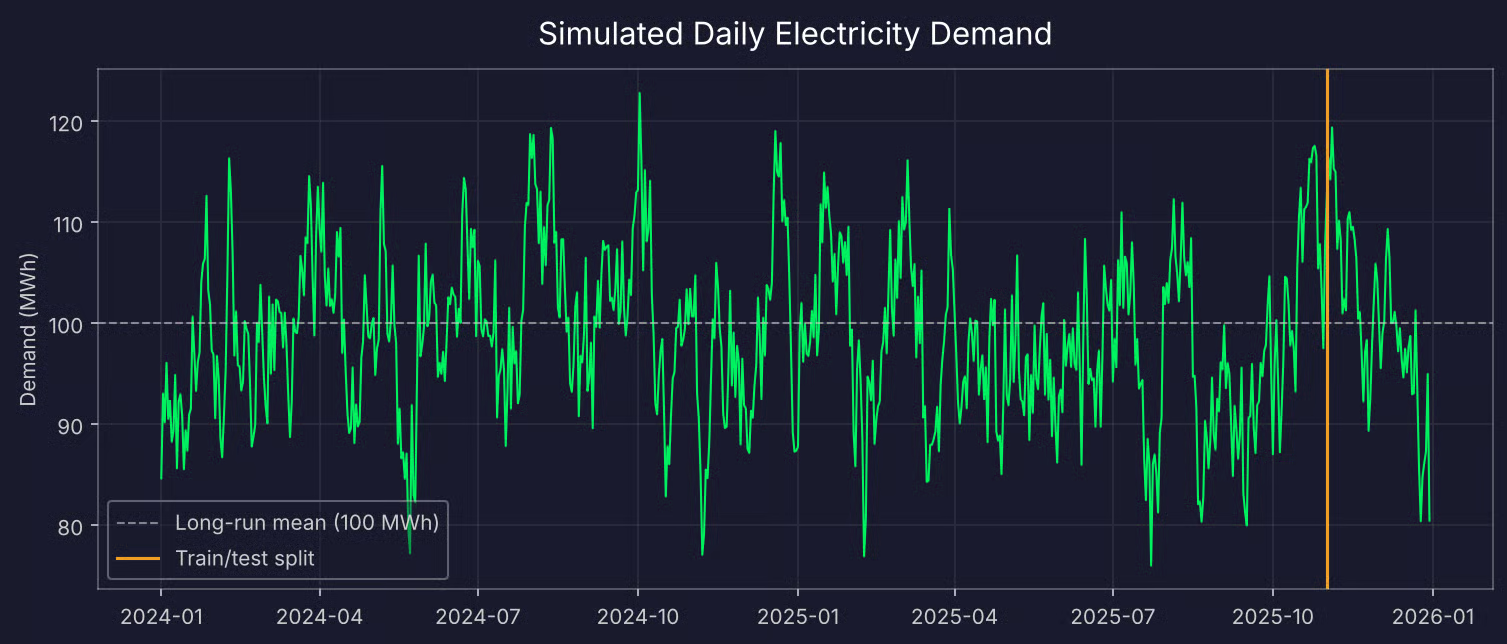
Dois anos de demanda diária de eletricidade simulada
A série oscila em torno de 100 sem tendência, que é o esperado de uma série estacionária. Mas inspeção visual não é prova.
O teste de Dickey-Fuller aumentado (ADF) verifica se uma série é estacionária. A hipótese nula é que a série não é estacionária, então um p-valor pequeno é o que você quer:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")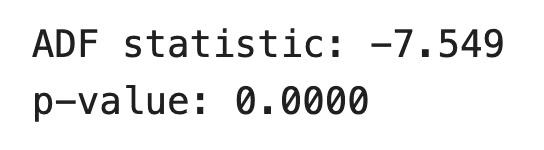
Resultados do teste ADF
O p-valor está bem abaixo de 0,05, então você pode rejeitar a hipótese nula e tratar a série como estacionária.
Se seus próprios dados falharem nesse teste, diferencie com df["demand"].diff().dropna() e rode o teste de novo.
Dados de séries temporais não podem ser embaralhados, então o conjunto de teste precisa vir do final da série. Vou reservar os últimos 60 dias para teste:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Isso deixa 670 dias para treino e 60 para teste.
Esta é a etapa que decide o quão bem o modelo funciona. Se você escolhe poucas defasagens, o modelo perde padrões. Se escolhe demais, ajusta ruído do treino que não se repete no futuro.
Você tem duas ferramentas para isso.
A primeira é a função de autocorrelação parcial (PACF). Ela mostra a correlação entre a série e cada defasagem após remover o efeito das defasagens menores. Para um processo AR(p), a PACF tem picos significativos até a defasagem p e cai próximo de zero depois disso:
plot_pacf(train, lags=20, method="ywm")
plt.show()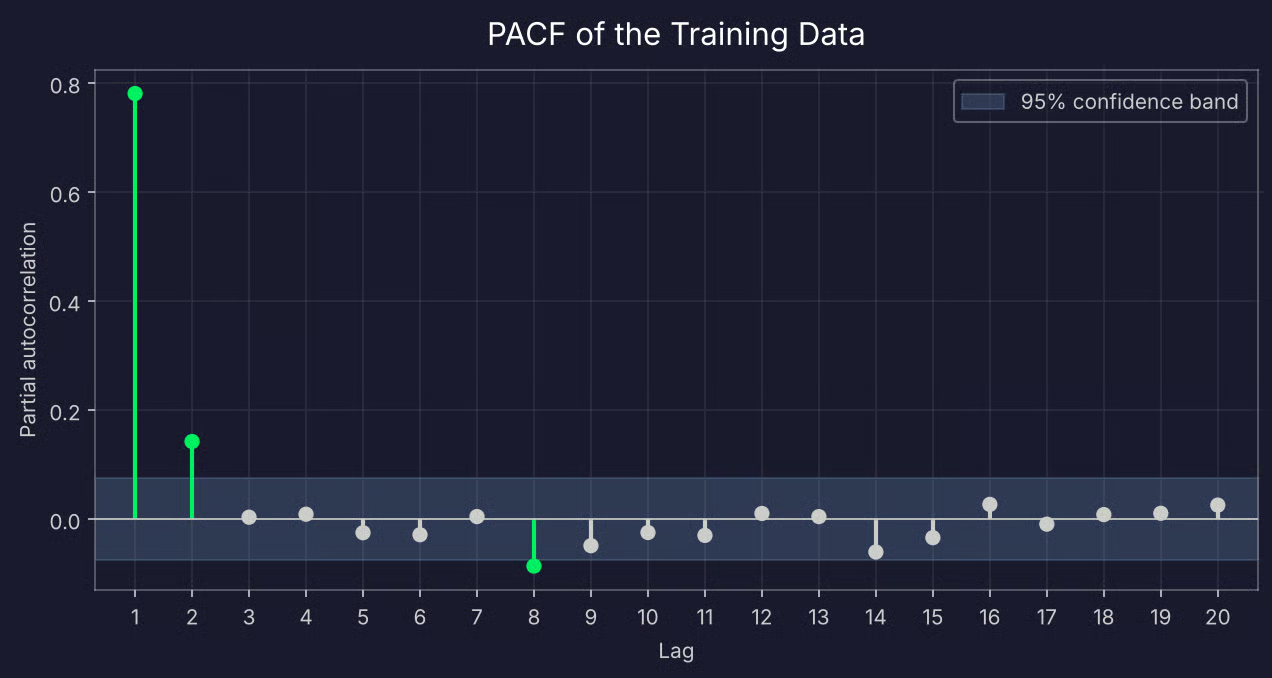
PACF dos dados de treino
As defasagens 1 e 2 estão bem fora da faixa de confiança, e a 3 cai perto de zero. Isso aponta para AR(2).
Há também um pequeno pico na defasagem 8, logo além da faixa. Não leia demais. A faixa é traçada a 95% de confiança; com 20 defasagens, é esperado que cerca de uma ultrapasse por acaso.
A segunda ferramenta são os critérios de informação. AIC e BIC recompensam um bom ajuste e penalizam cada parâmetro extra. BIC penaliza mais, então tende a escolher modelos menores. O statsmodels pode testar todas as ordens até um máximo e retornar a melhor:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")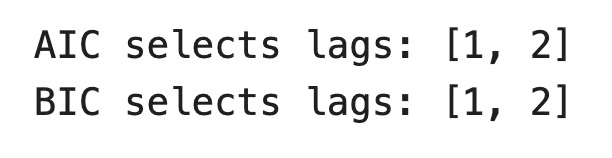
Seleção de defasagens por AIC/BIC
Ambos os critérios concordam com a PACF. Na prática, o AIC costuma escolher um modelo um pouco maior que o BIC. Se isso acontecer, comece pelo menor.
Com a ordem escolhida, ajustar o modelo leva duas linhas:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")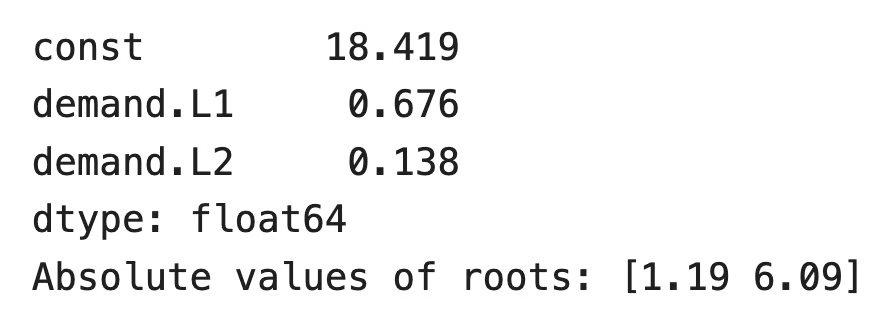
Parâmetros do modelo AR(2)
Os valores verdadeiros são 0,6 e 0,25. O modelo dá um pouco mais de peso à primeira defasagem e menos à segunda, mas a soma dos coeficientes fica próxima — 0,81 versus 0,85. Com 670 pontos, você não recupera exatamente os valores verdadeiros.
Ambas as raízes têm módulo maior que 1, então o modelo ajustado é estacionário. Você pode chamar results.summary() se quiser erros-padrão, p-valores e a tabela completa de raízes.
Há duas formas de prever o período de teste, e elas respondem a perguntas diferentes:
Previsões multi-step vêm direto dos resultados ajustados. Para previsões one-step, você aplica os coeficientes treinados à série completa:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")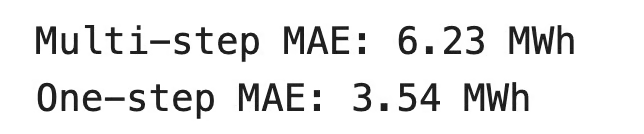
Resultados das previsões
Erro absoluto médio (MAE) é a diferença absoluta média entre previsões e valores reais. Está na mesma unidade dos dados, então dá para ler direto. A previsão one-step erra 3,54 MWh em média.
Veja como ambas as previsões se comparam aos valores reais:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()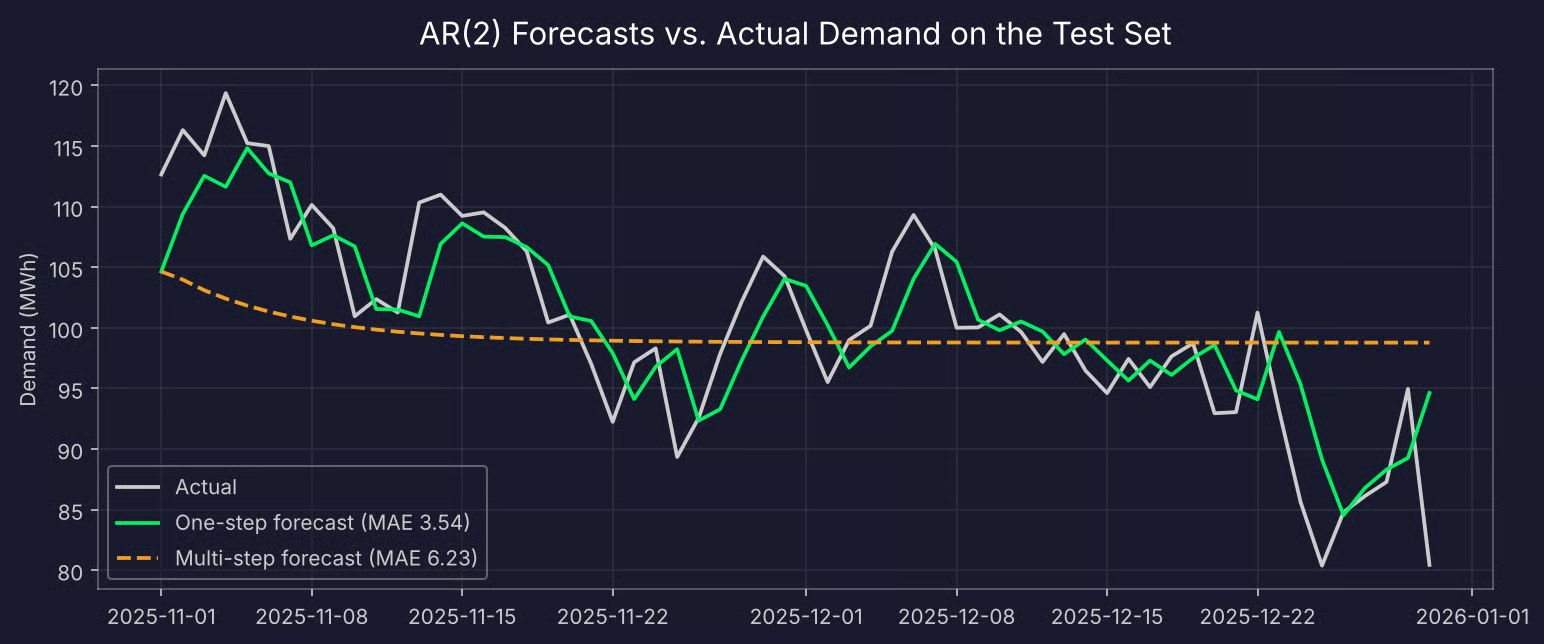
Previsões AR(2) one-step e multi-step comparadas à demanda real
A previsão one-step acompanha de perto os valores reais, com cerca de um dia de atraso. A multi-step começa no último valor conhecido e depois achata perto da média em cerca de três semanas.
É assim que todo AR estacionário se comporta — quanto mais longe você prevê, menos o passado informa, e o melhor palpite vira a média de longo prazo. Por isso AR funciona melhor para previsões de curto prazo.
É fácil supor que mais histórico significa previsões melhores. Vamos testar ajustando modelos com número crescente de defasagens e comparando o MAE one-step:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")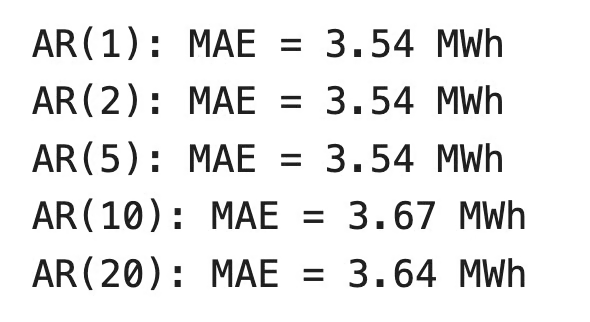
MAE com mais defasagens
O erro não melhora além de AR(2) e piora em AR(10) e AR(20). Esses coeficientes extras ajustam ruído do treino.
Você também nota que AR(1) vai tão bem quanto AR(2) aqui. O segundo coeficiente estimado é pequeno, então adiciona pouco neste conjunto de teste. Quando dois modelos performam igual, o mais simples é mais fácil de explicar e menos propenso a falhar em dados novos.
Há um custo também. AR(20) estima 21 parâmetros em vez de 3.
Em resumo, deixe a PACF e os critérios de informação sugerirem a ordem e confirme num conjunto de teste.
Modelos AR são ótimos para muitos problemas de previsão, mas não para todos. Veja onde funcionam, onde não funcionam e como se comparam aos modelos construídos sobre eles.
Modelos AR têm duas grandes vantagens:
Também têm duas limitações principais:
Há mais um problema. Valores defasados são correlacionados entre si porque vêm da mesma série. Nos dados de demanda, a correlação entre y_t-1 e y_t-2 é 0,78.
Isso é chamado de multicolinearidade, e afeta qualquer modelo de regressão. Quando dois preditores andam juntos, o modelo tem dificuldade de dizer qual é responsável. Os coeficientes ficam menos estáveis e seus erros-padrão aumentam.
Isso explica o que você viu antes. O modelo estimou 0,676 e 0,138 em vez de 0,6 e 0,25 — ele moveu peso de uma defasagem para a outra, mas a soma ficou próxima. As previsões não sofrem muito com isso, mas não dá para confiar tanto em coeficientes individuais. Cada defasagem extra piora o problema.
AR é um dos três blocos fundamentais da previsão clássica de séries temporais. Os outros dois são modelos de média móvel (MA) e ARIMA, que combina ambos.
Um AR prevê a partir de valores passados. Um MA prevê a partir de erros passados:
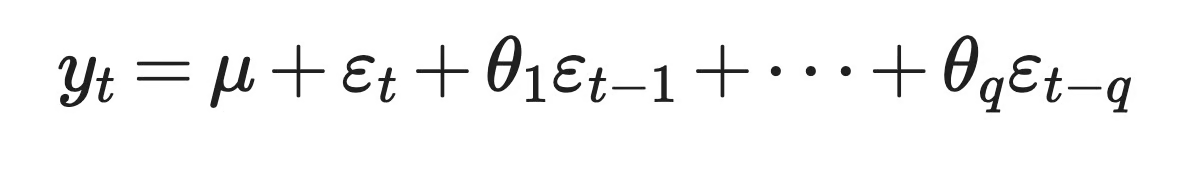
Modelo ARMA
Aqui, mu é a média da série, theta_1 a theta_q são os coeficientes, e epsilon_t-1 a epsilon_t-q são os choques aleatórios de passos anteriores. Não confunda com média móvel no sentido de média rolante. O nome é o mesmo, mas o modelo é outro.
Os dois modelos reagem a choques de maneiras diferentes. Em um MA(q), um choque afeta a série por exatamente q passos. Em AR, um choque se dissipa ao longo do tempo, mas nunca zera totalmente. Essa diferença também explica por que você usa ferramentas diferentes para escolher a ordem — a PACF corta após a defasagem p em AR, e a ACF corta após a defasagem q em MA.
ARIMA junta tudo. ARIMA(p, d, q) tem três partes:
Isso significa que AR é um caso especial de ARIMA. Se você define d e q como zero, obtém um AR. Você pode confirmar com os dados de demanda:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))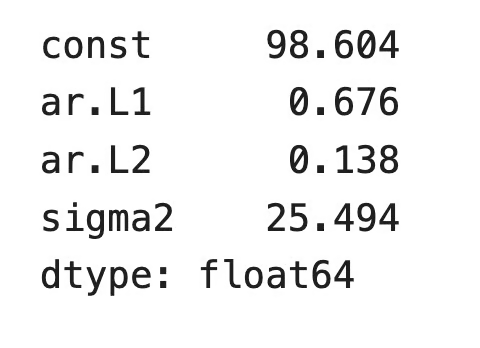
Modelo ARIMA com ordem de integração e média móvel 0
Os coeficientes AR batem com os do AutoReg. A constante difere porque ARIMA reporta a média da série, enquanto AutoReg reporta o intercepto c.
Agora vamos ver onde ARIMA vai além. Suponha que a cidade cresça e a demanda de eletricidade suba um pouco a cada dia. A série passa a ter tendência, o teste ADF falha e um AR não consegue mais trabalhar diretamente com a série.
Mas ARIMA(2, 1, 0) consegue. Ele diferencia a série uma vez, então o modelo trabalha com variações diárias em vez de valores brutos, e depois ajusta AR(2) nessas variações. Se um choque como uma onda de calor também afetar o dia seguinte, você pode adicionar um termo MA e obter ARIMA(2, 1, 1).
A parte AR faz o mesmo trabalho em todos os casos. ARIMA só prepara os dados para ela e modela o que sobra. Se quiser ir mais fundo, o curso ARIMA Models in R cobre o processo completo.
Um modelo autorregressivo prevê o próximo valor de uma série a partir do seu próprio passado. É uma regressão linear em que os preditores são cópias defasadas do alvo, e isso o torna um dos modelos de séries temporais mais fáceis de entender.
Você o verá em economia, codificação de fala, análise de EEG e até no nome dos modelos de linguagem atuais. Você também viu onde ele não é a melhor opção, pois precisa de dados estacionários, depende da ordem certa de defasagem e defasagens correlacionadas tornam coeficientes individuais menos confiáveis.
Se você entende modelos AR, o resto da previsão clássica fica bem mais fácil. ARIMA é o próximo passo natural, e nosso tutorial de ARIMA mostra como a diferenciação e os termos MA expandem o que você aprendeu aqui. Para uma trilha prática, experimente nosso curso ARIMA Models in Python.
Aprenda com a DataCamp
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
Avinash Navlani
10 min
Tutorial
Thushan Ganegedara
15 min
Tutorial
DataCamp Team
10 min
Tutorial
Elena Kosourova
8 min
Tutorial
Moez Ali
9 min