Kurs
Zeitreihenanalyse in Python
4 Std.
70.9K
Die meisten Online-Inhalte springen direkt zu ARIMA und schenken dem AR-Teil höchstens einen Satz. Dabei bildet AR das Fundament des Modells. Wenn du es nicht verstehst, wird der Rest von ARIMA ebenfalls keinen Sinn ergeben.
Ganz einfach gesagt: Ein autoregressives Modell sagt künftige Werte einer Zeitreihe anhand ihrer eigenen Vergangenheitswerte voraus. Du findest es in der Volkswirtschaft, im Finanzwesen, in der Signalverarbeitung und in Klimadaten. Im Kern ist es ein Regressionsmodell und verknüpft damit dein Wissen über Regression mit der Zeitreihenprognose – und es ist die Basis, auf der ARIMA aufbaut.
In diesem Artikel zeige ich dir, wie ein autoregressives Modell funktioniert, wie du es in Python mit statsmodels trainierst und wie du die passende Verzugsordnung auswählst.
Ein autoregressives Modell sagt den nächsten Wert einer Zeitreihe aus einer gewichteten Summe ihrer vorherigen Werte voraus.
Im Namen bedeutet „auto“ selbst und „Regression“ heißt, dass du eine Variable aus anderen vorhersagst. Ein autoregressives Modell ist also eine Regression einer Reihe auf ihre eigene Vergangenheit.
Angenommen, du willst die Stromnachfrage von morgen vorhersagen. Die heutige Nachfrage ist ein guter Startpunkt, und die gestrige liefert zusätzliche Information. Ein autoregressives Modell gießt diese Intuition in eine Formel und lernt die Gewichte aus deinen Daten.
AR-Modelle werden als AR(p) geschrieben, wobei p die Ordnung des Modells ist. Die Ordnung gibt an, wie viele Vergangenheitswerte das Modell nutzt:
p WerteEine höhere Ordnung ist nicht automatisch besser. Später im Artikel zeige ich dir, wie du p auswählst.
So sieht die allgemeine Form eines AR(p)-Modells aus:
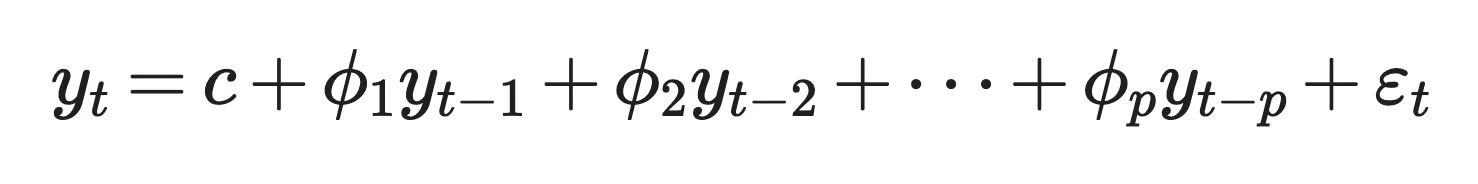
Das allgemeine AR(p)-Modell
Das bedeuten die Terme:
y_t: Der Wert der Reihe zum Zeitpunkt t – der Zielwert der Vorhersage
c: Eine Konstante, die zusammen mit den Koeffizienten den langfristigen Mittelwert der Reihe bestimmt
phi_1 bis phi_p: Die Koeffizienten, die angeben, wie stark jeder Vergangenheitswert zur Prognose beiträgt
y_t-1 bis y_t-p: Die verzögerten Werte; „Lag“ bezeichnet, wie viele Schritte du zurückgehst
epsilon_t: Weißes Rauschen, also ein Zufallsfehler mit Mittelwert null, konstanter Varianz und ohne zeitliche Korrelation
Einfach gesagt multipliziert das Modell jeden der letzten p Werte mit seinem Gewicht und addiert die Konstante. Der Rest ist Rauschen – der Teil von y_t, den die Vergangenheit nicht erklärt.
AR(1) ist die einfachste Variante:
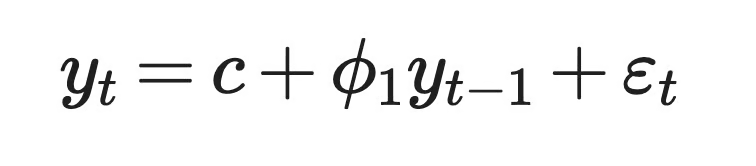
AR(1)-Modell
Der Wert von phi_1 steuert, wie stark das Heute das Morgen beeinflusst.
Angenommen, c = 2 und phi_1 = 0.8. Wenn der heutige Wert 15 ist, prognostiziert das Modell 2 + 0,8 × 15 = 14 für morgen. Die nächste Prognose ist 2 + 0,8 × 14 = 13,2. Jeder Schritt bringt die Reihe näher an 10 heran – ihren langfristigen Mittelwert c / (1 - phi_1).
Ist phi_1 negativ, springt die Reihe von einem Schritt zum nächsten über und unter den Mittelwert.
AR(2) fügt einen zweiten Lag hinzu:
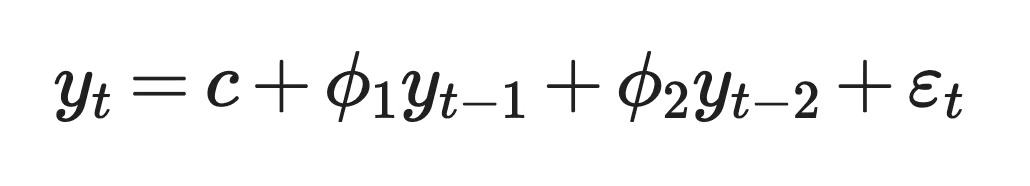
AR(2)-Modell
Mit zwei Lags kann das Modell Muster beschreiben, die AR(1) nicht erfasst – etwa Zyklen. Ein positives phi_1 mit negativem phi_2 kann eine Reihe erzeugen, die wellenförmig steigt und fällt – ähnlich einem Konjunkturzyklus.
Am Ende läuft jedes AR-Modell auf zwei Entscheidungen hinaus: Wie viele Lags nutzt du – und welche Gewichte bekommen sie?
Ein AR-Modell funktioniert nur, wenn zwei Dinge in deinen Daten zutreffen: Vergangenheitswerte müssen mit Zukunftswerten zusammenhängen, und die Reihe muss sich über die Zeit ähnlich verhalten. Ersteres nennt man Autokorrelation, letzteres Stationarität.
Autokorrelation ist die Korrelation zwischen einer Zeitreihe und einer verzögerten Kopie von ihr selbst.
Sie ist der Grund, warum AR-Modelle existieren. Wenn der heutige Wert nichts über morgen verrät, kann das Modell aus der Vergangenheit nichts lernen.
Im Code nimmst du eine Spalte mit Werten, kopierst sie und verschiebst die Kopie um eine Zeile nach unten. Jetzt paart jede Zeile einen Wert mit seinem Vorgänger. Die Korrelation zwischen beiden Spalten ist die Autokorrelation mit Lag 1. Verschiebst du um zwei Zeilen, erhältst du die Autokorrelation mit Lag 2.
So sieht das in pandas aus:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))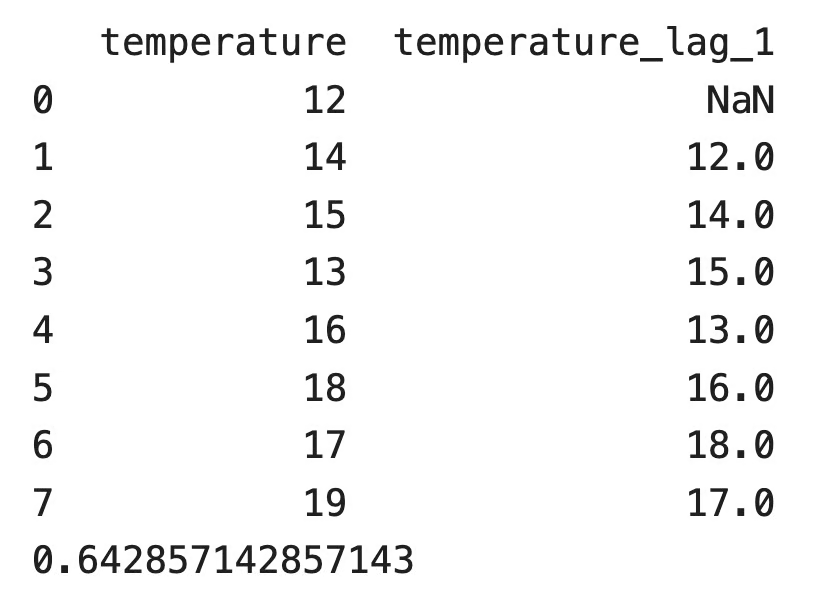
DataFrame mit der Temperaturspalte und ihrer Lag-1-Kopie
Die erste Zeile der verzögerten Spalte ist leer, weil es vor dem ersten Wert keine Messung gibt. pandas überspringt diese Zeile und liefert eine Lag-1-Autokorrelation von 0,643. In dieser Reihe folgen auf warme Tage tendenziell wieder warme Tage.
Das Vorzeichen der Autokorrelation verändert das Verhalten der Reihe:
Eine Autokorrelation nahe null bedeutet, die Vergangenheit hilft nicht weiter. Dann wird ein AR-Modell kaum besser sein als der Durchschnitt.
AR-Modelle benötigen eine stationäre Zeitreihe.
Eine stationäre Reihe hat denselben Mittelwert, dieselbe Varianz und dieselbe Autokorrelation bei einem gegebenen Lag – egal, welchen Abschnitt du betrachtest. Statistiker nennen das schwache Stationarität.
Das ist wichtig, weil das Modell einen festen Satz an Koeffizienten schätzt. Wenn der Mittelwert der Reihe über die Zeit driftet, beschreiben Koeffizienten aus alten Daten die neuen Daten nicht mehr. Aktienkurse sind ein typisches Beispiel für Nicht-Stationarität, weil sie über Jahre trenden. Tagesrenditen sind deutlich näher an stationär.
Ob ein AR-Prozess stationär ist, entscheiden die Koeffizienten. Für AR(1) ist die Regel einfach: phi_1 muss zwischen -1 und 1 liegen.
abs(phi_1) < 1: Schocks klingen mit der Zeit ab, und die Reihe kehrt zu ihrem Mittel zurück
phi_1 = 1: Die Reihe wird zu einer Random Walk, Schocks klingen nie ab
abs(phi_1) > 1: Jeder Schock verstärkt sich, die Reihe „explodiert“
AR(2) erfordert drei Bedingungen gleichzeitig: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 und abs(phi_2) < 1.
Ab zwei Lags brauchst du eine allgemeine Regel. Jedes AR(p)-Modell hat ein charakteristisches Polynom:
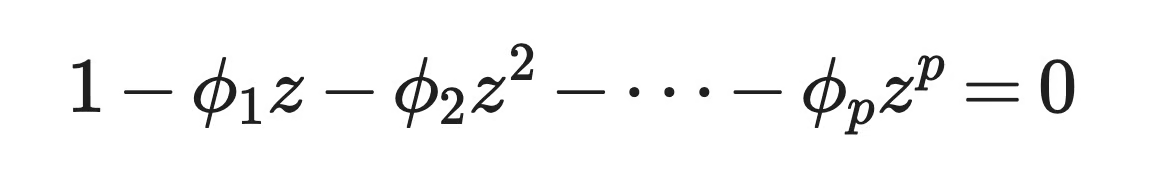
Charakteristisches Polynom
Der Prozess ist schwach stationär, wenn alle Nullstellen dieses Polynoms außerhalb des Einheitskreises liegen – also wenn jede Wurzel z einen Betrag größer als 1 hat. Die Wurzeln können komplex sein, deshalb ist die Grenze ein Kreis in der komplexen Ebene und keine Linie.
Das lässt sich mit AR(1) nachprüfen. Das Polynom ist 1 - phi_1 z = 0, also ist die Wurzel z = 1 / phi_1. Diese liegt nur dann außerhalb des Einheitskreises, wenn abs(phi_1) < 1 – genau die vorherige Regel.
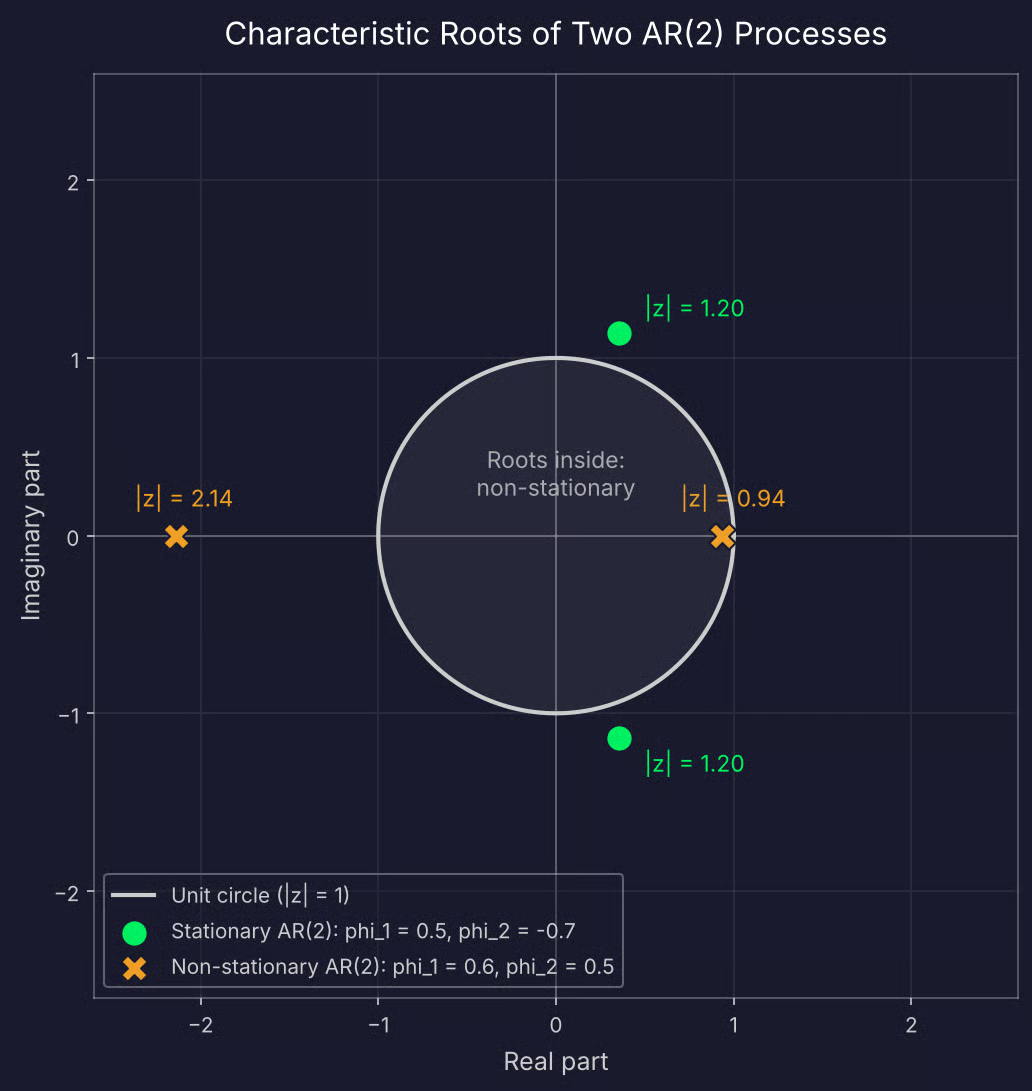
Wurzeln eines stationären und eines nicht-stationären AR(2)-Prozesses
Diese Wurzeln wirst du nicht per Hand berechnen. statsmodels gibt sie nach dem Fitten zurück, und im Python-Abschnitt zeige ich dir, wie du die Daten selbst auf Stationarität testest.
Ist deine Reihe nicht stationär, kannst du differenzieren – also jeden Wert vom nächsten abziehen – und die Differenzen modellieren. Dafür steht das „I“ in ARIMA-Modellen.
Alle AR-Modelle teilen sich dieselbe Gleichung. Was sich ändert, ist die Ordnung p – also die Anzahl der genutzten Vergangenheitswerte.
AR(1) nutzt nur den vorherigen Wert, um den nächsten vorherzusagen.
Das klingt nach linearer Regression – und das ist es auch. Wenn du y_t-1 auf die x-Achse und y_t auf die y-Achse setzt, legt AR(1) eine Gerade durch die Punkte. Die Konstante c ist der Achsenabschnitt, phi_1 die Steigung. Wenn du einfache lineare Regression kennst, weißt du bereits, wie AR(1) geschätzt wird.
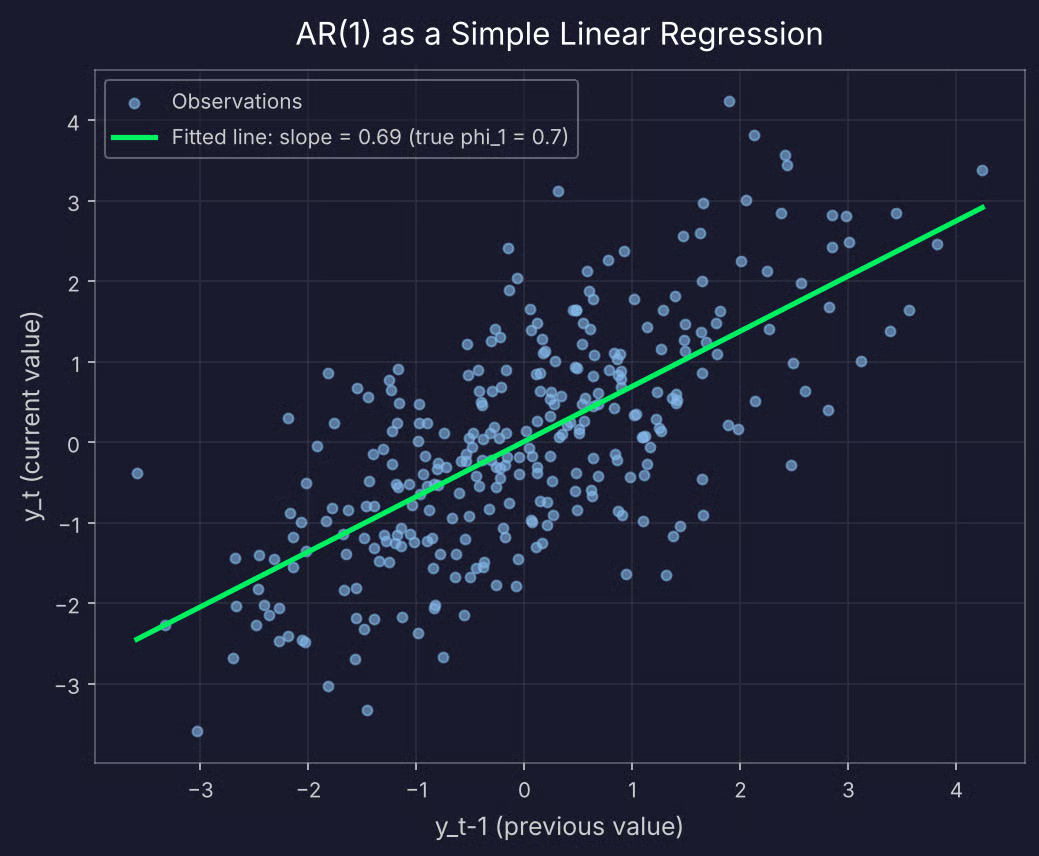
Streudiagramm von y_t gegen y_t-1 für AR(1)
Es gibt jedoch einen Unterschied: In der Standard-Regression sind Predictor und Target getrennte Variablen. In AR(1) ist der Prädiktor dieselbe Reihe, nur um einen Schritt verschoben. Deshalb kannst du die Zeilen nicht mischen oder einen zufälligen Train/Test-Split verwenden – die Reihenfolge der Daten ist Teil des Modells.
Der Wert von phi_1 verändert das Aussehen der Reihe:
phi_1 = 0.3: Die Reihe wirkt fast wie reines Rauschen, da jeder Wert wenig Information über den nächsten trägt
phi_1 = 0.9: Die Reihe bewegt sich in langen, glatten Schwüngen und braucht länger, um zum Mittel zurückzukehren
phi_1 = -0.8: Die Reihe zickzackt fast bei jedem Schritt über und unter den Mittelwert
phi_1 = 1: Die Reihe wird zu einem Random Walk und driftet ohne Rückkehr zum Mittel – der nicht-stationäre Fall von oben
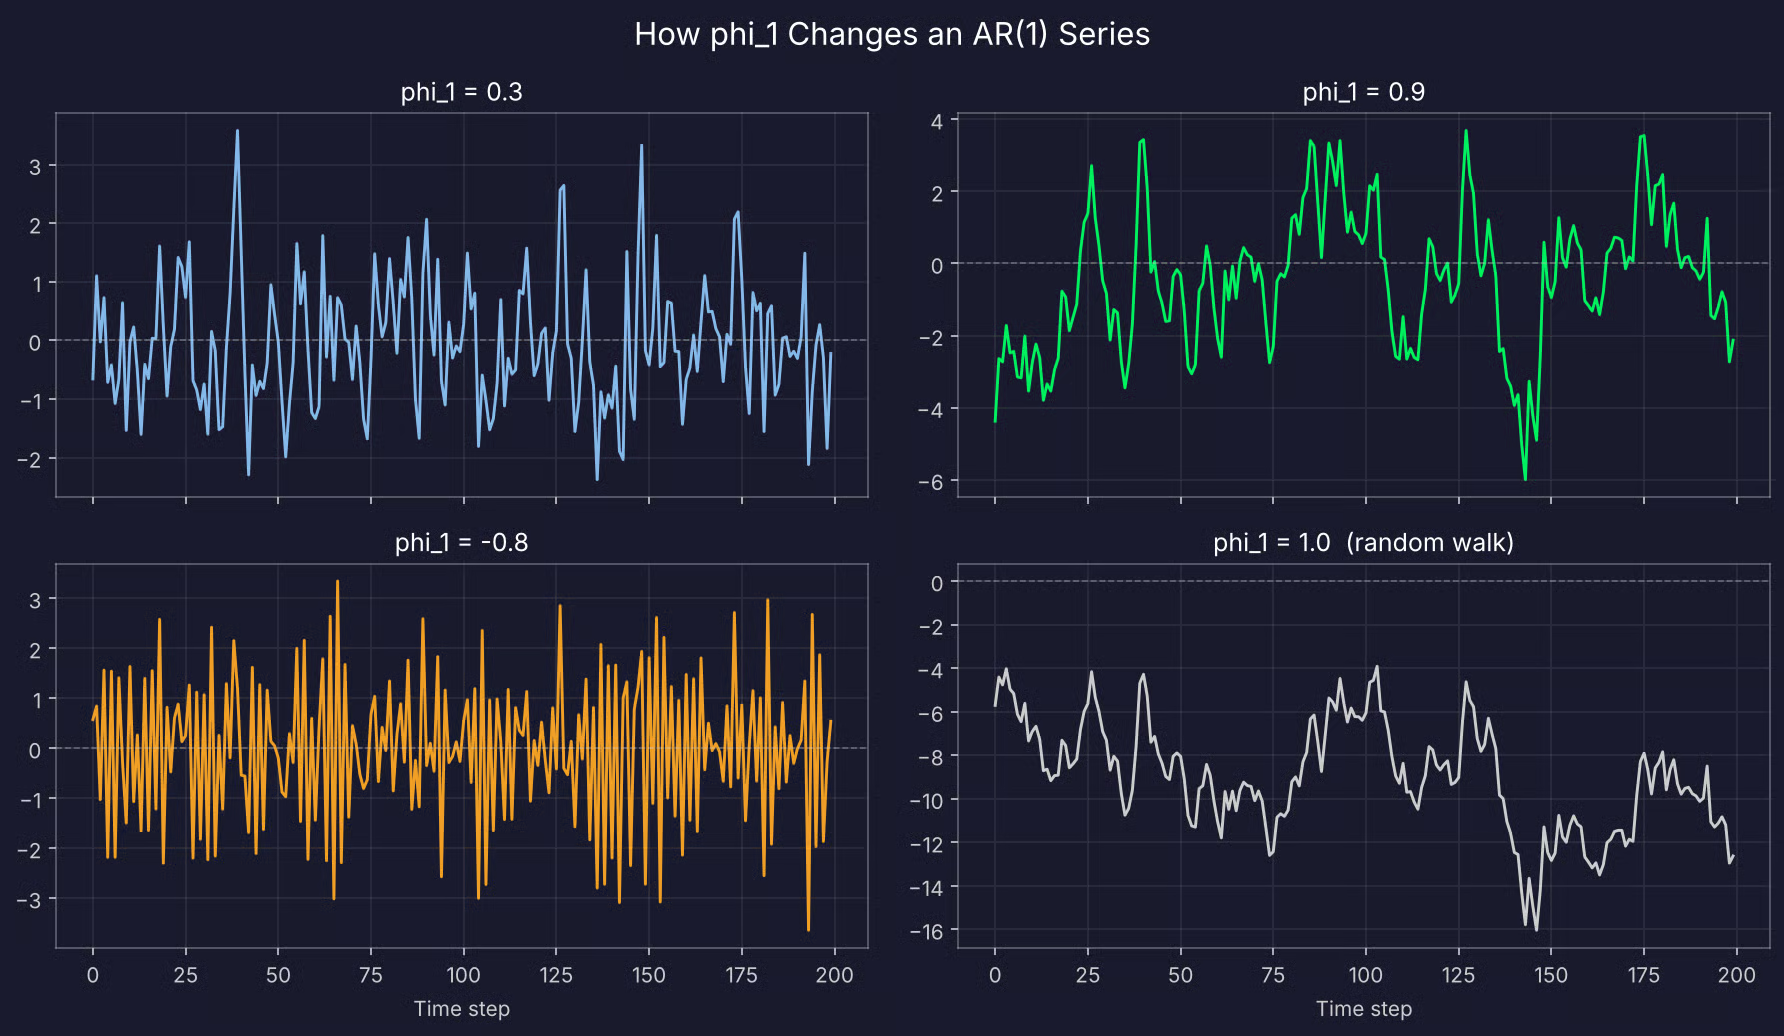
Vier simulierte AR(1)-Reihen
Je näher phi_1 an 1 oder -1 liegt, desto länger wirkt ein einzelner Schock nach.
AR(2) nutzt die zwei letzten Werte. Der zweite Lag ermöglicht Muster, die AR(1) nicht erzeugt – vor allem Zyklen.
So vergleichen sich zwei Koeffizientensätze:
phi_1 = 0.5, phi_2 = 0.3: Beide Lags ziehen in dieselbe Richtung – die Reihe ähnelt AR(1) mit längeren, glatteren Schwüngen
phi_1 = 0.5, phi_2 = -0.7: Der zweite Lag wirkt gegen den ersten, und die Reihe schwingt in Wellen, die sich etwa alle fünf Schritte wiederholen
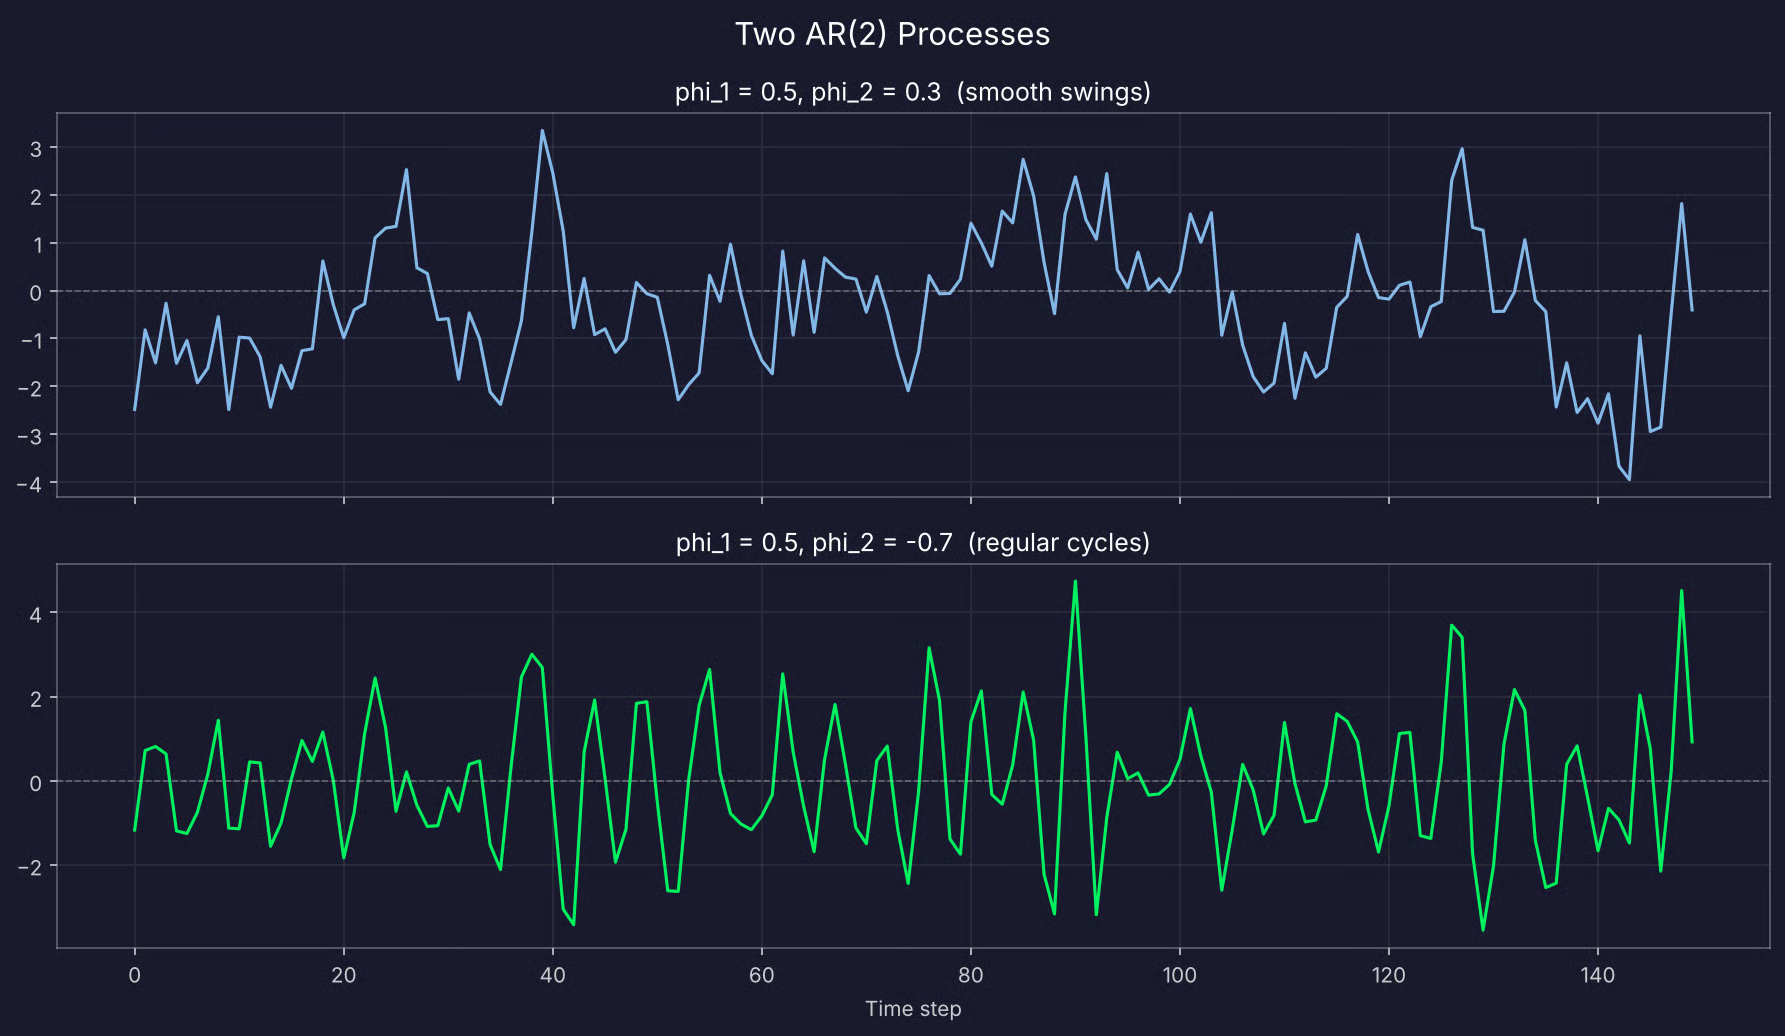
Zwei simulierte AR(2)-Reihen
AR(3), AR(4) und darüber hinaus fügen jeweils einen Lag hinzu. Du brauchst sie, wenn weiter zurückliegende Werte Informationen tragen, die in den jüngsten nicht enthalten sind.
Angenommen, du modellierst monatliche Umsätze, und derselbe Monat des Vorjahres sagt den aktuellen Monat gut voraus. Ein AR(12)-Modell enthält diesen 12-Monats-Lag plus die 11 dazwischenliegenden Lags.
Jeder zusätzliche Lag bringt einen weiteren zu schätzenden Koeffizienten mit. Du brauchst mehr Daten und erhöhst das Overfitting-Risiko. Außerdem werden die Koeffizienten schwerer lesbar – bei 12 Stück erkennst du am Zahlenbild nicht mehr intuitiv das Verhalten. Dann prüfst du die Wurzeln.
Wie du mit PACF und AIC die passende Ordnung wählst, zeige ich dir im Python-Teil.
AR-Modelle tauchen überall dort auf, wo Daten geordnet vorliegen und die jüngste Vergangenheit etwas über die nahe Zukunft verrät.
Die meisten Anwendungen fallen in eine dieser vier Gruppen:
Der letzte Punkt überrascht viele: Der Begriff hinter heutigen Chatbots stammt aus genau der Statistik, die du hier liest.
In diesem Abschnitt fitten wir ein autoregressives Modell in Python mit statsmodels – von Rohdaten bis zur bewertbaren Prognose.
Du brauchst pandas und NumPy für die Daten, statsmodels für Modell und Tests sowie scikit-learn für die Fehlermetrik:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorIch simuliere zwei Jahre tägliche Stromnachfrage aus einem AR(2)-Prozess.
Simulierte Daten nutze ich, weil die wahren Koeffizienten bekannt sind. So kannst du prüfen, ob das Modell sie findet und ob die Lag-Auswahlwerkzeuge die richtige Ordnung anzeigen.
Der Prozess hat c = 15, phi_1 = 0.6 und phi_2 = 0.25 – der langfristige Mittelwert liegt bei 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()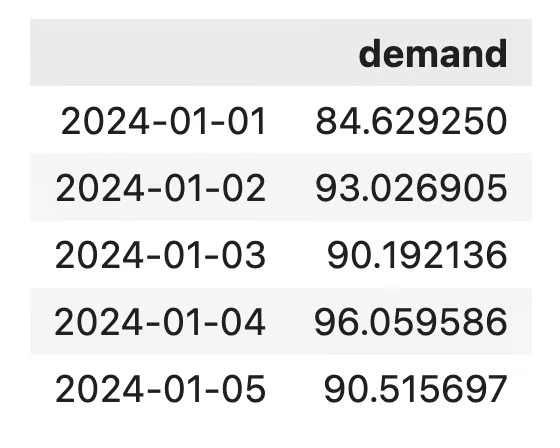
Der Datensatz zur täglichen Stromnachfrage
Die ersten 100 simulierten Tage werden entfernt. Diese Burn-in-Phase gibt der Reihe Zeit, sich einzupendeln, bevor du sie nutzt.
So sieht die komplette Reihe aus:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()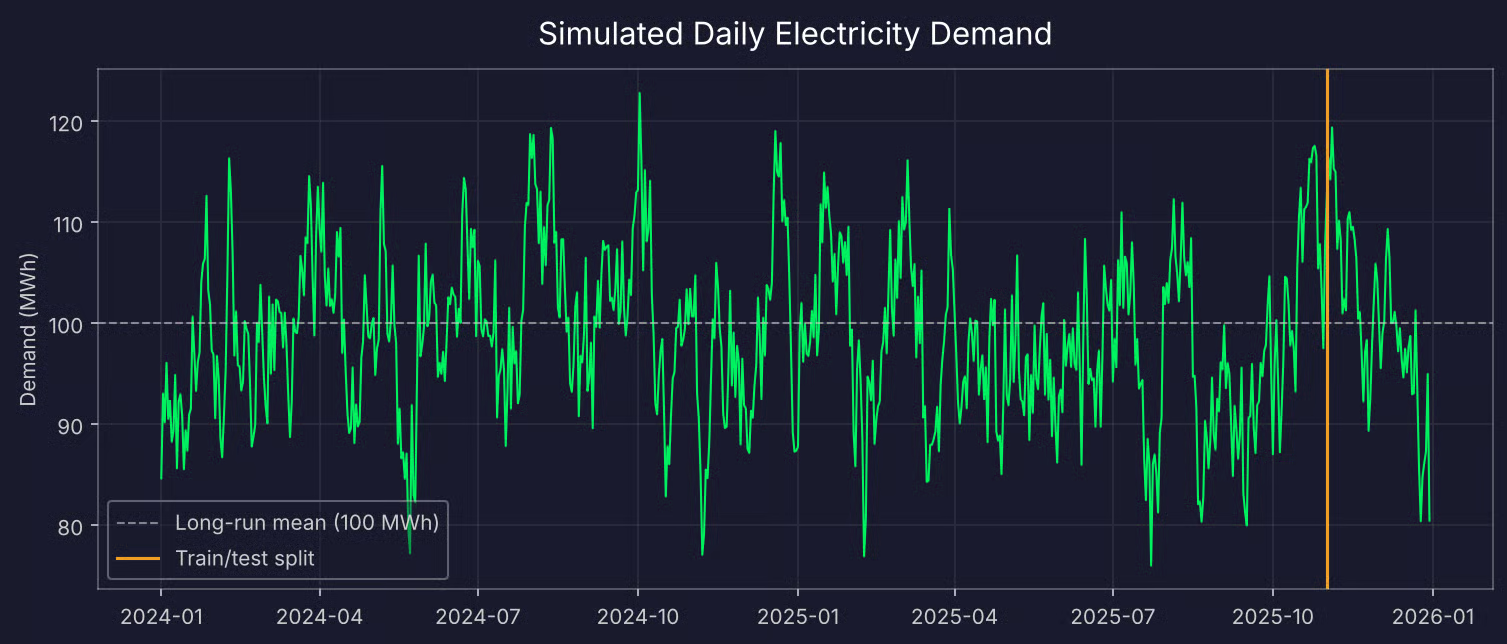
Zwei Jahre simulierte tägliche Stromnachfrage
Die Reihe schwankt um 100 ohne Trend – so sollte eine stationäre Reihe aussehen. Ein Blick reicht aber nicht als Beweis.
Der erweiterte Dickey-Fuller-Test (ADF) prüft, ob eine Reihe stationär ist. Die Nullhypothese lautet „nicht stationär“ – eine kleine p-Wert ist also das gewünschte Ergebnis:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")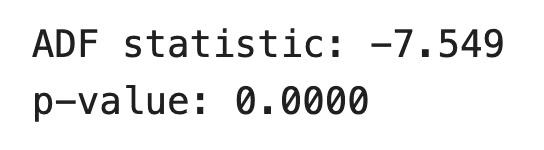
ADF-Testergebnisse
Der p-Wert liegt deutlich unter 0,05 – du kannst die Nullhypothese verwerfen und die Reihe als stationär behandeln.
Fallen deine eigenen Daten durch, differenziere mit df["demand"].diff().dropna() und führe den Test erneut aus.
Zeitreihendaten lassen sich nicht mischen, daher muss der Testsplit vom Ende der Reihe kommen. Ich behalte die letzten 60 Tage für den Test:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Es bleiben 670 Tage für das Training und 60 für den Test.
Dieser Schritt entscheidet über die Güte des Modells. Wählst du zu wenige Lags, verpasst das Modell Muster. Nimmst du zu viele, passt es Rauschen im Training an, das sich nicht wiederholt.
Dafür hast du zwei Werkzeuge.
Das erste ist die partielle Autokorrelationsfunktion (PACF). Sie zeigt die Korrelation zwischen der Reihe und jedem Lag, nachdem der Effekt aller kürzeren Lags entfernt wurde. Bei einem AR(p)-Prozess hat die PACF deutliche Ausschläge bis Lag p und fällt danach gegen null:
plot_pacf(train, lags=20, method="ywm")
plt.show()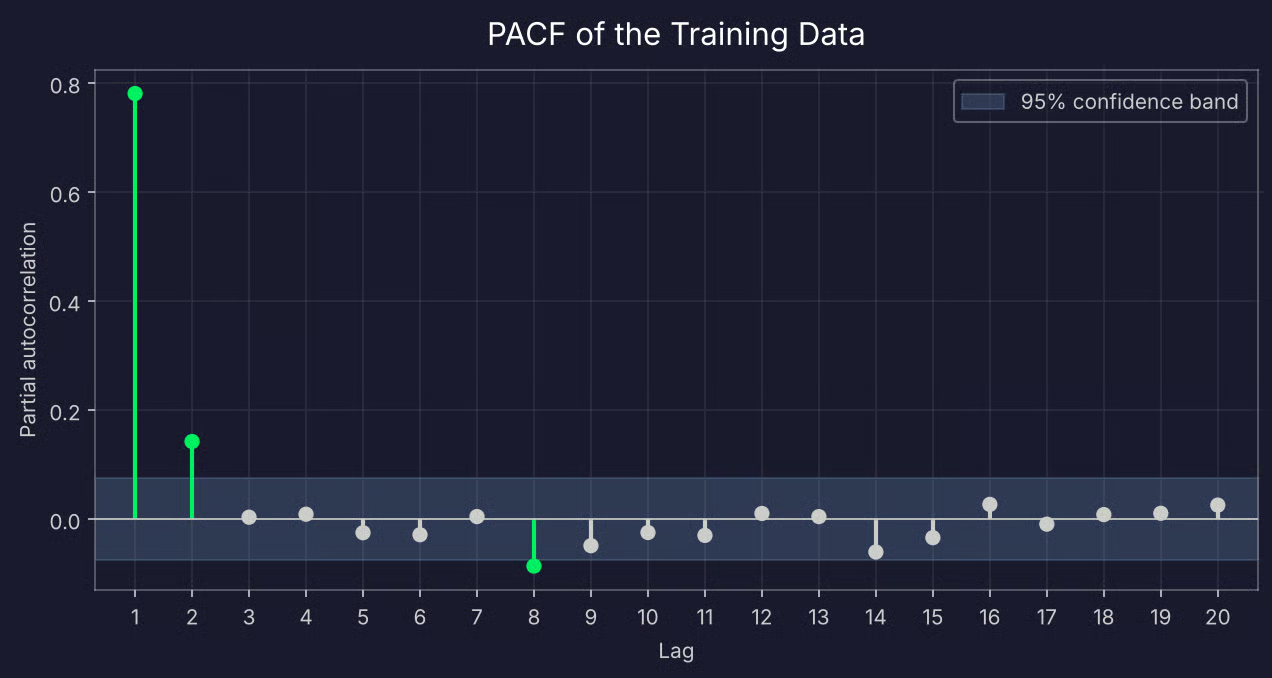
PACF der Trainingsdaten
Lags 1 und 2 liegen klar außerhalb des Konfidenzbandes, Lag 3 fällt nahe null. Das spricht für AR(2).
Bei Lag 8 gibt es einen kleinen Ausschlag, knapp außerhalb des Bandes. Lies nicht zu viel hinein. Das Band liegt bei 95% Konfidenz, also wird bei 20 Lags im Schnitt einer zufällig darüber liegen.
Das zweite Werkzeug sind Informationskriterien. AIC und BIC belohnen gute Anpassung und bestrafen jeden zusätzlichen Parameter. BIC bestraft stärker und wählt daher oft kleinere Modelle. statsmodels kann alle Ordnungen bis zu einem Maximum testen und die beste zurückgeben:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")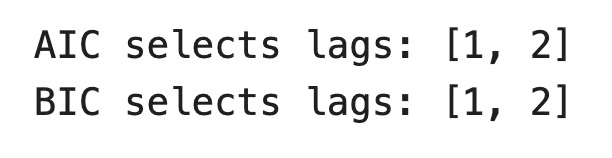
Lag-Auswahl mit AIC/BIC
Beide Kriterien stimmen mit der PACF überein. In der Praxis wählt AIC oft ein etwas größeres Modell als BIC. Starte in dem Fall mit dem kleineren.
Ist die Ordnung gewählt, braucht das Fitten nur zwei Codezeilen:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")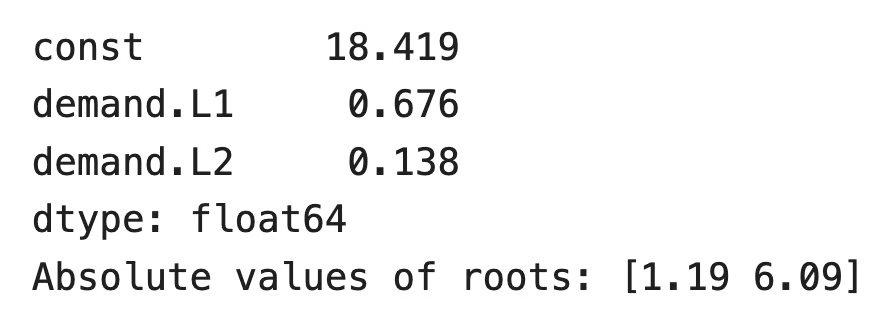
Parameter des AR(2)-Modells
Die wahren Werte sind 0,6 und 0,25. Das Modell gewichtet den ersten Lag etwas stärker und den zweiten schwächer, aber die Summe liegt nah beieinander – 0,81 gegenüber 0,85. Mit 670 Datenpunkten wirst du die exakten Werte nicht exakt wiederfinden.
Beide Wurzeln haben einen Betrag größer als 1 – das gefittete Modell ist stationär. Mit results.summary() bekommst du Standardfehler, p-Werte und die vollständige Wurzeltabelle.
Es gibt zwei Arten, den Testzeitraum zu prognostizieren – sie beantworten unterschiedliche Fragen:
Multi-Step-Prognosen kommen direkt aus den Fit-Ergebnissen. Für One-Step-Prognosen wendest du die gelernten Koeffizienten auf die vollständige Reihe an:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")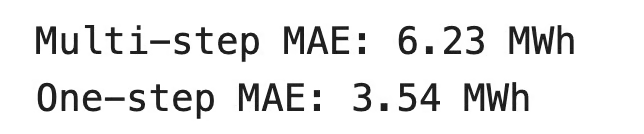
Prognoseergebnisse
Die mittlere absolute Abweichung (MAE) ist der durchschnittliche absolute Unterschied zwischen Prognose und Ist-Wert. Sie hat dieselbe Einheit wie die Daten – hier direkt ablesbar. Die One-Step-Prognose liegt im Schnitt um 3,54 MWh daneben.
So vergleichen sich beide Prognosen mit den Ist-Werten:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()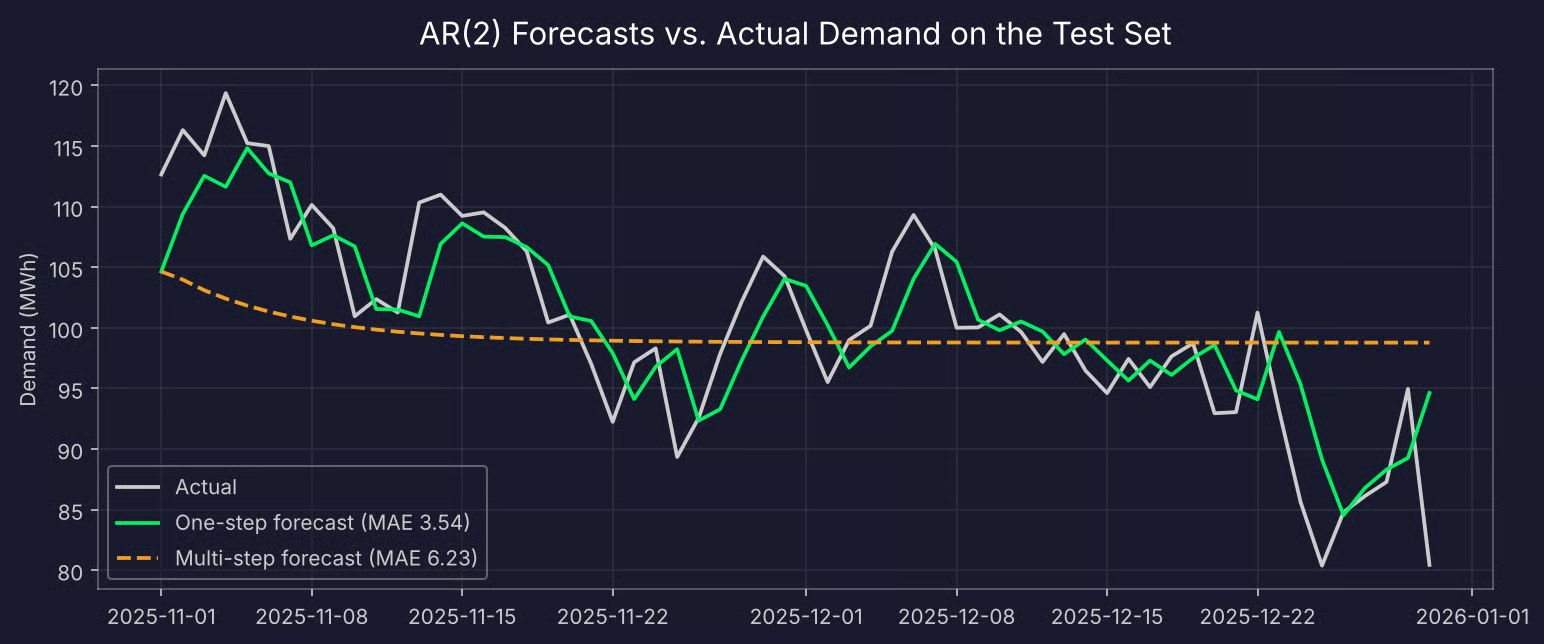
One-Step- und Multi-Step-AR(2)-Prognosen im Vergleich zur tatsächlichen Nachfrage
Die One-Step-Prognose folgt den Ist-Werten eng, etwa einen Tag versetzt. Die Multi-Step-Prognose startet beim letzten bekannten Wert und flacht binnen circa drei Wochen nahe dem Mittelwert ab.
So verhalten sich alle stationären AR-Modelle: Je weiter du in die Zukunft schaust, desto weniger sagt die Vergangenheit, und die beste Schätzung wird der langfristige Mittelwert. Deshalb eignen sich AR-Modelle besonders für kurzfristige Prognosen.
Es liegt nahe zu denken: Mehr Historie, bessere Vorhersagen. Testen wir das, indem wir Modelle mit steigender Lag-Anzahl fitten und ihre One-Step-MAE vergleichen:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")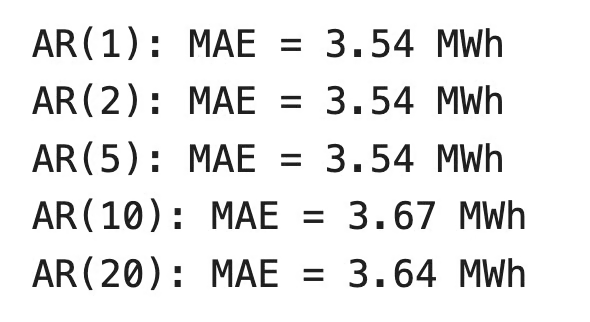
MAE mit mehr Lags
Über AR(2) hinaus verbessert sich der Fehler nicht, bei AR(10) und AR(20) wird er schlechter. Diese zusätzlichen Koeffizienten passen Rauschen an.
Auffällig ist auch: AR(1) schneidet hier so gut ab wie AR(2). Der geschätzte zweite Koeffizient ist klein und bringt auf diesem Testset wenig. Wenn zwei Modelle gleich gut abschneiden, ist das einfachere leichter erklärbar und robuster für neue Daten.
Hinzu kommt der Kostenaspekt: AR(20) schätzt 21 Parameter statt 3.
Kurz gesagt: Lass dir Ordnungsvorschläge von PACF und Informationskriterien geben und bestätige sie dann auf einem Testset.
AR-Modelle passen zu vielen Prognoseaufgaben, aber nicht zu allen. Hier funktionieren sie gut, hier weniger – und so schneiden sie im Vergleich zu darauf aufbauenden Modellen ab.
AR-Modelle haben zwei Hauptvorteile:
Und zwei wesentliche Grenzen:
Es gibt noch ein Problem: Verzögerte Werte korrelieren untereinander, weil sie aus derselben Reihe stammen. In den Nachfragedaten beträgt die Korrelation zwischen y_t-1 und y_t-2 0,78.
Das nennt man Multikollinearität, und sie betrifft jedes Regressionsmodell. Wenn sich zwei Prädiktoren gemeinsam bewegen, fällt es dem Modell schwer, ihren Anteil zu trennen. Die Koeffizienten werden instabiler, ihre Standardfehler steigen.
Das erklärt den früheren Befund: Geschätzt wurden 0,676 und 0,138 statt 0,6 und 0,25 – Gewicht wanderte vom einen Lag zum anderen, die Summe blieb ähnlich. Die Prognosen leiden darunter wenig, aber einzelnen Koeffizienten solltest du weniger trauen. Jeder zusätzliche Lag verstärkt das Problem.
AR ist eines von drei Grundmustern der klassischen Zeitreihenprognose. Die anderen beiden sind gleitende Durchschnitte (MA-Modelle) und ARIMA, das beides kombiniert.
Ein AR-Modell prognostiziert aus vergangenen Werten. Ein MA-Modell prognostiziert aus vergangenen Fehlern:
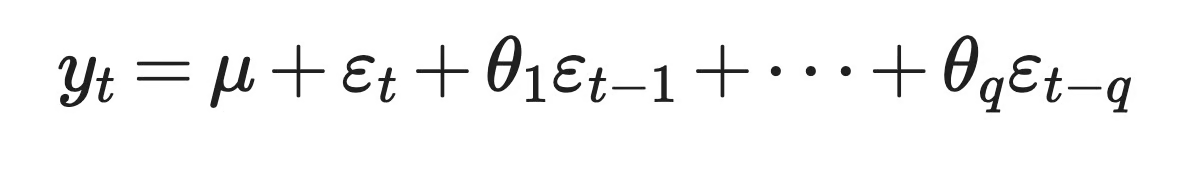
ARMA-Modell
Hier ist mu der Mittelwert der Reihe, theta_1 bis theta_q sind die Koeffizienten, und epsilon_t-1 bis epsilon_t-q sind die Zufallsschocks der vorherigen Schritte. Verwechsele das nicht mit einem gleitenden Durchschnitt im Sinn eines rollierenden Mittels – der Name ist gleich, das Modell ist ein anderes.
Die Modelle reagieren unterschiedlich auf Schocks. In einem MA(q)-Modell beeinflusst ein Schock die Reihe für genau q Schritte. In einem AR-Modell klingt ein Schock mit der Zeit ab, fällt aber nie exakt auf null. Daher nutzt du zur Ordnungswahl unterschiedliche Werkzeuge – bei AR kappt die PACF nach Lag p, bei MA die ACF nach Lag q.
ARIMA vereint alles. ARIMA(p, d, q) hat drei Teile:
Damit ist AR ein Spezialfall von ARIMA. Setzt du d und q auf null, erhältst du ein AR-Modell. Das kannst du an den Nachfragedaten prüfen:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))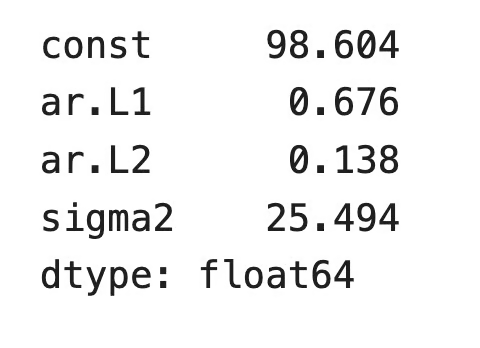
ARIMA-Modell mit 0-facher Differenzierung und MA-Ordnung 0
Die AR-Koeffizienten entsprechen denen aus AutoReg. Die Konstante unterscheidet sich, weil ARIMA den Mittelwert der Reihe ausgibt, während AutoReg den Achsenabschnitt c meldet.
Nun zum Mehrwert von ARIMA: Angenommen, die Stadt wächst und die Stromnachfrage steigt jeden Tag ein wenig. Die Reihe hat nun einen Trend, der ADF-Test fällt durch, ein AR-Modell kann die Rohreihe nicht mehr direkt modellieren.
ARIMA(2, 1, 0) kann es: Es differenziert einmal, modelliert also tägliche Änderungen statt Rohwerte, und fitten dann AR(2) auf diese Änderungen. Wirkt ein Schock – etwa eine Hitzewelle – auch am Folgetag nach, ergänzt du einen MA-Term: ARIMA(2, 1, 1).
Der AR-Teil erfüllt in allen Fällen dieselbe Aufgabe. ARIMA bereitet die Daten nur dafür vor und modelliert den Rest. Wenn du tiefer einsteigen willst, deckt der Kurs ARIMA Models in R den gesamten Prozess ab.
Ein autoregressives Modell sagt den nächsten Wert einer Reihe aus ihrer eigenen Vergangenheit voraus. Es ist eine lineare Regression, bei der die Prädiktoren verzögerte Kopien des Targets sind – und damit eines der verständlichsten Zeitreihenmodelle.
Du findest es in der Ökonomie, in Sprach-Codecs, in der EEG-Analyse – und sogar im Namen heutiger Sprachmodelle. Du hast auch gesehen, wo es nicht ideal ist: Es braucht stationäre Daten, hängt von der richtigen Lag-Ordnung ab, und korrelierte Lags machen einzelne Koeffizienten weniger verlässlich.
Wenn du AR-Modelle verstehst, fällt dir der Rest der klassischen Prognose viel leichter. ARIMA ist der nächste natürliche Schritt – unser ARIMA-Tutorial zeigt, wie Differenzierung und MA-Terme das hier Gelernte erweitern. Für einen praktischen Einstieg probiere unseren Kurs ARIMA Models in Python.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Tutorial
Josef Waples
8 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Allan Ouko
11 Min.