คอร์ส
การวิเคราะห์อนุกรมเวลาด้วย Python
4 ชม.
70.9K
คอนเทนต์ออนไลน์ส่วนใหญ่มักข้ามไปที่ ARIMA แล้วให้คำอธิบายส่วน AR เพียงบรรทัดเดียว ถ้ามีก็ตาม ทั้งที่จริง AR คือรากฐานของโมเดล หากไม่เข้าใจส่วนนี้ ที่เหลือของ ARIMA ก็จะไม่เข้าที่เข้าทางเช่นกัน
พูดง่ายๆ แบบจำลองออโตเรเกรสซีฟจะทำนายค่าของอนุกรมเวลาในอนาคตจากค่าของมันเองในอดีต เห็นใช้งานในเศรษฐศาสตร์ การเงิน การประมวลผลสัญญาณ และข้อมูลภูมิอากาศ โดยพื้นฐานแล้วมันคือแบบจำลองรีเกรสชัน จึงเชื่อมโยงสิ่งที่คุ้นเคยเกี่ยวกับรีเกรสชันเข้ากับการพยากรณ์อนุกรมเวลา และเป็นฐานที่ARIMA สร้างขึ้นมา
ในบทความนี้ จะพาไปรู้ว่าแบบจำลองออโตเรเกรสซีฟทำงานอย่างไร วิธีฟิตใน Python ด้วย statsmodels และวิธีเลือกจำนวนแลกระยะที่เหมาะสม
แบบจำลองออโตเรเกรสซีฟจะทำนายค่าถัดไปของอนุกรมเวลาจากผลรวมถ่วงน้ำหนักของค่าก่อนหน้า
ในชื่อ โมเดล "auto" แปลว่า ตัวเอง และ "regression" คือการทำนายตัวแปรหนึ่งจากตัวแปรอื่นๆ ดังนั้นแบบจำลองออโตเรเกรสซีฟคือการรีเกรสของอนุกรมกับอดีตของมันเอง
สมมติอยากทำนายความต้องการใช้ไฟวันพรุ่งนี้ ค่าวันนี้เป็นจุดเริ่มต้นที่ดี และค่าของเมื่อวานก็เพิ่มข้อมูลได้อีกนิด โมเดลออโตเรเกรสซีฟจะเปลี่ยนสัญชาตญาณนั้นเป็นสูตร และเรียนรู้น้ำหนักจากข้อมูลของคุณ
AR เขียนเป็น AR(p) โดย p คืออันดับของโมเดล อันดับบอกจำนวนค่าก่อนหน้าที่โมเดลใช้:
p ระยะการเพิ่มอันดับไม่ได้แปลว่าโมเดลจะดีกว่าเสมอ เดี๋ยวจะแสดงวิธีเลือก p ในช่วงท้ายบทความ
รูปแบบทั่วไปของโมเดล AR(p) คือ:
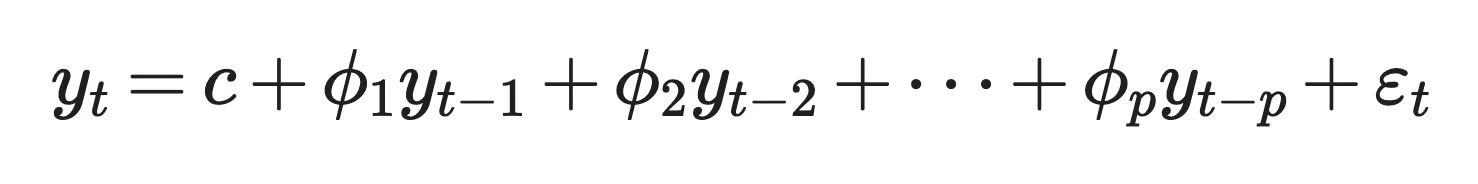
รูปแบบทั่วไปของโมเดล AR(p)
แต่ละพจน์ทำหน้าที่ดังนี้
y_t: ค่าของอนุกรม ณ เวลา t ซึ่งเป็นค่าที่ต้องการทำนาย
c: ค่าคงที่ที่ร่วมกับสัมประสิทธิ์กำหนดค่าเฉลี่ยระยะยาวของอนุกรม
phi_1 ถึง phi_p: สัมประสิทธิ์ที่บอกว่าค่าอดีตแต่ละระยะมีส่วนต่อการทำนายมากน้อยเพียงใด
y_t-1 ถึง y_t-p: ค่าล่าช้า โดย "lag" หมายถึงถอยหลังไปกี่ก้าวเวลา
epsilon_t: ไวต์นอยซ์ คือความคลาดเคลื่อนแบบสุ่มที่มีค่าเฉลี่ยศูนย์ ความแปรปรวนคงที่ และไม่เกิดสหสัมพันธ์ตามเวลา
โดยสรุป โมเดลจะคูณค่า p ระยะล่าสุดแต่ละค่าด้วยน้ำหนักของมันเองแล้วบวกค่าคงที่ ส่วนที่เหลือคือสัญญาณรบกวน คือส่วนของ y_t ที่อดีตอธิบายไม่ได้
AR(1) เป็นรุ่นที่ง่ายที่สุด:
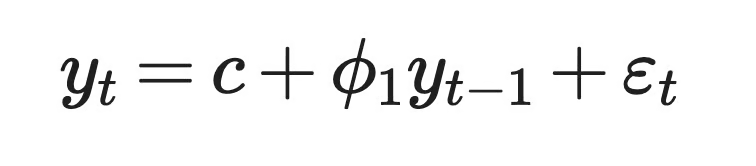
โมเดล AR(1)
ค่าของ phi_1 กำหนดว่า "วันนี้" ส่งผลต่อ "พรุ่งนี้" มากแค่ไหน
สมมติ c = 2 และ phi_1 = 0.8 ถ้าวันนี้มีค่า 15 โมเดลจะทำนายพรุ่งนี้เป็น 2 + 0.8 x 15 = 14 การทำนายถัดไปเป็น 2 + 0.8 x 14 = 13.2 แต่ละก้าวพาอนุกรมเข้าใกล้ 10 ซึ่งเป็นค่าเฉลี่ยระยะยาว c / (1 - phi_1)
ถ้า phi_1 เป็นลบ อนุกรมจะกระโดดเหนือและใต้ค่าเฉลี่ยสลับกันไปในแต่ละก้าว
AR(2) เพิ่มแลกระยะที่สอง:
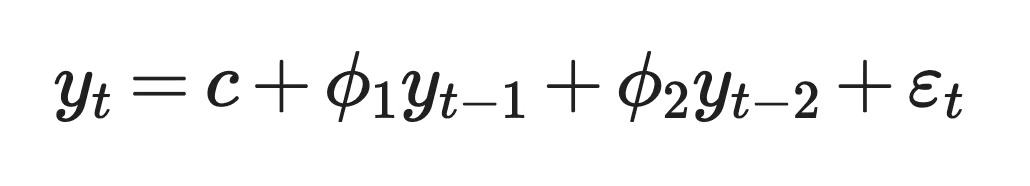
โมเดล AR(2)
เมื่อมีสองแลก โมเดลสามารถอธิบายรูปแบบที่ AR(1) ทำไม่ได้ เช่น วัฏจักร ตัวอย่างเช่น phi_1 เป็นบวกและ phi_2 เป็นลบ อาจทำให้อนุกรมขึ้นลงเป็นคลื่น คล้ายวัฏจักรธุรกิจ
ดังนั้นทุกโมเดล AR สรุปได้ว่ามีสองสิ่งที่ต้องเลือก — จะใช้กี่ย้อนหลัง และให้น้ำหนักเท่าไร
โมเดล AR ใช้ได้ดีต่อเมื่อข้อมูลมีสองเงื่อนไขจริง ค่าที่ผ่านมาเกี่ยวข้องกับค่าข้างหน้า และอนุกรมมีพฤติกรรมเหมือนเดิมตลอดเวลา อย่างแรกเรียกว่าออโตคอรีเลชัน และอย่างหลังเรียกว่าสถานียภาพ (stationarity)
ออโตคอรีเลชันคือสหสัมพันธ์ระหว่างอนุกรมเวลาและสำเนาที่ล่าช้าของตัวมันเอง
นี่คือเหตุผลที่มีโมเดล AR หากค่าของวันนี้ไม่บอกอะไรเกี่ยวกับพรุ่งนี้ โมเดลก็ไม่มีอะไรจะเรียนรู้จากอดีต
ในโค้ด จะคัดลอกคอลัมน์ค่าแล้วเลื่อนสำเนาลง 1 แถว ตอนนี้แต่ละแถวจะจับคู่ค่าหนึ่งกับค่าก่อนหน้า สหสัมพันธ์ระหว่างสองคอลัมน์คือออโตคอรีเลชันแลก 1 เมื่อเลื่อน 2 แถว จะได้ออโตคอรีเลชันแลก 2
ตัวอย่างใน pandas เป็นดังนี้:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))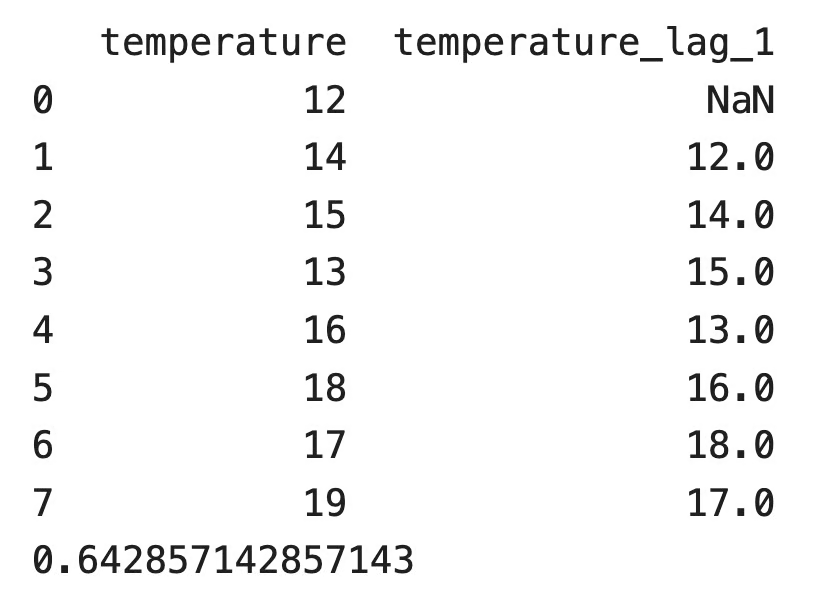
DataFrame ที่มีคอลัมน์อุณหภูมิและสำเนาแลก 1
แถวแรกของคอลัมน์แลกว่างอยู่ เพราะไม่มีค่าก่อนหน้าค่าแรก pandas จะข้ามแถวนั้นและคืนค่าออโตคอรีเลชันแลก 1 เป็น 0.643 วันอากาศอุ่นมักตามด้วยวันอุ่นในอนุกรมนี้
เครื่องหมายของออโตคอรีเลชันจะเปลี่ยนพฤติกรรมของอนุกรม:
ออโตคอรีเลชันใกล้ศูนย์หมายความว่าอดีตไม่ช่วย ในกรณีนั้น โมเดล AR จะทำได้ไม่ดีกว่าการทำนายค่าเฉลี่ยมากนัก
โมเดล AR ต้องการอนุกรมเวลาที่เป็นสถานี
อนุกรมที่เป็นสถานีจะมีค่าเฉลี่ยเท่ากัน ความแปรปรวนเท่ากัน และออโตคอรีเลชันที่แลกกำหนดเท่ากัน ไม่ว่ามองส่วนใดของอนุกรม นักสถิติเรียกสิ่งนี้ว่า weak-sense stationarity
เหตุผลที่สำคัญเพราะโมเดลจะประมาณชุดสัมประสิทธิ์ชุดเดียวคงที่ หากค่าเฉลี่ยของอนุกรมลอยไปตามเวลา สัมประสิทธิ์ที่เรียนรู้จากข้อมูลเก่าจะอธิบายข้อมูลใหม่ไม่ได้ ราคาหุ้นเป็นตัวอย่างทั่วไปของอนุกรมที่ไม่เป็นสถานีเพราะมีแนวโน้มในระยะยาว ส่วนผลตอบแทนรายวันมักใกล้เคียงสถานีมากกว่า
ตัวสัมประสิทธิ์เองเป็นผู้ตัดสินว่า AR process เป็นสถานีหรือไม่ สำหรับ AR(1) กฎง่ายๆ คือ phi_1 ต้องอยู่ระหว่าง -1 ถึง 1
abs(phi_1) < 1: แรงกระทบจะค่อยๆ จาง และอนุกรมกลับสู่ค่าเฉลี่ย
phi_1 = 1: อนุกรมกลายเป็น random walk และแรงกระทบไม่จาง
abs(phi_1) > 1: แต่ละแรงกระทบยิ่งทวี และอนุกรมระเบิด
AR(2) ต้องมีเงื่อนไขสามข้อพร้อมกัน: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1, และ abs(phi_2) < 1
พอมากกว่าสองแลก ต้องใช้กฎทั่วไป ทุกโมเดล AR(p) จะมีพหุนามลักษณะเฉพาะ (characteristic polynomial):
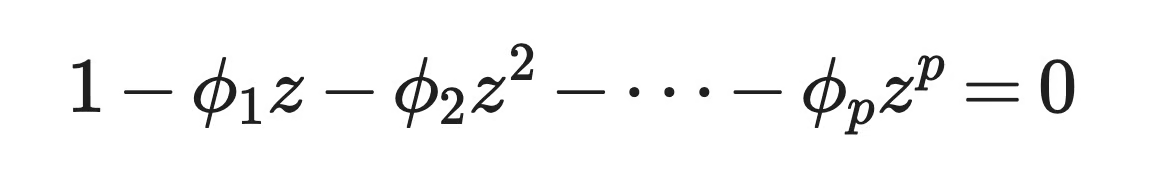
พหุนามลักษณะเฉพาะ
กระบวนการเป็น weak-sense stationary เมื่อรากของพหุนามทั้งหมดอยู่นอกวงกลมหนึ่งหน่วย หมายถึงค่าของราก z แต่ละตัวมีค่าสัมบูรณ์มากกว่า 1 รากอาจเป็นจำนวนเชิงซ้อน จึงใช้ขอบเขตเป็นวงกลมในระนาบเชิงซ้อนไม่ใช่เส้นตรง
ลองตรวจด้วย AR(1) พหุนามคือ 1 - phi_1 z = 0 ดังนั้นรากคือ z = 1 / phi_1 รากอยู่นอกวงหนึ่งหน่วยก็ต่อเมื่อ abs(phi_1) < 1 ซึ่งตรงกับกฎเดิม
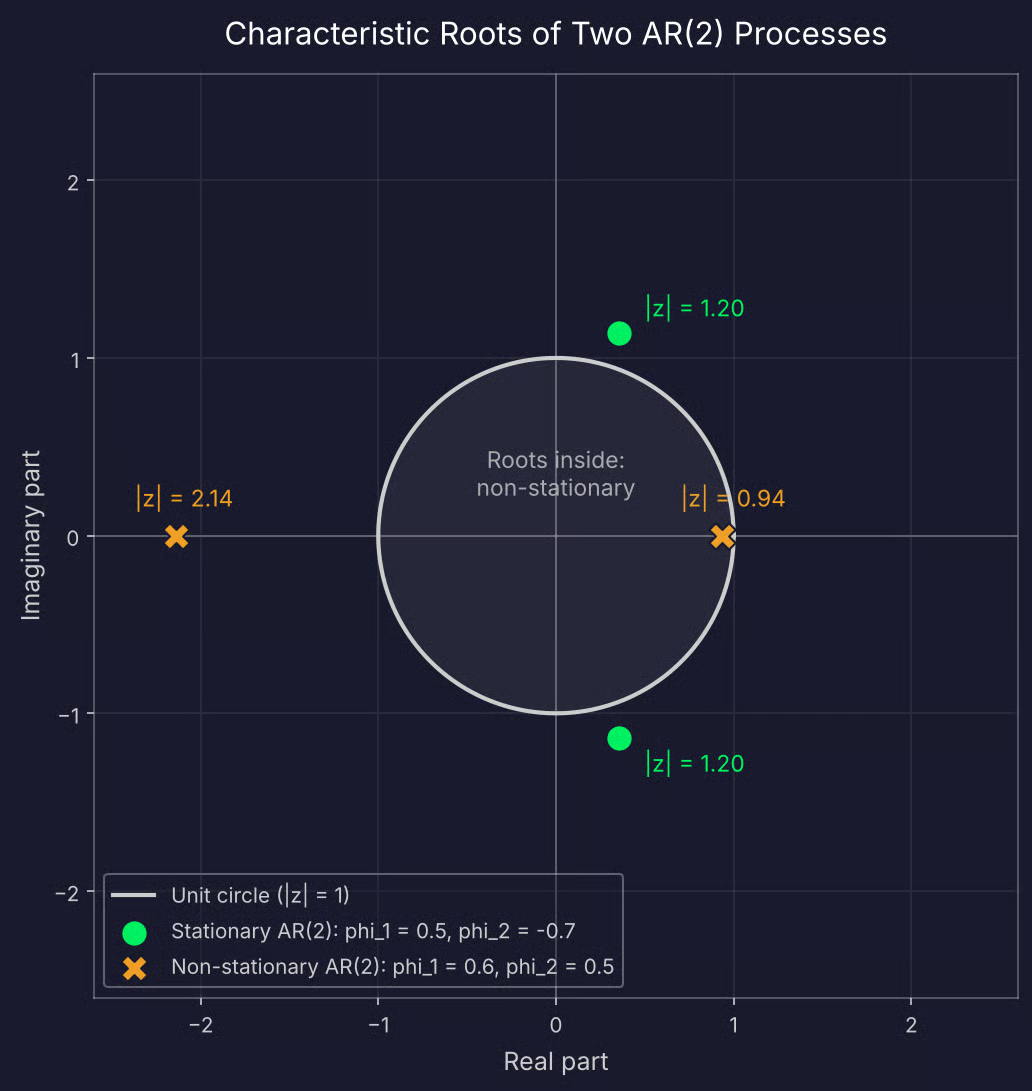
รากของกระบวนการ AR(2) ที่เป็นสถานีและไม่เป็นสถานี
ไม่จำเป็นต้องคำนวณรากเหล่านี้ด้วยมือ statsmodels จะคืนค่าให้หลังฟิตโมเดล และจะสาธิตวิธีทดสอบสถานียภาพของข้อมูลเองในส่วน Python
ถ้าอนุกรมไม่เป็นสถานี ให้ทำดิฟเฟอเรนซ์ — ลบค่าก่อนหน้าออกจากค่าถัดไป — แล้วสร้างโมเดลจากความแตกต่าง นั่นแหละที่ตัว "I" ในโมเดล ARIMA ย่อมาจาก
ทุกโมเดล AR มีสมการเดียวกัน สิ่งที่เปลี่ยนคืออันดับ p ซึ่งคือจำนวนค่าอดีตที่โมเดลใช้
AR(1) ใช้เพียงค่าก่อนหน้าเพื่อทำนายค่าถัดไป
ถ้าฟังดูเหมือนรีเกรสชันเชิงเส้น ก็ใช่เลย เมื่อวาง y_t-1 บนแกน x และ y_t บนแกน y AR(1) จะฟิตเส้นตรงผ่านจุดต่างๆ ค่าคงที่ c คืออินเตอร์เซปต์ และ phi_1 คือความชัน ถ้าคุ้นกับรีเกรสชันเชิงเส้นแบบง่าย ก็เท่ากับรู้วิธีประมาณ AR(1) แล้ว
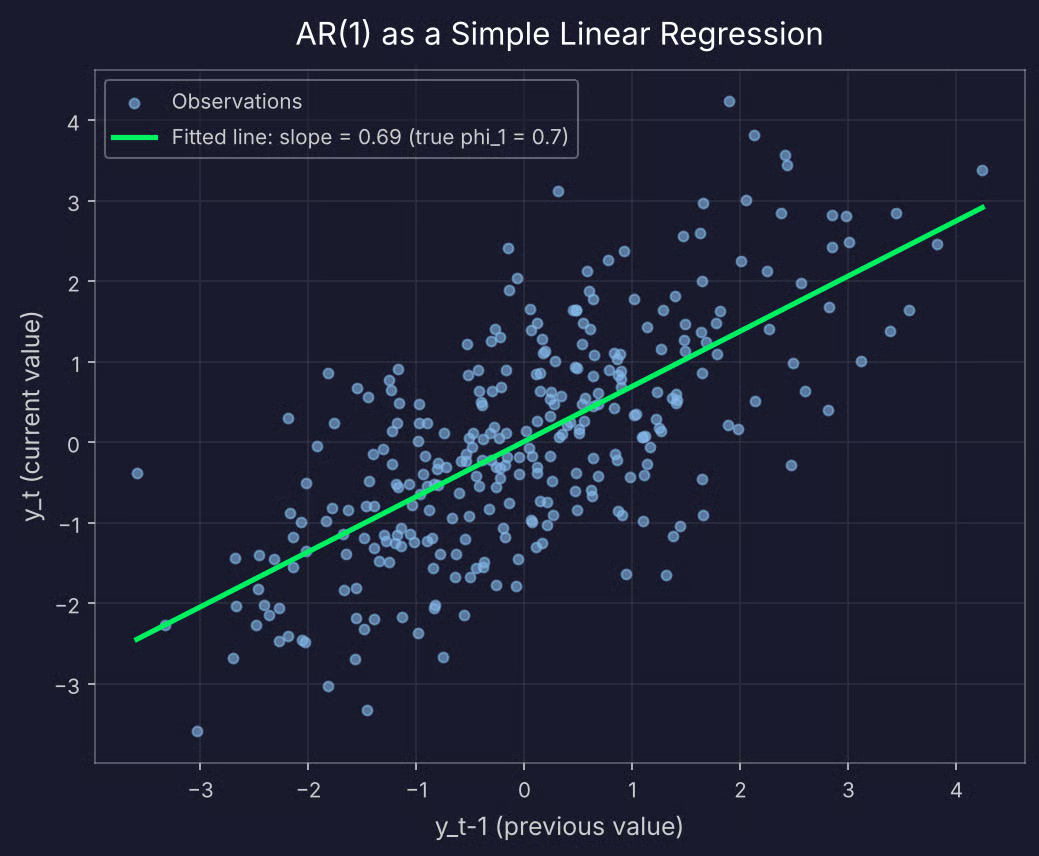
สเกตเตอร์พล็อตของ y_t เทียบกับ y_t-1 สำหรับ AR(1)
แต่มีจุดต่างจุดหนึ่ง ในรีเกรสชันปกติ ตัวพยากรณ์และเป้าหมายเป็นตัวแปรคนละตัว ใน AR(1) ตัวพยากรณ์คืออนุกรมเดียวกันที่ถูกเลื่อนหนึ่งก้าว จึงไม่สามารถสลับแถวหรือใช้การแบ่ง train/test แบบสุ่มได้ ลำดับของข้อมูลเป็นส่วนหนึ่งของโมเดล
ค่าของ phi_1 จะเปลี่ยนหน้าตาของอนุกรม:
phi_1 = 0.3: อนุกรมดูคล้ายสัญญาณรบกวนสุ่ม เพราะแต่ละค่ามีข้อมูลเกี่ยวกับค่าถัดไปน้อย
phi_1 = 0.9: อนุกรมเคลื่อนเป็นช่วงยาวๆ นุ่มนวล และใช้เวลานานกว่าจะกลับสู่ค่าเฉลี่ย
phi_1 = -0.8: อนุกรมซิกแซ็กเหนือและใต้ค่าเฉลี่ยแทบทุกก้าว
phi_1 = 1: อนุกรมกลายเป็น random walk และลอยไปโดยไม่มีค่าเฉลี่ยให้กลับ ซึ่งเป็นกรณีไม่เป็นสถานีจากส่วนก่อนหน้า
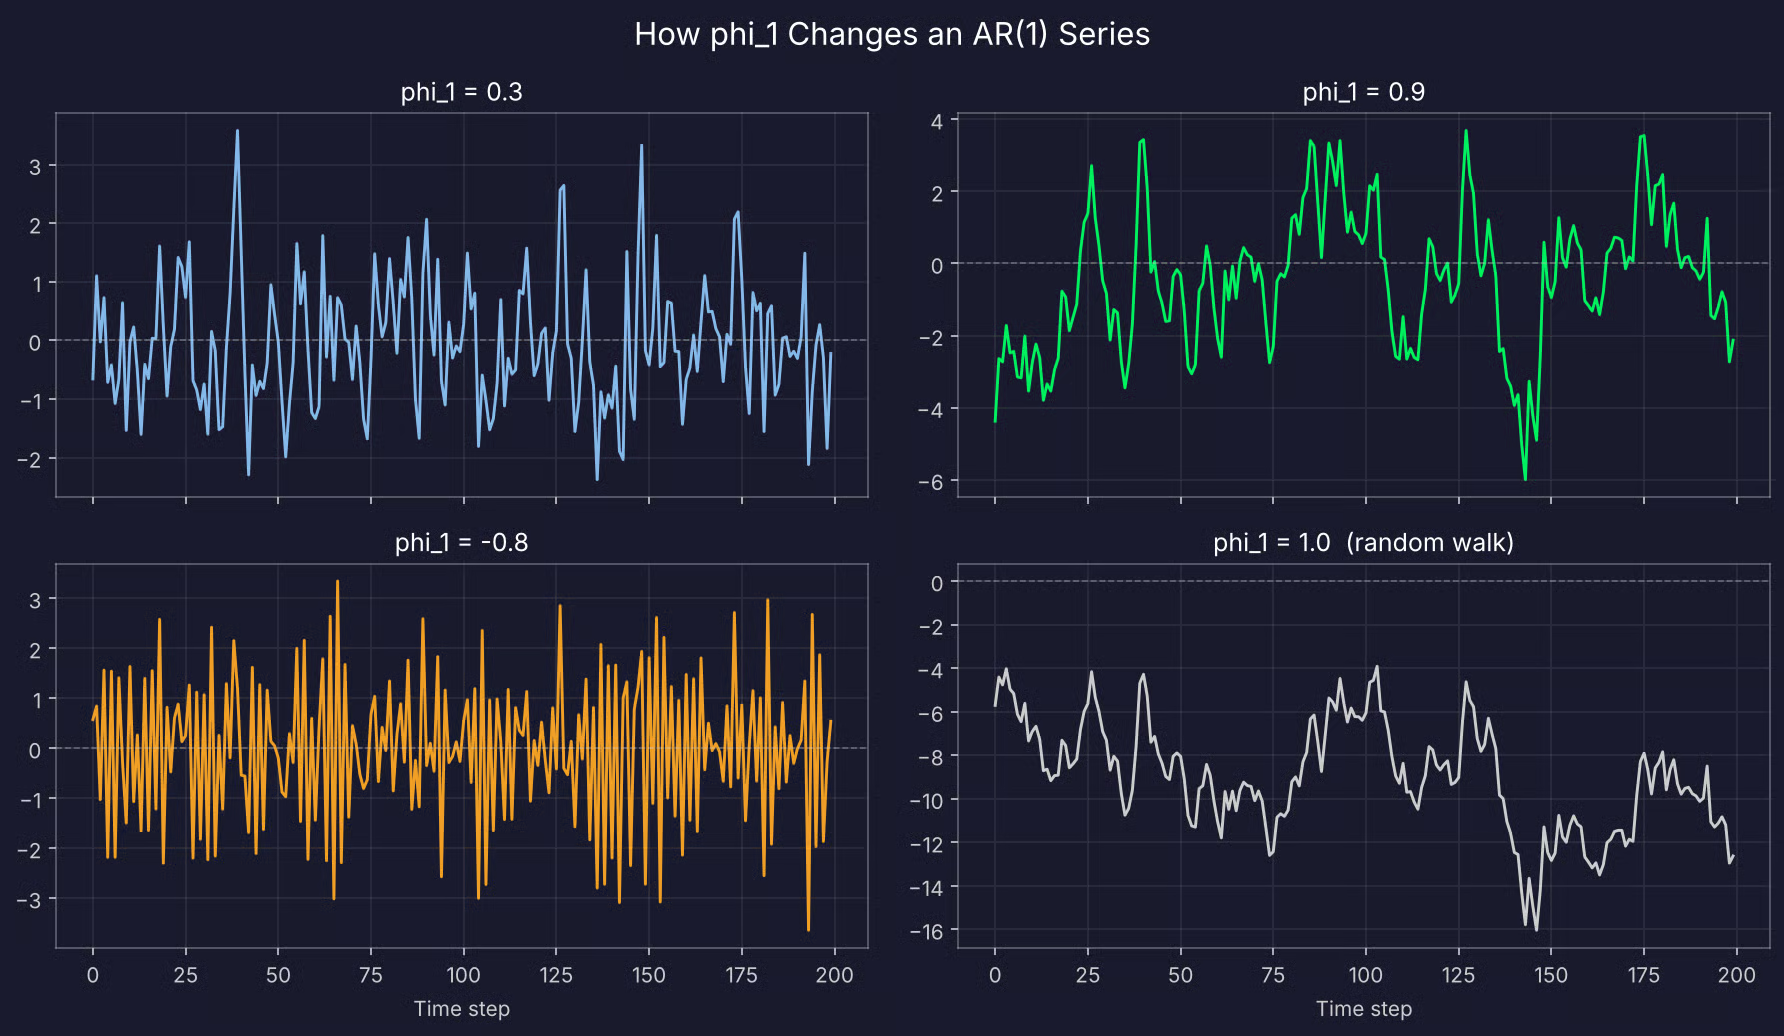
อนุกรม AR(1) จำลองสี่ชุด
ยิ่ง phi_1 เข้าใกล้ 1 หรือ -1 มากเท่าใด ผลของแรงกระทบครั้งเดียวก็ยิ่งอยู่นานขึ้นเท่านั้น
AR(2) ใช้ค่าย้อนหลังสองระยะ แลกที่สองเปิดโอกาสให้โมเดลสร้างรูปแบบที่ AR(1) ทำไม่ได้ โดยหลักคือวัฏจักร
เปรียบเทียบชุดสัมประสิทธิ์สองแบบ:
phi_1 = 0.5, phi_2 = 0.3: ทั้งสองแลกดันไปทิศทางเดียวกัน อนุกรมจึงดูเหมือน AR(1) ที่แกว่งยาวและนุ่มนวลกว่า
phi_1 = 0.5, phi_2 = -0.7: แลกที่สองทำงานสวนทางกับแลกแรก อนุกรมจึงขึ้นลงเป็นคลื่นซ้ำๆ ประมาณทุกห้าก้าว
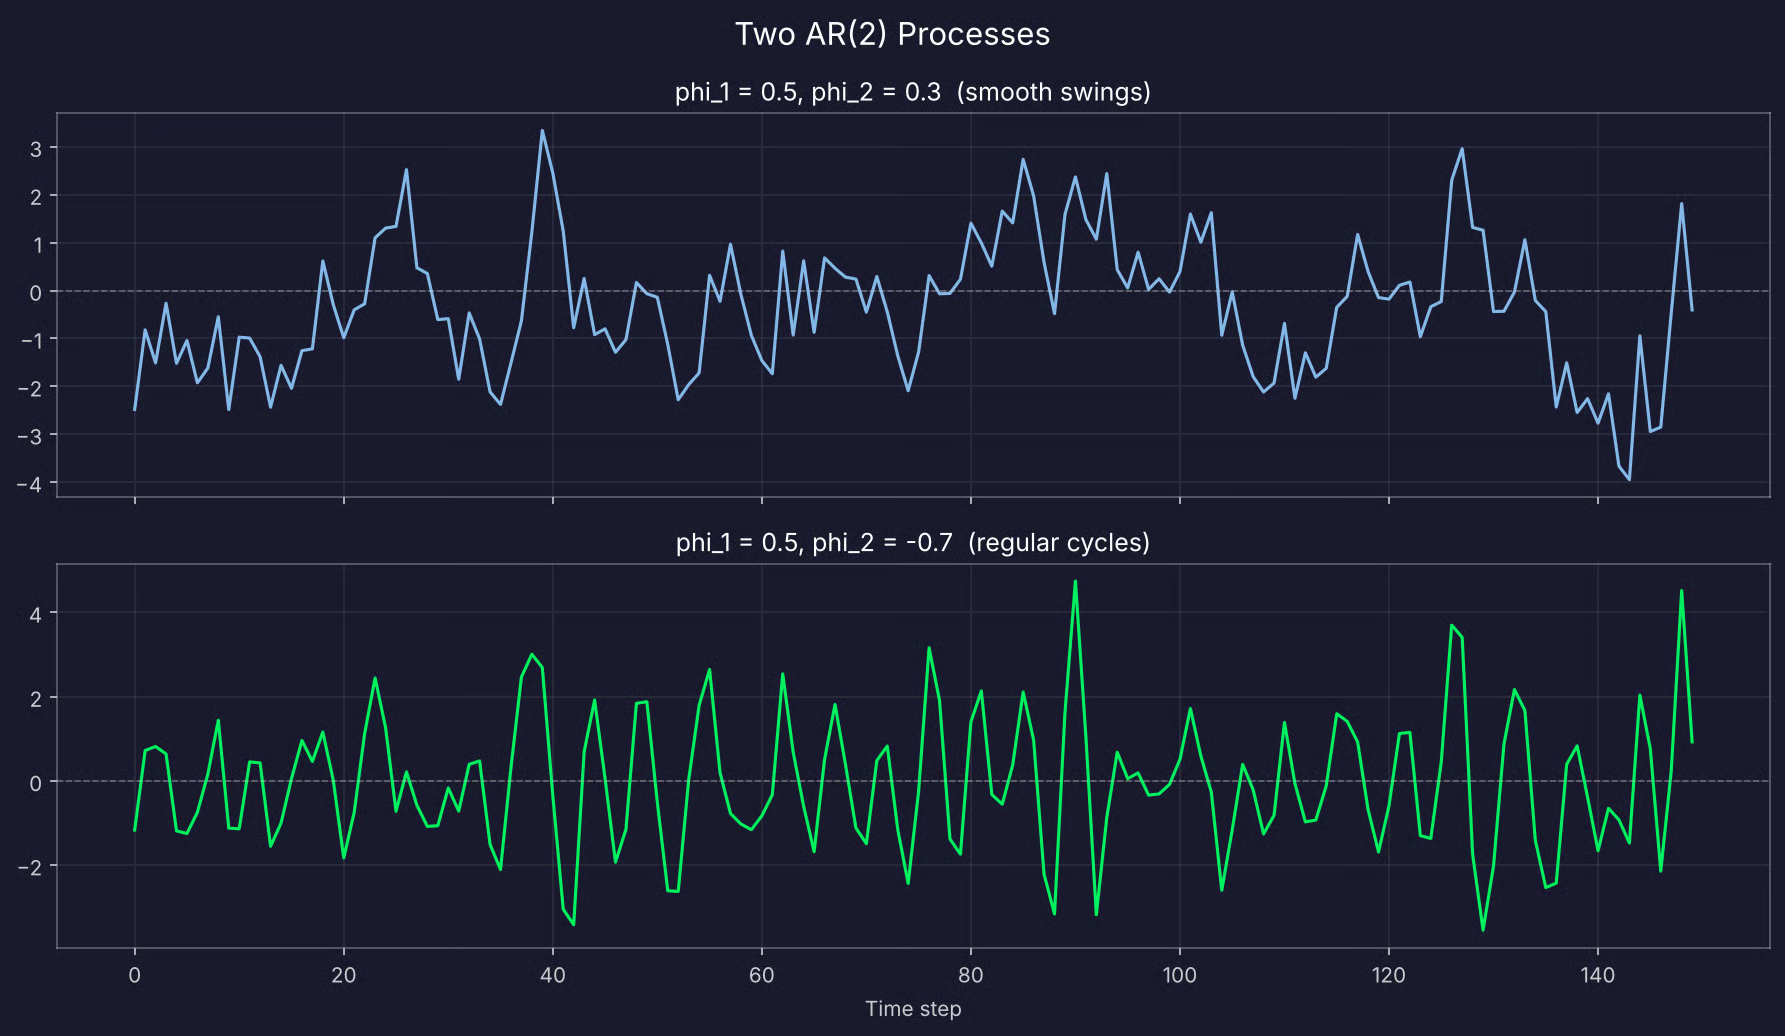
อนุกรม AR(2) จำลองสองชุด
AR(3), AR(4) และต่อๆ ไปจะเพิ่มแลกครั้งละหนึ่ง คุณต้องใช้เมื่อค่าที่ไกลออกไปมีข้อมูลที่ค่าล่าสุดไม่มี
เช่น โมเดลยอดขายรายเดือน และเดือนเดียวกันของปีก่อนช่วยทำนายเดือนนี้ได้ดี โมเดล AR(12) จะรวมแลก 12 เดือนนั้นพร้อมแลก 11 เดือนระหว่างทาง
แต่ละแลกที่เพิ่มมาคือสัมประสิทธิ์ที่ต้องประมาณเพิ่ม นั่นหมายถึงต้องใช้ข้อมูลมากขึ้น และความเสี่ยงโอเวอร์ฟิตก็สูงขึ้น สัมประสิทธิ์ก็อ่านยากขึ้น — มีตั้ง 12 ค่า มองแค่ตัวเลขก็บอกพฤติกรรมอนุกรมไม่ได้ ต้องดูรากแทน
เดี๋ยวจะแสดงวิธีเลือกอันดับที่เหมาะด้วย PACF และ AIC ในส่วน Python
โมเดล AR พบได้ทุกที่ที่ข้อมูลมีลำดับ และอดีตอันใกล้บอกอะไรบางอย่างเกี่ยวกับอนาคตอันใกล้
การใช้งานส่วนใหญ่อยู่ในสี่กลุ่ม:
ข้อสุดท้ายทำให้หลายคนแปลกใจ เพราะคำเรียกที่อยู่เบื้องหลังแชตบอตยุคนี้มาจากสถิติเดียวกับที่อ่านอยู่นี่เอง
ส่วนนี้จะฟิตโมเดลออโตเรเกรสซีฟใน Python ด้วย statsmodels ตั้งแต่ข้อมูลดิบไปจนถึงการพยากรณ์ที่ประเมินผลได้
ต้องใช้ pandas และ NumPy สำหรับข้อมูล, statsmodels สำหรับโมเดลและการทดสอบ และ scikit-learn สำหรับเมตริกความคลาดเคลื่อน:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorจะจำลองความต้องการใช้ไฟฟ้ารายวันสองปีจากกระบวนการ AR(2)
เลือกใช้ข้อมูลจำลองเพราะรู้ค่าสัมประสิทธิ์จริงล่วงหน้า จึงตรวจได้ว่าโมเดลหาเจอไหม และเครื่องมือเลือกแลกชี้อันดับที่ถูกหรือไม่
กระบวนการมี c = 15, phi_1 = 0.6, และ phi_2 = 0.25 ซึ่งให้ค่าเฉลี่ยระยะยาวที่ 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()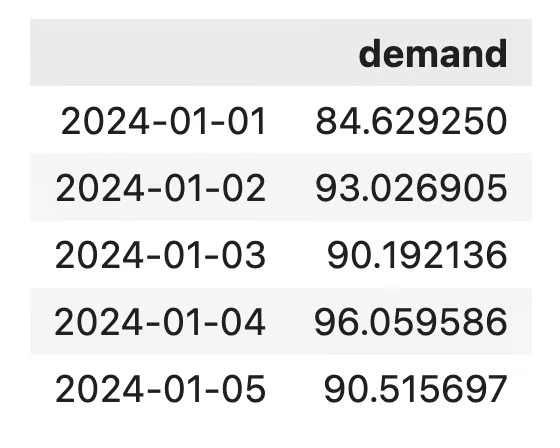
ชุดข้อมูลความต้องการใช้ไฟฟ้ารายวัน
นำ 100 วันแรกออก เพราะช่วง burn-in ช่วยให้อ นุกรมเข้าที่ก่อนเริ่มใช้งาน
หน้าตาของอนุกรมเต็มมีดังนี้:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()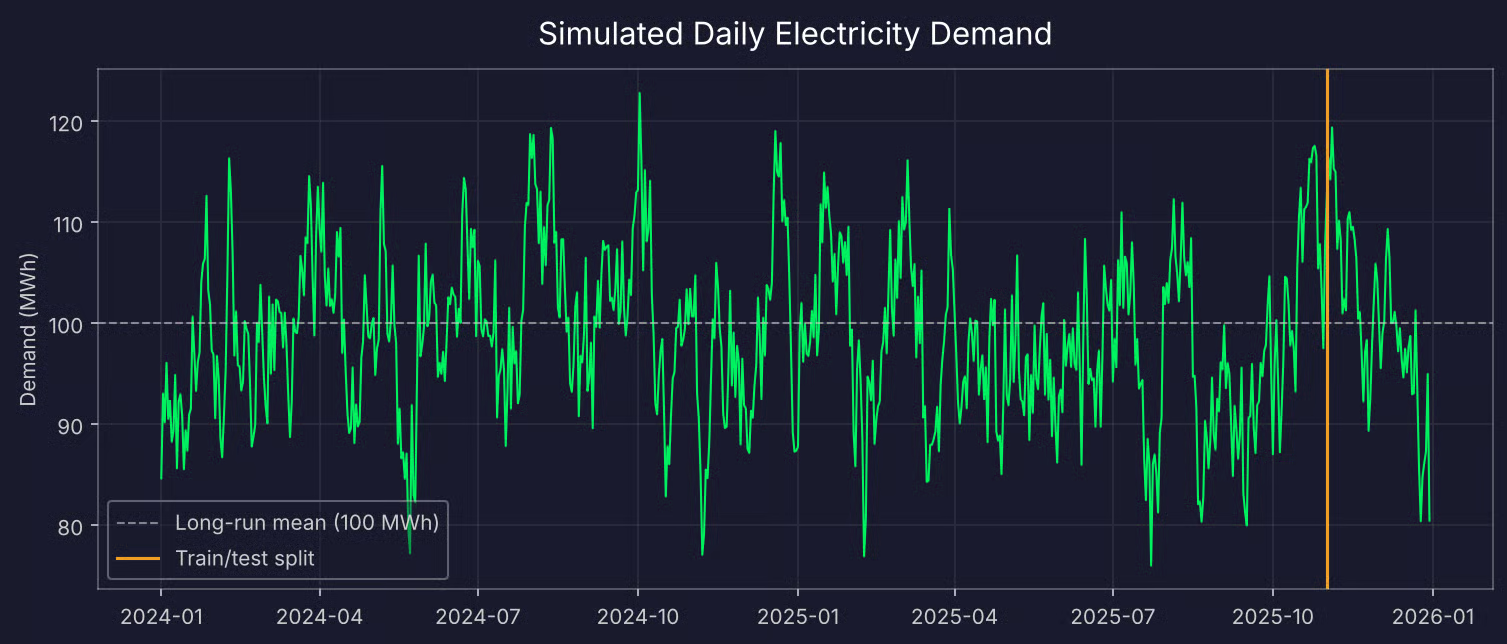
ความต้องการใช้ไฟฟ้ารายวันจำลองสองปี
อนุกรมขึ้นลงรอบๆ ค่า 100 โดยไม่มีแนวโน้ม ซึ่งเป็นลักษณะที่ควรเห็นในอนุกรมสถานี แต่การดูด้วยตาไม่ใช่หลักฐาน
การทดสอบ augmented Dickey-Fuller (ADF) ตรวจว่าอนุกรมเป็นสถานีหรือไม่ สมมติฐานศูนย์คืออนุกรมไม่เป็นสถานี ดังนั้นต้องการ p-value เล็ก:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")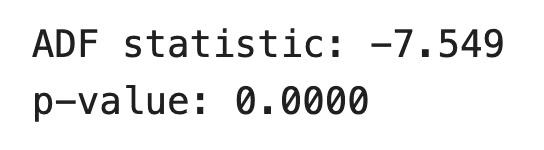
ผลการทดสอบ ADF
p-value ต่ำกว่า 0.05 มาก จึงปฏิเสธสมมติฐานศูนย์และถือว่าอนุกรมเป็นสถานีได้
ถ้าข้อมูลของคุณไม่ผ่าน ให้ทำดิฟเฟอเรนซ์ด้วย df["demand"].diff().dropna() แล้วทดสอบใหม่
ข้อมูลอนุกรมเวลาไม่สามารถสลับลำดับได้ ชุดทดสอบจึงต้องมาจากส่วนท้ายของอนุกรม จะกัน 60 วันสุดท้ายไว้ทดสอบ:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
เหลือ 670 วันสำหรับเทรน และ 60 วันสำหรับทดสอบ
นี่คือขั้นตอนที่ชี้ชะตาว่าโมเดลจะทำงานดีแค่ไหน ถ้าเลือกแลกน้อยไป โมเดลจะพลาดรูปแบบในข้อมูล แต่ถ้าเลือกมากไป ก็จะฟิตกับสัญญาณรบกวนในข้อมูลเทรนที่ไม่เกิดซ้ำในอนาคต
มีสองเครื่องมือสำหรับเรื่องนี้
อย่างแรกคือฟังก์ชันออโตคอรีเลชันบางส่วน (PACF) มันแสดงสหสัมพันธ์ระหว่างอนุกรมกับแต่ละแลกหลังจากตัดผลของแลกที่สั้นกว่าทั้งหมดออก สำหรับกระบวนการ AR(p) PACF จะมีสไปก์ที่มีนัยสำคัญจนถึงแลก p และลดลงใกล้ศูนย์หลังจากนั้น:
plot_pacf(train, lags=20, method="ywm")
plt.show()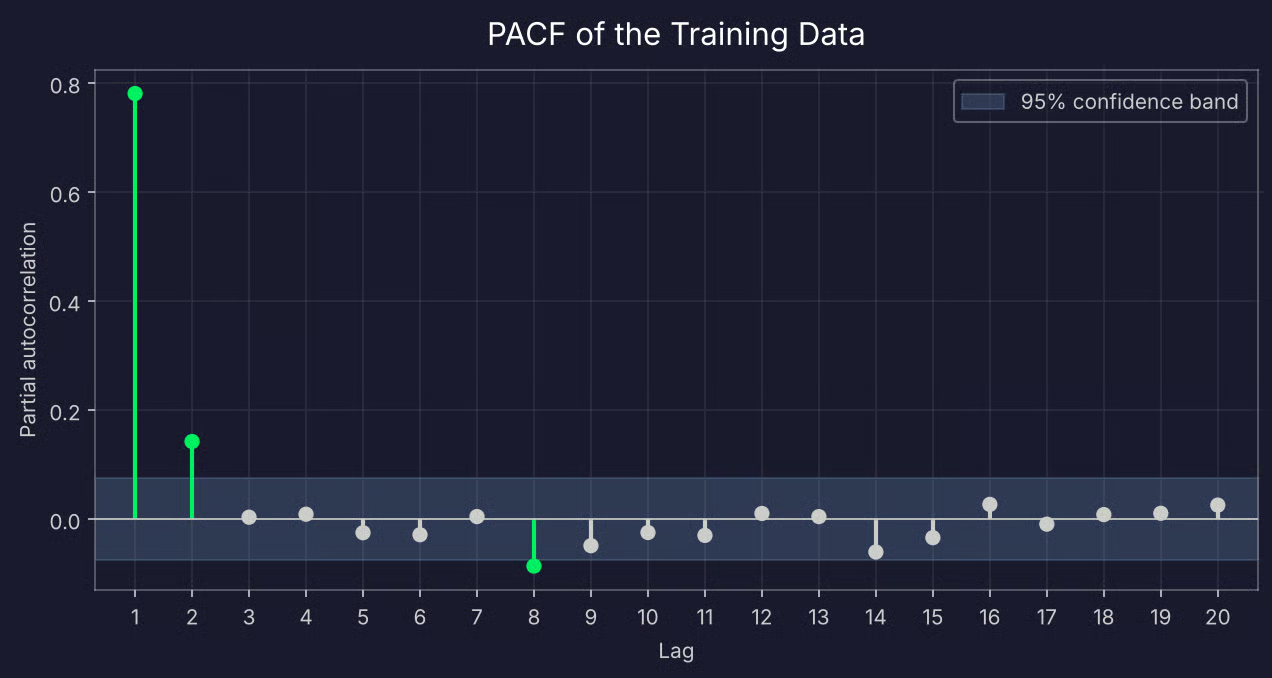
PACF ของข้อมูลเทรน
แลก 1 และ 2 อยู่ไกลนอกแถบความเชื่อมั่น และแลก 3 ลดลงใกล้ศูนย์ ชี้ไปที่ AR(2)
ยังมีสไปก์เล็กที่แลก 8 พ้นขอบแถบนิดหน่อย อย่าอ่านความหมายมากนัก แถบถูกวาดที่ความเชื่อมั่น 95% ดังนั้นเมื่อมี 20 แลก ก็คาดได้ว่ามีประมาณหนึ่งแลกที่ข้ามเส้นจากความบังเอิญ
เครื่องมือที่สองคือเกณฑ์สารสนเทศ AIC และ BIC ให้รางวัลโมเดลที่ฟิตข้อมูลดีและลงโทษทุกพารามิเตอร์ที่เพิ่ม BIC ลงโทษแรงกว่า จึงมักเลือกโมเดลที่เล็กกว่า statsmodels สามารถทดสอบทุกอันดับจนถึงค่าสูงสุดและคืนค่าที่ดีที่สุดได้:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")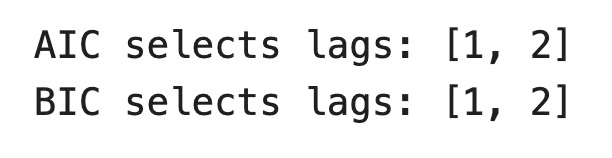
การเลือกแลกด้วย AIC/BIC
ทั้งสองเกณฑ์สอดคล้องกับ PACF ในทางปฏิบัติมักเห็น AIC เลือกโมเดลใหญ่กว่า BIC เล็กน้อย หากเกิดกรณีนั้น ให้เริ่มจากโมเดลเล็กกว่า
เมื่อได้อันดับแล้ว การฟิตโมเดลใช้โค้ดเพียงสองบรรทัด:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")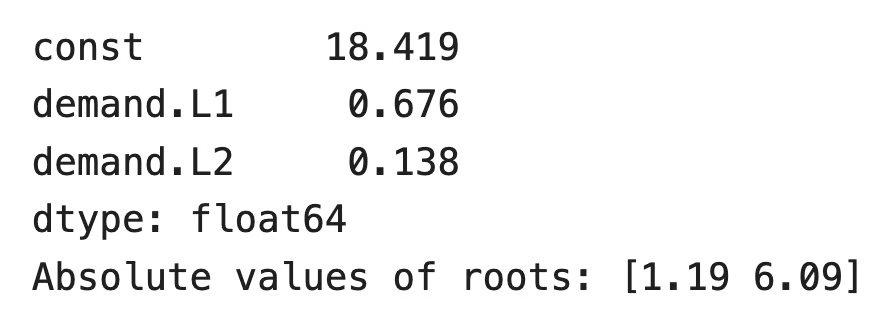
พารามิเตอร์ของโมเดล AR(2)
ค่าจริงคือ 0.6 และ 0.25 โมเดลให้น้ำหนักแลกแรกมากขึ้นและแลกที่สองน้อยลง แต่ผลรวมสองสัมประสิทธิ์ใกล้เคียงกัน — 0.81 เทียบกับ 0.85 ด้วยข้อมูล 670 จุด จะไม่กู้ค่าจริงได้เป๊ะๆ
รากทั้งสองมีโมดูลัสมากกว่า 1 จึงเป็นโมเดลสถานี เรียก results.summary() หากต้องการส่วนเบี่ยงเบนมาตรฐาน p-value และตารางรากเต็ม
มีสองวิธีพยากรณ์ช่วงทดสอบ และตอบคำถามต่างกัน:
การพยากรณ์หลายก้าวได้มาจากผลฟิตโดยตรง สำหรับการพยากรณ์ทีละก้าว ให้นำสัมประสิทธิ์ที่เทรนแล้วไปใช้กับอนุกรมเต็ม:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")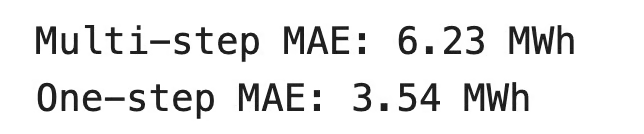
ผลการพยากรณ์
ค่า mean absolute error (MAE) คือค่าเฉลี่ยของความแตกต่างแบบค่าสัมบูรณ์ระหว่างค่าทำนายกับค่าจริง มีหน่วยเดียวกับข้อมูล จึงอ่านตรงๆ ได้ การพยากรณ์ทีละก้าวคลาดเคลื่อนเฉลี่ย 3.54 MWh
การเปรียบเทียบการพยากรณ์ทั้งสองกับค่าจริงเป็นดังนี้:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()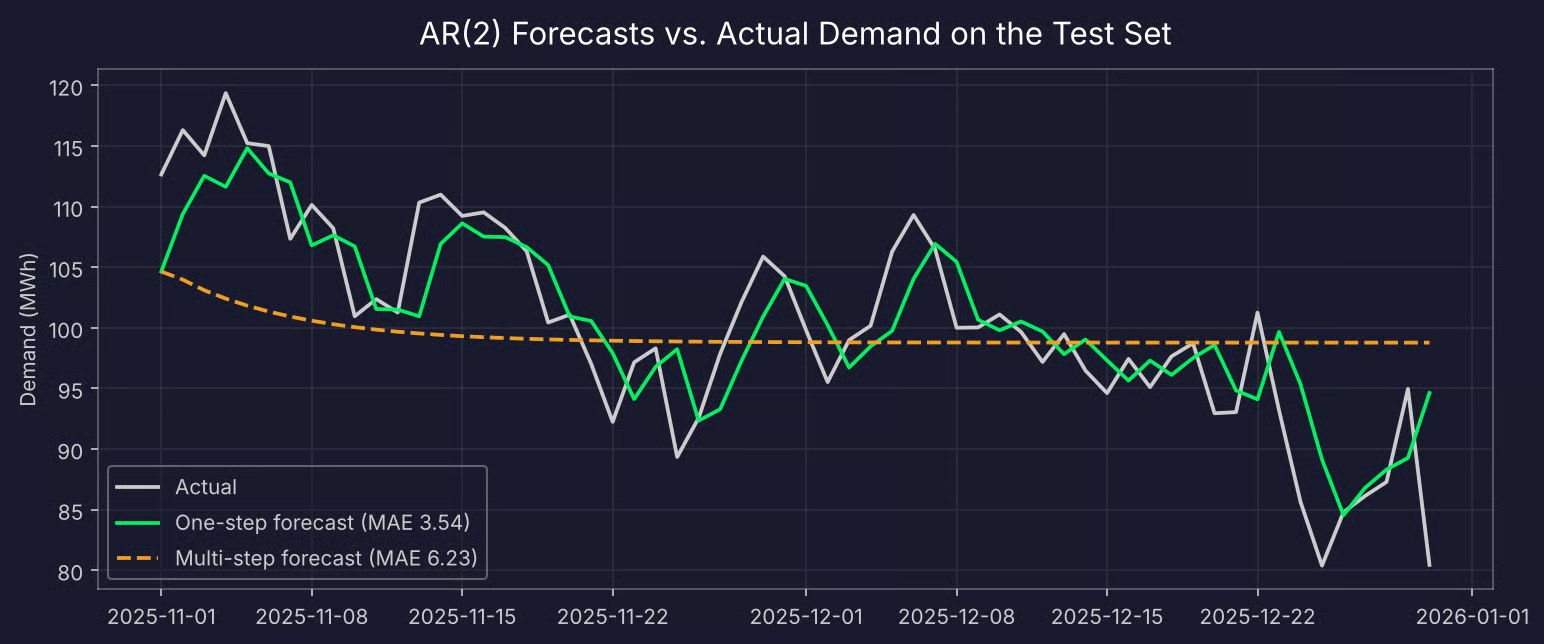
การพยากรณ์ AR(2) แบบทีละก้าวและหลายก้าวเทียบกับค่าความต้องการจริง
การพยากรณ์ทีละก้าวตามติดค่าจริงอย่างใกล้ชิด โดยช้ากว่าประมาณหนึ่งวัน การพยากรณ์หลายก้าวเริ่มที่ค่ารู้ล่าสุดแล้วค่อยๆ แบนราบใกล้ค่าเฉลี่ยภายในราวสามสัปดาห์
นี่คือพฤติกรรมของโมเดล AR ที่เป็นสถานีทุกรุ่น — ยิ่งพยากรณ์ไกล อดีตก็ยิ่งบอกอะไรได้น้อยลง และคำทำนายที่ดีที่สุดคือค่าเฉลี่ยระยะยาว นี่จึงเป็นเหตุผลที่โมเดล AR เหมาะกับการพยากรณ์ระยะสั้น
ง่ายที่จะคิดว่าอดีตมากขึ้นย่อมทำนายได้ดีกว่า มาทดสอบด้วยการฟิตโมเดลที่เพิ่มจำนวนแลกขึ้นเรื่อยๆ แล้วเปรียบเทียบ MAE แบบทีละก้าว:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")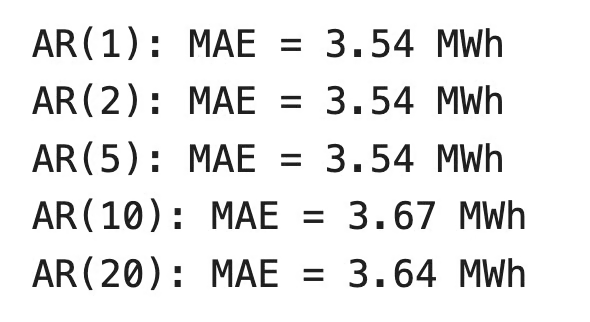
MAE เมื่อเพิ่มจำนวนแลก
ความคลาดเคลื่อนไม่ดีขึ้นหลัง AR(2) และแย่ลงที่ AR(10) และ AR(20) สัมประสิทธิ์ที่เพิ่มมาฟิตสัญญาณรบกวนในข้อมูลเทรน
จะสังเกตว่า AR(1) ทำได้พอๆ กับ AR(2) ที่นี่ เพราะค่าสัมประสิทธิ์ที่สองที่ประมาณได้มีค่าน้อย จึงเพิ่มประโยชน์น้อยในชุดทดสอบนี้ เมื่อสองโมเดลทำได้เท่ากัน ให้เลือกโมเดลที่ง่ายกว่า อธิบายง่ายกว่า และเสี่ยงพังกับข้อมูลใหม่ได้น้อยกว่า
ยังมีต้นทุนด้วย AR(20) ต้องประมาณพารามิเตอร์ 21 ตัวแทนที่จะเป็น 3 ตัว
สรุปคือให้ PACF และเกณฑ์สารสนเทศช่วยแนะอันดับ แล้วค่อยยืนยันบนชุดทดสอบ
โมเดล AR เหมาะกับปัญหาพยากรณ์หลายแบบ แต่ไม่ใช่ทั้งหมด ต่อไปนี้คือจุดที่เวิร์กและไม่เวิร์ก และการเปรียบเทียบกับโมเดลที่สร้างต่อยอดจากมัน
โมเดล AR มีประโยชน์หลักสองข้อ:
และมีข้อจำกัดหลักสองข้อ:
ยังมีปัญหาอีกข้อ ค่าล่าช้าต่างๆ มีสหสัมพันธ์กันเพราะมาจากอนุกรมเดียวกัน ในข้อมูลความต้องการ ค่า y_t-1 และ y_t-2 มีสหสัมพันธ์ 0.78
นี่เรียกว่า multicollinearity และมีผลกับโมเดลรีเกรสชันทุกแบบ เมื่อสองตัวพยากรณ์เคลื่อนไปด้วยกัน โมเดลจะแยกได้ยากว่าอันไหนเป็นต้นเหตุ สัมประสิทธิ์จึงไม่นิ่งขึ้น และส่วนเบี่ยงเบนมาตรฐานของมันจะสูงขึ้น
นี่อธิบายสิ่งที่เห็นก่อนหน้า โมเดลประมาณได้ 0.676 และ 0.138 แทน 0.6 และ 0.25 — มันย้ายนน.จากแลกหนึ่งไปอีกแลก แต่ผลรวมยังใกล้เคียง การทำนายไม่เสียหายมากนัก แต่ไม่ควรเชื่อมั่นสัมประสิทธิ์รายตัวมากเกินไป แลกที่เพิ่มมาทำให้ปัญหานี้หนักขึ้น
AR เป็นหนึ่งในสามองค์ประกอบพื้นฐานของการพยากรณ์อนุกรมเวลาแบบคลาสสิก อีกสองส่วนคือโมเดลค่าเฉลี่ยเคลื่อนที่ (MA) และ ARIMA ซึ่งรวมทั้งสองเข้าด้วยกัน
โมเดล AR ทำนายจากค่าอดีต ส่วนโมเดล MA ทำนายจากความคลาดเคลื่อนอดีต:
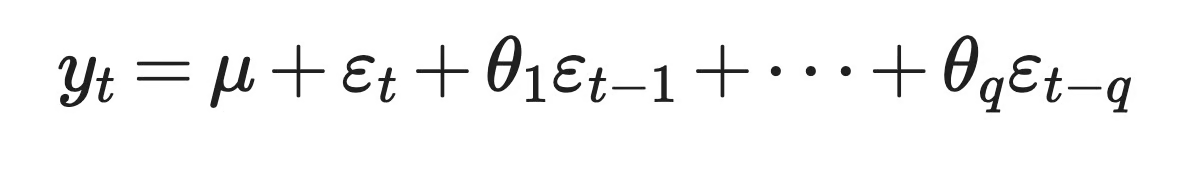
โมเดล ARMA
ที่นี่ mu คือค่าเฉลี่ยของอนุกรม theta_1 ถึง theta_q คือสัมประสิทธิ์ และ epsilon_t-1 ถึง epsilon_t-q คือช็อกแบบสุ่มจากก้าวก่อนหน้า อย่าสับสนกับค่าเฉลี่ยเคลื่อนที่ในความหมายค่าเฉลี่ยแบบกลิ้ง ชื่อเหมือนกันแต่โมเดลต่างกัน
สองโมเดลตอบสนองต่อช็อกต่างกัน ในโมเดล MA(q) ช็อกมีผลต่ออนุกรมพอดี q ก้าว ในโมเดล AR ช็อกจะจางลงตามเวลาแต่ไม่เป็นศูนย์สนิท ความต่างนี้ยังเป็นเหตุผลที่ใช้เครื่องมือเลือกอันดับต่างกัน — PACF ตัดขาดหลังแลก p สำหรับ AR และ ACF ตัดขาดหลังแลก q สำหรับ MA
ARIMA เอาทั้งหมดมารวมกัน ARIMA(p, d, q) มีสามส่วน:
ดังนั้น AR จึงเป็นกรณีพิเศษของ ARIMA หากตั้ง d และ q เป็นศูนย์ จะได้โมเดล AR ลองตรวจด้วยข้อมูลความต้องการไฟ:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))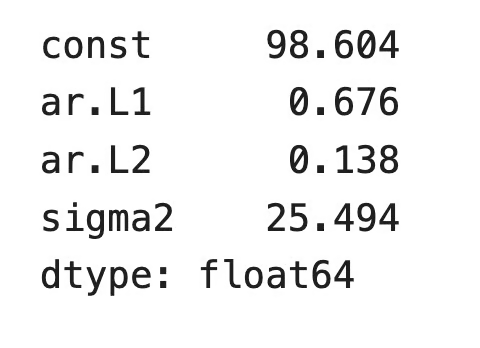
โมเดล ARIMA ที่มีระดับการดิฟเฟอเรนซ์และอันดับ MA เท่ากับ 0
สัมประสิทธิ์ AR ตรงกับของ AutoReg ค่าคงที่ต่างกันเพราะ ARIMA รายงานค่าเฉลี่ยของอนุกรม ในขณะที่ AutoReg รายงานอินเตอร์เซปต์ c
ต่อไปดูว่า ARIMA ไปได้ไกลกว่าอย่างไร สมมติเมืองเติบโต ความต้องการไฟฟ้าเพิ่มขึ้นเล็กน้อยทุกวัน อนุกรมมีแนวโน้ม การทดสอบ ADF จึงไม่ผ่าน และโมเดล AR ใช้กับอนุกรมดิบไม่ได้โดยตรง
แต่ ARIMA(2, 1, 0) ใช้ได้ มันทำดิฟเฟอเรนซ์หนึ่งครั้ง จึงทำงานกับการเปลี่ยนแปลงรายวันแทนค่าดิบ แล้วฟิต AR(2) บนการเปลี่ยนแปลงนั้น ถ้าช็อกอย่างคลื่นความร้อนยังส่งผลต่อความต้องการวันถัดไปได้ ก็เพิ่มเทอม MA กลายเป็น ARIMA(2, 1, 1)
ส่วน AR ทำงานเหมือนเดิมทุกกรณี ARIMA เพียงเตรียมข้อมูลให้และจำลองส่วนที่เหลือ หากอยากลงลึก คอร์ส ARIMA Models in R ครอบคลุมกระบวนการทั้งหมด
แบบจำลองออโตเรเกรสซีฟทำนายค่าถัดไปของอนุกรมจากอดีตของมันเอง เป็นรีเกรสชันเชิงเส้นที่ตัวพยากรณ์คือสำเนาที่ล่าช้าของเป้าหมาย จึงเป็นหนึ่งในโมเดลอนุกรมเวลาที่เข้าใจง่ายที่สุด
จะพบได้ในเศรษฐศาสตร์ การเข้ารหัสเสียง การวิเคราะห์ EEG และแม้แต่ในชื่อของโมเดลภาษายุคนี้ นอกจากนี้ยังเห็นว่าเมื่อใดมันไม่ใช่ตัวเลือกที่ดีที่สุด เพราะต้องการข้อมูลสถานี พึ่งพาการเลือกแลกที่เหมาะสม และแลกที่มีสหสัมพันธ์กันทำให้ความน่าเชื่อถือของสัมประสิทธิ์รายตัวลดลง
หากเข้าใจโมเดล AR ที่เหลือของการพยากรณ์แบบคลาสสิกจะง่ายขึ้นมาก ARIMA คือก้าวถัดไปโดยธรรมชาติ และบทความสอน ARIMA ของเราจะแสดงให้เห็นว่าการทำดิฟเฟอเรนซ์และเทอม MA ขยายสิ่งที่เรียนรู้ที่นี่อย่างไร หากอยากลงมือทำ ลองคอร์ส ARIMA Models in Python
เรียนกับ DataCamp
คอร์ส
คอร์ส
คอร์ส