Курс
Анализ временных рядов на Python
4 ч
70.9K
Большая часть материалов в интернете сразу переходит к ARIMA и в лучшем случае уделяет части AR одну строку. Но именно AR — фундамент модели. Если вы её не понимаете, остальная часть ARIMA тоже не сложится.
Проще говоря, авторегрессионная модель предсказывает будущие значения временного ряда по его собственным прошедшим значениям. Её используют в экономике, финансах, обработке сигналов и климатических данных. По сути это регрессионная модель, поэтому она связывает то, что вы уже знаете о регрессии, с прогнозированием временных рядов и служит базой, на которой построена ARIMA.
В этой статье мы разберёмся, как работает авторегрессионная модель, как обучить её в Python с помощью statsmodels и как выбрать подходящий порядок лага.
Авторегрессионная модель предсказывает следующее значение временного ряда как взвешенную сумму его предыдущих значений.
В названии «авто» означает «сам», а «регрессия» — предсказание одной переменной по другим. Значит, авторегрессия — это регрессия ряда на его собственное прошлое.
Допустим, вы хотите спрогнозировать завтрашний спрос на электроэнергию. Сегодняшнее значение — хорошая отправная точка, а вчерашнее добавляет немного информации. Авторегрессионная модель превращает эту интуицию в формулу и подбирает веса по вашим данным.
AR-модели записывают как AR(p), где p — порядок модели. Порядок показывает, сколько прошлых значений использует модель:
p значенийБолее высокий порядок сам по себе не означает лучшую модель. Ниже мы покажем, как выбирать p.
Общий вид модели AR(p):
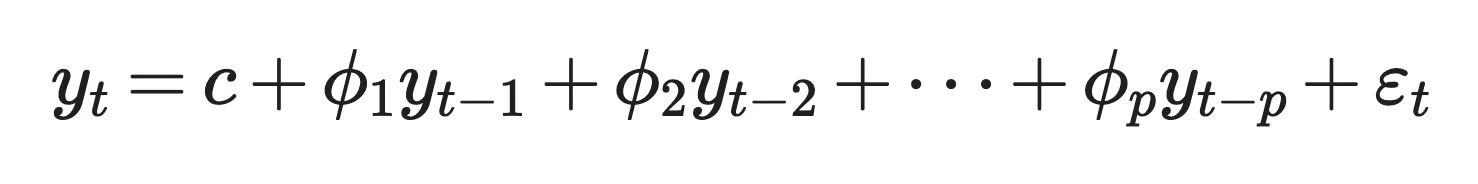
Общая модель AR(p)
Что означает каждый член:
y_t: Значение ряда в момент времени t — то, что вы хотите предсказать
c: Константа, которая вместе с коэффициентами задаёт долгосрочное среднее ряда
phi_1 до phi_p: Коэффициенты, показывающие, насколько каждое прошлое значение влияет на прогноз
y_t-1 до y_t-p: Запаздывающие значения; «лаг» — это насколько шагов назад вы смотрите
epsilon_t: Белый шум — случайная ошибка с нулевым средним, постоянной дисперсией и отсутствием автокорреляции
Проще говоря, модель умножает каждое из последних p значений на его вес и добавляет константу. Остаток — шум, та часть y_t, которую прошлое объяснить не может.
AR(1) — самый простой вариант:
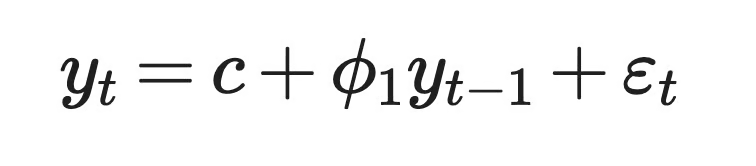
Модель AR(1)
Значение phi_1 определяет, насколько сильно сегодня влияет на завтра.
Пусть c = 2 и phi_1 = 0.8. Если сегодня значение равно 15, модель предсказывает на завтра 2 + 0.8 × 15 = 14. Далее 2 + 0.8 × 14 = 13.2. На каждом шаге ряд приближается к 10 — долгосрочному среднему c / (1 - phi_1).
Если phi_1 отрицательно, ряд будет прыгать выше и ниже среднего от шага к шагу.
AR(2) добавляет второй лаг:
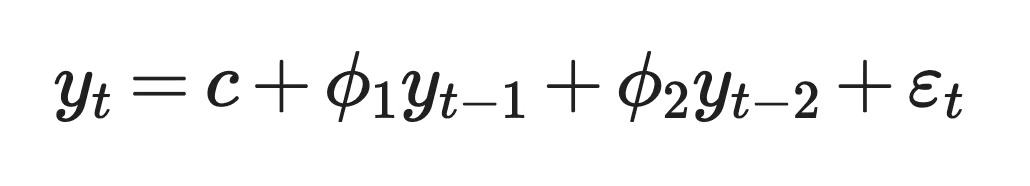
Модель AR(2)
С двумя лагами модель может описывать такие шаблоны, как циклы, с которыми AR(1) не справляется. Например, положительное phi_1 и отрицательное phi_2 могут давать волнообразную динамику, напоминающую деловой цикл.
Итак, любая AR-модель сводится к двум выборам: сколько лагов использовать и какие веса им назначить.
AR-модель работает только при двух условиях. Прошлые значения должны быть связаны с будущими, а поведение ряда — оставаться неизменным во времени. Первое называется автокорреляцией, второе — стационарностью.
Автокорреляция — это корреляция между временным рядом и его лаговой копией.
Именно благодаря ей существуют AR-модели. Если сегодняшнее значение ничего не говорит о завтрашнем, модели нечему учиться из прошлого.
В коде вы берёте столбец значений, копируете его и сдвигаете копию на одну строку вниз. Теперь каждая строка связывает значение с предыдущим. Корреляция между двумя столбцами — это автокорреляция лаг-1. При сдвиге на две строки вы получаете автокорреляцию лаг-2.
Вот как это выглядит в pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))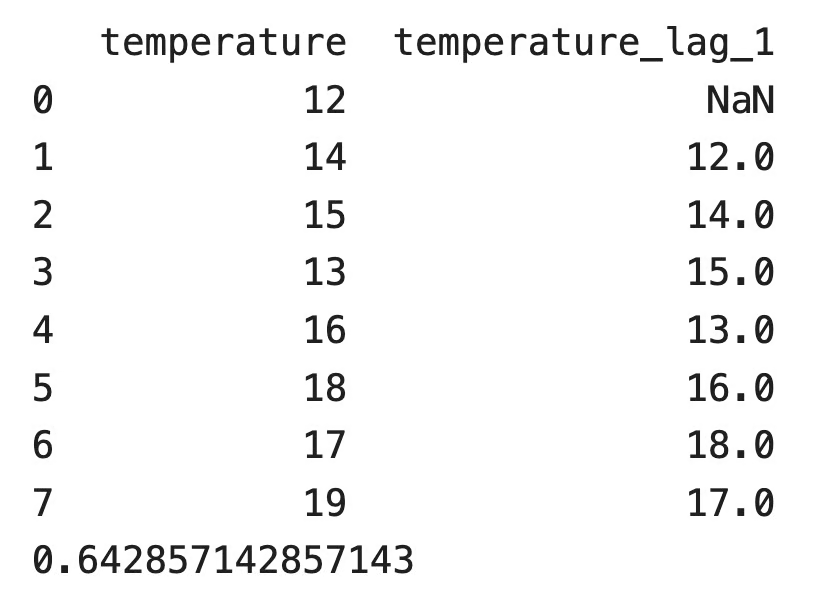
DataFrame со столбцом temperature и его копией лаг-1
Первая строка лагового столбца пустая, потому что перед первым значением нет предыдущего. pandas пропускает её и возвращает автокорреляцию лаг-1 равную 0.643. В этом ряду тёплые дни обычно следуют за тёплыми.
Знак автокорреляции меняет поведение ряда:
Автокорреляция, близкая к нулю, означает, что прошлое не помогает. В этом случае AR-модель вряд ли превзойдёт предсказание среднего.
AR-модели нужна стационарность временного ряда.
Стационарный ряд имеет одинаковые среднее, дисперсию и автокорреляцию для заданного лага — независимо от участка ряда. Статистики называют это слабо́й стационарностью.
Это важно, потому что модель оценивает один фиксированный набор коэффициентов. Если среднее ряда со временем сдвигается, коэффициенты, полученные на старых данных, не опишут новые. Цены акций — частый пример нестационарного ряда из‑за долгосрочного тренда. Ежедневные доходности гораздо ближе к стационарным.
Сами коэффициенты определяют, стационарен ли AR-процесс. Для AR(1) правило простое: phi_1 должно быть между −1 и 1.
abs(phi_1) < 1: Воздействия со временем затухают, и ряд возвращается к среднему
phi_1 = 1: Ряд превращается в случайное блуждание, воздействия не затухают
abs(phi_1) > 1: Каждое воздействие усиливается, ряд «взрывается»
Для AR(2) одновременно нужны три условия: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 и abs(phi_2) < 1.
Начиная с двух лагов, требуется общее правило. У каждой AR(p) есть характеристический полином:
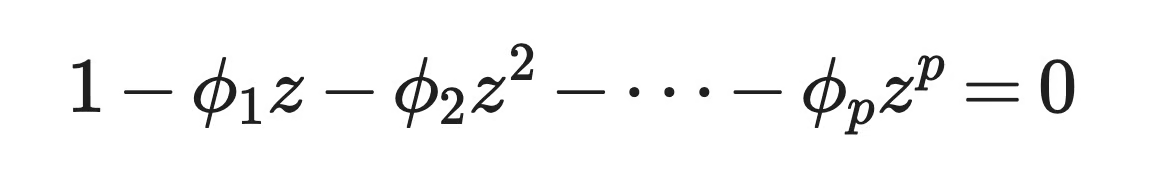
Характеристический полином
Процесс является слабо стационарным, когда все корни этого полинома лежат вне единичной окружности, то есть модуль каждого корня z больше 1. Корни могут быть комплексными, поэтому граница — окружность на комплексной плоскости, а не прямая.
Проверим это на AR(1). Полином 1 - phi_1 z = 0, значит корень z = 1 / phi_1. Он вне единичной окружности только если abs(phi_1) < 1 — то самое правило.
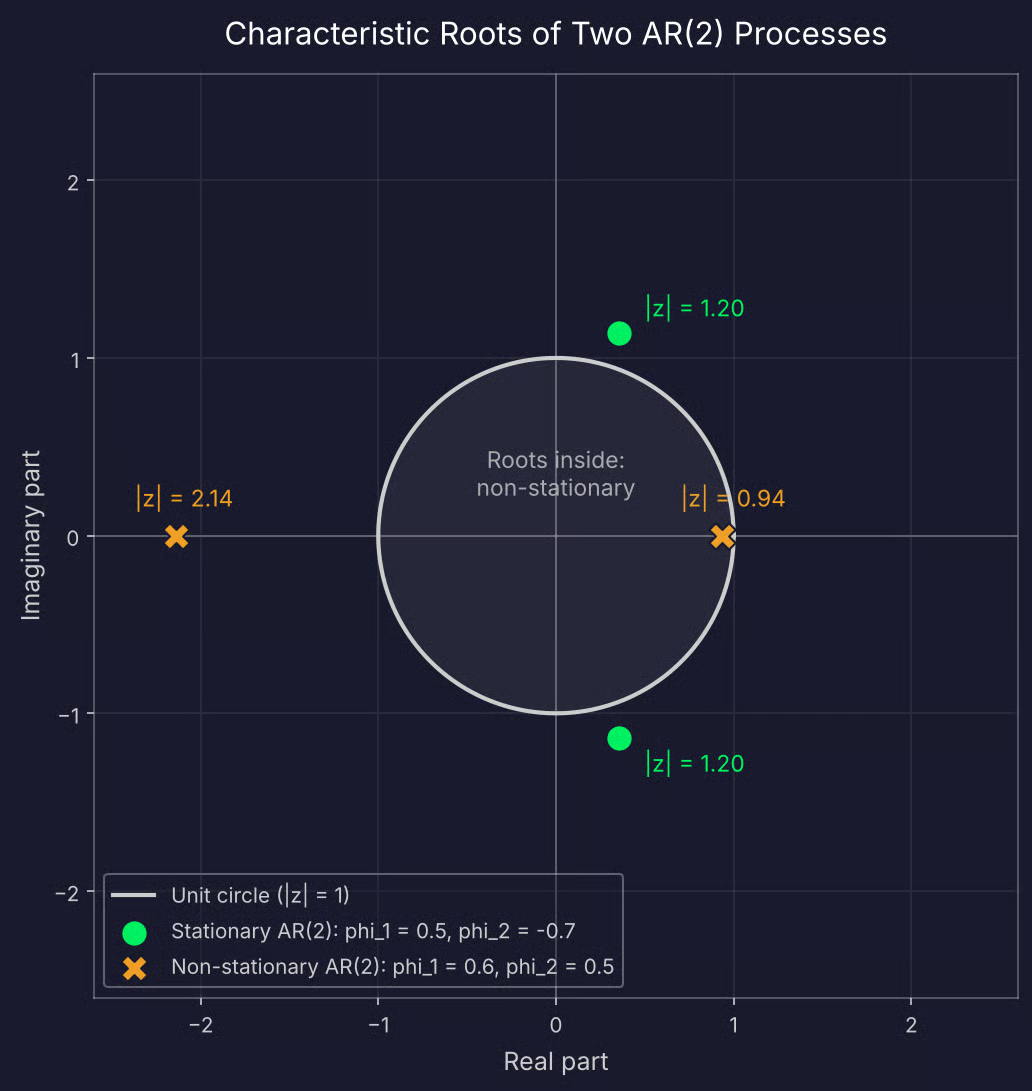
Корни стационарного и нестационарного процесса AR(2)
Считать корни вручную не придётся. statsmodels возвращает их после обучения модели, а как проверить стационарность самих данных — покажем в разделе про Python.
Если ваш ряд нестационарен, можно продифференцировать его — вычесть каждое значение из следующего — и моделировать разности. Именно это означает «I» в моделях ARIMA.
У всех AR-моделей одно и то же уравнение. Отличается только порядок p — сколько прошлых значений использует модель.
AR(1) использует только предыдущее значение, чтобы предсказать следующее.
Если это звучит как линейная регрессия — так и есть. Разместите y_t-1 по оси x, а y_t по оси y — AR(1) проведёт прямую через точки. Константа c — это свободный член, а phi_1 — наклон. Если вы знакомы с простой линейной регрессией, вы уже понимаете, как оценивается AR(1).
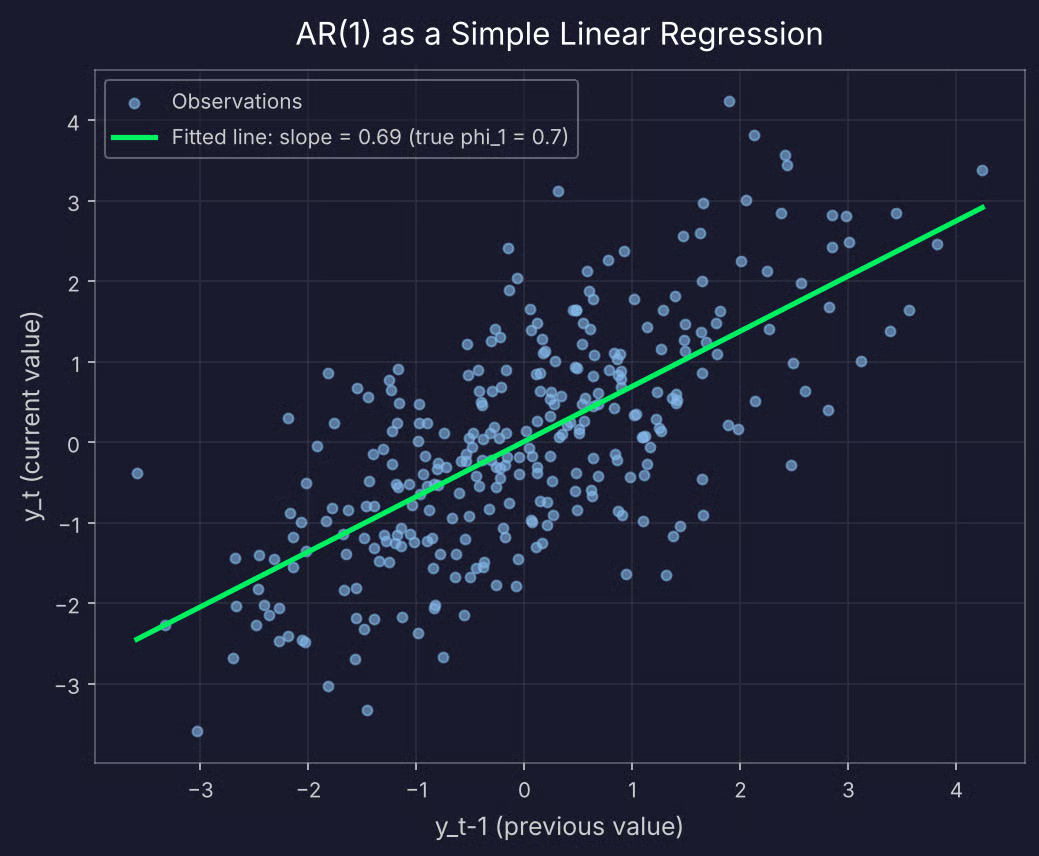
Диаграмма рассеяния y_t против y_t-1 для AR(1)
Но есть отличие. В стандартной регрессии признак и цель — разные переменные. В AR(1) признак — тот же ряд, сдвинутый на один шаг. Поэтому нельзя перемешивать строки или делать случайное разделение train/test — порядок данных является частью модели.
Значение phi_1 меняет внешний вид ряда:
phi_1 = 0.3: Ряд почти как случайный шум, поскольку каждое значение мало влияет на следующее
phi_1 = 0.9: Ряд движется длинными плавными колебаниями и медленно возвращается к среднему
phi_1 = -0.8: Ряд зигзагами проходит выше и ниже среднего почти на каждом шаге
phi_1 = 1: Ряд становится случайным блужданием и дрейфует без среднего, к которому возвращаться — нестационарный случай из предыдущего раздела
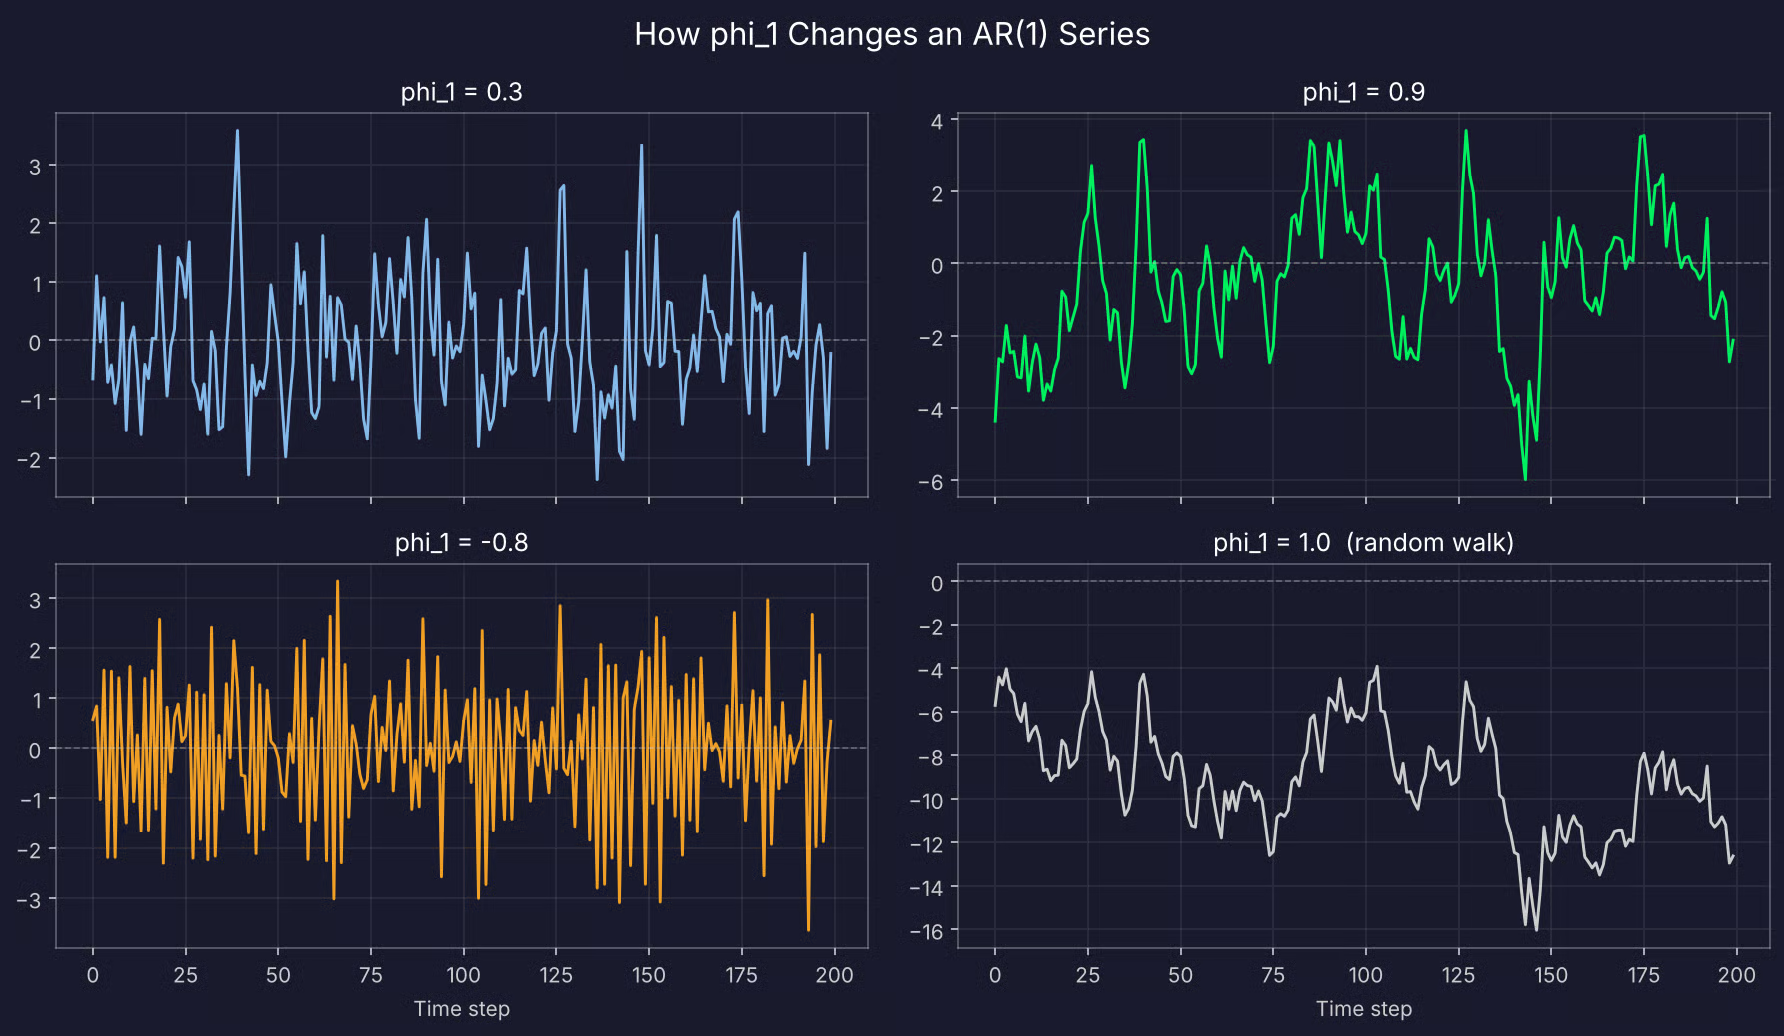
Четыре смоделированных ряда AR(1)
Чем ближе phi_1 к 1 или −1, тем дольше единичный шок влияет на ряд.
AR(2) использует два предыдущих значения. Второй лаг позволяет модели порождать паттерны, недоступные AR(1), в первую очередь циклы.
Сравним два набора коэффициентов:
phi_1 = 0.5, phi_2 = 0.3: Оба лага тянут в одну сторону, ряд похож на AR(1) с более длинными и плавными колебаниями
phi_1 = 0.5, phi_2 = -0.7: Второй лаг работает против первого, и ряд поднимается и опускается волнами с периодом примерно в пять шагов
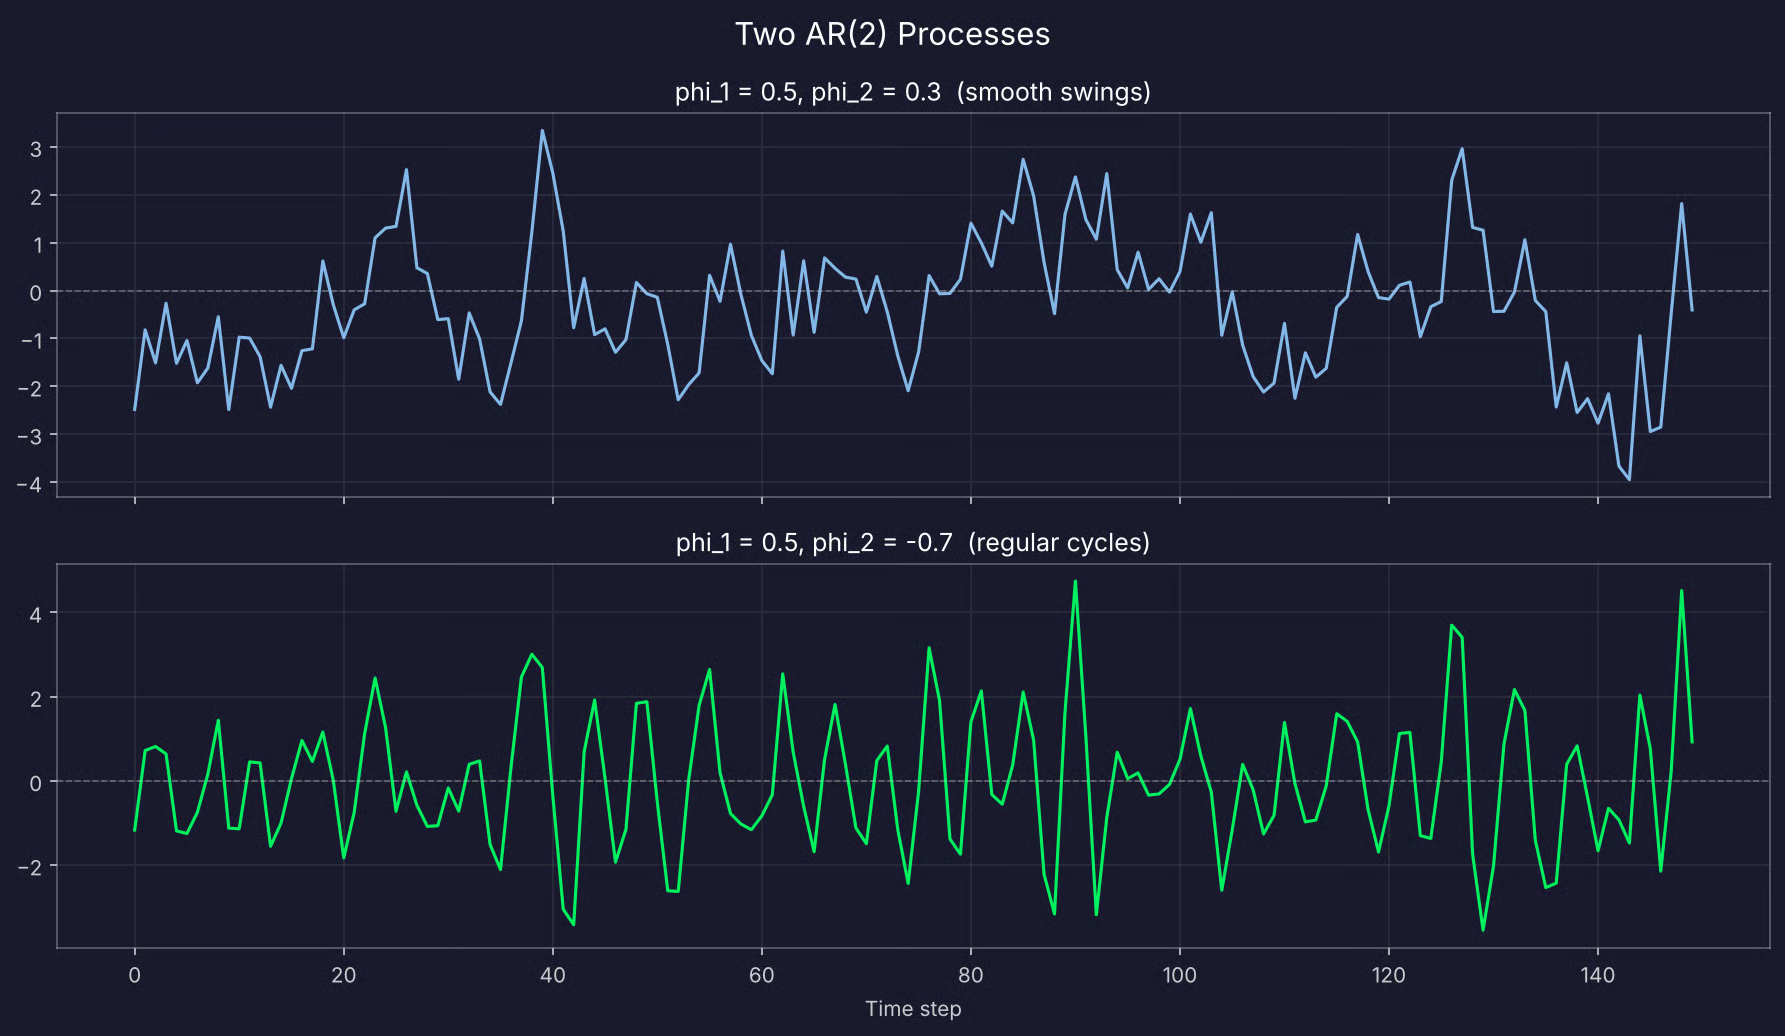
Два смоделированных ряда AR(2)
AR(3), AR(4) и далее добавляют по одному лагу. Они нужны, когда более дальние значения несут информацию, которой нет у недавних.
Например, вы моделируете помесячные продажи, и тот же месяц прошлого года хорошо предсказывает текущий. Модель AR(12) включает лаг в 12 месяцев и ещё 11 промежуточных лагов.
Каждый дополнительный лаг — это ещё один оцениваемый коэффициент. Значит, нужно больше данных, а риск переобучения растёт. Коэффициенты также труднее интерпретировать — при их числе 12 по самим числам уже не понять, что будет делать ряд. Проверяют корни.
Как выбрать порядок при помощи PACF и AIC покажем в разделе про Python.
AR-модели встречаются везде, где данные упорядочены, а недавнее прошлое что-то говорит о ближайшем будущем.
Большинство применений попадает в одну из четырёх групп:
Последний пункт часто удивляет: термин, стоящий за сегодняшними чат-ботами, происходит из той же статистики, о которой вы читаете.
В этом разделе мы обучим авторегрессионную модель в Python со statsmodels — от сырых данных до прогноза, который можно оценить.
Нужны pandas и NumPy для данных, statsmodels для модели и тестов, и scikit-learn для метрики ошибки:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorСмоделируем два года ежедневного спроса на электроэнергию из процесса AR(2).
Мы используем сгенерированные данные, потому что истинные коэффициенты заранее известны. Так можно проверить, находит ли их модель и указывает ли выбор лага на верный порядок.
Процесс имеет c = 15, phi_1 = 0.6 и phi_2 = 0.25, что даёт долгосрочное среднее 100 МВт⋅ч:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()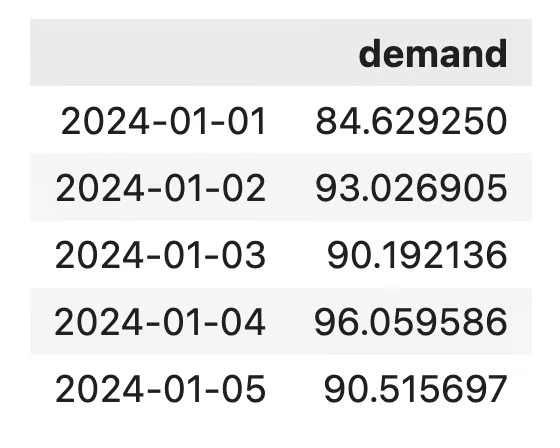
Набор данных с дневным спросом на электроэнергию
Первые 100 смоделированных дней удалены — период разгона даёт ряду время «устаканиться» перед началом использования.
Вот как выглядит весь ряд:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()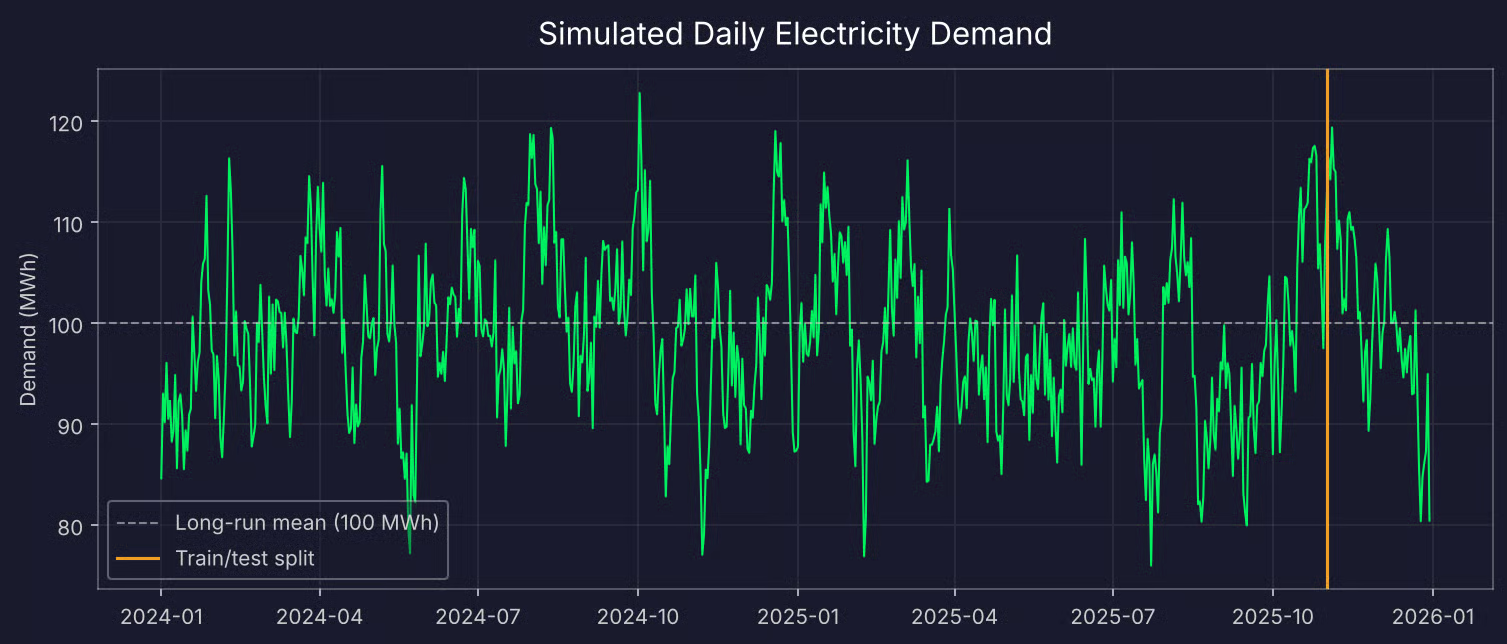
Два года смоделированного ежедневного спроса на электроэнергию
Ряд колеблется вокруг 100 без тренда — так должен выглядеть стационарный ряд. Но визуальной проверки недостаточно.
Тест расширенного Дики–Фуллера (ADF) проверяет, стационарен ли ряд. Нулевая гипотеза — ряд нестационарен, поэтому небольшое p-значение — это то, что нужно:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")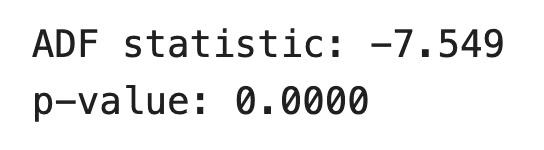
Результаты теста ADF
p-значение значительно ниже 0.05, значит нулевая гипотеза отвергается, и ряд можно считать стационарным.
Если ваши данные тест не проходят, продифференцируйте их с помощью df["demand"].diff().dropna() и запустите тест снова.
Данные временных рядов нельзя перемешивать, поэтому тестовый набор берётся из конца ряда. Оставим последние 60 дней на тест:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Остаётся 670 дней для обучения и 60 — для теста.
Этот шаг определяет, насколько хорошо заработает модель. Если лагов мало, модель упустит паттерны. Если слишком много — подгонит шум обучения, который не повторится в будущем.
Есть два инструмента.
Первый — частичная автокорреляционная функция (PACF). Она показывает корреляцию между рядом и каждым лагом после удаления эффекта всех более коротких лагов. Для процесса AR(p) PACF имеет значимые пики до лага p и далее падает примерно к нулю:
plot_pacf(train, lags=20, method="ywm")
plt.show()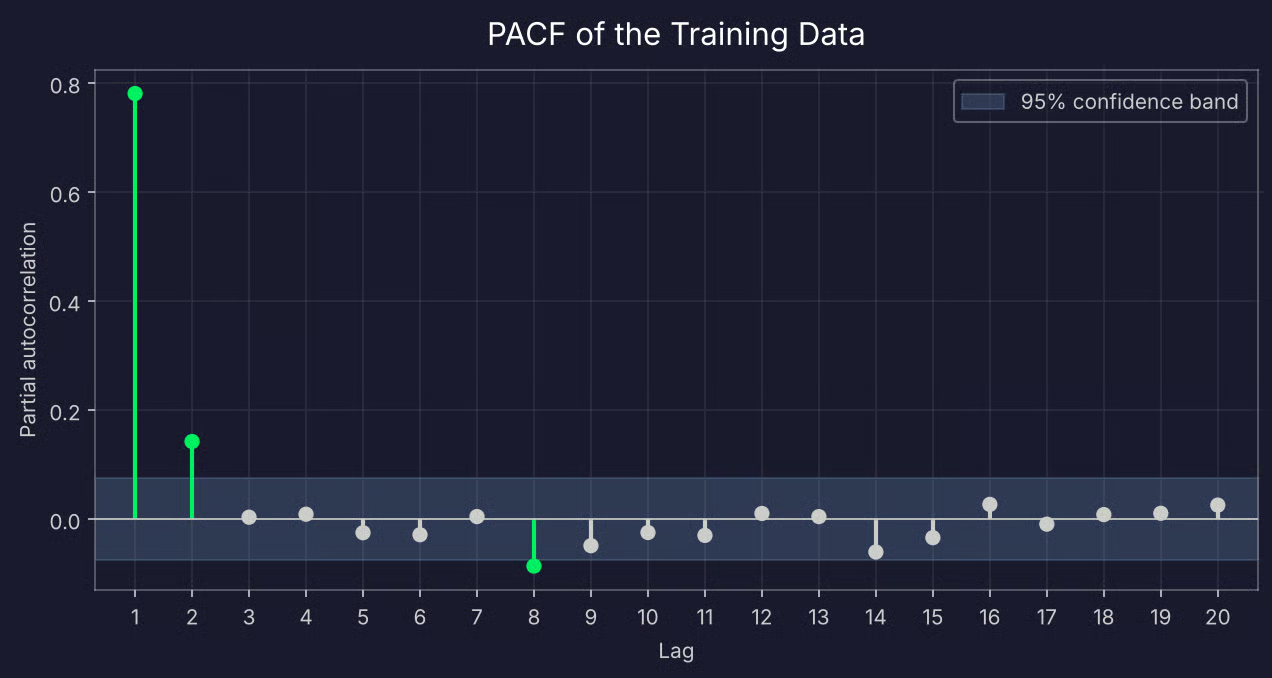
PACF обучающей выборки
Лаги 1 и 2 сильно выходят за пределы доверительной полосы, а лаг 3 падает почти до нуля. Это указывает на AR(2).
Есть небольшой пик на лаге 8, чуть за границей полосы. Не придавайте ему большого значения. Полоса построена на уровне доверия 95%, так что при 20 лагах один из них может пересечь её случайно.
Второй инструмент — информационные критерии. И AIC, и BIC поощряют хорошую подгонку данных и штрафуют за каждый лишний параметр. BIC штрафует сильнее и обычно выбирает более компактные модели. statsmodels может перебрать все порядки до максимального и вернуть лучший:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")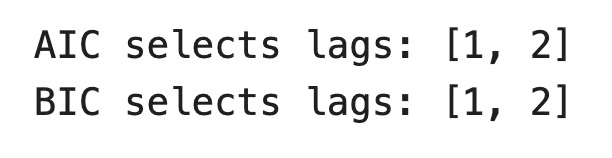
Выбор лагов по AIC/BIC
Оба критерия согласуются с PACF. На практике AIC часто выбирает чуть более крупную модель, чем BIC. В таком случае начните с меньшей.
Когда порядок выбран, обучение модели требует двух строк кода:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")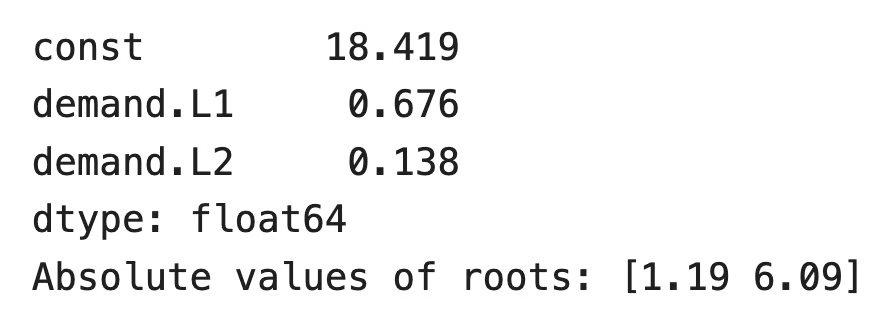
Параметры модели AR(2)
Истинные значения — 0.6 и 0.25. Модель даёт чуть больший вес первому лагу и меньший — второму, но их сумма близка: 0.81 против 0.85. С 670 наблюдениями точные значения восстановить сложно.
Оба корня имеют модуль больше 1, значит, подогнанная модель стационарна. Вызовите results.summary(), если нужны стандартные ошибки, p-значения и полная таблица корней.
Есть два способа прогнозировать тестовый период, и они отвечают на разные вопросы:
Многошаговые прогнозы берутся напрямую из результатов обучения. Для одношаговых вы применяете обученные коэффициенты ко всему ряду:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")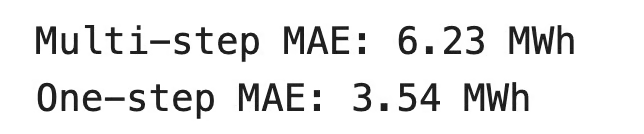
Результаты прогноза
Средняя абсолютная ошибка (MAE) — это среднее абсолютное отклонение предсказаний от фактических значений. Она выражена в тех же единицах, что и данные, поэтому читается напрямую. Одношаговый прогноз промахивается в среднем на 3.54 МВт⋅ч.
Сравним оба прогноза с фактическими значениями:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()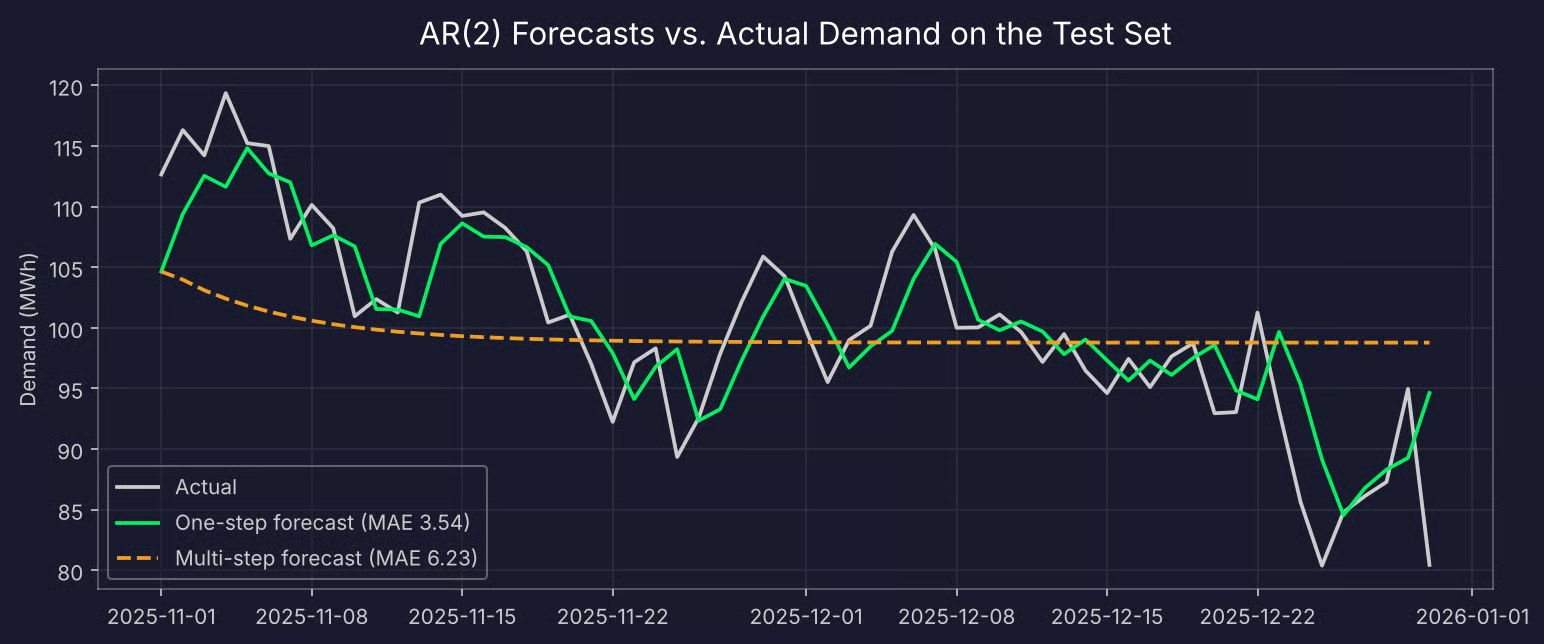
Одношаговый и многошаговый прогнозы AR(2) по сравнению с фактическим спросом
Одношаговый прогноз близко следует за фактическими значениями, с лагом примерно в один день. Многошаговый стартует с последнего известного значения и в течение примерно трёх недель выравнивается возле среднего.
Так ведёт себя любая стационарная AR-модель: чем дальше горизонт прогноза, тем меньше говорит прошлое, и лучшая догадка — долгосрочное среднее. Поэтому AR лучше всего работают для краткосрочного прогнозирования.
Легко предположить, что чем больше истории, тем лучше прогноз. Проверим: обучим модели с растущим числом лагов и сравним их одношаговые MAE:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")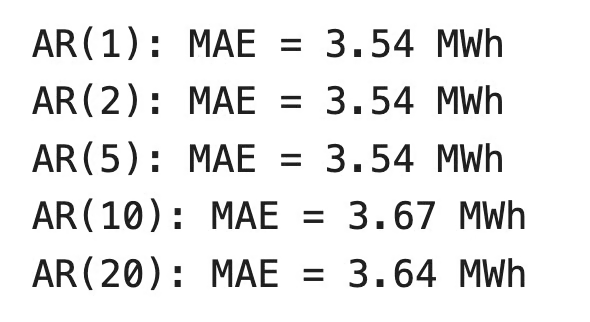
MAE при увеличении числа лагов
Ошибка не уменьшается после AR(2) и растёт у AR(10) и AR(20). Эти дополнительные коэффициенты подгоняют шум обучающей выборки.
Вы также заметите, что AR(1) работает здесь не хуже AR(2). Оценённый второй коэффициент мал, поэтому на этом тестовом наборе он мало что добавляет. Когда две модели дают одинаковый результат, проще объяснить и надёжнее на новых данных будет более простая.
Есть и затратная сторона: AR(20) оценивает 21 параметр вместо 3.
Итог: пусть порядок подскажут PACF и информационные критерии, а затем подтвердите его на тестовом наборе.
AR-модели подходят для многих задач прогнозирования, но не для всех. Разберём, где они уместны, где нет и как соотносятся с моделями, построенными на их основе.
У AR-моделей два главных преимущества:
Есть и два основных ограничения:
Есть ещё одна проблема. Лаговые значения коррелируют друг с другом, потому что происходят из одного ряда. В данных по спросу корреляция между y_t-1 и y_t-2 равна 0.78.
Это называется мультиколлинеарностью, и она затрагивает любую регрессию. Когда два предиктора движутся вместе, модели трудно понять, кто из них «виноват». Коэффициенты становятся менее стабильными, их стандартные ошибки растут.
Это объясняет увиденное выше: модель оценила 0.676 и 0.138 вместо 0.6 и 0.25 — она переставила вес между лагами, но их сумма осталась близкой. Прогнозы страдают от этого не сильно, но доверять отдельным коэффициентам уже нельзя. Каждый дополнительный лаг усугубляет проблему.
AR — один из трёх строительных блоков классического прогнозирования временных рядов. Два других — модели скользящего среднего (MA) и ARIMA, которая их объединяет.
AR предсказывает по прошлым значениям. MA предсказывает по прошлым ошибкам:
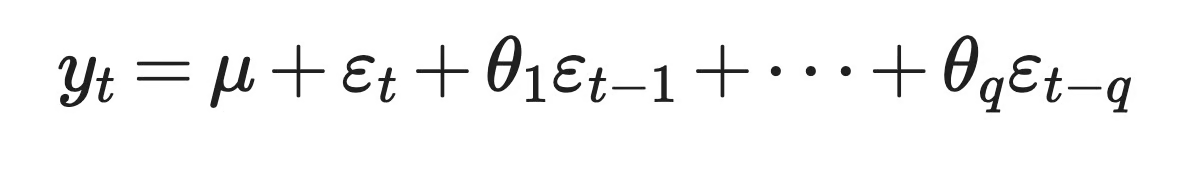
Модель ARMA
Здесь mu — среднее ряда, theta_1 до theta_q — коэффициенты, а epsilon_t-1 до epsilon_t-q — случайные шоки прошлых шагов. Не путайте со скользящим средним как скользящим окном — названия совпадают, но модель иная.
Две модели по‑разному реагируют на шоки. В MA(q) шок влияет ровно q шагов. В AR шок затухает со временем, но никогда не обнуляется полностью. Поэтому для выбора порядка используют разные инструменты: PACF обрывается после лага p в AR-моделях, а ACF — после лага q в MA-моделях.
ARIMA объединяет всё вместе. В ARIMA(p, d, q) три части:
Это означает, что AR — частный случай ARIMA. Если задать d и q равными нулю, получится AR-модель. Проверим это на данных спроса:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))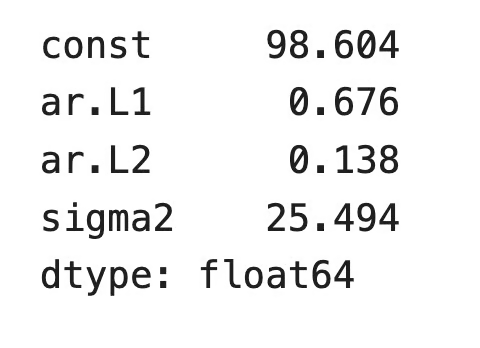
Модель ARIMA с нулевой интеграцией и порядком MA
AR‑коэффициенты совпадают с AutoReg. Константа отличается, потому что ARIMA сообщает среднее ряда, а AutoReg — свободный член c.
Теперь посмотрим, где ARIMA идёт дальше. Допустим, город растёт, и спрос на электроэнергию ежедневно немного повышается. В ряду появляется тренд, тест ADF его не проходит, и AR-модель уже не может напрямую работать с рядом.
Но модель ARIMA(2, 1, 0) может. Она один раз дифференцирует ряд, то есть работает с дневными изменениями спроса вместо исходных значений, а затем подгоняет AR(2) к этим изменениям. Если, скажем, жара влияет и на следующий день, можно добавить член MA и получить ARIMA(2, 1, 1).
Часть AR делает одну и ту же работу во всех случаях. ARIMA лишь готовит для неё данные и моделирует остатки. Если хотите углубиться, курс ARIMA Models in R подробно разбирает весь процесс.
Авторегрессионная модель предсказывает следующее значение ряда по собственному прошлому. Это линейная регрессия, где предикторы — лаговые копии целевой переменной, и поэтому это одна из самых понятных моделей временных рядов.
Её применяют в экономике, речевом кодировании, анализе ЭЭГ и даже в названии современных языковых моделей. Вы также увидели, где она не лучший выбор: ей нужны стационарные данные, она зависит от правильного порядка лагов, а коррелированные лаги снижают надёжность отдельных коэффициентов.
Поняв AR-модели, вы намного легче освоите классическое прогнозирование. Логичный следующий шаг — ARIMA: в нашем руководстве по ARIMA показано, как дифференцирование и члены MA расширяют изученное здесь. Для практики пройдите курс ARIMA Models in Python.
Учитесь с DataCamp
Курс
Курс
Курс