Kurs
Analiza szeregów czasowych w Pythonie
4 godz.
70.9K
Większość treści w sieci od razu przechodzi do ARIMA i co najwyżej poświęca części AR jedno zdanie. Tymczasem AR jest fundamentem całego modelu. Jeśli go nie rozumiesz, reszta ARIMA też nie będzie miała sensu.
W prostych słowach, model autoregresyjny przewiduje przyszłe wartości szeregu czasowego na podstawie jego własnych wartości z przeszłości. Spotkasz go w ekonomii, finansach, przetwarzaniu sygnałów i danych klimatycznych. To w gruncie rzeczy model regresyjny, więc łączy to, co już wiesz o regresji, z prognozowaniem szeregów czasowych, i stanowi bazę, na której zbudowano ARIMA.
W tym artykule pokażę ci, jak działa model autoregresyjny, jak dopasować go w Pythonie ze statsmodels oraz jak wybrać właściwy rząd opóźnień.
Model autoregresyjny przewiduje kolejną wartość szeregu jako ważoną sumę jego poprzednich wartości.
W nazwie „auto” znaczy „sam”, a „regresja” oznacza przewidywanie jednej zmiennej na podstawie innych. Zatem model autoregresyjny to regresja szeregu na jego własnej przeszłości.
Załóżmy, że chcesz przewidzieć jutrzejsze zapotrzebowanie na energię elektryczną. Dzisiejsze zapotrzebowanie to dobry punkt wyjścia, a wczorajsze dodaje nieco informacji. Model autoregresyjny zamienia tę intuicję w wzór i uczy się wag z twoich danych.
Modele AR zapisuje się jako AR(p), gdzie p to rząd modelu. Rząd mówi, ile przeszłych wartości model wykorzystuje:
p wartościWyższy rząd nie oznacza automatycznie lepszego modelu. Pokażę ci później, jak wybrać p.
Oto ogólna postać modelu AR(p):
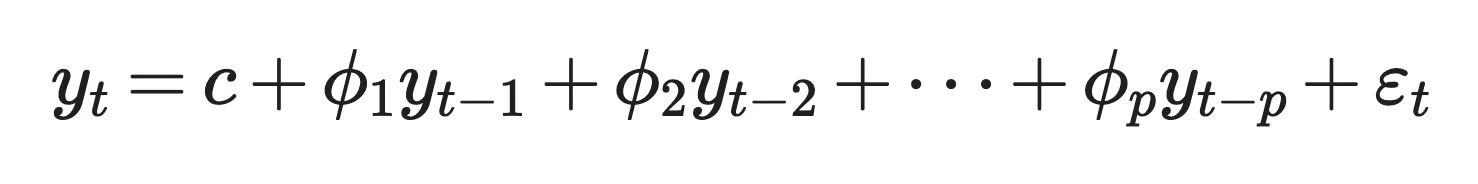
Ogólny model AR(p)
Rola poszczególnych składników
y_t: Wartość szeregu w chwili t, czyli to, co chcesz przewidzieć
c: Stała, która wraz ze współczynnikami wyznacza długookresową średnią szeregu
phi_1 do phi_p: Współczynniki mówiące, jak bardzo każda przeszła wartość wpływa na prognozę
y_t-1 do y_t-p: Wartości opóźnione, gdzie „opóźnienie” oznacza, o ile kroków wstecz patrzysz
epsilon_t: Biały szum, czyli losowy błąd o średniej zero, stałej wariancji i bez autokorelacji w czasie
W uproszczeniu model mnoży każdą z ostatnich p wartości przez jej wagę i dodaje stałą. To, co zostaje, to szum – część y_t, której przeszłość nie wyjaśnia.
AR(1) to najprostsza wersja:
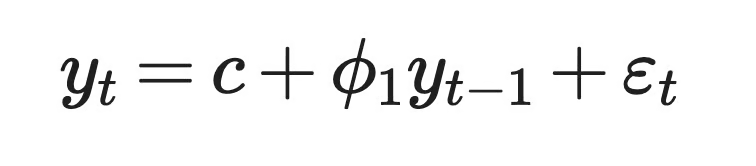
Model AR(1)
Wartość phi_1 kontroluje, jak bardzo dzisiejszy dzień wpływa na jutrzejszy.
Załóżmy, że c = 2 i phi_1 = 0.8. Jeśli dzisiejsza wartość to 15, model prognozuje 2 + 0.8 × 15 = 14 na jutro. Następna prognoza to 2 + 0.8 × 14 = 13.2. Każdy krok przybliża szereg do 10, czyli długookresowej średniej, c / (1 - phi_1).
Jeśli phi_1 jest ujemne, szereg przeskakuje powyżej i poniżej średniej z kroku na krok.
AR(2) dodaje drugie opóźnienie:
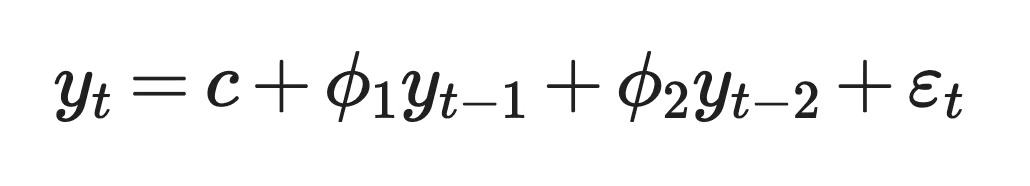
Model AR(2)
Dzięki dwóm opóźnieniom model potrafi opisać wzorce, których AR(1) nie uchwyci, jak cykle. Na przykład dodatnie phi_1 z ujemnym phi_2 może wytworzyć serię, która wznosi się i opada falami, podobnie do cyklu koniunkturalnego.
Każdy model AR sprowadza się więc do dwóch decyzji — ile opóźnień użyć i jakie wagi im nadać.
Model AR działa tylko wtedy, gdy w twoich danych spełnione są dwa warunki. Wartości z przeszłości muszą być powiązane z przyszłymi (autokorelacja), a szereg musi zachowywać się tak samo w czasie (stacjonarność).
Autokorelacja to korelacja między szeregiem a jego opóźnioną kopią.
To powód, dla którego modele AR w ogóle mają sens. Jeśli dzisiejsza wartość nic nie mówi o jutrzejszej, model nie ma się czego nauczyć z przeszłości.
W kodzie bierzesz kolumnę wartości, kopiujesz ją i przesuwasz kopię o jeden wiersz w dół. Teraz każdy wiersz paruje wartość z poprzednią. Korelacja między kolumnami to autokorelacja opóźnienia 1. Gdy przesuniesz o dwa wiersze, otrzymasz autokorelację opóźnienia 2.
Tak to wygląda w pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))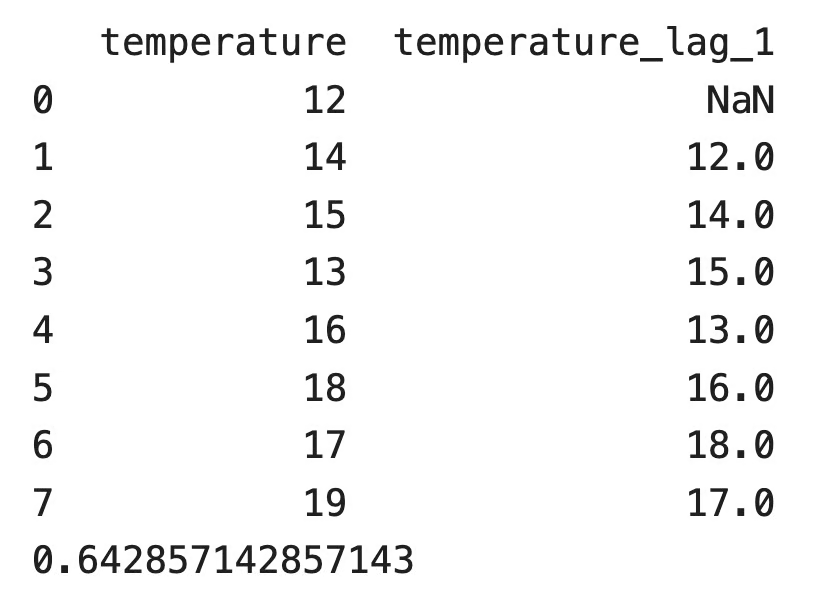
DataFrame z kolumną temperatury i jej kopią opóźnienia 1
Pierwszy wiersz w opóźnionej kolumnie jest pusty, bo nie ma odczytu sprzed pierwszego. pandas pomija ten wiersz i zwraca autokorelację opóźnienia 1 równą 0.643. Ciepłe dni mają tu tendencję do następowania po ciepłych dniach.
Znak autokorelacji zmienia zachowanie szeregu:
Autokorelacja bliska zeru oznacza, że przeszłość nie pomaga. W takim przypadku model AR nie przewyższy istotnie prognozy średniej.
Modele AR potrzebują stacjonarnego szeregu czasowego.
Szereg stacjonarny ma tę samą średnią, tę samą wariancję i tę samą autokorelację dla danego opóźnienia, niezależnie od fragmentu szeregu. Statystycy nazywają to stacjonarnością w słabym sensie.
To ważne, ponieważ model estymuje jeden stały zestaw współczynników. Jeśli średnia szeregu dryfuje w czasie, współczynniki nauczone na starszych danych nie opiszą nowszych. Ceny akcji to częsty przykład niestacjonarnego szeregu, bo wykazują trend przez lata. Dzienne stopy zwrotu są znacznie bliższe stacjonarności.
O stacjonarności procesu AR decydują same współczynniki. Dla AR(1) reguła jest prosta: phi_1 musi leżeć między -1 a 1.
abs(phi_1) < 1: Wstrząsy z czasem wygasają, a szereg wraca do swojej średniej
phi_1 = 1: Szereg staje się błądzeniem losowym, a wstrząsy nigdy nie zanikają
abs(phi_1) > 1: Każdy wstrząs narasta, a szereg „eksploduje”
AR(2) wymaga jednocześnie trzech warunków: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 oraz abs(phi_2) < 1.
Po dwóch opóźnieniach potrzebna jest reguła ogólna. Każdy model AR(p) ma charakterystyczny wielomian:
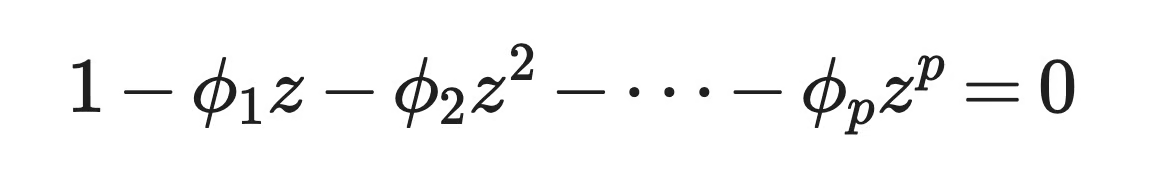
Wielomian charakterystyczny
Proces jest stacjonarny w słabym sensie, gdy wszystkie pierwiastki tego wielomianu leżą poza kołem jednostkowym, czyli każdy pierwiastek z ma moduł większy niż 1. Pierwiastki mogą być zespolone, dlatego granicą jest koło na płaszczyźnie zespolonej, a nie prosta.
Możesz to sprawdzić dla AR(1). Wielomian to 1 - phi_1 z = 0, więc pierwiastek to z = 1 / phi_1. Leży poza kołem jednostkowym tylko wtedy, gdy abs(phi_1) < 1, czyli zgodnie z wcześniejszą regułą.
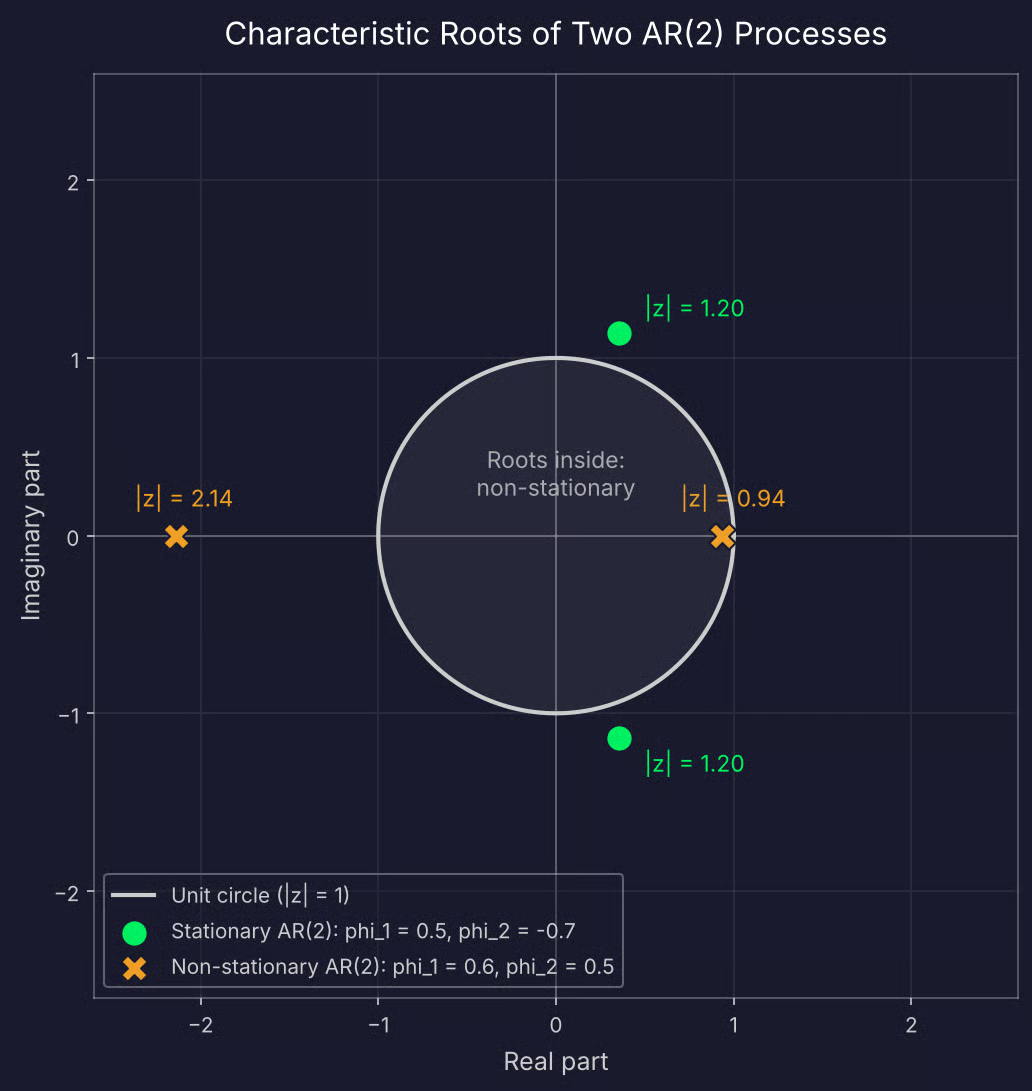
Pierwiastki stacjonarnego i niestacjonarnego procesu AR(2)
Nie będziesz liczyć tych pierwiastków ręcznie. statsmodels zwraca je po dopasowaniu modelu, a w sekcji o Pythonie pokażę ci też, jak testować samą stacjonarność danych.
Jeśli twój szereg nie jest stacjonarny, możesz go zróżnicować — odjąć każdą wartość od kolejnej — i modelować różnice. Na to właśnie wskazuje litera „I” w modelach ARIMA.
Każdy model AR ma to samo równanie. Różni je rząd p, czyli liczba przeszłych wartości użytych przez model.
AR(1) używa tylko poprzedniej wartości do przewidzenia kolejnej.
Brzmi jak regresja liniowa? Bo nią jest. Gdy umieścisz y_t-1 na osi x, a y_t na osi y, AR(1) dopasowuje prostą do punktów. Stała c to wyraz wolny, a phi_1 to nachylenie. Jeśli znasz prostą regresję liniową, wiesz już, jak estymuje się AR(1).
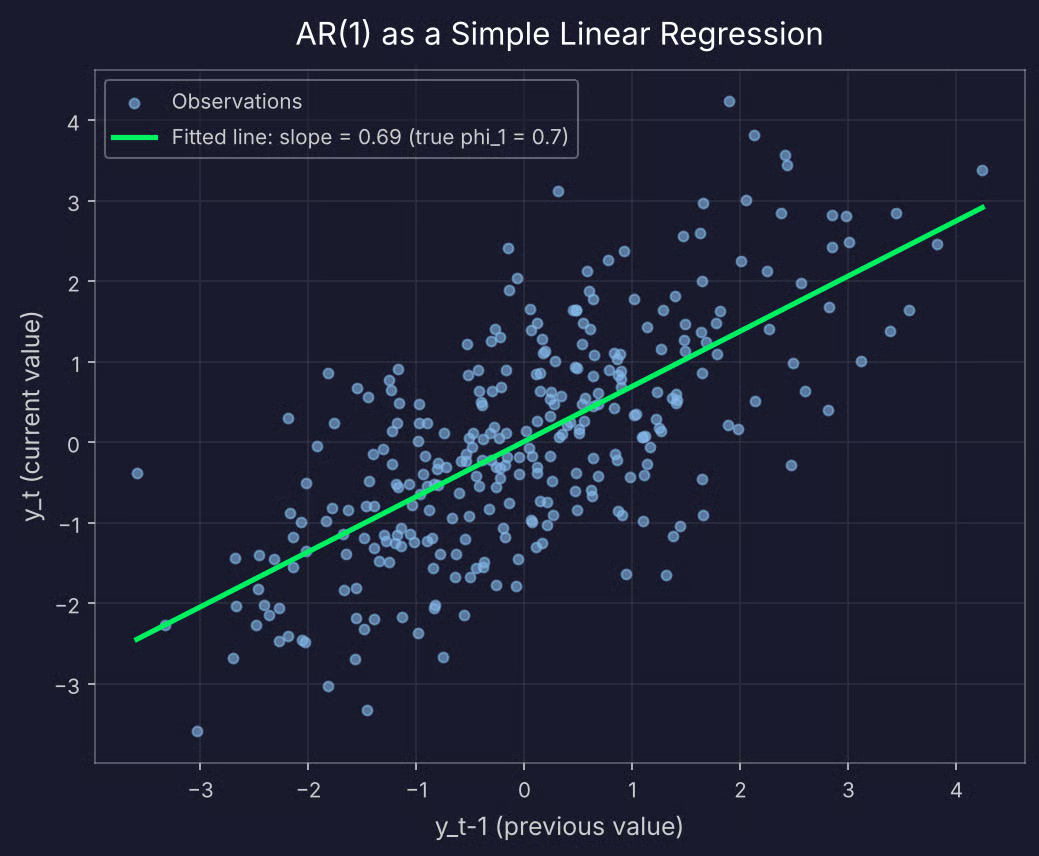
Wykres punktowy y_t względem y_t-1 dla AR(1)
Jest jednak jedna różnica. W standardowej regresji predyktor i cel to różne zmienne. W AR(1) predyktorem jest ten sam szereg przesunięty o jeden krok. Dlatego nie możesz tasować wierszy ani używać losowego podziału train/test — kolejność danych jest częścią modelu.
Wartość phi_1 zmienia wygląd szeregu:
phi_1 = 0.3: Szereg wygląda niemal jak losowy szum, bo każda wartość niewiele mówi o kolejnej
phi_1 = 0.9: Szereg porusza się długimi, gładkimi wahaniami i wolno wraca do średniej
phi_1 = -0.8: Szereg zygzakuje powyżej i poniżej średniej niemal na każdym kroku
phi_1 = 1: Szereg staje się błądzeniem losowym i dryfuje bez średniej, do której wraca — to niestacjonarny przypadek z poprzedniej sekcji
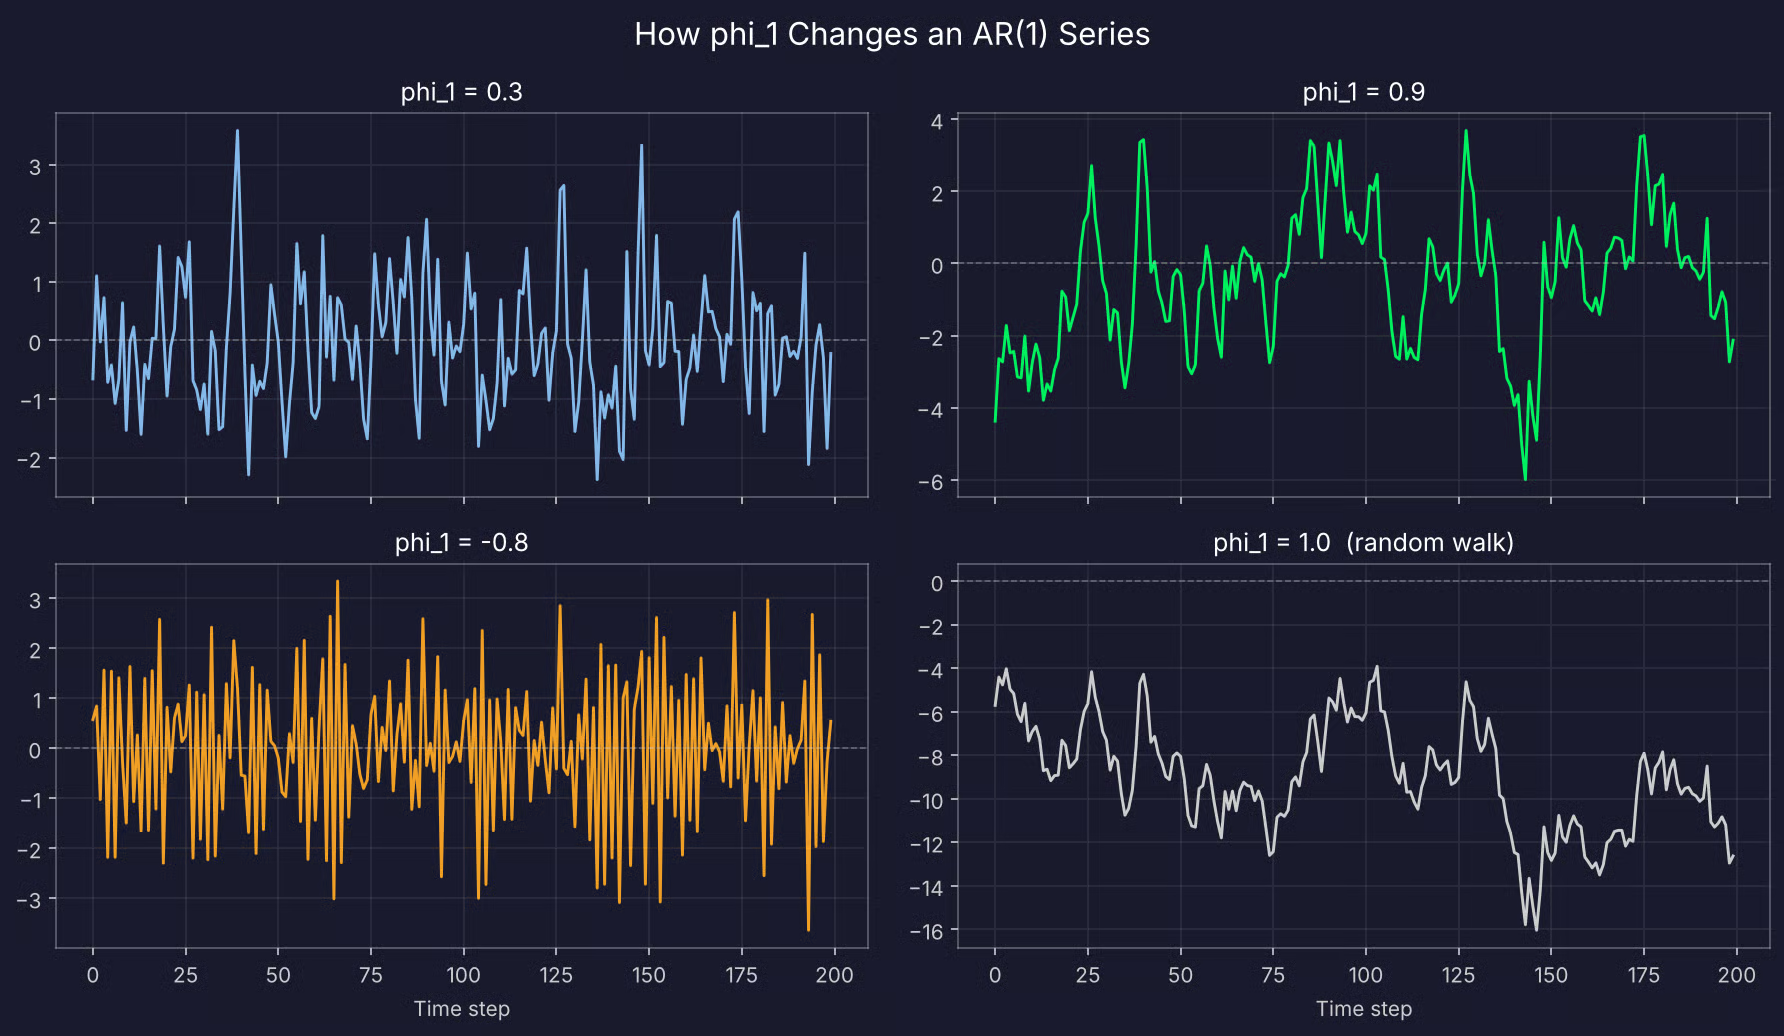
Cztery zasymulowane szeregi AR(1)
Im bliżej phi_1 do 1 lub -1, tym dłużej pojedynczy wstrząs wpływa na szereg.
AR(2) używa dwóch poprzednich wartości. Drugie opóźnienie pozwala modelowi wytwarzać wzorce, których AR(1) nie potrafi, głównie cykle.
Oto porównanie dwóch zestawów współczynników:
phi_1 = 0.5, phi_2 = 0.3: Oba opóźnienia pchają w tym samym kierunku, więc szereg wygląda jak AR(1) z dłuższymi, gładszymi wahaniami
phi_1 = 0.5, phi_2 = -0.7: Drugie opóźnienie działa przeciwnie do pierwszego i szereg wznosi się oraz opada falami powtarzającymi się mniej więcej co pięć kroków
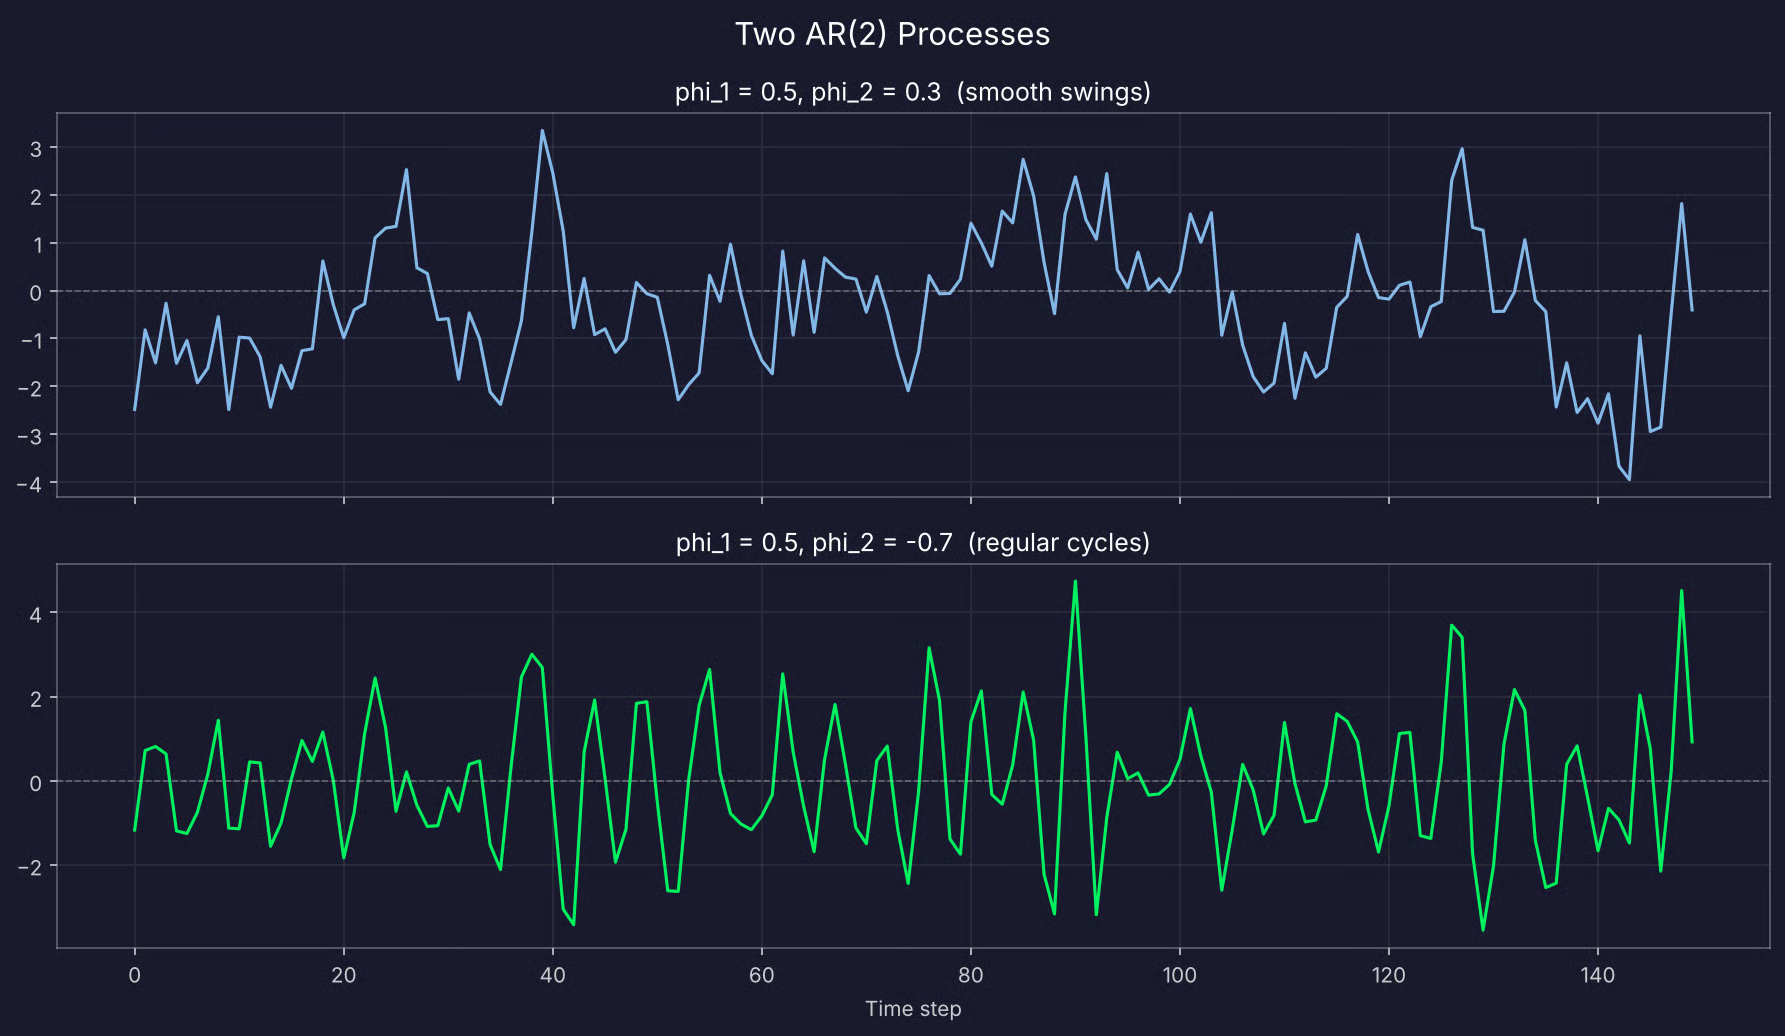
Dwa zasymulowane szeregi AR(2)
AR(3), AR(4) i kolejne dodają po jednym opóźnieniu. Są potrzebne, gdy wartości dalej wstecz niosą informację, której nie zawierają te najnowsze.
Załóżmy, że modelujesz miesięczną sprzedaż i ten sam miesiąc sprzed roku dobrze przewiduje ten miesiąc. Model AR(12) uwzględnia to 12-miesięczne opóźnienie wraz z 11 opóźnieniami pośrednimi.
Każde dodatkowe opóźnienie dodaje współczynnik do oszacowania. To oznacza potrzebę większej ilości danych i większe ryzyko przeuczenia. Współczynniki są też trudniejsze do interpretacji — przy 12 nie da się po samych liczbach wyczytać, co zrobi szereg. Zamiast tego sprawdzasz pierwiastki.
W sekcji o Pythonie pokażę, jak dobrać właściwy rząd za pomocą PACF i AIC.
Modele AR pojawiają się wszędzie tam, gdzie dane są uporządkowane w czasie, a niedaleka przeszłość mówi coś o bliskiej przyszłości.
Większość zastosowań mieści się w czterech grupach:
Ostatni punkt często zaskakuje — termin stojący za dzisiejszymi chatbotami pochodzi z tej samej statystyki, o której tu czytasz.
W tej sekcji dopasuję model autoregresyjny w Pythonie przy użyciu statsmodels — od surowych danych po prognozę, którą możesz ocenić.
Potrzebujesz pandas i NumPy do danych, statsmodels do modelu i testów oraz scikit-learn do metryki błędu:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorZasymuluję dwa lata dziennego zapotrzebowania na energię z procesu AR(2).
Wybrałem dane symulowane, bo znasz prawdziwe współczynniki z góry. Dzięki temu możesz sprawdzić, czy model je znajduje i czy narzędzia wyboru opóźnień wskazują właściwy rząd.
Proces ma c = 15, phi_1 = 0.6 i phi_2 = 0.25, co daje długookresową średnią równą 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()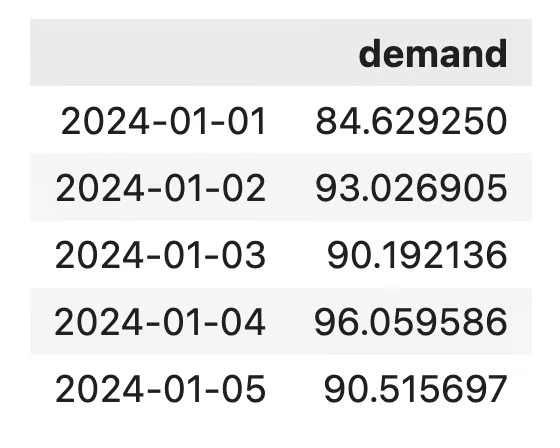
Zbiór danych dziennego zapotrzebowania na energię
Pierwsze 100 symulowanych dni usuwamy, bo okres rozruchu daje czas, by szereg ustabilizował się w swoim normalnym zachowaniu, zanim zaczniemy go używać.
Tak wygląda pełny szereg:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()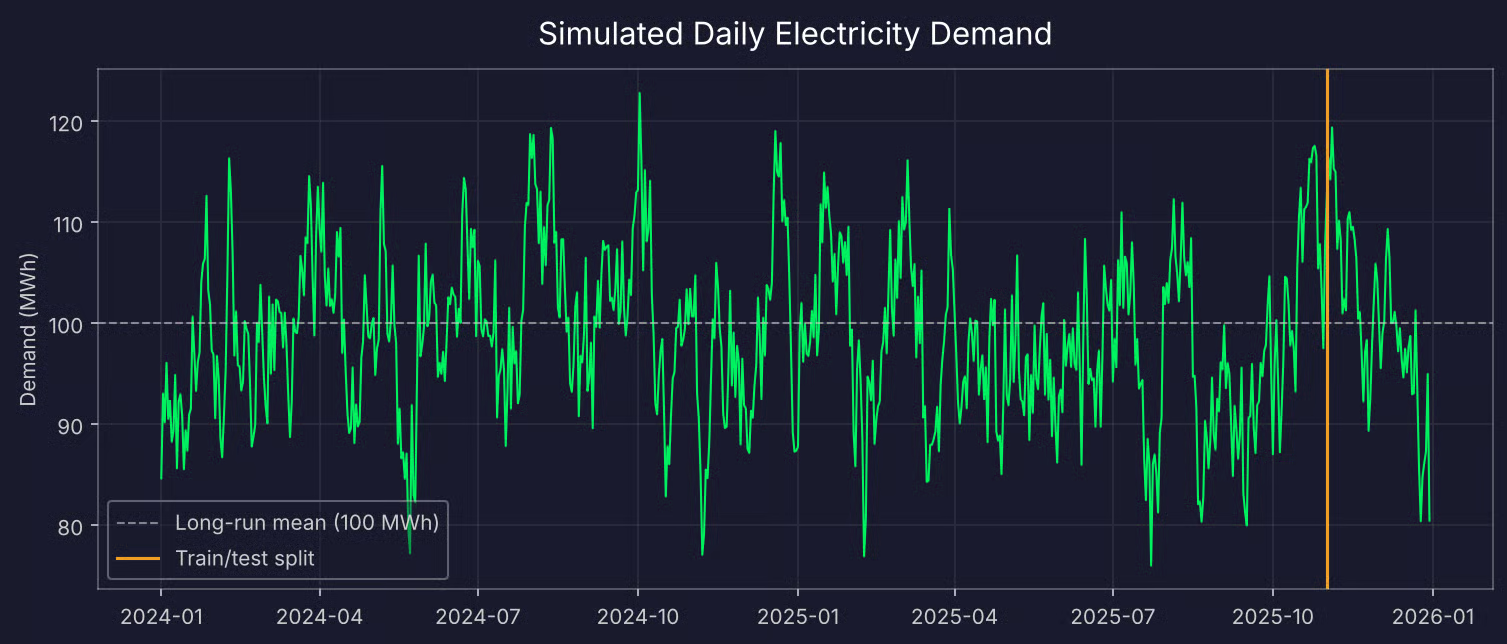
Dwa lata zasymulowanego dziennego zapotrzebowania na energię
Szereg waha się wokół 100 bez trendu — tak powinien wyglądać szereg stacjonarny. Ale wizyjna ocena to nie dowód.
Test rozszerzonego Dickeya-Fullera (ADF) sprawdza, czy szereg jest stacjonarny. Hipoteza zerowa głosi, że szereg nie jest stacjonarny, więc mała wartość p jest pożądana:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")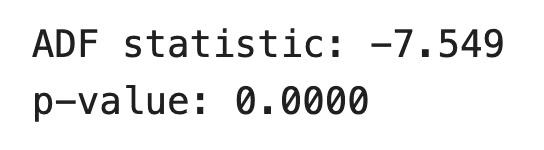
Wyniki testu ADF
Wartość p jest znacznie poniżej 0.05, więc możesz odrzucić hipotezę zerową i traktować szereg jako stacjonarny.
Jeśli twoje dane nie zdadzą testu, zróżnicuj je przez df["demand"].diff().dropna() i uruchom test ponownie.
Danych szeregów czasowych nie można tasować, więc zbiór testowy musi pochodzić z końca szeregu. Zostawię ostatnie 60 dni na test:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
To zostawia 670 dni do trenowania i 60 do testu.
To krok, który decyduje o skuteczności modelu. Jeśli wybierzesz zbyt mało opóźnień, model pominie wzorce w danych. Jeśli zbyt dużo — dopasuje szum z danych treningowych, który nie powtórzy się w przyszłości.
Masz do tego dwa narzędzia.
Pierwsze to funkcja cząstkowej autokorelacji (PACF). Pokazuje korelację między szeregiem a danym opóźnieniem po usunięciu wpływu wszystkich krótszych opóźnień. Dla procesu AR(p) PACF ma istotne piki do opóźnienia p, a potem spada w okolice zera:
plot_pacf(train, lags=20, method="ywm")
plt.show()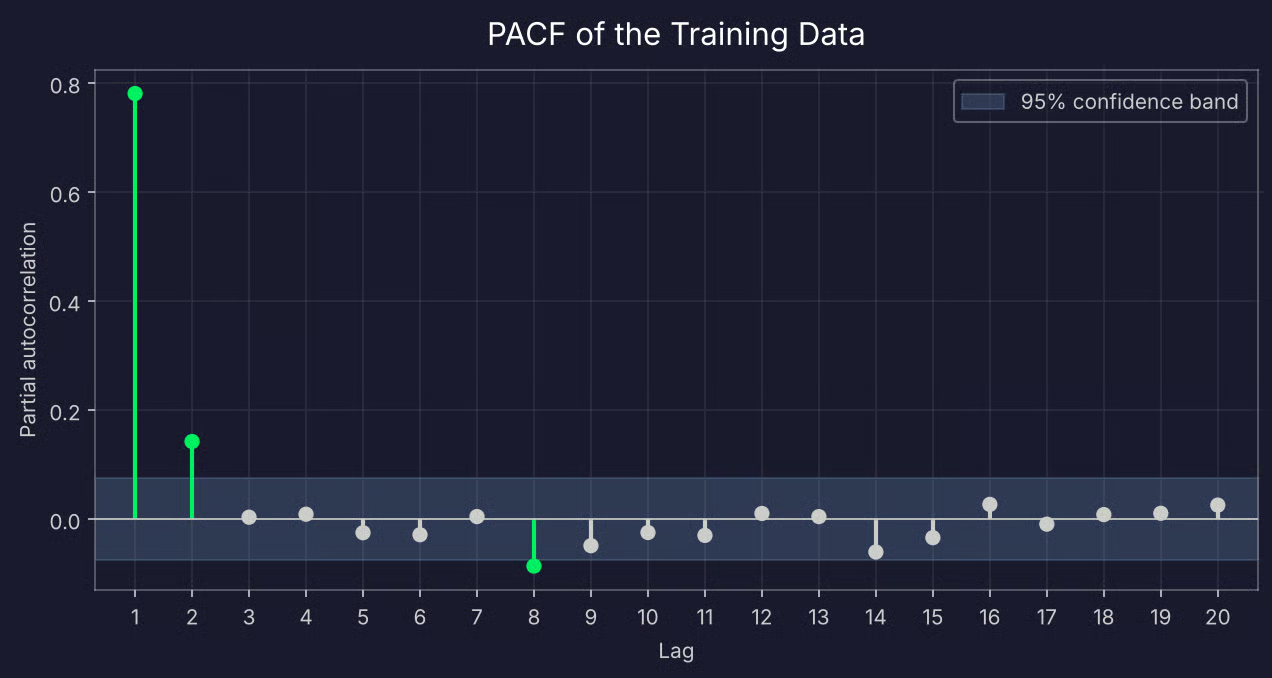
PACF danych treningowych
Opóźnienia 1 i 2 są daleko poza pasmem ufności, a opóźnienie 3 spada blisko zera. To wskazuje na AR(2).
Jest też mały pik przy opóźnieniu 8, tuż poza pasmem. Nie wyciągaj z tego daleko idących wniosków. Pasmo jest rysowane dla ufności 95%, więc przy 20 opóźnieniach możesz się spodziewać, że około jedno z nich przekroczy je przypadkiem.
Drugie narzędzie to kryteria informacyjne. AIC i BIC nagradzają model za dobre dopasowanie i karzą za każdy dodatkowy parametr. BIC nakłada większą karę, więc zwykle wybiera mniejsze modele. statsmodels może przetestować każdy rząd do maksimum i zwrócić najlepszy:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")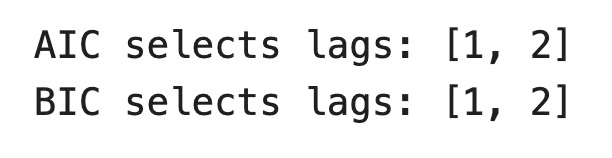
Wybór opóźnień wg AIC/BIC
Oba kryteria zgadzają się z PACF. W praktyce często zobaczysz, że AIC wybiera nieco większy model niż BIC. Jeśli tak się stanie, zacznij od mniejszego.
Gdy rząd jest wybrany, dopasowanie modelu to dwie linijki kodu:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")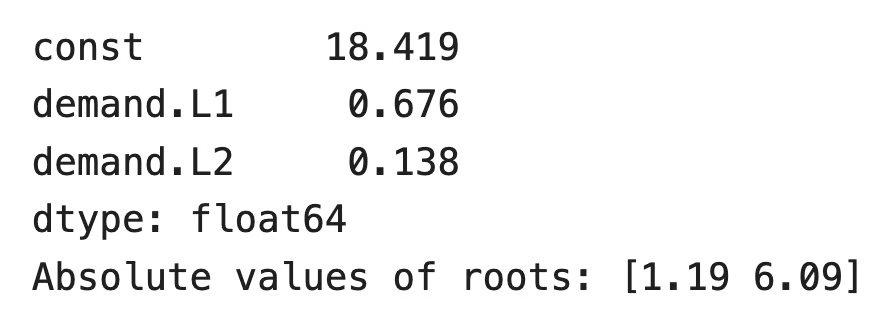
Parametry modelu AR(2)
Prawdziwe wartości to 0.6 i 0.25. Model daje nieco większą wagę pierwszemu opóźnieniu i mniejszą drugiemu, ale suma współczynników jest zbliżona — 0.81 wobec 0.85. Przy 670 punktach danych nie odzyskasz dokładnych wartości.
Oba pierwiastki mają moduł większy niż 1, więc dopasowany model jest stacjonarny. Możesz wywołać results.summary(), jeśli chcesz błędy standardowe, wartości p i pełną tabelę pierwiastków.
Są dwa sposoby prognozowania okresu testowego i odpowiadają na różne pytania:
Prognozy wielokrokowe pochodzą bezpośrednio z dopasowanych wyników. Dla jednokrokowych stosujesz wyuczone współczynniki do pełnego szeregu:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")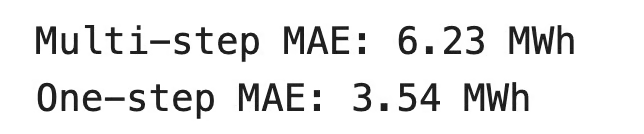
Wyniki prognoz
Średni błąd bezwzględny (MAE) to średnia bezwzględna różnica między prognozami a wartościami rzeczywistymi. Ma tę samą jednostkę co dane, więc czytasz go wprost. Prognoza jednokrokowa myli się średnio o 3.54 MWh.
Tak obie prognozy wypadają względem wartości rzeczywistych:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()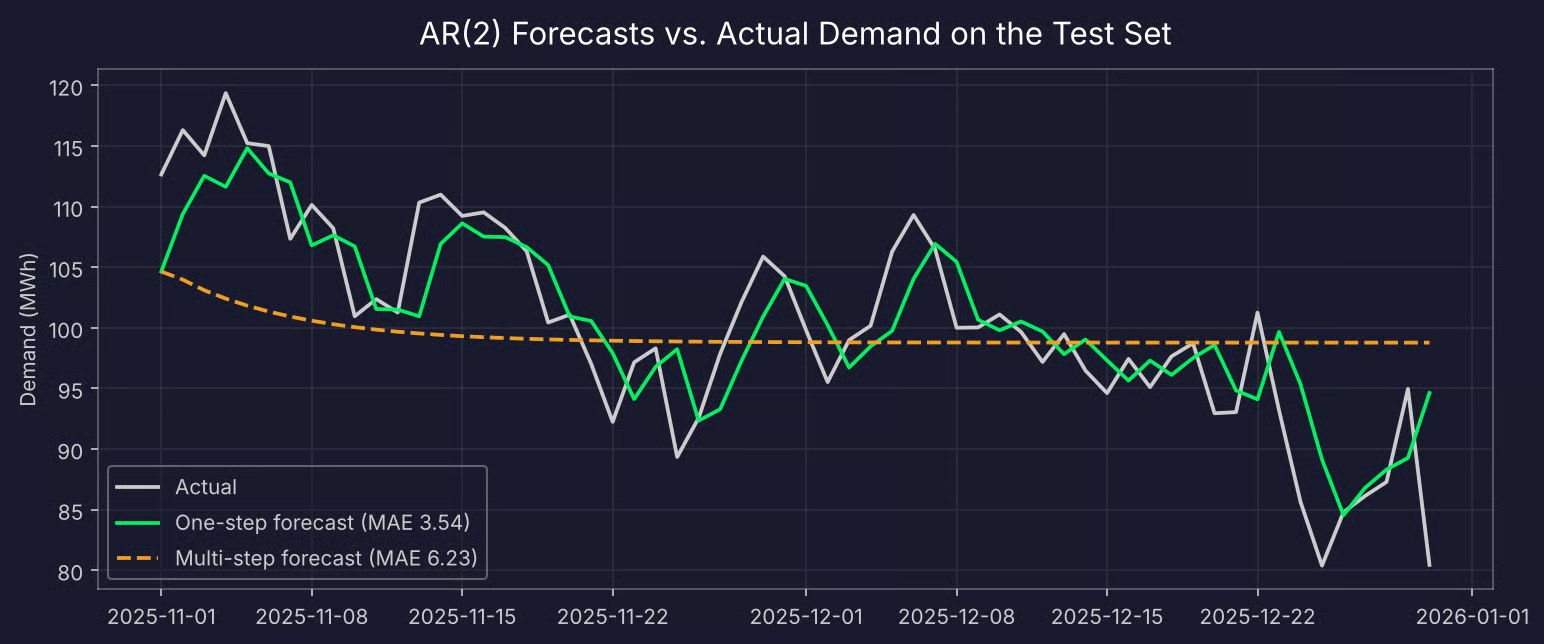
Prognozy AR(2) jednokrokowa i wielokrokowa względem rzeczywistego zapotrzebowania
Prognoza jednokrokowa blisko śledzi wartości rzeczywiste, z około jednodniowym opóźnieniem. Prognoza wielokrokowa startuje od ostatniej znanej wartości, a następnie spłaszcza się w pobliżu średniej w ciągu około trzech tygodni.
Tak zachowuje się każdy stacjonarny model AR — im dalej prognozujesz, tym mniej mówi przeszłość, a najlepszą zgadywanką staje się długookresowa średnia. Dlatego modele AR najlepiej sprawdzają się w krótkoterminowych prognozach.
Łatwo założyć, że więcej historii daje lepsze prognozy. Sprawdźmy to, dopasowując modele z rosnącą liczbą opóźnień i porównując ich jednokrokowy MAE:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")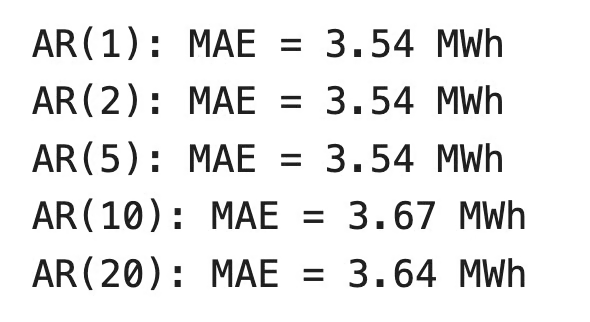
MAE przy większej liczbie opóźnień
Błąd nie poprawia się powyżej AR(2), a przy AR(10) i AR(20) rośnie. Te dodatkowe współczynniki dopasowują szum w danych treningowych.
Zauważysz też, że AR(1) radzi sobie tu równie dobrze jak AR(2). Oszacowany drugi współczynnik jest mały, więc niewiele wnosi w tym zbiorze testowym. Gdy dwa modele działają równie dobrze, prostszy jest łatwiejszy do wyjaśnienia i mniej podatny na awarie na nowych danych.
Jest też koszt. AR(20) estymuje 21 parametrów zamiast 3.
Podsumowując, pozwól, by PACF i kryteria informacyjne zasugerowały rząd, a potem tylko potwierdź go na zbiorze testowym.
Modele AR dobrze pasują do wielu problemów prognostycznych, ale nie do wszystkich. Oto gdzie działają, gdzie nie, i jak wypadają na tle modeli na nich opartych.
Modele AR mają dwie główne zalety:
Mają też dwa główne ograniczenia:
Jest jeszcze jeden problem. Wartości opóźnione są ze sobą skorelowane, bo pochodzą z tego samego szeregu. W danych popytu korelacja między y_t-1 a y_t-2 wynosi 0.78.
To nazywa się współliniowością wielokrotną, i dotyczy każdego modelu regresji. Gdy dwa predyktory poruszają się razem, modelowi trudno ustalić, który odpowiada za efekt. Współczynniki stają się mniej stabilne, a ich błędy standardowe rosną.
To wyjaśnia to, co widziałeś wcześniej. Model oszacował 0.676 i 0.138 zamiast 0.6 i 0.25 — przeniósł wagę z jednego opóźnienia na drugie, ale suma pozostała zbliżona. Prognozy na tym niewiele cierpią, ale poszczególnym współczynnikom nie można tak ufać. Każde dodatkowe opóźnienie pogarsza problem.
AR to jeden z trzech klocków klasycznego prognozowania szeregów czasowych. Pozostałe to modele średniej ruchomej (MA) oraz ARIMA, która je łączy.
Model AR przewiduje na podstawie przeszłych wartości. Model MA przewiduje na podstawie przeszłych błędów:
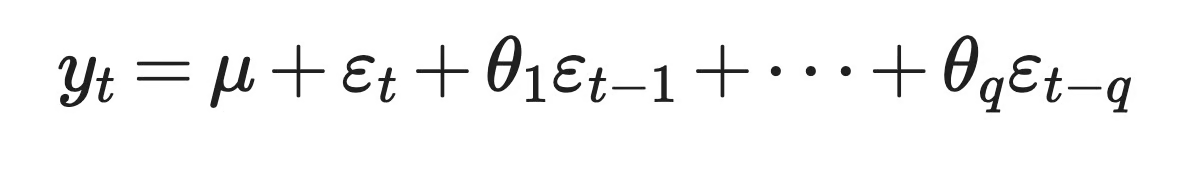
Model ARMA
Tutaj mu to średnia szeregu, theta_1 do theta_q to współczynniki, a epsilon_t-1 do epsilon_t-q to losowe wstrząsy z poprzednich kroków. Nie myl tego ze średnią ruchomą w sensie kroczącej średniej. Nazwa jest ta sama, ale model inny.
Modele reagują na wstrząsy inaczej. W modelu MA(q) wstrząs wpływa na szereg dokładnie przez q kroków. W modelu AR wstrząs wygasa w czasie, ale nigdy całkiem do zera. Ta różnica jest też powodem, dla którego używasz innych narzędzi do wyboru rzędu — PACF „odcina się” po opóźnieniu p dla modeli AR, a ACF po opóźnieniu q dla modeli MA.
ARIMA łączy to wszystko. ARIMA(p, d, q) ma trzy części:
To oznacza, że AR jest szczególnym przypadkiem ARIMA. Jeśli ustawisz d i q na zero, dostaniesz model AR. Możesz to sprawdzić na danych o popycie:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))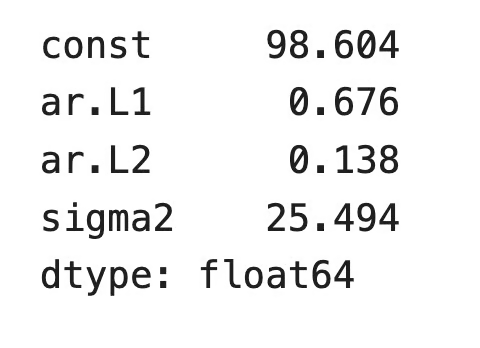
Model ARIMA z rzędem różnicowania i MA równym 0
Współczynniki AR zgadzają się z tymi z AutoReg. Stała się różni, bo ARIMA raportuje średnią szeregu, podczas gdy AutoReg raportuje wyraz wolny c.
Zobaczmy teraz, gdzie ARIMA idzie dalej. Załóżmy, że miasto się rozrasta i zapotrzebowanie na energię rośnie nieco każdego dnia. Szereg ma teraz trend, więc test ADF nie przechodzi i model AR nie może bezpośrednio pracować z szeregiem.
Ale model ARIMA(2, 1, 0) już tak. Różnicuje on szereg raz, więc model pracuje na dziennych zmianach popytu zamiast surowych wartości, a następnie dopasowuje AR(2) do tych zmian. Jeśli wstrząs, jak fala upałów, wpływa też na popyt następnego dnia, możesz dodać składnik MA i otrzymać ARIMA(2, 1, 1).
Część AR robi w każdym przypadku to samo. ARIMA po prostu przygotowuje dla niej dane i modeluje to, co zostaje. Jeśli chcesz wejść głębiej, kurs ARIMA Models in R omawia pełen proces.
Model autoregresyjny przewiduje kolejną wartość szeregu na podstawie jego przeszłości. To regresja liniowa, w której predyktory to opóźnione kopie celu, co czyni ją jednym z najłatwiejszych do zrozumienia modeli szeregów czasowych.
Zobaczysz go w ekonomii, kodowaniu mowy, analizie EEG, a nawet w nazwie dzisiejszych modeli językowych. Widziałeś też, gdzie nie jest najlepszym wyborem — potrzebuje danych stacjonarnych, zależy od właściwego rzędu opóźnień, a skorelowane opóźnienia czynią poszczególne współczynniki mniej wiarygodnymi.
Jeśli rozumiesz modele AR, reszta klasycznego prognozowania staje się dużo prostsza. Naturalnym kolejnym krokiem jest ARIMA, a nasz tutorial ARIMA pokazuje, jak różnicowanie i składniki MA rozwijają to, czego się tu nauczyłeś. Jeśli wolisz podejście praktyczne, spróbuj kursu ARIMA Models in Python.
Ucz się z DataCamp
Kurs
Kurs
Kurs