Cursus
Tijdreeksanalyse in Python
4 uur
70.9K
De meeste online content gaat direct naar ARIMA en geeft het AR-gedeelte hooguit één regeltje uitleg. Maar AR is de basis van het model. Als je dat niet begrijpt, slaat de rest van ARIMA ook nergens op.
In gewone taal: een autoregressief model voorspelt toekomstige waarden van een tijdreeks op basis van de eigen, eerdere waarden. Je komt het tegen in economie, financiën, signaalverwerking en klimaatgegevens. Het is in feite een regressiemodel, dus het sluit aan bij wat je al weet over regressie en verbindt dat met voorspellen met tijdreeksen. Het is ook de basis waarop ARIMA is gebouwd.
In dit artikel laat ik je zien hoe een autoregressief model werkt, hoe je er in Python met statsmodels één fit, en hoe je de juiste lag-orde kiest.
Een autoregressief model voorspelt de volgende waarde van een tijdreeks uit een gewogen som van de vorige waarden.
In de naam betekent "auto" zelf, en "regressie" betekent dat je één variabele voorspelt uit andere. Dus een autoregressief model is een regressie van een reeks op z’n eigen verleden.
Stel, je wilt de elektriciteitsvraag van morgen voorspellen. De vraag van vandaag is een goed uitgangspunt, en die van gisteren voegt wat extra informatie toe. Een autoregressief model zet die intuïtie om in een formule en leert de gewichten uit je data.
AR-modellen worden geschreven als AR(p), waarbij p de orde van het model is. De orde geeft aan hoeveel eerdere waarden het model gebruikt:
p waardenEen hogere orde is niet automatisch een beter model. Later in het artikel laat ik zien hoe je p kiest.
Dit is de algemene vorm van een AR(p)-model:
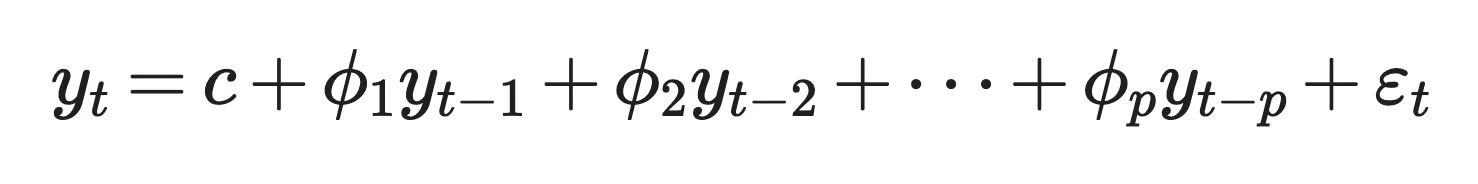
Het algemene AR(p)-model
Dit doet elke term:
y_t: De waarde van de reeks op tijdstip t, de waarde die je wilt voorspellen
c: Een constante die, samen met de coëfficiënten, het langetermijngemiddelde van de reeks bepaalt
phi_1 tot phi_p: De coëfficiënten, die aangeven hoeveel elke eerdere waarde bijdraagt aan de voorspelling
y_t-1 tot y_t-p: De vertraagde waarden, waarbij "lag" betekent hoeveel stappen je terugkijkt
epsilon_t: Witte ruis, een willekeurige fout met gemiddelde nul, constante variantie en geen correlatie in de tijd
Simpel gezegd: het model vermenigvuldigt elk van de laatste p waarden met z’n eigen gewicht en telt de constante erbij op. Wat overblijft is ruis, het deel van y_t dat het verleden niet kan verklaren.
AR(1) is de eenvoudigste versie:
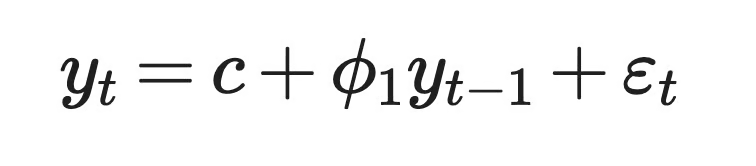
AR(1)-model
De waarde van phi_1 bepaalt hoeveel vandaag doorwerkt naar morgen.
Stel c = 2 en phi_1 = 0.8. Als de waarde van vandaag 15 is, voorspelt het model 2 + 0,8 x 15 = 14 voor morgen. De volgende voorspelling is 2 + 0,8 x 14 = 13,2. Elke stap brengt de reeks dichter bij 10, het langetermijngemiddelde c / (1 - phi_1).
Als phi_1 negatief is, springt de reeks van de ene stap op de andere boven en onder het gemiddelde.
AR(2) voegt een tweede lag toe:
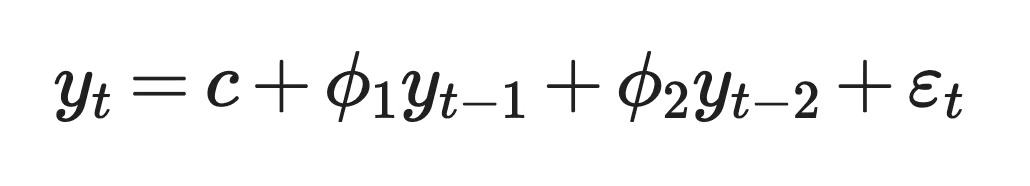
AR(2)-model
Met twee lags kan het model patronen beschrijven die AR(1) niet kan, zoals cycli. Bijvoorbeeld, een positieve phi_1 met een negatieve phi_2 kan een golfbeweging opleveren die lijkt op een conjunctuurcyclus.
Elke AR komt dus neer op twee keuzes: hoeveel lags je gebruikt en welke gewichten je eraan geeft.
Een AR-model werkt alleen als twee dingen kloppen voor je data. Eerdere waarden moeten gerelateerd zijn aan toekomstige waarden, en de reeks moet zich in de tijd hetzelfde gedragen. Het eerste heet autocorrelatie, het tweede stationariteit.
Autocorrelatie is de correlatie tussen een tijdreeks en een vertraagde kopie van zichzelf.
Het is de reden dat AR-modellen überhaupt bestaan. Als de waarde van vandaag je niets vertelt over morgen, valt er voor het model niets te leren uit het verleden.
In code neem je een kolom met waarden, je kopieert die, en schuift de kopie één rij naar beneden. Nu koppel je per rij een waarde aan de vorige waarde. De correlatie tussen de twee kolommen is de lag-1-autocorrelatie. Als je twee rijen schuift, krijg je de lag-2-autocorrelatie.
Zo ziet dat eruit in pandas:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))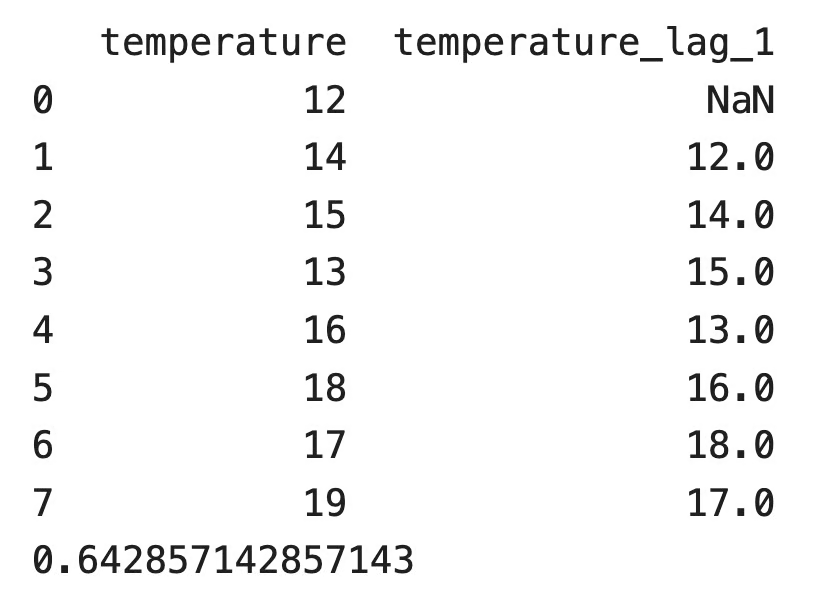
DataFrame met de temperature-kolom en de lag-1-kopie
De eerste rij van de vertraagde kolom is leeg omdat er geen meting is vóór de eerste. pandas slaat die rij over en geeft een lag-1-autocorrelatie van 0,643 terug. In deze reeks volgen warme dagen vaak op warme dagen.
Het teken van de autocorrelatie bepaalt hoe de reeks zich gedraagt:
Een autocorrelatie dicht bij nul betekent dat het verleden niet helpt. In dat geval doet een AR-model het niet veel beter dan het gemiddelde voorspellen.
AR-modellen hebben een stationaire tijdreeks nodig.
Een stationaire reeks heeft hetzelfde gemiddelde, dezelfde variantie en dezelfde autocorrelatie bij een gegeven lag, ongeacht welk deel van de reeks je bekijkt. Statistici noemen dit zwaksense stationariteit.
Dat is belangrijk omdat het model één vaste set coëfficiënten schat. Als het gemiddelde van de reeks in de tijd wegdrijft, beschrijven coëfficiënten uit oudere data de nieuwere data niet. Aandelenkoersen zijn een klassiek voorbeeld van een niet-stationaire reeks vanwege de trend door de jaren heen. Dagelijkse rendementen zijn veel dichter bij stationair.
De coëfficiënten zelf bepalen of een AR-proces stationair is. Voor AR(1) is de regel simpel: phi_1 moet tussen -1 en 1 liggen.
abs(phi_1) < 1: Schokken doven uit in de tijd en de reeks keert terug naar het gemiddelde
phi_1 = 1: De reeks wordt een random walk, en schokken doven nooit uit
abs(phi_1) > 1: Elke schok wordt groter en de reeks explodeert
AR(2) vereist drie voorwaarden tegelijk: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1, en abs(phi_2) < 1.
Na twee lags heb je een algemene regel nodig. Elk AR(p)-model heeft een karakteristieke veelterm:
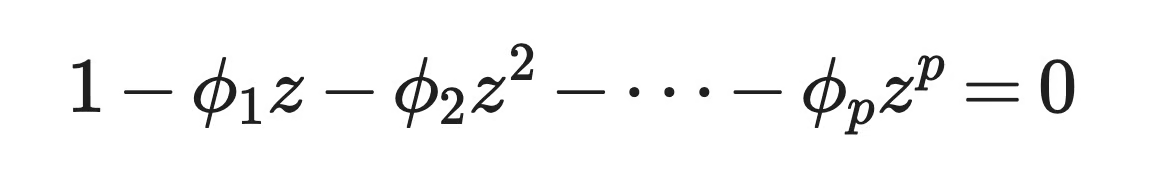
Karakteristieke veelterm
Het proces is zwaksense stationair wanneer alle wortels van deze veelterm buiten de eenheidscirkel liggen, wat betekent dat elke wortel z een absolute waarde groter dan 1 heeft. De wortels kunnen complexe getallen zijn, daarom is de grens een cirkel in het complexe vlak en geen lijn.
Je kunt dit checken met AR(1). De veelterm is 1 - phi_1 z = 0, dus de wortel is z = 1 / phi_1. Die wortel ligt alleen buiten de eenheidscirkel als abs(phi_1) < 1, dezelfde regel als hiervoor.
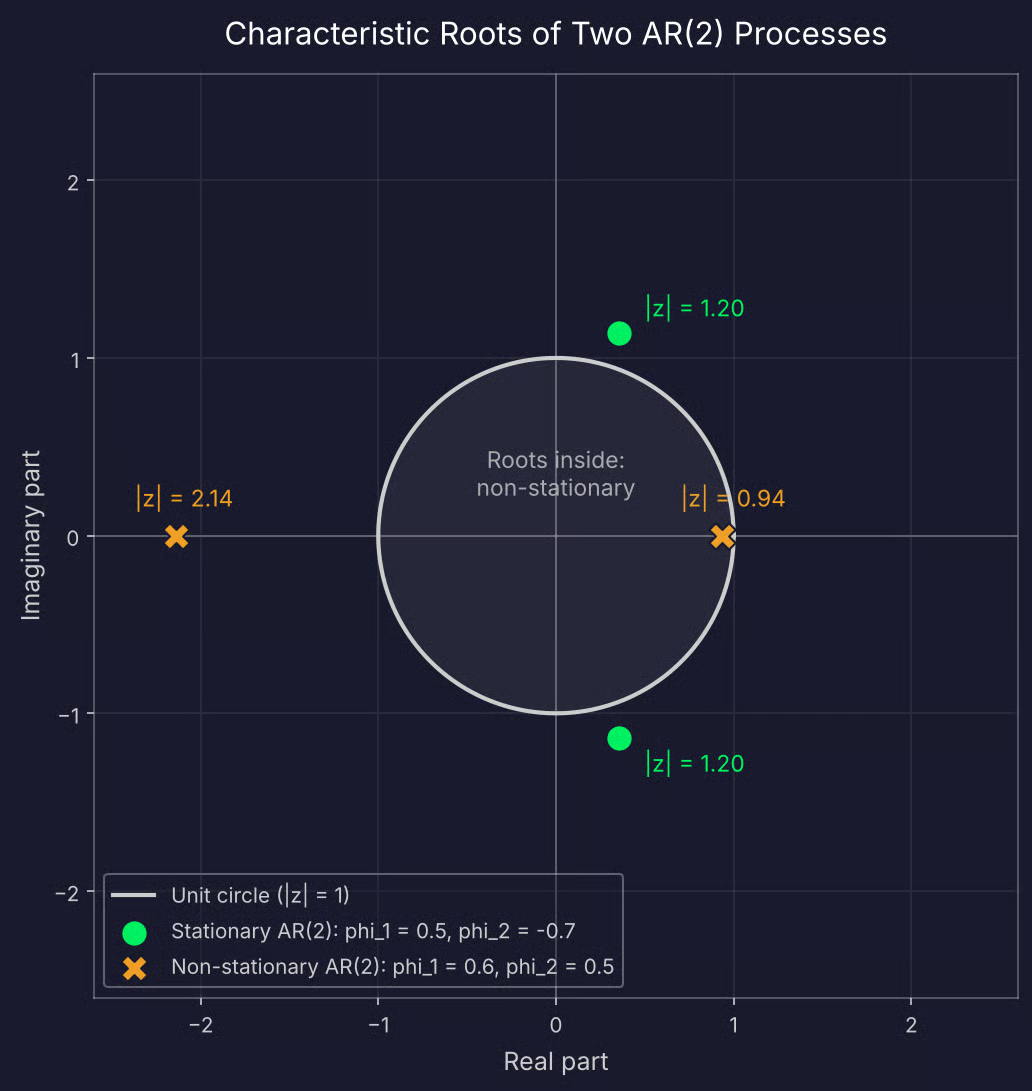
Wortels van een stationair en een niet-stationair AR(2)-proces
Je gaat deze wortels niet met de hand uitrekenen. statsmodels geeft ze terug nadat je een model hebt gefit, en ik laat in de Python-sectie zien hoe je de data zelf op stationariteit test.
Als je reeks niet stationair is, kun je differentiëren — trek elke waarde af van de volgende — en de verschillen modelleren. Daar staat de "I" in ARIMA-modellen voor.
Elk AR-model heeft dezelfde vergelijking. Wat verandert tussen de typen is de orde p: hoeveel eerdere waarden het model gebruikt.
AR(1) gebruikt alleen de vorige waarde om de volgende te voorspellen.
Klinkt dat als lineaire regressie? Dat is het ook. Als je y_t-1 op de x-as en y_t op de y-as zet, past AR(1) een rechte lijn door de punten. De constante c is het intercept en phi_1 de helling. Als je eenvoudige lineaire regressie kent, weet je al hoe AR(1) wordt geschat.
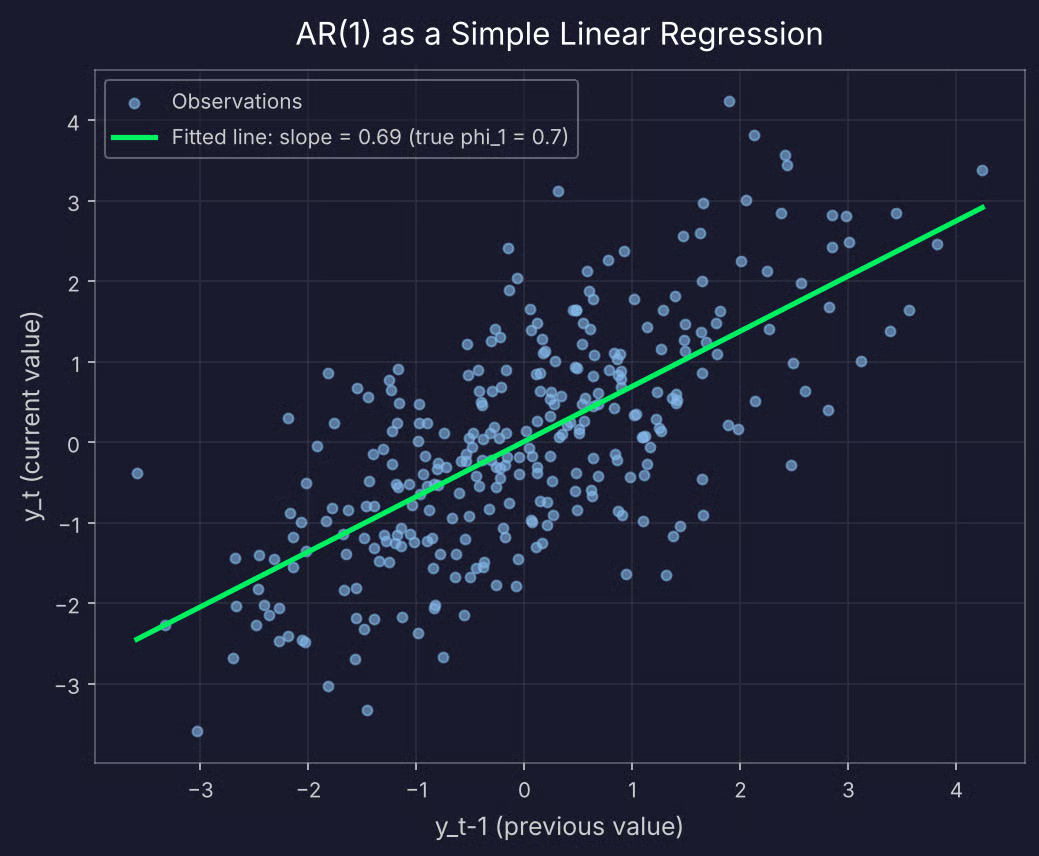
Spreidingsdiagram van y_t tegen y_t-1 voor AR(1)
Er is één verschil. In een standaardregressie zijn voorspeller en target aparte variabelen. In AR(1) is de voorspeller dezelfde reeks, verschoven met één stap. Daarom kun je de rijen niet husselen of een willekeurige train/test-split gebruiken — de volgorde van de data is onderdeel van het model.
De waarde van phi_1 verandert hoe de reeks eruitziet:
phi_1 = 0.3: De reeks lijkt bijna op willekeurige ruis, want elke waarde draagt weinig informatie over naar de volgende
phi_1 = 0.9: De reeks beweegt in lange, vloeiende slingers en doet er langer over om terug te keren naar het gemiddelde
phi_1 = -0.8: De reeks zigzagt vrijwel elke stap boven en onder het gemiddelde
phi_1 = 1: De reeks wordt een random walk en drijft zonder terugkeergemiddelde — de niet-stationaire case uit de vorige sectie
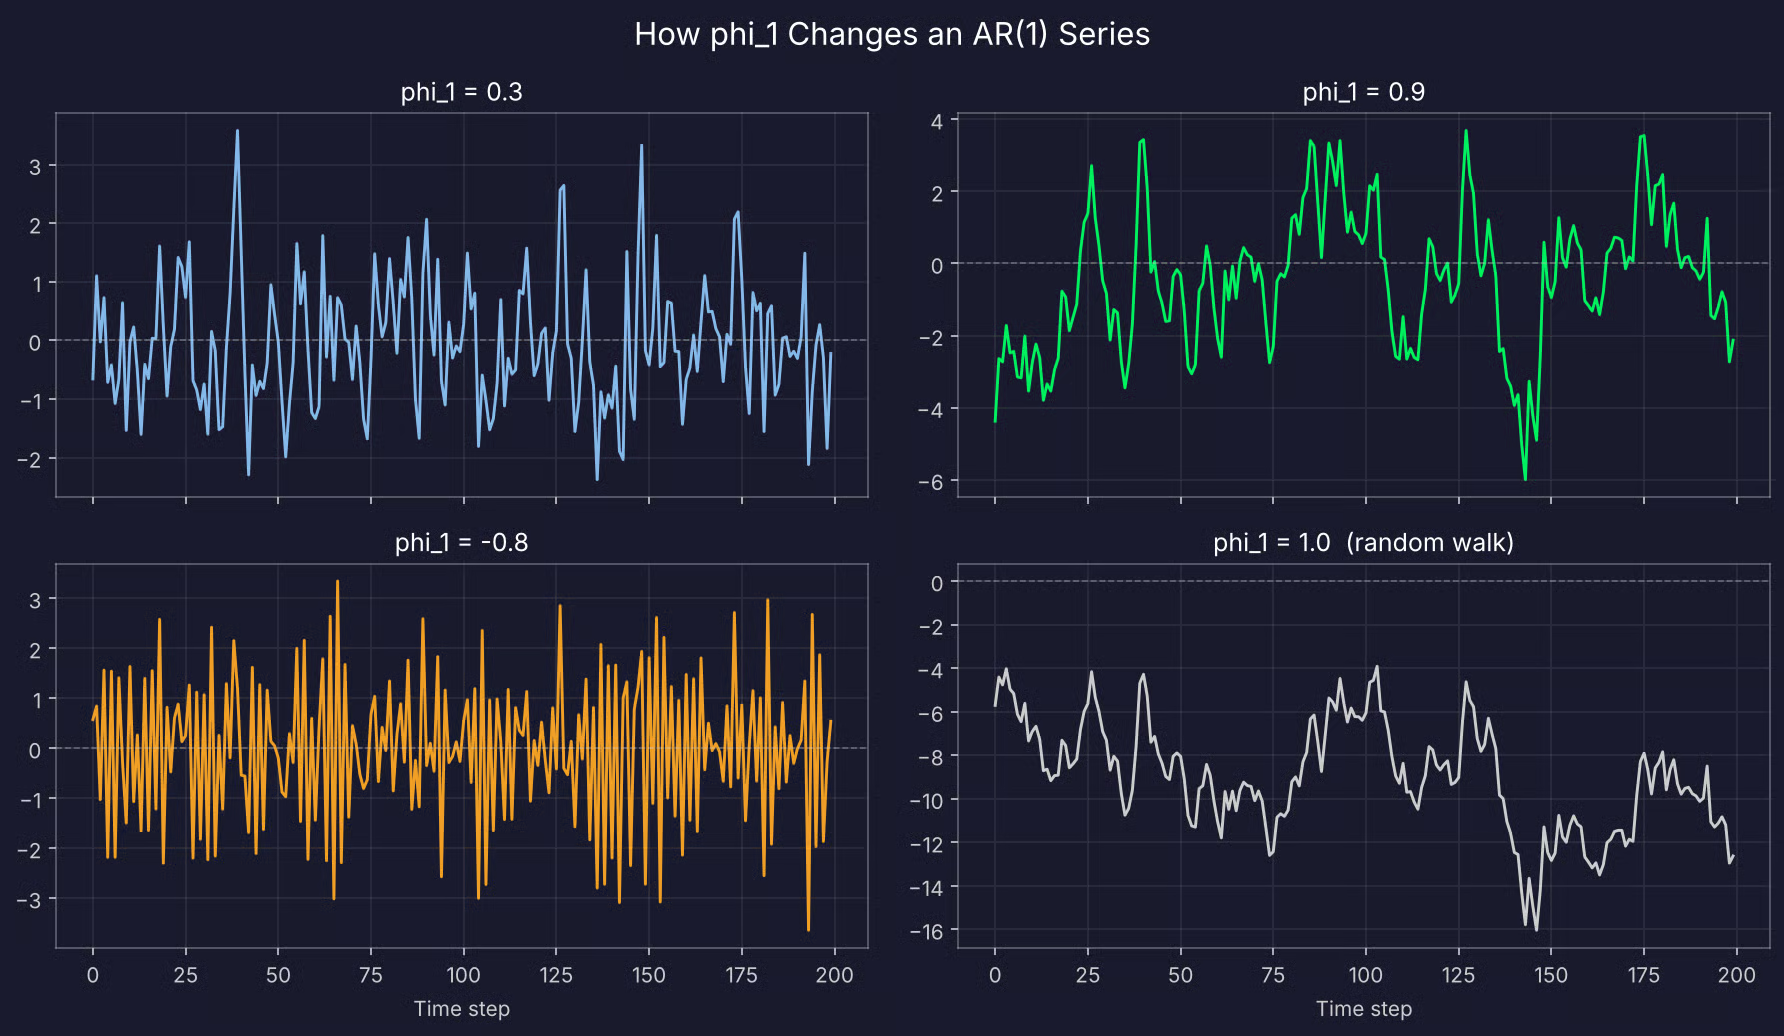
Vier gesimuleerde AR(1)-reeksen
Hoe dichter phi_1 bij 1 of -1 komt, hoe langer één schok doorwerkt in de reeks.
AR(2) gebruikt de vorige twee waarden. De tweede lag maakt patronen mogelijk die AR(1) niet kan, vooral cycli.
Zo vergelijken twee sets coëfficiënten:
phi_1 = 0.5, phi_2 = 0.3: Beide lags duwen dezelfde kant op, dus de reeks lijkt op AR(1) met langere, gladdere slingers
phi_1 = 0.5, phi_2 = -0.7: De tweede lag werkt tegen de eerste in, en de reeks stijgt en daalt in golven die grofweg elke vijf stappen herhalen
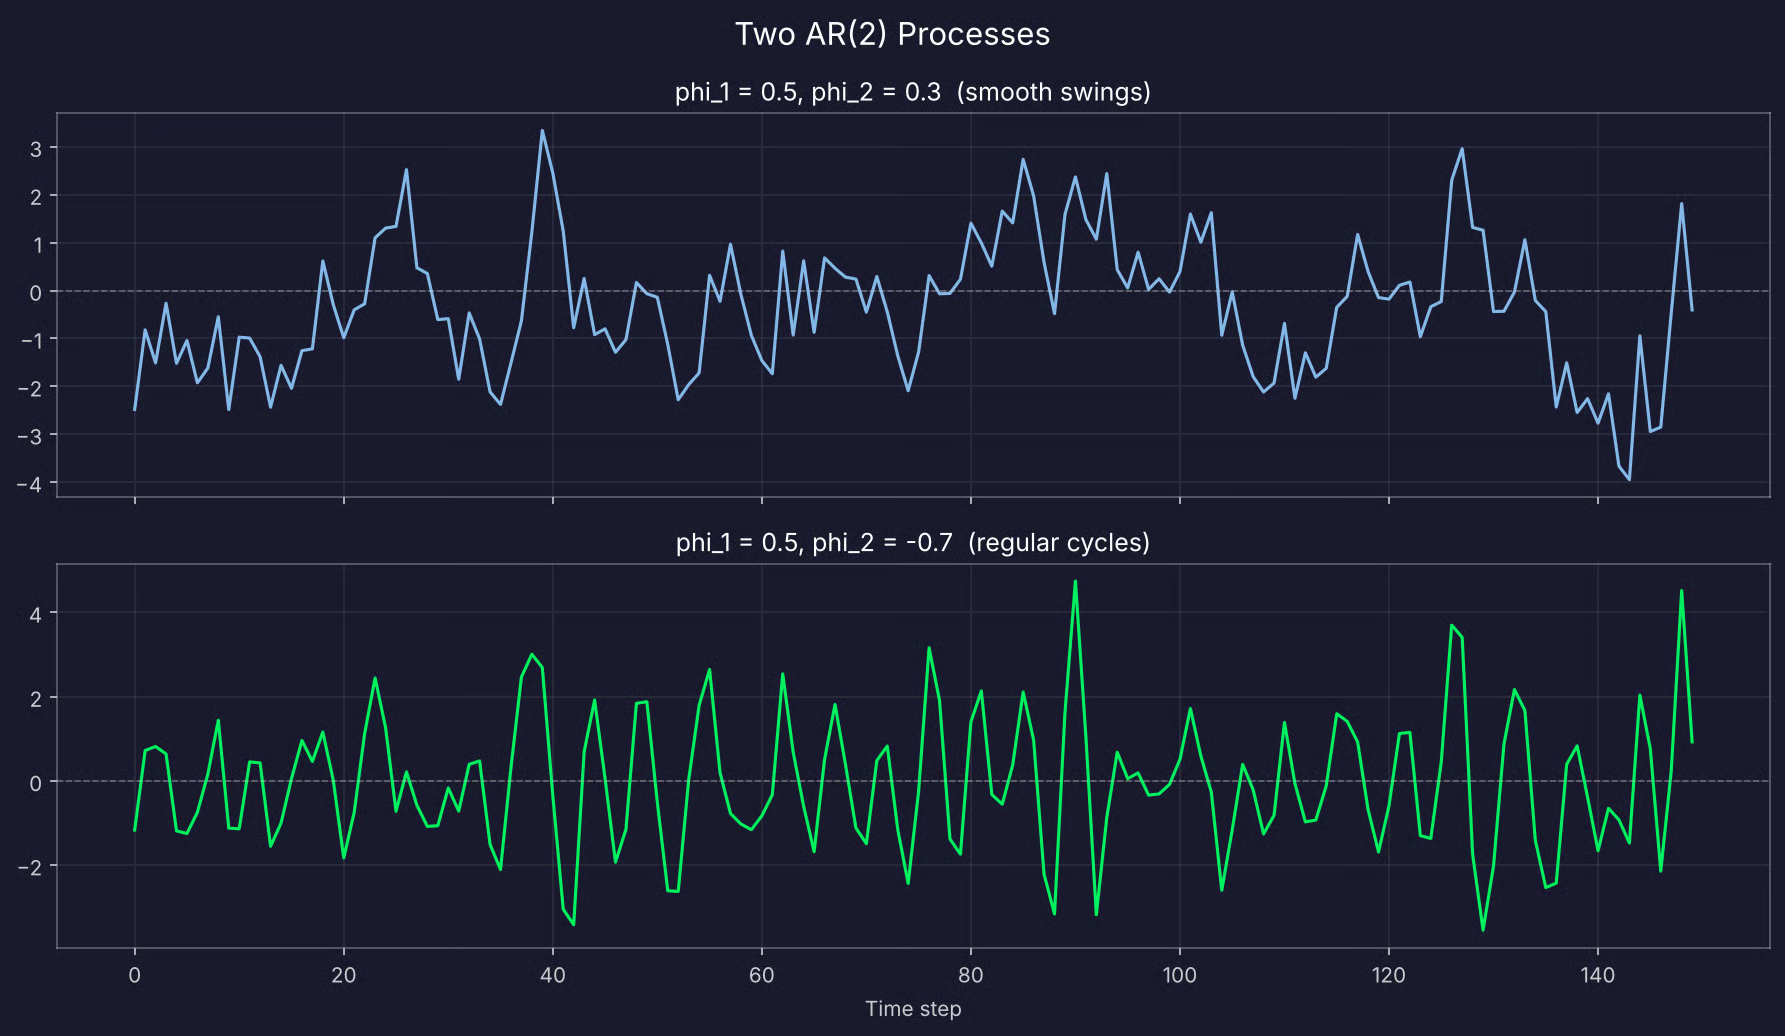
Twee gesimuleerde AR(2)-reeksen
AR(3), AR(4) en verder voegen telkens één lag toe. Je hebt ze nodig als verder terugliggende waarden informatie bevatten die de recentere niet hebben.
Stel, je modelleert maandelijkse verkoop en dezelfde maand vorig jaar voorspelt deze maand goed. Een AR(12)-model bevat die lag van 12 maanden, plus de 11 lags ertussen.
Elke extra lag voegt een te schatten coëfficiënt toe. Je hebt dus meer data nodig en het risico op overfitting neemt toe. De coëfficiënten worden ook lastiger te lezen — met er 12 kun je niet meer aan de hand van de getallen zien wat de reeks gaat doen. Je kijkt dan naar de wortels.
Ik laat in de Python-sectie zien hoe je de juiste orde kiest met PACF en AIC.
AR-modellen kom je tegen zodra data geordend zijn en het recente verleden iets zegt over de nabije toekomst.
De meeste toepassingen vallen in vier groepen:
De laatste verrast veel mensen, omdat de term achter de chatbots van vandaag uit dezelfde statistiek komt waar je hier over leest.
In deze sectie fit ik een autoregressief model in Python met statsmodels, van ruwe data tot een voorspelling die je kunt evalueren.
Je hebt pandas en NumPy nodig voor de data, statsmodels voor het model en tests, en scikit-learn voor de foutmaat:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorIk simuleer twee jaar dagelijkse elektriciteitsvraag met een AR(2)-proces.
Ik kies voor gesimuleerde data omdat je de echte coëfficiënten dan van tevoren kent. Zo kun je controleren of het model ze terugvindt en of de selectietools voor lags naar de juiste orde wijzen.
Het proces heeft c = 15, phi_1 = 0.6 en phi_2 = 0.25, wat het langetermijngemiddelde op 100 MWh zet:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()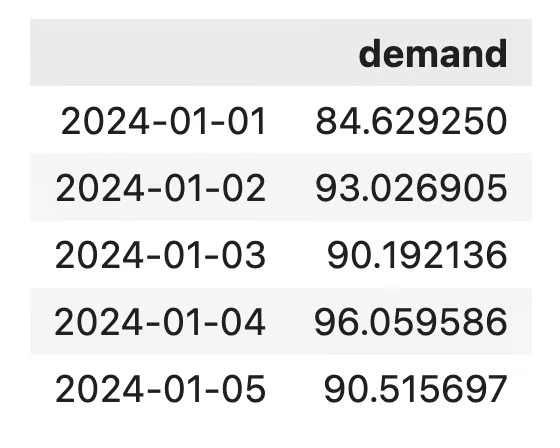
De dataset met dagelijkse elektriciteitsvraag
De eerste 100 gesimuleerde dagen zijn verwijderd omdat die burn-in periode de reeks tijd geeft om in z’n normale gedrag te komen voordat je hem gebruikt.
Zo ziet de volledige reeks eruit:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()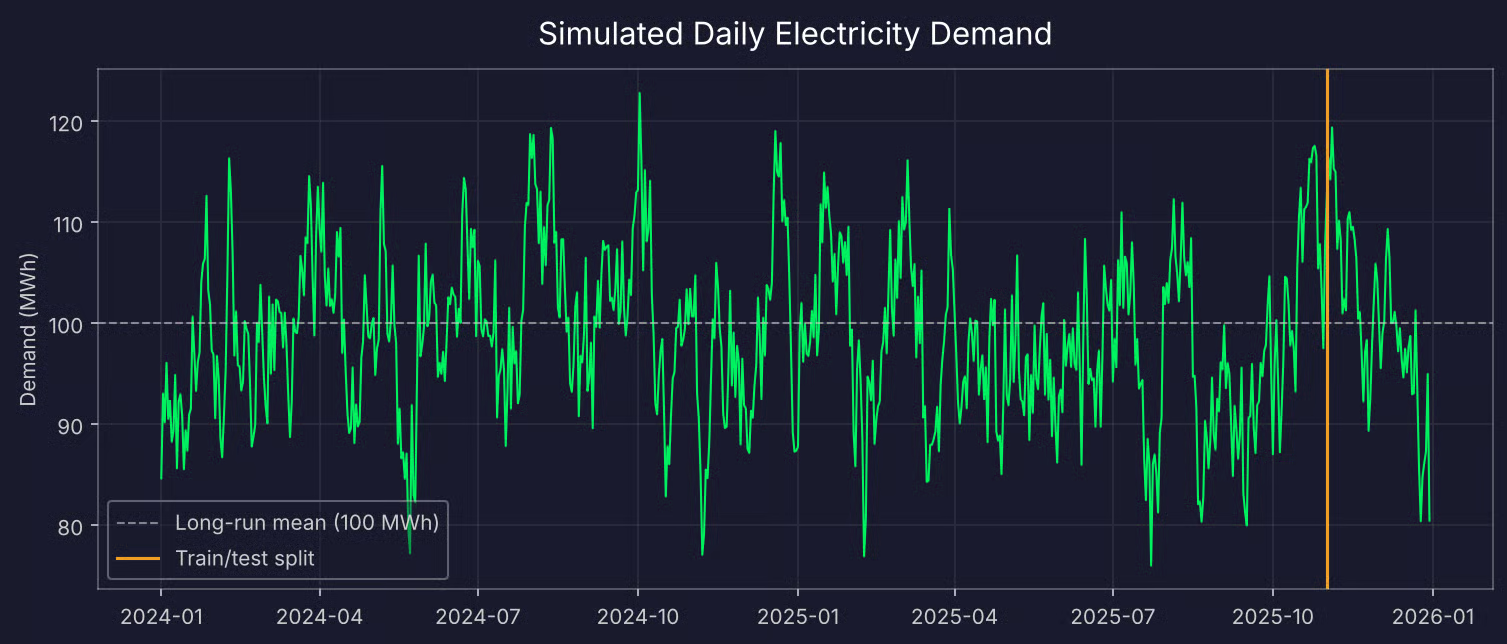
Twee jaar gesimuleerde dagelijkse elektriciteitsvraag
De reeks beweegt op en neer rond 100 zonder trend, wat is hoe een stationaire reeks eruit hoort te zien. Maar een visuele check is geen bewijs.
De augmented Dickey-Fuller (ADF)-test checkt of een reeks stationair is. De nulhypothese is dat de reeks niet stationair is, dus een kleine p-waarde is wat je wilt:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")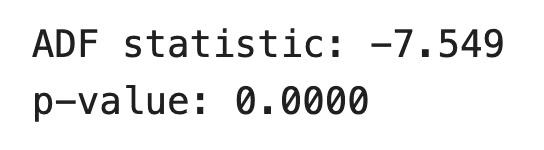
ADF-testresultaten
De p-waarde ligt ruim onder 0,05, dus je kunt de nulhypothese verwerpen en de reeks als stationair beschouwen.
Als je eigen data voor deze test zakt, differentieer dan met df["demand"].diff().dropna() en voer de test opnieuw uit.
Tijdreeksdata kun je niet husselen, dus de testset moet van het eind van de reeks komen. Ik houd de laatste 60 dagen voor testen apart:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Dat laat 670 dagen over voor training en 60 voor testen.
Dit is de stap die bepaalt hoe goed het model werkt. Kies je te weinig lags, dan mist het model patronen in de data. Maar kies je er te veel, dan past het ruis in de trainingsdata die zich in de toekomst niet herhaalt.
Je hebt hiervoor twee tools.
De eerste is de partiële autocorrelatiefunctie (PACF). Die laat de correlatie zien tussen de reeks en elke lag, na het effect van alle kortere lags te verwijderen. Voor een AR(p)-proces heeft de PACF significante pieken tot en met lag p en zakt daarna rond nul:
plot_pacf(train, lags=20, method="ywm")
plt.show()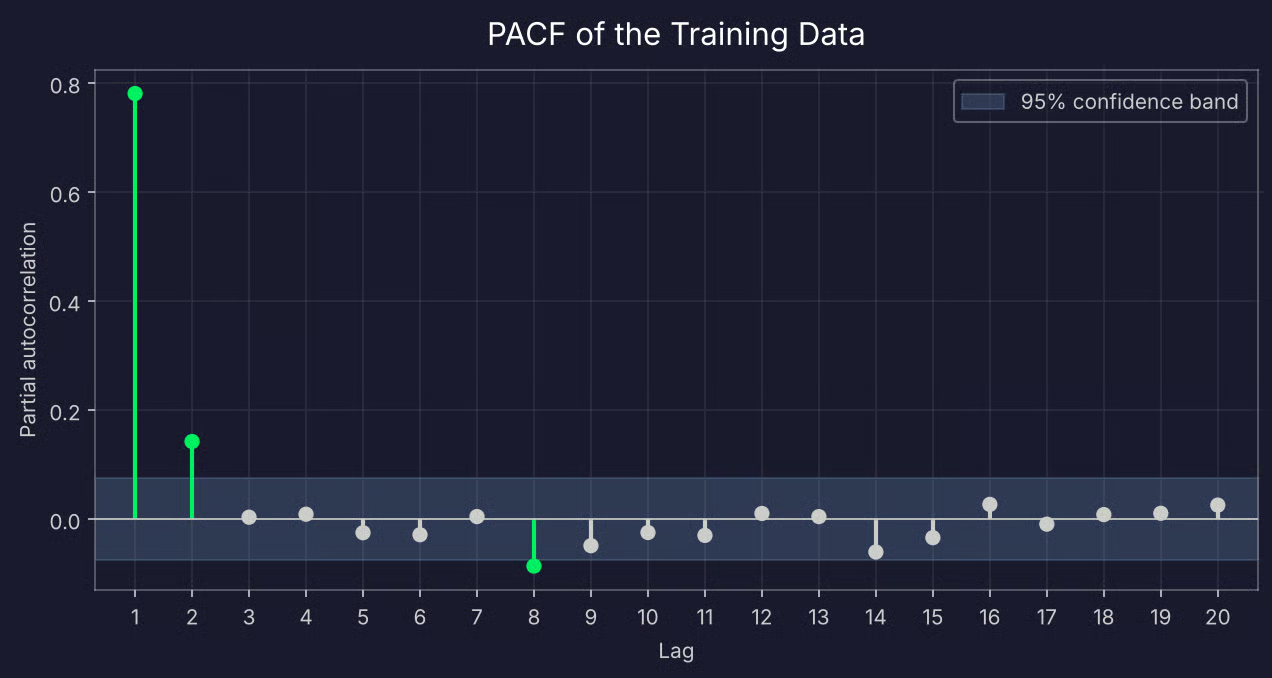
PACF van de trainingsdata
Lags 1 en 2 liggen ver buiten de betrouwbaarheidsband, en lag 3 zakt dicht bij nul. Dat wijst op AR(2).
Er is ook een kleine piek bij lag 8, net buiten de band. Lees daar niet te veel in. De band is op 95% betrouwbaar getekend, dus met 20 lags verwacht je dat er ongeveer één toevallig overheen gaat.
De tweede tool zijn informatiecriteria. AIC en BIC belonen een model voor goede fit en straffen elk extra parameter af. BIC past de grotere straf toe en kiest dus vaker kleinere modellen. statsmodels kan elke orde tot een maximum testen en de beste teruggeven:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")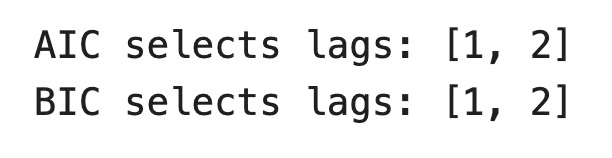
AIC/BIC-lagselectie
Beide criteria zijn het eens met de PACF. In de praktijk zie je vaak dat AIC een iets groter model kiest dan BIC. Als dat gebeurt, begin dan met het kleinere.
Met de orde gekozen, kost het fitten van het model twee regels code:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")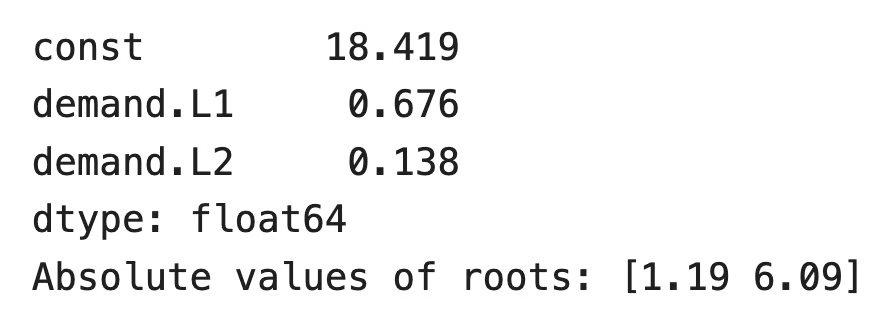
AR(2)-modelparameters
De echte waarden zijn 0,6 en 0,25. Het model geeft iets meer gewicht aan de eerste lag en minder aan de tweede, maar de som van de twee coëfficiënten ligt dicht bij elkaar — 0,81 versus 0,85. Met 670 datapunten haal je niet exact de echte waarden terug.
Beide wortels hebben een modulus groter dan 1, dus het gefitte model is stationair. Je kunt results.summary() aanroepen als je standaardfouten, p-waarden en de volledige worteltabel wilt.
Er zijn twee manieren om de testperiode te voorspellen, en ze beantwoorden verschillende vragen:
Multi-step-voorspellingen komen rechtstreeks uit de gefitte resultaten. Voor one-step-voorspellingen pas je de getrainde coëfficiënten toe op de volledige reeks:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")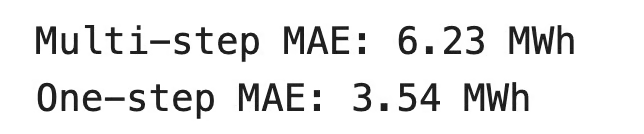
Voorspelresultaten
Mean absolute error (MAE) is het gemiddelde van de absolute verschillen tussen de voorspellingen en de werkelijke waarden. Het is in dezelfde eenheid als de data, dus je kunt het direct lezen. De one-step-voorspelling zit er gemiddeld 3,54 MWh naast.
Zo verhouden beide voorspellingen zich tot de werkelijke waarden:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()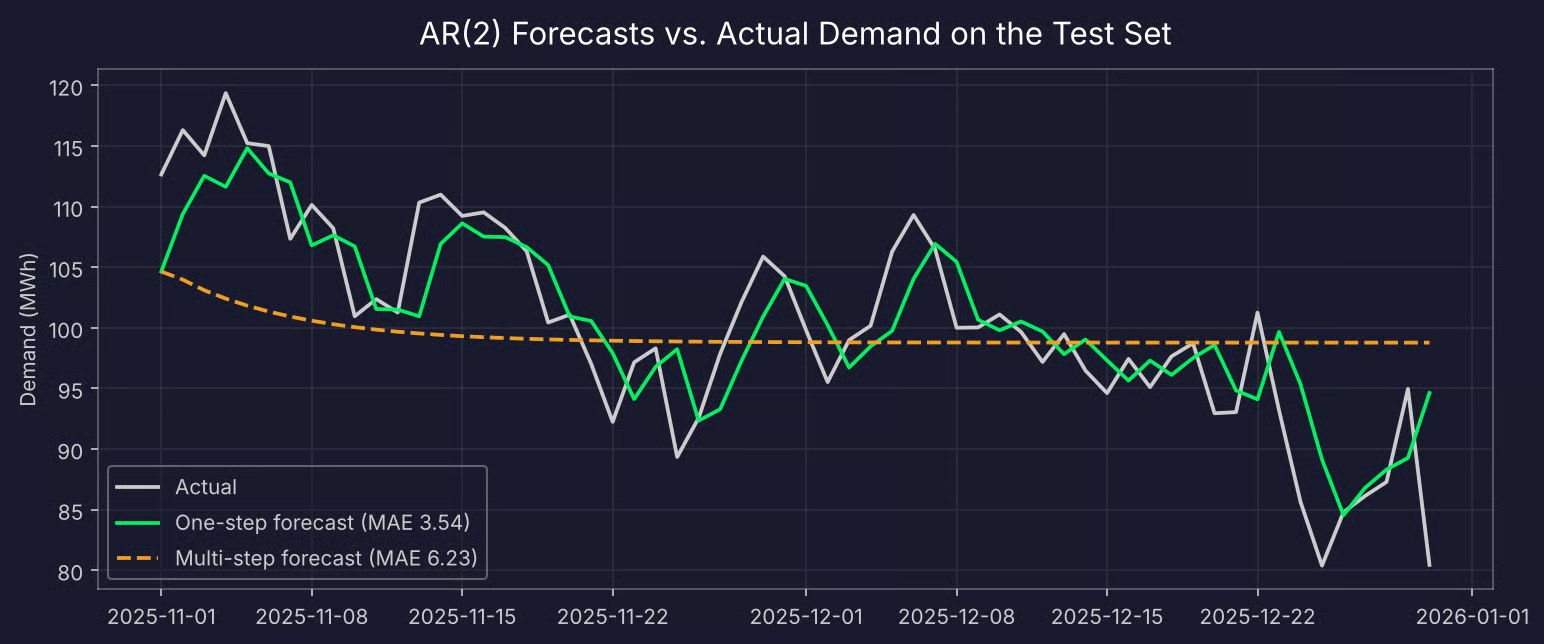
One-step- en multi-step-AR(2)-voorspellingen vergeleken met de werkelijke vraag
De one-step-voorspelling volgt de werkelijke waarden nauw, ongeveer één dag achter. De multi-step-voorspelling start bij de laatst bekende waarde en vlakt dan af richting het gemiddelde binnen zo’n drie weken.
Zo gedraagt elk stationair AR-model zich: hoe verder je vooruit voorspelt, hoe minder het verleden je vertelt, en wordt het langetermijngemiddelde de beste gok. Daarom werken AR-modellen het best voor kortetermijnvoorspellingen.
Het is verleidelijk te denken dat meer historie betere voorspellingen betekent. Laten we dat testen door modellen met een groeiend aantal lags te fitten en hun one-step-MAE te vergelijken:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")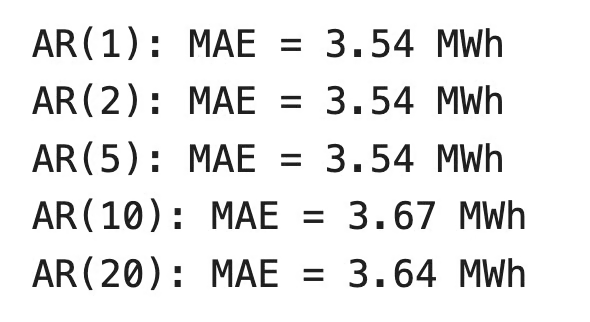
MAE met meer lags
De fout verbetert niet voorbij AR(2) en wordt slechter bij AR(10) en AR(20). Die extra coëfficiënten passen ruis in de trainingsdata.
Je ziet ook dat AR(1) het hier even goed doet als AR(2). De geschatte tweede coëfficiënt is klein, dus die voegt op deze testset weinig toe. Als twee modellen hetzelfde presteren, is het eenvoudigere model makkelijker uit te leggen en minder gevoelig om op nieuwe data stuk te lopen.
Er is ook een kostenzijde. AR(20) schat 21 parameters in plaats van 3.
Kortom: laat PACF en informatiecriteria de orde voorstellen, en bevestig die vervolgens op een testset.
AR-modellen passen goed bij veel voorspelproblemen, maar niet bij alle. Hier zie je waar ze werken en waar niet, en hoe ze zich verhouden tot de modellen die erop voortbouwen.
AR-modellen hebben twee grote voordelen:
Ze hebben ook twee belangrijke beperkingen:
Er is nog een probleem. Vertraagde waarden zijn onderling gecorreleerd omdat ze uit dezelfde reeks komen. In de vraagdata is de correlatie tussen y_t-1 en y_t-2 0,78.
Dit is multicollineariteit, en het raakt elk regressiemodel. Als twee voorspellers samen bewegen, kan het model lastig bepalen welke verantwoordelijk is. De coëfficiënten worden minder stabiel en hun standaardfouten nemen toe.
Dat verklaart wat je eerder zag. Het model schatte 0,676 en 0,138 in plaats van 0,6 en 0,25 — het schoof gewicht van de ene lag naar de andere, maar de som bleef dicht in de buurt. Voorspellingen lijden hier niet veel onder, maar je kunt individuele coëfficiënten minder vertrouwen. Elke extra lag verergert dit probleem.
AR is één van de drie bouwstenen van klassieke tijdreeksvoorspelling. De andere twee zijn moving average (MA)-modellen en ARIMA, dat ze combineert.
Een AR-model voorspelt uit eerdere waarden. Een MA-model voorspelt uit eerdere fouten:
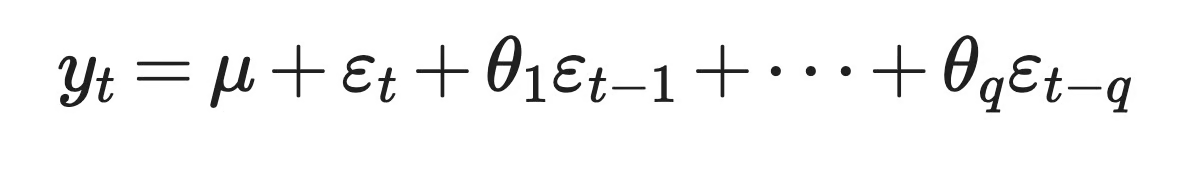
ARMA-model
Hier is mu het gemiddelde van de reeks, theta_1 tot theta_q zijn de coëfficiënten, en epsilon_t-1 tot epsilon_t-q zijn de willekeurige schokken van eerdere stappen. Verwar dit niet met een moving average in de zin van een voortschrijdend gemiddelde. De naam is hetzelfde, maar het model is anders.
De twee modellen reageren anders op schokken. In een MA(q)-model werkt een schok precies q stappen door. In een AR-model dooft een schok in de tijd uit maar valt nooit helemaal naar nul. Daarom kies je de orde met andere tools — de PACF kapt af na lag p voor AR-modellen, en de ACF kapt af na lag q voor MA-modellen.
ARIMA brengt alles samen. ARIMA(p, d, q) heeft drie onderdelen:
Dit betekent dat AR een speciaal geval van ARIMA is. Als je d en q op nul zet, krijg je een AR-model. Je kunt dit checken met de vraagdata:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))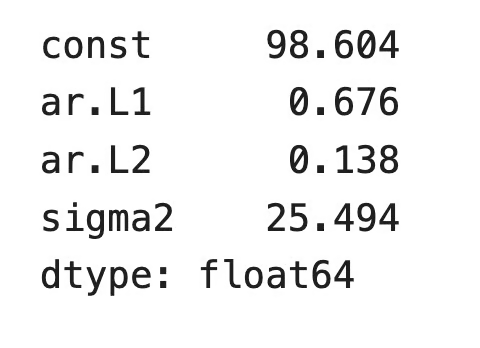
ARIMA-model met 0 integratie- en moving-average-orde
De AR-coëfficiënten komen overeen met die van AutoReg. De constante is anders omdat ARIMA het gemiddelde van de reeks rapporteert, terwijl AutoReg het intercept c rapporteert.
Laten we nu zien waar ARIMA verder gaat. Stel dat de stad groeit en de elektriciteitsvraag elke dag een beetje stijgt. De reeks heeft nu een trend, dus de ADF-test faalt en een AR-model kan niet meer direct met de reeks werken.
Maar ARIMA(2, 1, 0) kan dat wel. Het differentieert de reeks één keer, zodat het model werkt met dagelijkse veranderingen in vraag in plaats van de ruwe waarden, en fit vervolgens AR(2) op die veranderingen. Als een schok, zoals een hittegolf, ook de vraag van de volgende dag beïnvloedt, kun je een MA-term toevoegen en ARIMA(2, 1, 1) krijgen.
Het AR-deel doet in alle gevallen hetzelfde werk. ARIMA bereidt de data ervoor en modelleert wat overblijft. Wil je dieper gaan, dan behandelt de cursus ARIMA Models in R het volledige proces.
Een autoregressief model voorspelt de volgende waarde van een reeks uit het eigen verleden. Het is lineaire regressie waarbij de voorspellers vertraagde kopieën van de target zijn, en dat maakt het een van de makkelijkste tijdreeksmodellen om te begrijpen.
Je ziet het in economie, spraakcodering, EEG-analyse en zelfs in de naam van hedendaagse taalmodellen. Je hebt ook gezien waar het niet de beste optie is: het vereist stationaire data, hangt af van de juiste lag-orde, en gecorreleerde lags maken individuele coëfficiënten minder betrouwbaar.
Als je AR-modellen begrijpt, wordt de rest van klassieke forecasting veel eenvoudiger. ARIMA is de logische volgende stap, en onze ARIMA-tutorial laat zien hoe differentiëren en MA-termen voortbouwen op wat je hier hebt geleerd. Voor een hands-on pad kun je onze cursus ARIMA Models in Python proberen.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

