コース
Pythonで学ぶ時系列解析
4時間
70.9K
多くのオンライン記事はすぐにARIMAに進み、ARの部分には説明をほとんど割きません。しかし、ARはモデルの土台です。ここを理解していないと、ARIMAの残りも腑に落ちません。
平たく言えば、自己回帰モデルは、時系列の将来の値をその過去の値から予測します。経済、金融、信号処理、気候データなどで広く使われています。基本的には回帰モデルなので、既に知っている回帰の知識を時系列予測に結びつける橋渡しになり、ARIMAが構築されている基盤でもあります。
この記事では、自己回帰モデルの仕組み、Pythonのstatsmodelsでのフィッティング方法、そして適切な遅延次数の選び方を順に解説します。
自己回帰モデルは、時系列の次の値を、その過去の値の加重和から予測します。
名前の「auto」は自己を、「regression」は複数の変数から1つを予測することを意味します。つまり、自己回帰モデルは、系列をその過去の値に回帰するものです。
たとえば明日の電力需要を予測したいとします。今日の需要はよい出発点で、昨日の需要も少し情報を足してくれます。自己回帰モデルはその直感を数式に落とし込み、重みはデータから学習します。
ARモデルはAR(p)と書き、pはモデルの次数です。次数は、モデルが用いる過去の値の数を表します。
p個の値を使う次数が高ければ自動的に良いモデルになるわけではありません。pの選び方は後ほど解説します。
AR(p)モデルの一般形は次のとおりです。
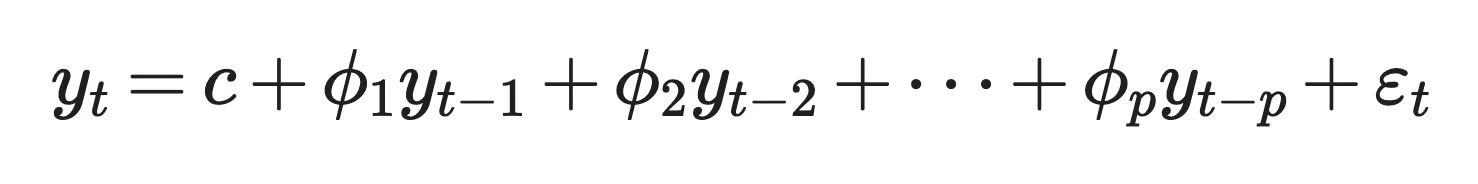
AR(p)モデルの一般形
各項の役割は次のとおりです。
y_t: 時点tの系列の値。予測したい対象
c: 定数項。係数と合わせて系列の長期平均を決める
phi_1〜phi_p: 係数。各過去値が予測にどの程度寄与するかを表す
y_t-1〜y_t-p: 遅延(ラグ)値。「遅延」とは何ステップ前を見るかという意味
epsilon_t: ホワイトノイズ(平均0、分散一定、時点間に相関なしの誤差)
要するに、直近p個の各値にそれぞれの重みを掛けて定数を足します。残りはノイズ、つまり過去では説明できないy_tの部分です。
AR(1)は最も単純な形です。
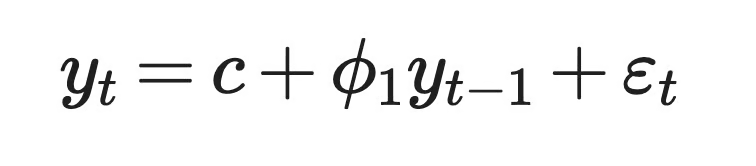
AR(1)モデル
係数phi_1の値が、今日が明日にどれだけ影響するかを決めます。
c = 2、phi_1 = 0.8としましょう。今日の値が15なら、モデルは明日を 2 + 0.8 × 15 = 14 と予測します。次は 2 + 0.8 × 14 = 13.2。各ステップで系列は10(長期平均 c / (1 - phi_1))に近づいていきます。
もしphi_1が負なら、系列は一歩ごとに平均の上下を行き来します。
AR(2)は2期前の遅延を追加します。
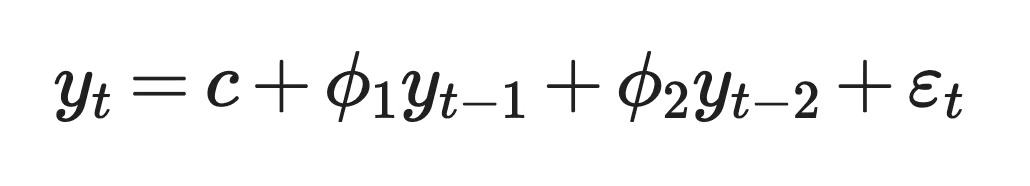
AR(2)モデル
2つの遅延があることで、周期のようなAR(1)では表せないパターンも記述できます。例えば、phi_1が正、phi_2が負だと、景気循環のように上下を繰り返す系列が生まれます。
つまり、どのARモデルでも本質は2つの選択に集約されます――いくつ遅延を使うか、そしてそれらにどんな重みを与えるかです。
ARモデルが機能するには、データに2つの条件が必要です。過去の値が将来の値と関係していること、そして系列のふるまいが時間を通じて同じであること。前者は自己相関、後者は定常性と呼ばれます。
自己相関とは、時系列とその遅延版との相関です。
ARモデルが存在する理由でもあります。今日の値が明日について何も教えてくれないなら、モデルは過去から学ぶことができません。
コードでは、値の列をコピーして1行下にシフトします。各行で一つの値とその直前の値が対になります。2つの列の相関がラグ1の自己相関です。2行シフトすればラグ2の自己相関が得られます。
pandasでの例は次のとおりです。
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))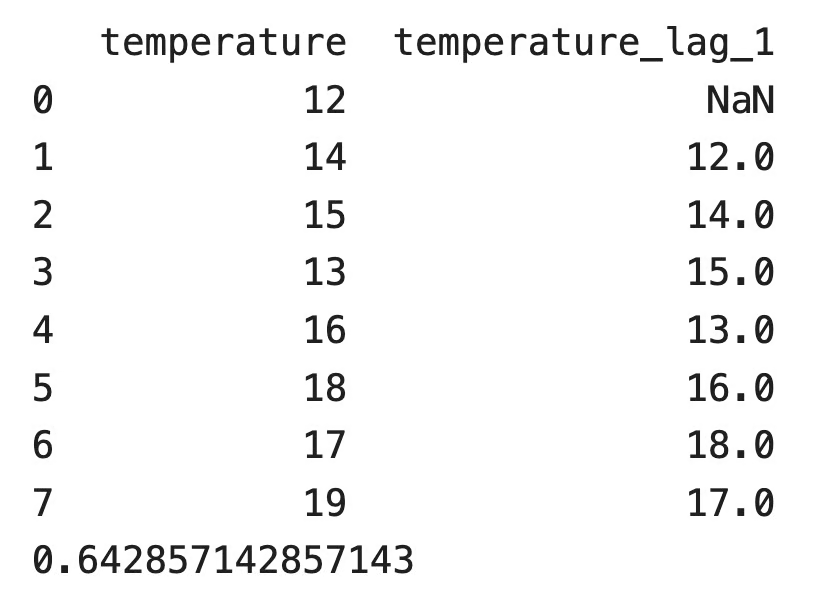
温度列とラグ1列を含むDataFrame
ラグ列の最初の行が空なのは、最初の観測の前に値がないからです。pandasはその行を飛ばし、ラグ1の自己相関は0.643を返します。この系列では、暖かい日の次も暖かい日になりがちです。
自己相関の符号によって系列の動きは変わります。
自己相関が0に近いと、過去は役に立ちません。その場合、ARモデルは平均を予測するのと大差ない結果になります。
ARモデルには定常な時系列が必要です。
定常系列とは、どの部分を見ても平均、分散、特定ラグでの自己相関が同じ系列のことです。これは弱定常とも呼ばれます。
重要なのは、モデルが一組の固定係数を推定するからです。系列の平均が時間とともに漂うなら、過去データで学んだ係数は新しいデータを記述できません。株価は年を追ってトレンドがある典型的な非定常系列で、日次リターンの方がはるかに定常に近いです。
AR(1)では、係数が定常性を決めます。ルールは単純で、phi_1は-1から1の間でなければなりません。
abs(phi_1) < 1: ショックは時間とともに薄れ、系列は平均に戻る
phi_1 = 1: ランダムウォークになり、ショックは薄れない
abs(phi_1) > 1: 各ショックが増幅し、系列が発散する
AR(2)では3つ同時に満たす条件が必要です:phi_1 + phi_2 < 1、phi_2 - phi_1 < 1、abs(phi_2) < 1。
2遅延を超えると一般則が要ります。すべてのAR(p)モデルには特性多項式があります。
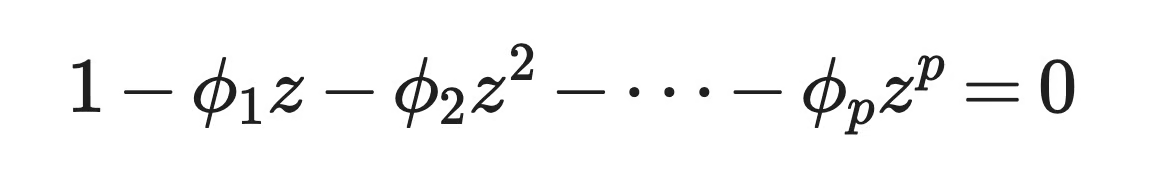
特性多項式
この多項式の全ての根が単位円の外側にあるとき(各根zの絶対値が1より大きいとき)、過程は弱定常です。根は複素数になり得るため、境界は複素平面上の円になります。
AR(1)で確認してみましょう。多項式は1 - phi_1 z = 0なので、根はz = 1 / phi_1。この根が単位円の外にあるのはabs(phi_1) < 1のときだけで、先のルールと一致します。
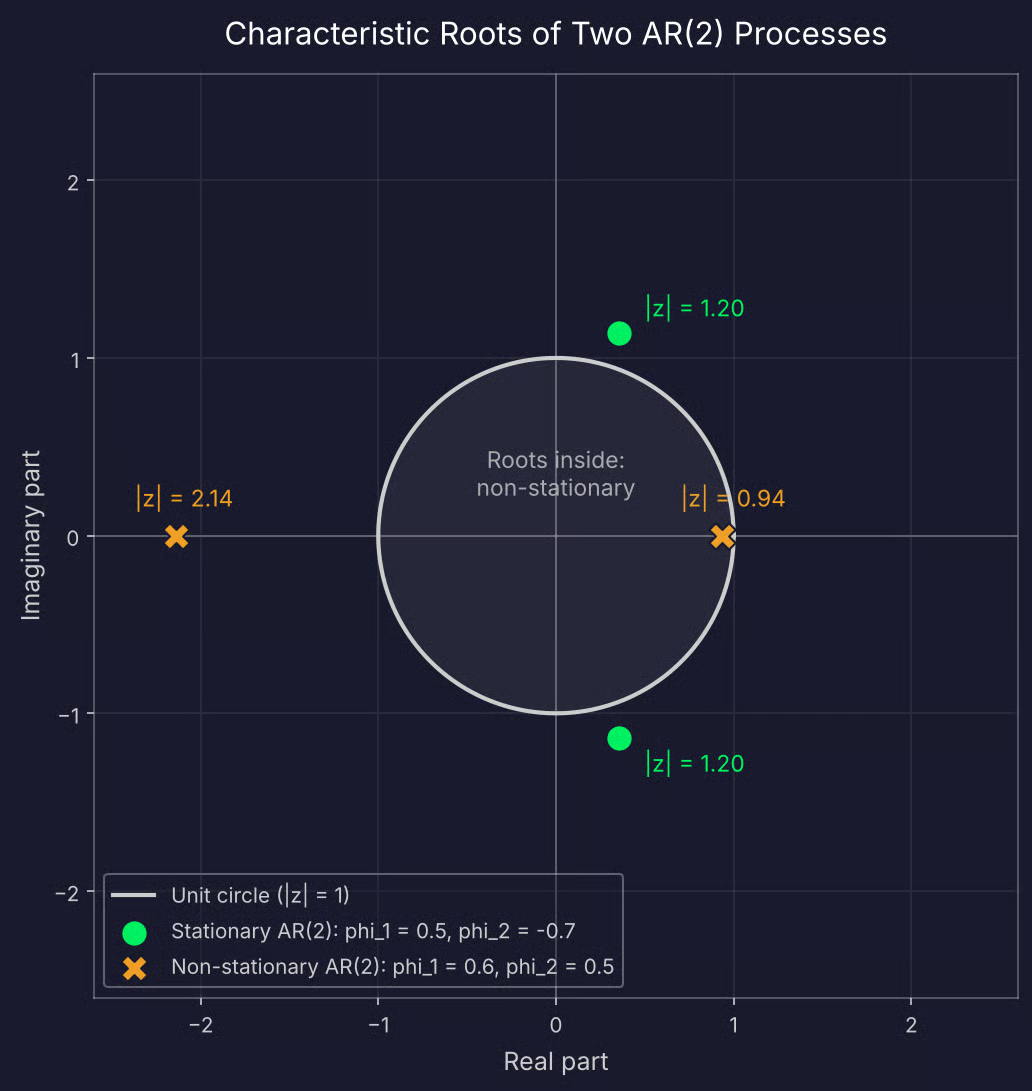
定常なAR(2)と非定常なAR(2)の根
これらの根を手計算する必要はありません。statsmodelsはフィット後に返してくれますし、Pythonの節ではデータ自体の定常性検定の方法も示します。
系列が定常でない場合は差分化(各値から次の値を引く)して、その差分をモデル化できます。これがARIMAモデルの「I(積分)」が意味するところです。
ARモデルは方程式自体は同じで、異なるのは次数p(使う過去の値の数)です。
AR(1)は直前の値だけで次を予測します。
線形回帰のように聞こえるなら、その通りです。y_t-1をx軸、y_tをy軸に置くと、AR(1)は点群に一直線を当てはめます。定数cは切片、phi_1は傾きです。単回帰を知っていれば、AR(1)の推定はもう理解しています。
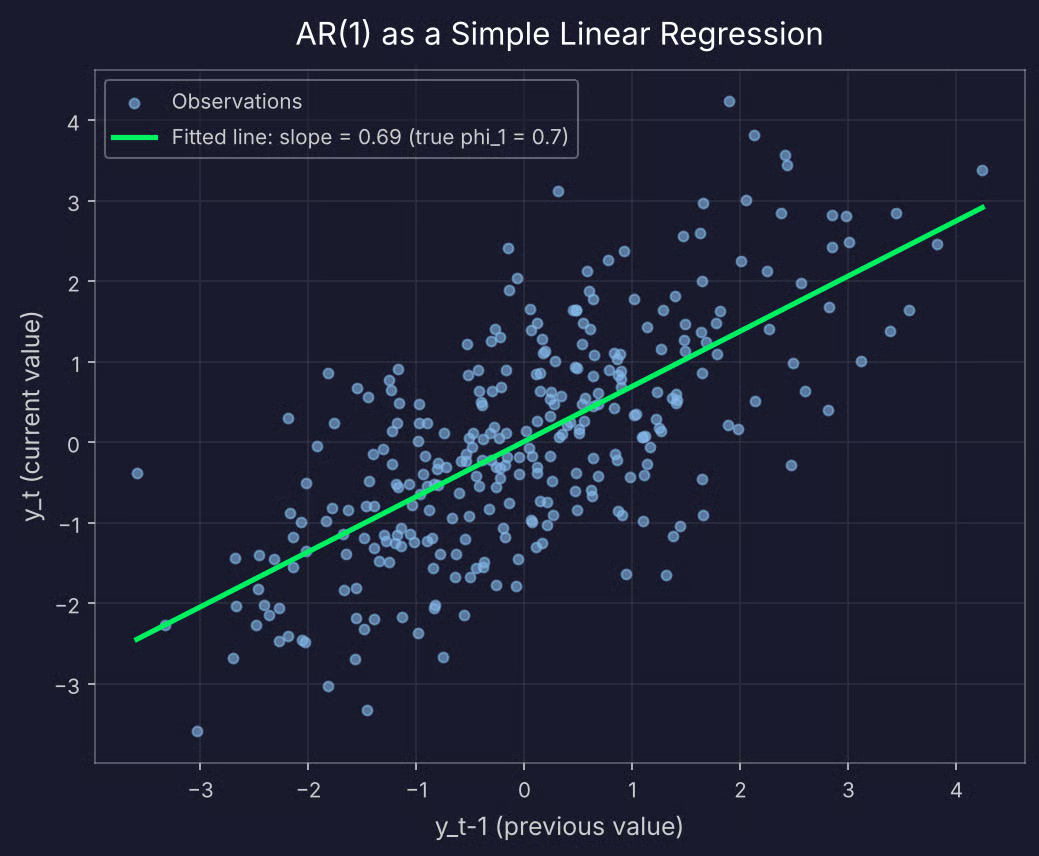
AR(1)における y_t と y_t-1 の散布図
ただし一つ違いがあります。標準的な回帰では説明変数と目的変数は別の変数です。AR(1)では、説明変数は1ステップだけシフトした同じ系列です。そのため、行をシャッフルしたり、ランダムな学習/テスト分割を使うことはできません。データの順序自体がモデルの一部だからです。
係数phi_1の値によって系列の見え方は変わります。
phi_1 = 0.3: 各値が次に運ぶ情報が小さいため、ほぼノイズのように見える
phi_1 = 0.9: 長く滑らかな振れを示し、平均に戻るのに時間がかかる
phi_1 = -0.8: ほぼ毎ステップで平均の上下をジグザグする
phi_1 = 1: ランダムウォークとなり、戻る平均がなく漂う(前節の非定常のケース)
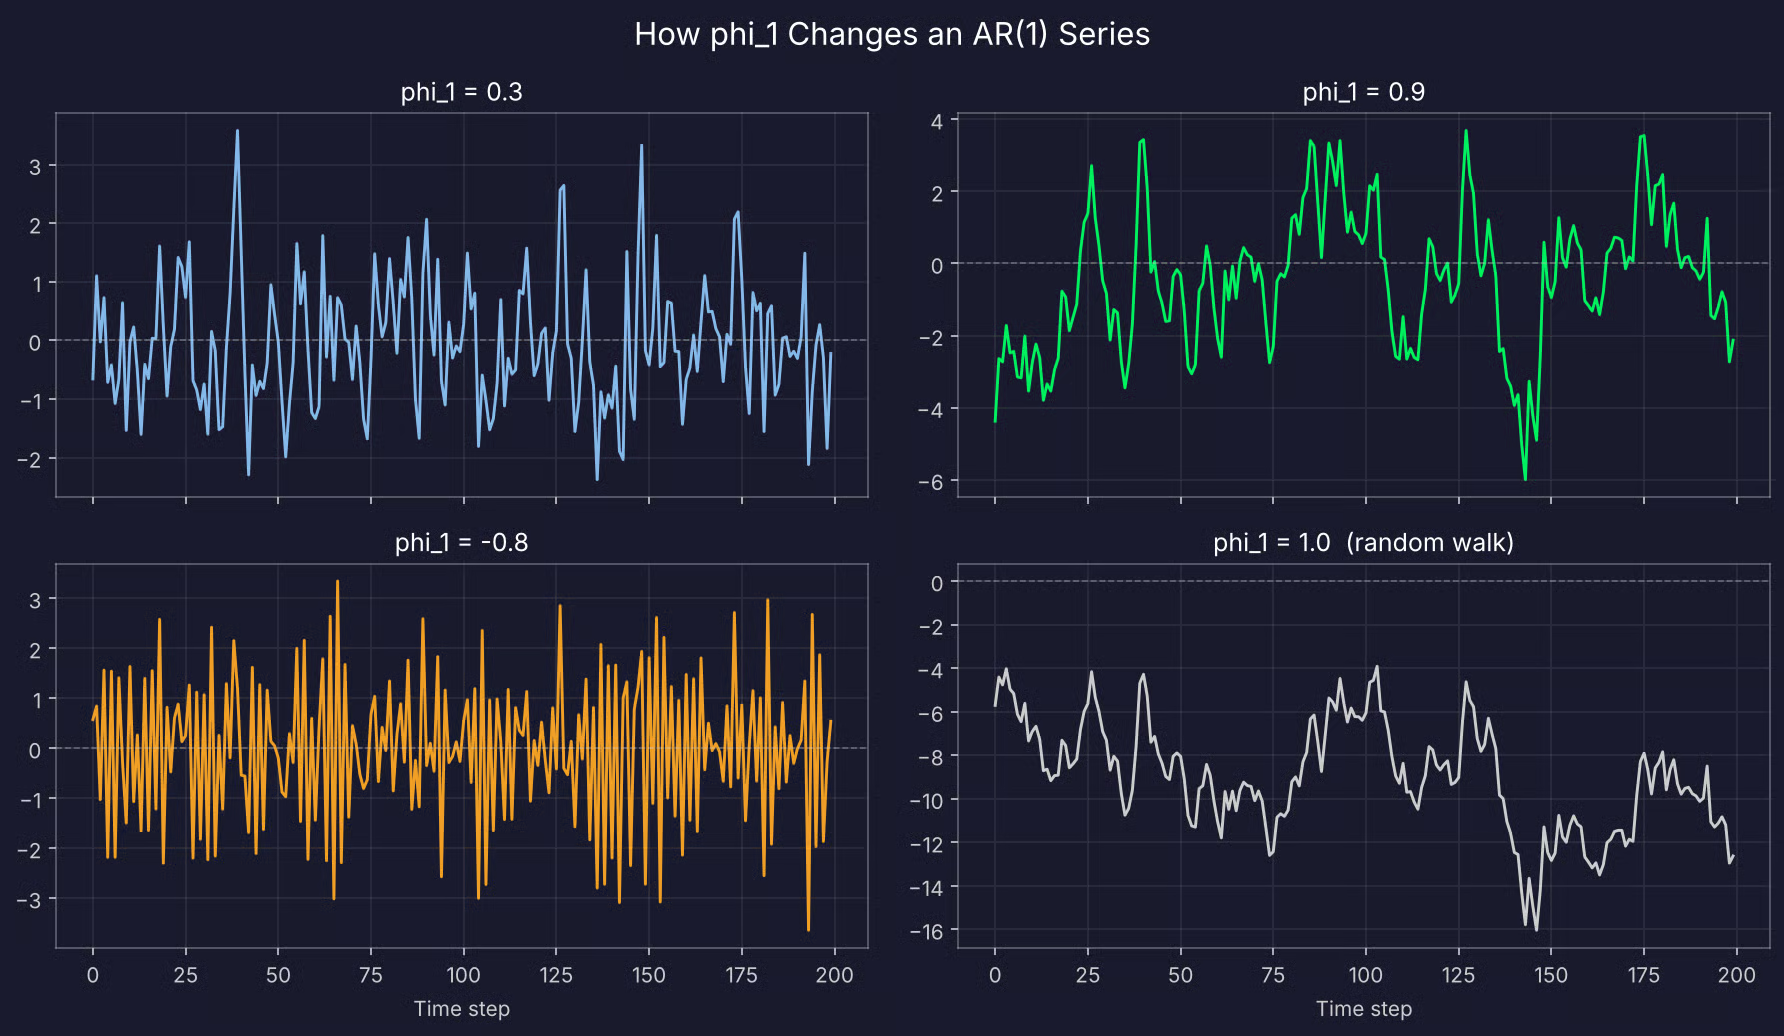
4つのシミュレートしたAR(1)系列
phi_1が1や-1に近いほど、単発のショックの影響が長く残ります。
AR(2)は直前2つの値を使います。2つ目のラグにより、主に周期といったAR(1)では出せないパターンを生み出せます。
2組の係数を比較すると次のようになります。
phi_1 = 0.5、phi_2 = 0.3: 両ラグが同方向に働き、AR(1)よりもさらに長く滑らかな振れになる
phi_1 = 0.5、phi_2 = -0.7: 2つ目のラグが1つ目に逆らい、概ね5ステップ周期で上下の波を繰り返す
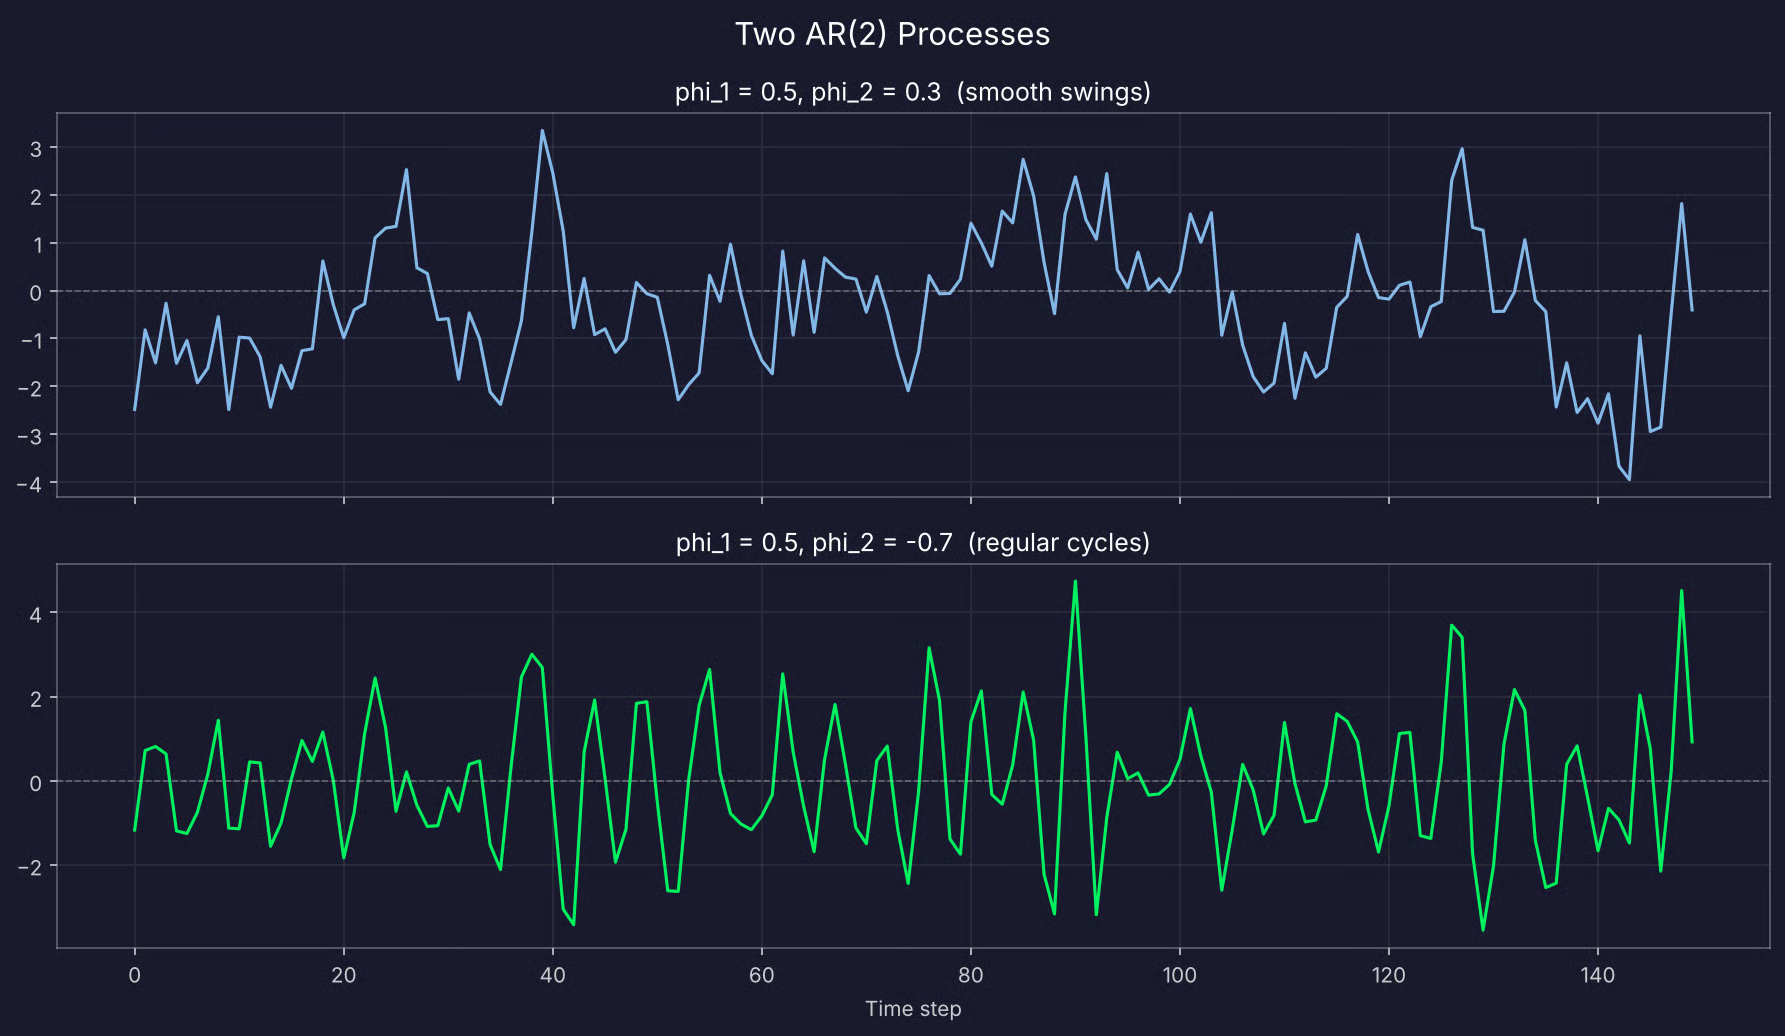
2つのシミュレートしたAR(2)系列
AR(3)、AR(4)…と、ラグを1つずつ追加していきます。より古い値に、直近では得られない情報がある場合に必要です。
例えば月次売上をモデリングするとき、昨年同月が今月の良い予測因子なら、AR(12)モデルが12か月前のラグを(その間の11個のラグとともに)含みます。
ラグを1つ増やすごとに推定すべき係数が増えます。つまり、より多くのデータが必要になり、過学習のリスクも高まります。係数の解釈も難しくなります――12個もあると、数値を眺めただけでは系列の動きが読めません。そこで根を確認します。
適切な次数はPythonの節でPACFとAICを使って選びます。
ARモデルは、データに順序があり、直近の過去が近い未来を示唆する場面ならどこでも現れます。
主な用途は次の4つに大別できます。
最後の例に驚く方も多いでしょう。今日のチャットボットの背後にある用語が、ここで扱っている統計に由来するからです。
この節では、Pythonのstatsmodelsを使って、生データから評価可能な予測まで自己回帰モデルを当てはめます。
データ処理にpandasとNumPy、モデルと検定にstatsmodels、誤差指標にscikit-learnを使います。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorAR(2)過程から2年分の日次電力需要をシミュレーションします。
シミュレートデータを使うのは、真の係数が最初から分かっているからです。そうすれば、モデルがそれらを見つけるか、遅延選択のツールが正しい次数を指すかを確認できます。
ここではc = 15、phi_1 = 0.6、phi_2 = 0.25で、長期平均は100 MWhになります。
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()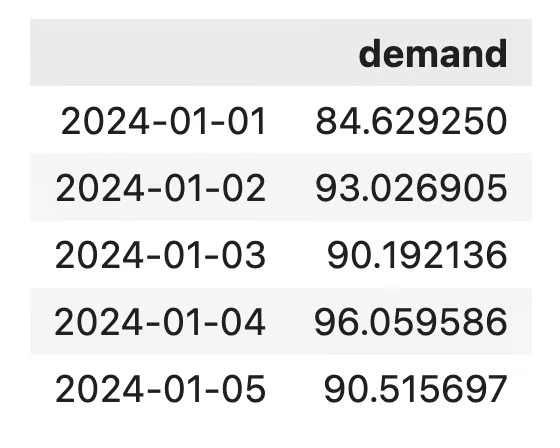
日次電力需要データセット
最初の100日を削除するのは、立ち上がり期間(バーンイン)を設けて、使用開始前に系列が通常のふるまいに落ち着くようにするためです。
全系列は次のようになります。
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()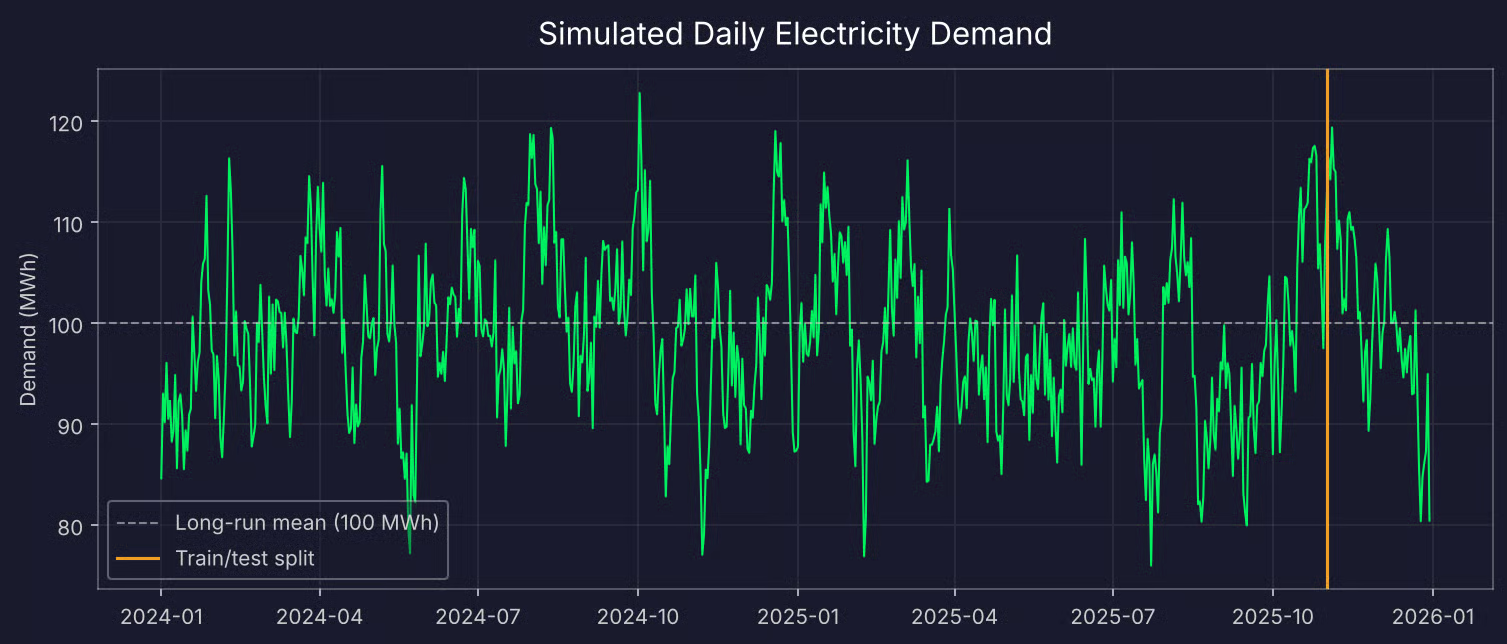
2年分のシミュレートした日次電力需要
トレンドなく100の周りを上下しており、定常系列らしい見た目です。ただし、見た目の確認だけでは十分ではありません。
拡張ディッキー=フラー(ADF)検定は系列が定常かどうかを確認します。帰無仮説は「非定常」ですので、小さいp値が望ましい結果です。
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")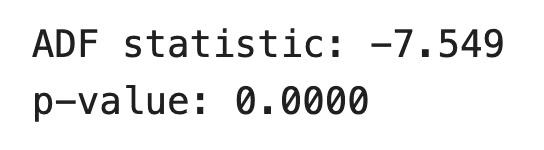
ADF検定結果
p値は0.05を大きく下回っているため、帰無仮説を棄却し、系列を定常と見なせます。
ご自身のデータがこの検定に落ちる場合は、df["demand"].diff().dropna()で差分化してから再度検定してください。
時系列データはシャッフルできないため、テストセットは系列の末尾から取り出す必要があります。ここでは最後の60日をテストにします。
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
これで学習670日、テスト60日となります。
モデルの性能を左右する重要な工程です。ラグが少なすぎるとデータのパターンを取り逃し、ラグが多すぎると将来繰り返されない訓練データのノイズまで当てはめてしまいます。
使えるツールは2つあります。
1つ目は偏自己相関関数(PACF)です。各ラグと系列の相関を、より短いラグの影響を除いた上で示します。AR(p)過程では、PACFはラグpまで顕著なスパイクを示し、その後は0付近に落ちます。
plot_pacf(train, lags=20, method="ywm")
plt.show()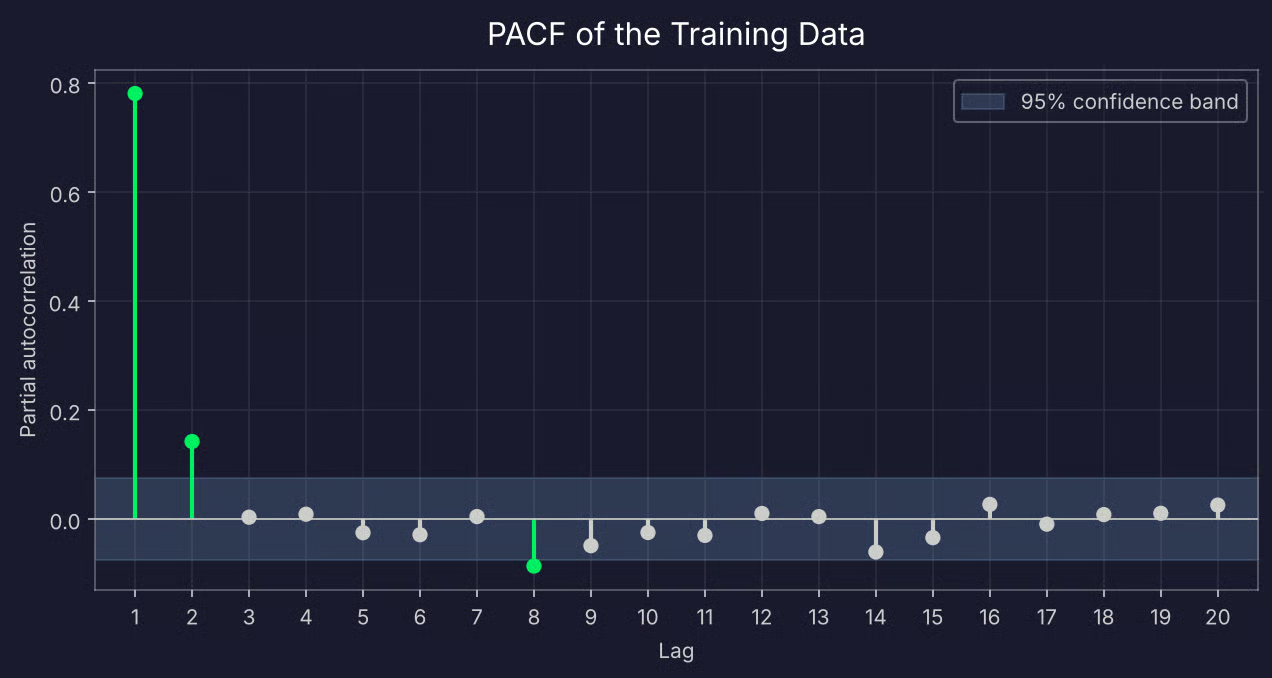
学習データのPACF
ラグ1と2が信頼帯を大きく超え、ラグ3は0付近に落ちています。AR(2)を示唆します。
ラグ8にも小さなスパイクがあり、わずかに帯を超えています。深読みは禁物です。帯は95%信頼で描かれているため、20個のラグがあれば偶然1つ程度は越えることがあります。
2つ目は情報量規準です。AICとBICはいずれも適合の良さを評価し、余分なパラメータには罰則を与えます。BICの方が罰則が強く、小さめのモデルを選びがちです。statsmodelsは最大次数までを総当たりし、最良のものを返せます。
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")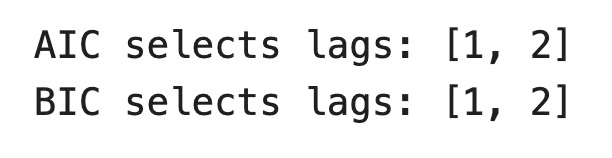
AIC/BICによるラグ選択
両規準はPACFと一致しました。実務ではAICがBICより少し大きいモデルを選ぶこともあります。その場合は、小さい方から始めるのが無難です。
次数が決まれば、フィッティングは2行で済みます。
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")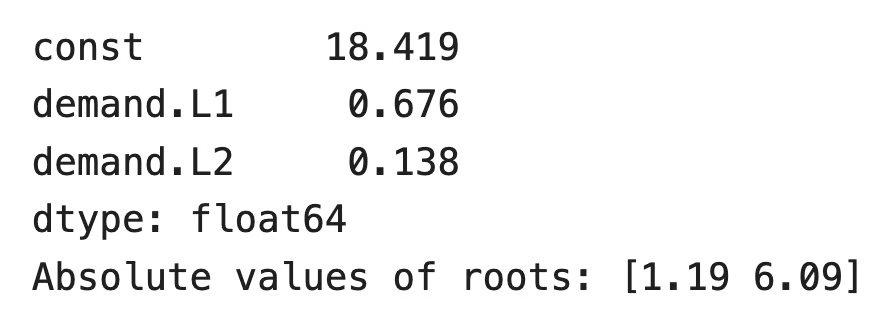
AR(2)モデルのパラメータ
真の値は0.6と0.25です。モデルは1つ目のラグにやや大きく、2つ目にやや小さく重みを置いていますが、2係数の和は近く(0.85に対して0.81)なっています。670点では厳密な値は回収できません。
両方の根の絶対値が1より大きいので、当てはめたモデルは定常です。標準誤差、p値、根の表が必要ならresults.summary()を呼び出してください。
テスト期間の予測には2通りあり、答える問いが異なります。
マルチステップはフィット結果から直接出せます。ワンステップでは、学習済み係数を全系列に適用します。
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")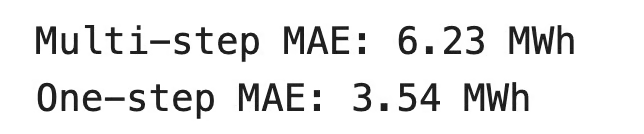
予測結果
平均絶対誤差(MAE)は、予測と実測の絶対差の平均です。データと同じ単位なので、そのまま解釈できます。ワンステップ予測は平均で3.54 MWh外れました。
両予測と実測の比較は次のとおりです。
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()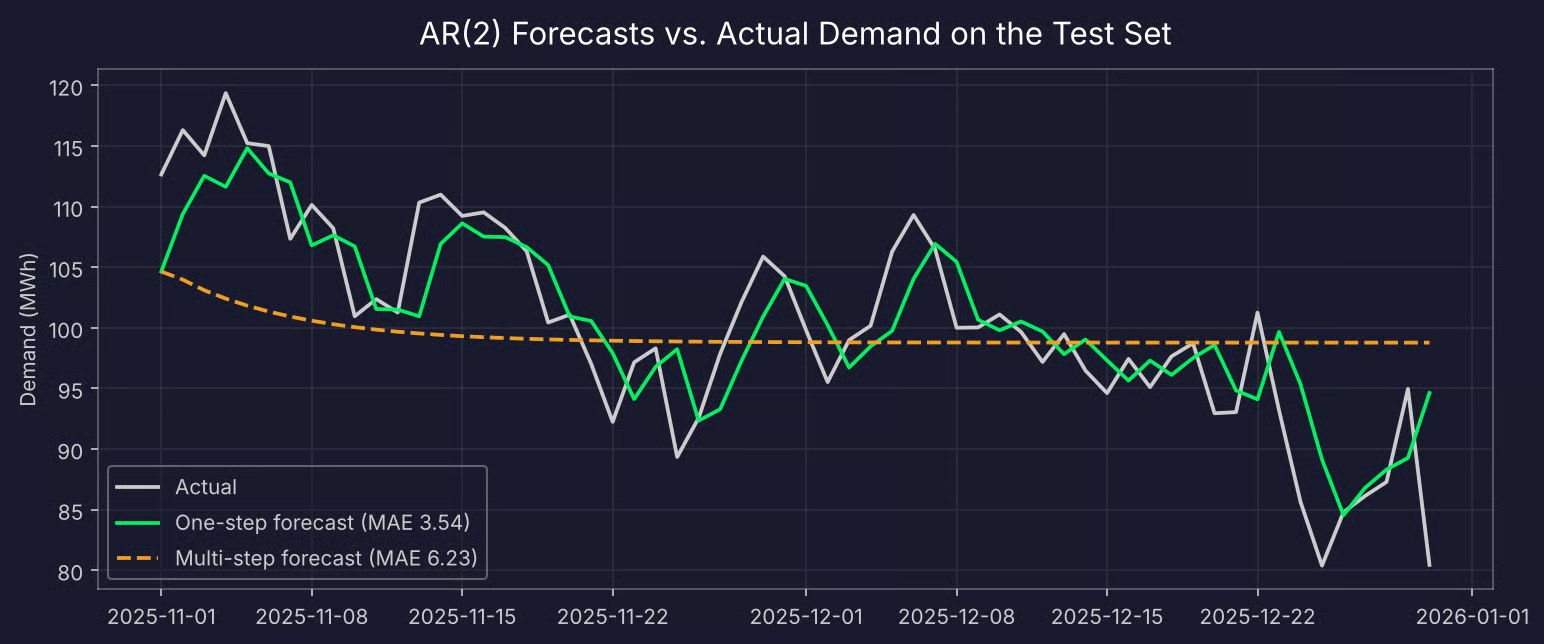
ワンステップとマルチステップのAR(2)予測と実測の比較
ワンステップ予測は実測にほぼ追随し、1日遅れで動きます。マルチステップ予測は最後の既知値から始まり、約3週間で平均付近へと平坦化します。
これは定常なARモデルすべてに見られる挙動です。先の期間を予測するほど過去の情報は効かなくなり、最善の推測は長期平均になります。だからこそ、ARモデルは短期予測に最も適しています。
履歴が多いほど予測が良くなる、と考えがちです。ラグ数を増やしたモデルを当てはめ、ワンステップのMAEを比較して確かめてみましょう。
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")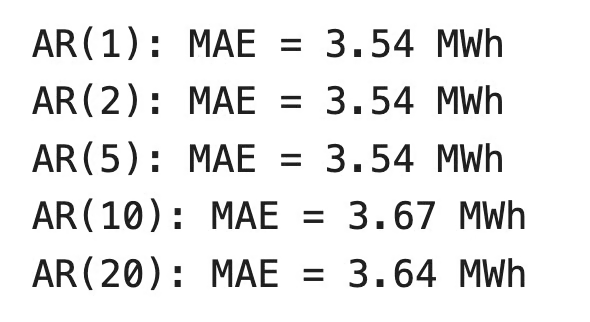
ラグ数を増やした場合のMAE
誤差はAR(2)以降で改善せず、AR(10)やAR(20)では悪化しました。余分な係数が訓練データのノイズに当てはまってしまったためです。
ここではAR(1)がAR(2)と同等に見えることにも気づくでしょう。推定された2つ目の係数が小さく、このテストセットでの寄与が小さいためです。性能が同じなら、より単純なモデルの方が説明しやすく、新しいデータでも壊れにくいものです。
計算コストの面でも、AR(20)は3つではなく21のパラメータを推定します。
結論として、PACFと情報量規準で次数のあたりを付け、テストセットで裏を取るのが良い方針です。
ARモデルは多くの予測課題に適しますが、万能ではありません。どこで効くのか・効かないのか、そしてその上に構築されたモデルとの比較を見ていきます。
ARモデルの主な利点は2つあります。
主な限界は2つあります。
もう一つの問題があります。遅延値は同じ系列から来るため互いに相関します。需要データでは、y_t-1とy_t-2の相関は0.78です。
これは 多重共線性と呼ばれ、あらゆる回帰モデルに影響します。2つの予測子が一緒に動くと、モデルはどちらが原因か判断しにくくなります。係数は不安定になり、標準誤差が大きくなります。
先ほど見た現象の説明にもなります。モデルは0.6と0.25の代わりに0.676と0.138を推定しました――片方のラグからもう片方へ重みが移ったものの、和は近いままです。予測精度への影響は大きくありませんが、個々の係数はあまり当てになりません。ラグを増やすほど、この問題は悪化します。
ARは古典的な時系列予測の3つの構成要素の1つです。他は移動平均(MA)モデルと、それらを組み合わせたARIMAです。
ARは過去の値から予測し、MAは過去の誤差から予測します。
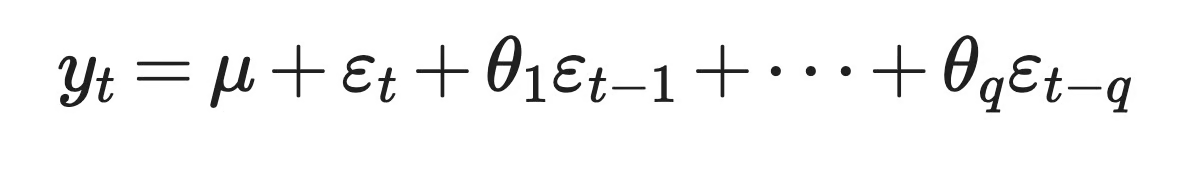
ARMAモデル
ここで、muは系列の平均、theta_1〜theta_qは係数、epsilon_t-1〜epsilon_t-qは以前のステップのランダムショックです。ローリング平均の「移動平均」と混同しないでください。名前は同じでもモデルは別物です。
両モデルはショックへの反応が異なります。MA(q)ではショックの影響はちょうどqステップで終わります。ARではショックは時間とともに薄れますが、完全に0にはなりません。この違いが、次数選択のツールの違いにもつながります――ARではPACFがラグpで打ち切れ、MAではACFがラグqで打ち切れます。
ARIMAはそれらを統合します。ARIMA(p, d, q)は3つの部分から成ります。
つまり、ARはARIMAの特殊例です。dとqを0にすればARモデルになります。需要データで確認してみましょう。
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))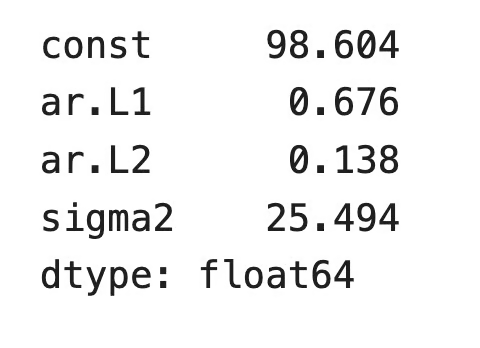
差分とMA次数が0のARIMAモデル
AutoRegでのAR係数と一致します。定数が異なるのは、ARIMAは系列の平均を、AutoRegは切片cを報告するためです。
ここからARIMAがどこまで拡張できるか見てみましょう。例えば都市が成長し、電力需要が日々少しずつ増えるとします。系列にトレンドが生じるためADF検定に落ち、ARモデルはもはや系列を直接扱えません。
しかしARIMA(2, 1, 0)なら可能です。1回差分を取り、生の値ではなく日々の変化量を扱ってから、その変化にAR(2)を当てはめます。熱波のようなショックが翌日にまで影響するなら、MA項を加えてARIMA(2, 1, 1)にできます。
いずれの場合も、ARの役割は同じです。ARIMAはそのための下ごしらえをし、残差をモデル化します。さらに深く学ぶには、ARIMA Models in Rコースが全体の流れをカバーしています。
自己回帰モデルは、系列の次の値をその過去から予測します。予測子が目的変数の遅延版である線形回帰であり、時系列モデルの中でも理解しやすい部類に入ります。
経済、音声符号化、EEG解析、さらには今日の言語モデルの名称にも登場します。一方で、定常データを必要とし、適切な遅延次数に依存し、相関したラグのために個々の係数の信頼性が下がる場面も見てきました。
ARモデルを理解すれば、古典的な予測の残りはぐっと楽になります。次の自然な一歩はARIMAで、ARIMAチュートリアルでは、差分化とMA項がここで学んだ内容をどう拡張するかを解説しています。実践重視なら、ARIMA Models in Pythonコースをお試しください。