
{count, plural, one {강의} other {강의}}
Seaborn으로 시작하는 데이터 시각화
{hours}시간
184.9K
주택 가격에 선형 회귀 모델을 만들고 있습니다. 잔차 플롯이 메가폰처럼 보입니다(왼쪽은 좁고 오른쪽으로 갈수록 퍼짐). 모델은 기술적으로는 실행됩니다. 다만 결과를 신뢰하기 어렵습니다. 이 패턴은 이분산성(heteroscedasticity)으로, 눈에 띄는 오류를 내지 않고도 추론을 조용히 무효화하는 위반 사항 중 하나입니다.
한 가지 방법은 반응 변수(종속 변수)를 변환하는 것입니다. 로그, 제곱근, 역수를 시도할지 감으로 정하는 대신, 데이터가 스스로 적절한 변환을 제안하게 할 수 있습니다. 이것이 Box-Cox 변환의 아이디어이며, 여기서는 그 공식, 람다를 선택하는 방법, Python과 R에서 구현하는 방법을 다룹니다.
Box-Cox 변환은 엄밀히 양수인 데이터에 적용하는 거듭제곱(power) 변환의 계열입니다. 특정 변환을 직접 고르는 대신, 람다(λ)라는 매개변수로 지표화된 넓은 범위의 변환을 탐색할 수 있는 방법을 제공합니다.
람다가 0이면 로그 변환이 됩니다. 0.5이면 제곱근에 가까운 형태가 됩니다. -1이면 역수에 가깝습니다. 모두 같은 공식의 특수한 경우이므로, 미리 이들 중 하나를 선택할 필요가 없습니다. 데이터로부터 무엇이 가장 잘 맞는지 추정합니다.
처음부터 분명히 해둘 점이 있습니다. Box-Cox가 단지 "데이터를 정규로 만든다"는 뜻은 아닙니다. 모델링 문제에 따라 분산 안정화, 예측 변수와 반응 변수 간 선형성 개선, 모델 가정 충족에 도움을 줄 수 있습니다. 또 입력값이 엄밀히 양수여야 합니다. 0과 음수는 허용되지 않습니다. 자세한 내용은 제한 사항 섹션에서 다룹니다.
공식으로 들어가기 전에 직관을 쌓아 봅시다. 주당 매출처럼 오른쪽으로 긴 꼬리를 가진 오른쪽 치우침(right-skewed) 변수가 있다고 가정합시다. 평균이 커질수록 분산도 커집니다. 이때 그 변수의 어떤 거듭제곱이 더 잘 behaved 된 반응처럼 작동할지 묻는 것입니다.
람다 값에 따라 익숙한 변환들에 대응합니다:
표준 Box-Cox 정식화에는 스케일링과 평행이동 관례가 포함되므로, 위 항목들은 문자 그대로 동일한 공식이라기보다 익숙한 등가물로 이해하는 것이 좋습니다. 로그 경우(lambda = 0)는 극한으로 다룹니다. 연속성을 위한 논변 때문에 그 지점에서 log(x)로 전환하는 것이지, 임의의 예외 규칙이 아닙니다.
표준 조각별(piecewise) 공식은 다음과 같습니다:
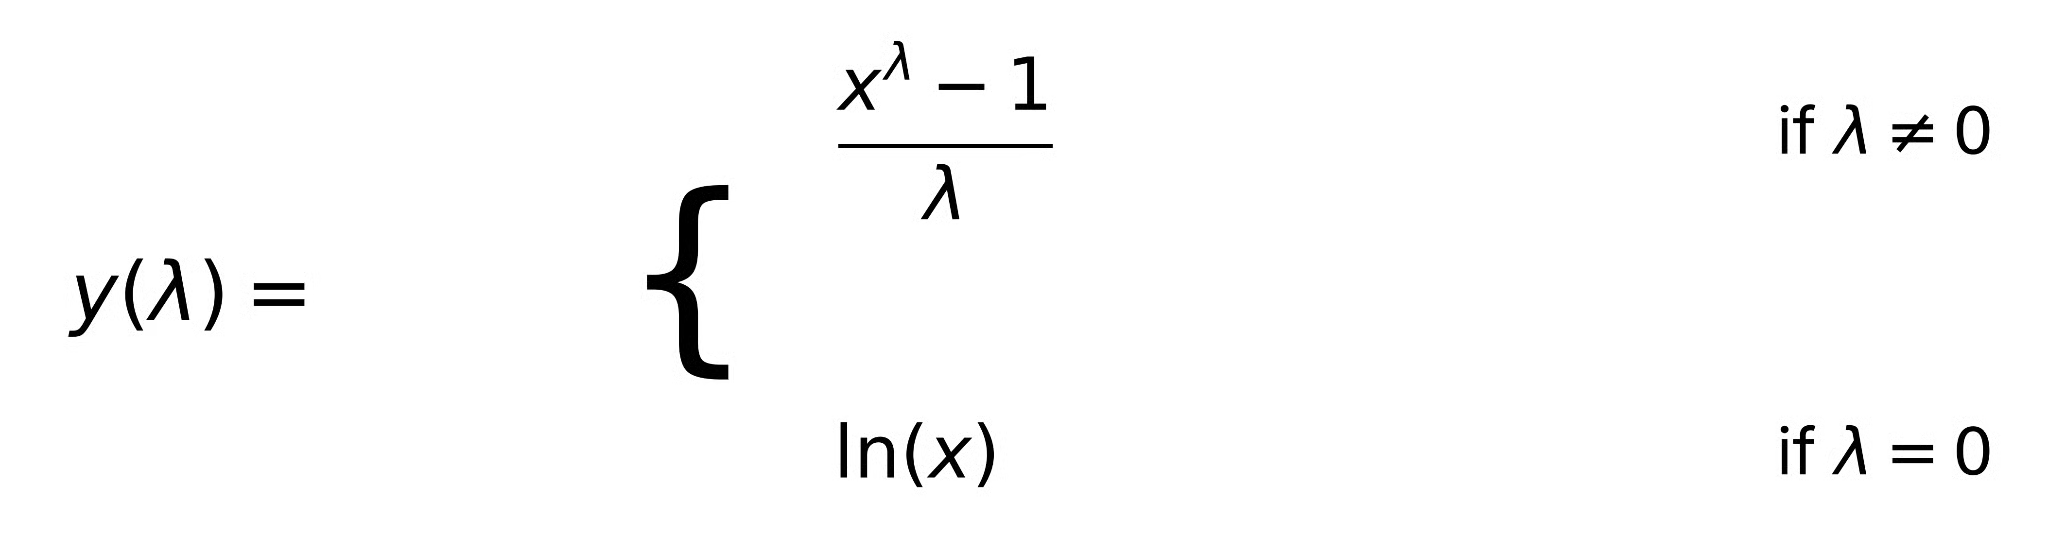
여기서 x는 변환할 양수 값이고, lambda는 변환 매개변수입니다. (xλ - 1) / λ 형태는 처음엔 낯설 수 있습니다. 이는 람다가 0에 접근할 때 변환의 연속성을 유지하는 스케일링 관례입니다. 이것이 없으면 lambda = 0에서 점프 불연속이 생기고, 로그 경우가 나머지 가족과 완전히 분리됩니다. 이를 통해 lambda → 0일 때 공식이 부드럽게 ln(x)로 이행합니다.
유도 과정은 지금은 걱정하지 않으셔도 됩니다. 실무적으로는: 람다를 선택하거나 추정하고, 양수 값을 대입하여 변환된 출력을 사용하면 됩니다.
람다는 직관에 따라 손으로 설정하는 값이 아닙니다. 데이터로부터 추정합니다. 이것이 단순히 "로그를 써보자"고 감으로 맞추는 것과 Box-Cox를 구분하는 지점입니다. 통계적으로 정당한 절차가 바탕에 있습니다.
아이디어는 가정한 모델에 가장 잘 맞게 하는 람다를 찾는 것입니다. 회귀 맥락에서는 변환된 반응 변수가 보통 잔차의 정규성 및 분산 불변성 같은 모델 가정을 가장 잘 만족하도록 하는 람다를 찾는다는 뜻입니다. 반응 변수의 주변 분포가 가장 정규에 가까워 보이도록 하는 람다를 고르는 것이 아닙니다. 모델링 맥락에서 가장 잘 작동하는 람다를 고르는 것입니다. 이 구분은 중요하며, 실수 섹션에서 다시 언급하겠습니다.
여기서 가장 유용한 진단 중 하나가 프로파일 우도(plot)입니다. x축은 람다 값, y축은 로그우도입니다. 꼭대기가 추정된 최적 람다를 알려 줍니다. 그 못지않게 유용한 것이 꼭대기 주변의 신뢰구간입니다. 보통 최대값보다 일정 임계치 낮은 수평선로 표시되며, 그 구간에 속하는 어떤 람다도 통계적으로 최적과 구별되지 않습니다.
현장에서 종종 과소평가되는 고려 사항이 있습니다. 최적 람다가 0.43 정도이고, lambda = 0.5가 신뢰구간 안에 들어간다면 0.5를 선택하세요. 제곱근 변환은 설명하기도, 역변환하기도 더 쉽고, 성능 손실은 거의 없습니다. 같은 논리는 0(로그)와 1(무변환)에도 적용됩니다. 특히 람다 = 0.43이 무엇을 의미하는지 모르는 사람에게 모델을 설명할 때 해석 용이성은 중요합니다.
람다가 무엇이고 어떻게 선택되는지 알았으니, 이제 실습해 봅시다. 먼저 Python, 그다음 R입니다.
SciPy의 stats 모듈이 이를 직접 지원합니다. boxcox() 함수는 람다를 추정하고 변환된 값을 한 번에 반환합니다. 다음은 시뮬레이션한 오른쪽 치우침 데이터를 사용한 최소 예제입니다:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
여기서 estimated_lambda는 정규성 가정하에 로그우도를 최대화하는 값입니다. 예측을 위해 새 데이터를 변환할 때도 동일한 값을 사용해야 합니다.
이 방법은 반응 변수의 주변 분포로부터 람다를 추정한다는 점에 유의하세요. 모델링 워크플로에서는 모델 맥락에서 람다를 평가합니다. 아래 R 예제에서 MASS의 boxcox() 사용법으로 이를 보여줍니다.
R에서는 MASS 패키지의 boxcox() 함수가 회귀 워크플로에 맞게 설계되어 있습니다. 적합된 모델 객체를 받아 프로파일 우도를 직접 그려 주므로, 독립 벡터가 아닌 모델 맥락에서 람다를 평가하는 방식에 자연스럽게 들어맞습니다.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R의 boxcox()는 프로파일 우도를 자동으로 그려 주므로, 신뢰구간 시각화를 바로 확인할 수 있습니다. 이를 통해 람다를 더 단순한 값으로 반올림할지 쉽게 결정할 수 있습니다.
반응 변수를 변환해 모델을 적합했다면, 예측치는 원래 스케일이 아니라 변환된 스케일에 있습니다. 3.2라는 예측은 매출 3.2 단위가 아니라 (xλ - 1) / λ의 3.2 단위를 의미합니다.
변환 후에는 계수 해석이 달라집니다. 변환된 스케일에서 예측 변수가 한 단위 증가하면 원래 y가 아니라 y(λ)의 변화에 대응합니다. 람다가 0에 가깝다면(로그에 근접) 원래 스케일에서의 퍼센트 변화를 근사할 수 있습니다. 다른 람다 값에서는 관계가 더 복잡하며 현재 수준에 따라 달라집니다.
예측치를 원래 스케일로 되돌리려면 다음 역함수를 적용합니다:
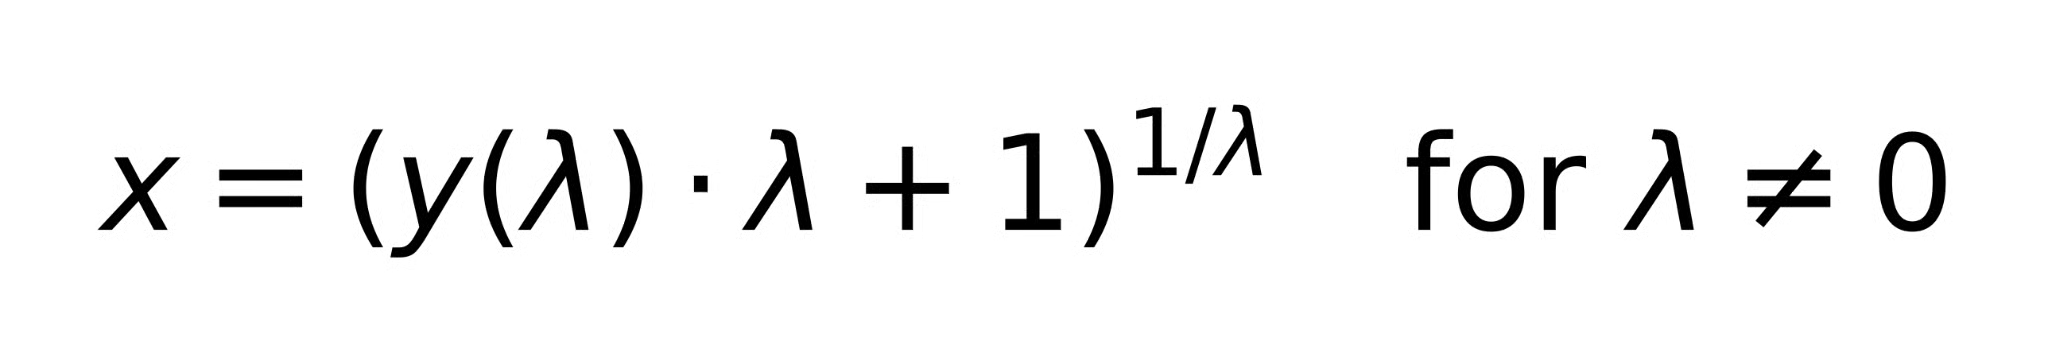
lambda = 0인 경우, ln(x)의 역함수는 단순히 exp(y)입니다.
변환 스케일에서의 예측 평균을 역변환한다고 해서 원래 스케일의 평균에 대한 불편 추정이 되지는 않습니다. 이는 Jensen의 부등식에서 비롯되는 잘 알려진 결과로, 로그-선형 모델에서 평균 예측과 같은 상황에서 특히 중요합니다. 편향 보정에 대한 깊은 논의는 여기 범위를 벗어납니다. 더 넓은 맥락이 필요하시다면 Introduction to Regression in Python 강의에서 회귀 모델의 예측과 해석을 폭넓게 다룹니다.
이미 사용 중일 수 있는 대안과 비교하여 언제 Box-Cox를 써야 할까요?
로그 변환은 Box-Cox의 lambda = 0 경우입니다. 이게 전부입니다. 로그 변환을 사용해 오셨다면, 람다를 추정하지 않고 고정한 Box-Cox의 특정 인스턴스를 사용해 온 것입니다. Box-Cox의 장점은 미리 lambda = 0에 고정하지 않는다는 점입니다. 다만 프로파일 우도가 lambda = 0에서 명확히 정점을 찍는다면 그냥 로그를 사용하세요. 불필요한 복잡성을 더할 이유가 없습니다.
Yeo-Johnson 변환은 0과 음수를 처리하도록 설계된 Box-Cox의 직접적인 확장입니다. 데이터에 0(예: 카운트)이나 음수가 포함될 때 사용할 변환입니다. 수학적으로 유사하며, Yeo-Johnson은 양수 제약을 완화합니다. scikit-learn의 PowerTransformer는 method='box-cox'와 method='yeo-johnson'를 모두 지원하므로 손쉽게 전환해 볼 수 있습니다.
표준화(z-점수)는 데이터를 이동·스케일링하여 평균을 0, 표준편차를 1로 만듭니다. Box-Cox는 비선형 변환으로 분포의 모양을 바꿉니다. 해결하는 문제가 다릅니다. 표준화는 왜도나 분산 불안정을 줄이지 못합니다. Box-Cox는 데이터를 중심화하거나 특성 크기를 서로 비교 가능하게 만들지 않습니다. 먼저 변환하고 그다음 표준화하는 식으로 둘 다 순차적으로 할 수 있지만, 서로 대체 관계는 아닙니다.
돌이켜 보면 자명한 것들도 있습니다. 그렇다고 해서 실제로 일어나지 않는 것은 아니며, 몇몇은 "자명하다"는 표현이 과할 정도로 미묘합니다.
공식은 0 이하에서 성립하지 않습니다. 0λ는 양의 람다에선 0이고 음의 람다에선 정의되지 않으며, log(0)는 음의 무한대입니다. 데이터에 0 또는 음수가 있으면 Box-Cox는 오류를 내거나 조용히 의미 없는 값을 낼 수 있습니다. 대신 Yeo-Johnson을 사용하거나, 작은 양의 상수를 더해 평행이동하세요. 다만 후자는 근사치이므로 신중하게 다뤄야 합니다.
Box-Cox는 특정 모델링 문제—비상수 분산, 선형성 저하, 잔차 가정 위반—에 대응해 적용해야 합니다. 모델을 적합하기 전에 주변 분포를 "정규처럼 보이게" 만들려는 자동 전처리 단계로 사용하는 것은 순서가 거꾸로입니다. 반응 변수를 고립시켜 정규에 가장 가깝게 만드는 람다가 실제로 모델의 잔차를 개선하는 람다와 같지 않을 수 있습니다.
람다를 추정하는 것은 반일뿐입니다. 변환하고 재적합한 뒤에는 잔차 플롯을 다시 확인하세요. Box-Cox가 가정 충족을 보장해 주지는 않습니다. 다만 가능성을 높여 줍니다. 잔차가 여전히 퍼지거나 곡률이 보인다면, 다른 문제가 있는 것입니다.
변환 후에는 계수가 더 이상 원래 스케일의 관계를 설명하지 않습니다. 결과 보고나 예측 시 이 점에서 가장 많이 실수합니다. 매 단계에서 어떤 스케일에서 작업 중인지 반드시 추적하세요.
반응 변수 히스토그램 같은 단변량 분포로 추정한 람다는 회귀 모델 내에서 추정한 람다와 다를 수 있습니다. 회귀 기반 접근이 올바릅니다. 목표는 주변 분포 가정이 아니라 잔차 가정을 만족하는 것입니다.
변환된 데이터로 학습한 모델을 배포할 때는, 동일한 람다로 새 입력을 같은 방식으로 변환하고, 예측을 역변환해야 합니다. 어느 한 단계라도 빼먹으면 잘못된 스케일의 예측을 얻게 됩니다. 분명해 보이지만 여전히 자주 잊힙니다.
Box-Cox는 단일 변환이 아니라 변환의 가족입니다. 람다가 그중 어느 구성원을 쓰는지 결정하며, 로그 변환은 lambda = 0의 특수한 경우일 뿐입니다. 대부분의 분석가는 별 생각 없이 기본으로 로그를 사용합니다. Box-Cox는 그 선택을 명시적으로 만들고, 다른 람다 값이 실제로 모델에 더 도움이 되는지 원칙적으로 질문할 수 있게 해 줍니다.
다음과 같은 구체적 이슈를 진단할 때 사용하세요: 잔차의 이분산성, 비선형성, 명백히 충족되지 않는 가정. 모든 반응 변수에 자동으로 적용하는 습관은 버릴 가치가 있습니다. 그리고 데이터에 0이나 음수가 있다면, 그건 Box-Cox의 영역이 아닙니다. Yeo-Johnson의 영역입니다.
Box-Cox가 보통 지원하는 회귀 기법을 더 깊이 익히고 싶다면, Intermediate Regression in R 강의와 Introduction to Regression with statsmodels in Python가 좋은 다음 단계입니다.
DataCamp로 학습하세요
{count, plural, one {강의} other {강의}}
{count, plural, one {강의} other {강의}}
{count, plural, one {강의} other {강의}}