
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}
Введение в визуализацию данных с помощью Seaborn
{hours} ч
184.9K
Вы строите модель линейной регрессии для цен на жильё. График остатков выглядит как мегафон (узкий слева, сильно расширяется справа). Модель технически работает. Просто результатам нельзя доверять. Такой рисунок — это гетероскедастичность, одно из тех нарушений, которое тихо обесценивает ваши выводы, не выдавая при этом явной ошибки.
Один из вариантов — преобразовать отклик. И вместо того чтобы гадать, пробовать ли логарифм, квадратный корень или обратную величину, можно позволить данным подсказать верный вариант. В этом и состоит идея преобразования Бокса—Кокса. Здесь мы разберём формулу, как выбирать лямбда, и как реализовать это в Python и R.
Преобразование Бокса—Кокса — это семейство степенных преобразований для строго положительных данных. Вместо того чтобы выбирать конкретное преобразование вручную, вы получаете способ искать по целому диапазону преобразований, каждое из которых задаётся параметром лямбда (λ).
Когда лямбда равна 0 — это логарифм. Когда равна 0.5 — что-то близкое к квадратному корню. Когда равна -1 — почти обратная величина. Все они — частные случаи одной и той же формулы, так что вам не нужно заранее выбирать между ними. Вы оцениваете по данным, что подходит лучше.
Важное уточнение с самого начала: Бокс—Кокс не просто «делает данные нормальными». В зависимости от задачи он может помочь стабилизировать дисперсию, улучшить линейность между предикторами и откликом или лучше удовлетворить предпосылкам модели. Он также требует строго положительных входных значений. Нули и отрицательные значения недопустимы. Подробнее — в разделе ограничений.
Прежде чем перейти к формуле, нарастим интуицию. Допустим, у вас есть переменная вроде еженедельной выручки, и она правосторонне асимметрична: длинный хвост вправо, дисперсия растёт вместе со средним. Вопрос в том, какая степень этой переменной ведёт себя как более «послушный» отклик.
Разные значения лямбда соответствуют знакомым преобразованиям:
Стандартная формулировка Бокса—Кокса включает соглашения о масштабировании и сдвиге, поэтому это скорее понятные аналоги, а не буквально идентичные формулы. Случай логарифма (lambda = 0) рассматривается как предел. Формула переходит к log(x) из соображений непрерывности, а не как произвольное исключение.
Стандартная кусочная формула такова:
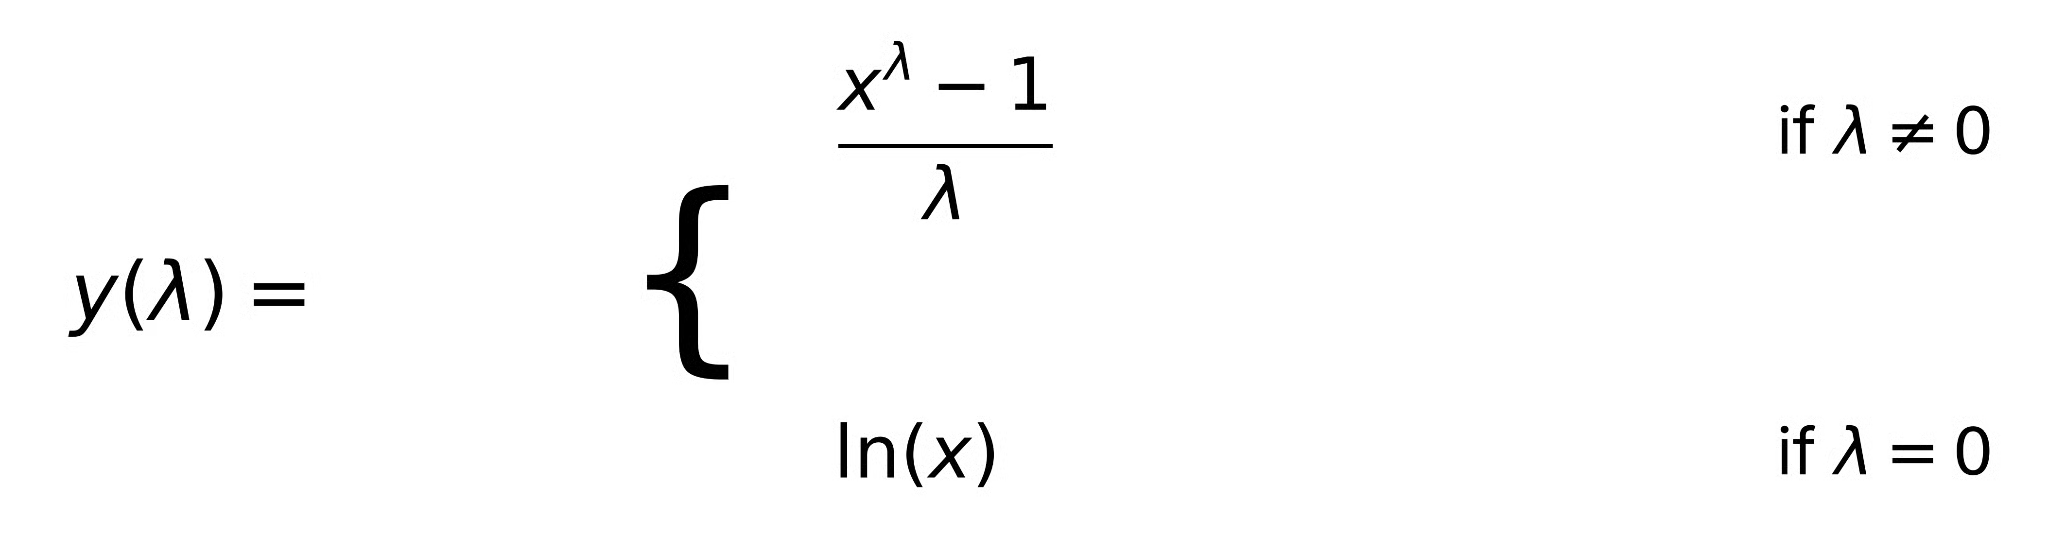
Здесь x — положительное значение, которое преобразуется, а лямбда — параметр преобразования. Вид (xλ - 1) / λ поначалу может показаться непривычным. Это соглашение о масштабировании, которое сохраняет непрерывность преобразования при стремлении лямбда к нулю. Без него была бы разрывная точка при lambda = 0, и логарифмический случай оказался бы полностью оторван от остального семейства. С ним формула плавно переходит в ln(x) при lambda → 0.
Не беспокойтесь сейчас о выводе. Практически: выбираете или оцениваете лямбда, подставляете положительные значения и работаете с преобразованным результатом.
Лямбда не задаётся «на глаз». Её оценивают по данным. В этом отличие Бокса—Кокса от догадки «попробуем логарифм». Под этим есть строгая статистическая процедура.
Идея — найти лямбда, при которой ваши данные лучше всего соответствуют предполагаемой модели. В регрессии это означает найти лямбда, при которой преобразованный отклик максимально удовлетворяет предпосылкам модели — обычно нормальности и постоянной дисперсии остатков. Вы выбираете не ту лямбда, при которой предельное распределение отклика «на глаз» выглядит самым нормальным. Вы выбираете ту, что лучше работает в контексте модели. Эта разница важна, мы вернёмся к ней в разделе ошибок.
Один из самых полезных диагностик — график профильного правдоподобия: значения лямбда по оси x, логарифм правдоподобия — по оси y. Пик укажет оценённое оптимальное лямбда. Не менее полезен доверительный интервал вокруг пика, обычно показанный горизонтальной линией на уровне ниже максимума. Любая лямбда внутри интервала статистически неотличима от оптимума.
Практический момент, который часто недооценивают. Если оптимальная лямбда около 0.43, а lambda = 0.5 попадает в доверительный интервал, берите 0.5. Преобразование квадратным корнем легче объяснить, проще обратить и почти не уступает по качеству. То же справедливо для 0 (логарифм) и 1 (без преобразования). Интерпретируемость важна, особенно когда вы объясняете модель тем, кто не знает, что такое лямбда = 0.43.
Теперь, когда понятно, что такое лямбда и как её выбирать, перейдём к практике. Сначала Python, затем R.
Модуль stats в SciPy умеет делать это напрямую. Функция boxcox() одновременно оценивает лямбда и возвращает преобразованные значения. Вот минимальный пример с имитацией правосторонне скошенных данных:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Здесь estimated_lambda — это значение, максимизирующее лог-правдоподобие при предположении нормальности. Это же значение вы используете при преобразовании новых данных для предсказаний.
Обратите внимание, что здесь лямбда оценивается по предельному распределению отклика, а не в рамках регрессионной модели. В рабочем процессе моделирования лямбда оценивают в контексте модели. Пример на R ниже показывает, как это делать с помощью функции boxcox() из MASS.
В R функция boxcox() из пакета MASS рассчитана на регрессионные сценарии. Она принимает обучённый объект модели и сразу строит график профильного правдоподобия — это естественнее, поскольку вы оцениваете лямбда в контексте модели, а не на отдельном векторе.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R-реализация boxcox() автоматически строит профиль правдоподобия, так что вы сразу видите визуализацию доверительного интервала. Это упрощает решение, можно ли округлить лямбда до более простого значения.
После преобразования отклика и подгонки модели ваши предсказания находятся в преобразованной шкале, а не в исходной. Прогноз 3.2 означает 3.2 единицы (xλ - 1) / λ, а не 3.2 единицы выручки.
Интерпретация коэффициентов меняется после преобразования. В преобразованной шкале увеличение предиктора на одну единицу соответствует определённому изменению y(λ), а не исходного y. Если лямбда близка к 0 (около логарифма), можно аппроксимировать процентные изменения в исходной шкале. Для других значений лямбда связь сложнее и зависит от текущего уровня x.
Чтобы вернуть предсказания в исходную шкалу, примените обратное преобразование:
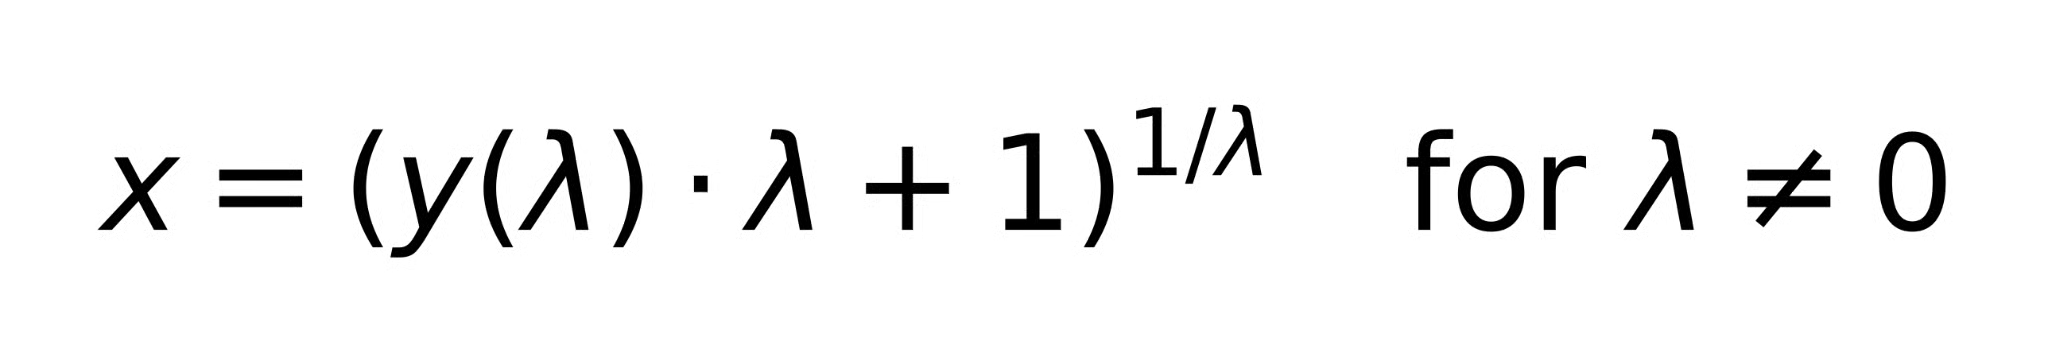
Для lambda = 0 обратное к ln(x) — просто exp(y).
Обратное преобразование предсказанного среднего в преобразованной шкале не даёт несмещённой оценки среднего в исходной шкале. Это известное следствие неравенства Йенсена, и особенно важно, например, при прогнозировании средних значений в лог-линейных моделях. Глубоко обсуждать корректировку смещения мы здесь не будем. Наш курс Introduction to Regression in Python шире охватывает предсказание и интерпретацию в регрессионных моделях, если вам нужен контекст.
Когда стоит выбирать Бокса—Кокса, а когда — знакомые альтернативы?
Логарифмическое преобразование — это случай lambda = 0 в семействе Бокса—Кокса. Точка. Если вы раньше применяли логарифм, вы использовали частный случай Бокса—Кокса с фиксированной, а не оценённой лямбда. Преимущество Бокса—Кокса в том, что он не фиксирует lambda = 0 заранее. Тем не менее, если пик профильного правдоподобия находится прямо при lambda = 0, используйте логарифм. Нет смысла усложнять.
Преобразование Йео—Джонсона — прямое продолжение Бокса—Кокса для обработки нулевых и отрицательных значений. К нему стоит прибегать, когда в данных есть нули (например, счётчики) или отрицательные значения. Преобразования математически похожи. Йео—Джонсон просто снимает ограничение на положительность. В scikit-learn PowerTransformer поддерживает оба варианта, method='box-cox' и method='yeo-johnson', так что переключаться легко.
Стандартизация (z-оценивание) сдвигает и масштабирует данные: делает среднее 0 и стандартное отклонение 1. Бокс—Кокс меняет форму распределения через нелинейное преобразование. Они решают разные задачи. Стандартизация не уменьшает асимметрию и не стабилизирует дисперсию. Бокс—Кокс не центрирует данные и не делает признаки сопоставимыми по масштабу. Можно делать оба шага по порядку — сначала преобразование, затем стандартизацию, — но это не взаимозаменяемые методы.
Многие из них с очевидностью задним числом. Но это не мешает им случаться, и некоторые достаточно тонкие, чтобы «очевидность» тут звучала натянуто.
Формула ломается при значениях ≤ 0. 0λ равно 0 для положительных лямбда и не определено для отрицательных; log(0) — минус бесконечность. Если в данных есть нули или отрицательные значения, Бокс—Кокс либо выдаст ошибку, либо молча породит бессмыслицу. Используйте Йео—Джонсона или добавьте небольшой положительный сдвиг. Второе — приблизительный приём, к которому стоит относиться скептически.
Бокс—Кокс следует применять в ответ на конкретную проблему моделирования: непостоянную дисперсию, слабую линейность, нарушенные предпосылки для остатков. Использовать его как автоматический препроцессинг, чтобы сделать предельное распределение «похожим на нормальное» перед любой моделью, — наоборот. Лямбда, которая нормализует отклик «сама по себе», может не быть той, что улучшает остатки модели.
Оценка лямбда — лишь половина дела. После преобразования и повторной подгонки снова проверьте графики остатков. Бокс—Кокс не гарантирует соблюдение предпосылок. Он даёт вам шанс на успех. Если остатки всё ещё «веером» или есть кривизна, причина в другом.
После преобразования коэффициенты больше не описывают связи в исходной шкале. Чаще всего это мешает при отчётности или прогнозировании. На каждом шаге отслеживайте, в какой шкале вы работаете.
Лямбда, оценённая по одномерному распределению (просто по гистограмме отклика), может отличаться от лямбда, оценённой в регрессионной модели. Верный подход — регрессионный. Цель — соблюдение предпосылок для остатков, а не требований к предельному распределению.
Если вы разворачиваете модель, обученную на преобразованных данных, нужно преобразовывать новые входы тем же способом с той же лямбда и затем обратно преобразовывать предсказания. Пропуск любого шага даст предсказания в неверной шкале. Звучит очевидно, но об этом регулярно забывают.
Бокс—Кокс — это семейство преобразований, а не одно единственное. Лямбда определяет, какой именно член семейства вы используете, а логарифм — всего лишь частный случай при lambda = 0. Большинство аналитиков по умолчанию берут логарифм, не задумываясь. Бокс—Кокс делает этот выбор явным и даёт обоснованный способ проверить, не послужит ли модели лучше иное значение лямбда.
Применяйте его, когда диагностируете что-то конкретное: гетероскедастичность остатков, нелинейность, явные нарушения предпосылок. Автоматически применять его ко всем переменным-откликам — привычка, от которой стоит отказаться. А если в данных есть нули или отрицательные значения — это уже не территория Бокса—Кокса, а Йео—Джонсона.
Чтобы глубже разобраться в методах регрессии, которые обычно поддерживает Бокс—Кокс, подойдут наш курс Intermediate Regression in R и Introduction to Regression with statsmodels in Python.
Учитесь с DataCamp
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}