{count, plural, one {Kursus} other {Kursus}}
Pengantar Visualisasi Data dengan Seaborn
{hours} jam
184.9K
Anda sedang membangun model regresi linear untuk harga rumah. Plot residual terlihat seperti megafon (sempit di kiri, melebar di kanan). Modelnya memang berjalan. Hanya saja hasilnya tidak andal. Pola itu adalah heteroskedastisitas, salah satu pelanggaran yang diam-diam membatalkan inferensi Anda tanpa menimbulkan galat yang jelas.
Salah satu opsi adalah mentransformasi variabel respons. Dan alih-alih menebak apakah perlu mencoba log, akar kuadrat, atau resiprokal, Anda bisa membiarkan data menyarankan yang tepat. Itulah gagasan di balik transformasi Box-Cox, dan itu yang akan kita bahas di sini: rumusnya, cara memilih lambda, dan cara mengimplementasikannya di Python dan R.
Transformasi Box-Cox adalah keluarga transformasi pangkat untuk data yang benar-benar positif. Alih-alih memilih transformasi tertentu sendiri, ini memberi Anda cara untuk menelusuri seluruh rentangnya, masing-masing diindeks oleh parameter bernama lambda (λ).
Ketika lambda sama dengan 0, Anda mendapatkan transformasi log. Ketika sama dengan 0,5, Anda mendapatkan sesuatu yang mendekati akar kuadrat. Ketika sama dengan -1, Anda berada di sekitar resiprokal. Semuanya adalah kasus khusus dari rumus yang sama, yang berarti Anda tidak harus memilih di antaranya sejak awal. Anda mengestimasi mana yang paling cocok dari data.
Satu hal yang perlu diperjelas sejak awal: Box-Cox tidak sekadar "membuat data menjadi normal." Bergantung pada masalah pemodelan Anda, ini dapat membantu menstabilkan varians, meningkatkan linearitas antara prediktor dan respons, atau lebih memenuhi asumsi model Anda. Ini juga memerlukan nilai masukan yang benar-benar positif. Nol dan negatif tidak diperbolehkan. Lebih lanjut di bagian keterbatasan.
Sebelum rumusnya, ada baiknya membangun intuisi. Misalkan Anda memiliki variabel seperti pendapatan penjualan mingguan dan condong ke kanan: ekor panjang ke kanan, varians meningkat seiring mean. Pertanyaannya adalah pangkat berapa dari variabel itu yang berperilaku lebih seperti respons yang baik.
Nilai lambda yang berbeda memetakan ke transformasi yang sudah Anda kenal:
Formulasi Box-Cox standar mencakup konvensi penskalaan dan translasi, jadi ini paling baik dipahami sebagai padanan yang familier, bukan rumus yang secara harfiah identik. Kasus log (lambda = 0) diperlakukan sebagai limit. Rumus beralih ke log(x) di sana karena argumen kontinuitas, bukan sebagai pengecualian sewenang-wenang.
Rumus potongan standar adalah:
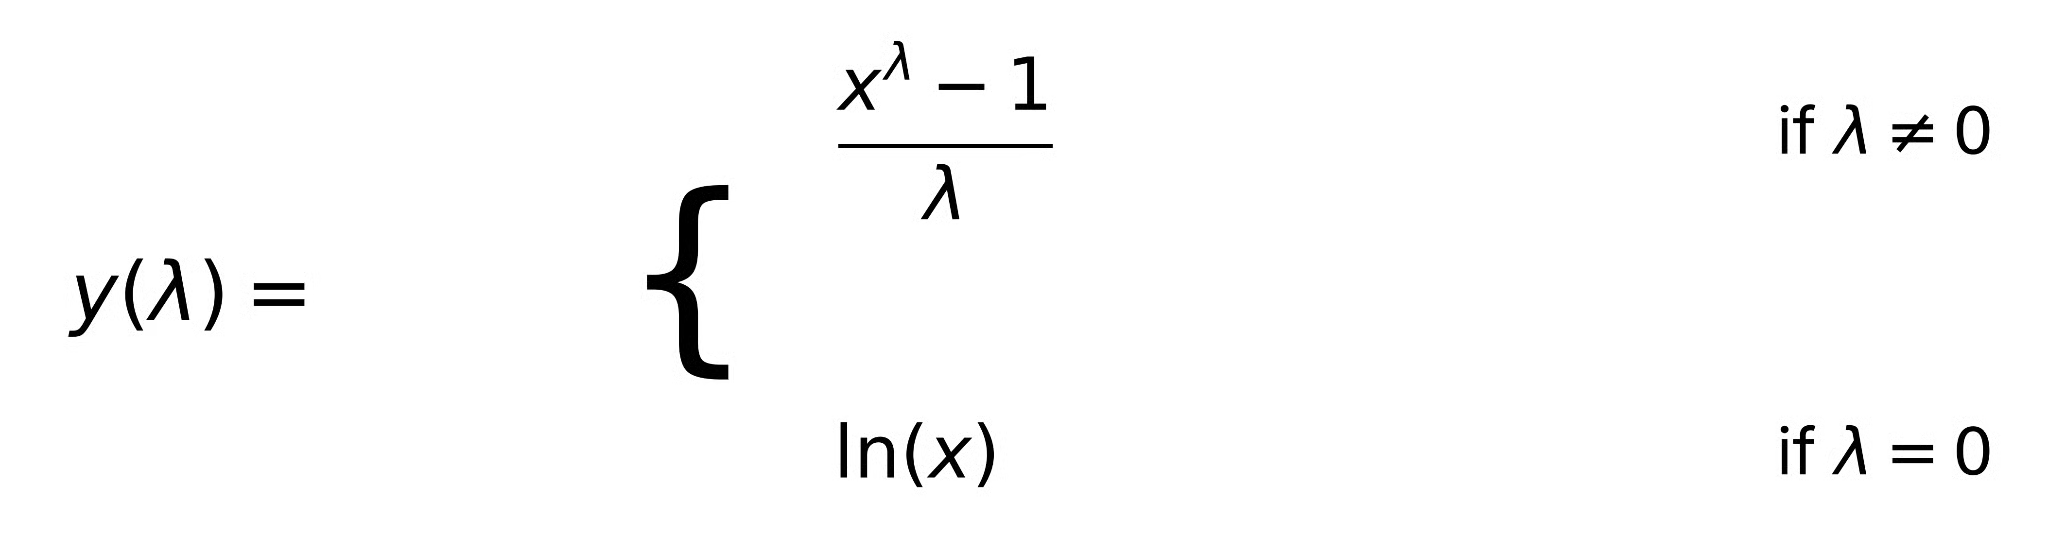
Di sini, x adalah nilai positif yang ditransformasi dan lambda adalah parameter transformasi. Bentuk (xλ - 1) / λ mungkin tampak asing pada awalnya. Itulah konvensi penskalaan yang menjaga transformasi tetap kontinu saat lambda mendekati nol. Tanpanya, Anda akan memiliki diskontinuitas loncatan pada lambda = 0 dan kasus log akan benar-benar terputus dari keluarga lainnya. Dengannya, rumus bertransisi mulus menjadi ln(x) saat lambda → 0.
Untuk saat ini, jangan khawatir tentang penurunannya. Secara operasional: pilih atau estimasi lambda, masukkan nilai-nilai positif Anda, dan bekerja dengan keluaran yang sudah ditransformasi.
Lambda bukan sesuatu yang Anda tetapkan secara manual berdasarkan intuisi. Anda mengestimasinya dari data. Inilah yang membedakan Box-Cox dari sekadar menebak "coba log." Ada prosedur statistik yang berprinsip di bawahnya.
Gagasannya adalah mencari lambda yang membuat data Anda paling cocok dengan model yang diasumsikan. Dalam konteks regresi, itu berarti mencari lambda di mana respons yang ditransformasi paling memenuhi asumsi model, biasanya kenormalan dan varians residual yang konstan. Anda tidak memilih lambda yang membuat distribusi marginal respons terlihat paling normal secara terpisah. Anda memilih yang paling cocok dalam konteks pemodelan. Pembedaan itu penting, dan akan kita bahas lagi di bagian kesalahan.
Salah satu diagnostik paling berguna di sini adalah plot profil likelihood: nilai lambda pada sumbu x, log-likelihood pada sumbu y. Puncaknya memberi tahu Anda estimasi lambda optimal. Sama bergunanya adalah interval kepercayaan di sekitar puncak itu, yang biasanya ditampilkan sebagai garis horizontal pada ambang di bawah maksimum. Setiap lambda di dalam interval itu tidak dapat dibedakan secara statistik dari yang optimum.
Berikut pertimbangan praktis yang sering diremehkan. Jika lambda optimal sekitar 0,43, dan lambda = 0,5 berada dalam interval kepercayaan, gunakan 0,5. Transformasi akar kuadrat lebih mudah dijelaskan, lebih mudah dibalik, dan hampir tidak kehilangan performa. Logika yang sama berlaku untuk 0 (log) dan 1 (tanpa transformasi). Keterjelasan interpretasi penting, terutama saat Anda menjelaskan model kepada seseorang yang tidak tahu apa arti lambda = 0,43.
Sekarang kita tahu apa itu lambda dan bagaimana ia dipilih, mari praktikkan. Python dulu, lalu R.
Modul stats di SciPy menangani ini secara langsung. Fungsi boxcox() sekaligus mengestimasi lambda dan mengembalikan nilai yang ditransformasi dalam satu panggilan. Berikut contoh minimal menggunakan data condong ke kanan yang disimulasikan:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Nilai estimated_lambda di sini memaksimalkan log-likelihood di bawah asumsi kenormalan. Anda kemudian akan menggunakan nilai yang sama saat mentransformasi data baru untuk prediksi.
Perhatikan bahwa ini mengestimasi lambda dari distribusi marginal respons, bukan dalam model regresi. Untuk alur kerja pemodelan, Anda akan mengevaluasi lambda dalam konteks model. Contoh R di bawah menunjukkan caranya menggunakan fungsi boxcox() dari MASS.
Di R, fungsi boxcox() dari paket MASS dibuat untuk alur kerja regresi. Fungsi ini menerima objek model yang telah dipasang dan memplot profil likelihood secara langsung, yang lebih alami karena Anda mengevaluasi lambda dalam konteks model alih-alih pada vektor mandiri.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
Fungsi boxcox() di R memplot profil likelihood secara otomatis, sehingga Anda mendapatkan visualisasi interval kepercayaan secara cuma-cuma. Ini memudahkan untuk memutuskan apakah akan membulatkan lambda ke nilai yang lebih sederhana.
Setelah Anda mentransformasi respons dan memasang model, prediksi Anda berada pada skala yang ditransformasi, bukan yang asli. Prediksi 3,2 berarti 3,2 satuan (xλ - 1) / λ, bukan 3,2 satuan pendapatan.
Interpretasi koefisien berubah setelah transformasi. Pada skala yang ditransformasi, peningkatan satu satuan pada prediktor berkaitan dengan perubahan tertentu pada y(λ), bukan pada y asli. Jika lambda mendekati 0 (mendekati log), Anda dapat mendekati perubahan persentase pada skala asli. Untuk nilai lambda lain, hubungan lebih rumit dan bergantung pada level x saat ini.
Untuk mengonversi prediksi kembali ke skala asli, terapkan inversnya:
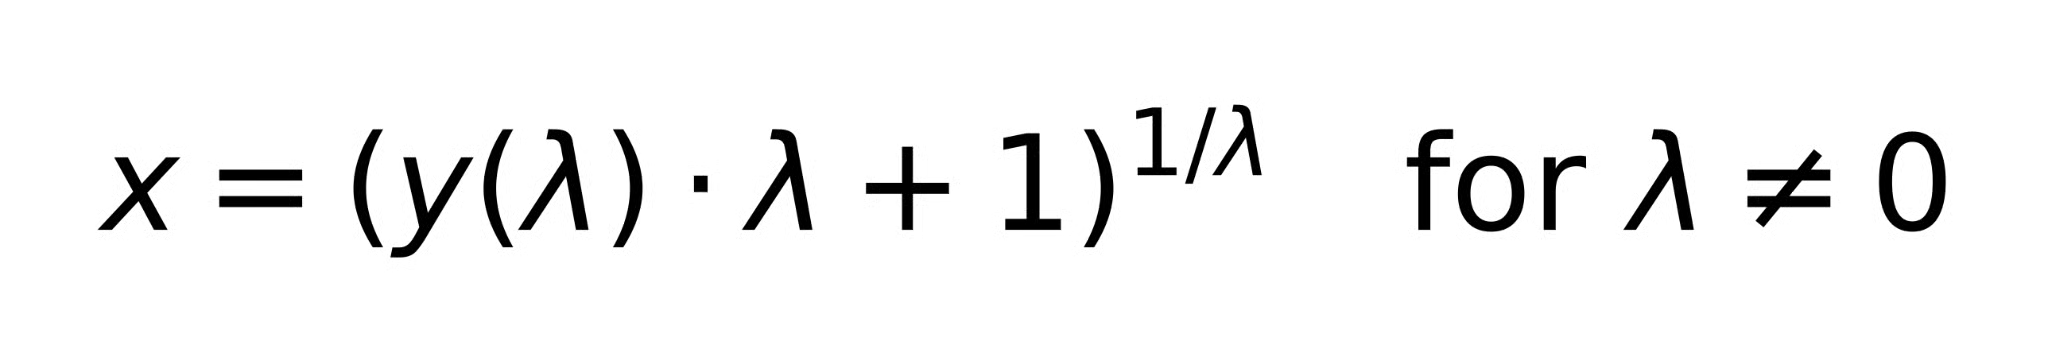
Untuk lambda = 0, invers dari ln(x) hanyalah exp(y).
Mengembalikan transformasi mean yang diprediksi pada skala yang ditransformasi tidak memberi Anda estimasi tak bias dari mean pada skala asli. Ini adalah konsekuensi yang dikenal dari ketaksamaan Jensen, dan paling penting dalam konteks seperti meramalkan nilai mean dalam model log-linear. Pembahasan mendalam tentang koreksi bias di luar cakupan kita di sini. Kursus Pengantar Regresi di Python kami membahas prediksi dan interpretasi dalam model regresi secara lebih luas jika Anda menginginkan konteks tersebut.
Kapan sebaiknya Anda memilih Box-Cox dibandingkan alternatif yang mungkin sudah Anda gunakan?
Transformasi log adalah kasus lambda = 0 dari Box-Cox. Titik. Jika Anda pernah menggunakan transformasi log, Anda telah menggunakan instance spesifik dari Box-Cox dengan lambda dipatok, bukan diestimasi. Keuntungan Box-Cox adalah tidak berkomitmen pada lambda = 0 sejak awal. Namun, jika profil likelihood Anda memuncak tepat di lambda = 0, gunakan log saja. Tidak ada alasan menambah kompleksitas.
Transformasi Yeo-Johnson adalah perpanjangan langsung dari Box-Cox yang dirancang untuk menangani nilai nol dan negatif. Inilah yang dipilih saat data Anda mencakup nol (misalnya hitungan) atau nilai negatif. Transformasinya serupa secara matematis. Yeo-Johnson hanya melonggarkan kendala positivitas. Dalam scikit-learn, PowerTransformer mendukung keduanya, method='box-cox' dan method='yeo-johnson', sehingga mudah untuk mencoba beralih.
Standardisasi (z-scoring) menggeser dan menskalakan data: mengubah mean menjadi 0 dan deviasi standar menjadi 1. Box-Cox mengubah bentuk distribusi melalui transformasi nonlinier. Keduanya memecahkan masalah yang berbeda. Standardisasi tidak mengurangi skewness atau menstabilkan varians. Box-Cox tidak memusatkan data Anda atau membuat fitur sebanding besarnya. Anda mungkin melakukan keduanya secara berurutan, mentransformasi terlebih dahulu lalu menstandardisasi, tetapi keduanya bukan alternatif.
Beberapa di antaranya jelas jika dipikirkan belakangan. Itu tidak mencegahnya terjadi, dan beberapa cukup halus sehingga "jelas" bekerja keras di sini.
Rumusnya rusak pada atau di bawah nol. 0λ adalah 0 untuk lambda positif dan tak terdefinisi untuk lambda negatif; log(0) adalah negatif tak berhingga. Jika data Anda memiliki nol atau negatif, Box-Cox akan menghasilkan galat atau diam-diam menghasilkan omong kosong. Gunakan Yeo-Johnson sebagai gantinya, atau tambahkan konstanta kecil sebagai pergeseran. Yang terakhir adalah pendekatan yang patut diperlakukan dengan skeptis.
Box-Cox harus diterapkan sebagai respons terhadap masalah pemodelan spesifik: varians tidak konstan, linearitas buruk, asumsi residual yang dilanggar. Menggunakannya sebagai langkah prapemrosesan otomatis untuk membuat distribusi marginal Anda "terlihat normal" sebelum memasang model apa pun adalah kebalikan. Lambda yang menormalkan respons Anda secara terpisah mungkin bukan lambda yang benar-benar memperbaiki residual model Anda.
Mengestimasi lambda hanyalah setengah pekerjaan. Setelah mentransformasi dan memasang ulang, periksa plot residual lagi. Box-Cox tidak menjamin asumsi terpenuhi. Ini memberi Anda peluang yang lebih baik. Jika residual masih menyebar kipas, atau ada kelengkungan, ada hal lain yang terjadi.
Setelah transformasi, koefisien tidak lagi menggambarkan hubungan pada skala asli. Ini sering menjebak orang saat melaporkan hasil atau membuat prediksi. Lacak skala mana yang Anda gunakan di setiap langkah.
Lambda yang diestimasi dari distribusi univariat (hanya melihat histogram variabel respons) dapat berbeda dari lambda yang diestimasi dalam model regresi. Pendekatan berbasis regresi adalah yang benar. Tujuannya adalah memenuhi asumsi residual, bukan asumsi distribusi marginal.
Saat Anda menerapkan model yang dilatih pada data yang ditransformasi, Anda harus mentransformasi masukan baru dengan cara yang sama menggunakan lambda yang sama dan kemudian mengembalikan transformasi prediksi. Melewatkan salah satu langkah memberi Anda prediksi pada skala yang salah. Ini terdengar jelas namun masih sering terlupakan.
Box-Cox adalah sebuah keluarga transformasi, bukan satu transformasi. Lambda menentukan anggota mana dari keluarga itu yang Anda dapatkan, dan transformasi log hanyalah kasus khusus lambda = 0. Kebanyakan analis menggunakan log secara default tanpa memikirkannya. Box-Cox membuat pilihan itu eksplisit dan memberi Anda cara berprinsip untuk menanyakan apakah nilai lambda yang berbeda sebenarnya lebih baik untuk model.
Gunakan saat Anda mendiagnosis sesuatu yang spesifik: heteroskedastisitas pada residual, non-linearitas, asumsi yang jelas tidak terpenuhi. Menerapkannya secara otomatis pada setiap variabel respons adalah kebiasaan yang perlu ditinggalkan. Dan jika data Anda memiliki nol atau negatif, itu bukan wilayah Box-Cox. Itu Yeo-Johnson.
Untuk landasan yang lebih mendalam dalam metode regresi yang biasanya didukung oleh Box-Cox, kursus Intermediate Regression in R dan Introduction to Regression with statsmodels in Python kami adalah langkah lanjutan yang baik.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt