{count, plural, one {Curso} other {Cursos}}
Introducción a la visualización de datos con Seaborn
{hours} h
184.9K
Estás construyendo un modelo de regresión lineal sobre precios de viviendas. El gráfico de residuales parece un megáfono (estrecho a la izquierda y cada vez más ancho a la derecha). El modelo se ejecuta, sí. El problema es que los resultados no son fiables. Ese patrón es heterocedasticidad, y es una de esas violaciones que invalidan tus inferencias sin lanzar un error evidente.
Una opción es transformar la variable respuesta. Y en lugar de adivinar si probar un logaritmo, una raíz cuadrada o un recíproco, puedes dejar que los datos sugieran cuál conviene. Esa es la idea detrás de la transformación Box-Cox, y es lo que veremos aquí: la fórmula, cómo elegir lambda y cómo implementarla en Python y R.
La transformación Box-Cox es una familia de transformaciones de potencia para datos estrictamente positivos. En lugar de que tú elijas una transformación concreta, te permite explorar toda una gama, cada una indexada por un parámetro llamado lambda (λ).
Cuando lambda es 0, obtienes una transformación logarítmica. Si es 0,5, es algo cercano a una raíz cuadrada. Si es -1, te aproximas a un recíproco. Todas son casos particulares de la misma fórmula, lo que significa que no tienes que elegir entre ellas por adelantado. Estimas cuál se ajusta mejor a partir de los datos.
Un matiz importante desde el principio: Box-Cox no "vuelve normales" los datos sin más. Según tu problema de modelado, puede ayudar a estabilizar la varianza, mejorar la linealidad entre predictores y respuesta o cumplir mejor los supuestos del modelo. Además, requiere valores de entrada estrictamente positivos. Ceros y negativos, descartados. Más sobre esto en la sección de limitaciones.
Antes de la fórmula, conviene construir algo de intuición. Imagina una variable como los ingresos semanales por ventas y que está sesgada a la derecha: una cola larga hacia la derecha y varianza que crece con la media. La pregunta es qué potencia de esa variable se comporta más como una respuesta bien portada.
Diferentes valores de lambda se corresponden con transformaciones que ya conoces:
La formulación estándar de Box-Cox incluye convenciones de escalado y traslación, así que conviene ver estos casos como equivalentes familiares y no como fórmulas literalmente idénticas. El caso log (lambda = 0) se trata como un límite. La fórmula cambia a log(x) ahí por continuidad, no como una excepción arbitraria.
La fórmula por tramos estándar es:
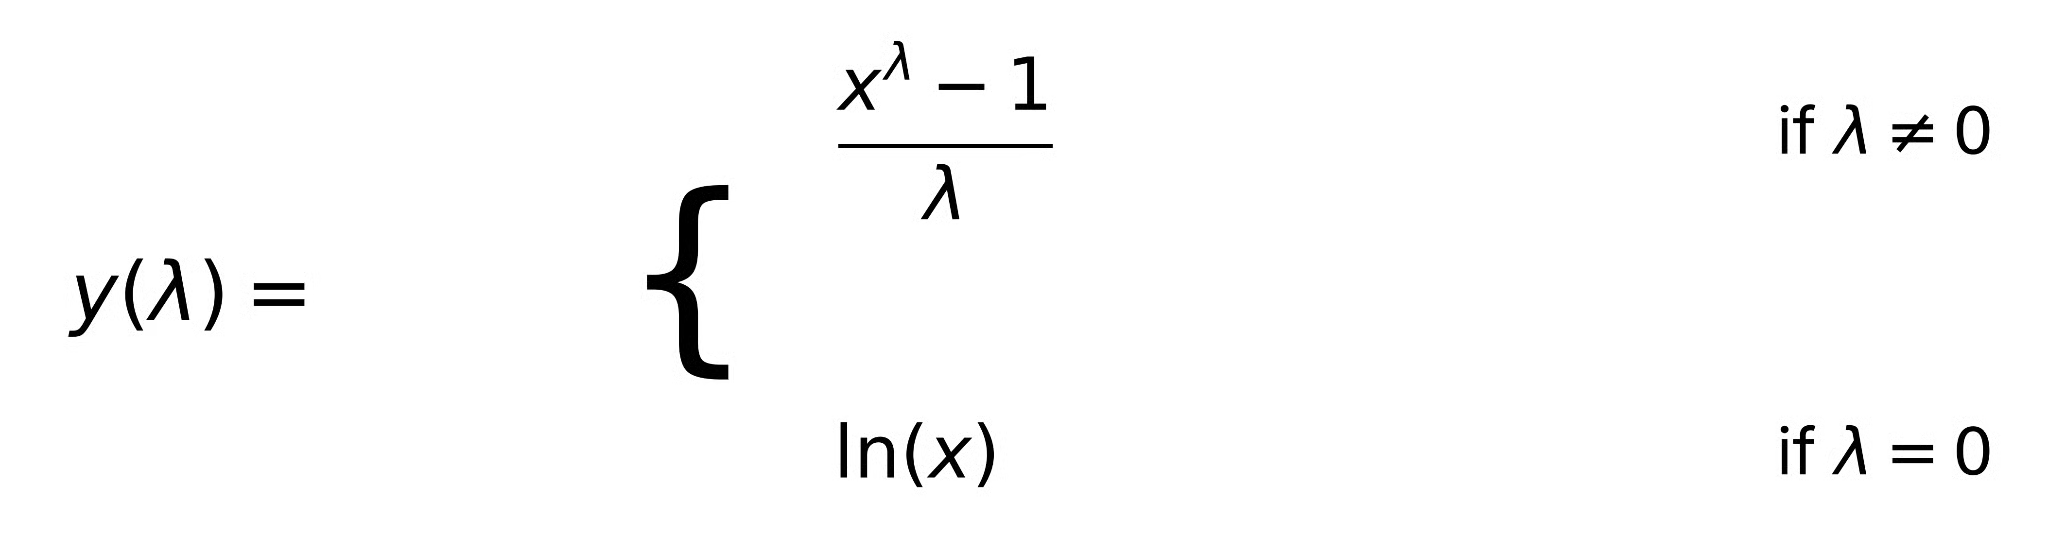
Aquí, x es el valor positivo que se transforma y lambda es el parámetro de transformación. La forma (xλ - 1) / λ puede parecerte extraña al principio. Es la convención de escalado que mantiene la transformación continua cuando lambda se aproxima a cero. Sin ella, habría una discontinuidad en lambda = 0 y el caso log quedaría desconectado del resto de la familia. Con ella, la fórmula pasa suavemente a ln(x) cuando lambda → 0.
No te preocupes ahora por la derivación. Operativamente: elige o estima lambda, introduce tus valores positivos y trabaja con la salida transformada.
Lambda no se ajusta a ojo por intuición. Se estima a partir de los datos. Esto es lo que diferencia Box-Cox de "probar un log" sin más. Hay un procedimiento estadístico con fundamento detrás.
La idea es encontrar el lambda que hace que tus datos se ajusten mejor al modelo supuesto. En regresión, significa hallar el lambda con el que la respuesta transformada satisface más de cerca los supuestos del modelo, típicamente normalidad y varianza constante de los residuales. No estás eligiendo el lambda que hace que la distribución marginal de la respuesta se vea más normal en aislamiento. Estás eligiendo el que mejor funciona en el contexto del modelado. Esa distinción importa, y volveremos a ella en la sección de errores comunes.
Uno de los diagnósticos más útiles aquí es el gráfico de verosimilitud perfilada: valores de lambda en el eje x y la log-verosimilitud en el eje y. El pico te indica el lambda óptimo estimado. Igualmente útil es el intervalo de confianza alrededor de ese pico, que suele mostrarse como una línea horizontal a un umbral por debajo del máximo. Cualquier lambda dentro de ese intervalo es estadísticamente indistinguible del óptimo.
Aquí va una recomendación práctica que a menudo se infravalora. Si el lambda óptimo es, por ejemplo, 0,43 y lambda = 0,5 cae dentro del intervalo de confianza, quédate con 0,5. Una transformación de raíz cuadrada es más fácil de explicar, más fácil de invertir y apenas pierde rendimiento. Lo mismo aplica para 0 (log) y 1 (sin transformación). La interpretabilidad importa, sobre todo cuando explicas tu modelo a alguien a quien "lambda = 0,43" no le dice nada.
Ahora que sabemos qué es lambda y cómo se selecciona, vamos a ponerlo en práctica. Primero en Python y luego en R.
El módulo stats de SciPy lo resuelve directamente. La función boxcox() estima lambda y devuelve los valores transformados en una sola llamada. Aquí tienes un ejemplo mínimo con datos simulados sesgados a la derecha:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
El estimated_lambda aquí es el que maximiza la log-verosimilitud bajo el supuesto de normalidad. Luego usarías este mismo valor al transformar nuevos datos para predicción.
Ten en cuenta que esto estima lambda a partir de la distribución marginal de la respuesta, no dentro de un modelo de regresión. En un flujo de modelado, evaluarías lambda en el contexto del modelo. El ejemplo en R de abajo muestra cómo hacerlo con boxcox() de MASS.
En R, la función boxcox() del paquete MASS está pensada para flujos de regresión. Recibe un objeto de modelo ajustado y dibuja directamente la verosimilitud perfilada, lo que encaja mejor porque evalúas lambda en el contexto de un modelo y no sobre un vector aislado.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
boxcox() en R traza automáticamente la verosimilitud perfilada, así que obtienes gratis la visualización del intervalo de confianza. Esto facilita decidir si redondear lambda a un valor más simple.
Una vez transformada la respuesta y ajustado el modelo, tus predicciones están en la escala transformada, no en la original. Una predicción de 3,2 significa 3,2 unidades de (xλ - 1) / λ, no 3,2 unidades de ingresos.
La interpretación de coeficientes cambia tras la transformación. En la escala transformada, un incremento de una unidad en un predictor corresponde a un cierto cambio en y(λ), no en la y original. Si lambda está cerca de 0 (casi log), puedes aproximar cambios porcentuales en la escala original. Para otros valores de lambda, la relación es más compleja y depende del nivel actual de x.
Para convertir las predicciones de vuelta a la escala original, aplica la inversa:
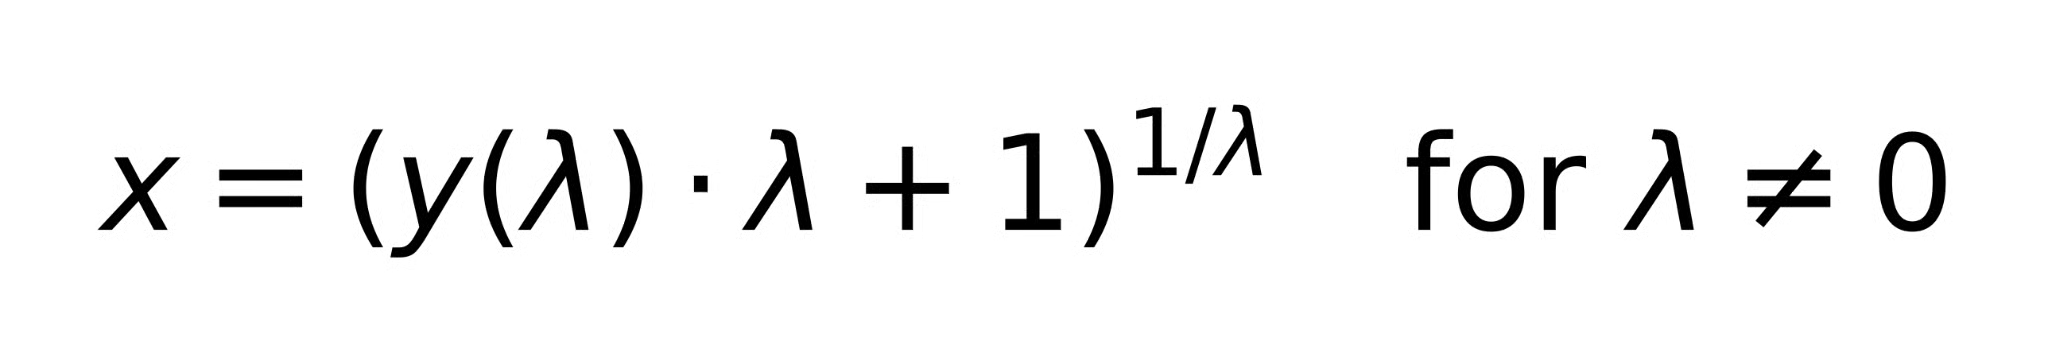
Para lambda = 0, la inversa de ln(x) es simplemente exp(y).
Volver a transformar la media predicha en la escala transformada no te da una estimación insesgada de la media en la escala original. Es una consecuencia conocida de la desigualdad de Jensen y es especialmente relevante al pronosticar medias en modelos log-lineales. Profundizar en la corrección del sesgo se escapa a nuestro alcance aquí. Nuestro curso Introduction to Regression in Python cubre la predicción y la interpretación en modelos de regresión con una visión más amplia si buscas ese contexto.
¿Cuándo deberías recurrir a Box-Cox frente a alternativas que quizá ya uses?
La transformación logarítmica es el caso lambda = 0 de Box-Cox. Punto. Si has usado logaritmos antes, has usado una instancia concreta de Box-Cox con lambda fijado en lugar de estimado. La ventaja de Box-Cox es que no se casa con lambda = 0 de antemano. Dicho esto, si tu verosimilitud perfilada tiene su pico claramente en lambda = 0, usa un logaritmo. No hay motivo para complicarlo.
La transformación Yeo-Johnson es una extensión directa de Box-Cox diseñada para manejar ceros y valores negativos. Es la opción adecuada cuando tus datos incluyen ceros (por ejemplo, recuentos) o negativos. Las transformaciones son matemáticamente similares. Yeo-Johnson simplemente relaja la restricción de positividad. En scikit-learn, PowerTransformer admite ambas, method='box-cox' y method='yeo-johnson', lo que facilita alternar y probar.
La estandarización (z-score) desplaza y escala los datos: cambia la media a 0 y la desviación estándar a 1. Box-Cox cambia la forma de la distribución mediante una transformación no lineal. Resuelven problemas distintos. La estandarización no reduce la asimetría ni estabiliza la varianza. Box-Cox no centra tus datos ni hace comparables las magnitudes de las variables. Puedes aplicar ambas en secuencia, transformando primero y estandarizando después, pero no son alternativas.
Algunas de estas cosas son obvias a posteriori. Eso no impide que ocurran, y varias son lo bastante sutiles como para que lo de "obvio" sea mucho decir.
La fórmula se rompe en cero o por debajo. 0λ es 0 para lambda positivo e indefinido para lambda negativo; log(0) es menos infinito. Si tus datos tienen ceros o negativos, Box-Cox dará error o producirá disparates silenciosamente. Usa Yeo-Johnson o añade un pequeño desplazamiento positivo. Esto último es una aproximación que conviene tratar con escepticismo.
Box-Cox debe aplicarse como respuesta a un problema de modelado concreto: varianza no constante, mala linealidad, supuestos de residuales incumplidos. Usarlo como un paso automático de preprocesado para que tu distribución marginal "parezca normal" antes de ajustar cualquier modelo es ir al revés. El lambda que normaliza tu respuesta en aislamiento puede no ser el que realmente mejora los residuales del modelo.
Estimar lambda es solo la mitad del trabajo. Después de transformar y re-ajustar, vuelve a revisar los gráficos de residuales. Box-Cox no garantiza que se cumplan los supuestos. Te da más opciones. Si los residuales siguen abriéndose en abanico o hay curvatura, pasa algo más.
Tras la transformación, los coeficientes ya no describen relaciones en la escala original. Esto suele confundir al informar resultados o al hacer predicciones. Ten claro en qué escala trabajas en cada paso.
El lambda estimado a partir de una distribución univariante (mirando solo el histograma de tu respuesta) puede diferir del estimado dentro de un modelo de regresión. El enfoque correcto es el basado en regresión. El objetivo es cumplir los supuestos de los residuales, no los de la distribución marginal.
Cuando despliegues un modelo entrenado con datos transformados, tienes que transformar las nuevas entradas del mismo modo con el mismo lambda y luego revertir las predicciones. Saltarte cualquiera de los pasos te deja predicciones en la escala equivocada. Suena obvio y, aun así, se olvida con frecuencia.
Box-Cox es una familia de transformaciones, no una sola. Lambda determina qué miembro de esa familia obtienes, y la transformación logarítmica es solo el caso especial lambda = 0. La mayoría usa el log por defecto sin pensarlo demasiado. Box-Cox hace explícita esa elección y te da una forma rigurosa de preguntar si otro valor de lambda serviría mejor al modelo.
Úsalo cuando estés diagnosticando algo concreto: heterocedasticidad en los residuales, no linealidad, supuestos que claramente no se cumplen. Aplicarlo automáticamente a toda variable respuesta es un hábito que conviene abandonar. Y si tus datos tienen ceros o negativos, eso no es terreno de Box-Cox. Es de Yeo-Johnson.
Para profundizar en los métodos de regresión que Box-Cox suele acompañar, nuestro curso Intermediate Regression in R y Introduction to Regression with statsmodels in Python son buenos siguientes pasos.
Aprende con DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Tutorial} other {Tutoriales}}
{count, plural, one {Tutorial} other {Tutoriales}}
Kurtis Pykes
8 min
{count, plural, one {Tutorial} other {Tutoriales}}
Josef Waples
8 min
{count, plural, one {Tutorial} other {Tutoriales}}
Arunn Thevapalan
10 min
{count, plural, one {Tutorial} other {Tutoriales}}
Kurtis Pykes
14 min
{count, plural, one {Tutorial} other {Tutoriales}}
Eladio Montero Porras
15 min