
{count, plural, other {课程}}
Seaborn 数据可视化入门
{hours} 小时
184.9K
您正在对房价建立线性回归模型。残差图看起来像个喇叭(左侧窄,右侧逐渐张开)。模型在技术上能跑通,但结果并不可靠。这个模式是异方差性,这是那种不会报明显错误,却会悄然使您的推断失效的违例。
一个选项是对响应变量做变换。而且与其猜测用对数、平方根还是倒数,不如让数据来建议合适的形式。这正是 Box-Cox 变换背后的理念,也是我们将在此介绍的内容:其公式、如何选择 lambda,以及如何在 Python 和 R 中实现。
Box-Cox 变换是一族针对严格正值数据的幂变换。它并非让您自己挑一个特定变换,而是提供一种在整个变换范围内搜索的方法,每一种由称为 lambda(λ)的参数索引。
当 lambda 等于 0 时,得到对数变换;等于 0.5 时,接近平方根;等于 -1 时,接近倒数。这些都是同一公式的特殊情形,这意味着您无需事先在它们之间做选择。您可以从数据中估计哪一种最合适。
先把一件事说明白:Box-Cox 并不会“让数据变正态”。根据您的建模问题,它可以帮助稳定方差、改善自变量与因变量之间的线性关系,或更好地满足模型假设。它也要求输入值必须严格为正,零和负数都不行。更多内容见“限制”部分。
在讲公式之前,先建立一点直觉。假设您有一个变量,比如每周销售收入,呈右偏:右侧长尾,方差随均值增长。问题是,这个变量的哪个幂更像一个“行为良好”的响应变量。
不同的 lambda 值对应您已熟悉的变换:
标准的 Box-Cox 形式包含缩放与平移约定,因此这些更应理解为熟悉的等价关系,而非逐字相同的公式。对数情况(lambda = 0)被视为极限。此处之所以切换为 log(x),是出于连续性的考虑,而非任意的特例。
标准的分段公式为:
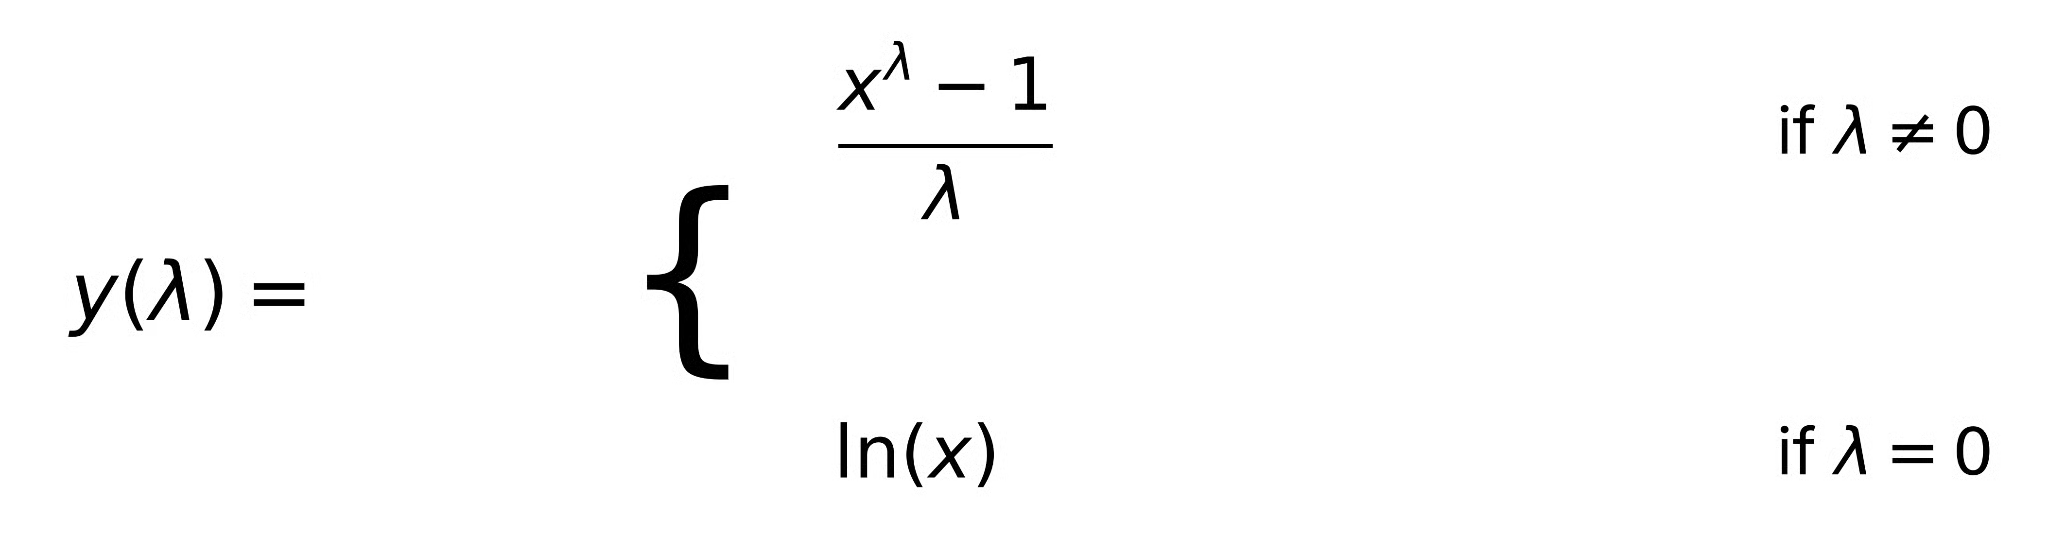
其中,x 是被变换的正值,lambda 是变换参数。(xλ - 1) / λ 的形式一开始看起来可能不熟悉。这是为了在 lambda 趋近于零时保持变换的连续性的缩放约定。没有它,lambda = 0 处会出现跳跃不连续,而对数情形将与其余族成员完全脱节。有了它,公式会在 lambda → 0 时平滑过渡到 ln(x)。
暂时不必关心推导。在操作层面:选取或估计 lambda,代入您的正值数据,并使用变换后的输出进行分析。
lambda 不是凭直觉手动设置的,而是从数据中估计。这正是 Box-Cox 与“试试对数吧”的盲猜不同之处。其背后有一套有依据的统计程序。
思路是找到能让数据最符合所假定模型的 lambda。在回归背景下,这意味着找到使变换后的响应尽可能满足模型假设(通常是残差正态性与方差恒定性)的 lambda。您并不是在挑使响应变量边际分布“看起来最正态”的 lambda,而是在建模语境中挑最合适的那个。这个区别很重要,我们会在“常见错误”部分再提。
这里最有用的诊断之一是轮廓似然图:x 轴是 lambda,y 轴是对数似然。峰值给出估计的最优 lambda。同样有用的是该峰值周围的置信区间,通常显示为低于最大值的某一阈值处的一条水平线。区间内的任意 lambda 在统计上与最优值无显著差异。
有个实用点常被低估:如果最优 lambda 是 0.43,而 0.5 落在置信区间内,那就用 0.5。平方根变换更易解释、更易反变换,性能几乎不损失。对 0(对数)和 1(不变换)同理。可解释性很重要,尤其当您需要向不了解 lambda = 0.43 意味着什么的人说明模型时。
既然我们知道了什么是 lambda 以及如何选择,接下来动手实践。先看 Python,再看 R。
SciPy 的 stats 模块可直接处理。boxcox() 函数一次调用即可同时估计 lambda 并返回变换后的值。下面用模拟的右偏数据做一个最小示例:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
这里的 estimated_lambda 是在正态性假设下使对数似然最大的值。随后您在对新数据进行预测时也应使用同一个值进行变换。
注意,这里是从响应变量的边际分布来估计 lambda,而不是在回归模型内。在建模流程中,您应在模型语境下评估 lambda。下面的 R 示例展示了如何使用 MASS 的 boxcox() 函数来实现。
在 R 中,MASS 包的 boxcox() 函数专为回归流程设计。它接受一个已拟合的模型对象并直接绘制轮廓似然,更贴合于在模型语境中而非仅对向量独立评估 lambda 的需求。
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R 的 boxcox() 会自动绘制轮廓似然,因此您可以直接看到置信区间,可据此更轻松地判断是否将 lambda 四舍五入为更简洁的值。
一旦您变换了响应并拟合了模型,预测就位于变换后的尺度,而非原始尺度。比如预测为 3.2,含义是 (xλ - 1) / λ 尺度上的 3.2,而不是收入的 3.2 个单位。
变换之后,系数的解读会改变。在变换尺度上,自变量增加一个单位对应的是 y(λ) 的某个变化,而不是原始 y。若 lambda 接近 0(近似对数),可以将其近似为原始尺度上的百分比变化。对于其他 lambda 值,关系更复杂,并取决于当前的 x 水平。
要将预测转回原始尺度,请应用反变换:
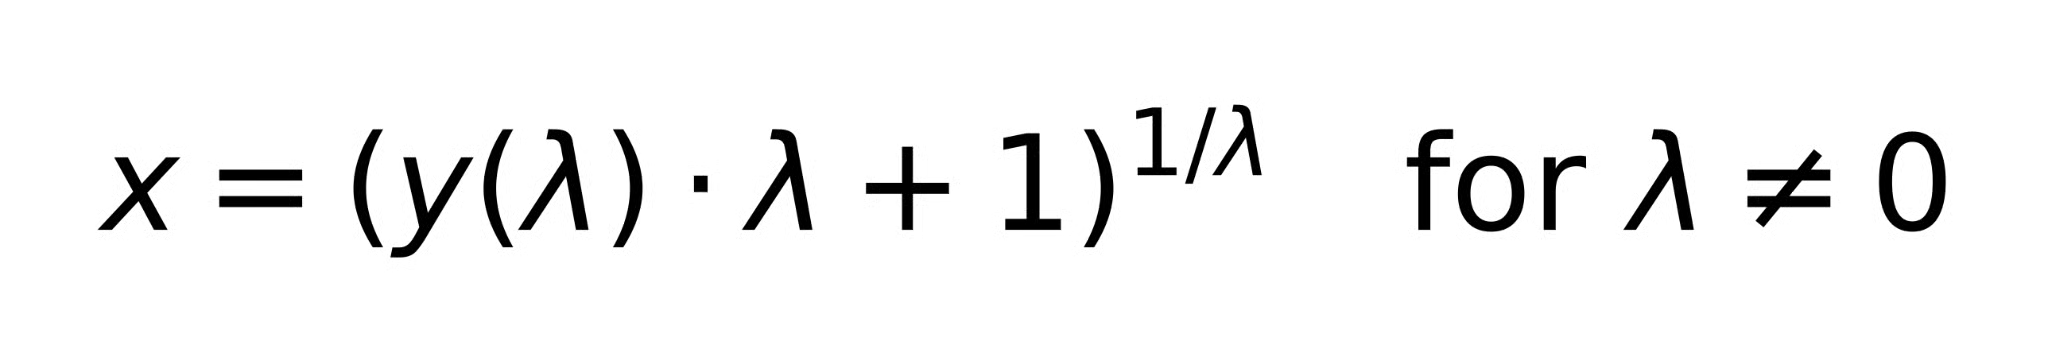
当 lambda = 0 时,ln(x) 的反函数就是 exp(y)。
将变换尺度上的预测均值反变换回原始尺度,并不能给出原始尺度均值的无偏估计。这是詹森不等式的已知后果,在如对数线性模型预测均值等场景中尤为重要。深入的偏差校正超出本文范围。若想了解更广泛的回归预测与解读,我们的Python 回归入门课程提供了更全面的背景。
何时该选 Box-Cox,而非您可能已经在用的替代方案?
对数变换就是 Box-Cox 的 lambda = 0 情况。就这样。如果您用过对数变换,您其实用过将 lambda 固定而非估计的 Box-Cox 特例。Box-Cox 的优势在于不预先固化在 lambda = 0。不过,如果您的轮廓似然峰值正好在 lambda = 0,那就直接用对数,不必增加复杂度。
Yeo-Johnson 变换是 Box-Cox 的直接扩展,旨在处理零和负值。当您的数据包含零(如计数)或负值时,应使用它。二者在数学上相似,Yeo-Johnson 只是放宽了正值约束。在 scikit-learn 中,PowerTransformer 同时支持 method='box-cox' 与 method='yeo-johnson',方便切换尝试。
标准化(z 评分)对数据做平移与缩放:将均值变为 0、标准差变为 1。Box-Cox 则通过非线性变换改变分布形状。二者解决的是不同问题。标准化不会降低偏度或稳定方差;Box-Cox 不会对数据居中或让特征量级可比。您可以按顺序同时做:先变换,再标准化,但它们不是替代关系。
有些问题事后看显而易见。但它们仍频繁发生,其中一些足够微妙,“显而易见”这四个字就显得有点勉强了。
当值小于等于零时,公式会失效。对正的 lambda,0λ 等于 0;对负的 lambda 则未定义;log(0) 为负无穷。如果您的数据包含零或负数,Box-Cox 要么报错,要么悄悄生成无意义的结果。请改用 Yeo-Johnson,或加一个很小的正常数做平移。后者只是近似,需要谨慎对待。
应当针对具体的建模问题来应用 Box-Cox:非恒定方差、线性关系较差、残差假设被违背。把它当作自动预处理步骤,只为在拟合任何模型之前让边际分布“看起来更正态”,是本末倒置。能在孤立的响应上实现正态化的 lambda,未必是能真正改善模型残差的那个。
估计 lambda 只完成了一半。变换并重新拟合之后,请再次检查残差图。Box-Cox 并不保证假设一定满足,它只是给您一个更大的胜算。如果残差仍然呈扇形散开,或存在曲率,那就是别的问题了。
变换之后,系数不再描述原始尺度上的关系。这在报告结果或做预测时最易踩坑。请在每一步都明确自己所处的尺度。
基于单变量分布(只看响应变量直方图)估计的 lambda,可能与在回归模型中估计的不同。应以回归为基础的方法为准。目标是满足残差假设,而非边际分布假设。
当您部署一个在变换后数据上训练的模型时,必须用同一个 lambda 对新输入做相同的变换,并对预测做反变换。跳过任一步,都会让预测落在错误的尺度上。这听起来显而易见,但仍然经常被忘记。
Box-Cox 是一族变换,而非单一变换。lambda 决定了您得到的是这一族中的哪一个,而对数变换只是 lambda = 0 的特殊情形。大多数分析者默认用对数,而不加思考。Box-Cox 让这个选择显性化,并提供一种有依据的方法来判断,是否有不同的 lambda 值会更有利于模型。
请在诊断出具体问题时使用它:如残差的异方差性、非线性关系、明显不满足的假设。把它自动应用到每个响应变量,是该改掉的习惯。而如果您的数据包含零或负值,那就不是 Box-Cox 的适用范围了,而是 Yeo-Johnson。
想要更扎实地掌握 Box-Cox 常用于配合的回归方法,我们的R 中级回归课程与 Python 中使用 statsmodels 的回归入门是不错的下一步。
与 DataCamp 一起学习
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}