{count, plural, one {Curso} other {Cursos}}
Introdução à Visualização de Dados com o Seaborn
{hours} h
184.9K
Você está construindo um modelo de regressão linear para preços de imóveis. O gráfico de resíduos parece um megafone (estreito à esquerda, abrindo à direita). O modelo até roda. Os resultados é que não são confiáveis. Esse padrão é heterocedasticidade, uma violação que pode invalidar silenciosamente suas inferências sem acusar um erro evidente.
Uma opção é transformar a variável resposta. E, em vez de chutar se deve usar log, raiz quadrada ou recíproca, você pode deixar os dados sugerirem a melhor alternativa. Essa é a ideia por trás da transformação de Box-Cox — e é o que vamos ver aqui: a fórmula, como escolher o lambda e como implementar em Python e R.
A transformação de Box-Cox é uma família de transformações de potência para dados estritamente positivos. Em vez de você escolher uma transformação específica, ela permite buscar em todo um intervalo, indexado por um parâmetro chamado lambda (λ).
Quando lambda é 0, você obtém uma transformação logarítmica. Quando é 0,5, chega perto de uma raiz quadrada. Quando é -1, fica próximo de uma recíproca. Todas são casos especiais da mesma fórmula, o que significa que você não precisa escolher entre elas de antemão. Você estima, a partir dos dados, qual se ajusta melhor.
Um ponto importante logo de início: Box-Cox não serve apenas para “deixar os dados normais”. Dependendo do seu problema de modelagem, ela pode ajudar a estabilizar a variância, melhorar a linearidade entre preditores e resposta ou atender melhor às premissas do modelo. Também exige valores de entrada estritamente positivos. Zeros e negativos ficam de fora. Mais sobre isso na seção de limitações.
Antes da fórmula, vale construir uma intuição. Suponha que você tenha uma variável como receita semanal de vendas e ela seja assimétrica à direita: cauda longa à direita e variância que cresce com a média. A pergunta é: que potência dessa variável se comporta mais como uma resposta “bem-comportada”.
Diferentes valores de lambda correspondem a transformações que você já conhece:
A formulação padrão de Box-Cox inclui convenções de escala e translação, então é melhor entender esses casos como equivalentes familiares, e não fórmulas literalmente idênticas. O caso log (lambda = 0) é tratado como um limite. A fórmula muda para log(x) por uma questão de continuidade, e não por exceção arbitrária.
A fórmula por partes padrão é:
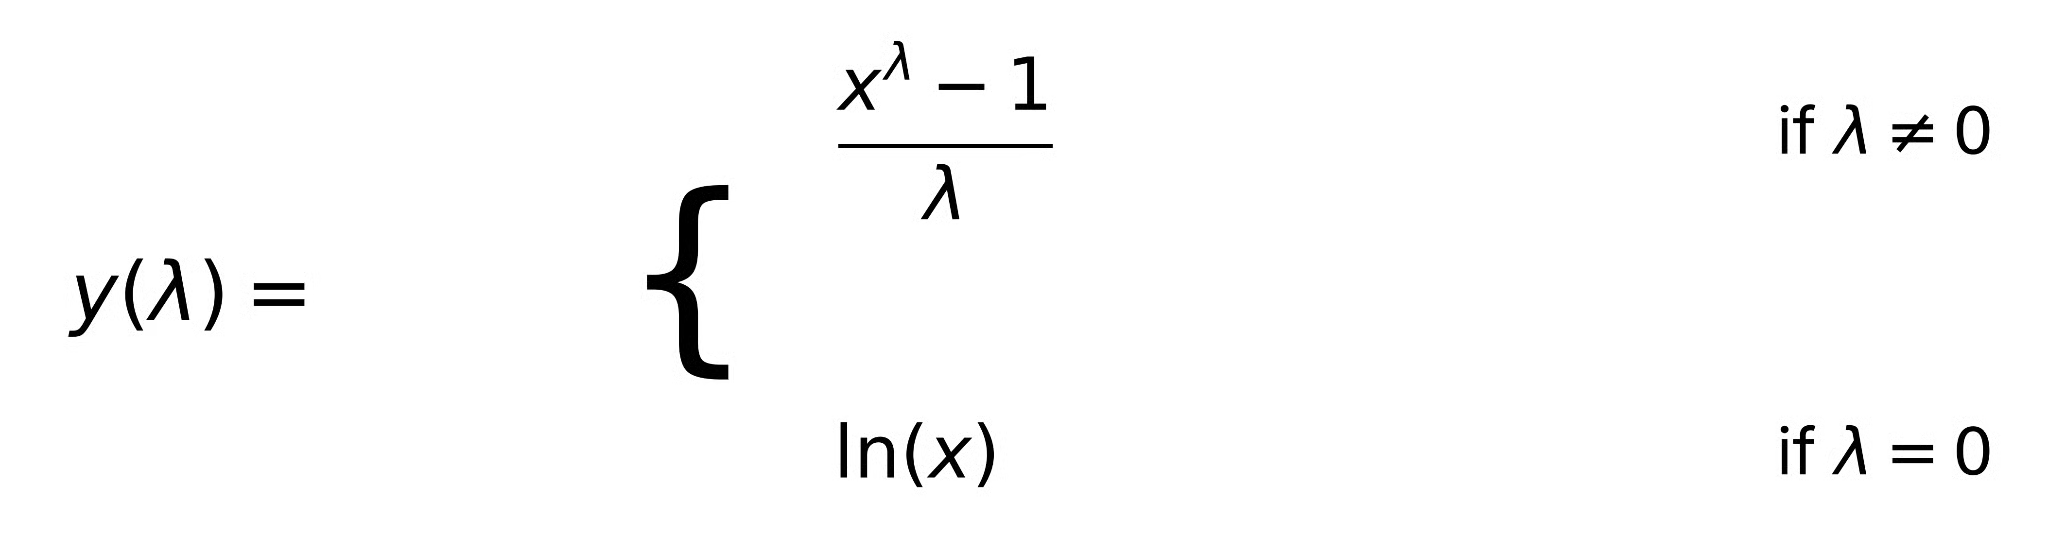
Aqui, x é o valor positivo a ser transformado e lambda é o parâmetro da transformação. A forma (xλ - 1) / λ pode parecer estranha à primeira vista. É a convenção de escala que mantém a transformação contínua quando lambda se aproxima de zero. Sem ela, haveria uma descontinuidade em lambda = 0 e o caso log ficaria desconectado do restante da família. Com ela, a fórmula transita suavemente para ln(x) quando lambda → 0.
Não se preocupe com a dedução agora. Na prática: você escolhe ou estima o lambda, aplica nos valores positivos e trabalha com a saída transformada.
Lambda não é algo que você define “no olho”. Você o estima a partir dos dados. É isso que diferencia Box-Cox de simplesmente “tentar um log”. Existe um procedimento estatístico bem fundamentado por trás.
A ideia é encontrar o lambda que faz seus dados se ajustarem melhor ao modelo assumido. Em regressão, isso significa achar o lambda em que a resposta transformada atende mais de perto às premissas do modelo, tipicamente normalidade e variância constante dos resíduos. Você não está escolhendo o lambda que deixa a distribuição marginal da resposta mais “normal” isoladamente. Está escolhendo o que funciona melhor no contexto do modelo. Essa distinção importa — e voltaremos a ela na seção de erros comuns.
Um dos diagnósticos mais úteis é o gráfico de verossimilhança perfilada: valores de lambda no eixo x e o log-verossimilhança no eixo y. O pico indica o lambda ótimo estimado. Igualmente útil é o intervalo de confiança ao redor desse pico, geralmente mostrado por uma linha horizontal em um limiar abaixo do máximo. Qualquer lambda dentro desse intervalo é estatisticamente indistinguível do ótimo.
Aqui vai uma dica prática que costuma ser subestimada. Se o lambda ótimo for algo como 0,43 e 0,5 estiver dentro do intervalo de confiança, fique com 0,5. A transformação de raiz quadrada é mais fácil de explicar, mais fácil de reverter e praticamente não perde desempenho. A mesma lógica vale para 0 (log) e 1 (sem transformação). Interpretabilidade conta, especialmente quando você precisa explicar seu modelo para quem não sabe o que é lambda = 0,43.
Agora que sabemos o que é lambda e como selecioná-lo, vamos à prática. Primeiro em Python, depois em R.
O módulo stats do SciPy resolve isso diretamente. A função boxcox() estima o lambda e retorna os valores transformados em uma única chamada. Veja um exemplo mínimo com dados simulados assimétricos à direita:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
O estimated_lambda aqui é o que maximiza a log-verossimilhança sob a suposição de normalidade. Você usaria esse mesmo valor ao transformar novos dados para previsão.
Note que isso estima o lambda a partir da distribuição marginal da resposta, não dentro de um modelo de regressão. Em um fluxo de modelagem, você avaliaria o lambda no contexto do modelo. O exemplo em R abaixo mostra como fazer isso usando o boxcox() do MASS.
Em R, a função boxcox() do pacote MASS é feita para fluxos de regressão. Ela recebe um objeto de modelo ajustado e plota diretamente a verossimilhança perfilada — o que faz mais sentido, já que você avalia o lambda no contexto de um modelo, e não em um vetor isolado.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
O boxcox() do R plota automaticamente a verossimilhança perfilada, então você ganha a visualização do intervalo de confiança de graça. Isso facilita decidir se vale arredondar o lambda para um valor mais simples.
Depois de transformar a resposta e ajustar o modelo, suas previsões estão na escala transformada, não na original. Uma previsão de 3,2 significa 3,2 unidades de (xλ - 1) / λ, não 3,2 unidades de receita.
A interpretação dos coeficientes muda após a transformação. Na escala transformada, um aumento de uma unidade em um preditor corresponde a uma certa variação em y(λ), e não no y original. Se lambda estiver próximo de 0 (quase log), você pode aproximar mudanças percentuais na escala original. Para outros valores de lambda, a relação é mais envolvida e depende do nível atual de x.
Para converter previsões de volta à escala original, aplique a inversa:
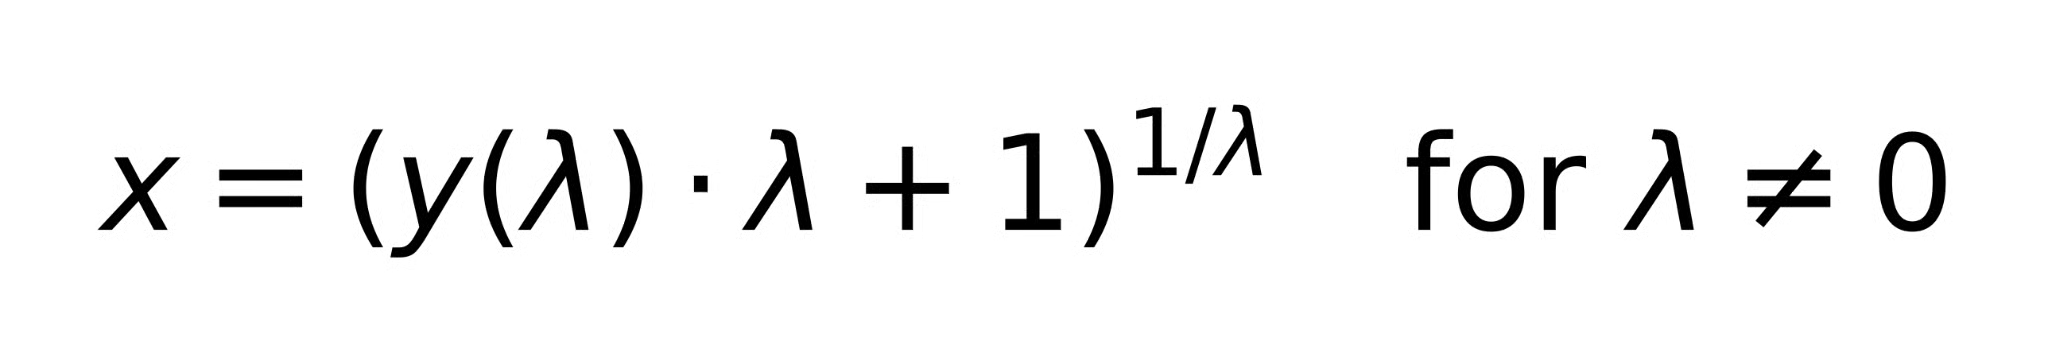
Para lambda = 0, a inversa de ln(x) é simplesmente exp(y).
Reverter a média prevista na escala transformada não produz uma estimativa não viesada da média na escala original. Esse é um efeito conhecido da desigualdade de Jensen, e pesa mais em cenários como previsão de médias em modelos log-lineares. Entrar a fundo em correção de viés foge do nosso escopo aqui. Nosso curso Introduction to Regression in Python aborda previsão e interpretação em modelos de regressão de forma mais ampla, se você quiser esse contexto.
Quando vale a pena usar Box-Cox em vez de alternativas que você já conhece?
A transformação log é o caso lambda = 0 de Box-Cox. Ponto. Se você já usou log antes, usou um caso específico de Box-Cox com lambda fixo em vez de estimado. A vantagem de Box-Cox é não se comprometer com lambda = 0 de saída. Dito isso, se a verossimilhança perfilada atinge o pico exatamente em lambda = 0, use log. Não há motivo para complicar.
A transformação de Yeo-Johnson é uma extensão direta de Box-Cox para lidar com zeros e valores negativos. É a indicada quando seus dados incluem zeros (contagens, por exemplo) ou negativos. As transformações são matematicamente semelhantes. Yeo-Johnson apenas relaxa a restrição de positividade. No scikit-learn, PowerTransformer suporta ambos, method='box-cox' e method='yeo-johnson', o que facilita testar uma ou outra.
Padronização (z-score) desloca e escala os dados: zera a média e define o desvio-padrão como 1. Box-Cox altera o formato da distribuição por uma transformação não linear. Elas resolvem problemas diferentes. Padronização não reduz assimetria nem estabiliza variância. Box-Cox não centraliza nem torna as variáveis comparáveis em magnitude. Você pode fazer ambas em sequência — primeiro transformar, depois padronizar —, mas elas não são alternativas entre si.
Algumas dessas questões parecem óbvias depois. Isso não impede que aconteçam — e algumas são sutis o suficiente para que “óbvio” seja um tanto otimista.
A fórmula quebra em zero ou abaixo dele. 0λ é 0 para lambda positivo e indefinido para lambda negativo; log(0) é menos infinito. Se seus dados têm zeros ou negativos, Box-Cox vai dar erro ou produzir bobagem silenciosamente. Use Yeo-Johnson ou adicione um pequeno constante positivo para deslocar os dados. Esta última é uma aproximação e deve ser usada com ceticismo.
Box-Cox deve ser aplicada em resposta a um problema específico de modelagem: variância não constante, baixa linearidade, premissas dos resíduos violadas. Usá-la como etapa automática de pré-processamento para deixar a distribuição marginal “com cara de normal” antes de ajustar qualquer modelo é o caminho inverso. O lambda que normaliza sua resposta isoladamente pode não ser o lambda que de fato melhora os resíduos do seu modelo.
Estimar o lambda é só metade do trabalho. Depois de transformar e reajustar, verifique os gráficos de resíduos novamente. Box-Cox não garante que as premissas serão atendidas. Ela aumenta suas chances. Se os resíduos ainda “abrem em leque” ou há curvatura, há outro problema em jogo.
Após a transformação, os coeficientes não descrevem mais relações na escala original. Isso costuma pegar muita gente na hora de reportar resultados ou fazer previsões. Mantenha o controle de em qual escala você está trabalhando em cada etapa.
O lambda estimado a partir de uma distribuição univariada (olhando só o histograma da variável resposta) pode diferir do lambda estimado dentro de um modelo de regressão. A abordagem baseada em regressão é a correta. O objetivo é satisfazer as premissas dos resíduos, não as suposições da distribuição marginal.
Ao colocar em produção um modelo treinado com dados transformados, você precisa transformar os novos dados da mesma forma, usando o mesmo lambda, e depois reverter as previsões. Pular qualquer uma das etapas gera previsões na escala errada. Parece óbvio, e ainda assim é esquecido com frequência.
Box-Cox é uma família de transformações, não uma só. O lambda define qual membro dessa família você usa, e a transformação log é apenas o caso especial lambda = 0. A maioria dos analistas usa log por padrão sem pensar muito. Box-Cox torna essa escolha explícita e oferece uma forma criteriosa de verificar se outro valor de lambda serviria melhor ao modelo.
Use quando estiver diagnosticando algo específico: heterocedasticidade nos resíduos, não linearidade, premissas claramente não atendidas. Aplicar automaticamente a toda variável resposta é um hábito a ser deixado de lado. E se seus dados têm zeros ou negativos, não é caso para Box-Cox — é para Yeo-Johnson.
Para se aprofundar nos métodos de regressão que Box-Cox costuma apoiar, nossos cursos Intermediate Regression in R e Introduction to Regression with statsmodels in Python são ótimos próximos passos.
Aprenda com a DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Tutorial} other {Tutoriais}}
Eladio Montero Porras
15 min
{count, plural, one {Tutorial} other {Tutoriais}}
Vidhi Chugh
14 min
{count, plural, one {Tutorial} other {Tutoriais}}
{count, plural, one {Tutorial} other {Tutoriais}}
DataCamp Team
10 min
{count, plural, one {Tutorial} other {Tutoriais}}
Abid Ali Awan
14 min
{count, plural, one {Tutorial} other {Tutoriais}}
Zoumana Keita
12 min