
{count, plural, one {Khóa học} other {Khóa học}}
Giới thiệu trực quan dữ liệu với Seaborn
{hours} giờ
184.9K
Bạn đang xây dựng một mô hình hồi quy tuyến tính cho giá nhà. Biểu đồ phần dư trông như một chiếc loa nén (hẹp bên trái, loe dần về bên phải). Về mặt kỹ thuật, mô hình vẫn chạy. Chỉ có điều kết quả không đáng tin. Mẫu hình đó là phương sai không đồng nhất (heteroscedasticity), và đó là một trong những vi phạm âm thầm làm vô hiệu suy luận của bạn mà không báo lỗi rõ ràng.
Một lựa chọn là biến đổi biến phản hồi. Và thay vì đoán xem nên thử log, căn bậc hai hay nghịch đảo, bạn có thể để dữ liệu gợi ý phương án phù hợp. Đó là ý tưởng đằng sau biến đổi Box-Cox, và cũng là nội dung chúng ta sẽ đề cập ở đây: công thức, cách chọn lambda, và cách triển khai trong Python và R.
Biến đổi Box-Cox là một họ biến đổi lũy thừa dành cho dữ liệu dương nghiêm ngặt. Thay vì tự bạn chọn một biến đổi cụ thể, nó cho phép tìm kiếm trên cả một dải biến đổi, mỗi biến đổi được đánh chỉ mục bởi một tham số gọi là lambda (λ).
Khi lambda bằng 0, bạn nhận được biến đổi log. Khi bằng 0,5, bạn có thứ gì đó gần với căn bậc hai. Khi bằng -1, bạn gần với nghịch đảo. Tất cả đều là các trường hợp đặc biệt của cùng một công thức, nghĩa là bạn không phải chọn trước giữa chúng. Bạn ước lượng xem cái nào phù hợp nhất từ dữ liệu.
Một điều cần làm rõ ngay từ đầu: Box-Cox không chỉ đơn giản là "làm dữ liệu trở nên chuẩn". Tùy bài toán mô hình, nó có thể giúp ổn định phương sai, cải thiện tính tuyến tính giữa biến dự báo và phản hồi, hoặc đáp ứng tốt hơn các giả định của mô hình. Nó cũng yêu cầu giá trị đầu vào dương nghiêm ngặt. Số 0 và số âm là không dùng được. Sẽ nói thêm ở phần hạn chế.
Trước khi đi vào công thức, hãy xây dựng trực giác. Giả sử bạn có một biến như doanh thu bán hàng hằng tuần và nó lệch phải: đuôi dài về bên phải, phương sai tăng theo trung bình. Câu hỏi là lũy thừa nào của biến đó sẽ hành xử giống một biến phản hồi "ngoan" hơn.
Các giá trị lambda khác nhau ánh xạ tới những biến đổi bạn đã biết:
Dạng Box-Cox chuẩn bao gồm các quy ước về tỉ lệ và tịnh tiến, nên tốt nhất hãy hiểu đây là các tương đương quen thuộc hơn là công thức hoàn toàn giống nhau. Trường hợp log (lambda = 0) được xử lý như một giới hạn. Khi đó công thức chuyển sang log(x) vì lý do liên tục, không phải ngoại lệ tùy tiện.
Công thức từng phần tiêu chuẩn là:
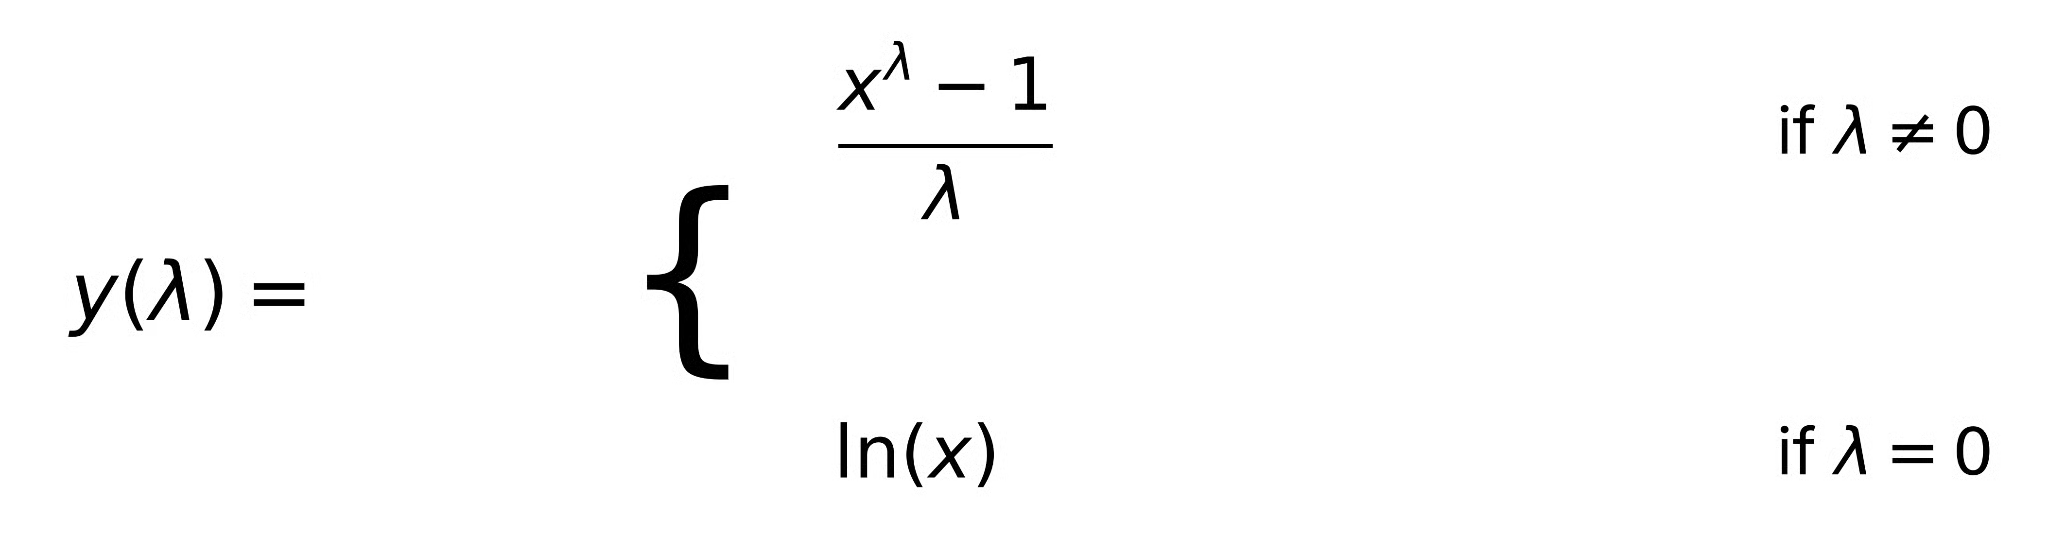
Ở đây, x là giá trị dương được biến đổi và lambda là tham số biến đổi. Dạng (xλ - 1) / λ có thể ban đầu trông lạ. Đó là quy ước tỉ lệ giúp phép biến đổi liên tục khi lambda tiến về 0. Nếu không có nó, bạn sẽ có một gián đoạn nhảy tại lambda = 0 và trường hợp log sẽ tách rời hoàn toàn khỏi phần còn lại. Nhờ vậy, công thức chuyển mượt mà sang ln(x) khi lambda → 0.
Chưa cần lo về phép suy dẫn. Về thao tác: chọn hoặc ước lượng lambda, thay các giá trị dương vào, và làm việc với đầu ra đã biến đổi.
Lambda không phải thứ bạn đặt thủ công theo trực giác. Bạn ước lượng nó từ dữ liệu. Đây là điểm phân biệt Box-Cox với việc đoán mò kiểu "thử log xem". Đằng sau là một thủ tục thống kê có cơ sở.
Ý tưởng là tìm lambda khiến dữ liệu của bạn phù hợp nhất với mô hình giả định. Trong ngữ cảnh hồi quy, nghĩa là tìm lambda tại đó phản hồi đã biến đổi thỏa mãn các giả định mô hình một cách sát nhất, thường là tính chuẩn và phương sai phần dư không đổi. Bạn không chọn lambda làm cho phân phối biên của phản hồi trông chuẩn nhất khi tách biệt. Bạn chọn cái hoạt động tốt nhất trong ngữ cảnh mô hình. Sự khác biệt này quan trọng, và chúng ta sẽ quay lại ở phần sai lầm thường gặp.
Một chẩn đoán hữu ích là biểu đồ hồ sơ hợp lý: các giá trị lambda trên trục hoành, log-likelihood trên trục tung. Đỉnh biểu đồ cho bạn lambda tối ưu ước lượng. Cũng hữu ích là khoảng tin cậy quanh đỉnh, thường hiển thị bằng một đường ngang tại ngưỡng dưới mức cực đại. Bất kỳ lambda nào trong khoảng đó đều không thể phân biệt về mặt thống kê so với tối ưu.
Đây là một cân nhắc thực tế thường bị xem nhẹ. Nếu lambda tối ưu khoảng 0,43, và lambda = 0,5 nằm trong khoảng tin cậy, hãy chọn 0,5. Biến đổi căn bậc hai dễ giải thích hơn, dễ biến đổi ngược hơn, và hầu như không mất mát hiệu năng. Logic tương tự áp dụng cho 0 (log) và 1 (không biến đổi). Tính dễ hiểu rất quan trọng, nhất là khi bạn giải thích mô hình cho người không biết lambda = 0,43 nghĩa là gì.
Giờ khi ta đã biết lambda là gì và cách chọn, hãy thực hành. Python trước, rồi đến R.
Mô-đun stats của SciPy xử lý trực tiếp việc này. Hàm boxcox() vừa ước lượng lambda vừa trả về các giá trị đã biến đổi trong một lần gọi. Đây là ví dụ tối giản dùng dữ liệu mô phỏng lệch phải:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
estimated_lambda ở đây là giá trị tối đa hóa log-likelihood dưới giả định phân phối chuẩn. Bạn sẽ dùng lại đúng giá trị này khi biến đổi dữ liệu mới để dự đoán.
Lưu ý rằng cách này ước lượng lambda từ phân phối biên của biến phản hồi, không phải trong một mô hình hồi quy. Với quy trình mô hình hóa, bạn nên đánh giá lambda trong ngữ cảnh mô hình. Ví dụ R bên dưới cho thấy cách làm bằng hàm boxcox() của MASS.
Trong R, hàm boxcox() của gói MASS được xây dựng cho quy trình hồi quy. Nó nhận một đối tượng mô hình đã fit và vẽ trực tiếp hồ sơ hợp lý, phù hợp hơn vì bạn đang đánh giá lambda trong bối cảnh một mô hình chứ không phải trên một vector độc lập.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
Hàm boxcox() của R tự động vẽ hồ sơ hợp lý, nên bạn có trực quan hóa khoảng tin cậy miễn phí. Điều đó giúp bạn dễ quyết định có nên làm tròn lambda về một giá trị đơn giản hơn không.
Khi bạn đã biến đổi biến phản hồi và fit mô hình, các dự đoán nằm trên thang đo đã biến đổi, không phải thang gốc. Một dự đoán 3,2 nghĩa là 3,2 đơn vị của (xλ - 1) / λ, không phải 3,2 đơn vị doanh thu.
Việc diễn giải hệ số thay đổi sau khi biến đổi. Trên thang đã biến đổi, tăng một đơn vị ở biến dự báo tương ứng với một mức thay đổi nào đó trong y(λ), không phải y gốc. Nếu lambda gần 0 (gần log), bạn có thể xấp xỉ phần trăm thay đổi trên thang gốc. Với các giá trị lambda khác, mối quan hệ phức tạp hơn và phụ thuộc vào mức hiện tại của x.
Để chuyển dự đoán về thang gốc, áp dụng phép đảo:
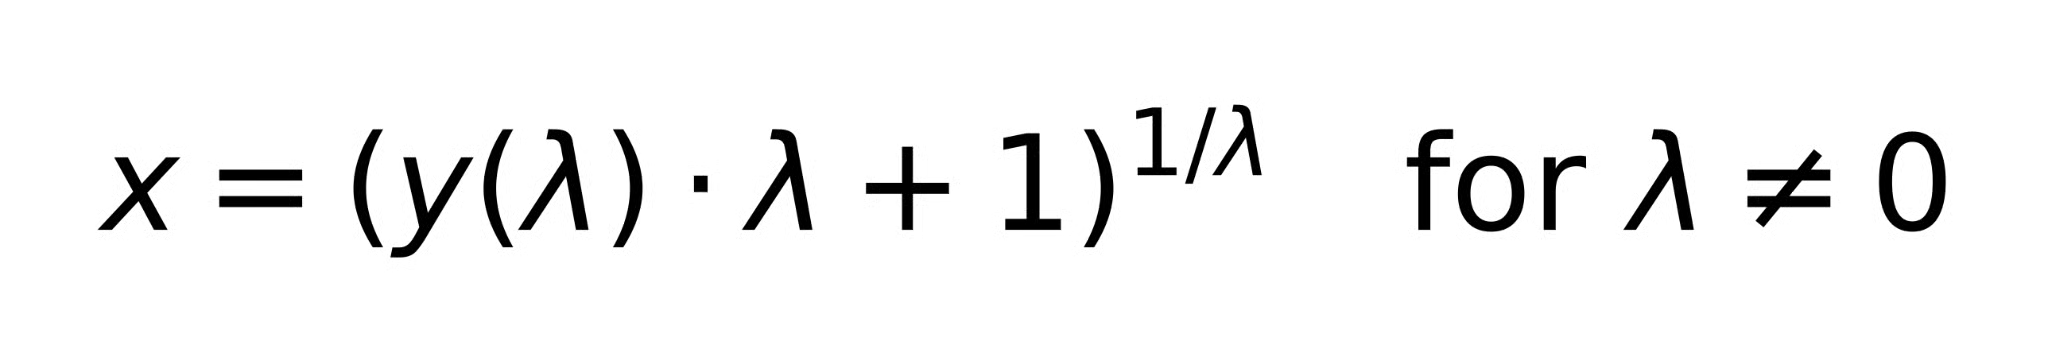
Với lambda = 0, nghịch đảo của ln(x) đơn giản là exp(y).
Biến đổi ngược giá trị trung bình dự đoán trên thang đã biến đổi không cho bạn ước lượng không chệch của trung bình trên thang gốc. Đây là hệ quả đã biết của bất đẳng thức Jensen, và quan trọng nhất trong các bối cảnh như dự báo giá trị trung bình trong mô hình log-tuyến tính. Đi sâu vào hiệu chỉnh sai lệch vượt ngoài phạm vi ở đây. Khóa học Introduction to Regression in Python của chúng tôi đề cập rộng hơn về dự đoán và diễn giải trong các mô hình hồi quy nếu bạn muốn có thêm ngữ cảnh.
Khi nào bạn thực sự nên dùng Box-Cox so với các phương án thay thế mà bạn có thể đã dùng?
Biến đổi log là trường hợp lambda = 0 của Box-Cox. Hết chuyện. Nếu bạn từng dùng log, bạn đã dùng một trường hợp cụ thể của Box-Cox với lambda được cố định thay vì ước lượng. Ưu điểm của Box-Cox là không chốt lambda = 0 ngay từ đầu. Tuy vậy, nếu hồ sơ hợp lý đạt đỉnh đúng ở lambda = 0, hãy dùng log. Không cần thêm phức tạp.
Biến đổi Yeo-Johnson là phần mở rộng trực tiếp của Box-Cox được thiết kế để xử lý số 0 và giá trị âm. Hãy dùng nó khi dữ liệu của bạn có số 0 (ví dụ dữ liệu đếm) hoặc giá trị âm. Các biến đổi này tương tự về mặt toán học. Yeo-Johnson chỉ nới lỏng ràng buộc dương tính. Trong scikit-learn, PowerTransformer hỗ trợ cả hai, method='box-cox' và method='yeo-johnson', giúp việc thử nghiệm chuyển đổi trở nên dễ dàng.
Chuẩn hóa (z-scoring) tịnh tiến và thay đổi tỉ lệ dữ liệu: đặt trung bình về 0 và độ lệch chuẩn về 1. Box-Cox thay đổi hình dạng phân phối thông qua biến đổi phi tuyến. Chúng giải quyết các vấn đề khác nhau. Chuẩn hóa không làm giảm độ lệch hay ổn định phương sai. Box-Cox không đưa dữ liệu về trung tâm hay làm các đặc trưng có độ lớn so sánh được. Bạn có thể làm cả hai tuần tự, biến đổi trước rồi chuẩn hóa, nhưng chúng không thay thế cho nhau.
Một số điều trở nên hiển nhiên khi nhìn lại. Điều đó không ngăn chúng xảy ra, và vài điều đủ tinh vi để từ "hiển nhiên" phải gánh nhiều ý nghĩa.
Công thức sụp đổ tại hoặc dưới 0. 0λ bằng 0 khi lambda dương và không xác định khi lambda âm; log(0) là âm vô cùng. Nếu dữ liệu có số 0 hoặc âm, Box-Cox sẽ hoặc báo lỗi hoặc âm thầm tạo ra vô nghĩa. Hãy dùng Yeo-Johnson, hoặc cộng một hằng số dương nhỏ để tịnh tiến dữ liệu trước khi biến đổi, dù cách sau chỉ là xấp xỉ và nên được xem xét thận trọng.
Box-Cox nên được áp dụng để phản hồi một vấn đề mô hình cụ thể: phương sai không hằng, tuyến tính kém, giả định phần dư bị vi phạm. Dùng nó như một bước tiền xử lý tự động để khiến phân phối biên "trông chuẩn" trước khi fit bất kỳ mô hình nào là làm ngược. Lambda giúp chuẩn hóa phản hồi khi xét riêng lẻ có thể không phải lambda thực sự cải thiện phần dư của mô hình.
Ước lượng lambda chỉ là nửa công việc. Sau khi biến đổi và fit lại, hãy kiểm tra lại các biểu đồ phần dư. Box-Cox không đảm bảo các giả định được thỏa mãn. Nó chỉ cho bạn một cơ hội tốt hơn. Nếu phần dư vẫn loe ra, hoặc có độ cong, thì còn vấn đề khác.
Sau biến đổi, các hệ số không còn mô tả mối quan hệ trên thang đo gốc. Điều này hay gây vấp khi báo cáo kết quả hoặc đưa ra dự đoán. Hãy theo dõi bạn đang làm việc trên thang đo nào ở mọi bước.
Lambda ước lượng từ phân phối đơn biến (chỉ nhìn biểu đồ tần suất của biến phản hồi) có thể khác với lambda ước lượng trong một mô hình hồi quy. Cách dựa trên hồi quy mới là đúng. Mục tiêu là thỏa mãn các giả định về phần dư, không phải giả định về phân phối biên.
Khi triển khai mô hình được huấn luyện trên dữ liệu đã biến đổi, bạn phải biến đổi dữ liệu mới theo cùng cách với cùng lambda và sau đó biến đổi ngược dự đoán. Bỏ qua bước nào cũng khiến dự đoán ở sai thang đo. Nghe thì hiển nhiên nhưng vẫn thường bị quên.
Box-Cox là một họ biến đổi, không phải một phép biến đổi đơn lẻ. Lambda quyết định bạn nhận được thành viên nào của họ đó, và biến đổi log chỉ là trường hợp đặc biệt lambda = 0. Phần lớn nhà phân tích mặc định dùng log mà không suy nghĩ nhiều. Box-Cox khiến lựa chọn đó trở nên minh bạch và cho bạn cách có cơ sở để hỏi liệu một giá trị lambda khác có phục vụ mô hình tốt hơn không.
Hãy dùng khi bạn đang chẩn đoán vấn đề cụ thể: phương sai phần dư không đồng nhất, phi tuyến tính, các giả định rõ ràng không được đáp ứng. Áp dụng tự động cho mọi biến phản hồi là thói quen nên bỏ. Và nếu dữ liệu của bạn có số 0 hoặc âm, đó không phải địa hạt của Box-Cox. Đó là Yeo-Johnson.
Để có nền tảng sâu hơn về các phương pháp hồi quy mà Box-Cox thường hỗ trợ, khóa học Intermediate Regression in R và Introduction to Regression with statsmodels in Python của chúng tôi là những bước tiếp theo phù hợp.
Học cùng DataCamp
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
