{count, plural, one {Corso} other {Corsi}}
Introduzione alla visualizzazione dei dati con Seaborn
{hours} ore
184.9K
Stai costruendo un modello di regressione lineare sui prezzi delle case. Il grafico dei residui sembra un megafono (stretto a sinistra, largo a destra). Tecnicamente il modello gira. Solo che i risultati non sono affidabili. Questo schema è eteroschedasticità, ed è una di quelle violazioni che invalidano silenziosamente le tue inferenze senza generare un errore evidente.
Una possibilità è trasformare la variabile di risposta. E invece di indovinare se provare un logaritmo, una radice quadrata o un reciproco, puoi lasciare che siano i dati a suggerire quello giusto. È l’idea alla base della trasformazione di Box-Cox, ed è ciò che vedremo qui: la formula, come scegliere lambda e come implementarla in Python e R.
La trasformazione di Box-Cox è una famiglia di trasformazioni di potenza per dati strettamente positivi. Invece di scegliere tu una trasformazione specifica, ti offre un modo per cercare su un intero intervallo, ognuna indicizzata da un parametro chiamato lambda (λ).
Quando lambda è pari a 0, ottieni una trasformazione logaritmica. Quando è pari a 0,5, ottieni qualcosa di simile a una radice quadrata. Quando è pari a -1, sei vicino a un reciproco. Tutte queste sono casi particolari della stessa formula, il che significa che non devi scegliere tra loro in anticipo. Stimi quale si adatta meglio a partire dai dati.
Una cosa da chiarire subito: Box-Cox non “rende i dati normali”. A seconda del problema di modellazione, può aiutare a stabilizzare la varianza, migliorare la linearità tra predittori e risposta o soddisfare meglio le assunzioni del modello. Richiede inoltre valori di input strettamente positivi. Zeri e negativi sono esclusi. Ne parliamo nella sezione sui limiti.
Prima della formula, vale la pena costruire un po’ di intuizione. Supponiamo di avere una variabile come il fatturato settimanale e che sia asimmetrica a destra: una lunga coda a destra, varianza che cresce con la media. La domanda è quale potenza di quella variabile si comporta più come una risposta “ben educata”.
Valori diversi di lambda corrispondono a trasformazioni che già conosci:
La formulazione standard di Box-Cox include convenzioni di scalatura e traslazione, quindi è meglio considerarle equivalenze familiari piuttosto che formule letteralmente identiche. Il caso log (lambda = 0) è trattato come un limite. La formula passa a log(x) lì per un argomento di continuità, non come eccezione arbitraria.
La formula standard a tratti è:
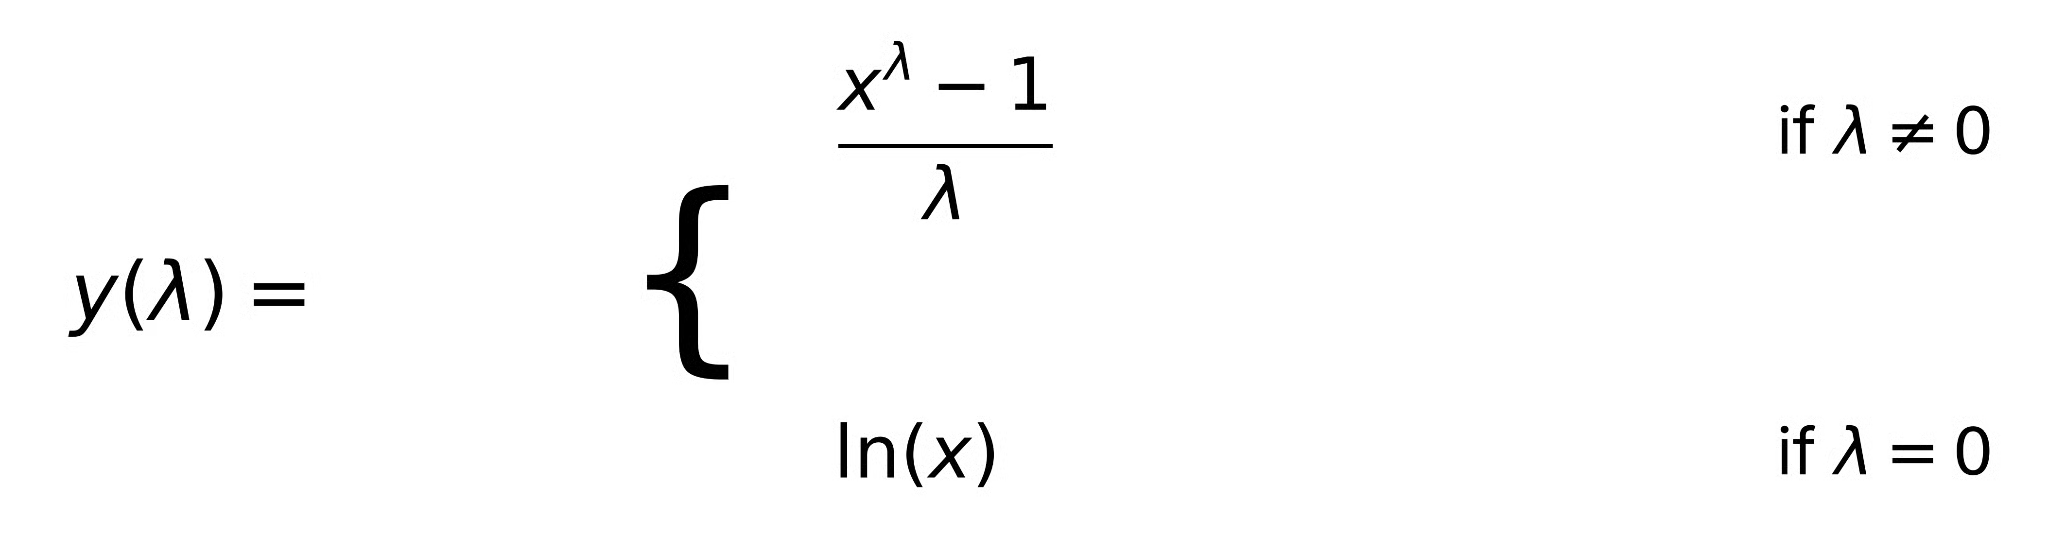
Qui, x è il valore positivo da trasformare e lambda è il parametro di trasformazione. La forma (xλ - 1) / λ può sembrare poco familiare all’inizio. È la convenzione di scalatura che mantiene continua la trasformazione mentre lambda si avvicina a zero. Senza di essa, avresti una discontinuità a salto in corrispondenza di lambda = 0 e il caso logaritmico sarebbe completamente disconnesso dal resto della famiglia. Con essa, la formula passa senza soluzione di continuità a ln(x) quando lambda → 0.
Per ora non preoccuparti della derivazione. Operativamente: scegli o stima lambda, inserisci i tuoi valori positivi e lavora con l’output trasformato.
Lambda non è qualcosa che imposti a mano per intuizione. Lo stimi dai dati. È questo che distingue Box-Cox dal semplice “prova un log”. C’è una procedura statistica rigorosa alla base.
L’idea è trovare il lambda che fa adattare al meglio i dati al modello assunto. In un contesto di regressione, significa trovare il lambda per cui la risposta trasformata soddisfa più da vicino le assunzioni del modello, tipicamente normalità e varianza costante dei residui. Non stai scegliendo il lambda che rende la distribuzione marginale della risposta più normale in isolamento. Stai scegliendo quello che funziona meglio nel contesto del modello. Questa distinzione conta, e ci torneremo nella sezione sugli errori.
Una delle diagnostiche più utili qui è il grafico della profile likelihood: valori di lambda sull’asse x, la log-verosimiglianza sull’asse y. Il picco indica il lambda ottimale stimato. Altrettanto utile è l’intervallo di confidenza intorno a quel picco, tipicamente mostrato come una linea orizzontale a una soglia sotto il massimo. Qualsiasi lambda dentro quell’intervallo è statisticamente indistinguibile dall’ottimo.
Ecco una considerazione pratica spesso sottovalutata. Se il lambda ottimale è, per esempio, 0,43 e lambda = 0,5 rientra nell’intervallo di confidenza, scegli 0,5. Una trasformazione con radice quadrata è più facile da spiegare, più facile da retro-trasformare e perde quasi nulla in prestazioni. La stessa logica vale per 0 (log) e 1 (nessuna trasformazione). L’interpretabilità conta, soprattutto quando devi spiegare il modello a chi non sa cosa significhi lambda = 0,43.
Ora che sappiamo cos’è lambda e come si seleziona, mettiamolo in pratica. Prima Python, poi R.
Il modulo stats di SciPy gestisce direttamente questa operazione. La funzione boxcox() stima sia lambda sia restituisce i valori trasformati in un’unica chiamata. Ecco un esempio minimale con dati simulati asimmetrici a destra:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Qui estimated_lambda è ciò che massimizza la log-verosimiglianza sotto l’assunzione di normalità. Userai poi questo stesso valore per trasformare i nuovi dati in fase di previsione.
Nota che qui lambda viene stimato dalla distribuzione marginale della risposta, non all’interno di un modello di regressione. In un flusso di modellazione, valuteresti lambda nel contesto del modello. L’esempio in R sotto mostra come farlo con la funzione boxcox() di MASS.
In R, la funzione boxcox() del pacchetto MASS è pensata per i flussi di lavoro di regressione. Prende un oggetto di modello già stimato e traccia direttamente la profile likelihood, che è più naturale perché stai valutando lambda nel contesto di un modello e non su un vettore isolato.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
boxcox() in R traccia automaticamente la profile likelihood, così ottieni gratis anche la visualizzazione dell’intervallo di confidenza. Questo rende facile decidere se arrotondare lambda a un valore più semplice.
Una volta trasformata la risposta e stimato un modello, le tue previsioni sono sulla scala trasformata, non su quella originale. Una previsione di 3,2 significa 3,2 unità di (xλ - 1) / λ, non 3,2 unità di fatturato.
L’interpretazione dei coefficienti cambia dopo la trasformazione. Sulla scala trasformata, un incremento di un’unità in un predittore corrisponde a un certo cambiamento in y(λ), non nella y originale. Se lambda è vicino a 0 (quasi log), puoi approssimare variazioni percentuali sulla scala originale. Per altri valori di lambda, la relazione è più articolata e dipende dal livello corrente di x.
Per riportare le previsioni alla scala originale, applica l’inversa:
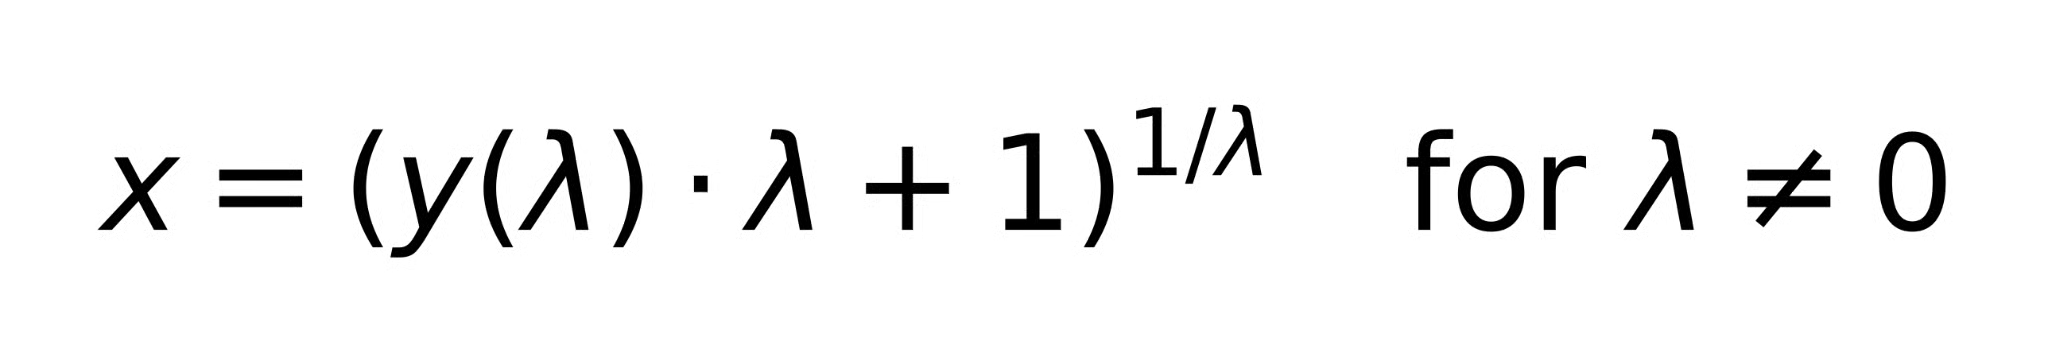
Per lambda = 0, l’inversa di ln(x) è semplicemente exp(y).
Retro-trasformare la media prevista sulla scala trasformata non ti dà una stima non distorta della media sulla scala originale. È una conseguenza nota della disuguaglianza di Jensen e conta soprattutto in contesti come la previsione di valori medi in modelli log-lineari. Entrare nel dettaglio delle correzioni di bias esula dal nostro scopo qui. Il nostro corso Introduzione alla Regressione in Python tratta in modo più ampio previsione e interpretazione nei modelli di regressione, se vuoi quel contesto.
Quando dovresti effettivamente utilizzare Box-Cox rispetto ad alternative che potresti già usare?
La trasformazione logaritmica è il caso lambda = 0 di Box-Cox. Punto. Se hai usato la trasformazione logaritmica in passato, hai usato un’istanza specifica di Box-Cox con lambda fissato invece che stimato. Il vantaggio di Box-Cox è che non si impegna a lambda = 0 in anticipo. Detto questo, se la profile likelihood ha il picco proprio a lambda = 0, usa semplicemente un log. Nessun motivo per aggiungere complessità.
La trasformazione di Yeo-Johnson è un’estensione diretta di Box-Cox progettata per gestire zeri e valori negativi. È quella da usare quando i tuoi dati includono zeri (per esempio conteggi) o valori negativi. Le trasformazioni sono matematicamente simili. Yeo-Johnson rilassa semplicemente il vincolo di positività. In scikit-learn, PowerTransformer supporta entrambe, method='box-cox' e method='yeo-johnson', rendendo facile provare a cambiare.
La standardizzazione (z-scoring) trasla e scala i dati: porta la media a 0 e la deviazione standard a 1. Box-Cox cambia la forma della distribuzione tramite una trasformazione non lineare. Risolvono problemi diversi. La standardizzazione non riduce l’asimmetria né stabilizza la varianza. Box-Cox non centra i tuoi dati né rende le feature comparabili in magnitudine. Potresti fare entrambe in sequenza, prima trasformare e poi standardizzare, ma non sono alternative.
Alcune di queste sono ovvie col senno di poi. Questo non impedisce che accadano, e alcune sono abbastanza sottili che “ovvie” è una parola grossa.
La formula si rompe a zero o sotto zero. 0λ è 0 per lambda positivo e non definito per lambda negativo; log(0) è meno infinito. Se i tuoi dati hanno zeri o negativi, Box-Cox genererà un errore o produrrà silenziosamente assurdità. Usa invece Yeo-Johnson o aggiungi una piccola costante di traslazione. Quest’ultima è un’approssimazione da trattare con un po’ di scetticismo.
Box-Cox va applicata in risposta a un problema di modellazione specifico: varianza non costante, scarsa linearità, assunzioni dei residui violate. Usarla come passaggio di pre-processing automatico per far “sembrare normale” la distribuzione marginale prima di adattare qualsiasi modello è sbagliato. Il lambda che normalizza la risposta in isolamento potrebbe non essere quello che migliora davvero i residui del modello.
Stimare lambda è solo metà del lavoro. Dopo aver trasformato e riadattato, controlla di nuovo i grafici dei residui. Box-Cox non garantisce che le assunzioni siano soddisfatte. Ti dà una chance concreta. Se i residui si allargano ancora, o c’è curvatura, c’è altro in gioco.
Dopo la trasformazione, i coefficienti non descrivono più relazioni sulla scala originale. È l’inghippo più comune quando si riportano i risultati o si fanno previsioni. Tieni traccia della scala su cui stai lavorando in ogni passaggio.
Lambda stimato da una distribuzione univariata (guardando solo l’istogramma della variabile risposta) può differire da lambda stimato all’interno di un modello di regressione. L’approccio basato sulla regressione è quello corretto. L’obiettivo è soddisfare le assunzioni sui residui, non quelle sulla distribuzione marginale.
Quando distribuisci un modello addestrato su dati trasformati, devi trasformare i nuovi input allo stesso modo usando lo stesso lambda e poi retro-trasformare le previsioni. Saltare uno dei due passaggi produce previsioni sulla scala sbagliata. Sembra ovvio eppure viene ancora dimenticato regolarmente.
Box-Cox è una famiglia di trasformazioni, non una singola. Lambda determina quale membro della famiglia ottieni, e la trasformazione logaritmica è solo il caso speciale lambda = 0. La maggior parte degli analisti usa il log di default senza pensarci troppo. Box-Cox rende esplicita quella scelta e ti dà un modo rigoroso per chiederti se un valore diverso di lambda servirebbe meglio il modello.
Usala quando stai diagnosticando qualcosa di specifico: eteroschedasticità nei residui, non linearità, assunzioni chiaramente non rispettate. Applicarla automaticamente a ogni variabile risposta è un’abitudine da perdere. E se i tuoi dati hanno zeri o negativi, non è territorio Box-Cox. È Yeo-Johnson.
Per una base più solida nei metodi di regressione che Box-Cox tipicamente supporta, il nostro corso Regressione Intermedia in R e Introduzione alla Regressione con statsmodels in Python sono buoni prossimi passi.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min