{count, plural, one {Kurs} other {Kurse}}
Einführung in die Datenvisualisierung mit Seaborn
{hours} Std.
184.9K
Du baust ein lineares Regressionsmodell für Immobilienpreise. Das Residuen-Diagramm sieht aus wie ein Megafon: links eng, rechts weit auffächernd. Das Modell läuft zwar, aber die Ergebnisse sind nicht belastbar. Dieses Muster heißt Heteroskedastizität und ist eine dieser Verletzungen, die deine Schlüsse leise entwerten, ohne einen klaren Fehler zu werfen.
Eine Option ist, die Zielvariable zu transformieren. Und statt zu raten, ob Log, Quadratwurzel oder Kehrwert passend ist, lässt du die Daten die Richtung vorgeben. Genau dahinter steckt die Box-Cox-Transformation. Hier zeige ich dir die Formel, wie du Lambda auswählst und wie du das Ganze in Python und R umsetzt.
Die Box-Cox-Transformation ist eine Familie von Potenztransformationen für strikt positive Daten. Statt dich für eine bestimmte Transformation zu entscheiden, kannst du über einen ganzen Bereich davon suchen, indiziert durch einen Parameter namens Lambda (λ).
Wenn Lambda 0 ist, erhältst du eine Log-Transformation. Bei 0,5 liegst du nahe an der Quadratwurzel. Bei -1 bist du in der Nähe eines Kehrwerts. Alles sind Spezialfälle derselben Formel, sodass du dich nicht vorab festlegen musst. Du schätzt aus den Daten, was am besten passt.
Wichtig von Anfang an: Box-Cox macht Daten nicht einfach „normal“. Je nach Problem kann sie Varianz stabilisieren, die Linearität zwischen Prädiktoren und Antwort verbessern oder Annahmen deines Modells besser erfüllen. Sie erfordert strikt positive Eingabewerte. Nullen und Negative sind tabu. Mehr dazu im Abschnitt zu Einschränkungen.
Vor der Formel etwas Intuition: Du hast eine Variable wie wöchentliche Umsätze, rechtsschief mit langem rechten Schwanz und einer Varianz, die mit dem Mittelwert wächst. Die Frage ist, welche Potenz dieser Variable sich wie eine gutmütige Antwortgröße verhält.
Verschiedene Lambda-Werte entsprechen dir bekannten Transformationen:
Die übliche Box-Cox-Formulierung enthält Skalierungs- und Verschiebungskonventionen; daher sind dies vertraute Äquivalente, keine wortwörtlich identischen Formeln. Der Log-Fall (Lambda = 0) wird als Grenzwert behandelt. Die Formel wechselt dort zu log(x) aufgrund von Stetigkeit, nicht als willkürliche Ausnahme.
Die stückweise definierte Standardformel lautet:
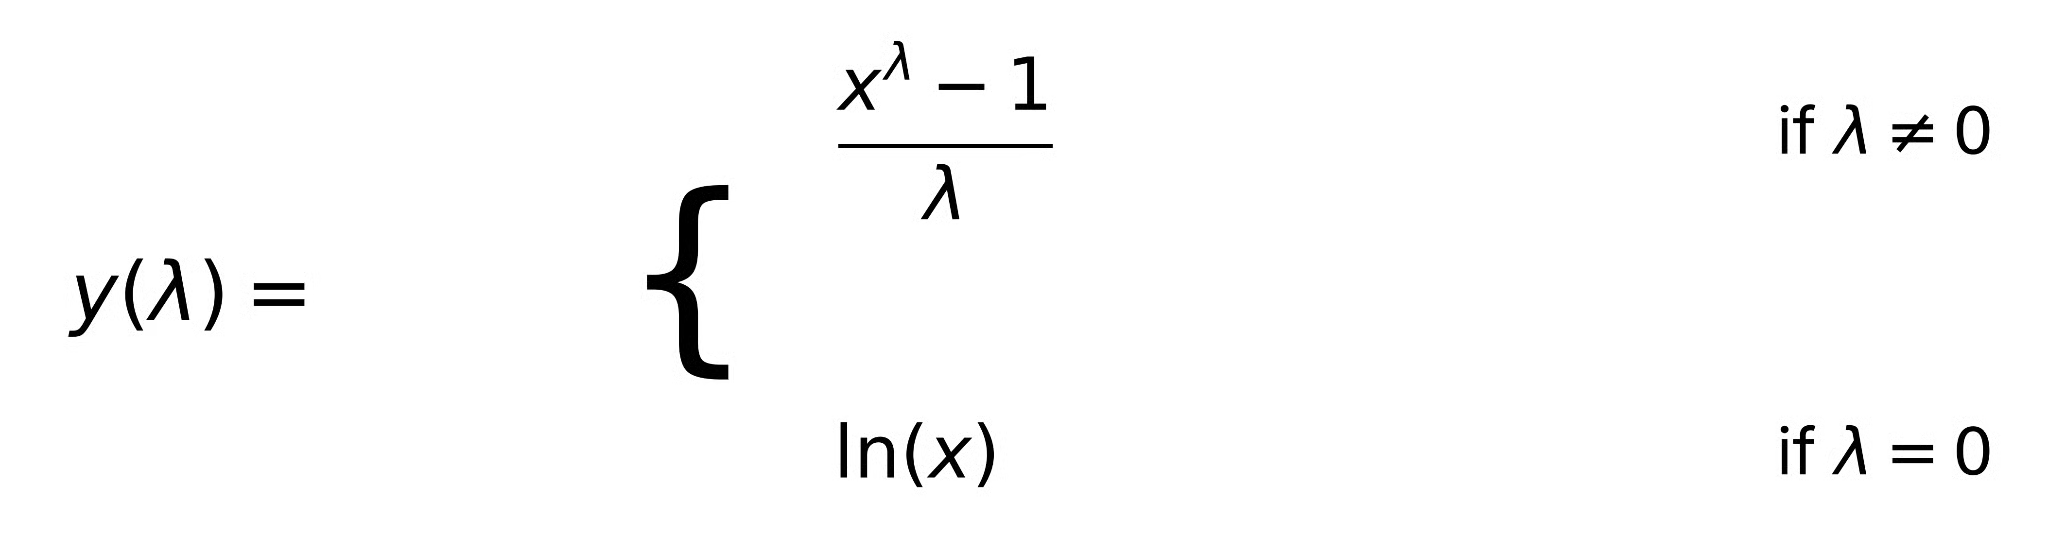
Hier ist x der positive zu transformierende Wert und Lambda der Transformationsparameter. Die Form (xλ - 1) / λ wirkt zunächst ungewohnt. Das ist die Skalierungskonvention, die die Transformation stetig hält, während Lambda gegen null geht. Ohne sie gäbe es einen Sprung bei Lambda = 0 und der Log-Fall wäre von der Familie entkoppelt. Mit ihr geht die Formel glatt in ln(x) über, wenn λ → 0.
Die Herleitung ist hier nicht entscheidend. Praktisch gilt: Lambda wählen oder schätzen, positive Werte einsetzen und mit den transformierten Ausgaben arbeiten.
Lambda setzt du nicht nach Bauchgefühl. Du schätzt es aus den Daten. Das unterscheidet Box-Cox vom „probier mal Log“. Dahinter steckt ein sauberes statistisches Verfahren.
Die Idee: Finde das Lambda, das deine Daten am besten zum angenommenen Modell passen lässt. In der Regression heißt das, das Lambda zu finden, bei dem die transformierte Antwort die Modellannahmen am besten erfüllt, typischerweise Normalität und konstante Varianz der Residuen. Du wählst nicht das Lambda, das die Randverteilung der Antwort isoliert am normalsten aussehen lässt, sondern das, das im Modellkontext am besten funktioniert. Dieser Unterschied ist wichtig und taucht in den typischen Fehlern wieder auf.
Sehr hilfreich ist der Profillikelihood-Plot: Lambda-Werte auf der x-Achse, die Log-Likelihood auf der y-Achse. Das Maximum zeigt das geschätzte optimale Lambda. Ebenso wichtig ist das Konfidenzintervall um dieses Maximum, oft als horizontale Linie unterhalb des Maximums dargestellt. Jedes Lambda in diesem Intervall ist statistisch nicht vom Optimum zu unterscheiden.
Ein Praxis-Tipp, der oft unterschätzt wird: Liegt das optimale Lambda bei 0,43 und liegt 0,5 im Konfidenzintervall, nimm 0,5. Eine Quadratwurzel-Transformation ist leichter zu erklären, leichter zurückzutransformieren und verliert kaum Leistung. Dasselbe gilt für 0 (Log) und 1 (keine Transformation). Verständlichkeit zählt, vor allem wenn du dein Modell erklären musst.
Jetzt, da klar ist, was Lambda ist und wie es gewählt wird, geht es in die Praxis. Erst Python, dann R.
Das stats-Modul von SciPy kann das direkt. Die Funktion boxcox() schätzt Lambda und gibt in einem Aufruf die transformierten Werte zurück. Ein minimales Beispiel mit simulierten rechtsschiefen Daten:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Das estimated_lambda maximiert die Log-Likelihood unter der Normalitätsannahme. Diesen Wert nutzt du anschließend auch, um neue Daten für Vorhersagen zu transformieren.
Beachte: Hier wird Lambda aus der Randverteilung der Antwort geschätzt, nicht im Regressionsmodell. In einem Modell-Workflow bewertest du Lambda im Modellkontext. Das R-Beispiel unten zeigt das mit boxcox() aus MASS.
In R ist die Funktion boxcox() aus dem Paket MASS für Regressions-Workflows gemacht. Sie nimmt ein gefittetes Modellobjekt und plottet direkt die Profillikelihood – passender, weil du Lambda im Modell- statt am isolierten Vektor bewertest.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R's boxcox() plottet die Profillikelihood automatisch, inklusive Konfidenzintervall. So kannst du leicht entscheiden, ob du Lambda auf einen einfacheren Wert rundest.
Nach der Transformation und dem Fit liegen deine Vorhersagen auf der transformierten Skala, nicht der ursprünglichen. Eine Prognose von 3,2 bedeutet 3,2 Einheiten von (xλ - 1) / λ, nicht 3,2 Einheiten Umsatz.
Die Interpretation der Koeffizienten ändert sich. Auf der transformierten Skala entspricht ein Anstieg eines Prädiktors um eine Einheit einer bestimmten Änderung in y(λ), nicht im ursprünglichen y. Liegt Lambda nahe 0 (nahe Log), kannst du Prozentänderungen auf der Originalskala näherungsweise ableiten. Bei anderen Lambda-Werten hängt die Beziehung vom aktuellen Niveau von x ab.
Um Vorhersagen auf die Originalskala zurückzuführen, wendest du die Inverse an:
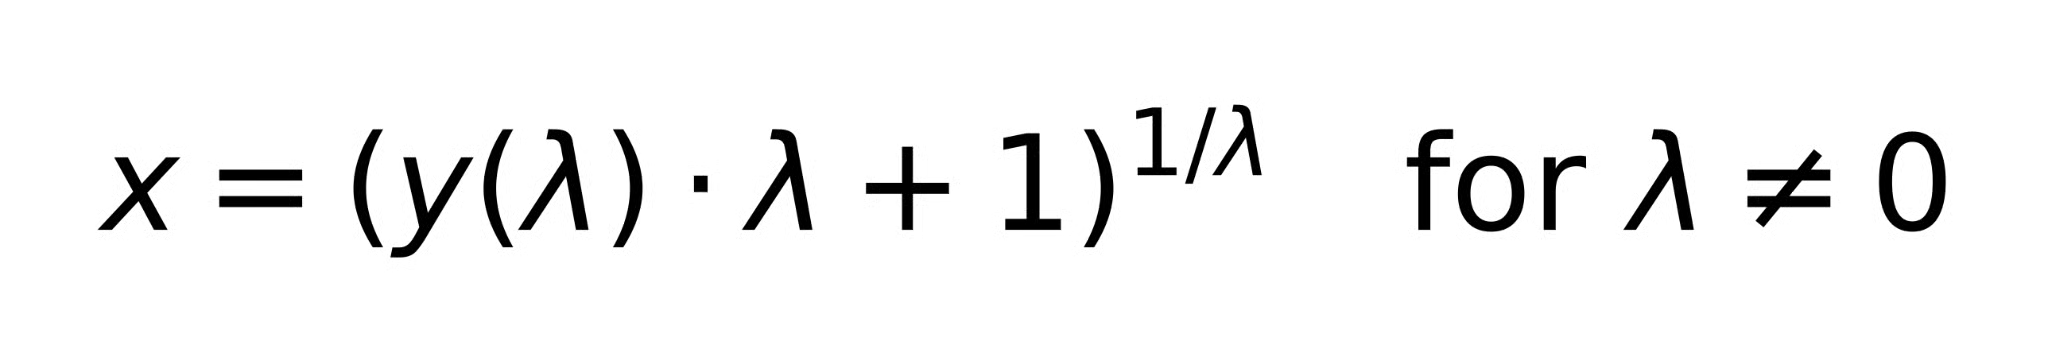
Für Lambda = 0 ist die Inverse von ln(x) einfach exp(y).
Das Rücktransformieren des vorhergesagten Mittelwerts auf der transformierten Skala liefert keine unverzerrte Schätzung des Mittelwerts auf der Originalskala. Das ist eine bekannte Folge der Ungleichung von Jensen und wiegt besonders bei Prognosen von Mittelwerten in log-linearen Modellen. Eine tiefe Behandlung der Bias-Korrektur sprengt hier den Rahmen. Unser Introduction to Regression in Python Kurs deckt Vorhersage und Interpretation breiter ab, falls du mehr Kontext möchtest.
Wann solltest du Box-Cox gegenüber Alternativen einsetzen, die du vielleicht schon nutzt?
Die Log-Transformation ist der Fall Lambda = 0 bei Box-Cox. Punkt. Wenn du Log bereits genutzt hast, hast du eine spezielle Box-Cox-Variante mit festem Lambda verwendet. Der Vorteil von Box-Cox: Du legst dich nicht vorab auf 0 fest. Liegt das Maximum der Profillikelihood klar bei Lambda = 0, nimm Log. Kein Grund für zusätzliche Komplexität.
Die Yeo-Johnson-Transformation ist eine Erweiterung von Box-Cox für Nullen und negative Werte. Greife dazu, wenn deine Daten Nullen (z. B. Zählwerte) oder Negative enthalten. Die Transformationen sind mathematisch ähnlich; Yeo-Johnson lockert nur die Positivitätsbedingung. In scikit-learn unterstützt PowerTransformer beides, method='box-cox' und method='yeo-johnson', sodass du leicht wechseln kannst.
Standardisierung (z-Standardisierung) verschiebt und skaliert Daten: Mittelwert 0, Standardabweichung 1. Box-Cox ändert die Form der Verteilung über eine nichtlineare Transformation. Sie lösen unterschiedliche Probleme. Standardisierung reduziert keine Schiefe und stabilisiert keine Varianz. Box-Cox zentriert nicht und macht Features nicht vergleichbar in der Größenordnung. Du kannst beides in Folge tun: erst transformieren, dann standardisieren – Alternativen sind es nicht.
Manches wirkt im Rückblick offensichtlich. Passieren tut es trotzdem – und einiges ist subtil genug, dass „offensichtlich“ viel Arbeit leistet.
Die Formel bricht bei Werten ≤ 0 zusammen. 0λ ist für positives Lambda 0 und für negatives undefiniert; log(0) ist minus Unendlich. Enthalten deine Daten Nullen oder Negative, gibt Box-Cox Fehler oder stillen Unsinn. Nutze stattdessen Yeo-Johnson oder füge eine kleine positive Konstante als Verschiebung hinzu. Letzteres ist eine Näherung und mit Vorsicht zu genießen.
Setze Box-Cox als Reaktion auf ein konkretes Modellproblem ein: nichtkonstante Varianz, miese Linearität, verletzte Residuenannahmen. Sie als automatischen Preprocessing-Schritt zu nutzen, um die Randverteilung „normal“ aussehen zu lassen, ist der falsche Ansatz. Das Lambda, das isoliert normalisiert, ist nicht zwingend das, das deine Modellresiduen verbessert.
Lambda zu schätzen ist nur die halbe Miete. Nach Transformation und Refit Residuenplots erneut prüfen. Box-Cox garantiert keine erfüllten Annahmen, es verschafft dir Chancen. Fächern die Residuen weiter auf oder zeigt sich Krümmung, liegt ein anderes Problem vor.
Nach der Transformation beschreiben Koeffizienten keine Zusammenhänge mehr auf der Originalskala. Das führt häufig zu Fehlinterpretationen bei Reporting oder Vorhersagen. Behalte jederzeit im Blick, auf welcher Skala du arbeitest.
Aus einer univariaten Verteilung (nur Histogramm der Antwort) geschätztes Lambda kann sich von dem im Regressionsmodell unterscheiden. Der modellbasierte Ansatz ist der richtige. Ziel ist die Erfüllung der Residuenannahmen, nicht die der Randverteilung.
Setzt du ein Modell mit transformierten Daten ein, musst du neue Eingaben mit demselben Lambda transformieren und Vorhersagen zurücktransformieren. Lässt du einen der Schritte aus, arbeitest du auf der falschen Skala. Klingt banal, wird aber regelmäßig vergessen.
Box-Cox ist eine Transformationsfamilie, nicht eine einzelne. Lambda bestimmt, welches Familienmitglied du bekommst; die Log-Transformation ist nur der Spezialfall Lambda = 0. Viele Analysten greifen automatisch zu Log, ohne darüber nachzudenken. Box-Cox macht die Wahl explizit und liefert einen fundierten Weg zu prüfen, ob ein anderes Lambda dem Modell besser dient.
Nutze sie, wenn du etwas Konkretes diagnostizierst: Heteroskedastizität in Residuen, Nichtlinearität, klar verletzte Annahmen. Sie pauschal auf jede Zielvariable anzuwenden, ist eine Gewohnheit, die du dir abgewöhnen solltest. Und wenn deine Daten Nullen oder Negative enthalten, ist das kein Box-Cox-Terrain, sondern Yeo-Johnson.
Für ein tieferes Fundament in den Regressionsmethoden, die Box-Cox typischerweise unterstützt, sind unser Intermediate Regression in R Kurs und Introduction to Regression with statsmodels in Python gute nächste Schritte.
Mit DataCamp lernen
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Tutorial} other {Tutorials}}
Josef Waples
8 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Mark Pedigo
10 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Josef Waples
3 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Allan Ouko
11 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Laiba Siddiqui
6 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Vinod Chugani
8 Min.