
{count, plural, one {コース} other {コース}}
Seabornで学ぶデータ可視化入門
{hours}時間
184.9K
住宅価格の線形回帰モデルを作っているとします。残差プロットがメガホンのように左が狭く右に広がる形をしています。モデル自体は動きますが、結果は信頼できません。このパターンは不均一分散(ヘテロスケダスティシティ)で、明らかなエラーを出さずに推測を静かに無効化する違反のひとつです。
対応策のひとつは、目的変数を変換することです。対数や平方根、逆数のどれを試すか勘で選ぶ代わりに、データに適切なものを示してもらえます。これがBox-Cox変換の考え方で、本稿ではその数式、ラムダの選び方、PythonとRでの実装方法を扱います。
Box-Cox変換は、厳密に正のデータに対するべき乗変換の族です。特定の変換を自分で選ぶのではなく、ラムダ(λ)と呼ばれるパラメータで索引づけられた広い範囲の変換を探索する方法を提供します。
ラムダが0なら対数変換、0.5なら平方根に近く、-1なら逆数に近い変換になります。これらはすべて同じ数式の特殊な場合で、事前にどれかを選ぶ必要はありません。データから最もうまく合うものを推定します。
最初に明確にしておくべきことがひとつあります。Box-Coxは単に「データを正規化する」ものではありません。モデリングの課題によっては、分散の安定化、説明変数と目的変数の線形性の改善、あるいはモデルの仮定をより満たすのに役立ちます。また、入力値が厳密に正である必要があります。0や負の値は不可です。詳しくは制約のセクションで説明します。
数式の前に直感を掴みましょう。週次売上収益のような変数が右に歪んでいる(右に長い裾、平均とともに分散が増える)とします。どのべき乗をとると、より扱いやすい応答のように振る舞うでしょうか、というのが問いです。
ラムダの値によって、既におなじみの変換に対応します。
標準的なBox-Coxの定式化にはスケーリングと並進の規約が含まれるため、これらは文字通り同一の数式というより、馴染みのある同等物と理解するのがよいでしょう。対数の場合(lambda = 0)は極限として扱います。連続性の観点からlog(x)に切り替わるのであって、恣意的な例外ではありません。
標準的な区分的な数式は次のとおりです。
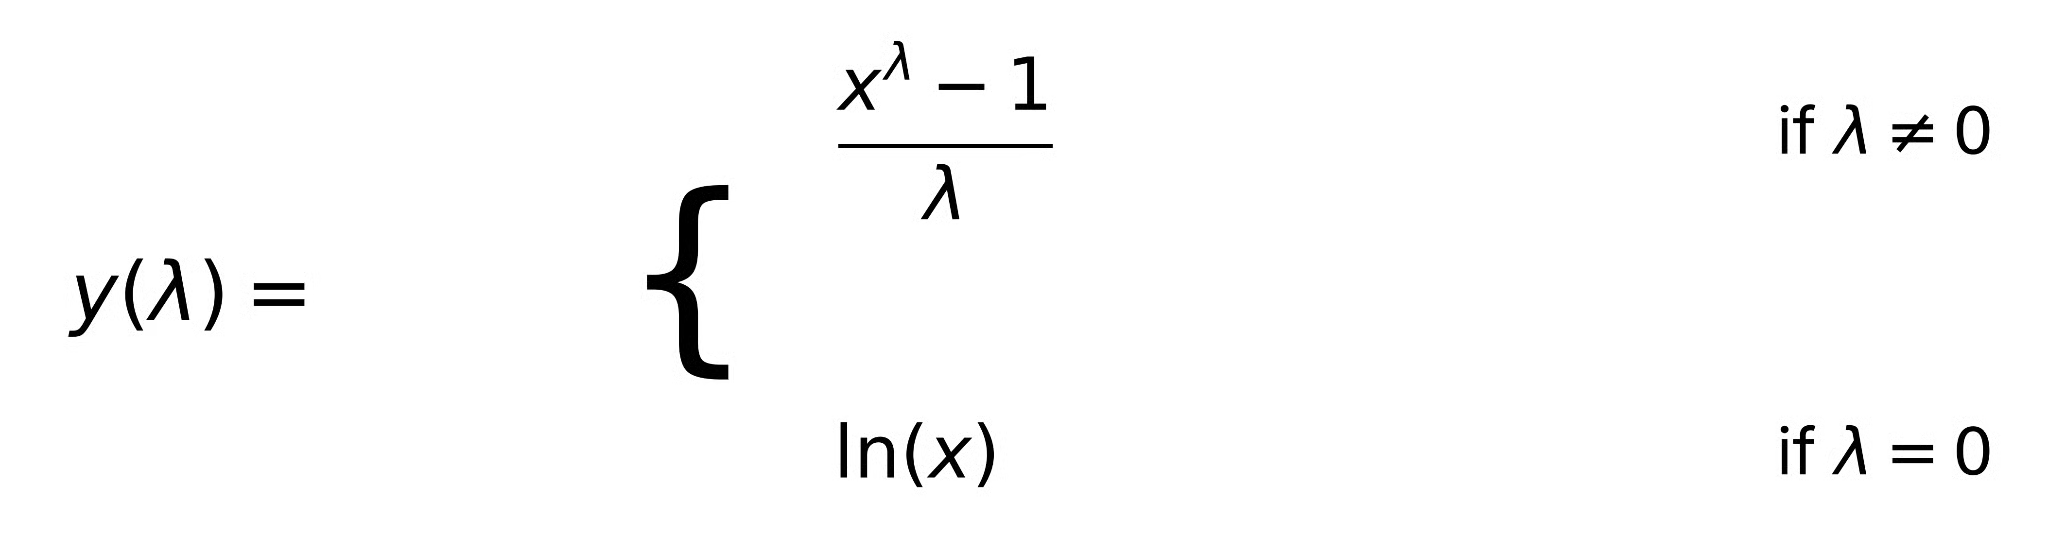
ここでxは変換される正の値、lambdaは変換パラメータです。(xλ - 1) / λ という形は最初は見慣れないかもしれません。これは、lambdaが0に近づくときに変換を連続に保つためのスケーリング規約です。これがないとlambda = 0で跳躍不連続が生じ、対数の場合が他と切り離されてしまいます。これにより、lambda → 0のときに数式は滑らかにln(x)へと移行します。
導出は今は気にしなくて構いません。実務的には、ラムダを選ぶか推定し、正の値を代入して、変換後の出力を使います。
ラムダは直感で手動設定するものではありません。データから推定します。これは「とりあえず対数を試す」と当てずっぽうでやるのとBox-Coxの違いです。背後には筋の通った統計的な手続きがあります。
狙いは、仮定したモデルに最も適合するラムダを見つけることです。回帰の文脈では、変換後の目的変数がモデルの仮定、典型的には残差の正規性と分散一定を最もよく満たすラムダを探します。周辺分布としての目的変数が最も正規に見えるラムダを選ぶのではありません。モデリングの文脈で最も機能するものを選びます。この違いは重要で、誤りのセクションで再び触れます。
ここで最も有用な診断のひとつがプロフィール尤度プロットです。横軸にラムダ、縦軸に対数尤度を置きます。頂点が推定された最適ラムダを示します。同様に有用なのがその頂点周りの信頼区間で、通常は最大値から一定の閾値下に水平線で示されます。その区間内の任意のラムダは統計的に最適値と区別できません。
実務的に見落とされがちな点があります。最適ラムダが0.43のような値で、0.5が信頼区間内にあるなら、0.5を選びましょう。平方根変換のほうが説明もしやすく、逆変換もしやすく、性能面の損失はごく僅かです。同じ論理は0(対数)や1(変換なし)にも当てはまります。特にラムダ=0.43が何を意味するか分からない人にモデルを説明する場合、解釈しやすさは重要です。
ラムダとは何か、どう選ぶかが分かったところで、実際に使ってみましょう。まずPython、次にRです。
SciPyのstatsモジュールで直接扱えます。boxcox()関数は、ラムダの推定と変換値の返却を1回の呼び出しで行います。右に歪んだデータをシミュレートした最小例を示します。
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")ここでのestimated_lambdaは、正規性の仮定のもとで対数尤度を最大化する値です。予測のために新しいデータを変換するときは、この同じ値を使用します。
これは目的変数の周辺分布からラムダを推定している点に注意してください。モデリングのワークフローでは、モデルの文脈でラムダを評価します。以下のRの例では、MASSのboxcox()関数を使った方法を示します。
Rでは、MASSパッケージのboxcox()関数が回帰ワークフロー向けに作られています。適合済みモデルオブジェクトを受け取り、プロフィール尤度を直接プロットします。スタンドアロンのベクトルではなく、モデルの文脈でラムダを評価するという点で、こちらのほうが自然です。
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)Rのboxcox()はプロフィール尤度を自動でプロットするため、信頼区間の可視化も同時に得られます。これにより、ラムダをより単純な値に丸めるかどうかの判断が容易になります。
目的変数を変換してモデルを当てた後、予測値は元の尺度ではなく変換後の尺度にあります。3.2という予測は、収益の3.2ではなく、(xλ - 1) / λ の3.2単位を意味します。
変換後は、係数の解釈が変わります。変換後の尺度では、説明変数が1単位増加するとy(λ)が一定量変化しますが、元のyではありません。ラムダが0に近い(準対数)場合は、元の尺度でのパーセンテージ変化を近似できます。その他のラムダでは、関係はより複雑で、現在のxの水準に依存します。
予測を元の尺度に戻すには、次の逆変換を適用します。
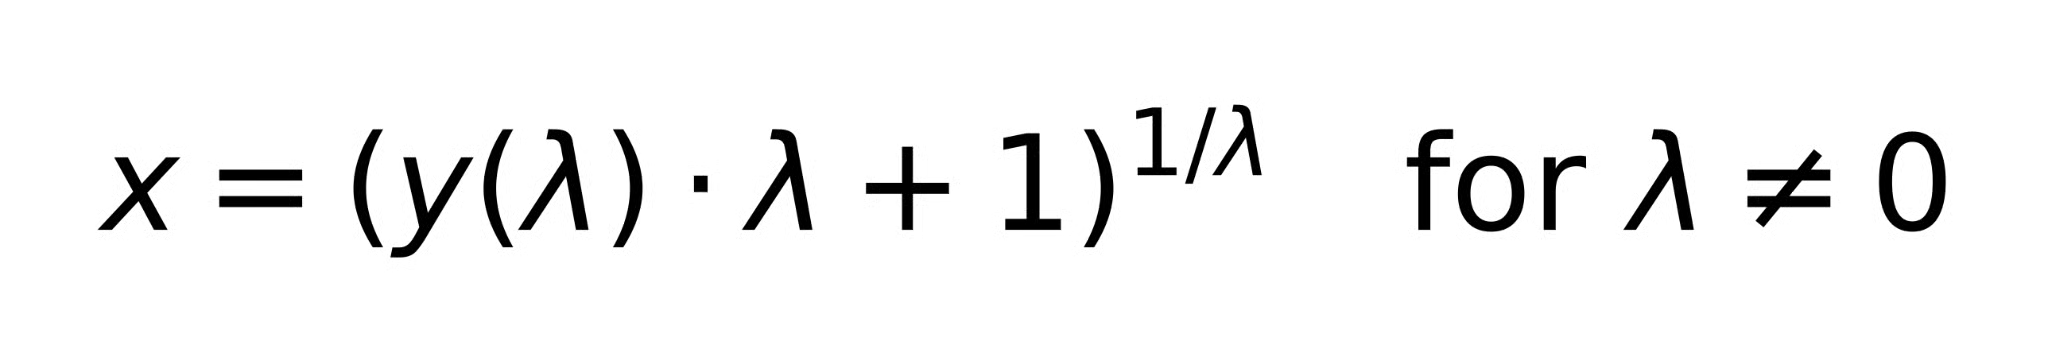
lambda = 0の場合、ln(x)の逆関数は単にexp(y)です。
変換後の尺度での予測平均を逆変換しても、元の尺度での平均の不偏推定量にはなりません。これはイェンセンの不等式に由来する既知の結果で、特に対数線形モデルで平均値を予測するような設定で重要です。バイアス補正の詳細は本稿の範囲外です。より広い文脈での回帰における予測と解釈は、Introduction to Regression in Pythonコースで扱っています。
実際には、いつBox-Coxを選び、既存の代替手段とどう使い分けるべきでしょうか?
対数変換はBox-Coxのlambda = 0という特殊ケースです。以上です。対数変換を使ったことがあれば、ラムダを固定して推定しないBox-Coxの一例を使ったことになります。Box-Coxの利点は、最初からlambda = 0に固定しないことです。とはいえ、プロフィール尤度がlambda = 0で明確にピークを打つなら、素直に対数を使いましょう。複雑さを増やす理由はありません。
Yeo-Johnson変換は、0や負の値を扱えるように設計されたBox-Coxの直接的な拡張です。カウントのように0を含むデータや負の値を含む場合はこちらを使います。変換は数学的に類似しており、Yeo-Johnsonは正値制約を緩和しているだけです。scikit-learnではPowerTransformerがmethod='box-cox'とmethod='yeo-johnson'の両方をサポートしており、切り替えは容易です。
標準化(zスコア化)はシフトとスケーリング、つまり平均を0、標準偏差を1にします。Box-Coxは非線形変換により分布の形状を変えます。両者は異なる問題に対処します。標準化は歪度の削減や分散の安定化をしません。Box-Coxはデータの中心化や特徴量の大きさの比較可能化をしません。両方を順に行う(先に変換、次に標準化)ことはありますが、代替関係にはありません。
いくつかは振り返れば明らかですが、それでも起こりますし、中には「明らか」とは言い難い微妙なものもあります。
この数式は0以下で破綻します。0λは正のラムダでは0、負のラムダでは未定義で、log(0)は負の無限大です。データに0や負の値があると、Box-Coxはエラーになるか、黙ってナンセンスを生みます。代わりにYeo-Johnsonを使うか、小さな正の定数を足してシフトします。後者は近似であり、慎重に扱う価値があります。
Box-Coxは特定のモデリング上の問題に応じて適用すべきです。例えば、分散不均一、線形性の欠如、残差の仮定違反です。モデルを当てる前に周辺分布を「正規っぽく見せる」ための自動前処理として使うのは本末転倒です。孤立した目的変数を正規化するラムダが、実際にモデルの残差を改善するラムダとは限りません。
ラムダの推定は仕事の半分にすぎません。変換して再推定したら、残差プロットを再確認してください。Box-Coxは仮定が満たされることを保証しません。改善のチャンスを与えるだけです。残差がなお扇形に広がる、あるいは曲率が残るなら、別の原因があります。
変換後、係数は元の尺度での関係を表さなくなります。これは結果報告や予測時にしばしばつまずく点です。各段階で、どの尺度で作業しているかを常に把握してください。
(目的変数のヒストグラムだけを見るような)単変量分布から推定したラムダは、回帰モデル内で推定したラムダと異なる場合があります。回帰に基づくアプローチが正しい方法です。目標は周辺分布の仮定を満たすことではなく、残差の仮定を満たすことです。
変換データで学習したモデルをデプロイする際は、同じラムダで新しい入力にも同じ変換を施し、予測を逆変換する必要があります。どちらか一方でも省くと、誤った尺度での予測になります。明らかに思えても、よく忘れられます。
Box-Coxは単一の変換ではなく、変換の族です。どのメンバーになるかはラムダで決まり、対数変換はlambda = 0という特殊ケースにすぎません。多くのアナリストは何も考えずにデフォルトで対数を使います。Box-Coxはその選択を明示化し、別のラムダ値のほうがモデルに実際に有利かどうかを検討するための、筋の通った方法を提供します。
適用するのは、残差の不均一分散、非線形性、明らかに満たされていない仮定など、具体的な問題を診断しているときです。すべての目的変数に自動適用する習慣は改める価値があります。また、データに0や負の値があるなら、それはBox-Coxの出番ではありません。Yeo-Johnsonの領分です。
Box-Coxが通常支える回帰手法をより深く学ぶには、Intermediate Regression in Rコースや Introduction to Regression with statsmodels in Pythonが次の一歩として有用です。
DataCampで学ぶ
{count, plural, one {コース} other {コース}}
{count, plural, one {コース} other {コース}}
{count, plural, one {コース} other {コース}}