
{count, plural, one {Kurs} other {Kurser}}
Introduktion till datavisualisering med Seaborn
{hours} tim
184.9K
Du bygger en linjär regressionsmodell för bostadspriser. Residualdiagrammet ser ut som en megafon (smalt till vänster, brett till höger). Modellen körs tekniskt sett. Resultaten är bara inte tillförlitliga. Det mönstret är heteroskedasticitet, och det är en av de överträdelser som tyst ogiltigförklarar dina slutsatser utan att ge ett tydligt fel.
Ett alternativ är att transformera responsvariabeln. Och i stället för att gissa om du ska prova logg, kvadratrot eller reciprok, kan du låta datan föreslå rätt val. Det är idén bakom Box-Cox-transformationen, och det är vad vi går igenom här: formeln, hur du väljer lambda och hur du implementerar den i Python och R.
Box-Cox-transformationen är en familj av potensomvandlingar för strikt positiva data. I stället för att själv välja en specifik transformation ger den dig ett sätt att söka över ett helt spann av dem, var och en indexerad av en parameter som kallas lambda (λ).
När lambda är 0 får du en loggtransformation. När den är 0,5 får du något nära en kvadratrot. När den är -1 ligger du nära en reciprok. Alla dessa är specialfall av samma formel, vilket betyder att du inte behöver välja mellan dem i förväg. Du skattar vilken som passar bäst utifrån datan.
En sak som är värd att vara tydlig med från början: Box-Cox gör inte bara att ”data blir normalfördelade”. Beroende på din modelleringsuppgift kan den hjälpa till att stabilisera variansen, förbättra lineariteten mellan prediktorer och respons eller bättre uppfylla din modells antaganden. Den kräver också strikt positiva indata. Nollor och negativa värden går bort. Mer om det i avsnittet om begränsningar.
Innan formeln är det värt att bygga lite intuition. Säg att du har en variabel som veckovis försäljningsintäkt och den är högerskev: en lång svans åt höger, varians som växer med medelvärdet. Frågan är vilken potens av den variabeln som beter sig mer som en välfungerande respons.
Olika värden på lambda motsvarar transformationer du redan känner till:
Den standardmässiga Box-Cox-formuleringen inkluderar skalnings- och translationskonventioner, så dessa ska förstås som bekanta motsvarigheter snarare än bokstavligen identiska formler. Loggfallet (lambda = 0) behandlas som en gräns. Formeln växlar då till log(x) på grund av ett kontinuitetsargument, inte som ett godtyckligt undantag.
Den standardmässiga styckvisa formeln är:
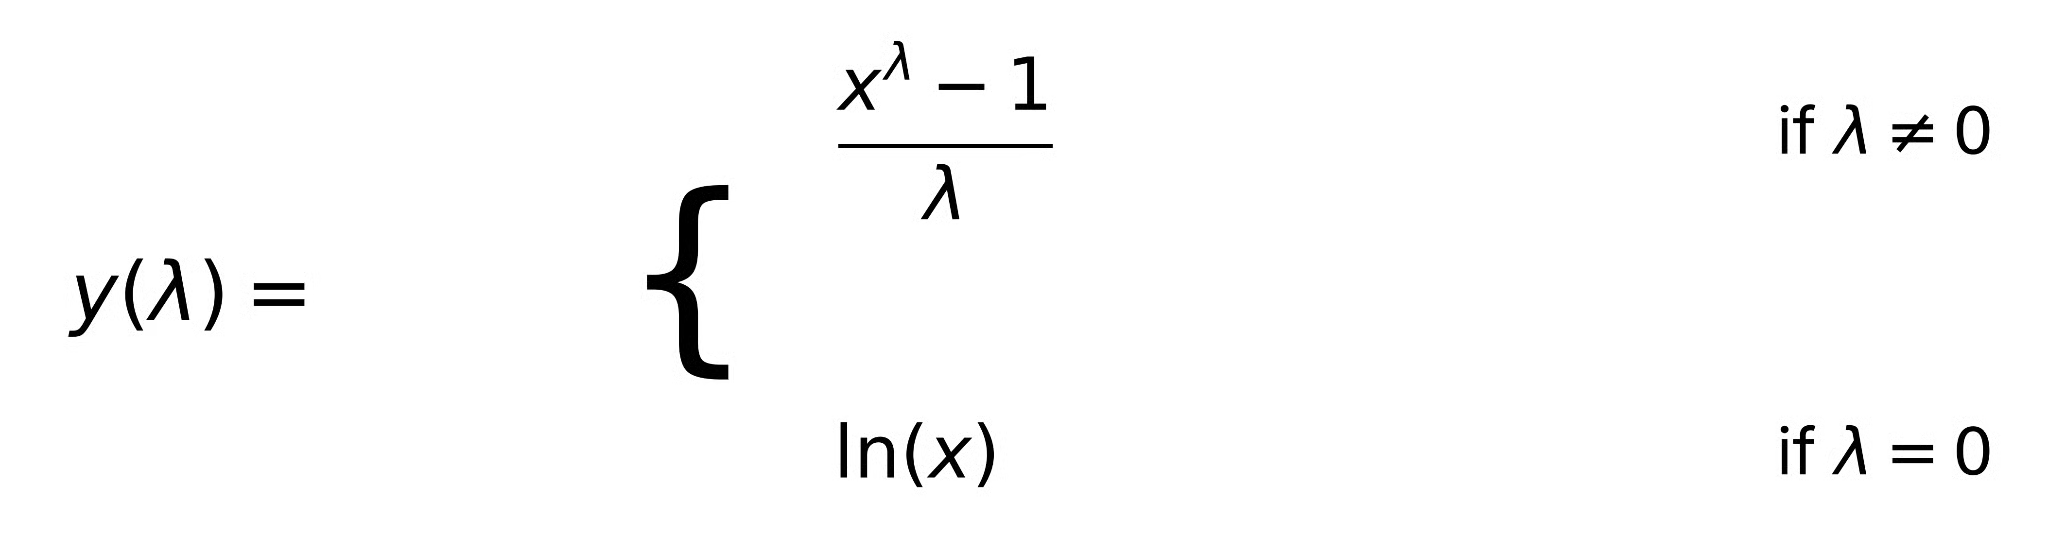
Här är x det positiva värde som transformeras och lambda är transformationsparametern. Formen (xλ - 1) / λ kan se obekant ut i början. Det är skalningskonventionen som håller transformationen kontinuerlig när lambda går mot noll. Utan den skulle du ha ett språng i kontinuiteten vid lambda = 0 och loggfallet vore helt frikopplat från resten av familjen. Med den övergår formeln smidigt till ln(x) när lambda → 0.
Bry dig inte om härledningen nu. Operativt: välj eller skatta lambda, stoppa in dina positiva värden och arbeta med det transformerade utfallet.
Lambda är inget du sätter på känsla. Du skattar den från datan. Det är detta som skiljer Box-Cox från att bara gissa ”prova logg”. Det finns en principfast statistisk procedur bakom.
Idén är att hitta den lambda som får dina data att bäst passa den antagna modellen. I en regressionskontext betyder det att hitta den lambda där den transformerade responsen bäst uppfyller modellens antaganden, vanligtvis normalitet och konstant varians hos residualerna. Du väljer inte den lambda som gör att responsens marginalfördelning ser mest normal ut isolerat. Du väljer den som fungerar bäst i modelleringskontexten. Den distinktionen är viktig, och vi återkommer till den i avsnittet om misstag.
Ett av de mest användbara diagnostiska verktygen här är en profil-sannolikhetsgraf: lambdavärden på x-axeln, log-likelihood på y-axeln. Toppen visar den skattade optimala lambda. Lika användbart är konfidensintervallet runt den toppen, vanligtvis visat som en horisontell linje vid en tröskel under maximum. Alla lambdavärden inom intervallet är statistiskt oskiljbara från optimum.
Här är en praktisk aspekt som ofta undervärderas. Om den optimala lambda är något i stil med 0,43 och lambda = 0,5 ligger inom konfidensintervallet, välj 0,5. En kvadratrots-transformation är lättare att förklara, lättare att backtransformera och förlorar nästan inget i prestanda. Samma logik gäller för 0 (logg) och 1 (ingen transformation). Tolkbarhet spelar roll, särskilt när du förklarar din modell för någon som inte vet vad lambda = 0,43 betyder.
Nu när vi vet vad lambda är och hur den väljs, låt oss omsätta detta i praktik. Först Python, sedan R.
SciPys stats-modul hanterar detta direkt. Funktionen boxcox() både skattar lambda och returnerar de transformerade värdena i ett anrop. Här är ett minimalt exempel med simulerade högerskeva data:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Här är estimated_lambda den som maximerar log-likelihood under normalitetsantagandet. Du använder sedan samma värde när du transformerar ny data för prediktion.
Observera att detta skattar lambda från responsens marginalfördelning, inte inom en regressionsmodell. För ett modelleringsflöde skulle du utvärdera lambda i modellkontext. R-exemplet nedan visar hur med MASS’ boxcox()-funktion.
I R är paketet MASS och dess funktion boxcox() byggd för regressionsarbetsflöden. Den tar ett anpassat modellobjekt och plottar profil-sannolikheten direkt, vilket passar mer naturligt eftersom du utvärderar lambda i kontexten av en modell snarare än på en fristående vektor.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R:s boxcox() plottar profil-sannolikheten automatiskt, så du får konfidensintervallet visualiserat på köpet. Det gör det enkelt att avgöra om du ska avrunda lambda till ett enklare värde.
När du har transformerat responsen och anpassat en modell ligger dina prediktioner på den transformerade skalan, inte den ursprungliga. En prediktion på 3,2 betyder 3,2 enheter av (xλ - 1) / λ, inte 3,2 enheter av intäkt.
Koefficienttolkning förändras efter transformation. På den transformerade skalan motsvarar en enhets ökning i en prediktor en viss förändring i y(λ), inte i det ursprungliga y. Om lambda är nära 0 (nära logg) kan du approximera procentuella förändringar på den ursprungliga skalan. För andra lambdavärden är relationen mer invecklad och beror på den aktuella nivån på x.
För att omvandla prediktioner tillbaka till ursprunglig skala, använd inversen:
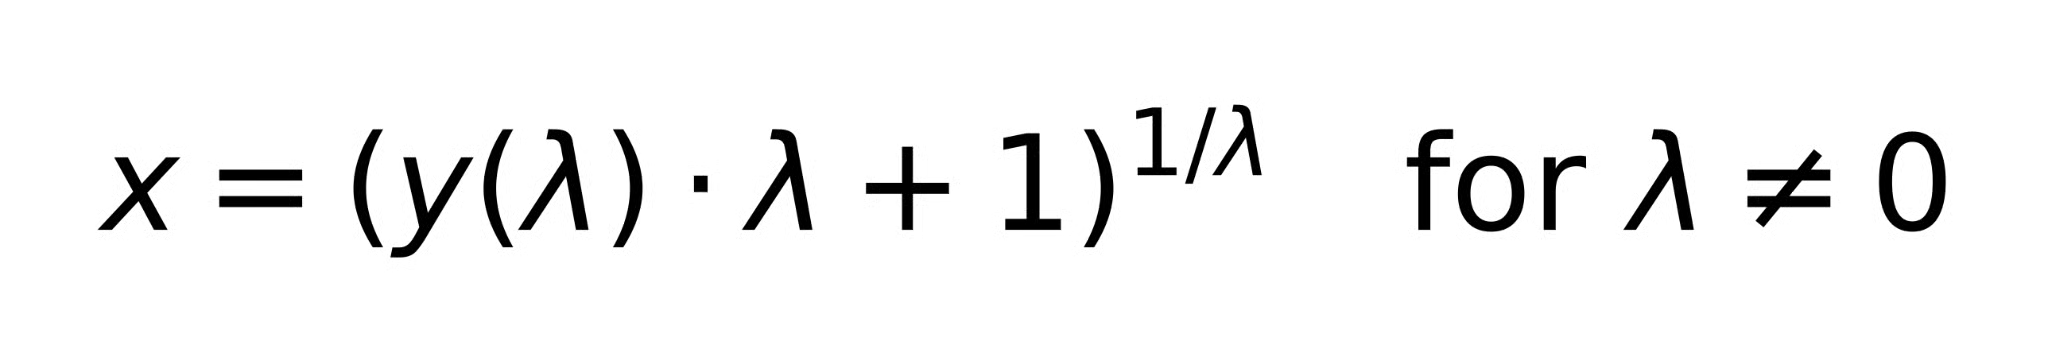
För lambda = 0 är inversen av ln(x) helt enkelt exp(y).
Att backtransformera det predikterade medelvärdet på den transformerade skalan ger dig inte en obiaserad skattning av medelvärdet på den ursprungliga skalan. Detta är en känd konsekvens av Jensens olikhet, och det spelar störst roll i sammanhang som att förutsäga medelvärden i log-linjära modeller. Att gå djupt på bias-korrektion ligger utanför vår räckvidd här. Vår Introduction to Regression in Python-kurs täcker prediktion och tolkning i regressionsmodeller mer brett om du vill ha den kontexten.
När bör du faktiskt välja Box-Cox framför alternativ du kanske redan använder?
Loggtransformationen är fallet lambda = 0 av Box-Cox. Punkt. Om du har använt loggtransformation förut har du använt ett specifikt instance av Box-Cox med lambda fixerad i stället för skattad. Fördelen med Box-Cox är att den inte låser sig vid lambda = 0 på förhand. Det sagt, om din profil-sannolikhetstopp ligger rakt på lambda = 0, använd bara logg. Ingen anledning att lägga till komplexitet.
Yeo-Johnson-transformationen är en direkt utvidgning av Box-Cox som är avsedd att hantera nollor och negativa värden. Det är den du ska välja när dina data innehåller nollor (till exempel räkningar) eller negativa värden. Transformationerna är matematiskt likartade. Yeo-Johnson släpper bara positiviteskravet. I scikit-learn stöder PowerTransformer båda, method='box-cox' och method='yeo-johnson', vilket gör det enkelt att byta.
Standardisering (z-skalning) förskjuter och skalar data: den ändrar medelvärdet till 0 och standardavvikelsen till 1. Box-Cox ändrar fördelningens form genom en icke-linjär transformation. De löser olika problem. Standardisering minskar inte skevhet eller stabiliserar varians. Box-Cox centrerar inte dina data eller gör variabler jämförbara i magnitud. Du kan göra båda i följd, transformera först och sedan standardisera, men de är inte alternativ till varandra.
En del av dessa är uppenbara i efterhand. Det hindrar dem inte från att inträffa, och några är tillräckligt subtila för att ”uppenbart” ska göra mycket jobb.
Formeln bryter ihop vid eller under noll. 0λ är 0 för positiv lambda och odefinierad för negativ lambda; log(0) är minus oändlighet. Om dina data har nollor eller negativa värden kommer Box-Cox antingen att ge fel eller tyst producera nonsens. Använd i stället Yeo-Johnson, eller lägg till en liten positiv konstant för att förskjuta datan. Det senare är en approximation som bör behandlas med viss skepsis.
Box-Cox bör tillämpas som svar på ett specifikt modelleringsproblem: icke-konstant varians, dålig linearitet, överträdda residualantaganden. Att använda den som ett automatiskt förbehandlingssteg för att få din marginalfördelning att ”se normal ut” innan du anpassar någon modell är bakvänt. Den lambda som normaliserar din respons isolerat kanske inte är den lambda som faktiskt förbättrar din modells residualer.
Att skatta lambda är bara halva jobbet. Efter att ha transformerat och anpassat igen, kontrollera dina residualdiagram på nytt. Box-Cox garanterar inte att antagandena uppfylls. Den ger dig en chans. Om residualerna fortfarande fläktar ut eller det finns kurvatur, pågår något annat.
Efter transformation beskriver koefficienterna inte längre relationer på den ursprungliga skalan. Detta snubblar många på när de rapporterar resultat eller gör prediktioner. Håll reda på vilken skala du arbetar på i varje steg.
Lambda skattad från en univariat fördelning (bara genom att titta på histogrammet över din responsvariabel) kan skilja sig från lambda skattad inom en regressionsmodell. Angreppssättet baserat på regression är det riktiga. Målet är att uppfylla residualantaganden, inte marginala fördelningsantaganden.
När du driftsätter en modell som tränats på transformerade data måste du transformera ny indata på samma sätt med samma lambda och sedan backtransformera prediktionerna. Att hoppa över något av stegen ger dig prediktioner på fel skala. Det låter självklart och glöms ändå regelbundet.
Box-Cox är en familj av transformationer, inte en enda. Lambda avgör vilket medlem av den familjen du får, och loggtransformationen är bara specialfallet lambda = 0. De flesta analytiker använder logg som standard utan att reflektera. Box-Cox gör det valet explicit och ger dig ett principfast sätt att fråga om ett annat lambdavärde faktiskt skulle tjäna modellen bättre.
Använd den när du diagnostiserar något specifikt: heteroskedasticitet i residualerna, icke-linearitet, antaganden som uppenbart inte uppfylls. Att tillämpa den automatiskt på varje responsvariabel är en vana värd att bryta. Och om dina data har nollor eller negativa värden är det inte Box-Cox-område. Det är Yeo-Johnson.
För en djupare grund i de regressionsmetoder som Box-Cox vanligtvis stödjer är vår Intermediate Regression in R-kurs och Introduction to Regression with statsmodels in Python är bra nästa steg.
Lär dig med DataCamp
{count, plural, one {Kurs} other {Kurser}}
{count, plural, one {Kurs} other {Kurser}}
{count, plural, one {Kurs} other {Kurser}}