{count, plural, one {Cursus} other {Cursussen}}
Introductie tot datavisualisatie met Seaborn
{hours} uur
184.9K
Je bouwt een lineair regressiemodel voor huizenprijzen. De residuplot ziet eruit als een megafoon (smal links, wijd uitlopend rechts). Het model draait technisch gezien wel. De resultaten zijn alleen niet betrouwbaar. Dat patroon is heteroscedasticiteit, en het is een van die schendingen die je conclusies stilletjes onderuit halen zonder een duidelijke foutmelding te geven.
Eén optie is het transformeren van de responsvariabele. En in plaats van te gokken of je een log, een wortel of een reciproke moet proberen, kun je de data laten suggereren welke het beste is. Dat is het idee achter de Box-Cox-transformatie, en dat is wat we hier behandelen: de formule, hoe je lambda kiest en hoe je het in Python en R implementeert.
De Box-Cox-transformatie is een familie van machtstransformaties voor strikt positieve data. In plaats van zelf een specifieke transformatie te kiezen, kun je zoeken over een heel bereik, elk geïndexeerd door een parameter genaamd lambda (λ).
Als lambda 0 is, krijg je een logtransformatie. Bij 0,5 krijg je iets dat lijkt op een worteltransformatie. Bij -1 zit je dicht bij een reciproke. Dit zijn allemaal speciale gevallen van dezelfde formule, wat betekent dat je niet van tevoren tussen ze hoeft te kiezen. Je schat uit de data welke het beste past.
Eén ding om meteen duidelijk over te zijn: Box-Cox maakt data niet simpelweg “normaal”. Afhankelijk van je modelprobleem kan het de variantie stabiliseren, de lineariteit tussen voorspellers en de respons verbeteren, of beter voldoen aan de aannames van je model. Het vereist ook strikt positieve inputwaarden. Nullen en negatieve waarden vallen af. Meer daarover in de sectie met beperkingen.
Voor we naar de formule gaan, is wat intuïtie handig. Stel, je hebt een variabele zoals wekelijkse omzet en die is rechts-scheef: een lange staart naar rechts, variantie die toeneemt met het gemiddelde. De vraag is welke macht van die variabele zich meer gedraagt als een goed-gedragen respons.
Verschillende waardes van lambda komen overeen met transformaties die je al kent:
De standaard Box-Cox-formulering bevat conventies voor schalen en transleren, dus beschouw dit als bekende equivalenten in plaats van letterlijk identieke formules. De log-variant (lambda = 0) wordt als een limiet behandeld. De formule schakelt daar over naar log(x) vanwege continuïteit, niet als willekeurige uitzondering.
De standaard stukgewijze formule is:
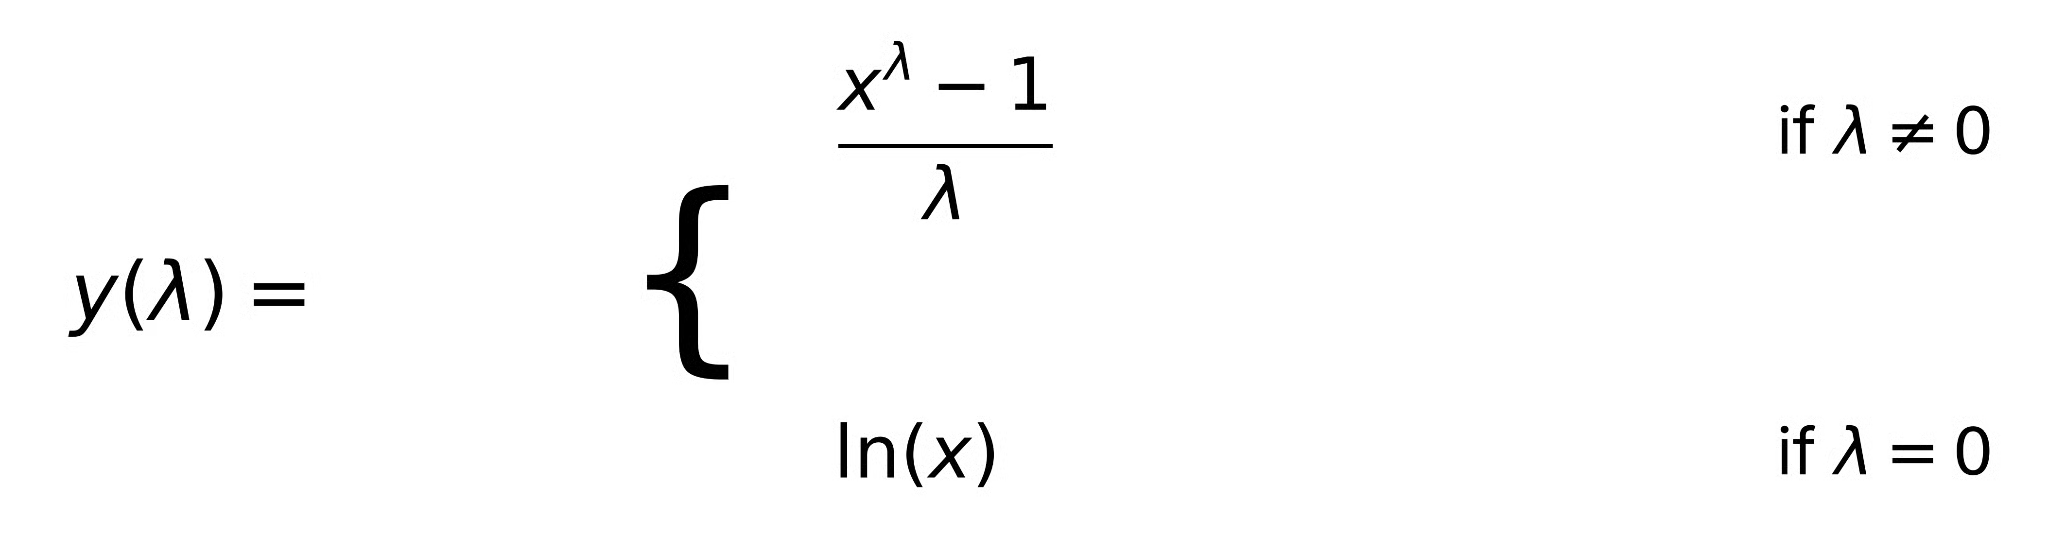
Hier is x de positieve waarde die getransformeerd wordt en is lambda de transformatieparameter. De vorm (xλ - 1) / λ oogt misschien eerst wat vreemd. Dat is de schaalconventie die de transformatie continu houdt als lambda naar nul nadert. Zonder die zou je een sprong-discontinuïteit hebben bij lambda = 0 en zou de log-variant volledig losstaan van de rest van de familie. Mét die conventie gaat de formule vloeiend over in ln(x) als lambda → 0.
Maak je nu niet druk om de afleiding. Praktisch: kies of schat lambda, vul je positieve waarden in en werk met de getransformeerde output.
Lambda stel je niet handmatig in op gevoel. Je schat hem uit de data. Dit onderscheidt Box-Cox van zomaar “probeer een log”. Er zit een principiële statistische procedure onder.
Het idee is om de lambda te vinden waarmee je data het best past bij het veronderstelde model. In een regressiecontext betekent dat de lambda vinden waarbij de getransformeerde respons het dichtst bij de modelaannames komt, meestal normaliteit en constante variantie van de residuen. Je kiest niet de lambda die de marginale verdeling van de respons in isolatie het meest normaal laat lijken. Je kiest degene die binnen de modelcontext het beste werkt. Dat onderscheid is belangrijk, en we komen erop terug bij de veelgemaakte fouten.
Een van de nuttigste diagnostieken is de profiel-likelihood-plot: lambdawaarden op de x-as, de log-likelihood op de y-as. De top geeft de geschatte optimale lambda aan. Net zo nuttig is het betrouwbaarheidsinterval rond die top, meestal weergegeven als een horizontale lijn op een drempel onder het maximum. Elke lambda binnen dat interval is statistisch niet te onderscheiden van het optimum.
Hier is een praktische overweging die vaak wordt onderschat. Als de optimale lambda zoiets is als 0,43, en lambda = 0,5 valt binnen het betrouwbaarheidsinterval, kies dan 0,5. Een worteltransformatie is makkelijker uit te leggen, makkelijker terug te transformeren en levert vrijwel geen prestatieverlies op. Hetzelfde geldt voor 0 (log) en 1 (geen transformatie). Interpreteerbaarheid telt, zeker als je je model uitlegt aan iemand die niet weet wat lambda = 0,43 betekent.
Nu we weten wat lambda is en hoe die wordt geselecteerd, gaan we het in de praktijk brengen. Eerst Python, dan R.
Het stats-module van SciPy verwerkt dit direct. De boxcox()-functie schat zowel lambda als dat ze de getransformeerde waarden in één call teruggeeft. Hier is een minimaal voorbeeld met gesimuleerde rechts-scheve data:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
De estimated_lambda hier maximaliseert de log-likelihood onder de normaliteitsaannname. Je zou dezezelfde waarde vervolgens gebruiken bij het transformeren van nieuwe data voor voorspellingen.
Let op dat dit lambda schat uit de marginale verdeling van de respons, niet binnen een regressiemodel. Voor een modelworkflow evalueer je lambda in de modelcontext. Het R-voorbeeld hieronder laat zien hoe, met MASS’ boxcox()-functie.
In R is de functie boxcox() uit het MASS-pakket gemaakt voor regressieworkflows. Hij neemt een gefit modelobject en plot direct de profiel-likelihood, wat natuurlijker past omdat je lambda evalueert in de context van een model in plaats van op een losse vector.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R’s boxcox() plot de profiel-likelihood automatisch, dus je krijgt de visualisatie van het betrouwbaarheidsinterval erbij. Dat maakt het makkelijk om te beslissen of je lambda kunt afronden naar een eenvoudigere waarde.
Zodra je de respons hebt getransformeerd en een model hebt gefit, staan je voorspellingen op de getransformeerde schaal, niet op de oorspronkelijke. Een voorspelling van 3,2 betekent 3,2 eenheden van (xλ - 1) / λ, niet 3,2 eenheden omzet.
De interpretatie van coëfficiënten verandert na transformatie. Op de getransformeerde schaal komt een toename van één eenheid in een voorspeller overeen met een bepaalde verandering in y(λ), niet in de oorspronkelijke y. Als lambda dicht bij 0 ligt (bijna-log), kun je procentuele veranderingen op de oorspronkelijke schaal benaderen. Voor andere waardes van lambda is de relatie complexer en hangt die af van het huidige niveau van x.
Om voorspellingen terug te zetten naar de oorspronkelijke schaal, pas je de inverse toe:
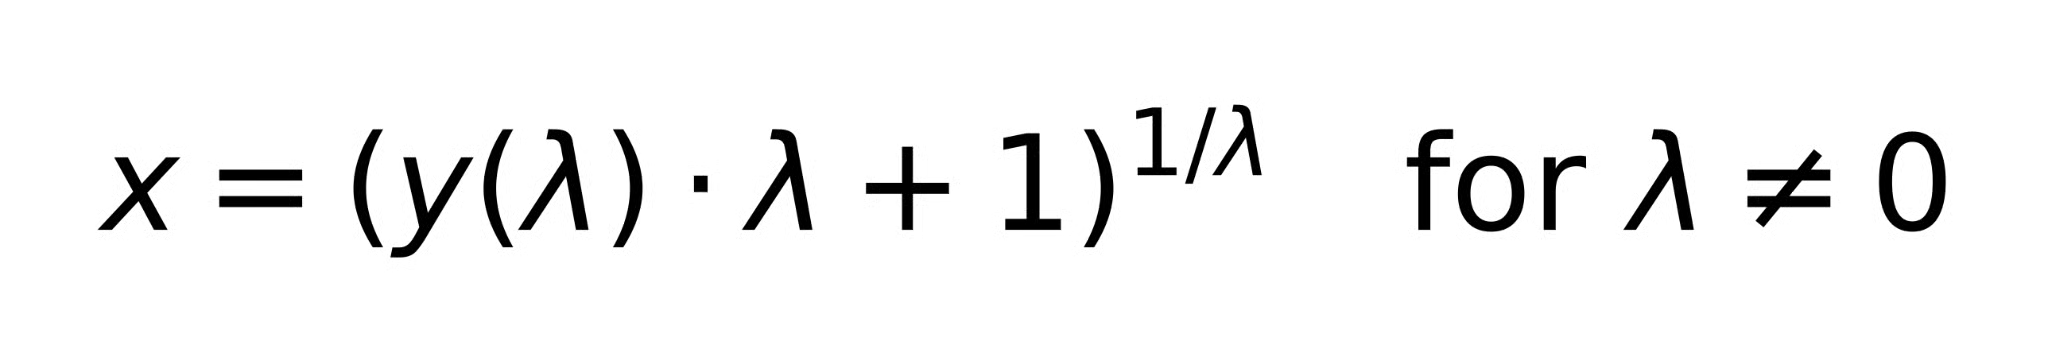
Voor lambda = 0 is de inverse van ln(x) simpelweg exp(y).
Het terugtransformeren van het voorspelde gemiddelde op de getransformeerde schaal geeft je geen onbevooroordeelde schatting van het gemiddelde op de oorspronkelijke schaal. Dit is een bekend gevolg van de ongelijkheid van Jensen en telt vooral in situaties als het voorspellen van gemiddelden in log-lineaire modellen. Diep ingaan op biascorrectie valt buiten onze scope. Onze Introduction to Regression in Python-cursus behandelt voorspellen en interpreteren in regressiemodellen breder als je die context wilt.
Wanneer kies je nu echt voor Box-Cox in plaats van alternatieven die je misschien al gebruikt?
De logtransformatie is het geval lambda = 0 van Box-Cox. Punt. Als je eerder een logtransformatie hebt gebruikt, heb je een specifieke Box-Cox-variant gebruikt met lambda gefixeerd in plaats van geschat. Het voordeel van Box-Cox is dat het niet vooraf vastlegt dat lambda = 0 is. Maar als je profiel-likelihood duidelijk piekt bij lambda = 0, gebruik dan gewoon een log. Geen reden om complexiteit toe te voegen.
De Yeo-Johnson-transformatie is een directe uitbreiding van Box-Cox die nul- en negatieve waarden aankan. Die gebruik je wanneer je data nullen (bijv. tellingen) of negatieve waarden bevat. De transformaties zijn wiskundig vergelijkbaar. Yeo-Johnson laat alleen de positiviteitsrestrictie los. In scikit-learn ondersteunt PowerTransformer beide, method='box-cox' en method='yeo-johnson', waardoor wisselen makkelijk is.
Standaardiseren (z-scoren) verschuift en schaalt data: het zet het gemiddelde op 0 en de standaarddeviatie op 1. Box-Cox verandert de vorm van de verdeling via een niet-lineaire transformatie. Ze lossen verschillende problemen op. Standaardiseren vermindert geen scheefheid en stabiliseert geen variantie. Box-Cox centreert je data niet en maakt kenmerken niet vergelijkbaar in grootte. Je kunt beide na elkaar doen, eerst transformeren en dan standaardiseren, maar het zijn geen alternatieven.
Sommige hiervan zijn achteraf gezien voor de hand liggend. Toch gebeuren ze, en een paar zijn subtiel genoeg dat “voor de hand liggend” veel werk verricht.
De formule gaat stuk bij nul of lager. 0λ is 0 voor positieve lambda en ongedefinieerd voor negatieve lambda; log(0) is min oneindig. Als je data nullen of negatieve waarden bevat, zal Box-Cox ofwel een fout geven of stilletjes onzin produceren. Gebruik in plaats daarvan Yeo-Johnson, of voeg een kleine constante verschuiving toe. Dat laatste is een benadering die je met scepsis moet behandelen.
Box-Cox pas je toe als reactie op een specifiek modelprobleem: niet-constante variantie, slechte lineariteit, geschonden residuaannames. Het als automatische preprocessingstap gebruiken om je marginale verdeling “normaal te laten lijken” vóórdat je een model fit, is de omgekeerde volgorde. De lambda die je respons in isolatie normaliseert, is mogelijk niet de lambda die je modelresiduen daadwerkelijk verbetert.
Lambda schatten is maar de helft van het werk. Controleer na transformeren en opnieuw fitten je residuplots opnieuw. Box-Cox garandeert niet dat aan de aannames wordt voldaan. Het geeft je een betere kans. Als de residuen nog steeds uitwaaieren, of er is kromming, speelt er iets anders.
Na een transformatie beschrijven coëfficiënten geen relaties meer op de oorspronkelijke schaal. Dit gaat het vaakst mis bij het rapporteren van resultaten of het maken van voorspellingen. Houd bij elke stap bij op welke schaal je werkt.
Lambda geschat uit een univariate verdeling (alleen naar het histogram van je responsvariabele kijken) kan verschillen van lambda geschat binnen een regressiemodel. De regressiegebaseerde aanpak is de juiste. Het doel is te voldoen aan residuaannames, niet aan marginale verdelingsaannames.
Als je een model uitrolt dat is getraind op getransformeerde data, moet je nieuwe inputs op dezelfde manier transformeren met dezelfde lambda en vervolgens de voorspellingen terugtransformeren. Een van beide stappen overslaan geeft voorspellingen op de verkeerde schaal. Het klinkt evident en wordt toch regelmatig vergeten.
Box-Cox is een familie van transformaties, niet één enkele. Lambda bepaalt welk familielid je krijgt, en de logtransformatie is slechts het speciale geval lambda = 0. De meeste analisten gebruiken standaard een log zonder erbij na te denken. Box-Cox maakt die keuze expliciet en geeft je een principiële manier om je af te vragen of een andere waarde van lambda het model niet beter zou dienen.
Gebruik het als je iets specifieks diagnosticeert: heteroscedasticiteit in de residuen, niet-lineariteit, aannames die duidelijk niet worden gehaald. Het automatisch toepassen op elke responsvariabele is een gewoonte die je beter kunt afleren. En als je data nullen of negatieve waarden bevat, dan is dat geen Box-Cox-terrein. Dat is Yeo-Johnson.
Voor een diepere basis in de regressiemethoden die Box-Cox doorgaans ondersteunt, zijn onze Intermediate Regression in R-cursus en Introduction to Regression with statsmodels in Python goede volgende stappen.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min