
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}
Introducere în vizualizarea datelor cu Seaborn
{hours} ore
184.9K
Construiești un model de regresie liniară pe prețuri de locuințe. Graficul reziduurilor arată ca un megafon (îngust în stânga, se lărgește în dreapta). Tehnic, modelul rulează. Doar că rezultatele nu sunt de încredere. Acest tipar este eteroscedasticitate și e una dintre abaterile care îți invalidează discret inferențele fără să arunce o eroare evidentă.
O opțiune este să transformi variabila răspuns. Și în loc să ghicești dacă să încerci logaritm, rădăcină pătrată sau reciprocă, poți lăsa datele să sugereze varianta potrivită. Asta e ideea din spatele transformării Box-Cox și despre asta vorbim aici: formula, cum alegi lambda și cum o implementezi în Python și R.
Transformarea Box-Cox este o familie de transformări de tip putere pentru date strict pozitive. În loc să alegi tu o transformare anume, îți oferă o modalitate de a căuta într-o gamă întreagă, fiecare indexată de un parametru numit lambda (λ).
Când lambda este 0, obții o transformare logaritmică. Când este 0,5, obții ceva apropiat de rădăcina pătrată. Când este -1, ești aproape de o transformare reciprocă. Toate acestea sunt cazuri speciale ale aceleiași formule, ceea ce înseamnă că nu trebuie să alegi între ele dinainte. Estimezi din date care se potrivește cel mai bine.
Un lucru important de clarificat de la început: Box-Cox nu doar „face datele normale”. În funcție de problema ta de modelare, poate ajuta la stabilizarea varianței, îmbunătățirea liniaritāții între predictori și răspuns sau satisfacerea mai bună a presupunerilor modelului. De asemenea, necesită valori de intrare strict pozitive. Zerourile și negativele nu sunt permise. Mai multe în secțiunea de limitări.
Înainte de formulă, merită să construim un pic de intuiție. Să zicem că ai o variabilă precum veniturile săptămânale din vânzări și este asimetrică spre dreapta: o coadă lungă spre dreapta, varianță care crește odată cu media. Întrebarea este ce putere a acelei variabile se comportă mai degrabă ca un răspuns bine „cuminte”.
Valorile diferite ale lui lambda corespund transformărilor pe care le știi deja:
Formularea standard Box-Cox include convenții de scalare și translație, așa că acestea sunt cel mai bine înțelese ca echivalente familiare, nu formule literal identice. Cazul log (lambda = 0) este tratat ca o limită. Acolo formula devine log(x) dintr-un motiv de continuitate, nu ca o excepție arbitrară.
Formula standard, pe bucăți, este:
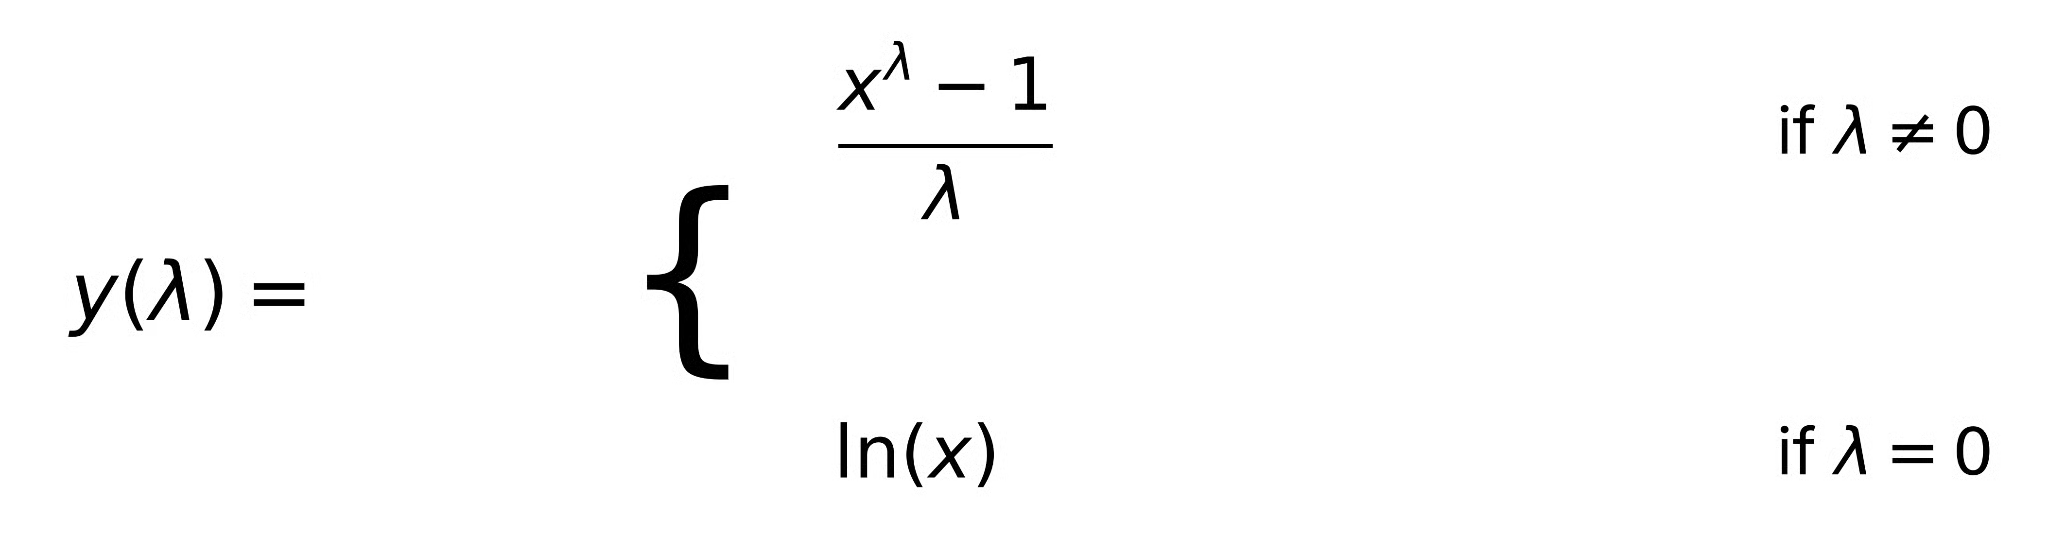
Aici, x este valoarea pozitivă transformată, iar lambda este parametrul transformării. Forma (xλ - 1) / λ poate părea neobișnuită la început. Aceasta este convenția de scalare care menține transformarea continuă pe măsură ce lambda se apropie de zero. Fără ea, ai avea o discontinuitate în salt la lambda = 0, iar cazul log ar fi complet deconectat de restul familiei. Cu ea, formula trece lin în ln(x) pe măsură ce lambda → 0.
Nu te îngrijora acum de deducție. Operațional: alegi sau estimezi lambda, introduci valorile pozitive și lucrezi cu ieșirea transformată.
Lambda nu e ceva ce setezi „din ochi”. Îl estimezi din date. Asta deosebește Box-Cox de abordarea „hai să încercăm un log”. Există o procedură statistică solidă în spate.
Ideea este să găsești lambda care face ca datele tale să se potrivească cel mai bine modelului presupus. În context de regresie, asta înseamnă să găsești lambda pentru care răspunsul transformat respectă cel mai bine presupunerile modelului, de obicei normalitatea și varianța constantă a reziduurilor. Nu alegi lambda care face ca distribuția marginală a răspunsului să pară cel mai normală în izolare. O alegi pe cea care funcționează cel mai bine în contextul modelului. Această distincție contează și revenim la ea în secțiunea de greșeli.
Unul dintre cele mai utile diagnostice aici este graficul profilului de verosimilitate: valorile lambda pe axa x, log-verosimilitatea pe axa y. Vârful îți indică lambda optim estimat. La fel de util este intervalul de încredere în jurul acelui vârf, de obicei afișat ca o linie orizontală la un prag sub maxim. Orice lambda din acel interval este nedistinct statistic de optim.
Iată un aspect practic pe care lumea îl subestimează. Dacă lambda optim este ceva precum 0,43, iar lambda = 0,5 cade în intervalul de încredere, mergi pe 0,5. O transformare prin rădăcină pătrată e mai ușor de explicat, mai ușor de inversat și pierde aproape nimic la performanță. Aceeași logică se aplică pentru 0 (log) și 1 (fără transformare). Interpretabilitatea contează, mai ales când explici modelul cuiva care nu știe ce înseamnă lambda = 0,43.
Acum că știm ce este lambda și cum se selectează, să punem în practică. Întâi Python, apoi R.
Modulul stats din SciPy se ocupă direct de asta. Funcția boxcox() estimează lambda și returnează valorile transformate într-un singur apel. Iată un exemplu minimal folosind date simulate asimetrice spre dreapta:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Aici, estimated_lambda este valoarea care maximizează log-verosimilitatea sub presupunerea de normalitate. Apoi ai folosi aceeași valoare când transformi date noi pentru predicție.
Reține că aici se estimează lambda din distribuția marginală a răspunsului, nu într-un model de regresie. Pentru un flux de modelare, ai evalua lambda în contextul modelului. Exemplul R de mai jos arată cum, folosind funcția boxcox() din MASS.
În R, funcția boxcox() din pachetul MASS este construită pentru fluxuri de lucru în regresie. Primește un obiect de model ajustat și trasează direct profilul verosimilității, ceea ce este mai natural, deoarece evaluezi lambda în contextul unui model, nu pe un vector izolat.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
Funcția boxcox() din R desenează automat profilul verosimilității, așa că primești gratuit vizualizarea intervalului de încredere. Asta face ușoară decizia de a rotunji lambda la o valoare mai simplă.
După ce ai transformat răspunsul și ai ajustat un model, predicțiile sunt pe scala transformată, nu pe cea originală. O predicție de 3,2 înseamnă 3,2 unități de (xλ - 1) / λ, nu 3,2 unități de venit.
Interpretarea coeficienților se schimbă după transformare. Pe scala transformată, o creștere de o unitate a unui predictor corespunde unei anumite schimbări în y(λ), nu în y original. Dacă lambda este aproape de 0 (aproape log), poți aproxima schimbări procentuale pe scala originală. Pentru alte valori ale lui lambda, relația e mai complicată și depinde de nivelul curent al lui x.
Pentru a converti predicțiile înapoi pe scala originală, aplică inversa:
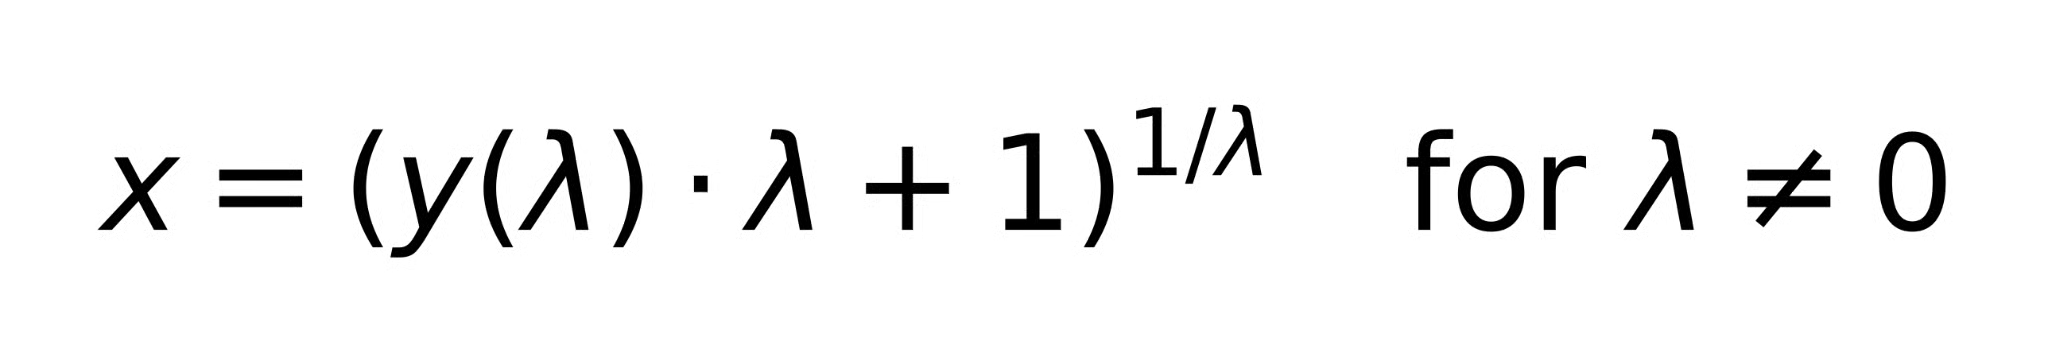
Pentru lambda = 0, inversa lui ln(x) este pur și simplu exp(y).
Re-transformarea mediei prezise pe scala transformată nu îți oferă o estimare neînclinată a mediei pe scala originală. Aceasta este o consecință cunoscută a inegalității lui Jensen și contează cel mai mult în contexte precum prognozarea valorilor medii în modele log-liniare. A intra în detalii despre corecția biasului depășește scopul nostru aici. Cursul nostru Introducere în regresie în Python acoperă mai pe larg predicția și interpretarea în modelele de regresie, dacă vrei acest context.
Când chiar ar trebui să alegi Box-Cox în locul alternativelor pe care le folosești deja?
Transformarea logaritmică este cazul lambda = 0 al lui Box-Cox. Punct. Dacă ai folosit transformarea log, ai folosit un caz specific de Box-Cox cu lambda fix, nu estimat. Avantajul Box-Cox este că nu se angajează din start la lambda = 0. Totuși, dacă vârful profilului de verosimilitate e clar la lambda = 0, folosește log. Nu are rost să adaugi complexitate.
Transformarea Yeo-Johnson este o extensie directă a lui Box-Cox, concepută pentru a gestiona zerouri și valori negative. E varianta la care apelezi când datele includ zerouri (de exemplu, numărători) sau valori negative. Transformările sunt matematic similare. Yeo-Johnson doar relaxează constrângerea de pozitivitate. În scikit-learn, PowerTransformer suportă ambele, method='box-cox' și method='yeo-johnson', ceea ce face ușor de încercat comutarea.
Standardizarea (z-scoring) deplasează și scalează datele: schimbă media la 0 și deviația standard la 1. Box-Cox schimbă forma distribuției printr-o transformare neliniară. Rezolvă probleme diferite. Standardizarea nu reduce asimetria și nu stabilizează varianța. Box-Cox nu îți centrează datele și nu face caracteristicile comparabile ca magnitudine. Le poți face pe ambele în secvență, întâi transformare, apoi standardizare, dar nu sunt alternative.
Unele dintre acestea sunt evidente în retrospectivă. Asta nu le împiedică să se întâmple, iar câteva sunt suficient de subtile încât „evident” muncește din greu.
Formula se prăbușește la sau sub zero. 0λ este 0 pentru lambda pozitiv și nedefinit pentru lambda negativ; log(0) este minus infinit. Dacă datele tale au zerouri sau negative, Box-Cox fie va da eroare, fie va produce pe furiș non-sens. Folosește Yeo-Johnson în schimb, sau adaugă o mică constantă pozitivă pentru a deplasa datele. Aceasta din urmă e o aproximație pe care merită să o privești cu scepticism.
Box-Cox ar trebui aplicată ca răspuns la o problemă specifică de modelare: varianță ne-constantă, linearitate slabă, presupuneri ale reziduurilor încălcate. Să o folosești ca pas de preprocesare automat pentru a face distribuția marginală să „pară normală” înainte de orice model este invers. Lambda care normalizează răspunsul în izolare s-ar putea să nu fie lambda care chiar îți îmbunătățește reziduurile modelului.
Estimarea lui lambda este doar jumătate din treabă. După transformare și re-ajustare, verifică din nou graficele reziduurilor. Box-Cox nu garantează că presupunerile sunt îndeplinite. Îți oferă o șansă mai bună. Dacă reziduurile tot se evazează sau apare curbură, altceva se întâmplă.
După transformare, coeficienții nu mai descriu relații pe scala originală. Asta îi încurcă pe mulți când raportează rezultate sau fac predicții. Ține evidența scării pe care lucrezi la fiecare pas.
Lambda estimat dintr-o distribuție univariată (doar uitându-te la histograma variabilei răspuns) poate diferi de lambda estimat într-un model de regresie. Abordarea bazată pe regresie este cea corectă. Ținta este să satisfaci presupunerile reziduurilor, nu pe cele ale distribuției marginale.
Când pui în producție un model antrenat pe date transformate, trebuie să transformi noile intrări la fel, folosind același lambda, și apoi să re-transformi predicțiile. Dacă sari oricare dintre pași, obții predicții pe scara greșită. Sună evident și totuși e uitat frecvent.
Box-Cox este o familie de transformări, nu una singură. Lambda determină ce membru al familiei obții, iar transformarea log este doar cazul special lambda = 0. Majoritatea analiștilor folosesc log din reflex, fără să se gândească. Box-Cox face alegerea explicită și îți oferă o metodă principială de a întreba dacă o altă valoare a lui lambda ar servi mai bine modelului.
Folosește-o când diagnostichezi ceva specific: eteroscedasticitate în reziduuri, neliniaritate, presupuneri clar neîndeplinite. Aplicarea ei automat pe fiecare variabilă răspuns e un obicei de abandonat. Iar dacă datele tale au zerouri sau negative, nu e teritoriu Box-Cox. E Yeo-Johnson.
Pentru o bază mai solidă în metodele de regresie pe care Box-Cox le sprijină de obicei, cursul nostru Intermediate Regression in R și Introduction to Regression with statsmodels in Python sunt următori pași buni.
Învață cu DataCamp
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}