
{count, plural, other {คอร์ส}}
การสร้างภาพข้อมูลด้วย Seaborn เบื้องต้น
{hours} ชม.
184.9K
กำลังสร้างแบบจำลองการถดถอยเชิงเส้นสำหรับราคาบ้าน แผนภาพเศษเหลือดูเหมือนโทรโข่ง (แคบทางซ้าย กว้างออกทางขวา) แบบจำลองรันได้ตามเทคนิค แต่ผลลัพธ์ไม่น่าเชื่อถือ นั่นคือรูปแบบของ heteroscedasticity และเป็นข้อฝ่าฝืนข้อสมมติที่ทำให้ข้อสรุปของคุณใช้ไม่ได้อย่างเงียบ ๆ โดยไม่แสดงข้อผิดพลาดชัดเจน
วิธีหนึ่งคือแปลงตัวแปรตอบสนอง และแทนที่จะเดาว่าจะลองลอก สแควร์รูต หรือรีซิโพรคอล คุณสามารถให้ข้อมูลช่วยชี้ว่าควรใช้แบบใด นั่นคือแนวคิดเบื้องหลังการแปลงแบบบ็อกซ์-ค็อกซ์ และนี่คือสิ่งที่จะกล่าวถึง: สูตร วิธีเลือกแลมบ์ดา และการใช้งานใน Python และ R
การแปลงแบบบ็อกซ์-ค็อกซ์เป็นตระกูลของการแปลงกำลัง (power transformations) สำหรับข้อมูลที่ต้องเป็นบวกเท่านั้น แทนที่จะเลือกการแปลงใดการแปลงหนึ่งเอง วิธีนี้เปิดให้ค้นหาข้ามการแปลงทั้งช่วง โดยกำกับด้วยพารามิเตอร์ที่เรียกว่าแลมบ์ดา (λ)
เมื่อแลมบ์ดาเท่ากับ 0 จะได้การแปลงแบบลอก เมื่อเท่ากับ 0.5 จะใกล้เคียงกับสแควร์รูต เมื่อเท่ากับ -1 จะใกล้กับรีซิโพรคอล ทั้งหมดนี้เป็นกรณีพิเศษของสูตรเดียวกัน ซึ่งหมายความว่าไม่ต้องตัดสินใจล่วงหน้าว่าจะใช้แบบใด แต่ประเมินจากข้อมูลว่าแบบใดเหมาะที่สุด
ขอเน้นให้ชัดตั้งแต่ต้น: บ็อกซ์-ค็อกซ์ไม่ได้แค่ "ทำให้ข้อมูลเป็นปกติ" ตามโจทย์การสร้างแบบจำลอง มันช่วยทำให้ความแปรปรวนคงที่ ปรับความเป็นเชิงเส้นระหว่างตัวทำนายกับการตอบสนองให้ดีขึ้น หรือช่วยให้เป็นไปตามข้อสมมติของแบบจำลองมากขึ้น อีกทั้งต้องใช้ค่าป้อนเข้าที่เป็นบวกเท่านั้น ค่าศูนย์และค่าติดลบใช้ไม่ได้ รายละเอียดเพิ่มเติมอยู่ในส่วนข้อจำกัด
ก่อนดูสูตร ลองสร้างสัญชาตญาณ สมมุติว่ามีตัวแปรอย่างรายได้จากการขายรายสัปดาห์ที่เบ้ขวา: หางยาวไปทางขวา ความแปรปรวนเพิ่มตามค่าเฉลี่ย คำถามคือกำลังของตัวแปรใดที่จะมีพฤติกรรมใกล้เคียงกับการตอบสนองที่จัดการได้ดีขึ้น
ค่าแลมบ์ดาที่ต่างกันสอดคล้องกับการแปลงที่คุ้นเคยอยู่แล้ว:
สูตรมาตรฐานของบ็อกซ์-ค็อกซ์มีธรรมเนียมการสเกลและการเลื่อนค่ารวมอยู่ด้วย จึงควรเข้าใจสิ่งเหล่านี้ว่าเป็นความเท่าเทียมที่คุ้นเคย ไม่ใช่สูตรเหมือนกันทุกประการ กรณีลอก (lambda = 0) ถูกปฏิบัติเป็นลิมิต สูตรจึงเปลี่ยนเป็น log(x) ที่จุดนั้นเพราะเหตุผลด้านความต่อเนื่อง ไม่ใช่ข้อยกเว้นตามอำเภอใจ
สูตรแบบแบ่งกรณีมาตรฐานมีดังนี้:
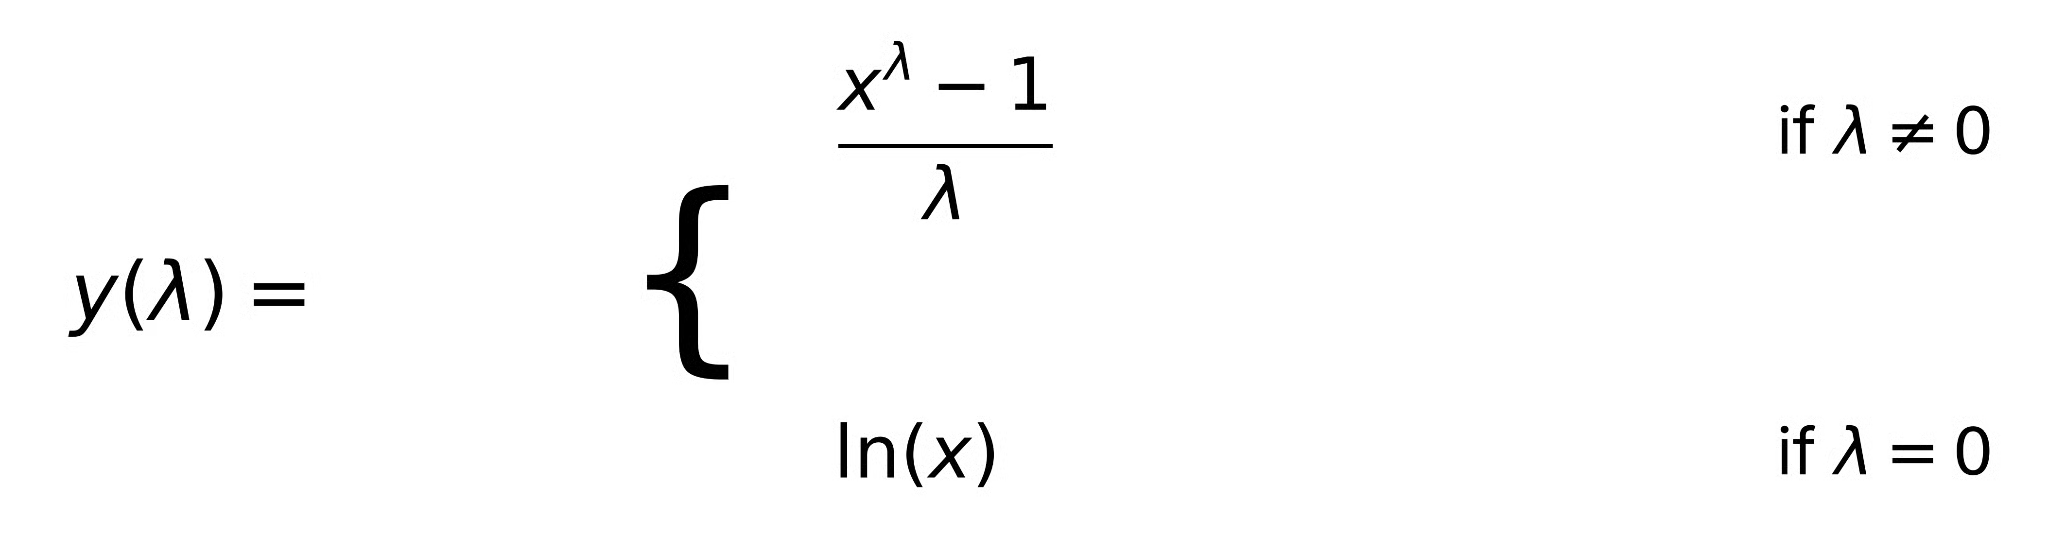
ที่นี่ x คือค่าบวกที่ถูกแปลง และแลมบ์ดาคือพารามิเตอร์การแปลง รูปแบบ (xλ - 1) / λ อาจดูไม่คุ้นตา นั่นคือนิยามการสเกลที่คงความต่อเนื่องของการแปลงเมื่อแลมบ์ดาเข้าใกล้ศูนย์ หากไม่มีสิ่งนี้ จะเกิดความไม่ต่อเนื่องแบบกระโดดที่ lambda = 0 และกรณีลอกจะถูกตัดขาดจากตระกูลที่เหลือทั้งหมด เมื่อมีแล้ว สูตรจะเปลี่ยนผ่านอย่างราบรื่นไปเป็น ln(x) เมื่อแลมบ์ดา → 0
ยังไม่ต้องกังวลกับการหาอนุพันธ์เชิงทฤษฎี ตอนใช้งาน: เลือกหรือประเมินค่าแลมบ์ดา ใส่ค่าบวกของคุณ แล้วทำงานต่อบนสเกลที่ถูกแปลง
แลมบ์ดาไม่ใช่สิ่งที่จะตั้งด้วยสัญชาตญาณ ต้องประเมินจากข้อมูล นี่คือสิ่งที่ทำให้บ็อกซ์-ค็อกซ์ต่างจากการเดาว่า "ลองลอก" มีวิธีการทางสถิติที่เป็นหลักการรองรับ
แนวคิดคือหาแลมบ์ดาที่ทำให้ข้อมูลเหมาะสมที่สุดกับแบบจำลองที่สมมติไว้ ในบริบทของการถดถอย นั่นหมายถึงการหาแลมบ์ดาที่ทำให้การตอบสนองที่ถูกแปลงสอดคล้องกับข้อสมมติของแบบจำลองมากที่สุด โดยทั่วไปคือเศษเหลือมีการกระจายปกติและความแปรปรวนคงที่ ไม่ได้เลือกแลมบ์ดาที่ทำให้การกระจายชายขอบของการตอบสนองดูเป็นปกติมากที่สุดโดยลำพัง แต่เลือกค่าที่เหมาะที่สุดในบริบทของการสร้างแบบจำลอง ความแตกต่างนี้สำคัญ และจะกลับมาพูดถึงในส่วนข้อผิดพลาด
หนึ่งในการวินิจฉัยที่มีประโยชน์ที่สุดคือกราฟโปรไฟล์ไลเคลิฮูด: ค่าแลมบ์ดาบนแกน x และล็อกไลเคลิฮูดบนแกน y จุดสูงสุดบอกแลมบ์ดาที่เหมาะที่สุดที่ประมาณได้ ช่วงความเชื่อมั่นรอบจุดสูงสุดนั้นก็มีประโยชน์มาก โดยมักแสดงเป็นเส้นแนวนอนที่ระดับต่ำกว่าค่าสูงสุด ค่าของแลมบ์ดาใด ๆ ภายในช่วงนี้ถือว่าไม่แตกต่างเชิงสถิติจากค่าที่เหมาะที่สุด
นี่คือข้อพิจารณาเชิงปฏิบัติที่มักถูกให้ความสำคัญน้อย หากแลมบ์ดาที่เหมาะที่สุดได้ประมาณ 0.43 และ lambda = 0.5 อยู่ในช่วงความเชื่อมั่น ให้เลือก 0.5 การแปลงแบบสแควร์รูตอธิบายง่ายกว่า กลับสู่สเกลเดิมง่ายกว่า และแทบไม่เสียประสิทธิภาพ เหตุผลเดียวกันนี้ใช้ได้กับ 0 (ลอก) และ 1 (ไม่แปลง) ความสามารถในการอธิบายสำคัญ โดยเฉพาะเมื่ออธิบายแบบจำลองให้ผู้ที่ไม่คุ้นกับค่าแลมบ์ดา = 0.43 ฟัง
เมื่อเข้าใจว่าแลมบ์ดาคืออะไรและเลือกอย่างไร มาลงมือปฏิบัติ เริ่มที่ Python แล้วต่อด้วย R
มอดูล stats ของ SciPy จัดการได้โดยตรง ฟังก์ชัน boxcox() ทั้งประมาณค่าแลมบ์ดาและคืนค่าข้อมูลที่ถูกแปลงในครั้งเดียว ตัวอย่างสั้น ๆ ต่อไปนี้ใช้ข้อมูลที่เบ้ขวาจำลองขึ้น:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
ตัวแปร estimated_lambda ที่ได้คือค่าที่ทำให้ล็อกไลเคลิฮูดสูงสุดภายใต้สมมติฐานความเป็นปกติ จากนั้นควรใช้ค่านี้เมื่อแปลงข้อมูลใหม่สำหรับการพยากรณ์
โปรดทราบว่านี่คือการประมาณแลมบ์ดาจากการกระจายชายขอบของตัวตอบสนอง ไม่ใช่ภายในแบบจำลองการถดถอย สำหรับเวิร์กโฟลว์การสร้างแบบจำลอง ควรประเมินแลมบ์ดาในบริบทของแบบจำลอง ตัวอย่าง R ด้านล่างแสดงการใช้ boxcox() ของ MASS
ใน R ฟังก์ชัน boxcox() ของแพ็กเกจ MASS ถูกออกแบบมาสำหรับเวิร์กโฟลว์การถดถอย โดยรับออบเจ็กต์แบบจำลองที่ฟิตแล้วและวาดกราฟโปรไฟล์ไลเคลิฮูดโดยตรง ซึ่งเหมาะกว่าเพราะคุณกำลังประเมินแลมบ์ดาในบริบทของแบบจำลองแทนที่จะเป็นเวกเตอร์เดี่ยว ๆ
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
ฟังก์ชัน boxcox() ของ R จะวาดกราฟโปรไฟล์ไลเคลิฮูดโดยอัตโนมัติ จึงได้ภาพช่วงความเชื่อมั่นมาพร้อมกัน ทำให้ตัดสินใจได้ง่ายขึ้นว่าจะปัดแลมบ์ดาเป็นค่าที่ง่ายต่อการสื่อสารหรือไม่
เมื่อแปลงตัวแปรตอบสนองและฟิตแบบจำลองแล้ว ค่าพยากรณ์จะอยู่บนสเกลที่ถูกแปลง ไม่ใช่สเกลเดิม การพยากรณ์ 3.2 หมายถึง 3.2 หน่วยของ (xλ - 1) / λ ไม่ใช่ 3.2 หน่วยของรายได้
การตีความค่าสัมประสิทธิ์เปลี่ยนไปหลังการแปลง บนสเกลที่แปลงแล้ว การเพิ่มตัวทำนายหนึ่งหน่วยสอดคล้องกับการเปลี่ยนแปลงของ y(λ) ไม่ใช่ y เดิม หากแลมบ์ดาใกล้ 0 (ใกล้ลอก) สามารถประมาณการเปลี่ยนแปลงเชิงร้อยละบนสเกลเดิมได้ สำหรับค่าแลมบ์ดาอื่น ๆ ความสัมพันธ์จะซับซ้อนกว่าและขึ้นกับระดับของ x ปัจจุบัน
เพื่อแปลงค่าพยากรณ์กลับสู่สเกลเดิม ให้ใช้ฟังก์ชันผกผัน:
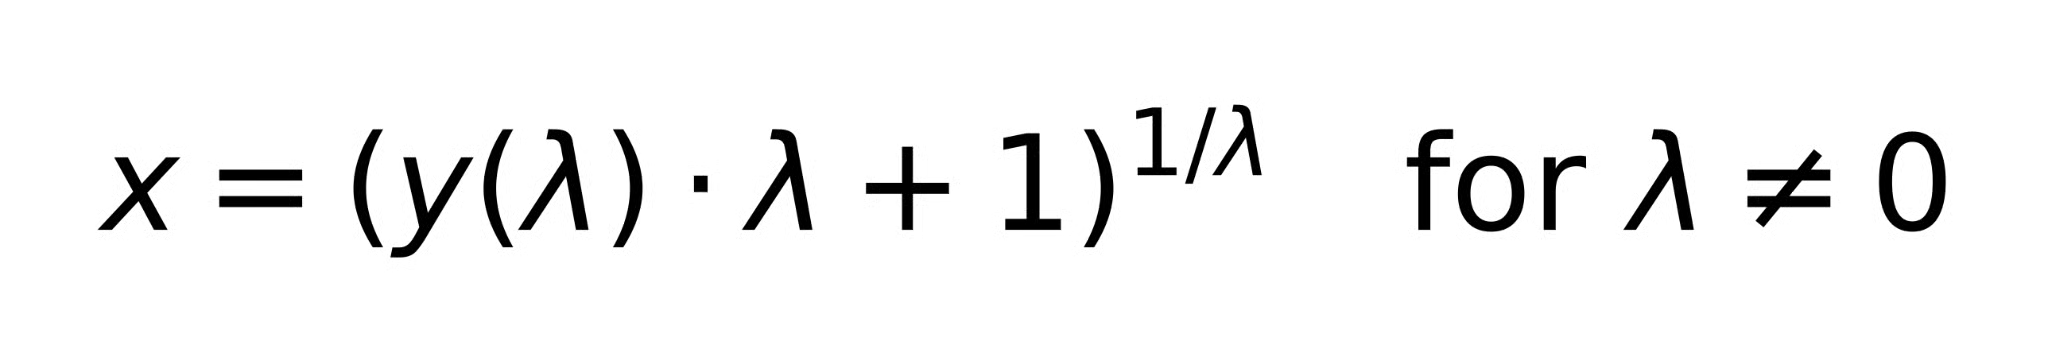
สำหรับ lambda = 0 ฟังก์ชันผกผันของ ln(x) คือ exp(y)
การแปลงกลับค่าเฉลี่ยที่พยากรณ์บนสเกลที่แปลงแล้วไม่ได้ให้ค่าประมาณแบบไม่มีอคติของค่าเฉลี่ยบนสเกลเดิม เป็นผลที่ทราบกันดีตามอสมการของเจนเซน และสำคัญมากในบริบทอย่างการพยากรณ์ค่าเฉลี่ยในแบบจำลองลอก-เชิงเส้น การแก้อคติอย่างละเอียดเกินขอบเขตที่กล่าวถึงได้ที่นี่ หลักสูตร Introduction to Regression in Python ครอบคลุมการพยากรณ์และการตีความในแบบจำลองการถดถอยในภาพรวม หากต้องการบริบทเพิ่มเติม
ควรเลือกใช้บ็อกซ์-ค็อกซ์เมื่อใดเมื่อเทียบกับทางเลือกที่อาจคุ้นเคยอยู่แล้ว?
การแปลงแบบลอกคือกรณี lambda = 0 ของบ็อกซ์-ค็อกซ์ จบ หากเคยใช้การแปลงแบบลอกมาก่อน เท่ากับว่าใช้กรณีเฉพาะของบ็อกซ์-ค็อกซ์ที่ตรึงแลมบ์ดาไว้แทนการประมาณ ข้อดีของบ็อกซ์-ค็อกซ์คือไม่ผูกมัดกับ lambda = 0 ล่วงหน้า อย่างไรก็ดี หากโปรไฟล์ไลเคลิฮูดพุ่งสูงสุดที่ lambda = 0 ก็ใช้ลอกไปเลย ไม่ต้องเพิ่มความซับซ้อน
การแปลงแบบเยโอ-จอห์นสันเป็นส่วนขยายตรงของบ็อกซ์-ค็อกซ์ที่ออกแบบมาเพื่อรองรับศูนย์และค่าติดลบ เหมาะเมื่อข้อมูลมีศูนย์ (เช่น นับจำนวน) หรือค่าติดลบ การแปลงทั้งสองมีความคล้ายกันทางคณิตศาสตร์ เยโอ-จอห์นสันเพียงผ่อนข้อจำกัดเรื่องค่าบวก ใน scikit-learn, PowerTransformer รองรับทั้ง method='box-cox' และ method='yeo-johnson' ทำให้ลองสลับใช้งานได้ง่าย
การทำมาตรฐาน (z-scoring) คือการเลื่อนและสเกลข้อมูล: เปลี่ยนค่าเฉลี่ยเป็น 0 และส่วนเบี่ยงเบนมาตรฐานเป็น 1 บ็อกซ์-ค็อกซ์เปลี่ยนรูปร่างการกระจายผ่านการแปลงไม่เชิงเส้น ทั้งสองแก้ปัญหาคนละแบบ การทำมาตรฐานไม่ลดความเบ้หรือทำให้ความแปรปรวนคงที่ บ็อกซ์-ค็อกซ์ไม่จัดศูนย์ข้อมูลหรือทำให้ฟีเจอร์มีขนาดใกล้เคียงกัน อาจทำทั้งคู่ต่อเนื่องกันได้ โดยแปลงก่อนแล้วค่อยมาตรฐาน แต่ไม่ใช่ตัวเลือกทดแทนกัน
บางอย่างดูชัดเจนเมื่อมองย้อนกลับ แต่นั่นก็ไม่ทำให้มันไม่เกิดขึ้น และบางข้อก็ละเอียดอ่อนจนคำว่า “ชัดเจน” ต้องทำงานหนัก
สูตรใช้ไม่ได้ที่ศูนย์หรือต่ำกว่านั้น 0λ เท่ากับ 0 เมื่อแลมบ์ดาเป็นบวกและไม่กำหนดค่าเมื่อแลมบ์ดาเป็นลบ; log(0) มีค่าเป็นลบอนันต์ หากข้อมูลมีศูนย์หรือค่าติดลบ บ็อกซ์-ค็อกซ์จะเกิดข้อผิดพลาดหรือได้ค่าที่ไร้ความหมายอย่างเงียบ ๆ ให้ใช้เยโอ-จอห์นสันแทน หรือเพิ่มค่าคงที่บวกเล็กน้อยเพื่อเลื่อนข้อมูล วิธีหลังเป็นการประมาณที่ควรใช้ด้วยความระมัดระวัง
ควรใช้บ็อกซ์-ค็อกซ์เพื่อตอบโจทย์ปัญหาการสร้างแบบจำลองเฉพาะ: ความแปรปรวนไม่คงที่ ความเป็นเชิงเส้นไม่ดี การละเมิดข้อสมมติของเศษเหลือ การใช้เป็นขั้นตอนพรีโพรเซสโดยอัตโนมัติเพื่อทำให้การกระจายชายขอบ “ดูเป็นปกติ” ก่อนฟิตแบบจำลองใด ๆ เป็นการทำกลับด้าน แลมบ์ดาที่ทำให้ตัวตอบสนองปกติเมื่อพิจารณาโดด ๆ อาจไม่ใช่แลมบ์ดาที่ปรับปรุงเศษเหลือของแบบจำลองจริง
การประมาณแลมบ์ดาเป็นเพียงครึ่งทาง หลังแปลงและฟิตใหม่แล้ว ควรตรวจแผนภาพเศษเหลืออีกครั้ง บ็อกซ์-ค็อกซ์ไม่ได้รับประกันว่าจะเป็นไปตามข้อสมมติ แต่ให้โอกาสที่ดีกว่า หากเศษเหลือยังแผ่ออกหรือมีความโค้ง แสดงว่ายังมีปัจจัยอื่น
หลังการแปลง ค่าสัมประสิทธิ์ไม่อธิบายความสัมพันธ์บนสเกลเดิมอีกต่อไป ประเด็นนี้มักสะดุดเมื่อรายงานผลหรือทำการพยากรณ์ ควรติดตามว่าแต่ละขั้นกำลังทำงานบนสเกลใด
แลมบ์ดาที่ประมาณจากการกระจายตัวแปรเดี่ยว (ดูเพียงฮิสโตแกรมของตัวตอบสนอง) อาจต่างจากแลมบ์ดาที่ประมาณภายในแบบจำลองการถดถอย วิธีที่ถูกต้องคือแบบอิงการถดถอย เป้าหมายคือทำให้ข้อสมมติของเศษเหลือพอเหมาะ ไม่ใช่ข้อสมมติของการกระจายชายขอบ
เมื่อใช้งานแบบจำลองที่ฝึกด้วยข้อมูลที่ถูกแปลง ต้องแปลงข้อมูลใหม่ในแบบเดียวกันโดยใช้แลมบ์ดาเดียวกัน และแปลงกลับค่าพยากรณ์ หากข้ามขั้นตอนใดจะได้ค่าพยากรณ์บนสเกลที่ไม่ถูกต้อง ฟังดูชัดเจนแต่ก็ถูกลืมอยู่บ่อยครั้ง
บ็อกซ์-ค็อกซ์เป็นตระกูลของการแปลง ไม่ใช่การแปลงเดียว แลมบ์ดากำหนดว่าสมาชิกใดของตระกูลที่ได้ และการแปลงแบบลอกเป็นเพียงกรณีเฉพาะ lambda = 0 นักวิเคราะห์ส่วนใหญ่ใช้ลอกโดยอัตโนมัติโดยไม่คิดมาก บ็อกซ์-ค็อกซ์ทำให้ทางเลือกนั้นชัดเจนและให้แนวทางเชิงหลักการในการถามว่าค่าแลมบ์ดาอื่นจะรับใช้แบบจำลองได้ดีกว่าหรือไม่
ใช้เมื่อกำลังวินิจฉัยปัญหาเฉพาะ: heteroscedasticity ในเศษเหลือ ความไม่เป็นเส้นตรง ข้อสมมติที่ไม่ผ่านชัดเจน การใช้โดยอัตโนมัติกับทุกตัวตอบสนองเป็นนิสัยที่ควรเลิก และหากข้อมูลมีศูนย์หรือค่าติดลบ ไม่ใช่พื้นที่ของบ็อกซ์-ค็อกซ์ แต่เป็นของเยโอ-จอห์นสัน
เพื่อปูพื้นฐานลึกขึ้นในวิธีการถดถอยที่บ็อกซ์-ค็อกซ์มักสนับสนุน หลักสูตร Intermediate Regression in R และ Introduction to Regression with statsmodels in Python เป็นก้าวถัดไปที่ดี
เรียนรู้กับ DataCamp
{count, plural, other {คอร์ส}}
{count, plural, other {คอร์ส}}
{count, plural, other {คอร์ส}}