
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}
Wprowadzenie do wizualizacji danych z Seaborn
{hours} godz.
184.9K
Budujesz model regresji liniowej dla cen mieszkań. Wykres reszt wygląda jak megafon (wąsko po lewej, szeroko po prawej). Model technicznie się uruchamia. Wyniki po prostu nie są wiarygodne. Ten wzorzec to heteroscedastyczność, i to jedna z tych niespełnień założeń, które po cichu unieważniają wnioski, nie zgłaszając oczywistego błędu.
Jedną z opcji jest transformacja zmiennej zależnej. I zamiast zgadywać, czy spróbować logarytmu, pierwiastka czy odwrotności, możesz pozwolić danym zasugerować właściwą. Na tym polega transformacja Boxa-Coxa i tym się tu zajmiemy: wzorem, wyborem lambdy oraz implementacją w Pythonie i R.
Transformacja Boxa-Coxa to rodzina transformacji potęgowych dla danych ściśle dodatnich. Zamiast samodzielnie wybierać konkretną transformację, pozwala przeszukać cały ich zakres, zindeksowany parametrem zwanym lambdą (λ).
Gdy lambda równa się 0, otrzymujesz transformację logarytmiczną. Gdy równa się 0,5, dostajesz coś zbliżonego do pierwiastka kwadratowego. Gdy równa się -1, jesteś blisko odwrotności. Wszystkie te przypadki są szczególnymi wersjami tego samego wzoru, więc nie musisz między nimi wybierać z góry. Szacujesz, która najlepiej pasuje na podstawie danych.
Warto od początku jasno powiedzieć jedno: Box-Cox nie po prostu „normalizuje danych”. W zależności od problemu modelowania, może pomóc stabilizować wariancję, poprawić liniowość między predyktorami a odpowiedzią albo lepiej spełnić założenia modelu. Wymaga też ściśle dodatnich wartości wejściowych. Zera i wartości ujemne odpadają. Więcej o tym w sekcji ograniczeń.
Zanim przejdziemy do wzoru, zbudujmy intuicję. Masz zmienną jak tygodniowe przychody ze sprzedaży i jest prawoskośna: długi ogon w prawo, wariancja rosnąca wraz ze średnią. Pytanie brzmi, jaka potęga tej zmiennej zachowuje się bardziej jak „porządna” odpowiedź.
Różne wartości lambdy odpowiadają transformacjom, które już znasz:
Standardowa formuła Boxa-Coxa obejmuje konwencje skalowania i translacji, więc najlepiej traktować je jako znajome odpowiedniki, a nie literalnie identyczne wzory. Przypadek logarytmu (lambda = 0) traktuje się jako granicę. Wzór przechodzi tam na log(x) z powodu ciągłości, a nie jako arbitralny wyjątek.
Standardowy wzór przedziałowy to:
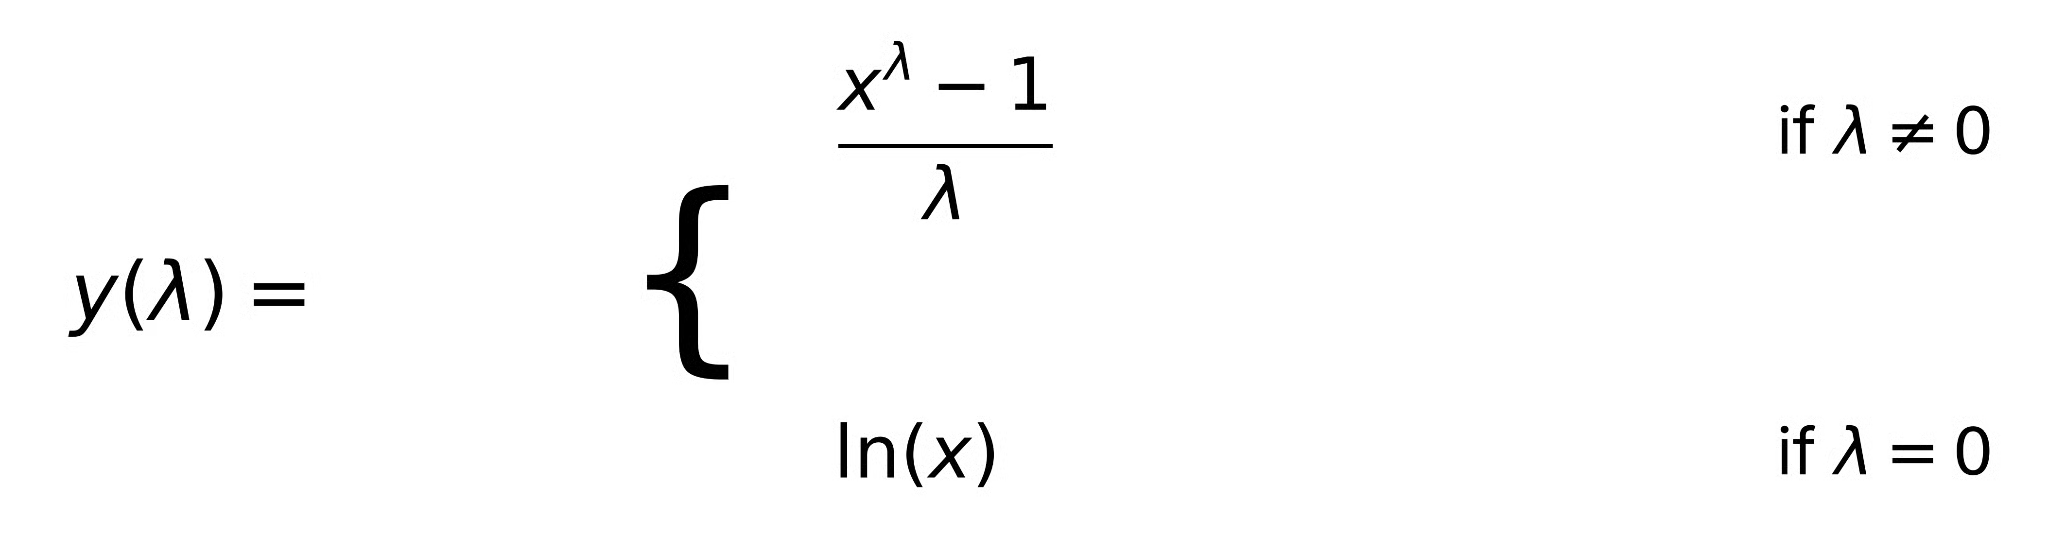
Tutaj x to dodatnia wartość poddawana transformacji, a lambda to parametr transformacji. Postać (xλ - 1) / λ może początkowo wyglądać obco. To konwencja skalowania, która zapewnia ciągłość transformacji, gdy lambda dąży do zera. Bez niej miałbyś skok nieciągłości przy lambda = 0 i przypadek log byłby całkowicie oderwany od reszty rodziny. Z nią wzór płynnie przechodzi w ln(x), gdy lambda → 0.
Na razie nie przejmuj się wyprowadzeniem. Operacyjnie: wybierz lub oszacuj lambdę, podstaw swoje dodatnie wartości i pracuj na przetransformowanym wyniku.
Lambdy nie ustawiasz „na wyczucie”. Szacujesz ją z danych. Tym Box-Cox różni się od zgadywania „spróbuj loga”. Pod spodem jest ugruntowana procedura statystyczna.
Chodzi o znalezienie lambdy, która sprawia, że twoje dane najlepiej pasują do założonego modelu. W kontekście regresji oznacza to znalezienie lambdy, przy której przetransformowana odpowiedź najlepiej spełnia założenia modelu, zwykle normalność i stałość wariancji reszt. Nie wybierasz lambdy, która sprawia, że brzegowy rozkład odpowiedzi „najbardziej” wygląda normalnie w oderwaniu od modelu. Wybierasz tę, która najlepiej działa w kontekście modelowania. Ta różnica ma znaczenie i wrócimy do niej w sekcji o błędach.
Jedną z najprzydatniejszych diagnostyk jest wykres profilu wiarygodności: wartości lambdy na osi X, log-wiarygodność na osi Y. Szczyt wskazuje oszacowaną optymalną lambdę. Równie przydatny jest przedział ufności wokół tego szczytu, zwykle pokazany jako pozioma linia na progu poniżej maksimum. Każda lambda w tym przedziale jest statystycznie nieodróżnialna od optimum.
Oto praktyczna kwestia, którą często się niedoszacowuje. Jeśli optymalna lambda to np. 0,43, a lambda = 0,5 mieści się w przedziale ufności, wybierz 0,5. Transformacja pierwiastkowa jest łatwiejsza do wyjaśnienia, łatwiejsza do odwrócenia i prawie nic nie traci na skuteczności. Ta sama logika dotyczy 0 (log) i 1 (brak transformacji). Interpretowalność ma znaczenie, zwłaszcza gdy tłumaczysz model komuś, kto nie wie, co znaczy lambda = 0,43.
Skoro wiemy, czym jest lambda i jak się ją wybiera, przejdźmy do praktyki. Najpierw Python, potem R.
Moduł stats w SciPy obsługuje to bezpośrednio. Funkcja boxcox() jednocześnie szacuje lambdę i zwraca przetransformowane wartości w jednym wywołaniu. Oto minimalny przykład z użyciem symulowanych prawoskośnych danych:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Tutaj estimated_lambda to wartość maksymalizująca log-wiarygodność przy założeniu normalności. Następnie użyjesz tej samej wartości, transformując nowe dane do predykcji.
Zauważ, że tutaj lambda jest szacowana z brzegowego rozkładu odpowiedzi, a nie w modelu regresji. W przepływie modelowania oceniasz lambdę w kontekście modelu. Przykład w R poniżej pokazuje jak, z użyciem funkcji boxcox() z pakietu MASS.
W R funkcja boxcox() z pakietu MASS jest zbudowana pod przepływy regresyjne. Przyjmuje dopasowany obiekt modelu i rysuje bezpośrednio profil wiarygodności, co lepiej pasuje, bo oceniasz lambdę w kontekście modelu, a nie na samodzielnym wektorze.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
Funkcja boxcox() w R automatycznie rysuje profil wiarygodności, więc „za darmo” dostajesz wizualizację przedziału ufności. To ułatwia decyzję, czy zaokrąglić lambdę do prostszej wartości.
Po przetransformowaniu odpowiedzi i dopasowaniu modelu twoje predykcje są w skali przekształconej, a nie oryginalnej. Predykcja 3,2 oznacza 3,2 jednostki (xλ - 1) / λ, a nie 3,2 jednostki przychodu.
Interpretacja współczynników zmienia się po transformacji. W skali przekształconej jednostkowy wzrost predyktora odpowiada określonej zmianie w y(λ), a nie w oryginalnym y. Jeśli lambda jest bliska 0 (blisko loga), możesz przybliżać zmiany procentowe w skali oryginalnej. Dla innych wartości lambdy zależność jest bardziej złożona i zależy od bieżącego poziomu x.
Aby przeliczyć predykcje z powrotem do skali oryginalnej, zastosuj odwrotność:
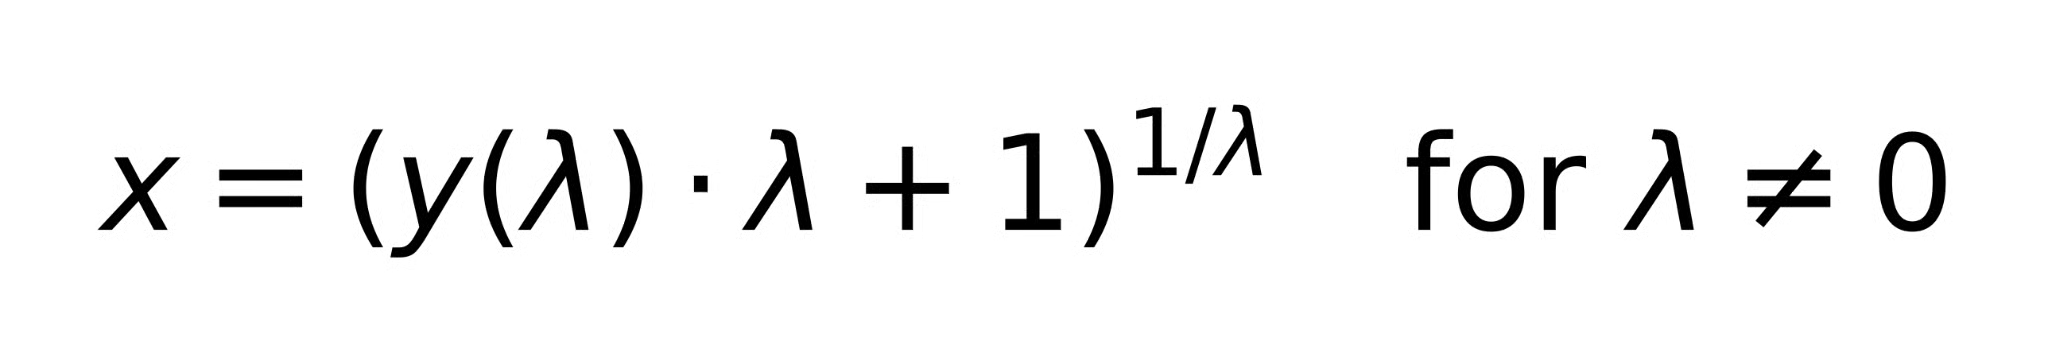
Dla lambda = 0 odwrotnością ln(x) jest po prostu exp(y).
Odwrotne przekształcenie przewidzianej średniej w skali przekształconej nie daje nieobciążonego oszacowania średniej w skali oryginalnej. To znana konsekwencja nierówności Jensena i ma największe znaczenie np. przy prognozowaniu średnich w modelach log-liniowych. Głębsza korekta obciążenia wykracza poza nasz zakres. Nasz kurs Wprowadzenie do regresji w Pythonie szerzej omawia predykcję i interpretację w modelach regresji, jeśli chcesz poznać kontekst.
Kiedy faktycznie sięgnąć po Boxa-Coxa, a kiedy po alternatywy, których już używasz?
Transformacja logarytmiczna to przypadek lambda = 0 w Boxie-Coxie. Kropka. Jeśli używałeś logarytmu, używałeś konkretnej wersji Boxa-Coxa z lambdą ustaloną, a nie oszacowaną. Przewaga Boxa-Coxa polega na tym, że nie zakłada z góry lambda = 0. Jeśli jednak profil wiarygodności ma wyraźny szczyt przy lambda = 0, po prostu użyj loga. Nie ma powodu dodawać złożoności.
Transformacja Yeo-Johnsona to bezpośrednie rozszerzenie Boxa-Coxa zaprojektowane do obsługi zer i wartości ujemnych. Sięgnij po nią, gdy twoje dane zawierają zera (np. zliczenia) lub wartości ujemne. Transformacje są matematycznie podobne. Yeo-Johnson po prostu luzuje wymóg dodatniości. W scikit-learn PowerTransformer obsługuje obie metody, method='box-cox' i method='yeo-johnson', co ułatwia przełączanie.
Standaryzacja (z-score) przesuwa i skaluje dane: zmienia średnią na 0 i odchylenie standardowe na 1. Box-Cox zmienia kształt rozkładu poprzez nieliniową transformację. Rozwiązują różne problemy. Standaryzacja nie redukuje skośności ani nie stabilizuje wariancji. Box-Cox nie centruje danych ani nie ujednolica skali cech. Możesz zrobić oba po kolei: najpierw transformacja, potem standaryzacja, ale to nie są alternatywy.
Niektóre z nich są oczywiste post factum. To nie znaczy, że się nie zdarzają, a kilka jest na tyle subtelnych, że „oczywiste” to spore nadużycie.
Wzór załamuje się przy zerze i poniżej. 0λ to 0 dla dodatniej lambdy i niezdefiniowane dla ujemnej; log(0) to minus nieskończoność. Jeśli twoje dane mają zera lub ujemne wartości, Box-Cox albo zwróci błąd, albo po cichu wygeneruje nonsens. Użyj Yeo-Johnsona albo dodaj małą dodatnią stałą jako przesunięcie. To drugie to przybliżenie, do którego warto podchodzić z rezerwą.
Box-Coxa stosuj w odpowiedzi na konkretny problem modelowania: niestałą wariancję, słabą liniowość, naruszone założenia reszt. Używanie go jako automatycznego kroku wstępnego, by brzegowy rozkład „wyglądał normalnie” przed dopasowaniem jakiegokolwiek modelu, to odwrócenie kolejności. Lambda, która normalizuje odpowiedź w oderwaniu, może nie być tą, która faktycznie poprawia reszty modelu.
Oszacowanie lambdy to tylko połowa pracy. Po transformacji i ponownym dopasowaniu znów sprawdź wykresy reszt. Box-Cox nie gwarantuje spełnienia założeń. Daje ci szansę. Jeśli reszty nadal się wachlują albo widać krzywiznę, dzieje się coś innego.
Po transformacji współczynniki nie opisują już zależności w skali oryginalnej. Najczęściej potyka to osoby przy raportowaniu wyników lub podczas predykcji. Na każdym etapie pilnuj, w jakiej skali pracujesz.
Lambda oszacowana z rozkładu jednowymiarowego (patrząc tylko na histogram zmiennej zależnej) może różnić się od lambdy oszacowanej w modelu regresji. Właściwe jest podejście oparte na regresji. Celem jest spełnienie założeń dla reszt, a nie założeń brzegowego rozkładu.
Gdy wdrażasz model wytrenowany na przetransformowanych danych, musisz transformować nowe wejścia w ten sam sposób, używając tej samej lambdy, a następnie odwracać transformację predykcji. Pominięcie któregokolwiek kroku daje predykcje w złej skali. Brzmi banalnie, a i tak regularnie bywa zapominane.
Box-Cox to rodzina transformacji, a nie jedna transformacja. To lambda decyduje, którego członka tej rodziny dostajesz, a transformacja logarytmiczna to tylko szczególny przypadek z lambda = 0. Większość analityków domyślnie używa loga bez zastanowienia. Box-Cox uświadamia ten wybór i daje ugruntowany sposób, by zapytać, czy inna wartość lambdy nie byłaby lepsza dla modelu.
Używaj go, gdy diagnozujesz coś konkretnego: heteroscedastyczność reszt, nieliniowość, wyraźnie niespełnione założenia. Automatyczne stosowanie do każdej zmiennej zależnej to nawyk, z którym warto zerwać. A jeśli twoje dane mają zera lub wartości ujemne, to nie jest teren Boxa-Coxa. To Yeo-Johnson.
Aby zbudować solidniejsze podstawy metod regresji, które Box-Cox zwykle wspiera, nasz kurs Regresja średniozaawansowana w R oraz Wprowadzenie do regresji ze statsmodels w Pythonie to dobre kolejne kroki.
Ucz się z DataCamp
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}