{count, plural, one {Kurs} other {Kurs}}
Seaborn ile Veri Görselleştirmeye Giriş
{hours} sa
184.9K
Konut fiyatları üzerinde bir doğrusal regresyon modeli kuruyorsunuz. Artık grafiği bir megafon gibi görünüyor (solda dar, sağa doğru açılıyor). Model teknik olarak çalışıyor. Sonuçlar ise güvenilir değil. Bu desen heteroskedastisite örneğidir ve açık bir hata vermeden sessizce çıkarımlarınızı geçersiz kılan ihlallerden biridir.
Bir seçenek, yanıt değişkenini dönüştürmektir. Ve log, karekök ya da ters alma denemelerinden hangisini seçeceğinizi tahmin etmek yerine, verilerin doğru olanı önermesine izin verebilirsiniz. Box-Cox dönüşümünün arkasındaki fikir budur ve burada ele alacağımız konu da bu: formül, lambda nasıl seçilir ve Python ile R'de nasıl uygulanır.
Box-Cox dönüşümü, yalnızca pozitif veriler için güç dönüşümleri ailesidir. Kendi başınıza belirli bir dönüşümü seçmek yerine, lambda (λ) adı verilen bir parametreyle indekslenen geniş bir aralıkta arama yapmanın bir yolunu sunar.
Lambda 0 olduğunda log dönüşümü elde edersiniz. 0,5 olduğunda karekök dönüşümüne yakın bir şey; -1 olduğunda ise ters alma işlemine yakın bir şey elde edersiniz. Bunların hepsi aynı formülün özel durumlarıdır; bu da aralarından önceden seçim yapmanız gerekmediği anlamına gelir. Hangisinin en iyi uyduğunu verilerden tahmin edersiniz.
En baştan net olmak gereken bir nokta: Box-Cox verileri sadece "normal yapmaz". Modelleme probleminize bağlı olarak varyansı dengelemeye, kestiriciler ile yanıt arasındaki doğrusallığı iyileştirmeye veya model varsayımlarınızı daha iyi karşılamaya yardımcı olabilir. Ayrıca girdilerin kesinlikle pozitif olmasını gerektirir. Sıfırlar ve negatifler kapsam dışıdır. Bununla ilgili daha fazlası kısıtlar bölümünde.
Formüle geçmeden önce biraz sezgi geliştirmek gerekir. Haftalık satış geliri gibi sağa çarpık bir değişkeniniz olduğunu düşünün: sağda uzun bir kuyruk, ortalamayla birlikte artan varyans. Soru şu: Bu değişkenin hangi kuvveti daha düzgün davranan bir yanıt gibi hareket eder?
Farklı lambda değerleri, zaten bildiğiniz dönüşümlere karşılık gelir:
Standart Box-Cox formülasyonu ölçekleme ve öteleme geleneklerini içerir; bu nedenle bunlar birebir aynı formüller değil, tanıdık eşdeğerler olarak anlaşılmalıdır. Log durumu (lambda = 0) bir limit olarak ele alınır. Formül, süreklilik argümanı nedeniyle burada log(x) ifadesine döner; bu keyfi bir istisna değildir.
Standart parçalı formül şöyledir:
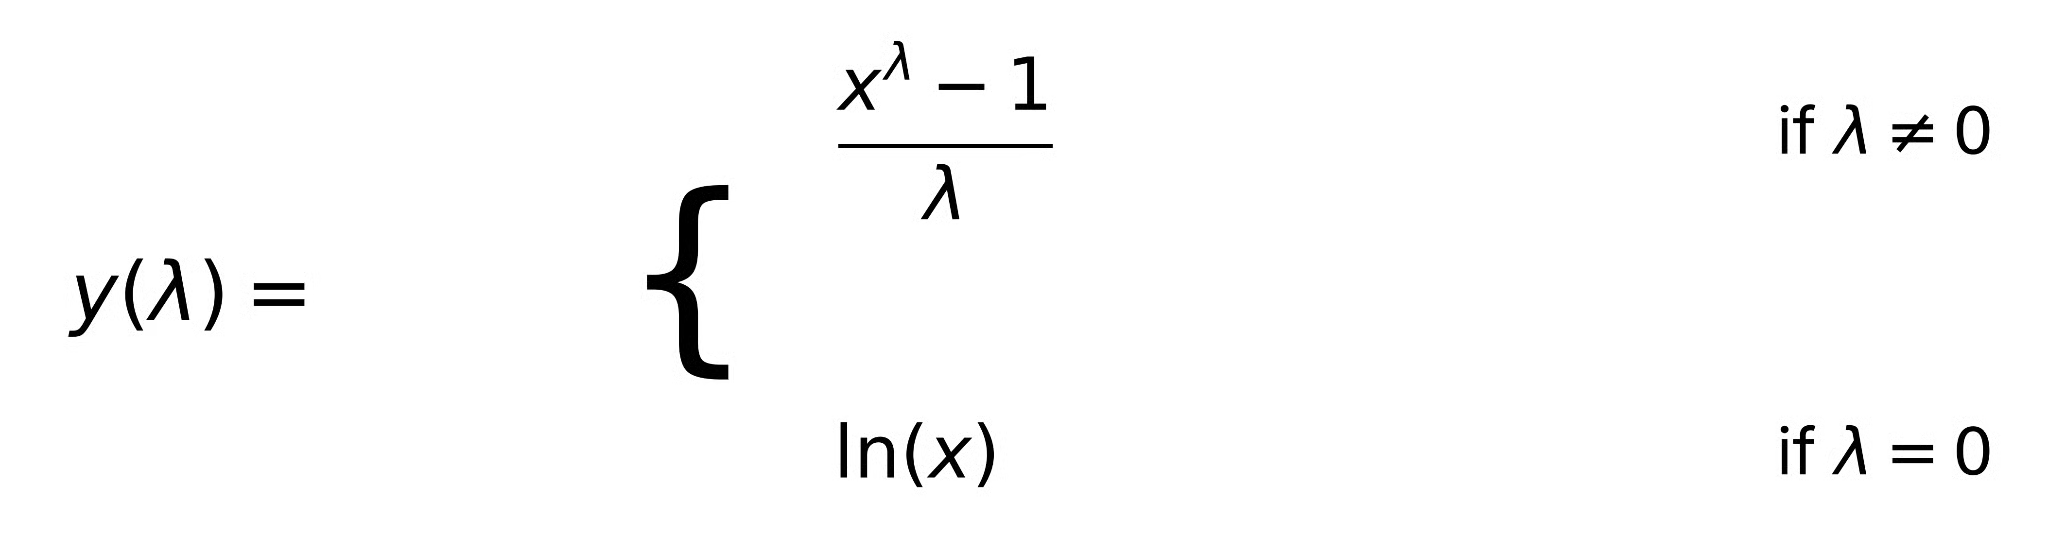
Burada x dönüştürülen pozitif değeri, lambda ise dönüşüm parametresini ifade eder. (xλ - 1) / λ biçimi ilk bakışta alışılmadık görünebilir. Bu, lambda sıfıra yaklaşırken dönüşümü sürekli tutan ölçekleme geleneğidir. Bu olmadan, lambda = 0 noktasında atlamalı süreksizlik olur ve log durumu geri kalan aileden tamamen kopuk kalırdı. Bununla birlikte formül, lambda → 0 iken düzgün bir şekilde ln(x)'e geçiş yapar.
Şimdilik türetme kısmını dert etmeyin. Operasyonel olarak: lambdayı seçin ya da tahmin edin, pozitif değerlerinizi yerine koyun ve dönüştürülmüş çıktı ile çalışın.
Lambda, sezgiye dayalı olarak el yordamıyla belirleyeceğiniz bir şey değildir. Veriden tahmin edilir. Box-Cox'u, "log deneyin" diye tahmin etmekten ayıran şey budur. Altında ilkeli bir istatistiksel prosedür vardır.
Amaç, verilerinizin varsayılan modele en iyi uymasını sağlayan lambdayı bulmaktır. Regresyon bağlamında bu, dönüştürülmüş yanıtın modelin varsayımlarını, tipik olarak artıkların normalliği ve sabit varyansı, en iyi karşıladığı lambdayı bulmak demektir. Burada seçtiğiniz şey, yanıtın marjinal dağılımını tek başına en normal gösteren lambda değildir. Modelleme bağlamında en iyi çalışan lambdayı seçersiniz. Bu ayrım önemlidir; hatalar bölümünde buna geri döneceğiz.
Buradaki en faydalı tanı araçlarından biri profil olabilirlik grafiğidir: x ekseninde lambda değerleri, y ekseninde log-olabilirlik. Tepe noktası, tahmin edilen en uygun lambdayı verir. En az bunun kadar faydalı olan, genellikle maksimumun altında bir eşikte yatay bir çizgiyle gösterilen tepe çevresindeki güven aralığıdır. Bu aralık içindeki herhangi bir lambda, istatistiksel olarak optimumdan ayırt edilemez.
İnsanların yeterince önemsemediği pratik bir husus: En uygun lambda 0,43 gibi bir şeyse ve 0,5 güven aralığı içinde kalıyorsa, 0,5'i tercih edin. Karekök dönüşümü açıklaması daha kolaydır, geri dönüşümü daha basittir ve performanstan neredeyse hiçbir şey kaybettirmez. Aynı mantık 0 (log) ve 1 (dönüşüm yok) için de geçerlidir. Yorumlanabilirlik önemlidir; özellikle de modelinizi lambda = 0,43'ün ne anlama geldiğini bilmeyen birine anlatırken.
Artık lambdanın ne olduğunu ve nasıl seçildiğini bildiğimize göre, bunu pratiğe dökelim. Önce Python, sonra R.
SciPy'nin stats modülü bunu doğrudan ele alır. boxcox() işlevi, tek çağrıda hem lambdayı tahmin eder hem de dönüştürülmüş değerleri döndürür. İşte simüle edilmiş sağa çarpık verilerle minimal bir örnek:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Buradaki estimated_lambda, normallik varsayımı altında log-olabilirliği maksimize eden değerdir. Daha sonra tahmin için yeni verileri dönüştürürken de aynı değeri kullanırsınız.
Bunun, lambdayı yanıtın marjinal dağılımından tahmin ettiğine dikkat edin; bir regresyon modeli içinde değil. Bir modelleme iş akışında, lambdayı model bağlamında değerlendirirsiniz. Aşağıdaki R örneği, MASS'in boxcox() işlevini kullanarak bunun nasıl yapıldığını gösterir.
R'de MASS paketindeki boxcox() işlevi, regresyon iş akışları için tasarlanmıştır. Uydurulmuş bir model nesnesi alır ve profil olabilirliğini doğrudan çizer; bu da tek başına bir vektör yerine model bağlamında lambdayı değerlendirirken daha doğal bir yaklaşımdır.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R'nin boxcox() işlevi profil olabilirliğini otomatik olarak çizer; böylece güven aralığı görselleştirmesini de doğrudan elde edersiniz. Bu da lambdayı daha basit bir değere yuvarlayıp yuvarlamamaya karar vermeyi kolaylaştırır.
Yanıtı dönüştürüp bir model uyumladıktan sonra, tahminleriniz dönüştürülmüş ölçekte olur; orijinal ölçekte değil. 3,2'lik bir tahmin, 3,2 birim (xλ - 1) / λ anlamına gelir; 3,2 birim gelir anlamına değil.
Dönüşümden sonra katsayıların yorumu değişir. Dönüştürülmüş ölçekte, bir kestiricideki bir birimlik artış, orijinal y'de değil, y(λ)'da belirli bir değişime karşılık gelir. Lambda 0'a yakınsa (log'a yakın), orijinal ölçekteki yüzde değişimleri yaklaşık olarak yorumlayabilirsiniz. Diğer lambda değerlerinde ilişki daha karmaşıktır ve x'in mevcut düzeyine bağlıdır.
Tahminleri orijinal ölçeğe geri çevirmek için tersini uygulayın:
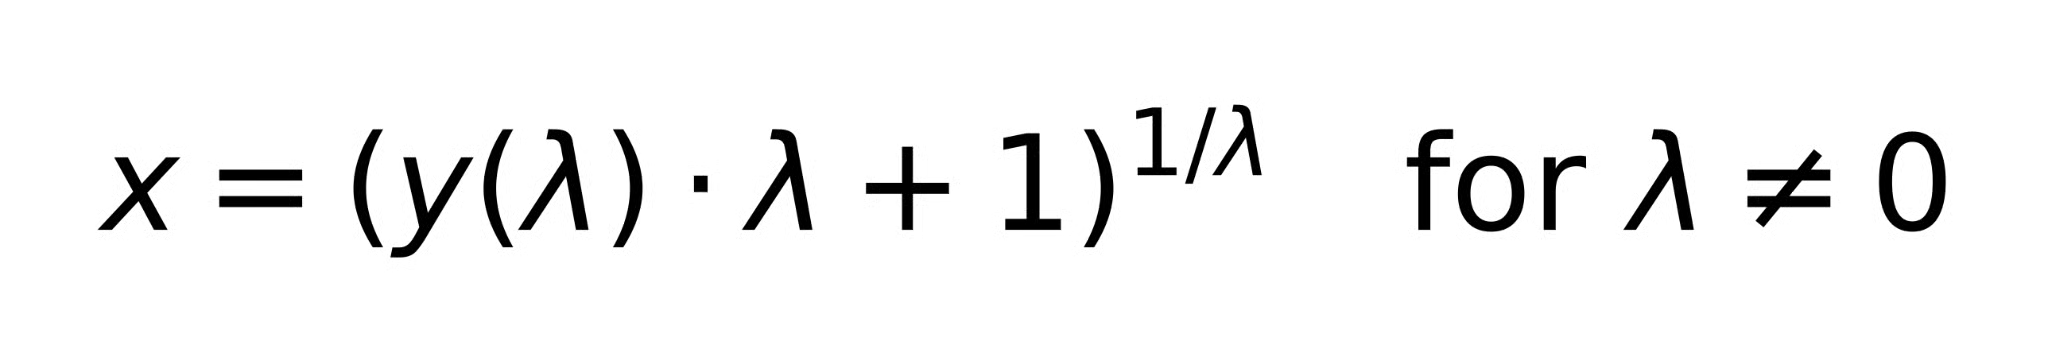
Lambda = 0 için ln(x)'in tersi basitçe exp(y)'dir.
Dönüştürülmüş ölçekteki tahmini ortalamayı geri dönüştürmek, orijinal ölçekteki ortalamanın yanlı olmayan bir tahminini vermez. Bu, Jensen eşitsizliğinin bilinen bir sonucudur ve özellikle log-lineer modellerde ortalama değerlerin tahmin edildiği durumlarda önemlidir. Yanlılık düzeltmesine derinlemesine girmek kapsamımızın dışında. Daha geniş bağlam isteyenler için Python ile Regresyona Giriş kursumuz, regresyon modellerinde tahmin ve yorumu daha geniş kapsamda ele alır.
Box-Cox'u, halihazırda kullanıyor olabileceğiniz alternatiflere karşı ne zaman tercih etmelisiniz?
Log dönüşümü, Box-Cox'un lambda = 0 durumudur. Nokta. Daha önce log dönüşümü kullandıysanız, lambda sabitlenmiş bir Box-Cox örneğini kullanmışsınızdır. Box-Cox'un avantajı, en baştan lambda = 0'a bağlanmamasıdır. Bununla birlikte, profil olabilirliğiniz doğrudan lambda = 0'da tepe yapıyorsa, log kullanın. Gereksiz karmaşıklığa gerek yok.
Yeo-Johnson dönüşümü, sıfır ve negatif değerleri ele almak için tasarlanmış Box-Cox'un doğrudan bir uzantısıdır. Verilerinizde sıfırlar (örneğin sayımlar) veya negatif değerler varsa başvurmanız gereken yöntem budur. Dönüşümler matematiksel olarak benzerdir. Yeo-Johnson yalnızca pozitiflik kısıtını gevşetir. Scikit-learn'de PowerTransformer her ikisini de destekler, method='box-cox' ve method='yeo-johnson'; bu da denemeyi kolaylaştırır.
Standartlaştırma (z-puanlama) verileri kaydırır ve ölçeklendirir: ortalamayı 0'a, standart sapmayı 1'e getirir. Box-Cox ise doğrusal olmayan bir dönüşümle dağılımın şeklini değiştirir. Farklı problemleri çözerler. Standartlaştırma çarpıklığı azaltmaz veya varyansı dengelemez. Box-Cox verilerinizi merkezileştirmez veya özellikleri büyüklükçe karşılaştırılabilir hale getirmez. Sırayla ikisini de yapabilirsiniz; önce dönüştürüp sonra standartlaştırabilirsiniz, ancak bunlar birbirinin alternatifi değildir.
Bazıları sonradan bakınca bariz görünür. Bu yine de yapılmalarını engellemez ve bazıları o kadar incedir ki "bariz" ifadesi fazlasıyla iyimser kalır.
Formül sıfırda veya altında bozulur. Pozitif lambda için 0λ sıfırdır, negatif lambda için tanımsızdır; log(0) ise eksi sonsuzdur. Verilerinizde sıfır veya negatif varsa, Box-Cox ya hata verir ya da sessizce saçma sonuçlar üretir. Bunun yerine Yeo-Johnson kullanın veya küçük bir pozitif sabitle veriyi kaydırın. İkincisi, şüpheyle yaklaşılması gereken bir yaklaşıklamadır.
Box-Cox, belirli bir modelleme problemine yanıt olarak uygulanmalıdır: sabit olmayan varyans, zayıf doğrusallık, ihlal edilen artık varsayımları. Marjinal dağılımınızı herhangi bir model kurmadan önce "normal görünsün" diye otomatik bir ön işleme adımı olarak kullanmak ters mantıktır. Yanıtınızı tek başına en iyi normale yaklaştıran lambda, modelinizin artıklarını gerçekten iyileştiren lambda olmayabilir.
Lambdayı tahmin etmek işin yalnızca yarısıdır. Dönüştürüp yeniden uyumladıktan sonra artık grafiklerinizi yeniden kontrol edin. Box-Cox varsayımların karşılanacağını garanti etmez. Size bir şans verir. Artıklar hâlâ açılıyorsa ya da eğrilik varsa, başka bir şey söz konusudur.
Dönüşümden sonra katsayılar artık orijinal ölçekteki ilişkileri tanımlamaz. Bu, sonuçlar rapor edilirken veya tahmin yapılırken en çok kafa karıştıran noktadır. Her adımda hangi ölçekte çalıştığınızı takip edin.
Yalnızca yanıt değişkeninizin histogramına bakarak tek değişkenli dağılımdan tahmin edilen lambda, bir regresyon modeli içinde tahmin edilenden farklı olabilir. Doğru yaklaşım regresyon temellidir. Hedef, marjinal dağılımsal varsayımları değil, artık varsayımlarını sağlamaktır.
Dönüştürülmüş verilerle eğitilmiş bir modeli devreye aldığınızda, yeni girdileri aynı lambda ile aynı şekilde dönüştürmeniz ve tahminleri geri dönüştürmeniz gerekir. Bu adımlardan herhangi birini atlamak, yanlış ölçekte tahminler verir. Kulağa bariz gelse de düzenli olarak unutulur.
Box-Cox tek bir dönüşüm değil, bir dönüşüm ailesidir. Hangi aile üyesini elde edeceğinizi lambda belirler ve log dönüşümü sadece lambda = 0 özel durumudur. Analistlerin çoğu, üzerinde düşünmeden varsayılan olarak log kullanır. Box-Cox bu seçimi görünür kılar ve lambdanın farklı bir değerinin modele gerçekten daha iyi hizmet edip etmeyeceğini sormanın ilkesel bir yolunu sunar.
Bunu, belirli bir şeyi teşhis ederken kullanın: artıklerde heteroskedastisite, doğrusal olmama, açıkça karşılanmayan varsayımlar. Her yanıt değişkenine otomatik olarak uygulamak, vazgeçmeye değer bir alışkanlıktır. Ve verilerinizde sıfırlar veya negatifler varsa, bu Box-Cox alanı değildir. Bu Yeo-Johnson'dır.
Box-Cox'un genellikle desteklediği regresyon yöntemlerinde daha sağlam bir temel için, R ile Orta Düzey Regresyon kursumuz ve Python'da statsmodels ile Regresyona Giriş iyi birer sonraki adımdır.
DataCamp ile Öğrenin
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.