
{count, plural, one {कोर्स} other {कोर्स}}
Seaborn के साथ Data Visualization परिचय
{hours} घंटा
184.9K
आप हाउसिंग प्राइस पर एक लीनियर रिग्रेशन मॉडल बना रहे हैं। रेजिडुअल प्लॉट मेगाफोन जैसा दिखता है (बाएँ संकरा, दाएँ फैलता हुआ)। मॉडल तकनीकी रूप से चलता है। बस नतीजे भरोसेमंद नहीं हैं। यह पैटर्न हेटेरोस्डैस्टिसिटी कहलाता है, और यह उन उल्लंघनों में से एक है जो बिना कोई साफ़ त्रुटि फेंके चुपचाप आपकी निष्कर्षों को अमान्य कर देता है।
एक विकल्प है रिस्पॉन्स वैरिएबल को ट्रांसफ़ॉर्म करना। और यह अंदाज़ा लगाने के बजाय कि लॉग, स्क्वायर रूट या रेसिप्रोकल आज़माएँ, आप डेटा को सही विकल्प सुझाने दे सकते हैं। यही बॉक्स-कॉक्स ट्रांसफ़ॉर्मेशन के पीछे का विचार है, और हम यहीं इसे कवर करेंगे: फ़ॉर्मूला, लैम्ब्डा कैसे चुनें, और इसे Python व R में कैसे लागू करें।
बॉक्स-कॉक्स ट्रांसफ़ॉर्मेशन सख्ती से धनात्मक डेटा के लिए पावर ट्रांसफ़ॉर्मेशनों का एक परिवार है। कोई एक ट्रांसफ़ॉर्मेशन चुनने के बजाय, यह आपको पूरे दायरे में खोजने का तरीका देता है, जहाँ हर ट्रांसफ़ॉर्मेशन एक पैरामीटर लैम्ब्डा (λ) से इंडेक्स होता है।
जब लैम्ब्डा 0 होता है, तो आपको लॉग ट्रांसफ़ॉर्मेशन मिलता है। 0.5 होने पर यह स्क्वायर रूट के क़रीब होता है। -1 होने पर यह रेसिप्रोकल के पास होता है। ये सभी उसी फ़ॉर्मूले के विशेष मामले हैं, जिसका मतलब है कि आपको पहले से इनके बीच चुनना नहीं पड़ता। आप डेटा से अनुमान लगाते हैं कि कौन-सा सबसे अच्छा फिट बैठता है।
एक बात शुरुआत से साफ़ रखनी चाहिए: बॉक्स-कॉक्स बस "डेटा को नॉर्मल" नहीं बना देता। आपके मॉडलिंग समस्या पर निर्भर करते हुए, यह वैरिएंस को स्थिर करने, प्रेडिक्टर्स और रिस्पॉन्स के बीच रैखिकता सुधारने, या आपके मॉडल की धारणा को बेहतर तरीके से संतुष्ट करने में मदद कर सकता है। यह सख्ती से धनात्मक इनपुट मानों की भी मांग करता है। ज़ीरो और निगेटिव स्वीकार्य नहीं हैं। इस पर सीमाओं वाले भाग में और विस्तार से।
फ़ॉर्मूले से पहले थोड़ी अंतर्दृष्टि बनाना ज़रूरी है। मान लें आपके पास साप्ताहिक बिक्री राजस्व जैसा वैरिएबल है जो दाहिनी ओर झुका हुआ है: दाईं ओर लंबी पूँछ, और माध्य के साथ बढ़ता वैरिएंस। सवाल यह है कि उस वैरिएबल की कौन-सी पावर एक अधिक सुव्यवस्थित रिस्पॉन्स की तरह बर्ताव करती है।
लैम्ब्डा के अलग-अलग मान उन ट्रांसफ़ॉर्मेशनों पर मैप होते हैं जिन्हें आप पहले से जानते हैं:
मानक बॉक्स-कॉक्स फॉर्म्युलेशन में स्केलिंग और ट्रांसलेशन कन्वेंशन शामिल होते हैं, इसलिए इन्हें शाब्दिक रूप से समान फॉर्मूले नहीं, बल्कि परिचित समतुल्य के रूप में समझना बेहतर है। लॉग वाला मामला (lambda = 0) सीमा के रूप में लिया जाता है। वहाँ फ़ॉर्मूला ln(x) में इसलिए बदलता है क्योंकि सततता का तर्क है, न कि मनमाना अपवाद।
मानक पीसवाइज़ फ़ॉर्मूला यह है:
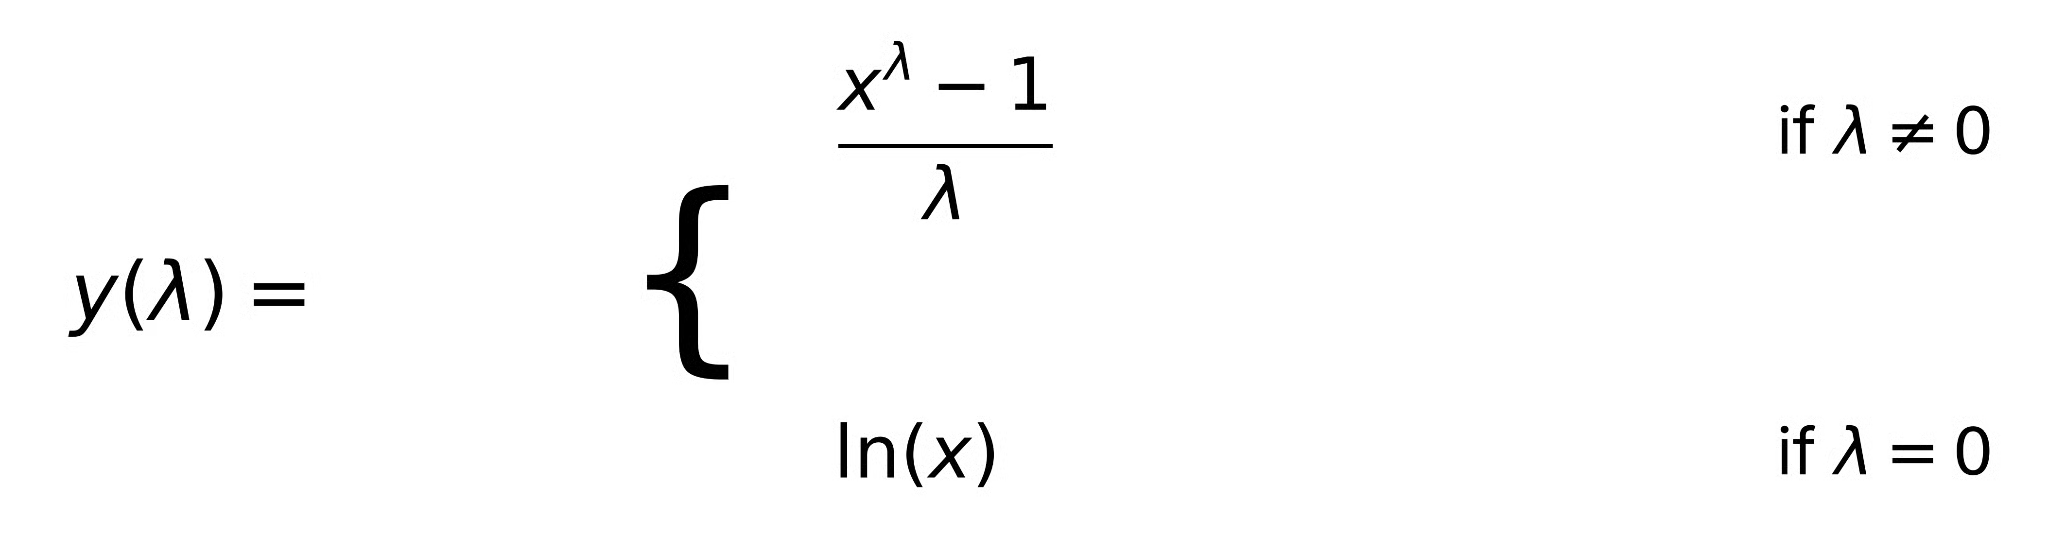
यहाँ x वह धनात्मक मान है जिसे ट्रांसफ़ॉर्म किया जा रहा है और लैम्ब्डा ट्रांसफ़ॉर्मेशन पैरामीटर है। (xλ - 1) / λ वाला रूप पहले थोड़ा अपरिचित लग सकता है। यही वह स्केलिंग कन्वेंशन है जो लैम्ब्डा के शून्य की ओर बढ़ने पर ट्रांसफ़ॉर्मेशन को सतत रखता है। इसके बिना, lambda = 0 पर एक जंप डिसकॉन्टिन्यूटी होती और लॉग वाला मामला परिवार के बाकी हिस्सों से पूरी तरह अलग हो जाता। इसके साथ, फ़ॉर्मूला lambda → 0 पर सुचारु रूप से ln(x) में ट्रांज़िशन करता है।
अभी व्युत्पत्ति की चिंता न करें। व्यावहारिक रूप से: लैम्ब्डा चुनें या आँकें, अपने धनात्मक मान डालें, और ट्रांसफ़ॉर्म किए गए आउटपुट के साथ काम करें।
लैम्ब्डा कोई ऐसी चीज़ नहीं है जिसे आप सहजज्ञान से हाथों-हाथ सेट कर दें। आप इसे डेटा से आँकते हैं। यही बात बॉक्स-कॉक्स को बस "लॉग आज़माएँ" वाले अनुमान से अलग करती है। इसके पीछे एक ठोस सांख्यिकीय प्रक्रिया है।
विचार यह है कि वह लैम्ब्डा खोजा जाए जो आपके डेटा को माने गए मॉडल में सबसे अच्छा फिट कर दे। रिग्रेशन संदर्भ में, इसका मतलब है वह लैम्ब्डा ढूँढ़ना जहाँ ट्रांसफ़ॉर्म किया गया रिस्पॉन्स मॉडल की धारणा—आमतौर पर रेजिडुअल्स की सामान्यता और स्थिर वैरिएंस—को सबसे नज़दीकी से संतुष्ट करता है। आप वह लैम्ब्डा नहीं चुन रहे जो रिस्पॉन्स के मार्जिनल वितरण को सबसे सामान्य जैसा दिखाए। आप वह चुन रहे हैं जो मॉडलिंग संदर्भ में सबसे अच्छा काम करता है। यह फर्क अहम है, और हम गलतियों वाले भाग में इस पर लौटेंगे।
यहाँ सबसे उपयोगी डायग्नॉस्टिक्स में से एक प्रोफ़ाइल लाइकलीहुड प्लॉट है: x-अक्ष पर लैम्ब्डा मान, y-अक्ष पर लॉग-लाइकलीहुड। शिखर अनुमानित इष्टतम लैम्ब्डा बताता है। उतना ही उपयोगी है उस शिखर के आसपास का कॉन्फिडेंस इंटरवल, जिसे आमतौर पर अधिकतम से नीचे किसी थ्रेसहोल्ड पर क्षैतिज रेखा के रूप में दिखाया जाता है। इस इंटरवल के भीतर आने वाला कोई भी लैम्ब्डा सांख्यिकीय रूप से इष्टतम से अभेद्य होता है।
यहाँ एक व्यावहारिक बात जिसे लोग कम आँकते हैं। यदि इष्टतम लैम्ब्डा 0.43 जैसा कुछ हो, और 0.5 कॉन्फिडेंस इंटरवल के भीतर आता हो, तो 0.5 ही लें। स्क्वायर-रूट ट्रांसफ़ॉर्मेशन समझाना आसान है, बैक-ट्रांसफ़ॉर्म करना आसान है, और प्रदर्शन में लगभग कुछ नहीं खोता। यही तर्क 0 (लॉग) और 1 (कोई ट्रांसफ़ॉर्मेशन नहीं) पर भी लागू होता है। व्याख्येयता मायने रखती है, खासकर जब आप किसी ऐसे व्यक्ति को मॉडल समझा रहे हों जिसे 0.43 का मतलब न पता हो।
अब जबकि हमें पता है कि लैम्ब्डा क्या है और कैसे चुना जाता है, इसे अभ्यास में लगाते हैं। पहले Python, फिर R।
SciPy का stats मॉड्यूल इसे सीधे संभालता है। boxcox() फ़ंक्शन एक ही कॉल में लैम्ब्डा का अनुमान लगाता है और ट्रांसफ़ॉर्म किए हुए मान लौटाता है। यहाँ सिम्युलेटेड राइट-स्क्यूड डेटा के साथ एक न्यूनतम उदाहरण है:
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
यहाँ estimated_lambda सामान्यता की धारणा के तहत लॉग-लाइकलीहुड को अधिकतम करता है। आप भविष्यवाणी के लिए नया डेटा ट्रांसफ़ॉर्म करते समय भी इसी मान का उपयोग करेंगे।
ध्यान दें कि यह लैम्ब्डा का अनुमान रिस्पॉन्स के मार्जिनल वितरण से लगाता है, न कि रिग्रेशन मॉडल के भीतर। मॉडलिंग वर्कफ़्लो के लिए, आप लैम्ब्डा का मूल्यांकन मॉडल संदर्भ में करेंगे। नीचे R का उदाहरण MASS के boxcox() का उपयोग करके यही दिखाता है।
R में, MASS पैकेज का boxcox() फ़ंक्शन रिग्रेशन वर्कफ़्लो के लिए बनाया गया है। यह एक फिटेड मॉडल ऑब्जेक्ट लेता है और सीधे प्रोफ़ाइल लाइकलीहुड प्लॉट करता है, जो स्वाभाविक रूप से अधिक उपयुक्त है क्योंकि आप किसी अकेले वेक्टर पर नहीं, बल्कि मॉडल के संदर्भ में लैम्ब्डा का आकलन कर रहे होते हैं।
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
R का boxcox() प्रोफ़ाइल लाइकलीहुड को स्वतः प्लॉट करता है, इसलिए आपको कॉन्फिडेंस इंटरवल का विज़ुअलाइज़ेशन मुफ़्त में मिल जाता है। इससे यह तय करना आसान हो जाता है कि लैम्ब्डा को सरल मान पर राउंड किया जाए या नहीं।
जब आप रिस्पॉन्स को ट्रांसफ़ॉर्म करके मॉडल फिट कर लेते हैं, तो आपकी भविष्यवाणियाँ ट्रांसफ़ॉर्म्ड स्केल पर होती हैं, मूल स्केल पर नहीं। 3.2 की भविष्यवाणी का अर्थ (xλ - 1) / λ के 3.2 यूनिट हैं, राजस्व के 3.2 यूनिट नहीं।
ट्रांसफ़ॉर्मेशन के बाद कोएफ़िशिएंट्स की व्याख्या बदल जाती है। ट्रांसफ़ॉर्म्ड स्केल पर, किसी प्रेडिक्टर में एक यूनिट की वृद्धि y(λ) में निश्चित परिवर्तन से संबद्ध होती है, मूल y में नहीं। यदि लैम्ब्डा 0 के क़रीब है (लगभग-लॉग), तो आप मूल स्केल पर प्रतिशत परिवर्तन का अनुमान लगा सकते हैं। अन्य मानों के लिए, संबंध अधिक जटिल होता है और x के वर्तमान स्तर पर निर्भर करता है।
भविष्यवाणियों को मूल स्केल पर वापस लाने के लिए, इनवर्स लागू करें:
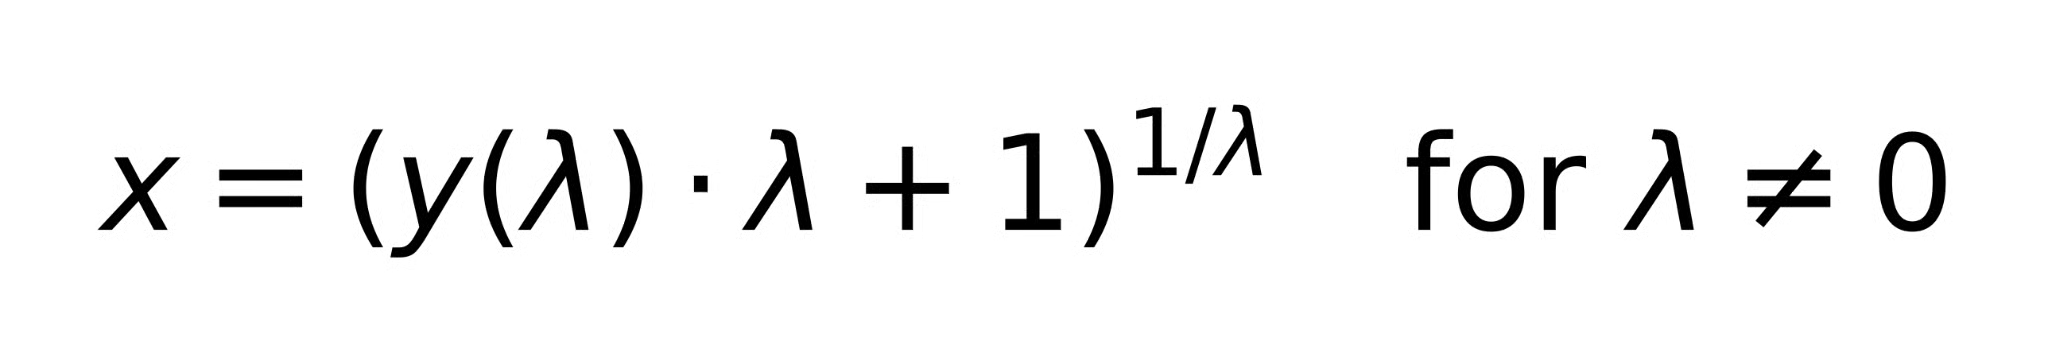
lambda = 0 के लिए, ln(x) का इनवर्स बस exp(y) होता है।
ट्रांसफ़ॉर्म्ड स्केल पर अनुमानित माध्य को बैक-ट्रांसफ़ॉर्म करना आपको मूल स्केल पर माध्य का बिना बायस वाला अनुमान नहीं देता। यह जेनसन की असमानता का जाना-पहचाना परिणाम है, और यह खासकर लॉग-लिनियर मॉडलों में माध्य का पूर्वानुमान लगाने जैसी स्थितियों में मायने रखता है। बायस करेक्शन में गहराई तक जाना हमारे दायरे से बाहर है। यदि आप व्यापक संदर्भ चाहते हैं, तो हमारा Introduction to Regression in Python कोर्स रिग्रेशन मॉडलों में भविष्यवाणी और व्याख्या को व्यापक रूप से कवर करता है।
आपको वास्तव में कब बॉक्स-कॉक्स चुनना चाहिए बनाम वे विकल्प जो आप पहले से इस्तेमाल कर रहे होंगे?
लॉग ट्रांसफ़ॉर्मेशन बॉक्स-कॉक्स का lambda = 0 वाला मामला है। बस। यदि आपने पहले लॉग ट्रांसफ़ॉर्मेशन इस्तेमाल किया है, तो आपने बॉक्स-कॉक्स का एक विशेष इंस्टेंस इस्तेमाल किया है जिसमें लैम्ब्डा तय था, अनुमानित नहीं। बॉक्स-कॉक्स का फ़ायदा यह है कि यह पहले से lambda = 0 पर प्रतिबद्ध नहीं होता। फिर भी, यदि आपका प्रोफ़ाइल लाइकलीहुड साफ़ तौर पर lambda = 0 पर पीक करता है, तो लॉग ही इस्तेमाल करें। अनावश्यक जटिलता जोड़ने का कारण नहीं।
येओ-जॉनसन ट्रांसफ़ॉर्मेशन बॉक्स-कॉक्स का सीधा विस्तार है जो ज़ीरो और निगेटिव मानों को संभालने के लिए बनाया गया है। जब आपके डेटा में ज़ीरो (जैसे काउंट्स) या निगेटिव मान हों, तो यही अपनाएँ। ट्रांसफ़ॉर्मेशन गणितीय रूप से समान हैं। येओ-जॉनसन बस पॉज़िटिविटी की बाधा को ढीला करता है। scikit-learn में, PowerTransformer दोनों को सपोर्ट करता है, method='box-cox' और method='yeo-johnson', जिससे स्विच करना आसान हो जाता है।
स्टैंडर्डाइज़ेशन (z-स्कोरिंग) डेटा को शिफ्ट और स्केल करता है: यह माध्य को 0 और मानक विचलन को 1 कर देता है। बॉक्स-कॉक्स नॉनलिनियर ट्रांसफ़ॉर्मेशन के ज़रिए वितरण का आकार बदलता है। ये अलग समस्याएँ हल करते हैं। स्टैंडर्डाइज़ेशन स्क्यूनेस नहीं घटाता और न ही वैरिएंस स्थिर करता है। बॉक्स-कॉक्स आपके डेटा को केंद्रित नहीं करता या फीचर्स को समान परिमाण का नहीं बनाता। आप क्रम में दोनों कर सकते हैं—पहले ट्रांसफ़ॉर्म, फिर स्टैंडर्डाइज़—पर ये विकल्प नहीं हैं।
इनमें से कुछ पीछे मुड़कर देखने पर स्पष्ट लगती हैं। फिर भी ये होती रहती हैं, और कुछ इतनी सूक्ष्म हैं कि "स्पष्ट" शब्द बहुत काम कर रहा होता है।
फ़ॉर्मूला शून्य या उससे नीचे टूट जाता है। 0λ पॉज़िटिव लैम्ब्डा के लिए 0 होता है और निगेटिव लैम्ब्डा के लिए अपरिभाषित; log(0) ऋणात्मक अनंत है। यदि आपके डेटा में ज़ीरो या निगेटिव हैं, तो बॉक्स-कॉक्स या तो त्रुटि देगा या चुपचाप निरर्थक नतीजे देगा। इसके बजाय येओ-जॉनसन का उपयोग करें, या एक छोटा पॉज़िटिव कॉन्स्टेंट जोड़कर शिफ्ट करें। बाद वाला एक अनुमान है जिसे संदेह के साथ लेना चाहिए।
बॉक्स-कॉक्स किसी विशिष्ट मॉडलिंग समस्या—अस्थिर वैरिएंस, कमजोर रैखिकता, रेजिडुअल धारणाओं का उल्लंघन—के जवाब में लागू किया जाना चाहिए। इसे एक स्वतः प्रीप्रोसेसिंग स्टेप के रूप में इसीलिए न लगाएँ कि आपका मार्जिनल वितरण "नॉर्मल दिखे" और फिर कोई भी मॉडल फिट करें—यह उल्टा है। जो लैम्ब्डा आपके रिस्पॉन्स को अलग-थलग सामान्य जैसा बनाता है, वही जरूरी नहीं कि आपके मॉडल के रेजिडुअल्स में सुधार करे।
लैम्ब्डा का अनुमान लगाना आधा काम है। ट्रांसफ़ॉर्म और रीफ़िट के बाद, अपने रेजिडुअल प्लॉट फिर देखें। बॉक्स-कॉक्स यह गारंटी नहीं देता कि धारणाएँ पूरी होंगी। यह बस आपको एक बेहतर मौका देता है। अगर रेजिडुअल्स अब भी फैल रहे हैं, या वक्रता है, तो कुछ और चल रहा है।
ट्रांसफ़ॉर्मेशन के बाद, कोएफ़िशिएंट्स मूल स्केल पर संबंधों का वर्णन नहीं करते। यह अक्सर नतीजे रिपोर्ट करते समय या भविष्यवाणी करते समय लोगों को उलझा देता है। हर चरण पर ध्यान रखें कि आप किस स्केल पर काम कर रहे हैं।
एकवेरिएट वितरण (सिर्फ अपने रिस्पॉन्स वैरिएबल के हिस्टोग्राम को देखकर) से अनुमानित लैम्ब्डा रिग्रेशन मॉडल के भीतर अनुमानित लैम्ब्डा से भिन्न हो सकता है। रिग्रेशन-आधारित तरीका सही है। लक्ष्य रेजिडुअल धारणाओं को संतुष्ट करना है, न कि मार्जिनल वितरण की धारणाओं को।
जब आप ट्रांसफ़ॉर्म्ड डेटा पर प्रशिक्षित मॉडल को डिप्लॉय करते हैं, तो आपको नए इनपुट्स पर भी वही लैम्ब्डा लगाकर ट्रांसफ़ॉर्म करना होता है और फिर भविष्यवाणियों को बैक-ट्रांसफ़ॉर्म करना होता है। किसी भी कदम को छोड़ देना आपको गलत स्केल पर भविष्यवाणियाँ देगा। यह सुनने में स्पष्ट लगता है, फिर भी अक्सर भुला दिया जाता है।
बॉक्स-कॉक्स ट्रांसफ़ॉर्मेशनों का एक परिवार है, कोई एकल ट्रांसफ़ॉर्मेशन नहीं। लैम्ब्डा तय करता है कि उस परिवार का कौन-सा सदस्य आपको मिलता है, और लॉग ट्रांसफ़ॉर्मेशन बस lambda = 0 का विशेष मामला है। अधिकतर विश्लेषक बिना सोचे-समझे डिफ़ॉल्ट रूप से लॉग का उपयोग करते हैं। बॉक्स-कॉक्स इस चयन को स्पष्ट करता है और आपको यह पूछने का सुसंगत तरीका देता है कि क्या कोई और लैम्ब्डा मान वास्तव में मॉडल को बेहतर सेवा देगा।
इसे तब उपयोग करें जब आप कुछ विशिष्ट निदान कर रहे हों: रेजिडुअल्स में हेटेरोस्डैस्टिसिटी, नॉन-लिनियरिटी, या ऐसी धारणाएँ जो साफ़ तौर पर पूरी नहीं हो रहीं। हर रिस्पॉन्स वैरिएबल पर स्वतः लागू करना एक आदत है जिसे छोड़ना चाहिए। और यदि आपके डेटा में ज़ीरो या निगेटिव हैं, तो वह बॉक्स-कॉक्स का क्षेत्र नहीं है। वह येओ-जॉनसन का है।
रिग्रेशन विधियों में गहरी नींव के लिए, जिन्हें बॉक्स-कॉक्स आम तौर पर सपोर्ट करता है, हमारा Intermediate Regression in R कोर्स और Introduction to Regression with statsmodels in Python अच्छे अगले कदम हैं।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}