{count, plural, one {Cours} other {Cours}}
Introduction à la visualisation de données avec Seaborn
{hours} h
184.9K
Vous construisez un modèle de régression linéaire sur des prix immobiliers. Le graphique des résidus ressemble à un mégaphone (resserré à gauche, très évasé à droite). Le modèle s’exécute techniquement. Les résultats, eux, ne sont pas fiables. Ce motif, c’est l’hétéroscédasticité, une violation qui invalide discrètement vos inférences sans afficher d’erreur évidente.
Une option consiste à transformer la variable réponse. Et plutôt que de deviner s’il faut essayer un log, une racine carrée ou un inverse, laissez les données vous indiquer la bonne voie. C’est l’idée derrière la transformation de Box-Cox. Nous verrons ici la formule, comment choisir lambda et comment l’implémenter en Python et en R.
La transformation de Box-Cox est une famille de transformations en puissance pour des données strictement positives. Plutôt que de choisir vous-même une transformation précise, elle permet d’explorer toute une gamme, chacune indexée par un paramètre appelé lambda (λ).
Quand lambda vaut 0, vous obtenez une transformation logarithmique. À 0,5, vous vous rapprochez d’une racine carrée. À -1, vous êtes proche d’un inverse. Toutes sont des cas particuliers d’une même formule : vous n’avez donc pas à trancher à l’avance. Vous estimez celle qui s’ajuste le mieux aux données.
Précision importante d’emblée : Box-Cox ne « rend pas juste les données normales ». Selon votre problème de modélisation, elle peut aider à stabiliser la variance, améliorer la linéarité entre prédicteurs et réponse, ou mieux satisfaire les hypothèses du modèle. Elle exige aussi des valeurs strictement positives. Zéros et négatifs exclus. Plus de détails dans les limites.
Avant la formule, cultivons un peu d’intuition. Supposez une variable comme le chiffre d’affaires hebdomadaire, asymétrique à droite : longue traîne, variance qui croît avec la moyenne. La question est : quelle puissance de cette variable se comporte davantage comme une réponse « bien élevée » ?
Différentes valeurs de lambda correspondent à des transformations déjà connues :
La formulation standard de Box-Cox inclut des conventions d’échelle et de translation ; voyez donc ces équivalences comme des analogies familières plutôt que des identités strictes. Le cas log (lambda = 0) est traité comme une limite. La formule bascule sur log(x) pour assurer la continuité, pas par exception arbitraire.
La formule usuelle par morceaux est :
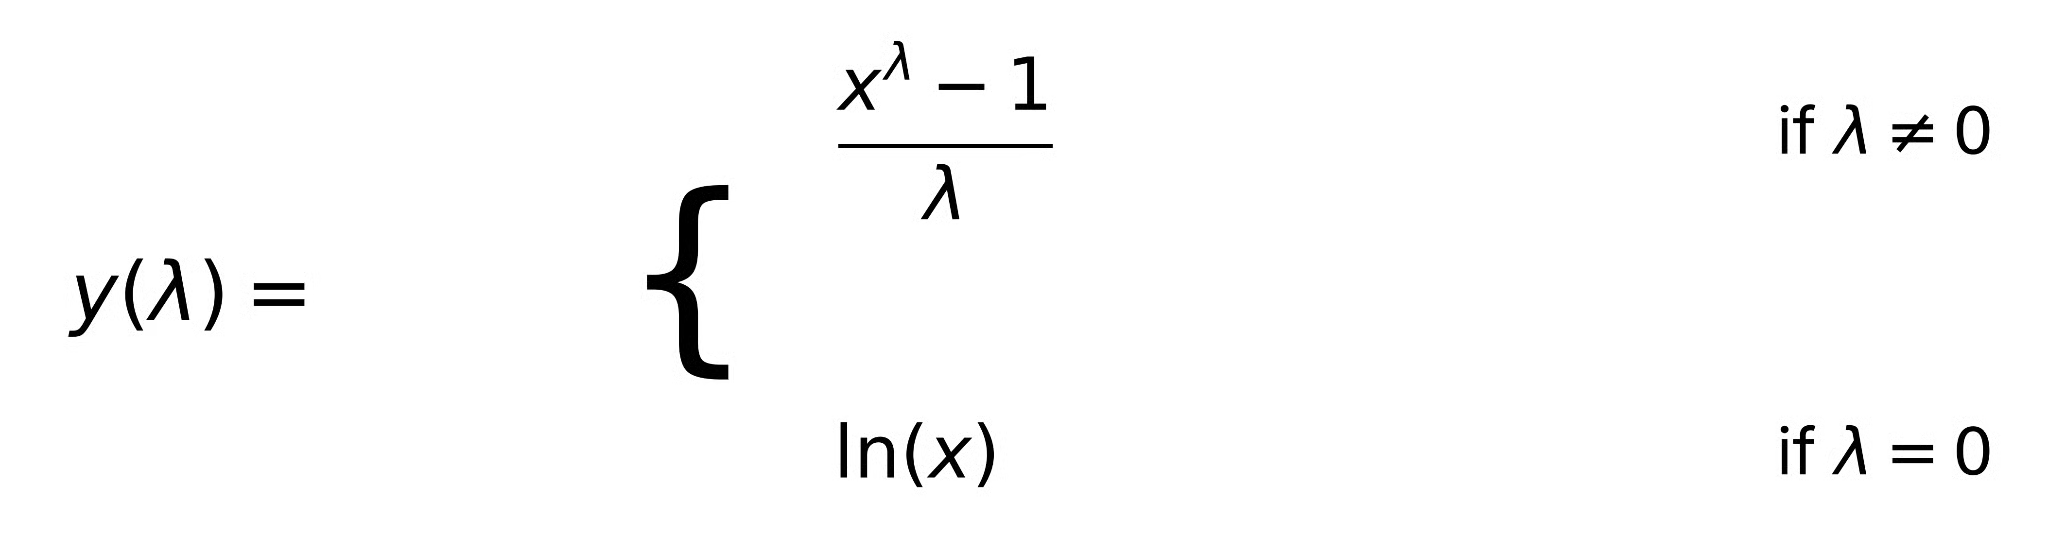
Ici, x est la valeur positive transformée et lambda est le paramètre de transformation. La forme (xλ - 1) / λ peut surprendre au premier abord. C’est la convention d’échelle qui garantit la continuité quand lambda tend vers zéro. Sans elle, vous auriez une discontinuité en lambda = 0 et le cas log serait déconnecté du reste de la famille. Avec, la formule converge en douceur vers ln(x) quand λ → 0.
Ne vous préoccupez pas de la dérivation pour l’instant. Concrètement : choisissez ou estimez lambda, appliquez la formule à vos valeurs positives et travaillez sur l’échelle transformée.
Lambda ne se règle pas « au feeling ». Il s’estime à partir des données. C’est ce qui distingue Box-Cox d’un simple « on tente un log ». Il y a une procédure statistique rigoureuse derrière.
L’idée est de trouver le lambda qui rend vos données les plus conformes au modèle supposé. En régression, cela revient à trouver le lambda pour lequel la réponse transformée satisfait au mieux les hypothèses du modèle, typiquement normalité et variance constante des résidus. Vous ne cherchez pas le lambda qui normalise au mieux la distribution marginale de la réponse isolément, mais celui qui fonctionne le mieux dans le contexte de modélisation. Cette nuance est importante ; nous y reviendrons dans les erreurs fréquentes.
Le diagnostic le plus utile est la courbe de vraisemblance profilée : valeurs de lambda en abscisse, log-vraisemblance en ordonnée. Le sommet indique le lambda optimal estimé. Tout aussi utile : l’intervalle de confiance autour de ce pic, souvent matérialisé par une ligne horizontale à un seuil sous le maximum. Tout lambda à l’intérieur est statistiquement indiscernable de l’optimum.
Un point pratique souvent sous-estimé : si le lambda optimal vaut 0,43 et que 0,5 est inclus dans l’intervalle de confiance, choisissez 0,5. Une racine carrée est plus simple à expliquer, plus facile à rétro-transformer, et la performance ne change quasiment pas. Même logique pour 0 (log) et 1 (pas de transformation). L’interprétabilité compte, surtout face à un public pour qui « lambda = 0,43 » ne parle pas.
Maintenant que nous savons ce qu’est lambda et comment il se choisit, passons à la pratique. Python d’abord, puis R.
Le module stats de SciPy le gère directement. La fonction boxcox() estime lambda et renvoie les valeurs transformées en un seul appel. Voici un exemple minimal avec des données simulées asymétriques à droite :
import numpy as np
from scipy import stats

# Simulate right-skewed data (e.g., weekly sales revenue in thousands)
rng = np.random.default_rng(42)
revenue = rng.exponential(scale=50, size=300)

# Confirm all values are positive before transforming
assert (revenue > 0).all(), "Box-Cox requires strictly positive values"

# Estimate lambda and transform
transformed, estimated_lambda = stats.boxcox(revenue)

print(f"Estimated lambda: {estimated_lambda:.4f}")
print(f"Original mean: {revenue.mean():.2f}, std: {revenue.std():.2f}")
print(f"Transformed mean: {transformed.mean():.2f}, std: {transformed.std():.2f}")
Ici, estimated_lambda maximise la log-vraisemblance sous l’hypothèse de normalité. Vous utiliserez ensuite cette même valeur pour transformer de nouvelles données lors de la prédiction.
Notez que cela estime lambda à partir de la distribution marginale de la réponse, et non dans un modèle de régression. Pour un flux de modélisation, évaluez lambda dans le contexte du modèle. L’exemple R ci-dessous illustre cela avec la fonction boxcox() de MASS.
En R, la fonction boxcox() du package MASS est conçue pour les workflows de régression. Elle prend un modèle ajusté et trace directement la vraisemblance profilée, ce qui est plus naturel puisque vous évaluez lambda dans un modèle plutôt que sur un vecteur isolé.
library(MASS)

# Simulate right-skewed response (e.g., weekly revenue)
set.seed(42)
revenue <- rexp(300, rate = 1/50)
predictor <- rnorm(300)

# Fit initial model
initial_model <- lm(revenue ~ predictor)

# Estimate lambda via profile likelihood
bc_result <- boxcox(initial_model, lambda = seq(-2, 2, by = 0.1))

# Extract the lambda with highest log-likelihood
best_lambda <- bc_result$x[which.max(bc_result$y)]
cat("Best lambda:", round(best_lambda, 3), "\n")

# Refit with transformed response
revenue_transformed <- (revenue^best_lambda - 1) / best_lambda
final_model <- lm(revenue_transformed ~ predictor)
La fonction boxcox() de R trace automatiquement la vraisemblance profilée ; vous obtenez donc l’intervalle de confiance sans effort, ce qui facilite la décision de « rondir » lambda vers une valeur plus simple.
Une fois la réponse transformée et le modèle ajusté, vos prédictions sont sur l’échelle transformée, pas l’originale. Une prédiction de 3,2 signifie 3,2 unités de (xλ - 1) / λ, pas 3,2 unités de chiffre d’affaires.
L’interprétation des coefficients change après transformation. Sur l’échelle transformée, une augmentation d’une unité d’un prédicteur correspond à une variation de y(λ), pas de y original. Si lambda est proche de 0 (quasi-log), on peut approximer des variations en pourcentage sur l’échelle d’origine. Pour d’autres valeurs, la relation dépend du niveau actuel de x et devient plus impliquée.
Pour revenir à l’échelle d’origine, appliquez l’inverse :
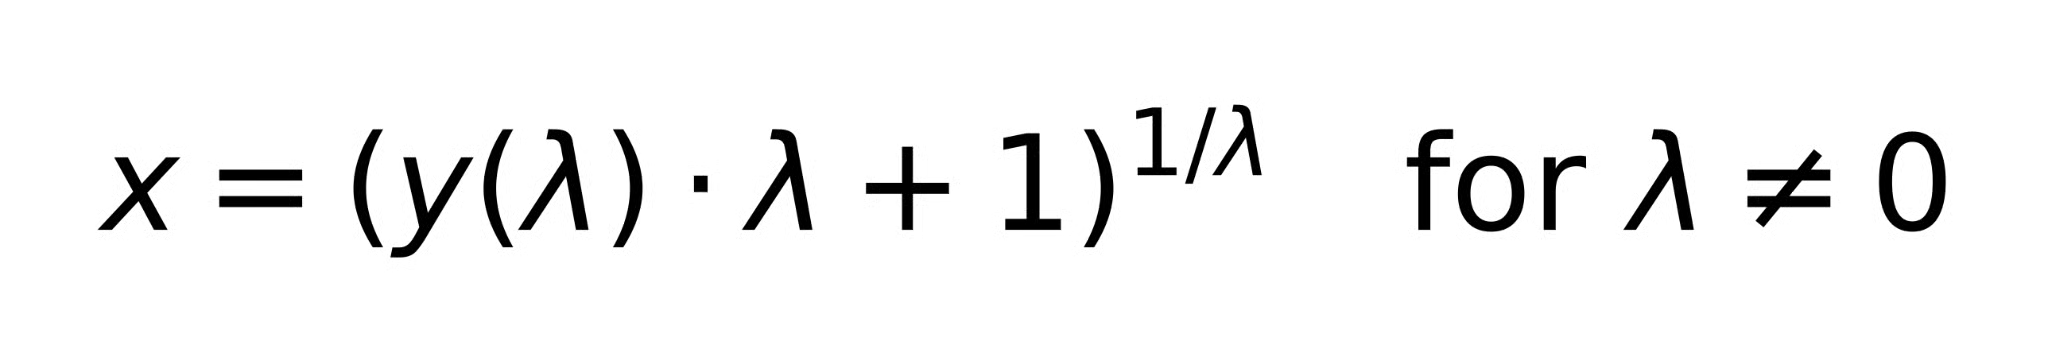
Pour lambda = 0, l’inverse de ln(x) est simplement exp(y).
Rétro-transformer la moyenne prédite sur l’échelle transformée ne fournit pas une estimation sans biais de la moyenne sur l’échelle d’origine. C’est une conséquence connue de l’inégalité de Jensen, particulièrement importante en prévision de moyennes dans des modèles log-linéaires. Aller plus loin dans la correction de biais dépasse notre cadre ici. Notre cours Introduction to Regression in Python couvre plus largement la prédiction et l’interprétation en régression si vous souhaitez ce contexte.
Quand privilégier Box-Cox plutôt que des alternatives déjà familières ?
La transformation logarithmique est le cas lambda = 0 de Box-Cox. Point final. Si vous avez déjà utilisé le log, vous avez appliqué un cas particulier de Box-Cox avec un lambda fixé plutôt qu’estimé. L’avantage de Box-Cox est de ne pas s’engager d’emblée sur lambda = 0. Cela dit, si votre vraisemblance profilée culmine nettement à lambda = 0, utilisez simplement un log. Inutile de complexifier.
La transformation de Yeo-Johnson est une extension directe de Box-Cox conçue pour gérer les zéros et valeurs négatives. C’est celle à privilégier lorsque vos données incluent des zéros (des comptes, par exemple) ou des négatifs. Les transformations sont mathématiquement proches ; Yeo-Johnson assouplit simplement la contrainte de positivité. Dans scikit-learn, PowerTransformer prend en charge les deux, method='box-cox' et method='yeo-johnson', ce qui facilite l’essai.
La standardisation (z-score) décale et met à l’échelle : moyenne à 0, écart type à 1. Box-Cox modifie la forme de la distribution par une transformation non linéaire. Elles répondent à des besoins différents. La standardisation ne réduit ni l’asymétrie ni ne stabilise la variance. Box-Cox ne centre pas vos données et ne rend pas les variables comparables en magnitude. Vous pouvez faire les deux, en transformant d’abord puis en standardisant, mais ce ne sont pas des substituts.
Beaucoup paraissent évidentes après coup. Cela n’empêche pas qu’elles surviennent, et certaines sont assez subtiles pour que « évidentes » soit un grand mot.
La formule s’effondre à 0 ou en dessous. 0λ vaut 0 pour λ positif et est indéfini pour λ négatif ; log(0) est moins l’infini. Si vos données contiennent des zéros ou des négatifs, Box-Cox lèvera une erreur ou produira silencieusement des absurdités. Utilisez Yeo-Johnson, ou ajoutez une petite constante positive en décalage. Cette dernière est une approximation à manier avec prudence.
Box-Cox doit répondre à un problème de modélisation précis : variance non constante, mauvaise linéarité, hypothèses résiduelles violées. L’utiliser comme prétraitement automatique pour « rendre jolie » votre distribution marginale avant tout modèle est une erreur. Le lambda qui normalise votre réponse isolément n’est pas nécessairement celui qui améliore les résidus du modèle.
Estimer lambda n’est que la moitié du travail. Après transformation et ré-ajustement, recontrôlez vos graphiques de résidus. Box-Cox ne garantit pas le respect des hypothèses. Elle vous donne une vraie chance. Si les résidus s’évasent encore, ou s’il y a de la courbure, autre chose cloche.
Après transformation, les coefficients ne décrivent plus des relations sur l’échelle d’origine. Cela piège souvent au moment de rapporter des résultats ou de prévoir. Suivez toujours l’échelle sur laquelle vous travaillez.
Un lambda estimé sur la distribution univariée (en regardant juste l’histogramme de la réponse) peut différer de celui estimé dans un modèle de régression. La bonne approche est celle basée sur la régression. L’objectif est de satisfaire les hypothèses sur les résidus, pas celles de la distribution marginale.
Quand vous déployez un modèle entraîné sur des données transformées, vous devez transformer les nouvelles entrées de la même façon avec le même lambda, puis rétro-transformer les prédictions. Omettre l’une ou l’autre étape produit des prédictions sur la mauvaise échelle. Cela semble évident et pourtant cela arrive régulièrement.
Box-Cox est une famille de transformations, pas une seule. Lambda détermine celle que vous obtenez, et le log n’est que le cas particulier lambda = 0. La plupart des analystes utilisent le log par défaut sans y réfléchir. Box-Cox explicite ce choix et vous offre une manière rigoureuse de vérifier si une autre valeur de lambda ne servirait pas mieux le modèle.
Utilisez-la pour diagnostiquer un problème précis : hétéroscédasticité des résidus, non-linéarité, hypothèses manifestement violées. L’appliquer automatiquement à toute variable réponse est une habitude à perdre. Et si vos données contiennent des zéros ou des négatifs, ce n’est pas le terrain de Box-Cox : c’est celui de Yeo-Johnson.
Pour approfondir les méthodes de régression auxquelles Box-Cox est souvent adossée, nos cours Intermediate Regression in R et Introduction to Regression with statsmodels in Python sont de bons prochains pas.
Apprenez avec DataCamp
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {blog} other {blogs}}
Kurtis Pykes
15 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Josef Waples
8 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Mark Pedigo
10 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Samuel Shaibu
9 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Laiba Siddiqui
14 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Josef Waples
3 min