

Gemini 4 Argon API란?
Gemini 4 Argon API는 gemini-4-argon을 제공합니다. 이는 복잡한 코딩과 다단계 에이전트 작업을 위해 설계된 Google의 추론 모델입니다. 2026년 10월 중순에 일반 제공(GA)에 도달했습니다. 모델 페이지에 따르면 입력, 사고, 출력이 하나의 1,048,576 토큰 윈도우를 공유하며, 동기식 응답은 출력 토큰 65,536에서 중단됩니다.
Google은 ADK 사례 연구에서 유사한 실험을 진행했습니다. Python Agent Development Kit(ADK)의 /goal로 11시간짜리 Antigravity 실행입니다. 검토자는 6개 제안 중 2개를 채택해 긴 세션에서 세션 준비 시간을 약 40% 줄이고 import를 21% 줄였습니다. 이 튜토리얼은 대신 작은 Python 루프를 사용합니다.
다음 네 가지 API 기능을 사용합니다:
-
Interactions API: 새 프로젝트에 권장되는 Google의 인터페이스로, 서버에 대화 상태를 유지합니다
-
함수 호출: 모델이 도구를 요청하면, 도구를 실행할지 여부를 여러분의 코드가 결정합니다
-
thinking_level:low,medium(기본값),high -
usage객체: 입력, 캐시, 출력, 사고 토큰을 보고합니다
Argon이 요청하고, 여러분의 코드가 일을 수행합니다.
프로젝트: Gemini 4 Argon이 고칠 느린 Python 앱
에이전트는 EventFlow 코드, 8가지 도구, 그리고 느려진 이유에 대한 단서 없이 시작합니다. 전체 코드는 GitHub에 있습니다. EventFlow로 시작하세요.
EventFlow의 동작 방식
EventFlow는 여섯 개의 작은 모듈로 된 가상의 이벤트 처리기입니다. 이벤트는 EventFlow.ingest()로 들어오고, validate()가 이를 Event로 변환하며, CustomerState가 고객별로 타임스탬프 순으로 저장합니다. 이후 summarize()가 각 이력을 세션, 매출, 환불, 페이지 수로 요약하고, build_report()가 CustomerReport를 생성합니다.
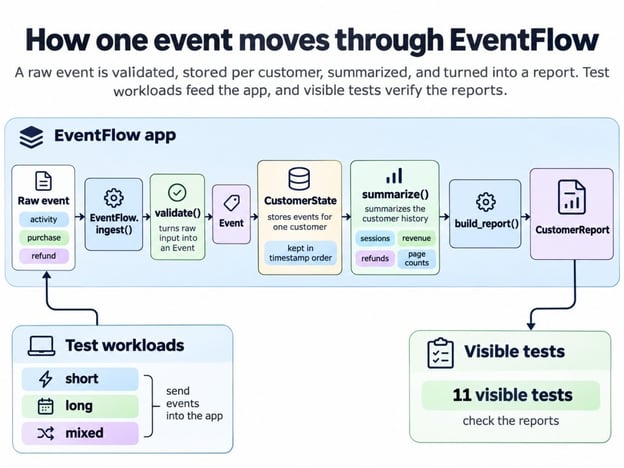
하나의 이벤트가 보고서가 되는 과정. 이미지: 작성자.
EventFlow의 독스트링은 다음 규칙을 설정합니다:
-
세션은 30분 공백 이후 분리됨
-
환불은 해당 구매 잔액을 초과할 수 없음
-
중복된
event_id는 무시되며, 최초 사본이 우선 -
이벤트는 배치를 넘어도 타임스탬프 순으로 정렬
-
history()와report()는 호출자가 소유하는 객체를 반환
숨겨진 테스트는 모두 이를 검증하며, 마지막 규칙은 뒤에서 다시 등장합니다.
EventFlow가 느려지는 이유
고정된 시드로 만든 세 가지 워크로드는 이력 길이에 따라 그림이 어떻게 달라지는지 보여줍니다:
-
short: 고객 수는 많고 각 5개 이벤트 -
long: 고객 수는 적고 각 160개 이벤트 -
mixed: 고객별 1~30개 이벤트, 중복과 순서 뒤바뀜 포함
long은 short보다 이벤트 수가 훨씬 적어도 시간이 약 3배 더 걸립니다. 아래 차트는 총 이벤트 수를 1,600으로 고정하면서 고객당 이력을 늘렸습니다.
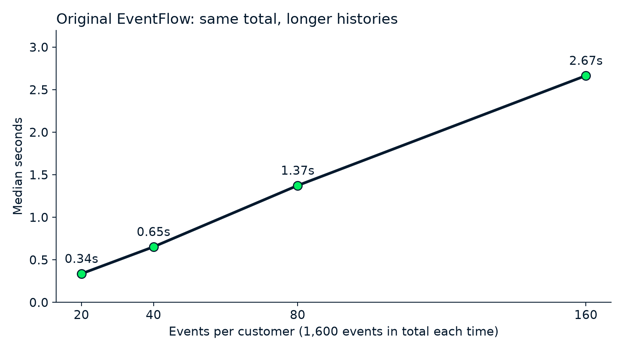
총량은 같아도, 이력이 길어질수록 처리 속도는 느려집니다. 이미지: 작성자.
이력 길이가 두 배가 될 때마다 실행 시간도 두 배가 되는데, 총 이벤트 수는 변하지 않습니다. 이런 패턴은 보통 어떤 단계가 매 이벤트마다 전체 이력에 대해 작업을 반복한다는 뜻입니다. 에이전트는 원인을 보지 못하므로, Argon의 차례가 끝난 뒤에 이름을 밝히겠습니다.
성공 기준과 숨겨진 테스트
수정은 첫 API 호출 전에 정한 다섯 가지 검사를 통과해야만 인정됩니다. 모델의 자체 보고서는 점수에 반영되지 않습니다. 에이전트의 최종 코드는 다음을 모두 만족해야 합니다:
-
long에서 최소 1.5배 더 빠르게 실행 -
short또는mixed에서 5% 이상 느려지지 않음 -
모든 보이는 테스트 통과
-
세 가지 워크로드 모두에서 원본과 동일한 보고서 출력 반환
-
모든 숨겨진 승인 케이스 통과
이 임계값은 제 기준이므로 예시로 보세요. 에이전트의 도구는 숨겨진 케이스에 접근할 수 없으며, 코드를 동결한 뒤에만 실행됩니다. 새 데이터, 지연된 배치, 중복, 소유권 규칙에서 에이전트의 코드를 분리된 기준 구현과 비교합니다.
숨겨진 스위트는 잘못된 수정을 걸러낼 때만 유용하므로, 일부러 몇 가지 오답을 넣어보세요. 여기서는 두 가지 쉬운 지름길이 모든 보이는 테스트를 통과합니다. 하나는 깊은 복사를 빼는 것이고, 다른 하나는 요약을 캐싱해놓고 절대 새로고침하지 않는 것입니다. 숨겨진 케이스는 둘 다 거부합니다.
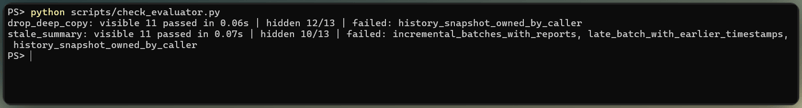
숨겨진 테스트가 두 가지 잘못된 수정을 잡아냅니다. 이미지: 작성자.
Python에서 Gemini 4 Argon API 설정 방법
Python 3.10 이상, Gemini API 키, 그리고 결제가 활성화된 Google AI Studio 프로젝트가 필요합니다. 요금 페이지에는 Argon의 Free 티어가 없다고 나와 있습니다. 이 프로젝트는 google-genai SDK를 2.33.0으로 고정합니다. Interactions API는 최소 2.3.0이 필요합니다.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envmacOS나 Linux에서는 가상 환경을 source .venv/bin/activate로 활성화하고 cp로 복사한 뒤, GEMINI_API_KEY=...를 .env에 넣으세요. 셸에 GOOGLE_API_KEY도 설정되어 있으면 SDK가 이를 대신 사용하므로, 아래 코드는 먼저 이를 제거합니다. Interactions API를 사용해본 적이 있다면 다음 절은 건너뛰세요.
첫 Gemini 4 Argon API 요청 보내기
첫 요청은 EventFlow의 프로파일러 출력 상단을 Argon에 건네고, 그 의미를 묻습니다. load_dotenv()가 .env에서 GEMINI_API_KEY를 로드하고, genai.Client()가 이를 읽으며, 모델 ID는 client.interactions.create()에 들어갑니다. generation_config는 사고 수준을 전달합니다.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)응답은 다음과 같았습니다:
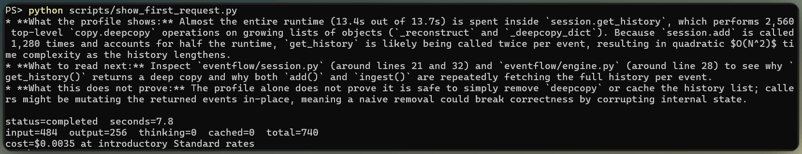
첫 Argon 요청이 프로파일을 읽습니다. 이미지: 작성자.
Argon의 해석은 정확했습니다. 거의 모든 시간이 get_history()와 copy.deepcopy 아래에 있었고, 아마도 이벤트당 두 번 호출된 듯했습니다. 세 번째 불릿은 깊은 복사를 제거하면 반환값을 수정하는 호출자가 깨질 수 있다고 경고했는데, 이는 앞서 언급한 첫 번째 지름길입니다. 이런 질문은 비용이 낮습니다. 8초 이하, 반센트 미만, 사고 토큰도 없습니다.
medium은 기본값이며, 앞서 링크한 latest-model 가이드는 "복잡한 코드와 에이전트형(use cases)에 포함한 대부분의 작업"에 이를 권장합니다. 같은 가이드는 temperature, top_p, top_k가 Argon에서는 무시된다고 하니 빼두세요.
Gemini 4 Argon 사용 전, Python 코드를 프로파일링하세요
모델이 코드를 건드리기 전에 원본 앱을 측정해 두세요. 그래야 이후 수치에 비교 기준이 생깁니다. 측정은 각 도구가 서로에 영향을 주므로, 각각 별도의 프로세스에서 세 가지를 수행합니다:
-
time.perf_counter()로 타이밍: 각기 새 프로세스 여러 번의 중앙값(각 1회 워밍업 포함) -
cProfile로 프로파일링: 시간이 어디서 쓰이는지 찾기; 이는 long을 약 6배 느리게 만들었으니, 프로파일러 하에서 잰 시간은 신뢰하지 마세요 -
tracemalloc으로 메모리: 전체 프로세스 메모리가 아닌 추적된 Python 할당의 피크를 보고
고정 1,600 이벤트의 차트 대신 세 가지 워크로드에서, 원본 앱은 short에서 약 0.7초, long에서 2.2초, mixed에서 1.0초 정도 걸렸습니다. 또한 모든 보이는 pytest 테스트를 통과했습니다.
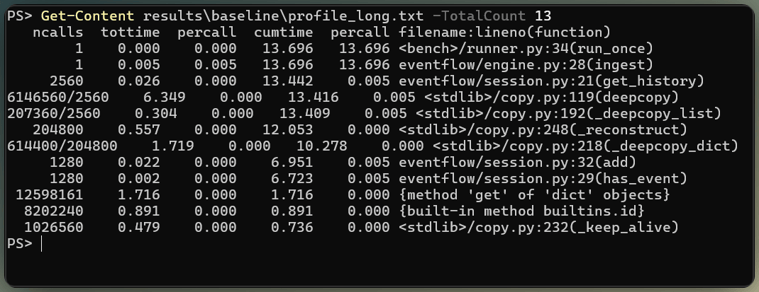
느린 앱이 시간을 보내는 곳. 이미지: 작성자.
드리프트를 예상하세요. 같은 코드가 나중에는 약 10% 더 빠르게 측정되었으므로, 한 세션 내에서 모든 버전을 재세요.
Gemini 4 Argon 함수 호출로 성능 에이전트 만들기
앞서 언급했듯, Argon은 도구를 요청만 합니다. 이를 실행하는 Python 코드는 하니스(harness)라고 하며, 우리의 에이전트 하니스 엔지니어링 가이드는 검증이 프롬프트가 아닌 코드에 있어야 하는 이유를 설명합니다. Argon이 건드릴 수 있는 범위를 결정하므로 도구부터 봅니다.
에이전트의 도구와 권한 정의
앞서 말한 8가지 도구는 평범한 JSON 스키마로 선언된 Python 함수이며, 이 중 코드 변경이 가능한 것은 둘뿐입니다:
-
list_files와read_file: 앱의 Python 소스, 테스트, 픽스처로 제한 -
run_profiler와run_benchmark: 지정한 워크로드 한 개에 대해 실행 -
apply_patch: 기존 앱 소스 파일에서 정확히 한 번 나타나는 텍스트를 치환 -
revert_file,run_tests,show_diff
선언은 앞서 링크한 함수 호출 가이드의 형식을 따릅니다:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},스키마는 호출을 설명할 뿐 안전하게 만들진 않습니다. 하니스는 Python에서 다음 검증을 추가합니다:
- 모든 경로는 먼저 해석되어, 복사본 앱을 벗어나는 경로는 실패
- 앱 소스 폴더 밖으로의 쓰기는 거부
- 패치된 파일은 여전히 컴파일 가능해야 하며, 아니면 패치 거부
- 테스트와 벤치마크는 API 키 없이 타임아웃이 있는 서브프로세스에서 실행
이는 컨테이너가 아니며, 패치된 코드가 여전히 복사본 밖의 파일을 읽을 수도 있으므로 최소 수준으로 보세요.
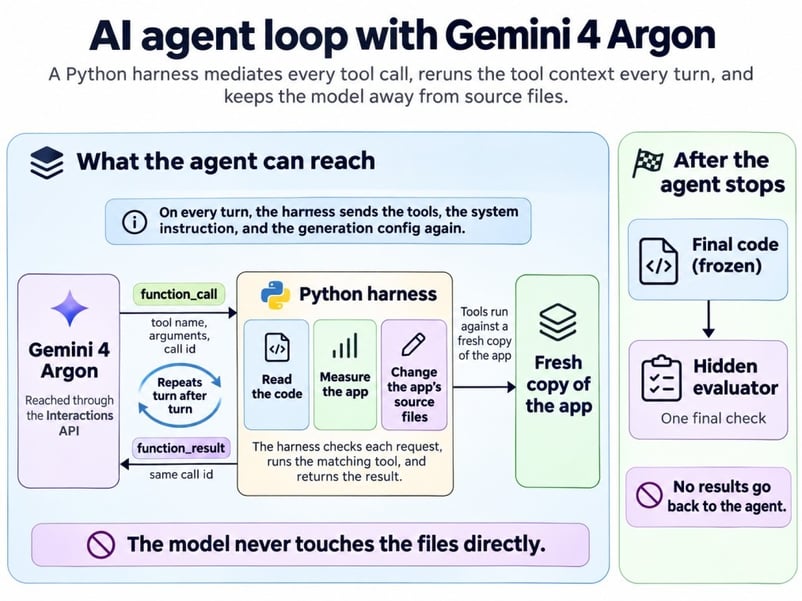
Argon이 요청하고, Python이 결정하고 실행합니다. 이미지: 작성자.
에이전트에 측정 가능한 성능 목표 부여
시스템 지시문은 목표와 규칙을 명시하지만, 어디가 느린지는 밝히지 않습니다:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.에이전트는 보이는 테스트, 프로파일러와 벤치마크 결과, 다음에 설정할 루프의 한계를 바탕으로 스스로 종료 시점을 결정합니다.
Interactions API 도구 루프 구현
아래 스니펫은 루프의 핵심이며, 전체 버전은 클라이언트, 도구 디스패처, 제한을 추가합니다. 각 턴은 하나의 client.interactions.create() 호출이며, Argon은 한 턴에 여러 도구를 자주 요청하므로, 반환된 모든 function_call 단계를 실행하세요. 각 결과는 일치하는 call_id와 함께 function_result로 다시 보내세요:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request를 후속 호출에 넣는 줄을 사람들이 종종 빼먹습니다. previous_interaction_id는 히스토리를 넘기지만, tools, system_instruction, generation_config는 상호작용 범위이므로, 이를 생략하면 도구를 잃거나 기본 사고 수준으로 돌아갑니다. 이 규칙을 잊기 쉬워서, 코드에서는 세 설정을 하나의 dict로 묶어둡니다.
API에는 작업 예산이 없으므로, 시작 전에 애플리케이션에서 턴, 시간, 비용 제한을 설정하세요. 저는 40턴, 10개 패치, 45분, $5를 사용했으며 어떤 시도도 가까워지지 않았습니다. 다만 비용 검사는 턴 사이에 이루어지므로, 하나의 긴 턴이 이를 초과할 수 있습니다. Google의 할당량 제한 페이지는 티어 1 계정에 10분 롤링 기준 $10의 상한을 두며, 이를 넘기면 429 RESOURCE_EXHAUSTED를 반환합니다.
Gemini 4 Argon 에이전트를 실행하고 변경 사항 검증하기
각 시도는 앱의 새 복사본에서 시작했고, 약 5분 이내에 스스로 종료했으며, 숨겨진 검사가 실행되기 전에 코드가 동결되었습니다.
증거에서 병목 찾기
Argon은 먼저 측정해 병목을 찾았습니다. 아래는 첫 medium 시도의 턴별 로그입니다.
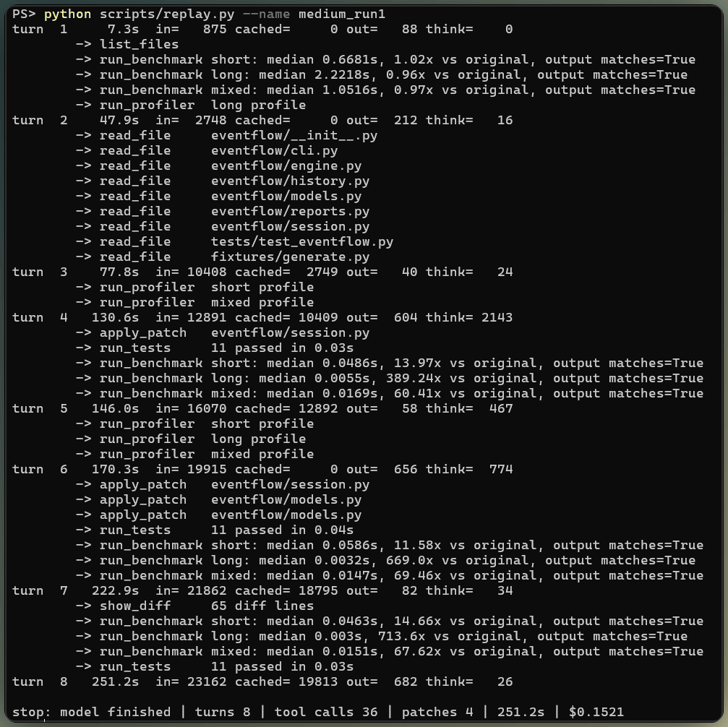
한 번의 medium 시도를 턴별로. 이미지: 작성자.
사고 요약은 모든 단계가 아닌 추론의 응축본으로, 어떻게 해결에 도달했는지 보여줍니다. Argon은 has_event()와 add()가 모두 get_history()를 호출한다는 점을 알아챘습니다. 깊은 복사가 "여기서 정말 필요한지, 아니면 호출자가 데이터를 소유한다는 요구인지"를 물었고, 입력을 수정하지 않는다고 밝힌 summarize()의 독스트링으로 이를 확인했습니다.
모든 주장에 증거가 있던 것은 아닙니다. 같은 요약에서 "테스트나 숨겨진 사용에서 직접 접근이 없다"고 말하는데, 이는 Argon이 알 수 없는 부분입니다. 이번에는 추측이 맞았지만, 리뷰에서 표시해 둘 만한 대목입니다.
여섯 번의 시도가 모두 도달한 수정
모든 시도는 CustomerState에 같은 핵심 변경을 적용했으며, 여섯 개 중 가장 작은 diff가 이를 가장 잘 보여줍니다:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = None이제 약속했던 심은 원인을 밝히겠습니다. add()는 매 이벤트마다 전체 이력을 다시 요약했고, 매 이벤트는 전체 깊은 복사를 두 번 수행했으며, 중복 검사는 리스트를 스캔했습니다.
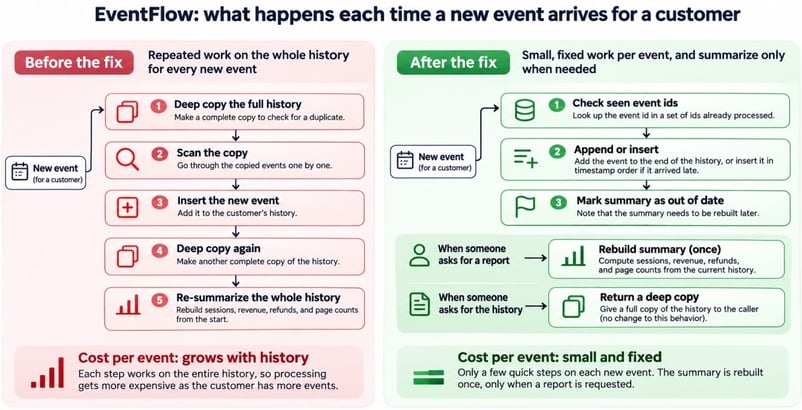
수정 전후 이벤트당 작업. 이미지: 작성자.
get_history()는 외부 호출자를 위해 깊은 복사를 유지합니다. 이는 앞서 언급한 깊은 복사 제거 지름길이 잘못 건드린 부분입니다.
모든 패치 라운드는 보이는 테스트를 통과해 에이전트가 되돌릴 필요는 없었지만, 대부분의 시도는 아무도 호출하지 않는 summary setter도 추가했습니다. 아무도 요구하지 않았고, 결국 누군가는 리뷰해야 합니다.
숨겨진 승인 테스트 결과
숨겨진 평가는 시도당 한 번 실행되었고, 모든 시도가 모든 케이스를 통과했습니다. 케이스는 report() 이후에 ingest()를 호출하고, 구매보다 먼저 환불을 보내며, 반환된 객체를 수정해 엔진 상태가 그대로인지 확인합니다.
Gemini 4 Argon은 정말 앱을 더 빠르게 만들었나요?
그렇습니다. 모든 새 버전은 훨씬 빨랐고 원본과 동일한 출력을 반환했습니다. 앞서 언급했듯 타이밍에는 드리프트가 있으므로, 원본과 6개 새 버전을 교차 순서로 각각 새 프로세스 9회씩 측정했습니다.
각 타이밍은 Python 시작이나 import가 아니라 ingest와 report만 포함합니다. 몇 밀리초 수준에서는 단일 측정이 중앙값보다 훨씬 높게 나올 수 있으니, 중앙값을 비교하세요. 로그 스케일 차트는 새 버전이 원본 옆에서 사라지지 않도록 합니다.
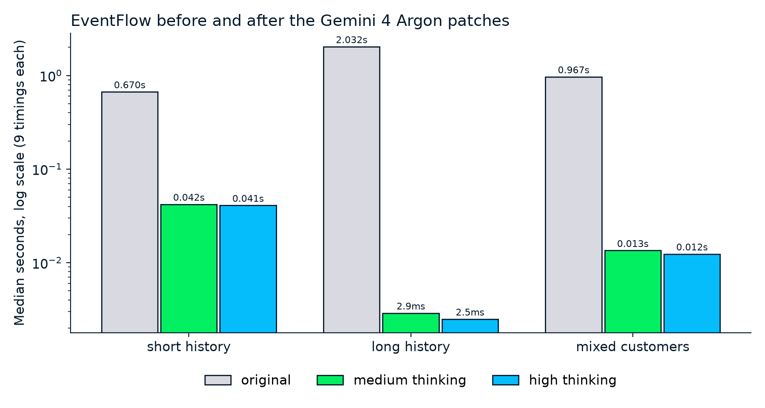
수정 전은 초, 수정 후는 밀리초지만 출력은 동일. 이미지: 작성자.
차트는 각 사고 수준의 첫 시도를 보여주고, 표는 6회 전체를 다룹니다. 속도 향상은 원본 중앙값을 새 중앙값으로 나눈 값입니다:
|
측정 |
원본 |
Medium (3회) |
High (3회) |
|
|
기준 |
14.8배 ~ 15.9배 |
16.3배 ~ 17.4배 |
|
|
기준 |
656배 ~ 701배 |
약 810배 |
|
|
기준 |
65.4배 ~ 71.6배 |
76.8배 ~ 78.0배 |
|
피크 추적 메모리, |
7,108 KiB |
7,822 KiB |
7,822 KiB |
|
피크 추적 메모리, |
885 KiB |
570 KiB |
569 KiB |
long이 가장 큰 향상을 보였습니다. 제거된 작업이 고객 이력 길이에 비례해 늘어났기 때문입니다. 메모리 행만이 수정 비용이 드는 부분입니다. short는 고객 수가 가장 많아 새로 추가된 고객별 ID 집합 때문에 약 10% 더 썼고, long은 복사를 중단한 덕에 더 적게 사용한 듯합니다.
700배라는 수치를 Argon 자체의 특별함으로 받아들이지 마세요. 합성 데이터에서 제곱 시간 루프를 제거하면, 누가 수정을 하든 대개 이런 숫자가 나옵니다.
Gemini 4 Argon 사고 수준: Medium vs. High
이 작업에서 high는 medium보다 약간 더 빠른 코드를 작성했지만, 두 수준 모두 같은 수정을 찾았으므로, 추가 사고는 진단보다는 다듬기에 쓰였습니다.
공정한 비교 유지
사고 수준만 바꾸고 나머지는 그대로 유지합니다. 모든 시도는 동일한 코드, 프롬프트, 도구, 제한, 평가기를 사용했고, 어느 것도 다른 시도의 결과를 보지 못했습니다. 두 수준은 번갈아 3회씩 수행되었으며, 이는 제 Claude Opus 5 API 튜토리얼에서 사용한 것과 같은 설정입니다.
수준별 결과, 시간, 비용
두 수준은 시도당 평균으로 보면 다음과 같이 나뉩니다:
|
시도당 평균 |
Medium |
High |
|
채택된 수정 |
3/3 |
3/3 |
|
도구 호출 수 |
28 |
35 |
|
사고 토큰 |
1,877 |
14,764 |
|
변경된 라인 수 |
24 |
193 |
|
시간 |
3.4분 |
5분 |
|
출시가 기준 비용 |
$0.10 |
$0.29 |
|
출시가 종료 후 비용 |
$0.20 |
$0.58 |
high는 첫 패치에서 같은 수정을 적용한 뒤 계속 다듬었습니다. 더 이상 핵심 병목이 아닌 요약, 보고, 검증의 일부도 다시 썼습니다.
이 격차는 머신에 따라 달라지고, 이미 밀리초에 끝나는 워크로드에서는 타이밍 노이즈와 비슷하므로, 리뷰 시간만 고려해도 medium의 더 작은 diff를 택하겠습니다.
High의 사고 토큰은 4번째 턴에서 정점을 찍었는데, 첫 패치로 이미 문제가 해결된 뒤였습니다.
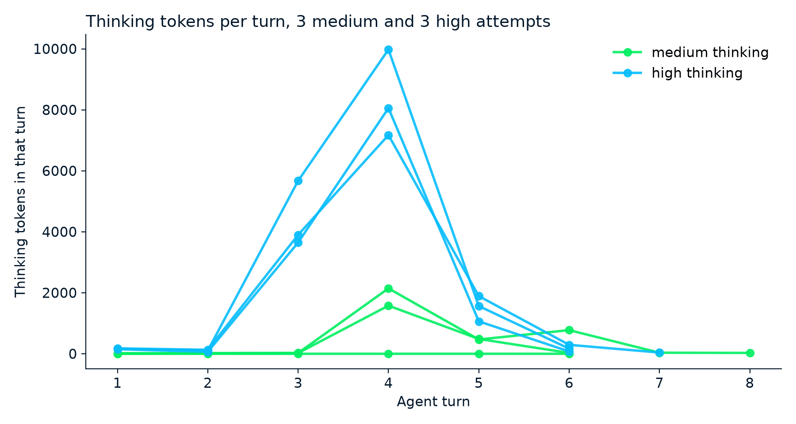
각 시도가 사고 토큰을 쓴 위치. 이미지: 작성자.
사고 토큰을 품질 신호로 받아들이지도 마세요. 첫 요청처럼, 한 medium 시도는 사고 토큰을 전혀 쓰지 않고도, 어떤 시도보다 빠르고 저렴하게 채택된 수정을 만들었습니다.
에이전트의 비용을 계산할 때는 매 턴의 usage를 모두 합산하세요. 각 턴은 처리한 전체 컨텍스트를 보고합니다. 매 턴의 입력 대부분은 이전 턴의 반복이며, 암시적 캐시는 약 3분의 2를 캐시 요금으로 청구했습니다.
캐싱 가이드에 따르면, 캐시는 최소 4,096 토큰의 프롬프트가 필요하고, 새 토큰이 2,050 미만으로 추가된 턴은 이전 요청의 마지막 2,050 토큰에 대해 전체 요금을 냅니다. 작은 도구 결과를 주고받는 루프는 절감 효과가 적습니다. Standard 출시가 기준(FAQ에서 다룸)으로 여섯 번의 시도 총비용은 $1.16이었습니다.
AI 성능 에이전트의 한계
이런 에이전트는 프로파일러가 지목할 수 있는 문제에 가장 잘 작동하며, 여기서는 이를 염두에 두고 깔끔하게 만들었습니다:
-
앞서 말했듯 병목은 심어 두었습니다. 프로파일러는 여섯 개의 작은 파일에 있는 제곱 시간 루프를 거의 곧장 가리키지만, 실제 느려짐은 I/O, 데이터베이스, 문서화되지 않은 코드에 숨어 있습니다.
-
독스트링이 큰 역할을 했습니다. Argon은 어떤 복사를 생략해도 되는지 판단할 때 독스트링에 의존했으며, 문서가 없는 코드베이스는 이를 제공하지 않습니다.
-
테스트는 누군가가 떠올린 것만 확인합니다. Google의 ADK 사례 연구에서는 한 import 변경이 공개 스위트를 통과했지만 내부 테스트 타깃에서는 실패했습니다.
-
타이밍은 합성 워크로드의 소형 Linux 머신 한 대에서 나왔으므로, 여러분의 속도 향상은 다를 수 있습니다.
-
에이전트가 읽는 모든 파일은 Google로 전송되며, 유료 티어 상호작용은 기본적으로 55일간 저장됩니다.
store=false는 이를 막지만previous_interaction_id사용이 불가합니다.
Google의 모델 카드는 알려진 한계로 환각과 간헐적 타임아웃도 나열합니다.
마무리
에이전트는 여섯 번 모두에서 반복 요약과 깊은 복사를 찾아냈고, 호출자가 의존하는 복사는 유지했으며, 보류된 검사를 통과했습니다. high 사고는 약간의 추가 속도와 훨씬 큰 diff를 남겼습니다.
이는 제가 병목을 심었다는 점에서 여러분의 코드베이스에 일반화할 수 없습니다. 이어받을 수 있는 것은 방법입니다. 먼저 측정하고, 도구 범위를 좁게 유지하며, 검증 전에 코드를 동결하고, 결과는 숨겨진 테스트에 맡기세요.
제가 가장 먼저 만들 확장은 medium 에서 시작해 보이는 테스트가 실패할 때만 high로 올리는 라우터입니다. 이렇게 하면 숨겨진 케이스가 에이전트에 피드백되지 않습니다.
위의 프로파일러 출력이 낯설다면, Writing Efficient Python Code는 Argon이 코드를 건드리기 전에 제가 사용한 동일한 타이밍 및 프로파일링 도구를 다룹니다.
FAQs
Gemini 4 Argon이 자동으로 Python 코드를 빠르게 만들 수 있나요?
그 자체로는 불가능합니다. Interactions API는 아직 도구를 자동 실행하지 않으므로, 여러분의 코드가 이를 실행해야 합니다. 여기서는 검증 코드가 앱의 두 배 크기가 되었습니다.
Gemini 4 Argon이 자체로 Python 코드를 실행할 수 있나요?
예, 내장된 코드 실행 도구로 가능합니다. 다만 30초 후 중단되며 pytest를 설치할 수 없습니다. 실제 테스트는 여러분의 머신이나 우리의 Managed Agents 튜토리얼의 호스팅된 설정을 사용하세요.
이런 에이전트에는 low 사고 수준을 써야 하나요?
시험해 보지는 않았고, Google은 어려운 작업에서 품질이 떨어질 수 있다고 말합니다. 턴마다 수준을 설정할 수 있으니, 파일 읽기에는 low, 패치 작성에는 medium을 권합니다.
Gemini 4 Argon API 비용은 얼마인가요?
저는 입력 토큰 백만 개당 $2, 출력 토큰 백만 개당 $10(사고 포함)을 지불했으며, 이 가격은 2026년 11월 30일 이후 두 배가 됩니다. Flex는 절반이지만 요청당 최대 15분이 걸릴 수 있어, 하룻밤 실험 정도에만 권하겠습니다.
프로덕션 코드베이스에 이 에이전트를 사용할 수 있나요?
현 상태 그대로는 권하지 않습니다. 일회용 컨테이너에서 실행하고, 사람이 모든 diff를 리뷰하세요. 또한 Argon의 지식은 2026년 3월까지이므로, 최신 라이브러리에 대해서는 최신 문서를 제공하세요.
고장난 것은 아니고, 단지 느린 Python 앱에 Gemini 4 Argon이 어떻게 대응하는지 확인하고 싶었습니다. 모든 테스트는 통과하고 모든 보고서는 정확하지만, 몇 가지 작업이 밀리초가 아니라 초 단위로 걸리며, 고객의 이력이 길어질수록 더 나빠집니다. 많은 AI 코딩 튜토리얼은 실패하는 테스트에서 시작해 모델에 분명한 표적을 제시하곤 합니다.
그런데 여기에는 느린 코드를 가리키는 실패 테스트가 없습니다. Gemini 4 Argon은 Gemini API를 통해 Python에서 호출하는 Google 모델이며, 목표를 향해 행동하는 AI 에이전트를 만드는 데 사용할 것입니다. 이 경우 에이전트는 코드를 읽고, 시간을 재고, 수정하지만 오직 여러분의 Python 코드가 제어하는 도구만을 통해 수행합니다.
앱은 EventFlow라는 소규모 가상 프로그램으로, 고객의 활동, 구매, 환불을 보고서로 전환합니다. 제 질문은 에이전트가 느린 부분을 찾아내고 앱의 반환값을 바꾸지 않고 고칠 수 있느냐였습니다. Python의 함수, 클래스, 테스트 실행에 익숙하다면 따라오실 수 있고, 다음 내용을 다룹니다:
우리의 Gemini 4 Argon 개요는 출시와 벤치마크를 다루므로, 이 튜토리얼은 API에 집중합니다. 더 넓은 모델 비교는 Gemini 4 Argon vs Claude Opus 5.5와 Gemini 4 Argon vs. GPT-6 Astra를 참고하세요.
요약
같은 작업을 6회 부여했으며,
medium사고 수준에서 3회,high에서 3회를 수행했고, 결과는 다음과 같습니다:Argon은 6회 모두에서 병목을 고쳤고, 별도의 숨겨진 테스트 세트도 이에 동의했습니다.
느린 워크로드는 약 2초에서 약 3밀리초로 단축되었습니다.
Argon은 코드를 바꾸기 전에 벤치마크와 프로파일러를 실행했습니다. 에이전트에 테스트와 함께 그런 도구도 제공하세요.
high는medium보다 비용이 약 3배 더 들었고(시도당 평균 $0.29 대 $0.10), 약간의 추가 속도 향상을 위해 8배 큰 diff를 썼습니다.medium부터 시작하세요.작은 앱 하나에 병목을 의도적으로 심었으므로, 이 결과는 이 사례에만 해당합니다.