

什么是 Gemini 4 Argon API?
Gemini 4 Argon API 提供 gemini-4-argon,这是一个为复杂编码与多步代理任务构建的 Google 推理模型。它在 2026 年 10 月中旬实现全面可用。根据 模型页面,输入、思考与输出共享一个 1,048,576 令牌的窗口,同步响应的输出在 65,536 令牌处停止。
Google 在其 ADK 案例研究中做过类似实验:在 Python Agent Development Kit (ADK) 上,用 /goal 跑了一个 11 小时的 Antigravity。审稿人保留了 6 个提案中的 2 个,将长会话中的准备时间缩短了约 40%,导入量减少了 21%。本教程则用一个小型的 Python 循环。
您将用到四项 API 功能:
-
Interactions API:Google 推荐给新项目的接口,服务器端保留会话状态
-
函数调用:模型请求使用某个工具,而您的代码决定是否执行
-
thinking_level:low、medium(默认)或high -
usage对象:报告输入、缓存、输出与思考令牌
Argon 只负责“开口”,而真正的工作由您的代码完成。
项目简介:一个等待 Gemini 4 Argon 修复的缓慢 Python 应用
代理会拿到 EventFlow 的代码、8 个工具,但没有任何关于变慢原因的提示。完整代码在 GitHub 上。从 EventFlow 开始。
EventFlow 的工作原理
EventFlow 是一个由六个小模块组成的虚构事件处理器。事件进入 EventFlow.ingest(),validate() 将其转为 Event,CustomerState 按客户以时间戳顺序存储。然后 summarize() 将每段历史变为会话、收入、退款与页面计数,build_report() 生成 CustomerReport。
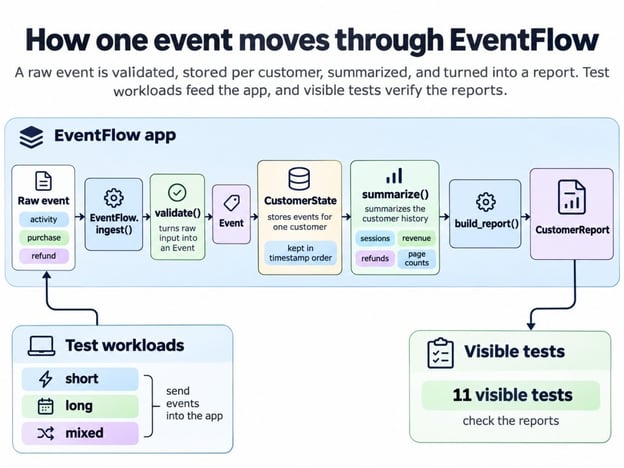
单个事件如何变成报表。图片来源:作者。
EventFlow 的文档字符串设定了以下规则:
-
会话在 30 分钟间隔后拆分
-
退款上限为购买剩余额度
-
重复的
event_id会被忽略,首个副本优先 -
事件按时间戳排序,即使跨批次
-
history()与report()返回的对象由调用方所有
隐藏测试会检查所有这些规则,最后一条稍后还会再出现。
EventFlow 为何会变慢
三个基于固定种子的工作负载展示了历史长度如何改变整体表现:
-
short:很多客户,每个 5 条事件 -
long:少量客户,每个 160 条事件 -
mixed:每个客户 1 到 30 条事件,包含重复与乱序抵达的事件
long 的事件数远少于 short,却仍然大概慢 3 倍。下图在总计 1,600 条事件不变的情况下,增加了每个客户的历史长度。
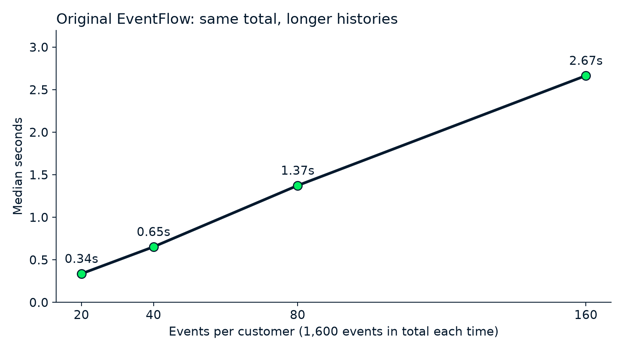
总量相同、历史更长、处理更慢。图片来源:作者。
每当历史长度翻倍,运行时间也翻倍,尽管事件总数不变。这种模式通常意味着某个步骤在每条新事件上都重复处理整个历史。代理从未看到原因,所以等 Argon 给出方案后我再来点名。
成功标准与隐藏测试
只有在通过首次 API 调用之前就设定的五项检查时,修复才算数;模型自己的报告不计分。代理的最终代码必须做到:
-
在
long上至少快 1.5 倍 -
在
short或mixed上最多慢 5% -
通过所有可见测试
-
在三种工作负载上都返回与原版相同的报表输出
-
通过所有隐藏验收用例
这些阈值是我自己定的,仅供示例。代理的工具无法触达隐藏用例;它们只会在代理代码冻结后才运行。它们会在新数据、晚到批次、重复事件与所有权规则上,将代理代码与单独的参考实现进行比较。
隐藏套件只有在能拒绝错误修复时才有用,所以请有意喂给它几个。这里有两条容易的捷径能通过所有可见测试,去掉深拷贝以及缓存摘要而从不刷新。隐藏用例会拒绝二者。
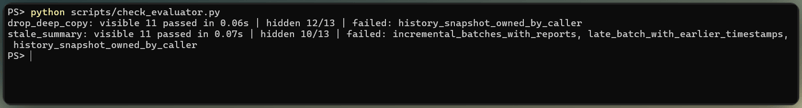
隐藏测试抓住了两种错误修复。图片来源:作者。
如何在 Python 中设置 Gemini 4 Argon API
您需要 Python 3.10 或更新版本、一个 Gemini API 密钥,以及启用了计费的 Google AI Studio 项目,因为定价页面未列出 Argon 的免费层。本项目将 google-genai SDK 固定在 2.33.0;Interactions API 至少需要 2.3.0。
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env在 macOS 或 Linux 上,用 source .venv/bin/activate 激活虚拟环境,复制用 cp,然后把 GEMINI_API_KEY=... 写入 .env。如果您的 shell 中也设置了 GOOGLE_API_KEY,SDK 会优先使用它,所以下面的代码会先把它移除。若您之前用过 Interactions API,可跳过下一小节。
发出您的第一个 Gemini 4 Argon API 请求
您的第一个请求把 EventFlow 的分析器输出顶部交给 Argon,并询问它看到了什么。load_dotenv() 从 .env 加载 GEMINI_API_KEY,genai.Client() 读取它,模型 ID 放入 client.interactions.create(),而 generation_config 携带思考级别。
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)返回结果如下:
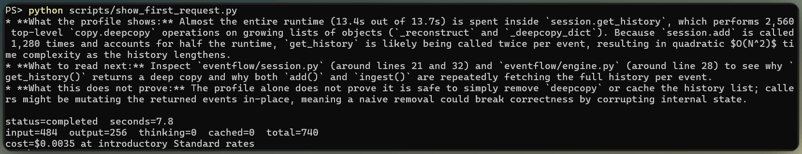
第一次 Argon 请求阅读分析结果。图片来源:作者。
Argon 理解正确;几乎所有时间都耗在 get_history() 和 copy.deepcopy 下,可能每个事件调用了两次。第三条要点警告说移除深拷贝可能会破坏那些会修改返回结果的调用方,这正是我前面提到的第一个捷径。这样的提问很便宜:用时不到 8 秒、成本不到半美分,且没有思考令牌。
medium 是默认级别,前面链接的最新模型指南建议它“适用于大多数任务,包括复杂代码与代理场景”。同一指南称 temperature、top_p 与 top_k 在 Argon 上会被忽略,所以别设它们。
在用 Gemini 4 Argon 前先为 Python 代码做分析
在模型接触之前先测量原始应用,这样后续数字都有可比对象。进行三类测量,每个各自独立进程,因为每种工具都会干扰其他工具:
-
用
time.perf_counter()计时,取多个全新进程(各一次预热)的中位数 -
用
cProfile定位时间去向;它让 long 慢了约 6 倍,所以永远不要相信分析器下的计时结果 -
用
tracemalloc看内存,它报告的是 Python 跟踪到的峰值分配,而不是整个进程内存
在这三种工作负载(而非上图固定的 1,600 事件)上,原始应用在 short 大约 0.7 秒、在 long 2.2 秒、在 mixed 1.0 秒。它也通过了所有可见的 pytest 测试。
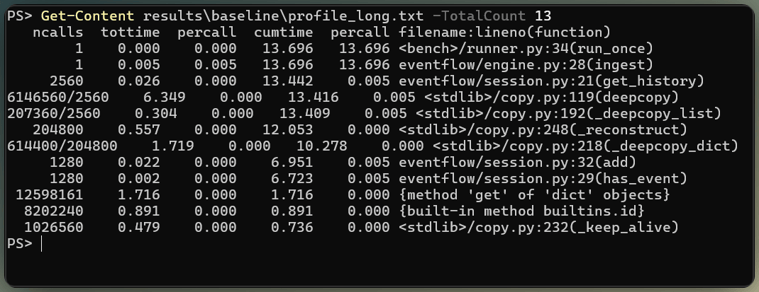
慢应用的时间都花在哪。图片来源:作者。
预期会有漂移:相同代码稍后计时大约快了 10%,所以请在同一会话中为每个版本计时。
如何用 Gemini 4 Argon 函数调用构建性能代理
如前所述,Argon 只会请求工具。运行这些工具的 Python 代码称为 harness(挂载框架),我们的代理挂载框架工程指南解释了为什么检查应写进代码而非提示。先从工具开始,因为它们决定了 Argon 能接触什么。
定义代理的工具与权限
我前面提到的 8 个工具是以普通 JSON 模式声明的 Python 函数,且只有两个能改代码:
-
list_files与read_file,限定在应用的 Python 源码、测试与夹具 -
run_profiler与run_benchmark:针对一个指定工作负载 -
apply_patch:在现有应用源码文件中精确替换一处文本 -
revert_file、run_tests与show_diff
声明遵循我先前链接的函数调用指南中的格式:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},模式描述了调用,但并不能保证调用安全。挂载框架在 Python 中增加了这些检查:
- 每个路径都会先解析,逃离复制应用的路径将失败
- 拒绝写入应用源码文件夹之外的位置
- 补丁应用后文件仍需能编译,否则回滚该补丁
- 测试与基准在子进程中运行,有超时,且不带 API 密钥
这并不是容器,打补丁的代码仍可能读取复制之外的文件,所以把它当作最低限度的措施。
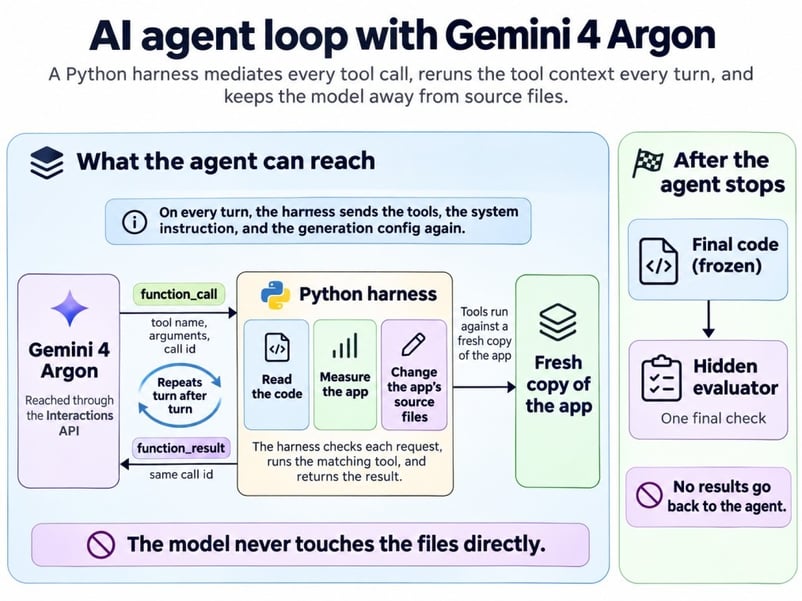
Argon 提出请求,Python 决定并执行。图片来源:作者。
给代理一个可量化的性能目标
系统指令阐明了目标与规则,但从不点明变慢之处:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.代理会根据它能看到的东西来决定何时停止:可见测试、分析器与基准结果,以及循环设定的限制。
实现 Interactions API 的工具循环
下面的片段是循环的核心;完整版本还包含客户端、工具分发器与限制。每一回合都是一次 client.interactions.create() 调用,Argon 常常在一回合里请求多个工具,所以要运行它返回的每个 function_call 步骤。将每个结果以 function_result 发回,并带上匹配的 call_id:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request 出现在跟进调用这一行很容易被人漏掉。previous_interaction_id 会带上历史,但 tools、system_instruction 与 generation_config 都是作用于单次 interaction 的,所以缺了它们的回合会丢失工具,或退回默认的思考级别。我觉得这条规则很容易忘,所以代码把三项配置都放在一个 dict 里。
API 没有任务预算,所以请在启动前就在您的应用中设置回合数、时长与开销限制。我用了 40 回合、10 个补丁、45 分钟与 $5,没有一次尝试接近上限,不过花费检查是在回合之间进行的,因此某个很长的回合可能会越界。Google 的 速率限制页面还对 Tier 1 账号设置了每 10 分钟滚动 $10 的上限,越界会返回 429 RESOURCE_EXHAUSTED。
运行 Gemini 4 Argon 代理并验证其变更
每次尝试都从应用的全新副本开始,会在约 5 分钟内自行停止,并在任何隐藏检查运行前冻结其代码。
用证据定位瓶颈
Argon 先测量后定位了瓶颈。下面是第一次 medium 尝试的逐回合记录。
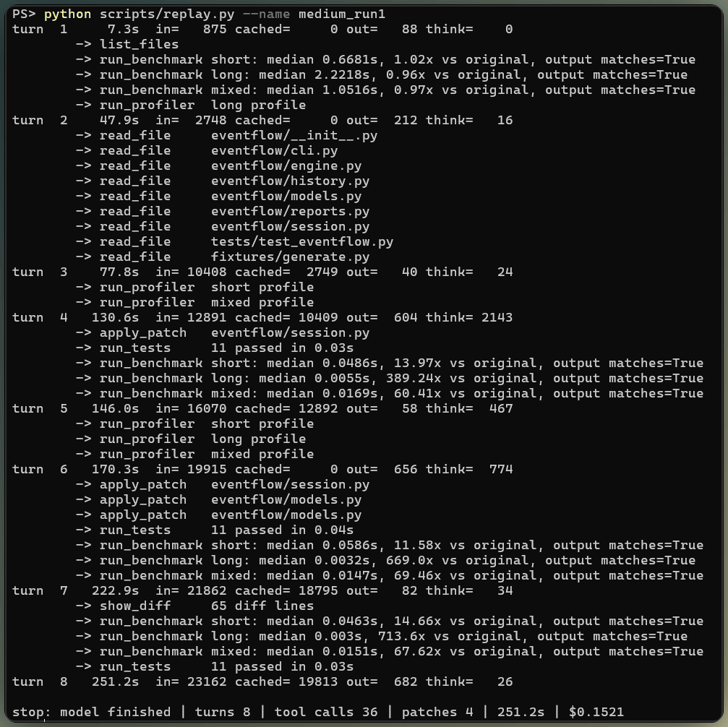
一次 medium 尝试的回合记录。图片来源:作者。
它的思考摘要(是推理的精简版而非每步记录)展示了如何得到修复。Argon 注意到 has_event() 与 add() 都调用了 get_history()。它询问深拷贝是否“在这里真的必要,或者要求只是调用方拥有数据”,并用 summarize() 的文档字符串定了性,文档写着该函数不会修改其输入。
并非每个判断都有证据支撑。摘要也写到测试或隐藏使用中“没有直接访问”,而这点是 Argon 不可能知道的。这次这个猜测成立,但这是代码审查里值得圈出来的一句。
六次尝试都落到的修复
每次尝试都对 CustomerState 做了相同的核心修改,六个 diff 中最小的那一个最能说明问题:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = None现在说说我之前承诺会点名的“埋雷”:add() 在每条事件上都对整个历史重新汇总、每条事件都要付出两次完整深拷贝、而重复检查要扫描整个列表。
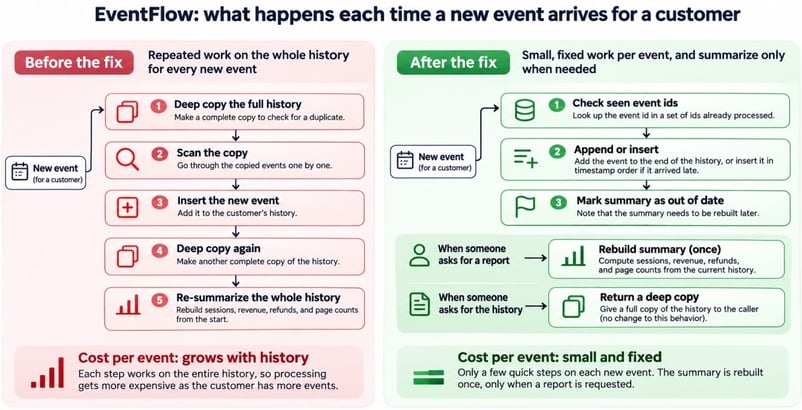
每条事件在修复前后的工作量。图片来源:作者。
get_history() 仍然为外部调用方保留深拷贝,这正是之前提到的“去掉深拷贝”捷径所忽略的细节。
每轮补丁都通过了可见测试,所以代理无需回滚,但大多数尝试还加了一个 summary 的 setter,然而没有任何地方会调用它。没人要求它,但仍需有人审核它。
隐藏验收测试结果
隐藏评估器每次尝试运行一次,且每次都通过了所有用例。这些用例会在 report() 之后调用 ingest()、在购买之前发送退款,并修改返回对象来确认引擎状态保持不变。
Gemini 4 Argon 真的让应用更快了吗?
是的。每个新版本都快了很多,且返回结果与原版相同。如前所述,计时会漂移,所以我对原版与 6 个新版本交替计时,每个 9 个全新进程。
每次计时只覆盖 ingest 与报表,不含 Python 启动或导入。由于在几毫秒的量级,单次计时可能远高于中位数,所以请比较中位数。用对数刻度可以避免新版本在原版旁边“消失”。
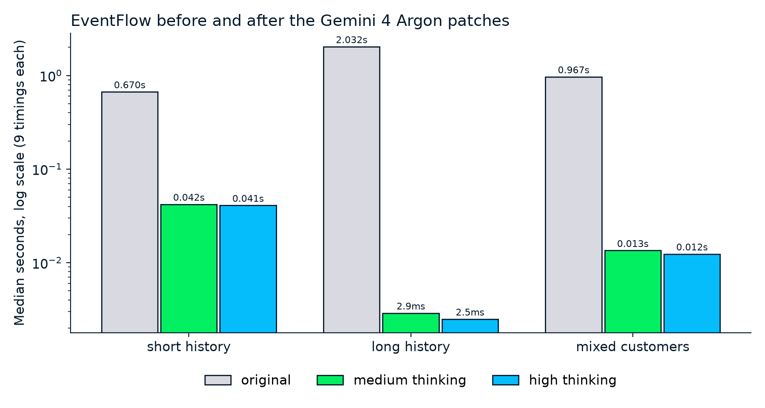
修复后是毫秒级,修复前是秒级,输出相同。图片来源:作者。
图表展示了每个级别的首次尝试,表格覆盖了全部 6 次,提速为原版中位数除以新版本中位数:
|
指标 |
原始 |
Medium(3 次) |
High(3 次) |
|
|
参考 |
14.8x 至 15.9x |
16.3x 至 17.4x |
|
|
参考 |
656x 至 701x |
约 810x |
|
|
参考 |
65.4x 至 71.6x |
76.8x 至 78.0x |
|
峰值跟踪内存, |
7,108 KiB |
7,822 KiB |
7,822 KiB |
|
峰值跟踪内存, |
885 KiB |
570 KiB |
569 KiB |
long 受益最大,因为被移除的工作会随着每个客户的历史增长而增长。内存行是修复唯一的成本所在。short(客户最多)大约多用了 10%,可能是新增的按客户 ID 集合所致,而 long 则更省,可能是因为不再构建拷贝。
别把 700x 理解为 Argon 的特殊之处。从一个二次复杂度的循环中删掉它,在合成数据上往往能得到类似的数字,不论是谁写的修复。
Gemini 4 Argon 的思考级别:Medium vs. High
在这个任务上,high 写出的代码比 medium 略快,但两者都找到了同样的修复,所以额外的思考更多花在打磨而非诊断上。
保证对比公平
只改变思考级别,其他保持不变。每次尝试使用相同的代码、提示、工具、限制与评估器,且互不看到对方的结果。两个级别交替进行,各 3 次,这与我在Claude Opus 5 API 教程中用的设置一致。
按级别的结果、时间与成本
两种级别的分布如下,按每次尝试的平均值计:
|
每次尝试平均 |
Medium |
High |
|
被接受的修复 |
3/3 |
3/3 |
|
工具调用 |
28 |
35 |
|
思考令牌 |
1,877 |
14,764 |
|
变更行数 |
24 |
193 |
|
耗时 |
3.4 分钟 |
5 分钟 |
|
按优惠价计算的成本 |
$0.10 |
$0.29 |
|
优惠结束后的成本 |
$0.20 |
$0.58 |
high 在第一处补丁中就落到了相同的修复,然后继续打磨。它接着重写了部分汇总、报表与校验逻辑,而那些已不再是主要瓶颈。
这个领先幅度会随机器变化;在已是毫秒级的工作负载上,它也接近计时噪声,所以仅从审查成本考虑,我仍会优先上线 medium 的更小 diff。
High 的思考在第 4 回合达到峰值,而那时它的第一处补丁已经修好了问题。
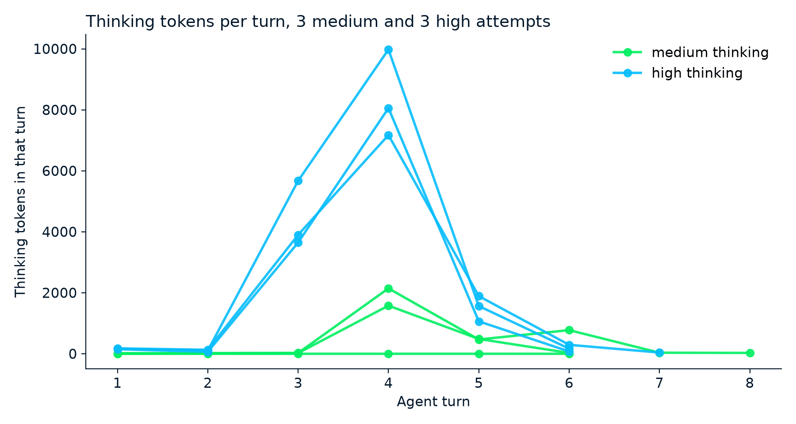
每次尝试的思考令牌花在哪。图片来源:作者。
也别把思考令牌当作质量信号;就像第一次请求一样,有一次 medium 尝试没用任何思考令牌,仍然落到了被接受的修复,速度与成本都是所有尝试中最优。
要给代理定价,请把每回合的 usage 加起来,因为每回合都会报告它处理过的完整上下文。大部分回合输入会重复上一回合的内容,隐式缓存会按缓存费率对其中约 2/3 计费。
根据缓存指南,缓存需要至少 4,096 令牌的提示,且当某回合新增令牌少于 2,050 时,会对上一请求最后的 2,050 个令牌按全价计费,因此工具结果很小的循环省得更少。按我在 FAQs 中提到的 Standard 优惠价,6 次尝试合计花费 $1.16。
AI 性能代理的局限
此类代理最适合分析器能指向的问题,而本案例就是为此构建得很“干净”:
-
正如开头所说,瓶颈是我埋的。分析器几乎直指六个小文件中的一个二次循环,而真实的变慢多藏在 I/O、数据库与缺文档的代码里。
-
文档字符串功不可没。Argon 借助其中一条来判断可以跳过哪一种拷贝,而对无文档的代码库它就无从借力。
-
测试只会检查被想到的情况。在 Google 的 ADK 案例研究中,有次导入变更通过了公共测试套件,却仍然未通过内部测试目标。
-
计时来自一台小型 Linux 机器与合成工作负载,您的提速会有所不同。
-
代理读到的每个文件都会发给 Google;默认情况下付费层的交互会保留 55 天;
store=false可阻止存储,但这会无法使用previous_interaction_id。
Google 的模型卡也列出了幻觉与偶发超时等已知限制。
结语
代理在六次尝试中都找到了重复汇总与深拷贝的问题,保留了调用方依赖的拷贝,并通过了保留测试。high 思考带来了些许加速,但 diff 大了很多。
我不会把这结论泛化到您的代码库上,因为瓶颈是我埋的。可迁移的是方法:先测量、把工具收紧、在检查前冻结代码,并让隐藏测试来定输赢。
我最先会做的扩展是一个路由器,从 medium 起步,只在可见测试失败时才切到 high,这样隐藏用例就不会反哺代理。
如果您还不熟悉上面的分析器输出,Writing Efficient Python Code 覆盖了我在让 Argon 改代码前所用的同样计时与分析工具。
FAQs
Gemini 4 Argon 能自动加速 Python 代码吗?
不能单靠它自己。Interactions API 目前还不会替您运行工具,所以需要您的代码来执行,而本例中检查用代码的体量最终是应用本身的两倍。
Gemini 4 Argon 能自己运行 Python 代码吗?
可以,用内置的代码执行工具,但它会在 30 秒后停止,且无法安装 pytest。要跑真正的测试,请用您自己的机器,或参见我们的“托管代理”教程中的托管环境。
这种代理是否该用低思考级别?
我没测过,且 Google 说在难题上质量可能下降。由于您可以在每回合设置级别,我会尝试用 low 来读文件、用 medium 来写补丁。
Gemini 4 Argon API 多少钱?
我当时的价格是每百万输入令牌 $2、每百万输出令牌 $10(包含思考),这些价格将在 2026 年 11 月 30 日后翻倍。Flex 价格是它的一半,但每次请求可能耗时至多 15 分钟,我只会在通宵实验时接受这种情况。
我可以把这个代理用在生产代码库上吗?
按本文所写并不行,请在一次性容器中运行,并让人审核每个 diff。另请注意 Argon 的知识截至 2026 年 3 月,所以对较新的库要提供当前文档。

我是一名数据工程师兼社区建设者,专注于数据管道、云端与 AI 工具链,同时为 DataCamp 和新兴开发者撰写实用且高影响力的教程。
我想看看 Gemini 4 Argon 面对一个不是坏掉、只是很慢的 Python 应用会怎么做。所有测试都能通过、所有报表也都正确,但有些工作需要几秒钟,而它本该只要几毫秒,而且客户历史越长就越慢。很多 AI 编码教程从一个失败的测试开始,这等于把明显的靶子递给了模型。
但在这里,没有失败的测试能指向慢代码。Gemini 4 Argon 是一个通过 Gemini API 用 Python 调用的 Google 模型,您将用它来构建一个AI 代理,也就是一个会为达成目标而采取行动的模型。本例中,代理会读取、计时并编辑代码,但只能通过您自己 Python 所控制的工具来完成。
这个应用叫 EventFlow,是一个小型的虚构程序,把客户活动、购买和退款转换成报表。我的问题是代理能否在不改变应用返回结果的前提下找到并修复慢点。只要您熟悉 Python 的函数、类与运行测试,就能跟上进度,我会讲到:
我们的Gemini 4 Argon 概览涵盖了发布与基准测试,所以本教程聚焦 API。关于更广的模型对比,也可参见我们的Gemini 4 Argon 与 Claude Opus 5.5以及Gemini 4 Argon 与 GPT-6 Astra的比较。
要点速览
我把同一任务给代理做了 6 次,
medium思考各 3 次、high思考各 3 次,结果如下:Argon 在 6 次尝试中都修复了瓶颈,且一套单独的隐藏测试也给出了同意结论。
慢负载从大约 2 秒降到约 3 毫秒。
Argon 在改代码前先跑了基准与分析器,所以请给您的代理这些工具以及测试。
high的成本大约是medium的 3 倍(平均每次 $0.29 对 $0.10),为了一点额外的速度写出了大 8 倍的 diff。建议从medium开始。我是在一个小应用里刻意埋了瓶颈,所以这些结果只描述这个特定案例。