

Apa Itu Gemini 4 Argon API?
Gemini 4 Argon API memberi Anda gemini-4-argon, model penalaran Google yang dibuat untuk pengodean kompleks dan tugas agen multi-langkah. Model ini mencapai ketersediaan umum pada pertengahan Oktober 2026. Menurut laman model, input, thinking, dan output berbagi satu jendela 1.048.576 token, dan respons sinkron berhenti pada 65.536 token output.
Google menjalankan eksperimen serupa dalam studi kasus ADK-nya: sebuah run Antigravity 11 jam dengan /goal pada Python Agent Development Kit (ADK). Para peninjaunya mempertahankan 2 dari 6 proposal, memangkas persiapan sesi sekitar 40% pada sesi panjang dan impor sebesar 21%. Tutorial ini menggunakan loop Python kecil sebagai gantinya.
Anda akan menggunakan empat fitur API:
-
Interactions API, antarmuka yang direkomendasikan Google untuk proyek baru, yang menyimpan status percakapan di server
-
Function calling, di mana model meminta alat, dan kode Anda yang memutuskan apakah akan menjalankannya
-
thinking_level:low,medium(default), atauhigh -
Objek
usage, yang melaporkan token input, cached, output, dan thought
Argon meminta, dan kode Anda yang mengerjakan.
Proyek: Aplikasi Python Lambat untuk Diperbaiki Gemini 4 Argon
Agen mendapatkan kode EventFlow, 8 alat, dan tanpa petunjuk tentang perlambatan. Kode lengkapnya ada di GitHub. Mulailah dengan EventFlow.
Cara kerja EventFlow
EventFlow adalah pemroses event fiksi dalam enam modul kecil. Sebuah event masuk ke EventFlow.ingest(), validate() mengubahnya menjadi Event, dan CustomerState menyimpannya dalam urutan cap waktu per pelanggan. Lalu summarize() mengubah setiap riwayat menjadi sesi, pendapatan, refund, dan hitungan halaman, dan build_report() menghasilkan CustomerReport.
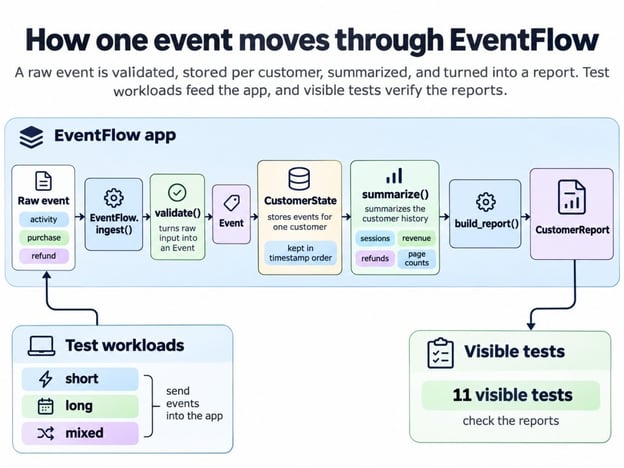
Bagaimana satu event menjadi laporan. Gambar oleh Penulis.
Docstring EventFlow menetapkan aturan berikut:
-
Sesi terpisah setelah jeda 30 menit
-
Refund dibatasi pada sisa nilai pembelian
-
event_idyang berulang diabaikan, dan salinan pertama yang berlaku -
Event diurutkan berdasarkan cap waktu, bahkan lintas batch
-
history()danreport()mengembalikan objek yang menjadi milik pemanggil
Tes tersembunyi memeriksa semuanya, dan yang terakhir akan muncul lagi nanti.
Mengapa EventFlow menjadi lambat
Tiga beban kerja, dibangun dari seed tetap, menunjukkan bagaimana panjang riwayat mengubah gambaran:
-
short: banyak pelanggan dengan 5 event masing-masing -
long: beberapa pelanggan dengan 160 event masing-masing -
mixed: 1 hingga 30 event per pelanggan, dengan duplikat dan event datang tidak berurutan
long memiliki jauh lebih sedikit event dibanding short dan tetap memakan waktu sekitar 3x lebih lama. Grafik menjaga total di 1.600 event sambil memberi setiap pelanggan riwayat yang lebih panjang.
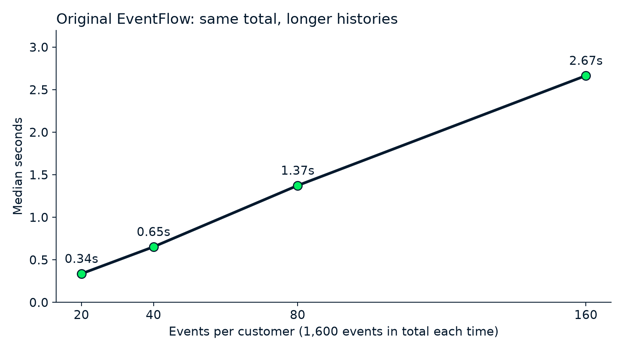
Total sama, riwayat lebih panjang, pemrosesan lebih lambat. Gambar oleh Penulis.
Setiap kali panjang riwayat berlipat ganda, runtime juga berlipat ganda, meskipun jumlah total event tidak pernah berubah. Pola itu biasanya berarti ada langkah yang mengulang pekerjaan atas seluruh riwayat pada setiap event baru. Agen tidak pernah melihat penyebabnya, jadi saya akan menamainya setelah Argon selesai.
Kriteria keberhasilan dan tes tersembunyi
Sebuah perbaikan dihitung hanya jika lolos lima pemeriksaan yang ditetapkan sebelum panggilan API pertama; laporan model sendiri tidak dihitung. Kode akhir agen harus melakukan semua hal berikut:
-
Berjalan setidaknya 1,5x lebih cepat pada
long -
Tidak lebih dari 5% lebih lambat pada
shortataumixed -
Lolos setiap tes yang terlihat
-
Mengembalikan output laporan yang sama seperti aslinya pada ketiga beban kerja
-
Lolos setiap kasus penerimaan tersembunyi
Ambang ini milik saya sendiri, jadi perlakukan sebagai contoh. Alat agen tidak dapat menjangkau kasus tersembunyi; alat tersebut hanya berjalan setelah kodenya dibekukan. Mereka membandingkan kodenya dengan implementasi referensi terpisah pada data baru, batch terlambat, duplikat, dan aturan kepemilikan.
Sebuah suite tersembunyi hanya membantu jika menolak perbaikan yang salah, jadi beri makan satu-dua dengan sengaja. Dua jalan pintas mudah meloloskan semua tes terlihat di sini, menghapus deep copy dan men-cache ringkasan tanpa pernah menyegarkannya. Kasus tersembunyi menolak keduanya.
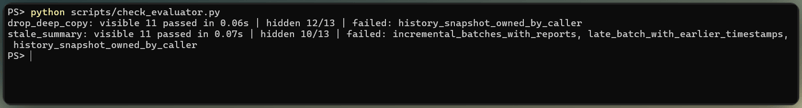
Tes tersembunyi menangkap dua perbaikan yang salah. Gambar oleh Penulis.
Cara Menyiapkan Gemini 4 Argon API di Python
Anda memerlukan Python 3.10 atau lebih baru, kunci Gemini API, dan proyek Google AI Studio dengan penagihan aktif, karena laman harga tidak mencantumkan tingkat Gratis untuk Argon. Proyek ini mematok SDK google-genai pada 2.33.0; Interactions API membutuhkan minimal 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envDi macOS atau Linux, aktifkan virtual environment dengan source .venv/bin/activate dan salin dengan cp, lalu letakkan GEMINI_API_KEY=... di .env. Jika GOOGLE_API_KEY juga disetel di shell Anda, SDK akan menggunakannya sebagai pengganti, jadi kode di bawah menghapusnya terlebih dahulu. Lewati subbagian berikut jika Anda pernah menggunakan Interactions API sebelumnya.
Buat permintaan API Gemini 4 Argon pertama Anda
Permintaan pertama Anda memberikan Argon bagian atas output profiler EventFlow dan menanyakan apa yang ditunjukkannya. load_dotenv() memuat GEMINI_API_KEY dari .env, genai.Client() membacanya, ID model masuk ke client.interactions.create(), dan generation_config membawa tingkat thinking.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Berikut yang kembali:
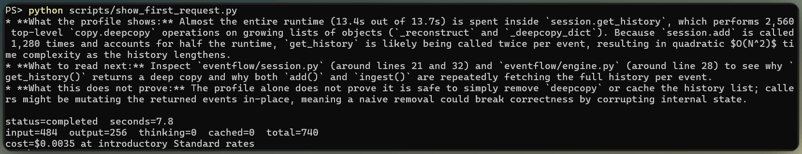
Permintaan Argon pertama membaca profil. Gambar oleh Penulis.
Argon benar; hampir semua waktu berada di bawah get_history() dan copy.deepcopy, kemungkinan dipanggil dua kali per event. Poin ketiganya memperingatkan bahwa menghapus deep copy dapat merusak pemanggil yang memodifikasi apa yang mereka terima kembali, yang merupakan jalan pintas pertama yang saya sebutkan sebelumnya. Pertanyaan seperti ini murah: di bawah 8 detik dan kurang dari setengah sen, tanpa token thinking.
medium adalah default, dan panduan latest-model yang saya tautkan sebelumnya merekomendasikannya "untuk sebagian besar tugas, termasuk kode kompleks dan use case agentic." Panduan yang sama menyatakan temperature, top_p, dan top_k diabaikan pada Argon, jadi tinggalkan saja.
Profilkan Kode Python Sebelum Menggunakan Gemini 4 Argon
Ukur aplikasi asli sebelum model menyentuhnya, sehingga setiap angka selanjutnya punya pembanding. Ambil tiga jenis pengukuran, masing-masing dalam prosesnya sendiri, karena setiap alat menggeser yang lain:
-
Pengukuran waktu dengan
time.perf_counter(), sebagai median dari beberapa proses baru dengan satu pemanasan masing-masing -
Profiling dengan
cProfileuntuk mencari ke mana waktu habis; ini membuat long sekitar 6x lebih lambat, jadi jangan pernah percaya timing di bawah profiler -
Memori dengan
tracemalloc, yang melaporkan puncak alokasi Python yang dilacak, bukan total memori proses
Pada tiga beban kerja, alih-alih 1.600 event tetap di grafik, aplikasi asli memakan waktu sekitar 0,7 detik pada short, 2,2 pada long, dan 1,0 pada mixed. Ia juga lolos setiap tes pytest yang terlihat.
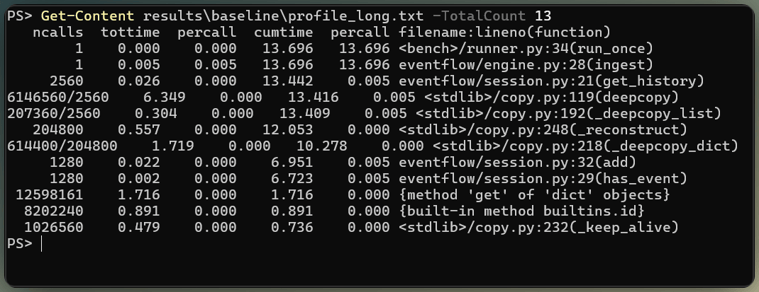
Di mana aplikasi lambat menghabiskan waktu. Gambar oleh Penulis.
Harapkan drift: kode yang sama kemudian terukur sekitar 10% lebih cepat, jadi ukur setiap versi dalam satu sesi.
Cara Membangun Agen Performa dengan Function Calling Gemini 4 Argon
Seperti yang saya sebutkan sebelumnya, Argon hanya meminta alat. Kode Python yang menjalankannya disebut harness, dan panduan rekayasa agent harness kami menjelaskan mengapa pemeriksaannya sebaiknya berada di kode, bukan di prompt. Alat datang lebih dulu, karena merekalah yang menentukan apa yang bisa disentuh Argon.
Definisikan alat dan izin agen
Delapan alat yang saya sebutkan sebelumnya adalah fungsi Python yang dideklarasikan sebagai skema JSON biasa, dan hanya dua yang bisa mengubah kode:
-
list_filesdanread_file, dibatasi pada sumber Python aplikasi, tes, dan fixture -
run_profilerdanrun_benchmarkuntuk satu beban kerja bernama -
apply_patch, yang mengganti satu kemunculan teks persis di satu berkas sumber aplikasi yang ada -
revert_file,run_tests, danshow_diff
Deklarasi mengikuti format pada panduan function-calling yang saya tautkan sebelumnya:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Sebuah skema menjelaskan panggilan, tetapi tidak membuat panggilan itu aman. Harness menambahkan pemeriksaan berikut di Python:
- Setiap path di-resolve dulu, jadi path yang keluar dari salinan aplikasi akan gagal
- Penulisan di luar folder sumber aplikasi ditolak
- Berkas yang ditambal harus tetap dapat dikompilasi, atau patch ditolak
- Tes dan benchmark berjalan di subprocess dengan timeout dan tanpa kunci API
Itu bukan kontainer, dan kode yang ditambal masih bisa membaca berkas di luar salinan, jadi perlakukan ini sebagai minimum.
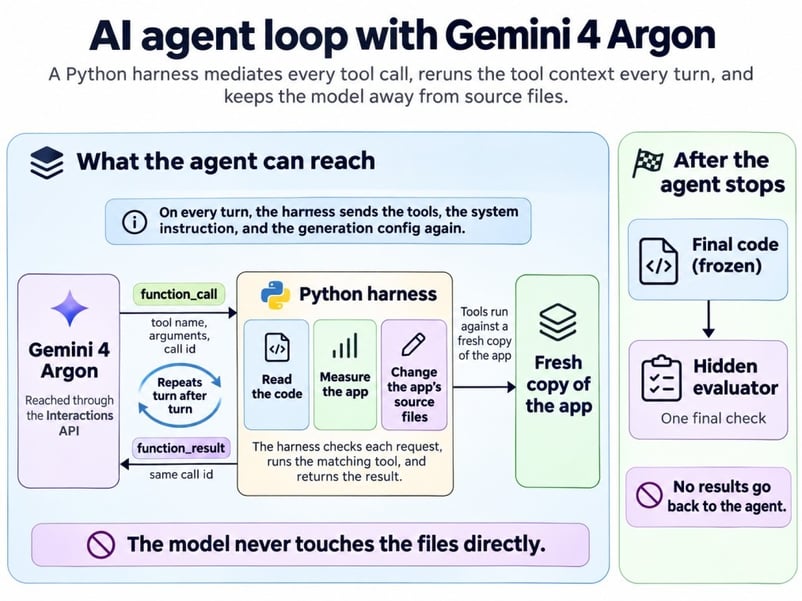
Argon meminta, Python memutuskan dan menjalankan. Gambar oleh Penulis.
Beri agen sasaran performa yang terukur
Instruksi sistem menyatakan tujuan dan aturan tetapi tidak pernah menyebut di mana perlambatan itu:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Agen memutuskan kapan berhenti dari apa yang bisa dilihatnya: tes yang terlihat, hasil profiler dan benchmark, serta batas yang ditetapkan loop berikutnya.
Implementasikan loop alat Interactions API
Cuplikan di bawah adalah inti loop; versi lengkap menambahkan klien, dispatcher alat, dan batas. Setiap giliran adalah satu pemanggilan client.interactions.create(), dan Argon sering meminta beberapa alat dalam satu giliran, jadi jalankan setiap langkah function_call yang dikembalikannya. Kirim setiap hasil kembali sebagai function_result dengan call_id yang cocok:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request pada panggilan lanjutan adalah baris yang sering terlewat. previous_interaction_id membawa riwayat, tetapi tools, system_instruction, dan generation_config bersifat lingkup interaksi, jadi giliran tanpa ketiganya akan kehilangan alat atau kembali ke tingkat thinking default. Saya merasa aturan ini mudah dilupakan, jadi kode menyimpan ketiga pengaturan dalam satu dict.
API tidak memiliki anggaran tugas, jadi tetapkan batas giliran, waktu, dan biaya di aplikasi Anda sebelum mulai. Saya menggunakan 40 giliran, 10 patch, 45 menit, dan $5, dan tidak ada percobaan yang mendekatinya, meskipun pemeriksaan biaya berjalan antar giliran, jadi satu giliran panjang bisa melampauinya. Laman batas laju Google menambahkan batasnya sendiri pada akun Tier 1, $10 per 10 menit berjalan, dan mengembalikan 429 RESOURCE_EXHAUSTED setelah melewatinya.
Jalankan Agen Gemini 4 Argon dan Verifikasi Perubahannya
Setiap percobaan dimulai dari salinan baru aplikasi, berhenti sendiri dalam sekitar 5 menit, dan kodenya dibekukan sebelum pemeriksaan tersembunyi apa pun dijalankan.
Menemukan bottleneck dari bukti
Argon menemukan bottleneck dengan mengukur terlebih dahulu. Berikut percobaan medium pertama, giliran demi giliran.
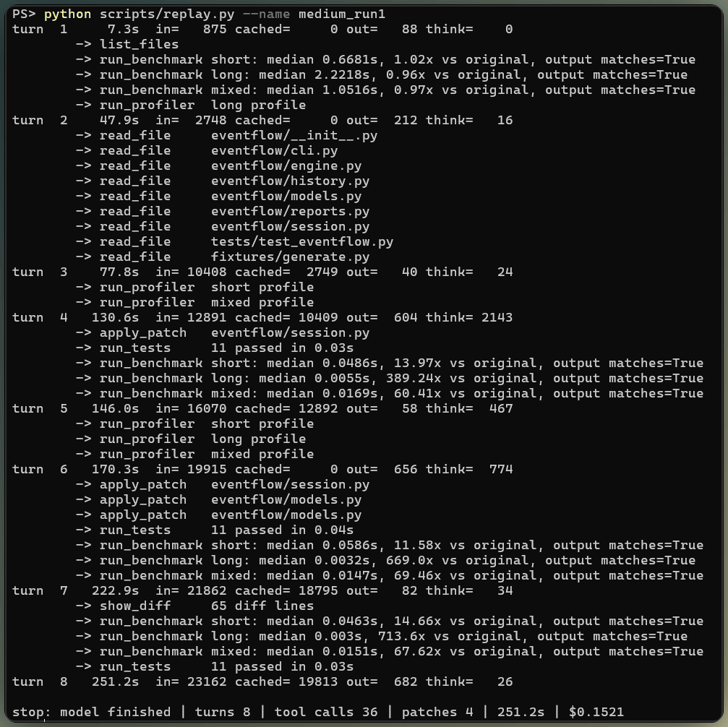
Satu percobaan medium, giliran demi giliran. Gambar oleh Penulis.
Ringkasan pemikirannya, versi ringkas dari penalarannya alih-alih setiap langkah, menunjukkan bagaimana ia sampai pada perbaikan. Argon menyadari bahwa has_event() dan add() keduanya memanggil get_history(). Ia menanyakan apakah deep copy itu "benar-benar diperlukan di sini, atau jika persyaratannya hanyalah bahwa pemanggil memiliki data," dan menyelesaikannya dengan docstring summarize(), yang menyatakan fungsi tidak memodifikasi inputnya.
Tidak setiap klaim bertumpu pada bukti. Ringkasan yang sama mengatakan ada "tidak ada akses langsung di tes atau penggunaan tersembunyi," yang tidak bisa diketahui Argon. Tebakannya benar (kali ini), tetapi ini jenis kalimat yang perlu dilingkari saat review.
Perbaikan yang diambil keenam percobaan
Setiap percobaan membuat perubahan inti yang sama pada CustomerState, dan diff terkecil dari keenamnya menunjukkan ini dengan baik:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneSekarang penyebab yang saya janjikan tadi: add() merangkum ulang seluruh riwayat pada setiap event, setiap event membayar dua deep copy penuh, dan pemeriksaan duplikat memindai daftar.
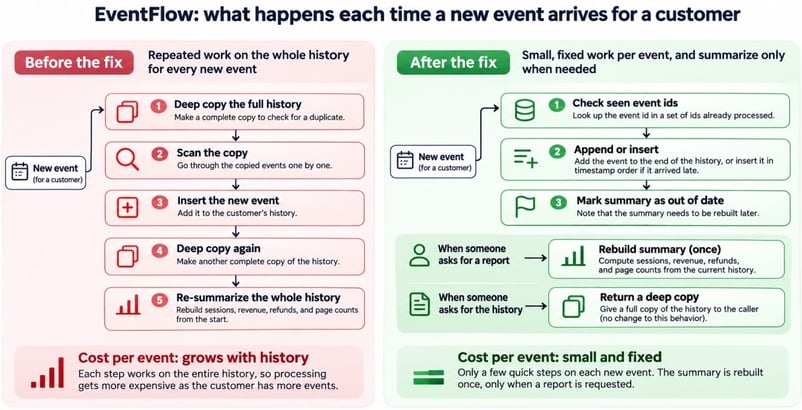
Pekerjaan per event sebelum dan sesudah perbaikan. Gambar oleh Penulis.
get_history() mempertahankan deep copy-nya untuk pemanggil eksternal, yang merupakan detail yang salah pada jalan pintas deep-copy sebelumnya.
Setiap putaran patch lolos tes terlihat, jadi agen tidak perlu revert, tetapi sebagian besar percobaan juga menambahkan setter summary yang tidak dipanggil siapa pun. Tidak ada yang memintanya, dan tetap perlu ditinjau seseorang.
Hasil tes penerimaan tersembunyi
Evaluator tersembunyi berjalan sekali per percobaan, dan setiap percobaan lolos semua kasus. Kasus-kasusnya memanggil ingest() setelah report(), mengirim refund sebelum pembeliannya, dan memodifikasi objek yang dikembalikan untuk mengonfirmasi state mesin tetap utuh.
Apakah Gemini 4 Argon Benar-Benar Membuat Aplikasi Lebih Cepat?
Ya. Setiap versi baru jauh lebih cepat dan mengembalikan output yang sama dengan aslinya. Seperti yang saya sebutkan, timing bisa drift, jadi saya mengukur asli dan semua 6 versi baru secara bergantian, 9 proses baru masing-masing.
Setiap pengukuran waktu mencakup hanya ingest dan laporan, bukan startup Python atau impor. Pada beberapa milidetik, satu pengukuran bisa jauh di atas median, jadi bandingkan median. Skala log pada grafik menjaga versi baru tidak menghilang di samping yang asli.
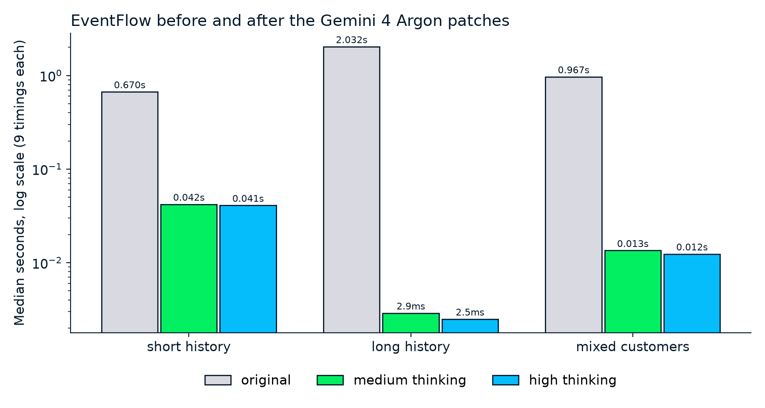
Sesudah milidetik, sebelumnya detik, output sama. Gambar oleh Penulis.
Grafik menampilkan percobaan pertama pada setiap level, dan tabel mencakup semua 6, dengan percepatan sebagai median asli dibagi median baru:
|
Ukuran |
Asli |
Medium (3 percobaan) |
High (3 percobaan) |
|
|
Referensi |
14,8x hingga 15,9x |
16,3x hingga 17,4x |
|
|
Referensi |
656x hingga 701x |
sekitar 810x |
|
|
Referensi |
65,4x hingga 71,6x |
76,8x hingga 78,0x |
|
Puncak memori terlacak, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Puncak memori terlacak, |
885 KiB |
570 KiB |
569 KiB |
long memperoleh paling banyak, karena pekerjaan yang dihapus tumbuh seiring riwayat setiap pelanggan. Baris memori adalah satu-satunya tempat perbaikan menimbulkan biaya apa pun. short, dengan pelanggan terbanyak, menggunakan sekitar 10% lebih banyak, kemungkinan untuk set ID per pelanggan yang baru, sementara long menggunakan lebih sedikit, kemungkinan karena ia berhenti membuat salinan.
Jangan baca 700x sebagai sesuatu yang spesial tentang Argon. Menghapus sebuah loop kuadratik dari data sintetis cenderung menghasilkan angka seperti ini, siapa pun yang menulis perbaikannya.
Tingkat Thinking Gemini 4 Argon: Medium vs. High
Pada tugas ini, high menulis kode sedikit lebih cepat daripada medium, tetapi keduanya menemukan perbaikan yang sama, jadi thinking tambahan masuk ke pemolesan alih-alih diagnosis.
Menjaga perbandingan tetap adil
Ubah tingkat thinking dan tidak ada yang lain. Setiap percobaan menggunakan kode, prompt, alat, batas, dan evaluator yang sama, dan tidak ada yang melihat pekerjaan percobaan lain. Levelnya bergantian, 3 percobaan masing-masing, setelan yang sama yang saya gunakan di tutorial API Claude Opus 5.
Hasil, waktu, dan biaya per level
Kedua level terbagi seperti ini, dirata-rata per percobaan:
|
Rata-rata per percobaan |
Medium |
High |
|
Perbaikan diterima |
3 dari 3 |
3 dari 3 |
|
Panggilan alat |
28 |
35 |
|
Token thinking |
1.877 |
14.764 |
|
Baris yang diubah |
24 |
193 |
|
Waktu |
3,4 menit |
5 menit |
|
Biaya pada harga perkenalan |
$0,10 |
$0,29 |
|
Biaya setelah harga itu berakhir |
$0,20 |
$0,58 |
high mendarat pada perbaikan yang sama pada patch pertamanya dan kemudian terus memoles. Ia melanjutkan untuk menulis ulang bagian peringkasan, pelaporan, dan validasi yang tidak lagi menjadi bottleneck utama.
Keunggulan itu bergeser dengan mesin dan berada dekat dengan noise pengukuran pada beban kerja yang sudah selesai dalam milidetik, jadi saya tetap akan mengirim diff yang lebih kecil milik medium hanya dari sisi waktu review.
Thinking pada High memuncak di giliran 4, setelah patch pertamanya sudah memperbaiki masalah.
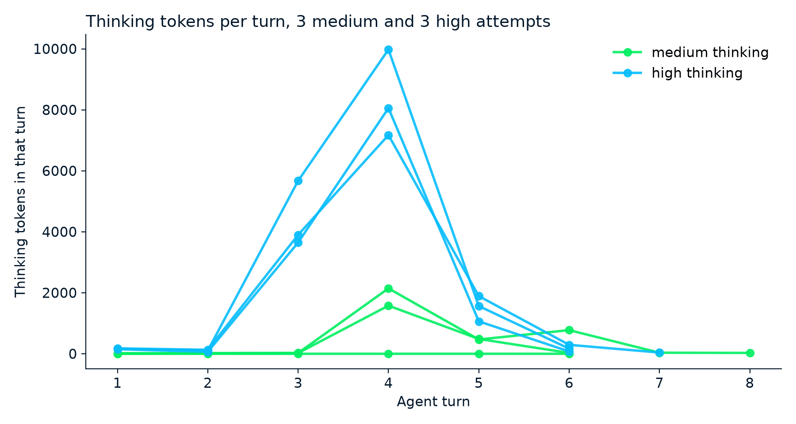
Di mana setiap percobaan menghabiskan thinking-nya. Gambar oleh Penulis.
Jangan jadikan token thinking sebagai sinyal kualitas; seperti permintaan pertama, satu percobaan medium tidak menggunakan apa pun dan tetap menghasilkan perbaikan yang diterima, lebih cepat dan lebih murah daripada percobaan lainnya.
Untuk menghitung harga agen, jumlahkan usage dari setiap giliran, karena setiap giliran melaporkan seluruh konteks yang diprosesnya. Sebagian besar input setiap giliran mengulang giliran sebelumnya, dan cache implisit menagih sekitar dua pertiga darinya pada tarif cached.
Menurut panduan caching, cache membutuhkan prompt setidaknya 4.096 token, dan giliran yang menambah kurang dari 2.050 token baru membayar tarif penuh pada 2.050 terakhir dari permintaan sebelumnya, jadi loop dengan hasil alat yang kecil menghemat lebih sedikit. Pada tarif Standard perkenalan, yang saya bahas di FAQ, keenam percobaan bersama-sama menelan biaya $1,16.
Keterbatasan Agen Performa AI
Agen seperti ini paling cocok untuk masalah yang bisa ditunjukkan profiler, dan yang satu ini dibangun agar bersih:
-
Bottleneck ditanam, seperti saya sebutkan di awal. Sebuah profiler menunjuk hampir langsung ke loop kuadratik dalam enam berkas kecil, sementara perlambatan nyata bersembunyi di I/O, database, dan kode yang tidak terdokumentasi.
-
Docstring banyak berperan. Argon mengandalkan satu di antaranya untuk memutuskan salinan mana yang bisa dilewati, dan basis kode tanpa dokumentasi tidak memberinya sandaran.
-
Tes hanya memeriksa apa yang terpikirkan seseorang. Dalam studi kasus ADK Google, satu perubahan impor meloloskan suite publik dan tetap gagal pada target tes internal.
-
Pengukuran waktu berasal dari satu mesin Linux kecil pada beban kerja sintetis, jadi percepatan Anda akan berbeda.
-
Setiap berkas yang dibaca agen dikirim ke Google, yang menyimpan interaksi tingkat berbayar selama 55 hari secara default;
store=falsemenghentikannya tetapi meniadakanprevious_interaction_id.
Kartu model Google juga mendaftar halusinasi dan sesekali timeout sebagai keterbatasan yang diketahui.
Penutup
Agen menemukan peringkasan berulang dan deep copy di keenam percobaan, mempertahankan salinan yang diandalkan pemanggil, dan lolos pemeriksaan yang ditahan. high thinking menambahkan sedikit kecepatan dan diff yang jauh lebih besar.
Saya tidak akan menggeneralisasi itu ke basis kode Anda, karena saya yang menanam bottleneck. Yang bisa dibawa adalah metodenya: ukur dulu, jaga alat tetap sempit, bekukan kode sebelum memeriksanya, dan biarkan tes tersembunyi yang memutuskan hasil.
Ekstensi pertama yang akan saya bangun adalah router yang mulai pada medium dan berpindah ke high hanya ketika tes yang terlihat gagal, sehingga kasus tersembunyi tidak pernah memberi umpan balik ke agen.
Jika output profiler di atas baru bagi Anda, Writing Efficient Python Code membahas alat pengukuran waktu dan profiling yang sama yang saya gunakan sebelum membiarkan Argon menyentuh kode.
FAQs
Bisakah Gemini 4 Argon mempercepat kode Python secara otomatis?
Tidak secara otomatis. Interactions API belum menjalankan alat untuk Anda, jadi kode Andalah yang melakukannya, dan di sini kode pemeriksaannya berukuran dua kali lipat aplikasi.
Bisakah Gemini 4 Argon menjalankan kode Python sendiri?
Ya, dengan alat eksekusi kode bawaan, tetapi berhenti setelah 30 detik dan tidak bisa menginstal pytest. Untuk tes nyata, gunakan mesin Anda sendiri atau setup hosted di tutorial Managed Agents kami.
Haruskah saya menggunakan thinking rendah untuk agen seperti ini?
Saya tidak mengujinya, dan Google mengatakan kualitas bisa turun pada tugas berat. Karena Anda menyetel level di setiap giliran, saya akan mencoba low untuk membaca file dan medium untuk menulis patch.
Berapa biaya Gemini 4 Argon API?
Saya membayar $2 per juta token input dan $10 per juta token output, termasuk thinking, dan harga tersebut menjadi dua kali lipat setelah 30 November 2026. Flex biayanya setengah, tetapi setiap permintaan bisa memakan waktu hingga 15 menit, yang hanya akan saya terima untuk eksperimen semalam.
Dapatkah saya menggunakan agen ini pada basis kode produksi?
Tidak seperti yang tertulis, jadi jalankan dalam kontainer sekali pakai dan mintalah orang untuk meninjau setiap diff. Perlu diingat juga bahwa pengetahuan Argon berhenti pada Maret 2026, jadi berikan dokumentasi terkini untuk pustaka yang lebih baru.

Saya seorang data engineer dan pembangun komunitas yang bekerja lintas pipeline data, cloud, dan perkakas AI sambil menulis tutorial praktis dan berdampak tinggi untuk DataCamp dan pengembang yang sedang berkembang.



Saya ingin melihat apa yang dilakukan Gemini 4 Argon pada aplikasi Python yang tidak rusak, hanya lambat. Semua tes lolos dan setiap laporan benar, tetapi sebagian pekerjaan memakan waktu beberapa detik padahal seharusnya hanya milidetik, dan makin parah seiring makin panjang riwayat pelanggan. Banyak tutorial AI coding dimulai dari tes yang gagal, yang memberi model target yang jelas.
Namun di sini, tidak ada tes yang gagal yang menunjuk ke kode yang lambat. Gemini 4 Argon adalah model Google yang Anda panggil dari Python melalui Gemini API, dan Anda akan menggunakannya untuk membangun sebuah agen AI, yaitu model yang mengambil tindakan menuju suatu tujuan. Dalam kasus ini agen membaca, mengukur waktu, dan mengedit kode, tetapi hanya melalui alat yang dikendalikan Python Anda sendiri.
Aplikasinya adalah EventFlow, program fiksi kecil yang mengubah aktivitas pelanggan, pembelian, dan refund menjadi laporan. Pertanyaan saya adalah apakah agen dapat menemukan bagian yang lambat dan memperbaikinya tanpa mengubah keluaran aplikasi. Jika Anda nyaman dengan fungsi Python, kelas, dan menjalankan tes, Anda bisa mengikuti, dan saya akan membahas cara:
Tinjauan Gemini 4 Argon kami membahas peluncuran dan benchmark, jadi tutorial ini fokus pada API. Untuk gambaran model yang lebih luas, lihat juga perbandingan Gemini 4 Argon vs Claude Opus 5.5 dan Gemini 4 Argon vs. GPT-6 Astra.
Ringkasnya
Saya memberi agen tugas yang sama 6 kali, 3 kali pada
mediumthinking dan 3 kali padahigh, dan inilah hasilnya:Argon memperbaiki perlambatan di semua 6 percobaan, dan serangkaian tes tersembunyi terpisah menyetujuinya.
Beban kerja lambat turun dari sekitar 2 detik menjadi sekitar 3 milidetik.
Argon menjalankan benchmark dan profiler sebelum mengubah kode apa pun, jadi berikan agen Anda alat-alat itu selain tes.
highmenelan biaya sekitar 3x lebih mahal daripadamedium($0,29 versus $0,10 per percobaan, rata-rata) dan menulis diff 8x lebih besar untuk kenaikan kecepatan tambahan yang kecil. Mulailah darimedium.Saya menanam bottleneck dengan sengaja dalam satu aplikasi kecil, jadi hasil ini hanya menggambarkan kasus ini saja.