

Ce este API-ul Gemini 4 Argon?
API-ul Gemini 4 Argon îți oferă gemini-4-argon, un model Google de raționare construit pentru cod complex și sarcini de agent multi-pas. A ajuns la disponibilitate generală la mijlocul lui octombrie 2026. Conform paginii modelului, inputul, gândirea și outputul împart o fereastră de 1.048.576 tokeni, iar un răspuns sincron se oprește la 65.536 tokeni de ieșire.
Google a rulat un experiment similar în studiul de caz ADK: o rulare de 11 ore Antigravity cu /goal pe Python Agent Development Kit (ADK). Evaluatorii au păstrat 2 din 6 propuneri, reducând pregătirea sesiunii cu aproximativ 40% în sesiunile lungi și importurile cu 21%. Acest tutorial folosește în schimb o mică buclă Python.
Vei folosi patru funcționalități ale API-ului:
-
Interactions API, interfața recomandată de Google pentru proiecte noi, care păstrează starea conversației pe server
-
Function calling, unde modelul cere o unealtă, iar codul tău decide dacă o rulează
-
thinking_level:low,medium(implicit) sauhigh -
Obiectul
usage, care raportează tokenii de input, în cache, de output și de gândire
Argon cere, iar codul tău face treaba.
Proiectul: o aplicație Python lentă pe care Gemini 4 Argon s-o repare
Agentul primește codul EventFlow, 8 unelte și niciun indiciu despre încetinire. Codul complet este pe GitHub. Începe cu EventFlow.
Cum funcționează EventFlow
EventFlow este un procesator de evenimente fictiv în șase module mici. Un eveniment intră în EventFlow.ingest(), validate() îl transformă într-un Event, iar CustomerState îl stochează în ordine temporală pe client. Apoi summarize() transformă fiecare istoric în sesiuni, venituri, rambursări și număr de pagini, iar build_report() produce un CustomerReport.
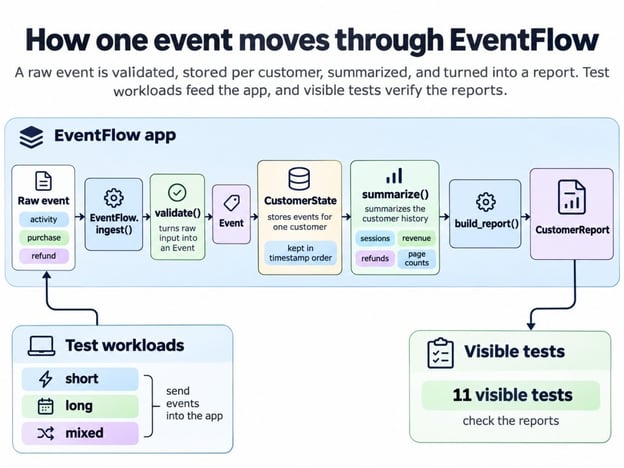
Cum devine un eveniment un raport. Imagine de autor.
Docstring-urile EventFlow stabilesc următoarele reguli:
-
Sesiunile se separă după o pauză de 30 de minute
-
Rambursările sunt plafonate la cât a mai rămas din achiziție
-
Un
event_idrepetat este ignorat, iar prima copie are prioritate -
Evenimentele se sortează după timestamp, chiar și între batch-uri
-
history()șireport()returnează obiecte deținute de apelant
Testele ascunse le verifică pe toate, iar ultima regulă revine mai târziu.
De ce devine EventFlow lent
Trei sarcini, construite din seed-uri fixe, arată cum lungimea istoricului schimbă perspectiva:
-
short: mulți clienți cu câte 5 evenimente -
long: câțiva clienți cu câte 160 de evenimente -
mixed: între 1 și 30 de evenimente per client, cu duplicate și evenimente care sosesc în afara ordinii
long are mult mai puține evenimente decât short și totuși durează cam de 3 ori mai mult. Graficul păstrează totalul la 1.600 de evenimente în timp ce oferă fiecărui client un istoric mai lung.
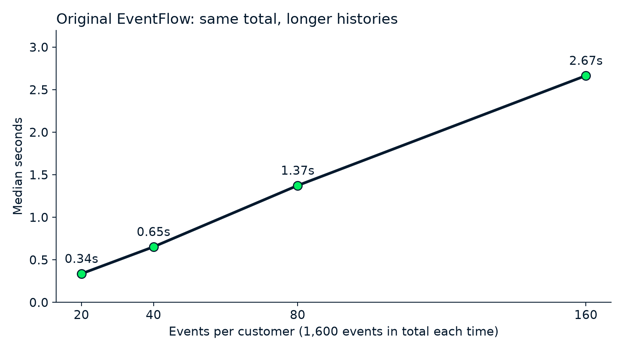
Același total, istorice mai lungi, procesare mai lentă. Imagine de autor.
De fiecare dată când lungimea istoricului se dublează, timpul de rulare se dublează și el, deși numărul total de evenimente nu se schimbă niciodată. Modelul acesta de obicei înseamnă că un pas repetă muncă peste tot istoricul la fiecare eveniment nou. Agentul nu vede cauzele, așa că le voi numi după ce Argon își face treaba.
Criterii de succes și teste ascunse
O remediere contează doar dacă trece cinci verificări stabilite înainte de primul apel la API; raportul modelului nu are nicio greutate. Codul final al agentului trebuie să facă toate următoarele:
-
Să ruleze de cel puțin 1,5 ori mai repede pe
long -
Să nu ruleze cu mai mult de 5% mai lent pe
shortsaumixed -
Să treacă fiecare test vizibil
-
Să returneze același output de raport ca originalul pe toate cele trei sarcini
-
Să treacă fiecare caz de acceptanță ascuns
Aceste praguri sunt ale mele, deci tratează-le ca exemplu. Uneltele agentului nu pot ajunge la cazurile ascunse; ele rulează doar după ce codul său e înghețat. Ele compară codul cu o implementare de referință separată pe date noi, batch-uri târzii, duplicate și regulile de proprietate.
Un set ascuns ajută doar dacă respinge remedieri greșite, așa că oferă-i câteva intenționat. Două scurtături ușoare trec toate testele vizibile aici, renunțând la deep copy și memorizând sumarul fără să-l mai reîmprospăteze vreodată. Cazurile ascunse le resping pe ambele.
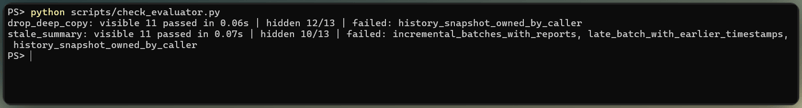
Testele ascunse prind două remedieri greșite. Imagine de autor.
Cum să configurezi API-ul Gemini 4 Argon în Python
Ai nevoie de Python 3.10 sau mai nou, o cheie Gemini API și un proiect Google AI Studio cu facturare activă, pentru că pagina de prețuri nu listează un nivel Free pentru Argon. Acest proiect fixează SDK-ul google-genai la 2.33.0; Interactions API are nevoie de cel puțin 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envPe macOS sau Linux, activează mediul virtual cu source .venv/bin/activate și copiază cu cp, apoi pune GEMINI_API_KEY=... în .env. Dacă GOOGLE_API_KEY este setată și în shell, SDK-ul o folosește în schimb, așa că codul de mai jos o elimină mai întâi. Sari peste următoarea subsecțiune dacă ai folosit Interactions API înainte.
Fă prima ta cerere către API-ul Gemini 4 Argon
Prima cerere îi dă lui Argon începutul ieșirii profiler-ului din EventFlow și îl întreabă ce arată. load_dotenv() încarcă GEMINI_API_KEY din .env, genai.Client() o citește, ID-ul modelului intră în client.interactions.create(), iar generation_config poartă nivelul de gândire.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Iată ce a venit înapoi:
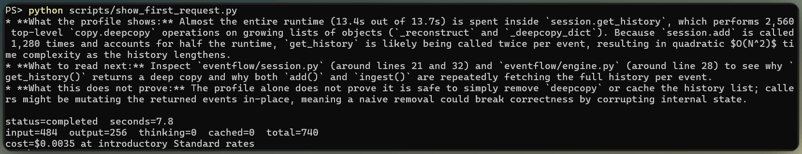
Prima cerere către Argon citește profilul. Imagine de autor.
Argon a înțeles corect; aproape tot timpul stătea sub get_history() și copy.deepcopy, probabil apelate de două ori per eveniment. Al treilea punct a avertizat că înlăturarea deep copy-ului ar putea strica apelanții care modifică ce primesc înapoi, ceea ce este prima scurtătură menționată mai devreme. O întrebare ca aceasta e ieftină: sub 8 secunde și mai puțin de jumătate de cent, fără tokeni de gândire.
medium este implicit, iar ghidul latest-model pe care l-am linkuit mai devreme îl recomandă „pentru majoritatea sarcinilor, inclusiv cod complex și cazuri agentice”. Același ghid spune că temperature, top_p și top_k sunt ignorate pe Argon, deci lasă-le pe dinafară.
Profilează codul Python înainte de a folosi Gemini 4 Argon
Măsoară aplicația originală înainte ca modelul să o atingă, astfel încât fiecare număr ulterior să aibă un reper de comparație. Ia trei tipuri de măsurători, fiecare în propriul proces, pentru că fiecare unealtă denaturează celelalte:
-
Chronometrare cu
time.perf_counter(), ca mediană a mai multor procese proaspete cu câte o încălzire -
Profilare cu
cProfilepentru a găsi unde se duce timpul; a făcut long cam de 6 ori mai lent, deci nu te baza niciodată pe o cronometrare sub profiler -
Memorie cu
tracemalloc, care raportează vârful alocărilor Python urmărite în loc de memoria totală a procesului
Pe cele trei sarcini, în loc de cele 1.600 de evenimente fixe din grafic, aplicația originală a durat aproximativ 0,7 secunde pe short, 2,2 pe long și 1,0 pe mixed. A trecut de asemenea fiecare test pytest vizibil.
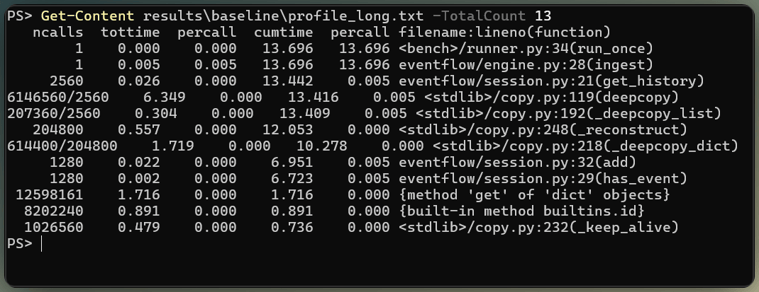
Unde își petrece timpul aplicația lentă. Imagine de autor.
Așteaptă derive: același cod, mai târziu, a cronometrat cu aproximativ 10% mai repede, așa că cronometrează fiecare versiune într-o singură sesiune.
Cum să construiești un agent de performanță cu Function Calling în Gemini 4 Argon
După cum am menționat mai devreme, Argon doar cere unelte. Codul Python care le rulează se numește harness, iar ghidul nostru despre ingineria agent harness explică de ce verificările aparțin în cod, nu în prompt. Uneltele vin primele, deoarece ele decid ce poate atinge Argon.
Definește uneltele și permisiunile agentului
Cele 8 unelte menționate mai devreme sunt funcții Python declarate ca scheme JSON simple, și doar două dintre ele pot schimba cod:
-
list_filesșiread_file, limitate la sursa Python a aplicației, teste și fixture-uri -
run_profilerșirun_benchmarkpentru o sarcină numită -
apply_patch, care înlocuiește o apariție exactă de text într-un fișier sursă al aplicației -
revert_file,run_testsșishow_diff
Declarațiile urmează formatul din ghidul function-calling la care am făcut legătură mai devreme:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},O schemă descrie apelul, dar nu îl face sigur. Harness-ul adaugă următoarele verificări în Python:
- Fiecare cale este rezolvată mai întâi, astfel încât o cale care scapă din copia aplicației eșuează
- Scrierile în afara folderului sursă al aplicației sunt refuzate
- Un fișier patch-uit trebuie să compileze în continuare, altfel patch-ul este respins
- Testele și benchmark-urile rulează în subprocess-uri cu time-out-uri și fără cheie API
Asta nu este un container, iar codul patch-uit ar putea încă citi fișiere în afara copiei, așa că trateaz-o ca minimul.
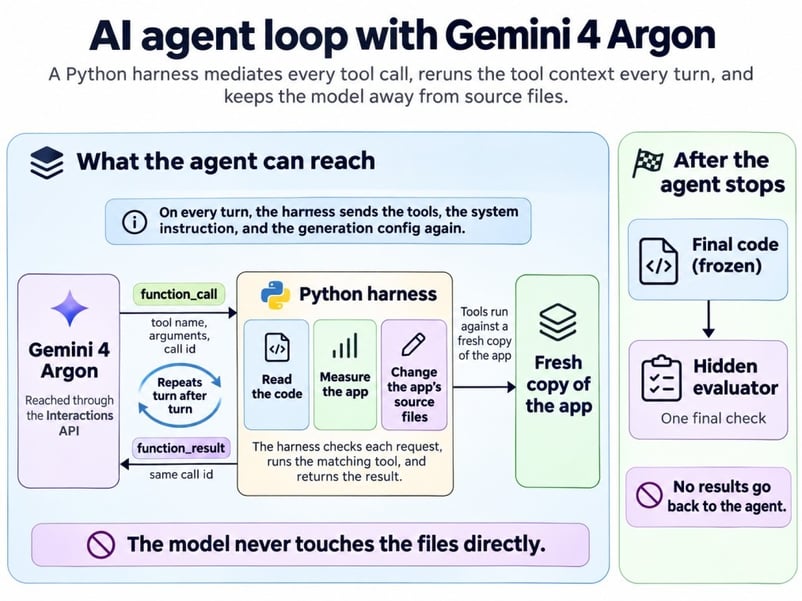
Argon cere, Python decide și rulează. Imagine de autor.
Dă-i agentului un obiectiv de performanță măsurabil
Instrucțiunea de sistem stabilește obiectivul și regulile, dar nu spune niciodată unde este încetinirea:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Agentul decide când să se oprească din ceea ce poate vedea: teste vizibile, rezultate de profiler și benchmark, și limitele pe care le stabilește bucla în continuare.
Implementează bucla de unelte Interactions API
Fragmentul de mai jos este miezul buclei; versiunea completă adaugă clientul, dispatcher-ul de unelte și limitele. Fiecare tură este un apel client.interactions.create(), iar Argon cere des mai multe unelte într-o tură, deci rulează fiecare pas function_call pe care îl întoarce. Trimite fiecare rezultat înapoi ca function_result cu call_id aferent:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request pe apelul următor este linia pe care lumea o scapă. previous_interaction_id poartă istoricul, dar tools, system_instruction și generation_config sunt la nivel de interacțiune, deci o tură fără ele pierde uneltele sau revine la nivelul implicit de gândire. Găsesc regula ușor de uitat, așa că codul păstrează toate cele trei setări într-un dict.
API-ul nu are buget de sarcină, așa că stabilește limite de ture, timp și cheltuieli în aplicația ta înainte să începi. Eu am folosit 40 de ture, 10 patch-uri, 45 de minute și 5 $, și nicio încercare nu s-a apropiat, deși verificarea cheltuielii rulează între ture, astfel încât o tură lungă o poate depăși. Pagina Google de rate limits adaugă propriul plafon pe conturile Tier 1, 10 $ per 10 minute rulante, și întoarce 429 RESOURCE_EXHAUSTED după ce îl depășești.
Rulează agentul Gemini 4 Argon și verifică-i schimbările
Fiecare încercare a pornit dintr-o copie proaspătă a aplicației, s-a oprit singură în aproximativ 5 minute și și-a înghețat codul înainte ca vreo verificare ascunsă să ruleze.
Găsirea gâtului de sticlă din dovezi
Argon a găsit gâtul de sticlă măsurând mai întâi. Iată prima încercare cu medium, tură cu tură.
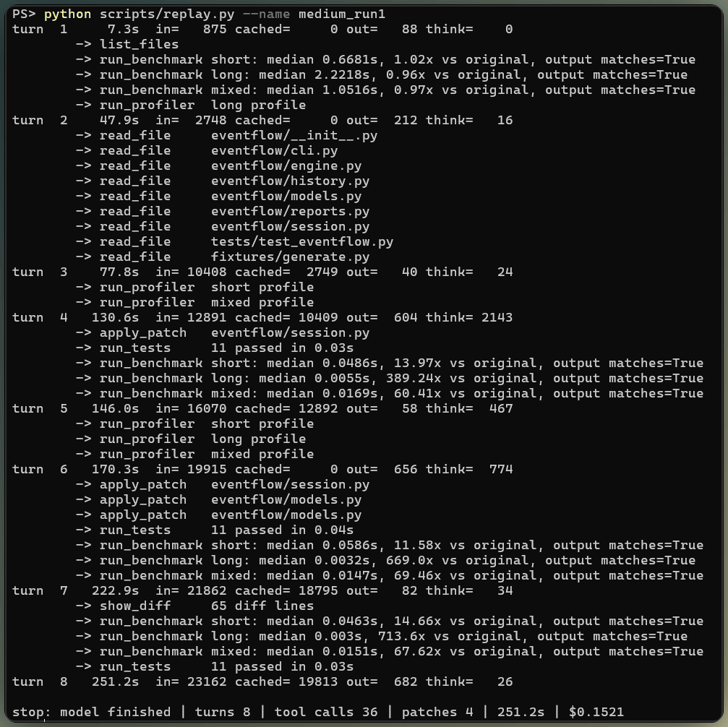
O încercare medium, tură cu tură. Imagine de autor.
Rezumatele gândirii sale, o versiune condensată a raționamentului (nu fiecare pas), arată cum a ajuns la remediere. Argon a observat că has_event() și add() apelează ambele get_history(). A întrebat dacă deep copy-ul este „chiar necesar aici sau dacă cerința este doar ca apelantul să dețină datele”, și a lămurit cu docstring-ul summarize(), care spune că funcția nu își modifică inputul.
Nu fiecare afirmație s-a sprijinit pe dovezi. Același rezumat spune că nu există „acces direct în teste sau utilizări ascunse”, lucru pe care Argon nu avea cum să-l știe. Intuiția s-a confirmat (de data asta), dar e genul de linie pe care o încercuiești în review.
Remedierea la care au ajuns toate cele șase încercări
Fiecare încercare a făcut aceeași schimbare de bază în CustomerState, iar cel mai mic dintre cele șase diffs o arată cel mai bine:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneAcum cauzele plantate promise mai devreme: add() re-sumariza întreg istoricul la fiecare eveniment, fiecare eveniment plătea pentru două deep copy-uri complete, iar verificările de duplicate scanau lista.
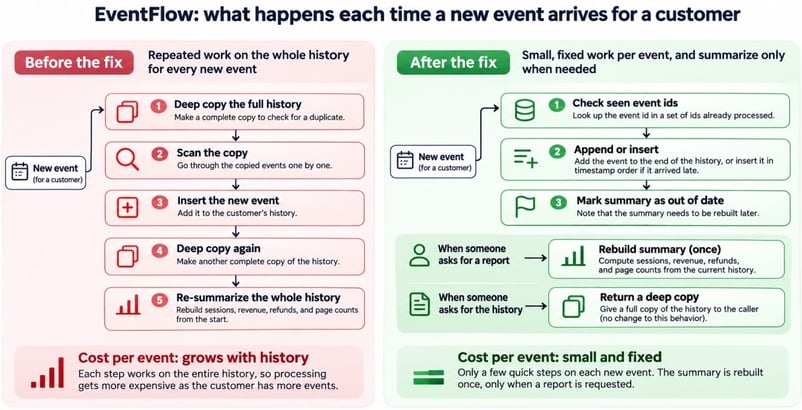
Munca per eveniment înainte și după remediere. Imagine de autor.
get_history() își păstrează deep copy-ul pentru apelanții externi, detaliul la care dă greș scurtătura cu deep copy de mai devreme.
Fiecare rundă de patch-uri a trecut testele vizibile, deci agentul nu a trebuit să revină, dar majoritatea încercărilor au adăugat și un setter pentru summary pe care nu îl apelează nimeni. Nimeni nu l-a cerut, și tot trebuie revizuit de cineva.
Rezultatele testelor ascunse de acceptanță
Evaluatorul ascuns a rulat o dată per încercare, iar fiecare încercare a trecut fiecare caz. Cazurile apelează ingest() după report(), trimit rambursări înaintea achizițiilor și modifică obiectele returnate ca să confirme că starea motorului rămâne neschimbată.
A făcut Gemini 4 Argon aplicația mai rapidă în mod real?
Da. Fiecare versiune nouă a fost mult mai rapidă și a returnat același output ca originalul. După cum am menționat mai devreme, cronometrările derapează, așa că am cronometrat originalul și toate cele 6 versiuni noi în ordine alternată, câte 9 procese proaspete fiecare.
Fiecare cronometrare acoperă doar ingest și rapoarte, nu pornirea Python sau importurile. La câteva milisecunde, o singură cronometrare poate cădea mult peste mediană, așa că compară medianele. Scala log a graficului împiedică noile versiuni să dispară lângă original.
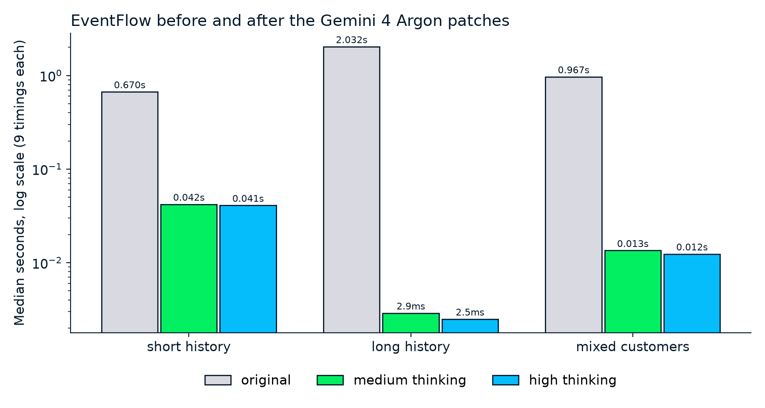
Milisecunde după, secunde înainte, aceleași outputuri. Imagine de autor.
Graficul arată prima încercare la fiecare nivel, iar tabelul acoperă toate cele 6, cu accelerarea ca mediană originală împărțită la mediana nouă:
|
Măsură |
Original |
Medium (3 încercări) |
High (3 încercări) |
|
|
Referință |
14,8x la 15,9x |
16,3x la 17,4x |
|
|
Referință |
656x la 701x |
aprox. 810x |
|
|
Referință |
65,4x la 71,6x |
76,8x la 78,0x |
|
Vârf memorie urmărită, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Vârf memorie urmărită, |
885 KiB |
570 KiB |
569 KiB |
long a câștigat cel mai mult, deoarece munca eliminată creștea odată cu istoricul fiecărui client. Rândurile de memorie sunt singurul loc unde remedierea costă ceva. short, cu cei mai mulți clienți, a folosit cu aproximativ 10% mai mult, probabil pentru noul set de ID-uri per client, în timp ce long a folosit mai puțin, probabil pentru că a încetat să mai construiască copii.
Nu citi 700x ca pe ceva special despre Argon. Eliminarea unei bucle cuadratice din date sintetice tinde să producă astfel de cifre, indiferent cine scrie remedierea.
Nivelurile de gândire Gemini 4 Argon: Medium vs. High
În această sarcină, high a scris cod ușor mai rapid decât medium, dar ambele niveluri au găsit aceeași remediere, deci gândirea suplimentară a mers în finisaj, nu în diagnostic.
Cum păstrezi comparația corectă
Schimbă nivelul de gândire și nimic altceva. Fiecare încercare a folosit același cod, prompt, unelte, limite și evaluator, și niciuna nu a văzut munca altei încercări. Nivelurile au alternat, 3 încercări fiecare, aceeași configurare pe care am folosit-o în tutorialul meu despre Claude Opus 5 API.
Rezultate, timp și cost pe nivel
Cele două niveluri s-au împărțit astfel, în medie per încercare:
|
Media per încercare |
Medium |
High |
|
Remedieri acceptate |
3 din 3 |
3 din 3 |
|
Apeluri de unelte |
28 |
35 |
|
Tokeni de gândire |
1.877 |
14.764 |
|
Linii schimbate |
24 |
193 |
|
Timp |
3,4 minute |
5 minute |
|
Cost la prețul introductiv |
0,10 $ |
0,29 $ |
|
Cost după încheierea prețului |
0,20 $ |
0,58 $ |
high a aterizat aceeași remediere la primul patch și apoi a continuat să lustruiască. A ajuns să rescrie părți din sumarizare, raportare și validare care nu mai erau principalul gât de sticlă.
Avansul acela se schimbă în funcție de mașină și stă aproape de zgomotul de cronometrare pe sarcini care se termină deja în milisecunde, așa că tot aș livra diff-ul mai mic al lui medium doar pe baza timpului de review.
Gândirea la high a atins vârful în tura 4, după ce primul său patch rezolvase deja problema.
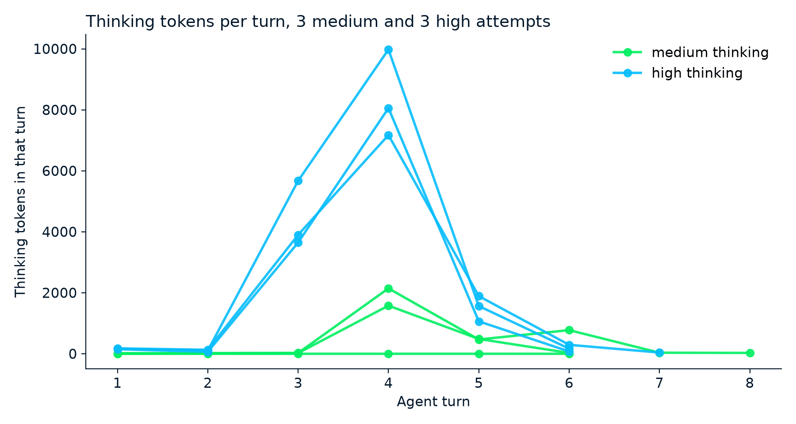
Unde și-a petrecut gândirea fiecare încercare. Imagine de autor.
Nu lua nici tokenii de gândire ca semnal de calitate; ca la prima cerere, o încercare medium nu a folosit deloc și tot a livrat o remediere acceptată, mai rapidă și mai ieftină decât orice altă încercare.
Pentru a prețui un agent, adună usage din fiecare tură, pentru că fiecare tură raportează întregul context procesat. Majoritatea inputului fiecărei ture repetă tura anterioară, iar cache-ul implicit a facturat cam două treimi la rata de cache.
Conform ghidului de caching, cache-ul are nevoie de un prompt de cel puțin 4.096 tokeni, iar o tură care adaugă mai puțin de 2.050 tokeni noi plătește rata completă pe ultimii 2.050 din cererea anterioară, deci buclele cu rezultate mici de unelte economisesc mai puțin. La tarifele introductive Standard, pe care le acopăr în FAQ, toate cele 6 încercări la un loc au costat 1,16 $.
Limitările unui agent AI de performanță
Un astfel de agent funcționează cel mai bine pe probleme spre care poate indica un profiler, iar acesta a fost construit să fie curat:
-
Gâtul de sticlă a fost plantat, cum am menționat la început. Un profiler indică aproape direct o buclă cu complexitate quadratică în șase fișiere mici, în timp ce încetinirile reale se ascund în I/O, baze de date și cod nedocumentat.
-
Docstring-urile au făcut multă treabă. Argon s-a sprijinit pe unul ca să decidă ce copie poate sări, iar o bază de cod nedocumentată nu îi oferă sprijin.
-
Testele verifică doar ce s-a gândit cineva. În studiul de caz ADK al Google, o schimbare de import a trecut suita publică și tot a picat ținte interne de test.
-
Cronometrările vin de pe o mică mașină Linux pe sarcini sintetice, deci accelerările tale vor diferi.
-
Fiecare fișier pe care agentul îl citește ajunge la Google, care stochează interacțiunile pe nivel plătit timp de 55 de zile în mod implicit;
store=falseoprește asta, dar excludeprevious_interaction_id.
Fișa modelului de la Google menționează de asemenea halucinații și time-out-uri ocazionale printre limitările cunoscute.
Concluzii
Agentul a găsit sumarizările repetate și deep copy-urile în toate cele șase încercări, a păstrat copia pe care se bazează apelanții și a trecut verificările separate. Gândirea high a adăugat puțină viteză și un diff mult mai mare.
Nu aș generaliza asta la baza ta de cod, pentru că eu am plantat gâtul de sticlă. Ce se transferă este metoda: măsoară mai întâi, păstrează uneltele înguste, îngheață codul înainte să-l verifici și lasă testele ascunse să decidă rezultatul.
Extensia pe care aș construi-o prima ar fi un router care începe la medium și trece la high doar când testele vizibile pică, astfel încât cazurile ascunse să nu se întoarcă niciodată în agent.
Dacă ieșirea de profiler de mai sus îți este nouă, Writing Efficient Python Code acoperă aceleași unelte de cronometrare și profilare pe care le-am folosit înainte să-l las pe Argon să atingă codul.
Întrebări frecvente
Poate Gemini 4 Argon să accelereze cod Python automat?
Nu de unul singur. Interactions API încă nu îți rulează uneltele, așa că codul tău face asta, iar aici codul de verificare a ajuns de două ori mai mare decât aplicația.
Poate Gemini 4 Argon să ruleze singur cod Python?
Da, cu unealta încorporată de execuție a codului, dar se oprește după 30 de secunde și nu poate instala pytest. Pentru teste reale, folosește-ți propria mașină sau configurarea găzduită din tutorialul Managed Agents.
Ar trebui să folosesc gândire low pentru un astfel de agent?
Nu am testat, iar Google spune că pe sarcini grele calitatea poate scădea. Din moment ce setezi nivelul la fiecare tură, aș încerca low pentru citirea fișierelor și medium pentru scrierea patch-urilor.
Cât costă API-ul Gemini 4 Argon?
Am plătit 2 $ per milion de tokeni de input și 10 $ per milion de tokeni de output, gândire inclusă, iar aceste prețuri se dublează după 30 noiembrie 2026. Flex costă jumătate, dar fiecare cerere poate dura până la 15 minute, ceea ce aș accepta doar pentru experimente peste noapte.
Pot folosi acest agent pe o bază de cod de producție?
Nu în forma aceasta, deci rulează-l într-un container de unică folosință și pune o persoană să revizuiască fiecare diff. Ține cont și că cunoașterea lui Argon se oprește în martie 2026, deci dă-i documentație actuală pentru biblioteci mai noi.
Am vrut să văd ce face Gemini 4 Argon cu o aplicație Python care nu e stricată, doar lentă. Toate testele trec și toate rapoartele sunt corecte, dar o parte din lucru durează secunde când ar trebui să dureze milisecunde, iar problema se agravează cu cât un client are mai mult istoric. Multe tutoriale de AI pentru cod pornesc de la un test care pică, ceea ce oferă modelului o țintă evidentă.
Dar aici, niciun test picant nu indică codul lent. Gemini 4 Argon este un model Google pe care îl apelezi din Python prin Gemini API și îl vei folosi pentru a construi un agent AI, adică un model care ia acțiuni către un obiectiv. În cazul acesta, agentul citește, cronometrează și editează cod, dar doar prin unelte pe care le controlează propriul tău Python.
Aplicația este EventFlow, un mic program fictiv care transformă activitatea, achizițiile și rambursările clienților în rapoarte. Întrebarea mea a fost dacă agentul poate găsi partea lentă și o poate repara fără să schimbe ce returnează aplicația. Dacă ești confortabil cu funcții și clase Python și să rulezi teste, poți urmări, iar eu voi acoperi cum să:
Prezentarea noastră Gemini 4 Argon acoperă lansarea și benchmark-urile, așa că acest tutorial rămâne pe API. Pentru o imagine mai largă a modelelor, vezi și comparațiile Gemini 4 Argon vs Claude Opus 5.5 și Gemini 4 Argon vs. GPT-6 Astra.
Pe scurt
I-am dat agentului aceeași sarcină de 6 ori, 3 cu gândire
mediumși 3 cuhigh, iar acesta este rezultatul:Argon a remediat încetinirea în toate cele 6 încercări, iar un set separat de teste ascunse a confirmat.
Sarcina lentă a trecut de la aproximativ 2 secunde la circa 3 milisecunde.
Argon a rulat benchmark-uri și un profiler înainte să schimbe codul, așa că dă-i agentului aceste unelte pe lângă teste.
higha costat cam de 3 ori mai mult decâtmedium(0,29 $ față de 0,10 $ per încercare, în medie) și a scris diffs de 8 ori mai mari pentru un câștig suplimentar moderat de viteză. Începe cumedium.Am plantat intenționat gâtul de sticlă într-o aplicație mică, deci aceste rezultate descriu doar acest caz.