

Что такое Gemini 4 Argon API?
Gemini 4 Argon API предоставляет gemini-4-argon — модель рассуждения Google, предназначенную для сложного кодирования и многошаговых задач агентов. Общая доступность достигнута в середине октября 2026 года. Согласно странице модели, вход, «мышление» и выход делят единое окно в 1 048 576 токенов, а синхронный ответ останавливается на 65 536 выходных токенах.
Google провела похожий эксперимент в своём кейс‑стади ADK: 11‑часовой прогон Antigravity с /goal в Python Agent Development Kit (ADK). Ревьюеры приняли 2 из 6 предложений, сократив подготовку сессий примерно на 40% в длинных сессиях и импорты на 21%. В этом учебнике вместо этого используется небольшой Python‑цикл.
Вы будете использовать четыре возможности API:
-
Interactions API — рекомендованный Google интерфейс для новых проектов, который хранит состояние диалога на сервере
-
Вызов функций, когда модель запрашивает инструмент, а ваш код решает, запускать ли его
-
thinking_level:low,medium(по умолчанию) илиhigh -
Объект
usage, который сообщает токены входа, кэша, выхода и «мысли»
Argon запрашивает — ваш код делает работу.
Проект: медленное Python‑приложение для исправления Gemini 4 Argon
Агент получает код EventFlow, 8 инструментов и ни единой подсказки о замедлении. Полный код доступен на GitHub. Начните с EventFlow.
Как работает EventFlow
EventFlow — вымышленный обработчик событий из шести небольших модулей. Событие попадает в EventFlow.ingest(), validate() превращает его в Event, а CustomerState хранит события по клиентам в порядке временных меток. Затем summarize() превращает каждую историю в сессии, выручку, возвраты и число страниц, а build_report() формирует CustomerReport.
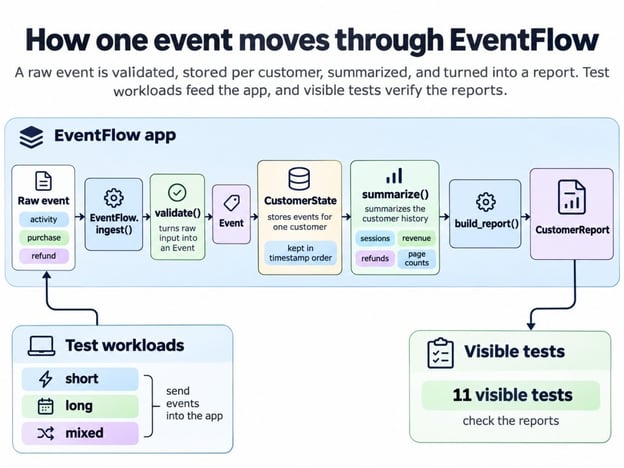
Как одно событие превращается в отчёт. Изображение автора.
Правила EventFlow заданы в докстрингах:
-
Сессии разделяются после 30‑минутного разрыва
-
Возвраты ограничены оставшейся суммой покупки
-
Повторяющийся
event_idигнорируется, приоритет у первого экземпляра -
События сортируются по времени, даже между партиями
-
history()иreport()возвращают объекты, которыми владеет вызывающий код
Скрытые тесты проверяют все эти правила, и последнее пригодится позже.
Почему EventFlow замедляется
Три набора нагрузок, построенные из фиксированных сидов, показывают, как длина истории меняет картину:
-
short: много клиентов по 5 событий у каждого -
long: мало клиентов по 160 событий у каждого -
mixed: от 1 до 30 событий на клиента, с дубликатами и событиями вне порядка
long содержит гораздо меньше событий, чем short, и всё равно работает примерно в 3 раза дольше. На графике общее число событий фиксировано на 1 600, но история каждого клиента становится длиннее.
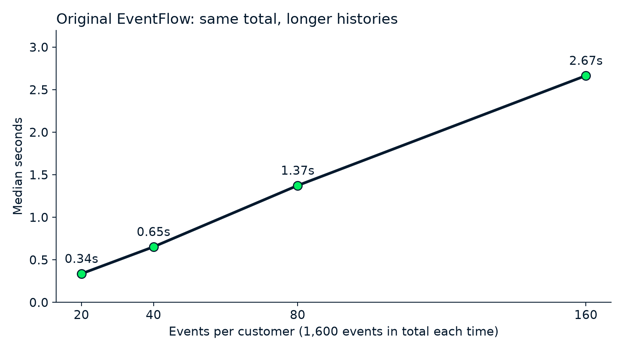
Общее то же, истории длиннее, обработка медленнее. Изображение автора.
Каждое удвоение длины истории удваивает время выполнения, хотя общее число событий не меняется. Такой паттерн обычно означает, что какой‑то шаг повторяет работу по всей истории при каждом новом событии. Агент причин не видит, поэтому я назову их после того, как Argon сделает свою работу.
Критерии успеха и скрытые тесты
Исправление засчитывается только если проходит пять проверок, установленных до первого вызова API; отчёт модели не учитывается. Итоговый код агента должен:
-
Работать как минимум в 1,5 раза быстрее на
long -
Быть не более чем на 5% медленнее на
shortилиmixed -
Проходить все видимые тесты
-
Возвращать тот же отчёт, что и оригинал, на всех трёх нагрузках
-
Проходить все скрытые приёмочные кейсы
Пороги — мои собственные, так что считайте их примером. Инструменты агента не имеют доступа к скрытым случаям; они запускаются только после «заморозки» кода. Скрытая проверка сравнивает код агента с отдельной референсной реализацией на новых данных, поздних пакетах, дубликатах и правилах владения объектами.
Скрытый набор полезен только если отбраковывает неверные исправления, поэтому подайте туда пару заведомо неверных. Здесь два лёгких шортката проходят все видимые тесты: убрать глубокое копирование и кэшировать сводку без её обновления. Скрытые случаи отклоняют оба.
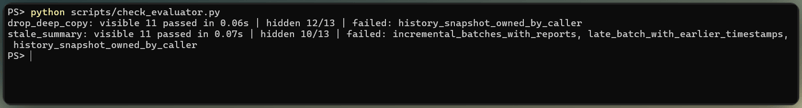
Скрытые тесты ловят два неверных фикса. Изображение автора.
Как настроить Gemini 4 Argon API в Python
Понадобятся Python 3.10+, ключ Gemini API и проект в Google AI Studio с включённым биллингом, поскольку страница цен не указывает бесплатный тариф для Argon. В этом проекте SDK google-genai зафиксирован на версии 2.33.0; Interactions API требует минимум 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envНа macOS или Linux активируйте виртуальное окружение с помощью source .venv/bin/activate, копируйте через cp, затем пропишите GEMINI_API_KEY=... в .env. Если в вашей оболочке также задан GOOGLE_API_KEY, SDK использует его, поэтому код ниже сначала удаляет его. Пропустите следующий подраздел, если уже работали с Interactions API.
Сделайте первый запрос к Gemini 4 Argon API
Первый запрос передаёт Argon верхнюю часть вывода профайлера EventFlow и спрашивает, что из этого следует. load_dotenv() загружает GEMINI_API_KEY из .env, genai.Client() его читает, ID модели указывается в client.interactions.create(), а generation_config несёт уровень «мышления».
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Вот что вернулось:
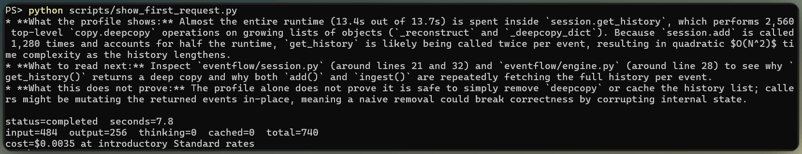
Первый запрос к Argon читает профиль. Изображение автора.
Argon понял верно: почти всё время тратилось внутри get_history() и copy.deepcopy, вероятно, вызывавшихся дважды на событие. Третий пункт предупредил, что удаление глубокого копирования может сломать вызывающие коды, которые модифицируют получаемые объекты — это и был первый шорткат, о котором я упоминал. Такой запрос стоит дёшево: меньше 8 секунд и менее полцента, без «мысленных» токенов.
medium — значение по умолчанию, и руководство по latest‑model, на которое я ссылался выше, рекомендует его «для большинства задач, включая сложный код и агентные сценарии». То же руководство говорит, что temperature, top_p и top_k на Argon игнорируются, так что их можно не указывать.
Профилируйте Python‑код до использования Gemini 4 Argon
Измерьте исходное приложение до вмешательства модели, чтобы у всех следующих чисел была точка отсчёта. Сделайте три вида измерений, каждое в отдельном процессе, потому что каждый инструмент искажает другие:
-
Замеры времени с
time.perf_counter()— медиана нескольких «чистых» процессов с одним прогревом -
Профилирование с
cProfileдля локализации затрат времени; оно замедлило long примерно в 6 раз, поэтому никогда не доверяйте таймингам под профайлером -
Память через
tracemalloc, который показывает пик отслеживаемых Python‑выделений, а не полную память процесса
На трёх нагрузках, а не на фиксированных 1 600 событиях из графика, оригинал показал около 0,7 секунды на short, 2,2 на long и 1,0 на mixed. Он также прошёл все видимые pytest тесты.
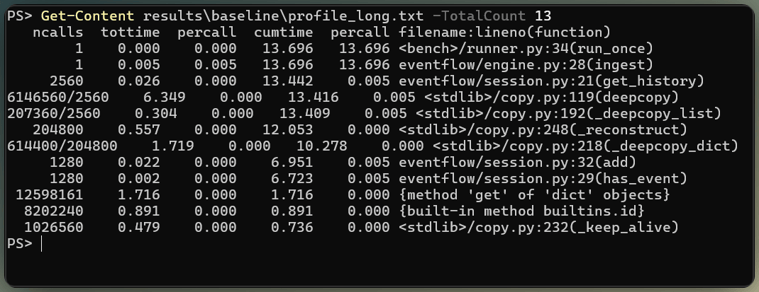
Где медленное приложение тратит время. Изображение автора.
Ожидайте дрейфа: позже тот же код показывал примерно на 10% быстрее, поэтому замеряйте все версии в одной сессии.
Как построить агента производительности с функциями Gemini 4 Argon
Как уже говорилось, Argon только запрашивает инструменты. Python‑код, который их запускает, называется «harness» (обвязка), и в нашем руководстве по разработке обвязки агента объясняется, почему проверки должны быть в коде, а не в промпте. Сначала — инструменты, потому что они определяют, к чему Argon имеет доступ.
Определите инструменты и права агента
Упомянутые 8 инструментов — это функции Python, объявленные в виде простых JSON‑схем, и только два из них могут менять код:
-
list_filesиread_file, ограниченные исходниками приложения, тестами и фикстурами -
run_profilerиrun_benchmarkдля одной названной нагрузки -
apply_patch, который заменяет одно точное вхождение текста в существующем исходнике приложения -
revert_file,run_testsиshow_diff
Объявления соответствуют формату из руководства по вызову функций, на которое я ссылался:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Схема описывает вызов, но не делает его безопасным. Обвязка добавляет такие проверки в Python:
- Каждый путь сначала нормализуется, чтобы попытка выйти за пределы копии приложения проваливалась
- Записи вне каталога исходников приложения запрещены
- Файл после патча должен компилироваться, иначе патч отклоняется
- Тесты и бенчмарки запускаются в подпроцессах с тайм‑аутами и без API‑ключа
Это не контейнер, и пропатченный код всё ещё может читать файлы вне копии, так что считайте это минимумом.
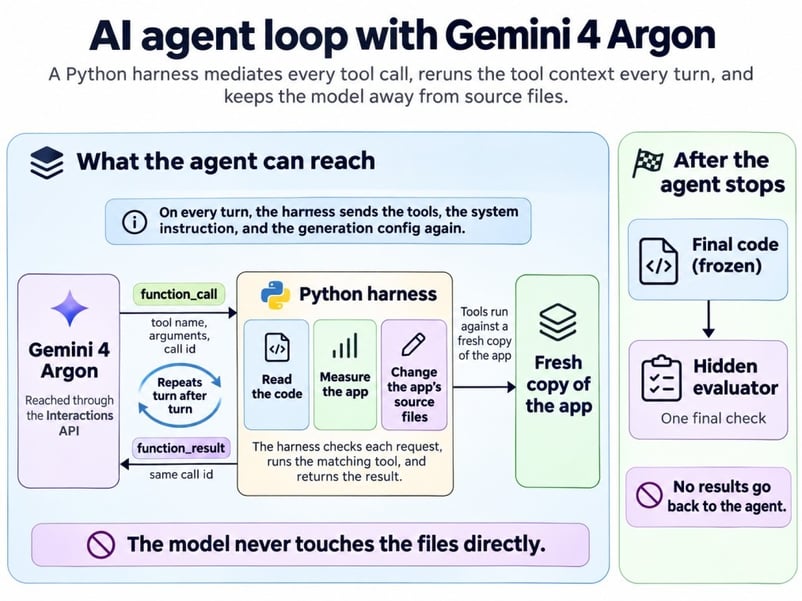
Argon запрашивает, Python решает и запускает. Изображение автора.
Задайте агенту измеримую цель по производительности
Системная инструкция формулирует цель и правила, но не говорит, где замедление:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Агент сам решает, когда остановиться, исходя из доступного: видимых тестов, результатов профайлера и бенчмарков и ограничений цикла.
Реализуйте цикл инструментов Interactions API
Ниже — ядро цикла; полная версия добавляет клиент, диспетчер инструментов и лимиты. Каждый ход — это один вызов client.interactions.create(), и Argon часто запрашивает несколько инструментов за ход, поэтому выполните каждый шаг function_call, который он вернёт. Отправляйте каждый результат обратно как function_result с соответствующим call_id:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)Строка с **request в последующем вызове — то, что часто забывают. previous_interaction_id переносит историю, но tools, system_instruction и generation_config имеют область действия «интеракции», поэтому ход без них потеряет инструменты или вернётся к уровню по умолчанию. Это легко забыть, поэтому код держит все три настройки в одном dict.
В API нет бюджетов на задачу, поэтому установите лимиты по ходам, времени и расходам в вашем приложении перед стартом. Я использовал 40 ходов, 10 патчей, 45 минут и $5 — ни одна попытка не приблизилась к лимитам, хотя проверка расходов идёт между ходами, так что один длинный ход может их превысить. Страница лимитов Google добавляет свой потолок для аккаунтов Tier 1 — $10 за скользящие 10 минут — и возвращает 429 RESOURCE_EXHAUSTED при превышении.
Запустите агента Gemini 4 Argon и подтвердите его изменения
Каждая попытка начиналась с новой копии приложения, останавливалась сама примерно за 5 минут, и код «замораживался» перед любыми скрытыми проверками.
Поиск узкого места по данным
Argon нашёл узкое место, начав с измерений. Вот первая попытка на medium, ход за ходом.
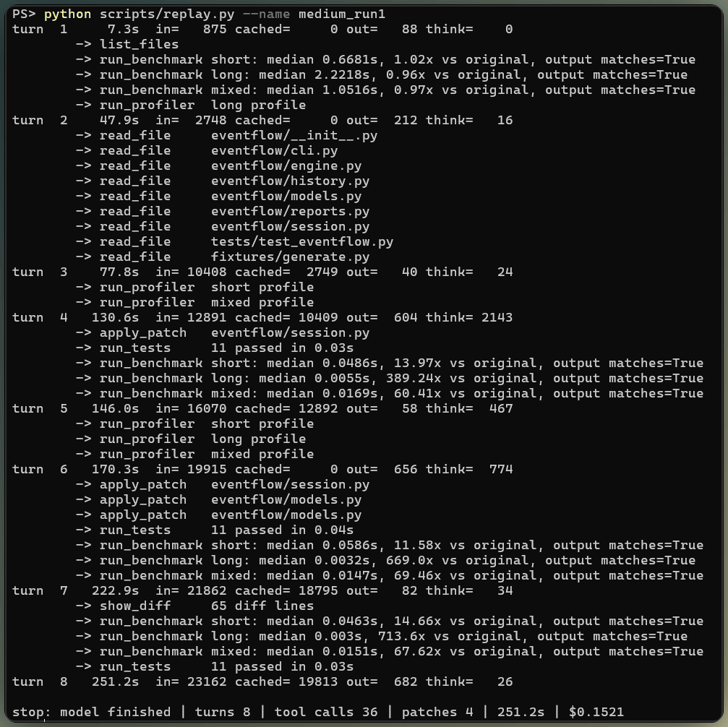
Одна попытка на medium, ход за ходом. Изображение автора.
Сводки мыслей — это конденсированная версия рассуждений, а не каждый шаг — показывают путь к фиксу. Argon заметил, что has_event() и add() оба вызывают get_history(). Он спросил, «действительно ли здесь необходимо глубокое копирование, или требование лишь в том, чтобы вызывающий код владел данными», и закрыл вопрос докстрингом summarize(), где сказано, что функция не модифицирует свой ввод.
Не каждое утверждение опиралось на данные. В той же сводке говорится об «отсутствии прямого доступа в тестах или скрытых использованиях», чего Argon знать не мог. Догадка оказалась верной (в этот раз), но такие фразы стоит отмечать при ревью.
Исправление, к которому пришли все шесть попыток
Каждая попытка внесла одно и то же ключевое изменение в CustomerState, и наименьший из шести диффов показывает это лучше всего:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneТеперь о намеренно заложенных причинах: add() пересуммировала всю историю при каждом событии, каждое событие платило за две полные глубокие копии, а проверка дубликатов сканировала список.
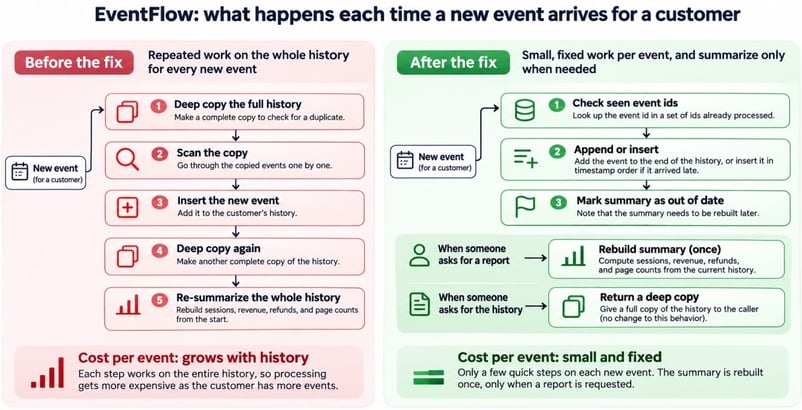
Работа на событие до и после исправления. Изображение автора.
get_history() сохраняет глубокое копирование для внешних вызовов — это деталь, которую нарушает упомянутый ранее «шорткат» с удалением deepcopy.
Каждый раунд патчей проходил видимые тесты, так что агенту не пришлось откатываться, но большинство попыток также добавляли сеттер для summary, который никто не вызывает. Никто его не просил, и его всё равно должен проверить человек.
Результаты скрытых приёмочных тестов
Скрытый оценщик запускался по разу на попытку, и каждая попытка прошла все случаи. Кейсы вызывают ingest() после report(), отправляют возвраты до соответствующих покупок и модифицируют возвращённые объекты, чтобы подтвердить неизменность состояния движка.
Сделал ли Gemini 4 Argon приложение действительно быстрее?
Да. Каждая новая версия была значительно быстрее и возвращала те же результаты, что и исходная. Как уже упоминалось, тайминги «плавают», поэтому я замерял оригинал и все 6 новых версий в чередующемся порядке, по 9 «чистых» процессов.
Каждый замер покрывает только ingest и построение отчётов, без запуска Python или импортов. На миллисекундных временах один прогон может оказаться сильно выше медианы, поэтому сравнивайте медианы. Логарифмическая шкала графика не даёт новым версиям «исчезнуть» рядом с оригиналом.
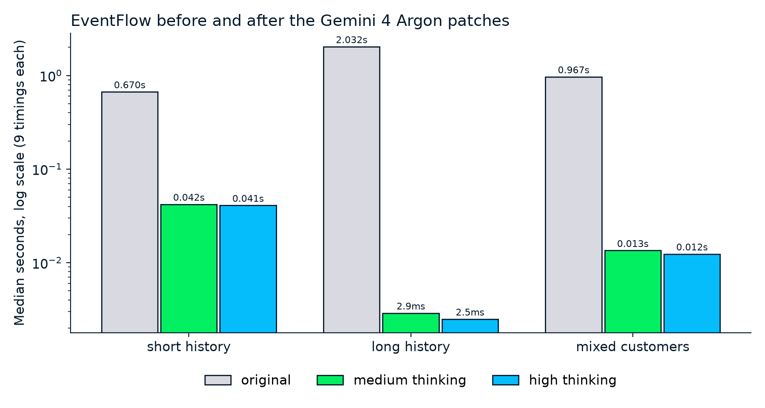
Миллисекунды после, секунды до, результаты те же. Изображение автора.
На графике — первая попытка каждого уровня, в таблице — все 6, ускорение — это медиана оригинала, делённая на медиану новой версии:
|
Метрика |
Оригинал |
Medium (3 попытки) |
High (3 попытки) |
|
|
Референс |
14,8× до 15,9× |
16,3× до 17,4× |
|
|
Референс |
656× до 701× |
около 810× |
|
|
Референс |
65,4× до 71,6× |
76,8× до 78,0× |
|
Пик отслеженной памяти, |
7 108 КиБ |
7 822 КиБ |
7 822 КиБ |
|
Пик отслеженной памяти, |
885 КиБ |
570 КиБ |
569 КиБ |
long выиграла больше всего, поскольку удалённая работа росла с длиной истории клиента. Строки про память — единственное место, где фикс что‑то «стоит». short с наибольшим числом клиентов использовала примерно на 10% больше, вероятно, из‑за нового множества ID на клиента, а long — меньше, скорее всего потому, что перестала создавать копии.
Не воспринимайте 700× как особенность Argon. Удаление квадратичного цикла на синтетических данных обычно даёт такие цифры — независимо от того, кто пишет фикс.
Уровни «мышления» Gemini 4 Argon: Medium vs High
В этой задаче high написал чуть более быстрый код, чем medium, но оба уровня нашли одно и то же решение, так что дополнительное «мышление» ушло в полировку, а не в диагностику.
Как сохранить корректность сравнения
Меняйте только уровень «мышления». Каждая попытка использовала один и тот же код, промпт, инструменты, лимиты и оценщик, и ни одна не видела результаты других. Уровни чередовались, по 3 попытки — тот же подход, что и в моём руководстве по Claude Opus 5 API.
Результаты, время и стоимость по уровням
Два уровня разошлись так, в среднем на попытку:
|
Среднее на попытку |
Medium |
High |
|
Принятые фиксы |
3 из 3 |
3 из 3 |
|
Вызовы инструментов |
28 |
35 |
|
«Мыслительные» токены |
1 877 |
14 764 |
|
Изменённых строк |
24 |
193 |
|
Время |
3,4 минуты |
5 минут |
|
Стоимость по вводной цене |
$0.10 |
$0.29 |
|
Стоимость после окончания цены |
$0.20 |
$0.58 |
high нашёл тот же фикс в первом патче, а потом продолжил полировать. Он переписал части суммирования, отчётности и валидации, которые больше не были основным узким местом.
Этот перевес зависит от машины и близок к шуму измерений на нагрузках, которые уже выполняются за миллисекунды, поэтому на одном времени ревью я бы всё равно отправил medium с меньшим диффом.
Пик «мышления» у high пришёлся на 4‑й ход — уже после первого патча, исправившего проблему.
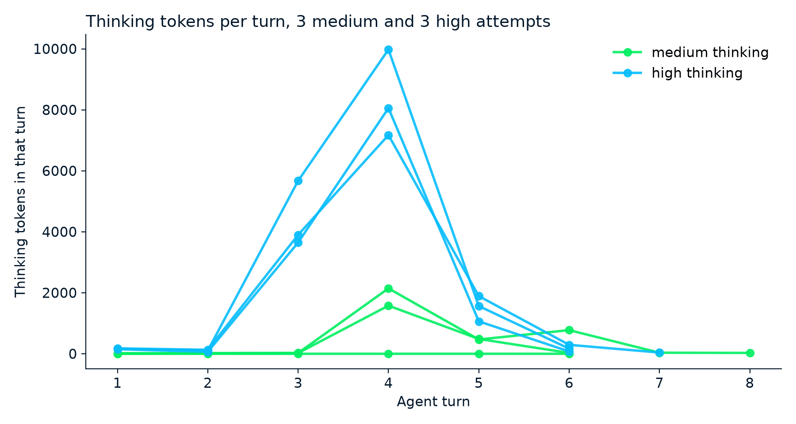
Где каждая попытка тратила «мышление». Изображение автора.
Не считайте «мыслительные» токены признаком качества: как и первый запрос, одна попытка на medium обошлась без них и всё равно дала принятый фикс — быстрее и дешевле остальных.
Чтобы посчитать цену агента, сложите usage всех ходов, потому что каждый ход сообщает весь обработанный контекст. Большая часть ввода повтора предыдущего хода, и неявный кэш биллировал около двух третей по кэш‑тарифу.
Согласно гайду по кэшированию, кэш требует промпт минимум на 4 096 токенов, а ход, добавляющий менее 2 050 новых токенов, платит полную ставку за последние 2 050 предыдущего запроса, так что циклы с крошечными результатами инструментов экономят меньше. По вводным стандартным тарифам, о которых я расскажу в FAQ, все 6 попыток вместе стоили $1.16.
Ограничения агента производительности на ИИ
Такой агент лучше всего работает с проблемами, на которые указывает профайлер, а этот кейс был сделан чистым:
-
Узкое место было заложено намеренно, как я говорил вначале. Профайлер почти напрямую указывает на квадратичный цикл в шести маленьких файлах, тогда как реальные тормоза прячутся в I/O, базах и недокументированном коде.
-
Докстринги сильно помогли. Argon опирался на один из них, чтобы решить, какое копирование можно убрать; у кода без документации опоры не будет.
-
Тесты проверяют лишь то, о чём кто‑то подумал. В кейс‑стади Google по ADK одно изменение импортов прошло публичный набор, но провалило внутренние цели тестов.
-
Замеры сделаны на небольшом Linux‑хосте и синтетических нагрузках — ваши ускорения будут иными.
-
Каждый файл, который читает агент, уходит в Google; по умолчанию платные интеракции хранятся 55 дней. Параметр
store=falseэто отключает, но исключаетprevious_interaction_id.
В карточке модели Google также указаны галлюцинации и эпизодические тайм‑ауты среди известных ограничений.
Заключение
Агент во всех шести попытках нашёл повторные суммирования и глубокие копии, сохранил копирование, на которое рассчитывают вызывающие коды, и прошёл скрытые проверки. high добавил немного скорости и существенно больший дифф.
Не стал бы обобщать это на вашу кодовую базу — узкое место заложено мной. Что переносится — это метод: сначала измеряйте, держите инструменты узкими, «замораживайте» код перед проверкой и давайте скрытым тестам решать исход.
Первым делом я бы добавил роутер, который начинает с medium и переключается на high только если видимые тесты падают, чтобы скрытые случаи не влияли на агента.
Если вывод профайлера выше для вас в новинку, курс Writing Efficient Python Code покрывает те же инструменты тайминга и профилирования, что я использовал до того, как дать Argon менять код.
FAQs
Может ли Gemini 4 Argon автоматически ускорить Python‑код?
Нет, самостоятельно — нет. Interactions API пока не запускает инструменты за вас, это делает ваш код, и здесь проверяющий код получился вдвое больше самого приложения.
Может ли Gemini 4 Argon сам выполнять Python‑код?
Да, с помощью встроенного инструмента выполнения кода, но он останавливается через 30 секунд и не может установить pytest. Для реальных тестов используйте свою машину или размещённую среду из нашего руководства по Managed Agents.
Стоит ли использовать низкий уровень «мышления» для такого агента?
Я не проверял, и Google пишет, что на сложных задачах качество может падать. Поскольку уровень задаётся на каждый ход, я бы попробовал low для чтения файлов и medium для внесения патчей.
Сколько стоит Gemini 4 Argon API?
Я платил $2 за миллион входных токенов и $10 за миллион выходных токенов, включая «мысленные», и эти цены удваиваются после 30 ноября 2026 года. Тариф Flex стоит вдвое дешевле, но каждый запрос может занимать до 15 минут — я бы принимал такое только для ночных экспериментов.
Можно ли использовать этого агента в продакшн‑кодовой базе?
Не в таком виде, поэтому запускайте его в одноразовом контейнере и давайте человеку просматривать каждый дифф. Также учитывайте, что знания Argon обрываются мартом 2026 года, поэтому давайте ему актуальную документацию для новых библиотек.
Хотелось понять, что сделает Gemini 4 Argon с Python‑приложением, которое не сломано, а просто медленное. Все тесты проходят, отчёты верны, но часть работы занимает секунды вместо миллисекунд — и становится хуже, чем длиннее история клиента. Многие учебники по ИИ‑кодингу начинают с падающего теста, давая модели очевидную цель.
Но здесь нет падающего теста, который указывал бы на медленный участок. Gemini 4 Argon — это модель Google, к которой вы обращаетесь из Python через Gemini API, и вы используете её, чтобы построить ИИ‑агента — модель, которая предпринимает действия для достижения цели. В нашем случае агент читает код, замеряет время и вносит правки, но только через инструменты, которыми управляет ваш Python.
Приложение называется EventFlow — это небольшой вымышленный проект, который превращает активность клиентов, покупки и возвраты в отчёты. Вопрос был в том, сможет ли агент найти узкое место и исправить его, не меняя возвращаемые результаты. Если вам знакомы функции и классы Python и вы умеете запускать тесты, вы сможете повторить шаги, а я покажу, как:
В нашем обзоре Gemini 4 Argon — запуск и бенчмарки, поэтому здесь мы сосредоточимся на API. Для общей картины модели также смотрите сравнения Gemini 4 Argon и Claude Opus 5.5 и Gemini 4 Argon и GPT-6 Astra.
TL;DR
Я дал агенту одну и ту же задачу 6 раз: 3 на уровне
mediumи 3 наhigh. Результат оказался таким:Argon устранил замедление во всех 6 попытках, и отдельный набор скрытых тестов это подтвердил.
Медленная нагрузка сократилась примерно с 2 секунд до около 3 миллисекунд.
Argon запустил бенчмарки и профайлер перед любыми правками кода, поэтому обеспечьте агенту эти инструменты наряду с тестами.
highстоил примерно в 3 раза дороже, чемmedium(в среднем $0.29 против $0.10 за попытку) и написал диффы в 8 раз больше ради умеренного прироста скорости. Начинайте сmedium.Я намеренно создал узкое место в маленьком приложении, так что эти результаты касаются только этого случая.