

Gemini 4 Argon API とは?
Gemini 4 Argon API は gemini-4-argon を提供します。これは複雑なコーディングやマルチステップのエージェントタスク向けに設計された Google の推論モデルです。2026 年 10 月中旬に一般提供になりました。 モデルページによると、入力・思考・出力は 1,048,576 トークンのウィンドウを共有し、同期レスポンスは出力 65,536 トークンで停止します。
Google は ADK 事例研究で同様の実験を行っています。Python Agent Development Kit(ADK)の /goal を用いた 11 時間の Antigravity 実行です。レビュー担当者は 6 件の提案のうち 2 件を採用し、長時間セッションの準備時間を約 40% 短縮、インポートを 21% 削減しました。本チュートリアルでは代わりに小さな Python ループを用います。
4 つの API 機能を使います。
-
新規プロジェクトに推奨され、会話状態をサーバー側に保持する Interactions API
-
モデルがツールを要求し、実行するかどうかをコード側で判断する 関数呼び出し
-
thinking_level:low、medium(デフォルト)、high -
入力・キャッシュ・出力・思考トークンを報告する
usageオブジェクト
Argon は依頼し、実際の作業はあなたのコードが行います。
プロジェクト:Gemini 4 Argon が修正する遅い Python アプリ
エージェントには EventFlow のコード、8 つのツール、スローダウンに関するヒントは一切与えません。完全なコードは GitHub にあります。まずは EventFlow から始めてください。
EventFlow の仕組み
EventFlow は 6 つの小さなモジュールからなる架空のイベント処理系です。イベントは EventFlow.ingest() に入り、validate() が Event に変換し、CustomerState が顧客ごとにタイムスタンプ順で保存します。続いて summarize() が履歴をセッション、売上、返金、ページ数に集計し、build_report() が CustomerReport を生成します。
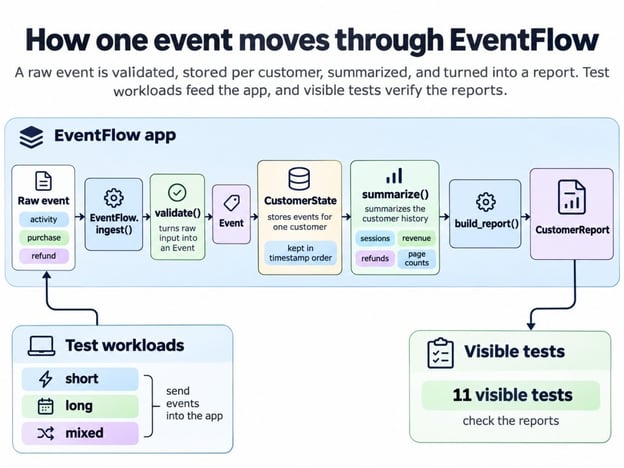
1 件のイベントがレポートになるまで。画像:筆者作成。
EventFlow のドックストリングは次の規則を定めています。
-
30 分の空白でセッションを分割する
-
返金は購入残高を上限とする
-
重複する
event_idは無視し、最初のものを優先する -
イベントはバッチをまたいでもタイムスタンプでソートされる
-
history()とreport()は呼び出し側が所有するオブジェクトを返す
非公開テストはこれらすべてを確認します。最後の規則は後で再登場します。
EventFlow が遅くなる理由
固定シードから作った 3 種類のワークロードで、履歴の長さが状況をどう変えるかを示します。
-
short:顧客数が多く、各 5 イベント -
long:顧客数は少なく、各 160 イベント -
mixed:顧客あたり 1〜30 イベントで、重複や順不同の到着を含む
long は short よりイベント総数がはるかに少ないのに、所要時間は約 3 倍です。以下のグラフは総数を 1,600 イベントに固定し、顧客ごとの履歴を長くしています。
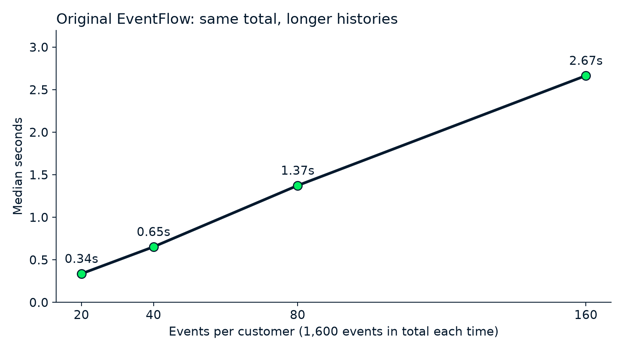
総数は同じでも、履歴が長くなると遅くなる。画像:筆者作成。
履歴の長さが倍になるたびに、実行時間も倍になります。総イベント数は変わらないのに、です。このパターンは、どこかの工程が新しいイベントのたびに履歴全体に対して仕事を繰り返していることを示すのが通例です。エージェントは原因を目にしないので、Argon に一通り任せた後で名前を挙げます。
成功基準と非公開テスト
修正がカウントされるのは、最初の API 呼び出し前に設定した 5 つのチェックを通った場合のみです。モデル自身の報告は考慮しません。エージェントの最終コードは次をすべて満たす必要があります。
-
longで少なくとも 1.5 倍速い -
shortとmixedで 5% 以上遅くならない -
可視テストをすべて通過する
-
3 つのワークロードすべてで元の実装と同じレポート出力を返す
-
非公開の受け入れケースをすべて通過する
これらの閾値は私自身の設定なので、あくまで一例と捉えてください。エージェントのツールは非公開ケースにアクセスできません。コード凍結後にのみ実行されます。新しいデータ、後着バッチ、重複、所有権ルールについて、別のリファレンス実装と比較します。
非公開スイートは誤った修正を弾いてこそ役に立つので、意図的にいくつか与えてください。ここでは 2 つの安易な近道、ディープコピーの削除とキャッシュしたサマリを更新せずに使い続ける、は可視テストをすべて通過します。非公開ケースは両方を拒否します。
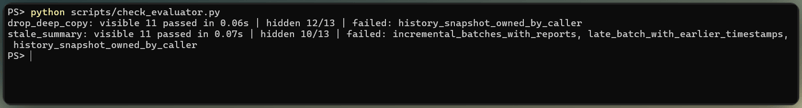
非公開テストが 2 つの誤修正を検出。画像:筆者作成。
Python で Gemini 4 Argon API をセットアップする方法
Python 3.10 以上、Gemini API キー、課金を有効化した Google AI Studio プロジェクトが必要です。なぜなら 料金ページに Argon の Free ティアは記載されていないからです。このプロジェクトでは SDK google-genai を 2.33.0 に固定しています。Interactions API には 2.3.0 以上が必要です。
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envmacOS または Linux では、仮想環境を source .venv/bin/activate で有効化し、コピーは cp を使います。次に GEMINI_API_KEY=... を .env に設定してください。シェルに GOOGLE_API_KEY も設定されている場合、SDK はそちらを優先するので、以下のコードは先に削除します。Interactions API を使ったことがある場合は次の小節はスキップしてください。
最初の Gemini 4 Argon API リクエストを作る
最初のリクエストでは、EventFlow のプロファイラ出力の先頭を Argon に渡し、何が読み取れるかを尋ねます。load_dotenv() は .env から GEMINI_API_KEY を読み込み、genai.Client() がそれを参照します。モデル ID は client.interactions.create() に渡し、generation_config で思考レベルを指定します。
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)返ってきた結果は次のとおりです。
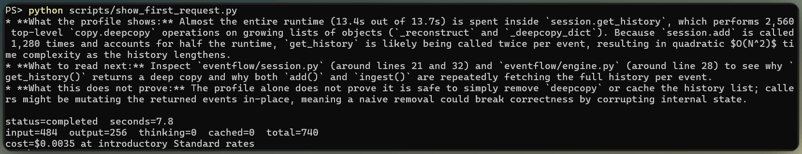
最初の Argon リクエストがプロファイルを読む。画像:筆者作成。
Argon の指摘は正確でした。時間のほぼすべてが get_history() と copy.deepcopy の下にあり、イベントごとに 2 回呼ばれている可能性が高い、と。3 つ目の箇条書きでは、ディープコピーを外すと、返り値を変更する呼び出し側が壊れる恐れがあると警告しました。これは先に述べた安易な近道の 1 つです。この種の問いは安価です。8 秒未満、1 セント未満で、思考トークンはゼロでした。
medium はデフォルトで、先ほどリンクした latest-model ガイドでも「複雑なコードやエージェント的なユースケースを含むほとんどのタスクに推奨」とあります。同ガイドによれば temperature、top_p、top_k は Argon では無視されるので、省きましょう。
Gemini 4 Argon を使う前に Python コードをプロファイルする
モデルに触らせる前に元のアプリを計測し、後の数値に比較対象を用意します。3 種類の計測をそれぞれ別プロセスで行ってください。ツール同士が互いに結果を歪めるからです。
-
time.perf_counter()によるタイミング測定(新規プロセスを複数回、各 1 回のウォームアップ後の中央値) -
時間の使い道を見つけるための
cProfileによるプロファイル。longでは約 6 倍遅くなったため、プロファイラ下のタイミングは信用しないこと -
tracemallocによるメモリ測定(プロセス全体ではなく、Python が追跡するピーク確保量を報告)
固定 1,600 イベントのグラフではなく、3 種のワークロードでの結果は、元のアプリが short は約 0.7 秒、long は 2.2 秒、mixed は 1.0 秒ほどでした。可視の pytest テストもすべて通過しました。
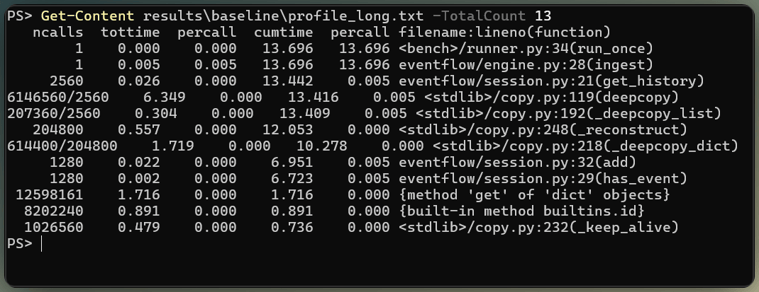
遅いアプリが時間を費やしている箇所。画像:筆者作成。
ドリフトは想定してください。同じコードでも後ほど約 10% 速く計測されたため、各バージョンは同一セッションで計測しましょう。
Gemini 4 Argon の関数呼び出しでパフォーマンスエージェントを構築する方法
先ほど述べたように、Argon はツールを要求するだけです。これらを実行する Python のコードはハーネスと呼ばれ、エージェントハーネスのエンジニアリングガイドでは、チェックをプロンプトではなくコードに置く理由を説明しています。まずツールからです。Argon が触れられる範囲を決めるからです。
エージェントのツールと権限を定義する
先に挙げた 8 つのツールは Python 関数で、プレーンな JSON スキーマとして宣言します。コードを変更できるのは 2 つだけです。
-
list_filesとread_file(対象はアプリの Python ソース、テスト、フィクスチャに限定) -
1 つのワークロード名に対する
run_profilerとrun_benchmark -
apply_patch(アプリの既存ソースファイル内のテキスト 1 か所を正確に置換) -
revert_file、run_tests、show_diff
宣言は、先ほどリンクした関数呼び出しガイドの形式に従います。
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},スキーマは呼び出しを記述するだけで、安全性は担保しません。ハーネス側で次のチェックを Python に実装します。
- すべてのパスは事前に解決し、コピーしたアプリから外へ出るパスは失敗させる
- アプリのソースフォルダ外への書き込みは拒否する
- パッチ適用後もファイルがコンパイル可能でなければ却下する
- テストとベンチマークは API キーなし、タイムアウト付きのサブプロセスで実行する
これはコンテナではなく、パッチ済みコードがコピー外のファイルを読む可能性は残るので、あくまで最小限と捉えてください。
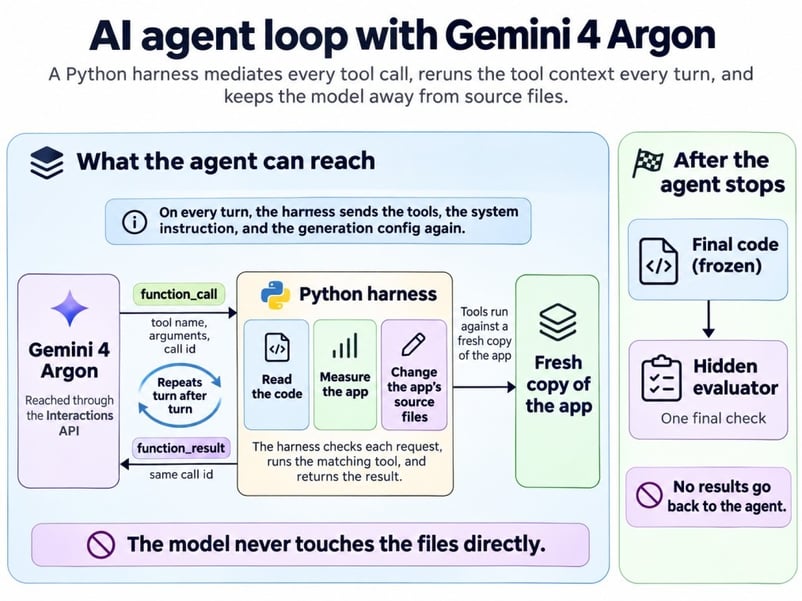
Argon が依頼し、Python が判断して実行。画像:筆者作成。
エージェントに測定可能な性能目標を与える
システム指示は目標とルールを示しますが、スローダウンの所在は一切明かしません。
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.エージェントは可視テスト、プロファイラとベンチマーク結果、そして次に述べるループの制限から、停止のタイミングを自ら判断します。
Interactions API のツールループを実装する
以下の抜粋がループの中核です。完全版はクライアント、ツールディスパッチャ、各種制限を追加します。各ターンは 1 回の client.interactions.create() 呼び出しで、Argon は 1 ターンで複数のツールを要求することが多いので、返ってきた function_call ステップはすべて実行します。各結果は対応する call_id とともに function_result として送り返します。
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request のつけ忘れはありがちです。 previous_interaction_id は履歴を引き継ぎますが、tools、system_instruction、generation_config はインタラクション単位です。これらを欠いたターンではツールが失われたり、思考レベルがデフォルトに戻ったりします。忘れやすいので、コードでは 3 つを 1 つの dict にまとめています。
API はタスク予算を持たないため、開始前にアプリ側でターン数、時間、費用の制限を設定してください。私は 40 ターン、10 パッチ、45 分、$5 を用いましたが、どの試行も届きませんでした。ただし費用チェックはターン間で行われるため、1 つの長いターンで超過する可能性はあります。 レート制限ページにあるとおり、Tier 1 アカウントには 10 分ローリングで $10 の上限があり、超過すると 429 RESOURCE_EXHAUSTED が返ります。
Gemini 4 Argon エージェントを実行し、変更を検証する
各試行はアプリの新しいコピーから開始し、約 5 分以内に自発的に停止し、非公開チェックの前にコードを凍結しました。
証拠からボトルネックを特定する
Argon はまず計測することでボトルネックを見つけました。最初の medium の試行をターンごとに示します。
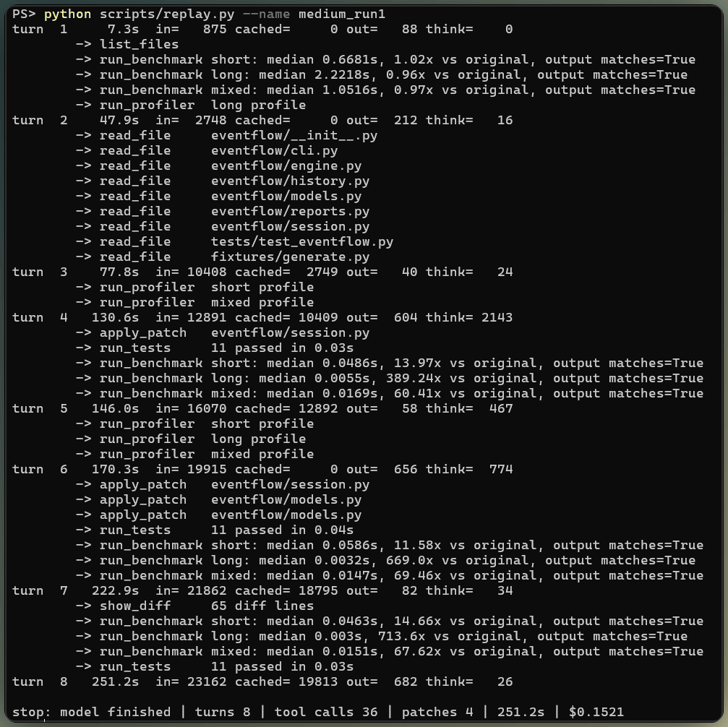
medium の 1 試行をターンごとに。画像:筆者作成。
思考サマリ(全工程ではなく推論の要約)から、修正に至る過程がわかります。Argon は has_event() と add() がともに get_history() を呼んでいる点に気づきました。ディープコピーが「本当に必要なのか、それとも必要なのは 呼び出し側 がデータを所有することだけなのか」を問い、入力を変更しないと記す summarize() のドックストリングで判断を下しました。
ただし、すべての主張が証拠に基づいていたわけではありません。同じサマリには「テストや非公開使用箇所での直接アクセスはない」とありますが、Argon には知りようがないことです。今回は当たっていましたが、レビューでは丸を付けて確認すべき類の記述です。
6 回すべてが辿り着いた修正
すべての試行が CustomerState に同じ中核の変更を加えました。6 つの差分のうち最小のものが最もわかりやすいです。
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = None予告した仕込みの原因は次のとおりです。add() がイベントごとに履歴全体を再集計し、各イベントが 2 回のフルディープコピーの代金を払い、重複チェックがリストを走査していました。
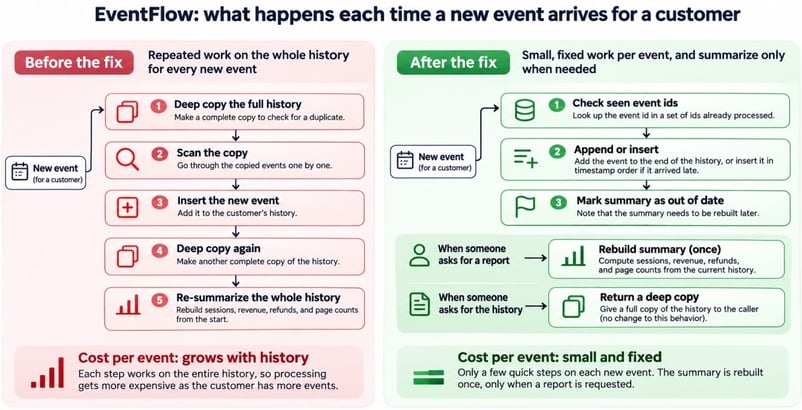
修正前後のイベント単位の作業。画像:筆者作成。
get_history() は外部呼び出し側のためにディープコピーを維持します。これは、先の「ディープコピーを削る」近道が見落としていた重要な点です。
各パッチのラウンドは可視テストを通過したため、エージェントが巻き戻す必要はありませんでしたが、多くの試行で誰も呼ばない summary セッターが追加されました。誰も求めていませんし、最終的には人のレビューが必要です。
非公開の受け入れテスト結果
非公開の評価器は試行ごとに 1 回実行され、すべての試行がすべてのケースを通過しました。ケースは report() の後に ingest() を呼び、購入前に返金が届き、返されたオブジェクトを変更してエンジン状態が保持されることを確認します。
Gemini 4 Argon は実際にアプリを速くしたのか?
はい。新バージョンはどれも大幅に速く、元の実装と同一の出力を返しました。先ほど述べたとおりタイミングはドリフトするため、元の実装と 6 つの新バージョンを交互に並べ、各 9 プロセスで計測しました。
各計測には Python の起動やインポートは含まず、取り込みとレポートのみを対象にしています。ミリ秒オーダーでは単発のタイミングが中央値を大きく上回ることがあるので、中央値を比較します。対数スケールのグラフは、元の実装の横で新バージョンが消えてしまわないようにするためです。
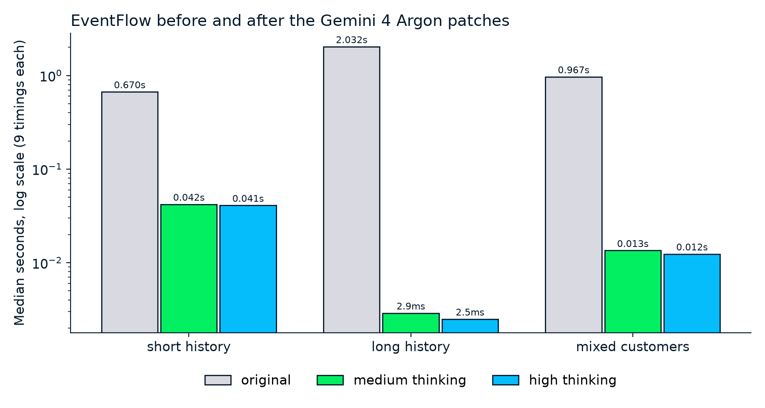
修正後はミリ秒、修正前は秒。出力は同一。画像:筆者作成。
グラフは各レベルの最初の試行を示し、表は 6 試行すべてをカバーします。スピードアップは元の中央値を新中央値で割った値です。
|
Measure |
Original |
Medium (3 attempts) |
High (3 attempts) |
|
|
Reference |
14.8x to 15.9x |
16.3x to 17.4x |
|
|
Reference |
656x to 701x |
about 810x |
|
|
Reference |
65.4x to 71.6x |
76.8x to 78.0x |
|
Peak tracked memory, |
7,108 KiB |
7,822 KiB |
7,822 KiB |
|
Peak tracked memory, |
885 KiB |
570 KiB |
569 KiB |
long の伸びが最も大きいのは、削除した作業が顧客履歴の長さに比例して増えていたからです。メモリの行だけが修正のコストを示します。顧客数の多い short は、おそらく顧客ごとの ID セット新設のために約 10% 増えました。一方 long はコピー生成をやめたため、減少しました。
700 倍という数字を Argon 特有のものと捉えないでください。合計二乗のループを人工データから取り除けば、誰が修正しても似た数字になりがちです。
Gemini 4 Argon の思考レベル:Medium 対 High
このタスクでは high の方がわずかに速いコードを書きましたが、両レベルとも同じ修正に到達しました。追加の思考は診断ではなく磨きに費やされた形です。
公正な比較の維持
思考レベル以外は変えません。すべての試行でコード、プロンプト、ツール、制限、評価器は同一で、互いの作業を見ていません。レベルは交互に 3 回ずつ、Claude Opus 5 API チュートリアルと同じ手順です。
レベル別の結果・時間・コスト
2 つのレベルは次のように分かれました(試行あたりの平均)。
|
Average per attempt |
Medium |
High |
|
Accepted fixes |
3 of 3 |
3 of 3 |
|
Tool calls |
28 |
35 |
|
Thinking tokens |
1,877 |
14,764 |
|
Lines changed |
24 |
193 |
|
Time |
3.4 minutes |
5 minutes |
|
Cost at the introductory price |
$0.10 |
$0.29 |
|
Cost after that price ends |
$0.20 |
$0.58 |
high は最初のパッチで同じ修正に到達し、その後も磨きを続けました。主要ボトルネックではなくなった集計、レポート、バリデーションの一部まで書き換えています。
その差はマシンにより変動し、ミリ秒で終わるワークロードではタイミングノイズに近いので、レビュー工数だけでも medium の小さな差分を採用したいところです。
high の思考はターン 4 でピークを迎えましたが、その前の最初のパッチでもう問題は解決していました。
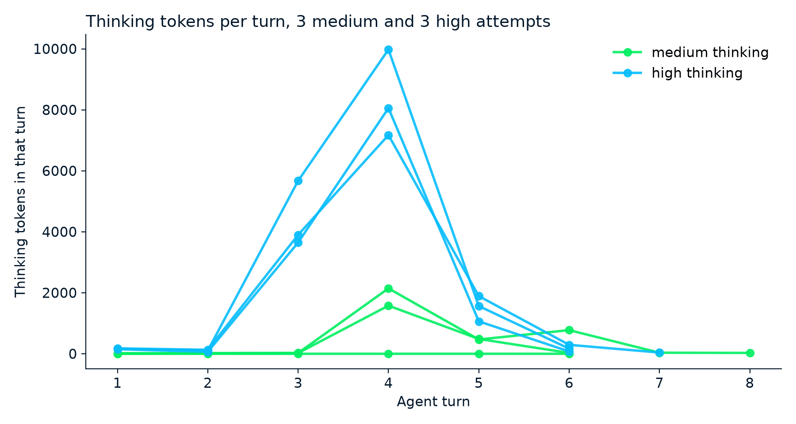
各試行が思考を費やした箇所。画像:筆者作成。
思考トークンを品質の指標と見なすのも禁物です。最初のリクエスト同様、medium の 1 試行はゼロでも受け入れ修正に到達し、他のどの試行よりも速く安く済みました。
エージェントの価格見積もりは各ターンの usage を合算します。各ターンは処理した完全なコンテキストを報告するからです。入力の大半は前ターンの繰り返しで、暗黙キャッシュはその約 3 分の 2 をキャッシュ料金で課金しました。
キャッシングガイドによると、キャッシュには 4,096 トークン以上のプロンプトが必要で、追加トークンが 2,050 未満のターンでは、前回リクエストの最後の 2,050 トークンが正規料金で課金されます。したがってツール結果がごく小さいループは節約効果が薄いです。Standard のイントロ価格(FAQ で解説)では、6 試行合計で $1.16 でした。
AI パフォーマンスエージェントの制約
この種のエージェントは、プロファイラが指し示せる問題に最もよく効きます。今回はそのためにきれいに作りました。
-
冒頭で述べたとおり、ボトルネックは仕込みです。プロファイラは 6 つの小さなファイルにある二乗時間のループをほぼ直指ししますが、実問題のスローダウンは I/O、データベース、未記述のコードに潜みます。
-
ドックストリングの寄与が大きかった。Argon は、どのコピーを省けるかの判断にそれを頼りました。無文書のコードベースでは拠り所がありません。
-
テストは思いついたことしか検査しません。Google の ADK 事例では、あるインポート変更が公開スイートを通ったのに、内部テストターゲットでは失敗しました。
-
タイミングは小さな Linux マシンでの人工ワークロードに基づくため、速度向上は環境により異なります。
-
エージェントが読むファイルはすべて Google に送られます。有料ティアのやり取りは既定で 55 日間保存されます。
store=falseで停止できますが、その場合はprevious_interaction_idが使えません。
Google の モデルカードには、既知の制限として幻覚や時折のタイムアウトも挙げられています。
まとめ
エージェントは 6 回すべてで、繰り返しの集計とディープコピーを見つけ、呼び出し側が頼るコピーは維持し、保持テストも通過しました。 high 思考は速度を少しだけ上げ、差分はかなり大きくなりました。
ただし、ボトルネックは私が仕込んだものなので、あなたのコードベースに一般化はしません。持ち帰れるのは手順です。まず計測し、ツールは狭く保ち、検証前にコードを凍結し、非公開テストで結果を判断することです。
最初に作る拡張は、medium で始め、可視テストが失敗した場合のみ high に切り替えるルーターです。非公開ケースがエージェントにフィードバックされるのを防げます。
もし上記のプロファイラ出力が初見であれば、Writing Efficient Python Code は、Argon にコードを触らせる前に使ったのと同じタイミング/プロファイリング手法を扱っています。
FAQs
Gemini 4 Argon は自動で Python コードを高速化できますか?
単体ではできません。Interactions API はまだツールを自動実行しないため、実行はあなたのコード側で行います。こちらのケースでは、検証コードはアプリ本体の 2 倍の分量になりました。
Gemini 4 Argon は自分で Python コードを実行できますか?
はい。内蔵のコード実行ツールで可能ですが、30 秒で停止し、pytest をインストールできません。実運用的なテストには自前のマシンか、当社のManaged Agents チュートリアルのホステッド環境を使ってください。
この種のエージェントには low 思考を使うべきですか?
今回は検証していません。Google は難しいタスクで品質が低下する可能性を示唆しています。ターンごとにレベルを設定できるので、ファイル読みには low、パッチ作成には medium を試すのがよいでしょう。
Gemini 4 Argon API の料金はいくらですか?
私は入力 100 万トークンあたり $2、出力 100 万トークンあたり $10(思考込み)を支払い、これらの価格は 2026 年 11 月 30 日以降は倍になります。Flex は半額ですが、リクエストが最大 15 分かかるため、夜間の実験にしか使わないでしょう。
このエージェントを本番コードベースで使えますか?
そのままでは推奨しません。使い捨てのコンテナで実行し、すべての差分を人がレビューしてください。また、Argon の知識は 2026 年 3 月で止まっているため、新しいライブラリには最新ドキュメントを与えてください。
壊れてはいないが遅い Python アプリを Gemini 4 Argon がどう扱うのか見てみたかったのです。すべてのテストは通り、すべてのレポートも正しいのに、本来ミリ秒で終わる作業が秒単位かかり、顧客の履歴が長くなるほど悪化します。多くの AI コーディングチュートリアルは失敗するテストから始まり、モデルに明確な標的を与えます。
しかしここでは、遅いコードを指し示す失敗テストはありません。Gemini 4 Argon は Gemini API 経由で Python から呼び出す Google のモデルで、AI エージェント、つまり目標に向けて行動を取るモデルを構築します。今回のエージェントはコードを読み、計測し、編集しますが、実行はすべて自分の Python が管理するツール経由だけです。
アプリは EventFlow という小さな架空のプログラムで、顧客の行動、購入、返金をレポートに変換します。エージェントが遅い部分を見つけ、アプリの出力を変えずに修正できるかが問いでした。Python の関数やクラス、テスト実行に慣れていれば付いて来られます。ここでは次の内容を扱います。
ローンチやベンチマークはGemini 4 Argon の概要で扱っているので、本チュートリアルは API に集中します。モデル全体の位置付けは、Gemini 4 Argon と Claude Opus 5.5 の比較やGemini 4 Argon と GPT-6 Astra の比較も参照してください。
TL;DR
同じ課題を 6 回与え、思考レベル
mediumで 3 回、highで 3 回実行しました。結果は次のとおりです。Argon は 6 回すべてでスローダウンを修正し、別の非公開テスト群も同意しました。
遅いワークロードは約 2 秒から約 3 ミリ秒になりました。
Argon はコード変更前にベンチマークとプロファイラを走らせたので、テストに加え、それらのツールもエージェントに与えてください。
highはmediumの約 3 倍の費用(平均で 1 回あたり $0.29 対 $0.10)で、速度上昇は控えめな一方、差分は 8 倍大きくなりました。まずはmediumから始めてください。ボトルネックは意図的に 1 つの小さなアプリに仕込みました。したがって、これらの結果はあくまでこのケースに限ります。