

Was ist die Gemini 4 Argon API?
Die Gemini 4 Argon API gibt dir gemini-4-argon, ein Google-Reasoning-Modell für komplexes Coding und mehrschrittige Agentenaufgaben. Allgemein verfügbar seit Mitte Oktober 2026. Laut Modellseite teilen sich Input, Denken und Output ein Fenster mit 1.048.576 Tokens, und eine synchrone Antwort stoppt bei 65.536 Output-Tokens.
Google hat ein ähnliches Experiment in der ADK-Fallstudie durchgeführt: ein 11-stündiger Antigravity-Run mit /goal auf dem Python Agent Development Kit (ADK). Die Reviewer behielten 2 von 6 Vorschlägen, reduzierten die Sitzungsvorbereitung in langen Sessions um ca. 40% und die Importe um 21%. Dieses Tutorial nutzt stattdessen eine kleine Python-Schleife.
Du nutzt vier API-Features:
-
Die Interactions API, Googles empfohlene Schnittstelle für neue Projekte, die den Gesprächsstatus serverseitig hält
-
Function Calling, bei dem das Modell ein Tool anfordert und dein Code entscheidet, ob es ausgeführt wird
-
thinking_level:low,medium(Standard) oderhigh -
Das
usage-Objekt, das Input-, Cache-, Output- und Thought-Tokens meldet
Argon fragt, und dein Code erledigt die Arbeit.
Das Projekt: Eine langsame Python-App für Gemini 4 Argon
Der Agent bekommt den EventFlow-Code, 8 Tools und keinen Hinweis auf die Verlangsamung. Der komplette Code liegt auf GitHub. Starte mit EventFlow.
So funktioniert EventFlow
EventFlow ist ein fiktiver Event-Prozessor in sechs kleinen Modulen. Ein Event kommt in EventFlow.ingest() an, validate() macht daraus ein Event, und CustomerState speichert es pro Kunde in Zeitstempelreihenfolge. Dann verwandelt summarize() jede Historie in Sessions, Umsatz, Erstattungen und Seitenzählungen, und build_report() erzeugt einen CustomerReport.
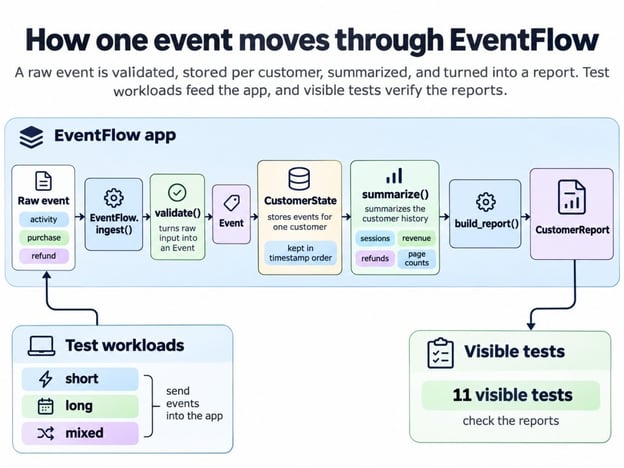
Wie aus einem Event ein Report wird. Bild: Autor.
Die Docstrings von EventFlow legen diese Regeln fest:
-
Sessions trennen sich nach 30 Minuten Pause
-
Erstattungen sind auf den verbleibenden Kaufbetrag gedeckelt
-
Eine wiederholte
event_idwird ignoriert, die erste Kopie gewinnt -
Events werden nach Zeitstempel sortiert, auch über Batches hinweg
-
history()undreport()liefern Objekte zurück, die der Aufrufer besitzt
Die versteckten Tests prüfen all das, und der letzte Punkt kommt später noch einmal vor.
Warum EventFlow langsam wird
Drei Workloads – aus festen Seeds gebaut – zeigen, wie sich längere Historien auswirken:
-
short: viele Kunden mit jeweils 5 Events -
long: wenige Kunden mit jeweils 160 Events -
mixed: 1 bis 30 Events pro Kunde, mit Duplikaten und außer der Reihenfolge eintreffenden Events
long hat deutlich weniger Events als short und braucht trotzdem rund 3-mal so lang. Das Diagramm hält die Summe bei 1.600 Events, verteilt aber längere Historien pro Kunde.
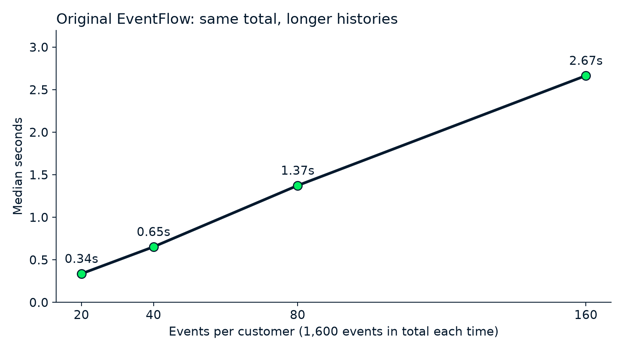
Gleiche Summe, längere Historien, langsamere Verarbeitung. Bild: Autor.
Jedes Mal, wenn sich die Historienlänge verdoppelt, verdoppelt sich auch die Laufzeit – obwohl die Gesamtzahl der Events konstant bleibt. So ein Muster deutet meist darauf hin, dass irgendein Schritt bei jedem neuen Event erneut die ganze Historie bearbeitet. Der Agent sieht die Ursachen nie, deshalb nenne ich sie erst nach Argons Einsatz.
Erfolgskriterien und versteckte Tests
Eine Lösung zählt nur, wenn sie fünf vorab gesetzte Checks besteht – der Bericht des Modells selbst zählt nicht. Der finale Code des Agenten muss alles Folgende erfüllen:
-
Mindestens 1,5-mal schneller auf
long -
Auf
shortundmixedhöchstens 5% langsamer -
Alle sichtbaren Tests bestehen
-
Auf allen drei Workloads dieselben Report-Ausgaben wie das Original liefern
-
Jeden versteckten Akzeptanzfall bestehen
Diese Schwellen sind meine eigenen – behandle sie als Beispiel. Die Tools des Agenten erreichen die versteckten Fälle nicht; sie laufen erst, nachdem sein Code eingefroren wurde. Sie vergleichen den Code mit einer separaten Referenzimplementierung auf neuen Daten, späten Batches, Duplikaten und die Eigentumsregeln.
Eine versteckte Suite hilft nur, wenn sie falsche Fixes ablehnt. Füttere sie also absichtlich mit ein paar solchen. Zwei einfache Abkürzungen bestehen hier alle sichtbaren Tests: das Weglassen der Deep Copy und das Cachen der Zusammenfassung ohne je zu aktualisieren. Die versteckten Fälle lehnen beides ab.
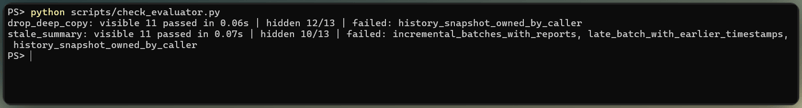
Versteckte Tests erwischen zwei falsche Fixes. Bild: Autor.
So richtest du die Gemini 4 Argon API in Python ein
Du brauchst Python 3.10 oder neuer, einen Gemini API Key und ein Google AI Studio-Projekt mit aktivierter Abrechnung, denn auf der Preisseite gibt es für Argon keine Free Tier. Dieses Projekt pinnt das google-genai SDK auf 2.33.0; die Interactions API benötigt mindestens 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envUnter macOS oder Linux aktivierst du die virtuelle Umgebung mit source .venv/bin/activate und kopierst mit cp. Dann kommt GEMINI_API_KEY=... in .env. Wenn GOOGLE_API_KEY ebenfalls in deiner Shell gesetzt ist, nutzt das SDK ihn stattdessen – der folgende Code entfernt ihn daher zunächst. Überspringe den nächsten Abschnitt, wenn du die Interactions API schon genutzt hast.
Sende deine erste Gemini 4 Argon API-Anfrage
Deine erste Anfrage gibt Argon den Kopf der Profiler-Ausgabe von EventFlow und fragt, was sie zeigt. load_dotenv() lädt GEMINI_API_KEY aus .env, genai.Client() liest ihn, die Model-ID geht in client.interactions.create(), und generation_config trägt die Denkstufe.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # liest GEMINI_API_KEY aus der Umgebung
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Das kam zurück:
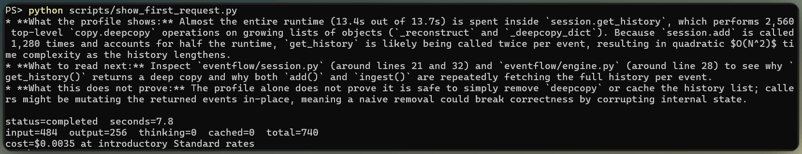
Erste Argon-Anfrage liest das Profil. Bild: Autor.
Argon lag richtig: Beinahe die gesamte Zeit hing unter get_history() und copy.deepcopy, vermutlich zweimal pro Event aufgerufen. Im dritten Punkt warnte es, dass das Entfernen der Deep Copy Aufrufer brechen könnte, die die Rückgabe verändern – genau die Abkürzung von vorhin. So eine Frage ist günstig: unter 8 Sekunden und weniger als einem halben Cent – ohne Thinking Tokens.
medium ist Standard, und der verlinkte "latest-model"-Guide empfiehlt es "für die meisten Aufgaben, einschließlich komplexen Codes und agentischer Use Cases". Laut demselben Guide werden temperature, top_p und top_k auf Argon ignoriert – lass sie weg.
Python-Code profilieren, bevor du Gemini 4 Argon nutzt
Miss die Original-App, bevor das Modell eingreift, damit alle späteren Zahlen einen Vergleich haben. Nimm drei Messarten – jeweils in einem eigenen Prozess, weil sich die Tools gegenseitig beeinflussen:
-
Timing mit
time.perf_counter()als Median mehrerer frischer Prozesse mit je einem Warm-up -
Profiling mit
cProfile, um Zeitfresser zu finden; es machte long ca. 6-mal langsamer – verlasse dich also nie auf Timings unter einem Profiler -
Speicher mit
tracemalloc, das Spitzenwerte getrackter Python-Allokationen statt Gesamtspeicher des Prozesses meldet
Auf den drei Workloads – nicht auf der Diagramm-Konstante von 1.600 Events – brauchte die Original-App ca. 0,7 Sekunden auf short, 2,2 auf long und 1,0 auf mixed. Außerdem bestand sie jeden sichtbaren pytest-Test.
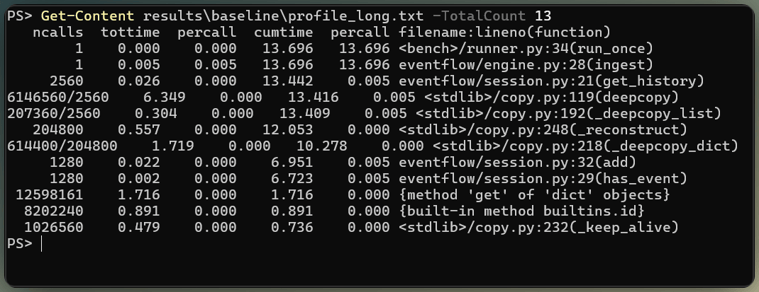
Hier steckt die Zeit der langsamen App. Bild: Autor.
Rechne mit Drift: Dasselbe Timing war später rund 10% schneller. Miss also jede Version in einer Session.
Einen Performance-Agenten mit Gemini 4 Argon Function Calling bauen
Wie gesagt: Argon fordert nur Tools an. Der Python-Code, der sie ausführt, heißt Harness. Unser Guide zu Agent-Harness-Engineering erklärt, warum Prüfungen in den Code – nicht in den Prompt – gehören. Die Tools kommen zuerst, denn sie bestimmen, was Argon berühren darf.
Tools und Berechtigungen des Agenten definieren
Die 8 Tools sind Python-Funktionen, als einfache JSON-Schemas deklariert. Nur zwei dürfen Code ändern:
-
list_filesundread_file, begrenzt auf den Python-Quellcode der App, Tests und Fixtures -
run_profilerundrun_benchmarkfür eine benannte Workload -
apply_patch, das eine exakte Vorkommnis-Ersetzung in einer bestehenden Quellcodedatei vornimmt -
revert_file,run_testsundshow_diff
Die Deklarationen folgen dem Format aus dem Function-Calling-Guide:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Ein Schema beschreibt den Aufruf, macht ihn aber nicht sicher. Der Harness ergänzt in Python folgende Checks:
- Jeder Pfad wird aufgelöst; Pfade, die aus der App-Kopie herausführen, scheitern
- Schreibzugriffe außerhalb des Quellordners der App werden verweigert
- Eine gepatchte Datei muss weiterhin kompilieren, sonst wird der Patch verworfen
- Tests und Benchmarks laufen in Subprozessen mit Timeouts und ohne API Key
Das ist kein Container. Gepatchter Code könnte weiterhin Dateien außerhalb der Kopie lesen – betrachte es als Minimum.
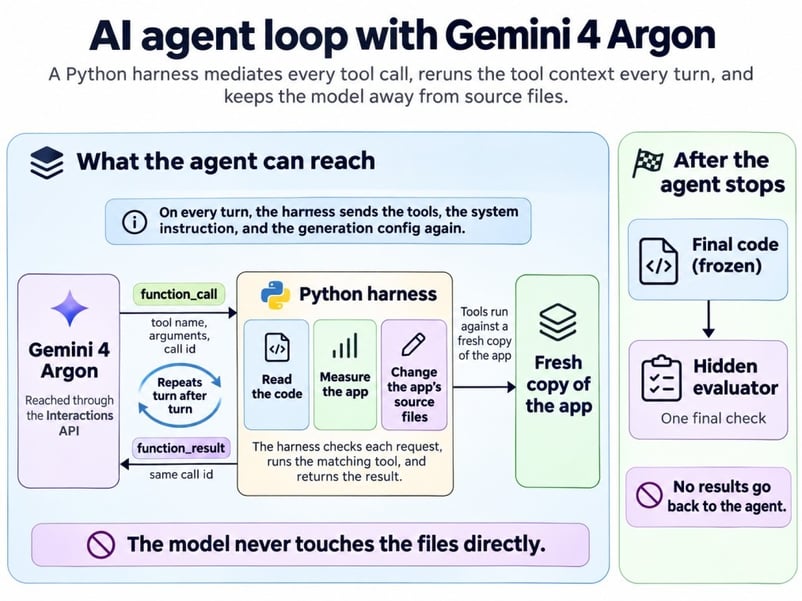
Argon fragt – Python entscheidet und führt aus. Bild: Autor.
Dem Agenten ein messbares Performanceziel geben
Die System-Anweisung definiert Ziel und Regeln, ohne zu verraten, wo die Verlangsamung liegt:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Der Agent entscheidet, wann Schluss ist – basierend auf sichtbaren Tests, Profil- und Benchmark-Ergebnissen und den Grenzen der folgenden Schleife.
Die Tool-Schleife der Interactions API implementieren
Der folgende Ausschnitt ist der Kern der Schleife; die vollständige Version ergänzt Client, Tool-Dispatcher und Limits. Jede Runde ist ein client.interactions.create()-Aufruf. Argon verlangt oft mehrere Tools pro Runde, also führe jeden function_call-Schritt aus. Sende jedes Ergebnis als function_result mit passender call_id zurück:
# requires_action bedeutet "führe meine Tools aus"; incomplete heißt, das Output-Limit hat die Runde abgeschnitten
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # das oben gezeigte Ziel
tools=DECLARATIONS, # die 8 Schemas, z. B. apply_patch
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # fehlgeschlagen, abgeschnitten oder abgeschlossen
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validiert, lokal ausgeführt
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# Applikations-Limits hier prüfen: 40 Runden, 45 Minuten, $5
# **request erneut: Tools, Instruction und Config werden nicht zwischen Runden übernommen
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)Das **request im Folgeaufruf ist die Zeile, die viele vergessen. previous_interaction_id trägt den Verlauf, aber tools, system_instruction und generation_config sind auf die jeweilige Interaktion scoped. Eine Runde ohne sie verliert die Tools oder fällt auf die Standard-Denkstufe zurück. Damit ich das nicht vergesse, liegen alle drei Einstellungen in einem Dict.
Die API hat kein Aufgabenbudget. Setze also Runden-, Zeit- und Ausgabenlimits in deiner Anwendung, bevor du startest. Ich nutzte 40 Runden, 10 Patches, 45 Minuten und $5 – keiner der Versuche kam nahe dran. Die Kostenprüfung läuft zwischen Runden, daher kann eine lange Runde sie überziehen. Googles Rate-Limits-Seite fügt auf Tier-1-Konten ein eigenes Limit hinzu: $10 pro rollende 10 Minuten – darüber gibt es 429 RESOURCE_EXHAUSTED.
Den Gemini 4 Argon Agenten ausführen und Änderungen verifizieren
Jeder Versuch startete mit einer frischen App-Kopie, endete selbstständig nach etwa 5 Minuten und wurde eingefroren, bevor irgendein versteckter Check lief.
Den Flaschenhals aus Belegen heraus finden
Argon fand den Flaschenhals, indem es zuerst maß. Hier der erste Versuch mit medium, Runde für Runde.
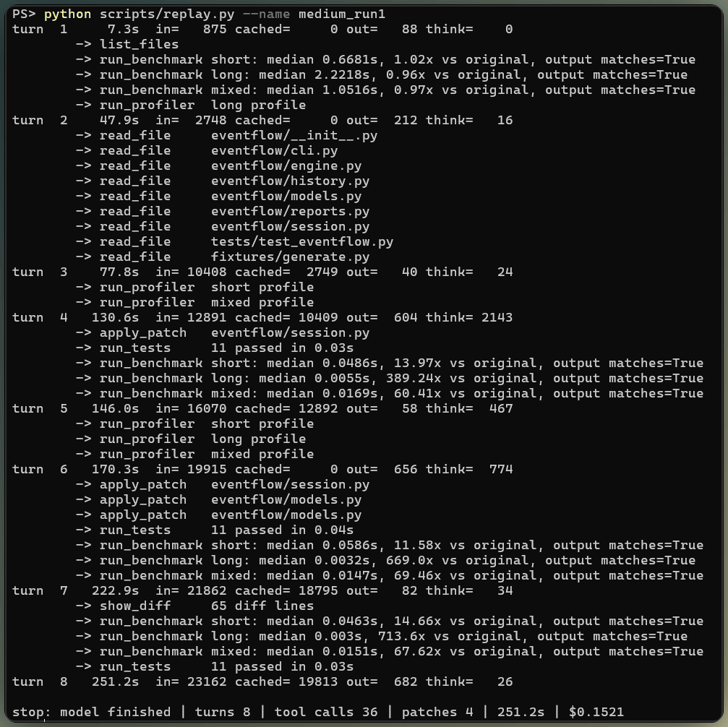
Ein medium-Versuch, Runde für Runde. Bild: Autor.
Die Thinking-Summaries – eine verdichtete Begründung statt jedes einzelnen Schritts – zeigen den Weg zur Lösung. Argon erkannte, dass has_event() und add() beide get_history() aufrufen. Es fragte, ob die Deep Copy „hier wirklich nötig ist oder ob nur gefordert ist, dass der Aufrufer die Daten besitzt“, und klärte das mit dem Docstring von summarize(), der sagt, dass die Funktion ihr Input nicht verändert.
Nicht jede Aussage war belegt. Dieselbe Summary behauptet „keinen direkten Zugriff in Tests oder versteckten Nutzungen“ – das konnte Argon nicht wissen. Die Vermutung hielt (diesmal), ist aber genau die Art von Satz, den man im Review markieren sollte.
Der Fix, auf den alle sechs Versuche kamen
Jeder Versuch nahm dieselbe Kernänderung an CustomerState vor. Der kleinste der sechs Diffs zeigt es am besten:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneNun die versprochenen eingebauten Ursachen: add() fasste bei jedem Event die gesamte Historie erneut zusammen, jedes Event bezahlte zwei volle Deep Copies, und die Duplikatsprüfung scannte die Liste.
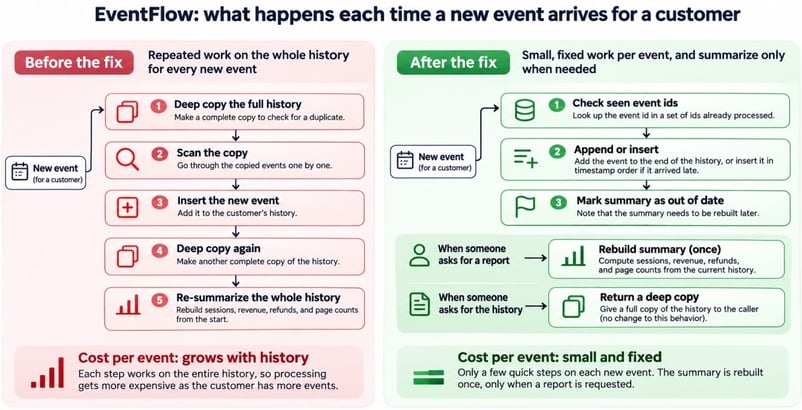
Pro-Event-Arbeit vor und nach dem Fix. Bild: Autor.
get_history() behält seine Deep Copy für externe Aufrufer – genau das Detail, das die „Deep-Copy-weg“-Abkürzung falsch macht.
Jede Patch-Runde bestand die sichtbaren Tests, also musste der Agent nie zurückrollen. Die meisten Versuche fügten allerdings auch einen summary-Setter hinzu, den niemand aufruft. Hat niemand verlangt – und muss trotzdem jemand reviewen.
Ergebnisse der versteckten Akzeptanztests
Der versteckte Evaluator lief pro Versuch einmal – und jeder Versuch bestand jeden Fall. Die Fälle rufen ingest() nach report() auf, schicken Erstattungen vor zugehörigen Käufen und ändern zurückgegebene Objekte, um zu bestätigen, dass der Engine-State unverändert bleibt.
Hat Gemini 4 Argon die App wirklich schneller gemacht?
Ja. Jede neue Version war deutlich schneller und lieferte dieselbe Ausgabe wie das Original. Wie erwähnt driften Timings, deshalb habe ich das Original und alle 6 neuen Versionen in abwechselnder Reihenfolge gemessen, je 9 frische Prozesse.
Jedes Timing umfasst nur Ingest und Reporting, nicht Python-Start oder Importe. Bei ein paar Millisekunden kann ein einzelnes Timing weit über dem Median landen – vergleiche also die Mediane. Die Log-Skala im Diagramm verhindert, dass die neuen Versionen neben dem Original verschwinden.
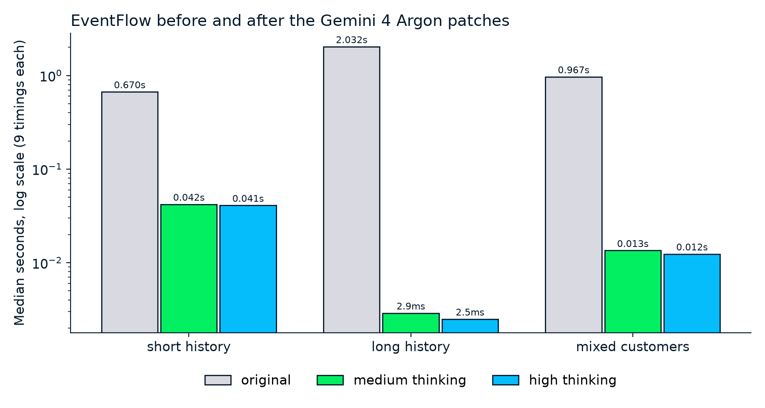
Millisekunden nachher, Sekunden vorher – gleiche Outputs. Bild: Autor.
Das Diagramm zeigt den ersten Versuch je Stufe, die Tabelle alle 6 – die Beschleunigung ist Original-Median geteilt durch neuen Median:
|
Messung |
Original |
Medium (3 Versuche) |
High (3 Versuche) |
|
|
Referenz |
14,8x bis 15,9x |
16,3x bis 17,4x |
|
|
Referenz |
656x bis 701x |
rund 810x |
|
|
Referenz |
65,4x bis 71,6x |
76,8x bis 78,0x |
|
Peak getrackter Speicher, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Peak getrackter Speicher, |
885 KiB |
570 KiB |
569 KiB |
long profitierte am meisten, weil die entfernte Arbeit mit der Kundenhistorie wuchs. Nur bei den Speicherzeilen kostet der Fix etwas. short mit den meisten Kunden brauchte ca. 10% mehr – vermutlich für das neue kundenspezifische ID-Set. long brauchte weniger, wahrscheinlich weil Kopien wegfielen.
Lies 700x nicht als etwas Spezifisches für Argon. Das Entfernen einer quadratischen Schleife in synthetischen Daten liefert oft solche Zahlen – egal, wer den Fix schreibt.
Gemini 4 Argon Denkstufen: Medium vs. High
Bei dieser Aufgabe schrieb high etwas schnelleren Code als medium, aber beide fanden denselben Fix – das Extra-Denken floss also eher in Feinschliff als in Diagnose.
Fair vergleichen
Ändere nur die Denkstufe. Jeder Versuch nutzte denselben Code, Prompt, dieselben Tools, Limits und denselben Evaluator – keiner sah die Arbeit eines anderen. Die Stufen wechselten sich ab, je 3 Versuche – dieselbe Anlage wie im Claude Opus 5 API Tutorial.
Ergebnisse, Zeit und Kosten nach Stufe
Die beiden Stufen teilten sich so auf – gemittelt pro Versuch:
|
Durchschnitt pro Versuch |
Medium |
High |
|
Akzeptierte Fixes |
3 von 3 |
3 von 3 |
|
Tool-Aufrufe |
28 |
35 |
|
Thinking Tokens |
1.877 |
14.764 |
|
Geänderte Zeilen |
24 |
193 |
|
Zeit |
3,4 Minuten |
5 Minuten |
|
Kosten zum Einführungspreis |
$0,10 |
$0,29 |
|
Kosten nach Ende des Preises |
$0,20 |
$0,58 |
high landete den Fix bereits im ersten Patch und polierte danach weiter. Es schrieb Teile von Summarizing, Reporting und Validation um, die nicht mehr der Hauptflaschenhals waren.
Dieser Vorsprung schwankt je nach Maschine und liegt nahe an der Messtoleranz – bei Workloads, die ohnehin in Millisekunden fertig sind. Ich würde allein wegen der Review-Zeit eher das kleinere Diff von medium shippen.
Highs Denken erreichte seinen Peak in Runde 4 – nachdem der erste Patch das Problem schon gelöst hatte.
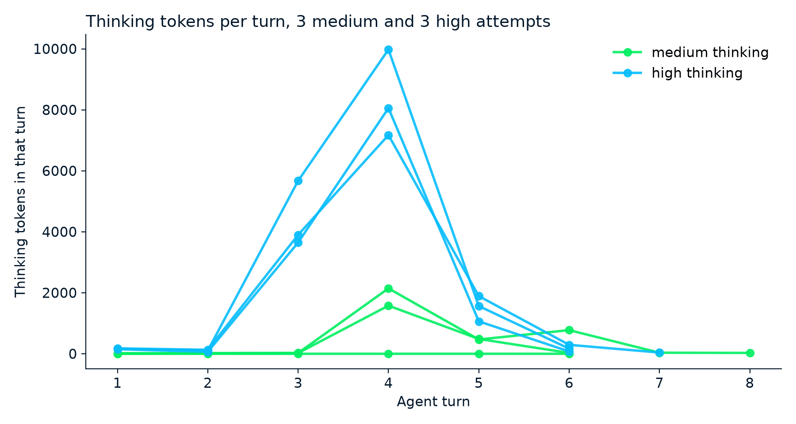
Wo jeder Versuch sein Denken investierte. Bild: Autor.
Nimm Thinking Tokens ebenfalls nicht als Qualitätssignal. Wie bei der ersten Anfrage nutzte ein medium-Versuch gar keine – und lieferte dennoch einen akzeptierten Fix, schneller und günstiger als jeder andere Versuch.
Um einen Agenten zu bepreisen, addiere die usage aller Runden, denn jede Runde meldet den kompletten verarbeiteten Kontext. Der Großteil des Inputs wiederholt die Vor-Runde; der implizite Cache berechnete rund zwei Drittel davon zum Caching-Tarif.
Laut Caching-Guide braucht der Cache einen Prompt von mindestens 4.096 Tokens. Fügt eine Runde weniger als 2.050 neue Tokens hinzu, zahlst du den vollen Satz auf die letzten 2.050 der vorherigen Anfrage. Schleifen mit winzigen Tool-Outputs sparen also weniger. Zu den Standard-Einführungspreisen (Details in den FAQs) kosteten alle 6 Versuche zusammen $1,16.
Grenzen eines KI-Performance-Agenten
Ein solcher Agent funktioniert am besten bei Problemen, auf die ein Profiler zeigen kann – und dieses Setup ist bewusst „clean“ gebaut:
-
Der Flaschenhals war – wie eingangs erwähnt – gepflanzt. Ein Profiler zeigt fast direkt auf eine quadratische Schleife in sechs kleinen Dateien, während echte Verlangsamungen sich in I/O, Datenbanken und undokumentiertem Code verstecken.
-
Die Docstrings leisteten viel. Argon stützte sich darauf, um zu entscheiden, welche Kopie es sich sparen konnte. In einem undokumentierten Codebase fehlt diese Stütze.
-
Tests prüfen nur, woran jemand gedacht hat. In Googles ADK-Fallstudie bestand eine Importänderung die öffentliche Suite – fiel aber bei internen Testzielen durch.
-
Timings stammen von einer kleinen Linux-Maschine auf synthetischen Workloads – deine Speedups werden abweichen.
-
Jede vom Agenten gelesene Datei geht an Google. Bezahlte Interaktionen werden standardmäßig 55 Tage gespeichert;
store=falseverhindert das, schließt aberprevious_interaction_idaus.
Googles Model Card führt zudem Halluzinationen und gelegentliche Timeouts als bekannte Limitierungen auf.
Fazit
Der Agent fand in allen sechs Versuchen die wiederholten Summaries und Deep Copies, behielt die Kopie, auf die Aufrufer angewiesen sind, und bestand die zurückgehaltenen Checks. high lieferte etwas mehr Speed, aber ein deutlich größeres Diff.
Ich würde das nicht auf deinen Code verallgemeinern – der Flaschenhals war gesetzt. Was sich übertragen lässt, ist die Methode: erst messen, Tools schlank halten, Code vor der Prüfung einfrieren und versteckte Tests über das Ergebnis entscheiden lassen.
Die erste Erweiterung wäre für mich ein Router: starte mit medium und schalte nur auf high, wenn die sichtbaren Tests scheitern – so fließen die versteckten Fälle nie in den Agenten zurück.
Wenn dir die Profiler-Ausgabe oben neu ist, deckt Writing Efficient Python Code dieselben Timing- und Profiling-Tools ab, die ich genutzt habe, bevor Argon den Code anfasste.
FAQs
Beschleunigt Gemini 4 Argon Python-Code automatisch?
Nicht von allein. Die Interactions API führt deine Tools noch nicht selbst aus – dein Code übernimmt das. In diesem Projekt war der Prüfcode am Ende doppelt so groß wie die App.
Kann Gemini 4 Argon selbst Python-Code ausführen?
Ja, mit dem integrierten Code-Execution-Tool – aber es bricht nach 30 Sekunden ab und kann pytest nicht installieren. Für echte Tests nutze deine eigene Maschine oder das gehostete Setup in unserem Managed-Agents-Tutorial.
Sollte ich für so einen Agenten die Denkstufe low nutzen?
Habe ich nicht getestet, und Google sagt, die Qualität kann bei harten Aufgaben sinken. Da du die Stufe pro Runde setzt, würde ich low fürs Lesen von Dateien und medium fürs Schreiben von Patches probieren.
Was kostet die Gemini 4 Argon API?
Ich zahlte $2 pro Million Input-Tokens und $10 pro Million Output-Tokens – Denken inklusive. Diese Preise verdoppeln sich nach dem 30. November 2026. Flex kostet die Hälfte, aber jede Anfrage kann bis zu 15 Minuten dauern – das würde ich nur für Overnight-Experimente akzeptieren.
Kann ich diesen Agenten auf einem Produktions-Codebase einsetzen?
Nicht wie hier geschrieben. Führe ihn in einem Wegwerf-Container aus und lass jede Änderung von einer Person reviewen. Bedenke auch, dass Argons Wissensstand im März 2026 endet – gib ihm also aktuelle Dokus für neuere Libraries.

Ich bin Dateningenieur und Community-Builder und arbeite mit Datenpipelines, Cloud- und KI-Tools. Außerdem schreibe ich praktische, super nützliche Tutorials für DataCamp und angehende Entwickler.





Ich wollte sehen, was Gemini 4 Argon mit einer Python-App macht, die nicht kaputt ist, sondern nur langsam. Alle Tests bestehen und alle Reports stimmen, aber manches braucht Sekunden, wo Millisekunden reichen sollten – und je mehr Historie ein Kunde hat, desto schlimmer wird es. Viele KI-Coding-Tutorials starten mit einem fehlschlagenden Test, der dem Modell ein offensichtliches Ziel liefert.
Hier zeigt aber kein fehlschlagender Test auf den langsamen Code. Gemini 4 Argon ist ein Google-Modell, das du aus Python über die Gemini API ansteuerst – und du nutzt es, um einen KI-Agenten zu bauen, also ein Modell, das Schritte in Richtung eines Ziels ausführt. In diesem Fall liest, misst und bearbeitet der Agent Code – aber ausschließlich über Tools, die deine eigene Python-App kontrolliert.
Die App heißt EventFlow, ein kleines fiktives Programm, das Kundenaktivitäten, Käufe und Erstattungen in Reports verwandelt. Meine Frage war, ob der Agent die langsame Stelle finden und beheben kann, ohne die Ausgaben der App zu verändern. Wenn du dich mit Python-Funktionen, -Klassen und dem Ausführen von Tests wohlfühlst, kannst du mitmachen. Ich zeige dir, wie du:
Unsere Übersicht zu Gemini 4 Argon deckt Launch und Benchmarks ab, deshalb konzentriert sich dieses Tutorial auf die API. Für den größeren Modellvergleich sieh dir auch Gemini 4 Argon vs Claude Opus 5.5 und Gemini 4 Argon vs. GPT-6 Astra an.
TL;DR
Ich habe dem Agenten dieselbe Aufgabe 6-mal gegeben: 3-mal mit
mediumund 3-mal mithighals Denkstufe. Das kam dabei heraus:Argon hat die Verlangsamung in allen 6 Versuchen behoben, und ein separater Satz versteckter Tests hat das bestätigt.
Die langsame Workload fiel von etwa 2 Sekunden auf rund 3 Millisekunden.
Argon führte Benchmarks und einen Profiler aus, bevor Code geändert wurde. Gib deinem Agenten also diese Tools – zusätzlich zu Tests.
highkostete etwa das 3-Fache vonmedium(im Schnitt $0.29 vs. $0.10 pro Versuch) und schrieb 8-mal größere Diffs – für einen moderaten Extra-Speed. Starte mitmedium.Ich habe den Flaschenhals absichtlich in diese kleine App eingebaut. Die Ergebnisse beschreiben also nur diesen Fall.