

Gemini 4 Argon API คืออะไร
Gemini 4 Argon API ให้คุณเรียกใช้ gemini-4-argon โมเดลให้เหตุผลของ Google ที่สร้างมาเพื่อการเขียนโค้ดซับซ้อนและงานเอเจนต์แบบหลายขั้นตอน เปิดให้ใช้งานทั่วไปกลางตุลาคม 2026 ตาม หน้ารายละเอียดโมเดล หน้าต่างรวมสำหรับอินพุต การคิด และเอาต์พุตคือ 1,048,576 โทเคน และการตอบสนองแบบซิงโครนัสหยุดที่เอาต์พุต 65,536 โทเคน
Google ทำการทดลองคล้ายกันใน กรณีศึกษา ADK: รัน Antigravity 11 ชั่วโมงด้วย /goal บน Python Agent Development Kit (ADK) ผู้ตรวจทานเก็บ 2 จาก 6 ข้อเสนอ ลดเวลาการเตรียมเซสชันราว 40% ในเซสชันยาว ๆ และลดการ import ได้ 21% บทช่วยสอนนี้ใช้ลูป Python เล็ก ๆ แทน
คุณจะใช้คุณสมบัติ API สี่อย่าง:
-
Interactions API อินเทอร์เฟซที่ Google แนะนำสำหรับโปรเจ็กต์ใหม่ ซึ่งเก็บสถานะการสนทนาไว้บนเซิร์ฟเวอร์
-
Function calling ที่โมเดลร้องขอเครื่องมือ แล้วโค้ดของคุณตัดสินใจว่าจะรันหรือไม่
-
thinking_level:low,medium(ค่าเริ่มต้น) หรือhigh -
ออบเจ็กต์
usageที่รายงานจำนวนโทเคนอินพุต แคช เอาต์พุต และโทเคนความคิด
Argon เป็นฝ่ายขอ เครื่องของคุณเป็นฝ่ายทำงาน
โปรเจ็กต์: แอป Python ที่ช้าให้ Gemini 4 Argon แก้
เอเจนต์ได้รับโค้ด EventFlow เครื่องมือ 8 อย่าง และไม่มีคำใบ้เกี่ยวกับความช้า โค้ดฉบับเต็มอยู่บน GitHub เริ่มจาก EventFlow
EventFlow ทำงานอย่างไร
EventFlow เป็นตัวประมวลผลเหตุการณ์สมมติใน 6 โมดูลเล็ก ๆ เหตุการณ์หนึ่งเข้าที่ EventFlow.ingest(), validate() แปลงเป็น Event, และ CustomerState เก็บเรียงตามเวลาแยกรายลูกค้า จากนั้น summarize() แปลงแต่ละประวัติเป็นเซสชัน รายได้ การคืนเงิน และจำนวนหน้า และ build_report() สร้าง CustomerReport ออกมา
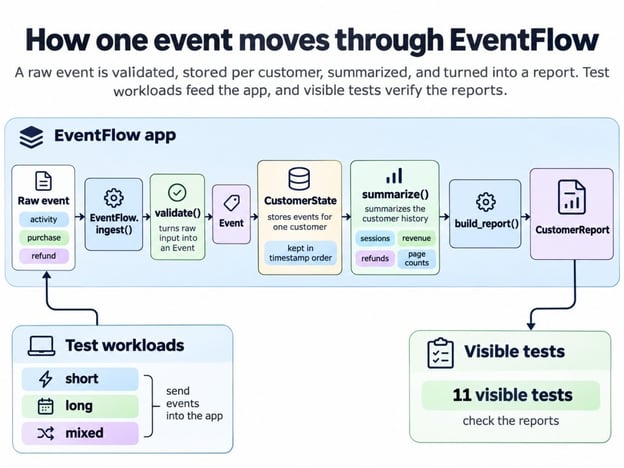
เหตุการณ์หนึ่งกลายเป็นรายงานได้อย่างไร ภาพโดยผู้เขียน
docstring ของ EventFlow กำหนดกติกาดังนี้:
-
แยกเซสชันเมื่อเว้นช่วง 30 นาที
-
การคืนเงินถูกจำกัดไม่ให้เกินยอดคงเหลือของการซื้อ
-
event_idซ้ำถูกเมิน และสำเนาแรกเป็นฝ่ายชนะ -
เหตุการณ์เรียงตามเวลา แม้จะมาจากหลายชุด
-
history()และreport()คืนออบเจ็กต์ที่ผู้เรียกเป็นเจ้าของ
การทดสอบที่ซ่อนไว้ตรวจทั้งหมด และข้อสุดท้ายจะถูกหยิบมาพูดถึงอีกครั้งภายหลัง
เหตุใด EventFlow จึงช้า
งาน 3 แบบที่สร้างจากเมล็ดสุ่มคงที่ แสดงให้เห็นว่าความยาวประวัติเปลี่ยนภาพรวมอย่างไร:
-
short: ลูกค้าจำนวนมากและมี 5 เหตุการณ์ต่อราย -
long: ลูกค้าจำนวนเล็กน้อยและมี 160 เหตุการณ์ต่อราย -
mixed: 1 ถึง 30 เหตุการณ์ต่อราย มีรายการซ้ำและเหตุการณ์มาถึงไม่เรียงลำดับ
long มีจำนวนเหตุการณ์น้อยกว่า short มาก แต่ยังใช้เวลานานกว่าประมาณ 3 เท่า กราฟนี้ตรึงจำนวนเหตุการณ์รวมไว้ที่ 1,600 รายการ โดยเพิ่มความยาวประวัติต่อลูกค้า
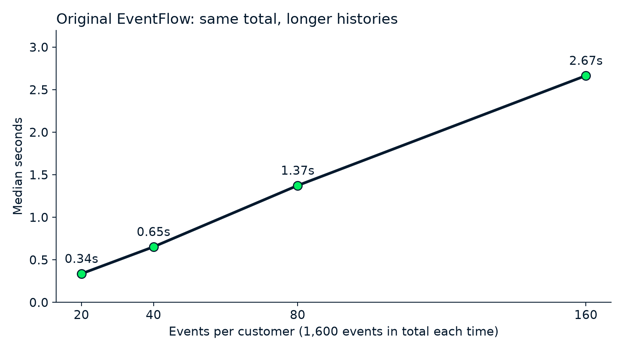
จำนวนรวมเท่าเดิม ประวัติยาวขึ้น ประมวลผลช้าลง ภาพโดยผู้เขียน
ทุกครั้งที่ความยาวประวัติเท่าตัว รันไทม์ก็เท่าตัวเช่นกัน ทั้งที่จำนวนเหตุการณ์รวมไม่เปลี่ยน รูปแบบนี้มักหมายความว่ามีขั้นตอนหนึ่งที่ทำงานซ้ำกับทั้งประวัติในทุกเหตุการณ์ใหม่ เอเจนต์ไม่เห็นสาเหตุ ดังนั้นจะเฉลยหลัง Argon ทำงานเสร็จ
เกณฑ์ความสำเร็จและการทดสอบที่ซ่อนอยู่
การแก้ไขจะนับว่าผ่านเมื่อผ่านการตรวจ 5 ข้อที่กำหนดไว้ก่อนเรียก API ครั้งแรก รายงานของโมเดลเองไม่มีน้ำหนัก โค้ดสุดท้ายของเอเจนต์ต้องทำสิ่งต่อไปนี้ครบ:
-
ทำงานเร็วขึ้นอย่างน้อย 1.5 เท่าบนงาน
long -
ทำงานช้าลงไม่เกิน 5% บนงาน
shortหรือmixed -
ผ่านชุดทดสอบที่มองเห็นได้ทั้งหมด
-
ส่งคืนรายงานเหมือนเดิมกับเวอร์ชันต้นฉบับบนทั้งสามงาน
-
ผ่านทุกกรณียอมรับที่ซ่อนไว้
เกณฑ์เหล่านี้ตั้งเอง ดังนั้นใช้เป็นตัวอย่าง เครื่องมือของเอเจนต์เข้าถึงกรณีซ่อนไม่ได้ จะรันหลังโค้ดของมันถูกแช่แข็งแล้ว โดยจะเปรียบเทียบโค้ดของเอเจนต์กับโค้ดอ้างอิงแยกต่างหากบนข้อมูลใหม่ ชุดหลัง ๆ รายการซ้ำ และกฎความเป็นเจ้าของออบเจ็กต์
ชุดทดสอบซ่อนมีประโยชน์ก็ต่อเมื่อคัดกรองวิธีแก้ที่ผิดได้ ดังนั้นควรป้อนวิธีลัดที่ผิดสองสามแบบโดยตั้งใจ สองทางลัดง่าย ๆ ที่ผ่านชุดทดสอบที่มองเห็นทั้งหมดในที่นี้คือ ตัดการ คัดลอกแบบลึก และ แคชสรุปผลโดยไม่เคยรีเฟรช ชุดกรณีซ่อนปฏิเสธทั้งคู่
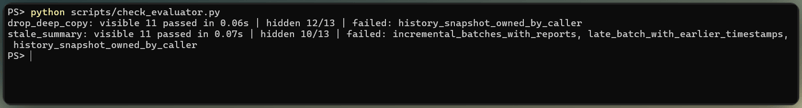
การทดสอบที่ซ่อนจับได้ว่าสองวิธีแก้ผิด ภาพโดยผู้เขียน
วิธีตั้งค่า Gemini 4 Argon API ใน Python
ต้องใช้ Python 3.10 ขึ้นไป คีย์ Gemini API และโปรเจ็กต์ Google AI Studio ที่เปิดการเรียกเก็บเงินแล้ว เพราะ หน้าราคา ไม่มี Free tier สำหรับ Argon โปรเจ็กต์นี้ตรึง SDK google-genai ที่เวอร์ชัน 2.33.0; Interactions API ต้องใช้ตั้งแต่ 2.3.0 ขึ้นไป
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envบน macOS หรือ Linux ให้เปิดใช้ สภาพแวดล้อมเสมือน ด้วย source .venv/bin/activate และคัดลอกด้วย cp จากนั้นใส่ GEMINI_API_KEY=... ในไฟล์ .env หาก GOOGLE_API_KEY ถูกตั้งไว้ในเชลล์ด้วย SDK จะใช้ตัวนั้นแทน ดังนั้นโค้ดด้านล่างจึงลบออกก่อน หากเคยใช้ Interactions API มาก่อนให้ข้ามหัวข้อถัดไป
ส่งคำขอ Gemini 4 Argon API ครั้งแรกของคุณ
คำขอแรกจะส่งส่วนบนของเอาต์พุต profiler ของ EventFlow ให้ Argon และถามว่ามันบอกอะไร load_dotenv() โหลด GEMINI_API_KEY จาก .env, genai.Client() อ่านค่า โมเดลไอดีใส่ใน client.interactions.create() และ generation_config ระบุระดับการคิด
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)ผลที่ได้กลับมาคือ:
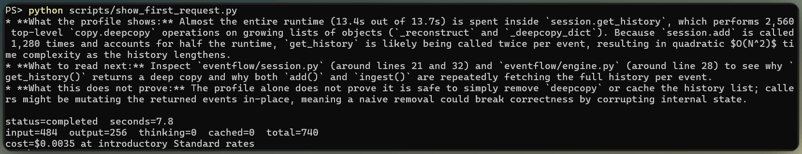
คำขอ Argon ครั้งแรกอ่านโปรไฟล์ ภาพโดยผู้เขียน
Argon เข้าใจถูก เวลาส่วนใหญ่ไปอยู่ใต้ get_history() และ copy.deepcopy ซึ่งน่าจะถูกเรียกสองครั้งต่อเหตุการณ์ บูลเล็ตข้อที่สามเตือนว่าการตัดการคัดลอกแบบลึกอาจทำให้ผู้เรียกที่แก้ไขสิ่งที่ได้รับคืนเสียหาย ซึ่งเป็นทางลัดอันแรกที่กล่าวถึงก่อนหน้านี้ คำถามแบบนี้มีต้นทุนต่ำ: ไม่ถึง 8 วินาทีและน้อยกว่าครึ่งเซ็นต์ โดยไม่มีโทเคนความคิด
medium เป็นค่าเริ่มต้น และคู่มือ latest-model ที่ลิงก์ไว้แนะนำสำหรับ "งานส่วนใหญ่ รวมถึงโค้ดซับซ้อนและเคสเอเจนต์" คู่มือเดียวกันระบุว่า temperature, top_p และ top_k ไม่ถูกใช้กับ Argon ดังนั้นไม่ต้องตั้งค่า
โปรไฟล์โค้ด Python ก่อนใช้ Gemini 4 Argon
วัดเวอร์ชันต้นฉบับก่อนที่โมเดลจะแตะ เพื่อให้ทุกตัวเลขหลังจากนั้นมีสิ่งเปรียบเทียบ วัดสามแบบ โดยให้แต่ละแบบรันในโพรเซสของตัวเอง เพราะแต่ละเครื่องมือมีผลกระทบต่อกัน:
-
จับเวลาโดยใช้
time.perf_counter()เป็นค่ามัธยฐานจากหลายโพรเซสที่เพิ่งเริ่มใหม่ โดยมีการวอร์มอัปหนึ่งครั้ง -
โปรไฟล์ด้วย
cProfileเพื่อหาว่าเวลาไปอยู่ที่ใด; มันทำให้งาน long ช้าลงประมาณ 6 เท่า จึงไม่ควรเชื่อเวลาที่จับภายใต้ profiler -
หน่วยความจำด้วย
tracemallocซึ่งรายงานยอดสูงสุดของการจัดสรรที่ Python ติดตาม ไม่ใช่หน่วยความจำของโพรเซสทั้งหมด
บนงานทั้งสาม (ไม่ใช่กราฟที่ตรึงเหตุการณ์รวม 1,600 รายการ) เวอร์ชันต้นฉบับใช้เวลาประมาณ 0.7 วินาทีบน short, 2.2 วินาทีบน long และ 1.0 วินาทีบน mixed นอกจากนี้ยังผ่านทุกการทดสอบ ที่มองเห็นได้ของ pytest
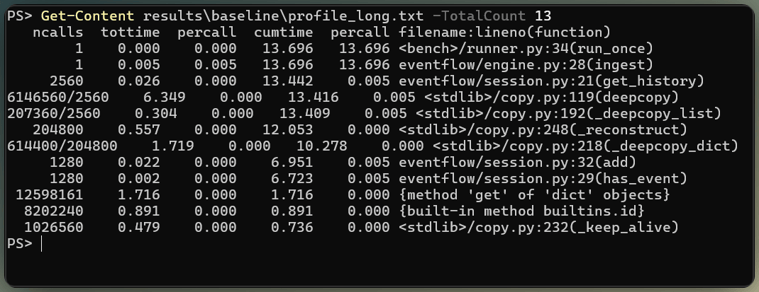
แอปที่ช้าใช้เวลาไปที่ไหน ภาพโดยผู้เขียน
คาดการณ์ความแปรผันได้: โค้ดเดียวกันภายหลังเร็วขึ้นราว 10% ดังนั้นควรจับเวลาทุกเวอร์ชันในเซสชันเดียวกัน
วิธีสร้างเอเจนต์เพิ่มประสิทธิภาพด้วย Gemini 4 Argon Function Calling
อย่างที่กล่าวไว้ Argon แค่ร้องขอเครื่องมือ โค้ด Python ที่รันเครื่องมือเรียกว่า harness และ คู่มือการออกแบบ agent harness ของเราอธิบายว่าทำไมการตรวจสอบควรอยู่ในโค้ดแทนที่จะอยู่ในพรอมต์ เครื่องมือมาก่อน เพราะกำหนดว่า Argon แตะต้องอะไรได้บ้าง
กำหนดเครื่องมือและสิทธิ์ของเอเจนต์
เครื่องมือ 8 อย่างที่กล่าวถึงเป็นฟังก์ชัน Python ที่ประกาศเป็นสคีม่า JSON ธรรมดา และมีเพียงสองตัวที่เปลี่ยนโค้ดได้:
-
list_filesและread_fileจำกัดเฉพาะซอร์ส Python ของแอป ชุดทดสอบ และฟิกซ์เจอร์ -
run_profilerและrun_benchmarkสำหรับงานที่ระบุชื่อหนึ่งงาน -
apply_patchที่แทนที่ข้อความหนึ่งตำแหน่งพอดีในไฟล์ซอร์สของแอปที่มีอยู่ -
revert_file,run_tests, และshow_diff
การประกาศทำตามรูปแบบในคู่มือ function calling ที่ลิงก์ไว้:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},สคีม่าบรรยายการเรียก แต่ไม่ได้ทำให้การเรียกปลอดภัย harness จึงเพิ่มการตรวจสอบเหล่านี้ใน Python:
- แก้เส้นทางไฟล์ให้เป็นแบบสมบูรณ์ก่อนเสมอ เส้นทางที่หนีออกนอกสำเนาแอปจะล้มเหลว
- ปฏิเสธการเขียนนอกโฟลเดอร์ซอร์สของแอป
- ไฟล์ที่ถูกแพตช์ต้องคอมไพล์ได้ มิฉะนั้นปฏิเสธแพตช์
- รันทดสอบและ benchmark ใน subprocess โดยมี timeout และไม่มีคีย์ API
นั่นยังไม่ใช่คอนเทนเนอร์ และโค้ดที่แพตช์ยังอาจอ่านไฟล์นอกสำเนาได้ ดังนั้นถือเป็นขั้นต่ำสุด
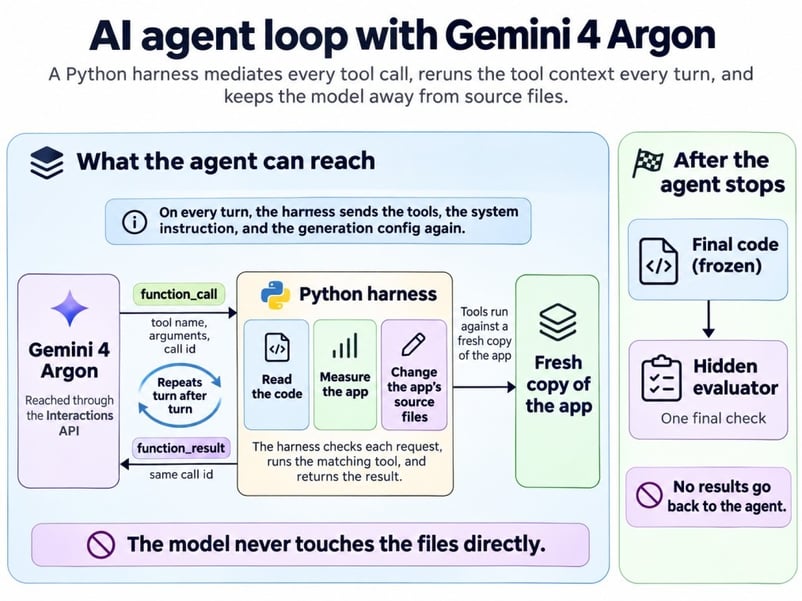
Argon ขอ Python ตัดสินใจและรัน ภาพโดยผู้เขียน
กำหนดเป้าหมายประสิทธิภาพที่วัดได้ให้เอเจนต์
system instruction ระบุเป้าหมายและกติกา โดยไม่บอกว่าความช้าอยู่ที่ไหน:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.เอเจนต์ตัดสินใจหยุดจากสิ่งที่มองเห็นได้: ชุดทดสอบที่มองเห็น ผล profiler และ benchmark และข้อจำกัดของลูปที่กำหนดถัดไป
สร้างลูปเครื่องมือของ Interactions API
ตัวอย่างด้านล่างคือแกนกลางของลูป; เวอร์ชันเต็มเพิ่ม client ตัวกระจายเครื่องมือ และขีดจำกัด แต่ละเทิร์นคือหนึ่งการเรียก client.interactions.create() และ Argon มักขอหลายเครื่องมือในหนึ่งเทิร์น ดังนั้นให้รันทุกขั้น function_call ที่ส่งกลับมา ส่งผลลัพธ์แต่ละรายการกลับไปเป็น function_result พร้อม call_id ที่ตรงกัน:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request ในคำเรียกต่อเนื่องคือบรรทัดที่คนชอบลืม previous_interaction_id พาประวัติไปด้วย แต่ tools, system_instruction และ generation_config มีขอบเขตอยู่ที่ interaction ดังนั้นเทิร์นที่ไม่มีสามอย่างนี้จะเสียเครื่องมือไปหรือกลับไปใช้ระดับการคิดค่าเริ่มต้น โค้ดจึงเก็บทั้งสามค่าไว้ในดิกตัวเดียวเพื่อกันลืม
API ไม่มีงบประมาณของงาน จึงต้องกำหนดขีดจำกัดจำนวนเทิร์น เวลา และค่าใช้จ่ายในแอปพลิเคชันก่อนเริ่ม ใช้ 40 เทิร์น 10 แพตช์ 45 นาที และ $5 ซึ่งไม่มีครั้งใดเข้าใกล้ ถึงอย่างนั้นการตรวจค่าใช้จ่ายจะรันระหว่างเทิร์น ดังนั้นเทิร์นที่ยาวอาจเกินงบได้ หน้าระบุ อัตราจำกัด ของ Google เองยังเพิ่มเพดานให้บัญชี Tier 1 ที่ $10 ต่อทุก 10 นาทีแบบกลิ้ง และส่งคืน 429 RESOURCE_EXHAUSTED เมื่อเกิน
รันเอเจนต์ Gemini 4 Argon และยืนยันการเปลี่ยนแปลง
แต่ละความพยายามเริ่มจากสำเนาแอปใหม่ เอเจนต์หยุดเองภายในประมาณ 5 นาที และโค้ดถูกแช่แข็งก่อนรันการตรวจที่ซ่อน
หาคอขวดจากหลักฐาน
Argon หาเจอด้วยการวัดก่อน นี่คือความพยายามระดับ medium ครั้งแรก แบบเทิร์นต่อเทิร์น
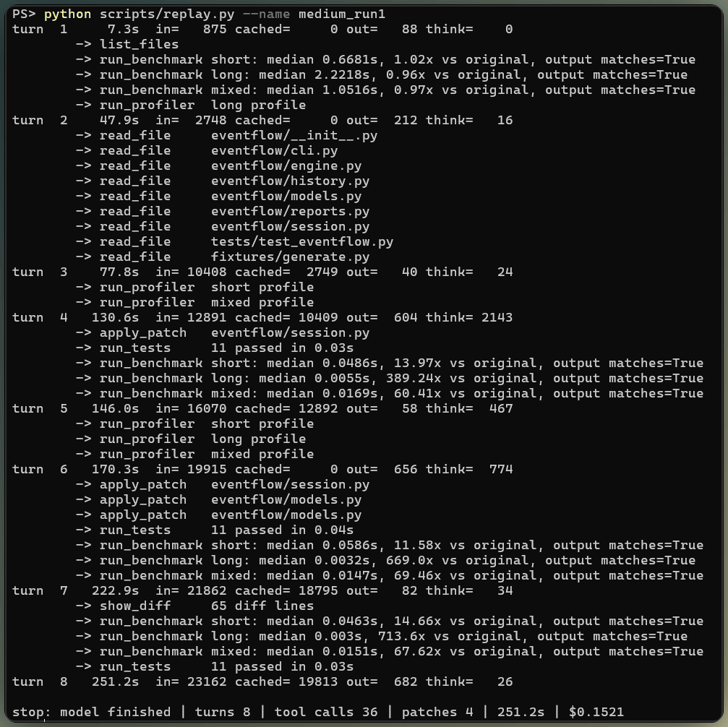
ความพยายามระดับ medium หนึ่งครั้ง แบบเทิร์นต่อเทิร์น ภาพโดยผู้เขียน
สรุปความคิด (thought summaries) ซึ่งเป็นเวอร์ชันย่อของกระบวนการให้เหตุผล แสดงให้เห็นว่าไปถึงวิธีแก้อย่างไร Argon สังเกตว่า has_event() และ add() ต่างก็เรียก get_history() จึงถามว่าการคัดลอกแบบลึก “จำเป็นจริงหรือไม่ หรือข้อกำหนดมีเพียงว่า ผู้เรียก เป็นเจ้าของข้อมูล” และตัดสินด้วย docstring ของ summarize() ซึ่งระบุว่าฟังก์ชันไม่แก้ไขอินพุตของมัน
ไม่ใช่ทุกข้ออ้างจะตั้งอยู่บนหลักฐาน สรุปเดียวกันบอกว่า “ไม่มีการเข้าถึงโดยตรงในชุดทดสอบหรือการใช้งานที่ซ่อน” ซึ่ง Argon ไม่มีทางรู้ เดาครั้งนี้ถูก แต่เป็นบรรทัดที่ควรขีดวงไว้ตอนรีวิว
วิธีแก้ที่ทั้งหกครั้งลงเอยเหมือนกัน
ทุกครั้งแกนหลักของการเปลี่ยนอยู่ที่ CustomerState และ diff ที่เล็กที่สุดแสดงได้ชัดที่สุด:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = Noneและนี่คือสาเหตุที่ฝังไว้ตามสัญญา: add() สรุปใหม่ทั้งประวัติทุกเหตุการณ์ ทุกเหตุการณ์ต้องจ่ายค่าคัดลอกแบบลึกเต็มสองครั้ง และการตรวจซ้ำใช้การสแกนลิสต์
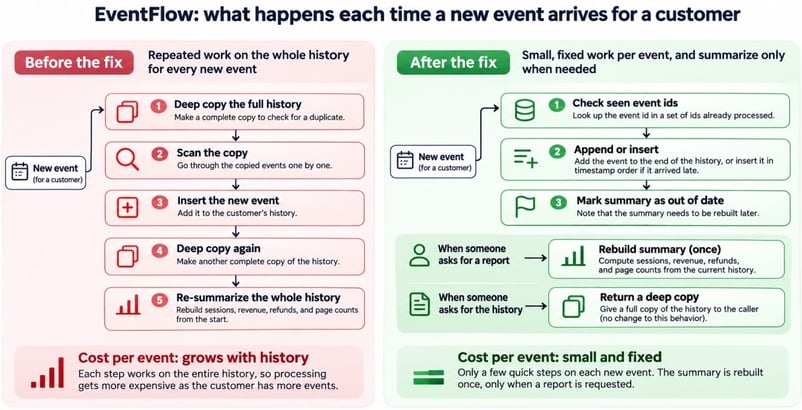
งานต่อเหตุการณ์ก่อนและหลังแก้ ภาพโดยผู้เขียน
get_history() ยังคงคัดลอกแบบลึกไว้สำหรับผู้เรียกภายนอก ซึ่งเป็นรายละเอียดที่ทางลัด “ตัด deep copy” ก่อนหน้านี้ทำผิด
ทุกชุดแพตช์ผ่านการทดสอบที่มองเห็นได้ จึงไม่ต้องย้อนกลับ แต่หลายความพยายามยังเพิ่ม setter ของ summary ที่ไม่มีใครเรียก ไม่มีใครขอ และยังต้องมีคนรีวิว
ผลการทดสอบยอมรับที่ซ่อน
ตัวประเมินที่ซ่อนรันครั้งละหนึ่งต่อความพยายาม และทุกครั้งผ่านทุกกรณี กรณีเหล่านี้เรียก ingest() หลัง report() ส่งคืนเงินก่อนการซื้อ และแก้ไขออบเจ็กต์ที่ส่งคืนเพื่อยืนยันว่าสถานะเอนจินไม่เปลี่ยน
Gemini 4 Argon ทำให้แอปเร็วขึ้นจริงไหม
ใช่ ทุกเวอร์ชันใหม่เร็วขึ้นมากและให้เอาต์พุตเหมือนเดิม ดังที่กล่าวไว้ การจับเวลาแปรผัน จึงจับเวลาต้นฉบับและเวอร์ชันใหม่ทั้ง 6 แบบสลับกัน ครั้งละ 9 โพรเซสใหม่
แต่ละครั้งครอบคลุมการ ingest และสร้างรายงานเท่านั้น ไม่รวมการเริ่มต้น Python หรือการ import ที่ระดับมิลลิวินาที การจับเวลาเพียงครั้งอาจสูงกว่ามัธยฐานมาก จึงให้เปรียบเทียบค่ามัธยฐาน กราฟสเกลลอการิทึมช่วยไม่ให้เวอร์ชันใหม่จางหายเมื่อเทียบกับต้นฉบับ
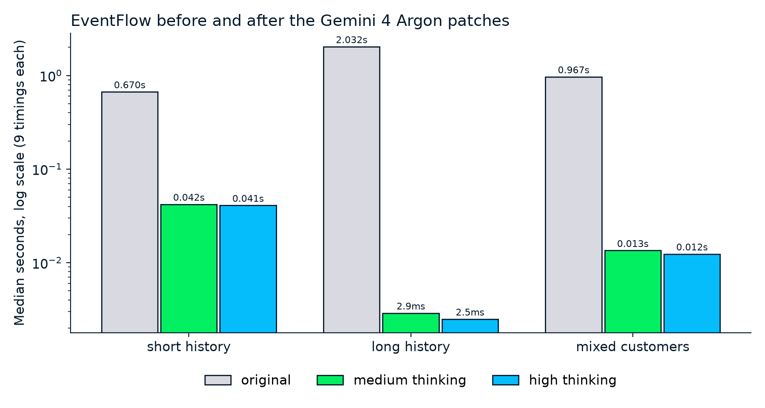
หลังแก้เป็นมิลลิวินาที ก่อนแก้เป็นวินาที เอาต์พุตเท่าเดิม ภาพโดยผู้เขียน
กราฟแสดงความพยายามครั้งแรกในแต่ละระดับ และตารางครอบคลุมทั้ง 6 ครั้ง โดยคำนวณอัตราเร่งเป็นมัธยฐานของต้นฉบับหารด้วยมัธยฐานของเวอร์ชันใหม่
|
ตัวชี้วัด |
ต้นฉบับ |
Medium (3 ครั้ง) |
High (3 ครั้ง) |
|
อัตราเร่ง |
อ้างอิง |
14.8x ถึง 15.9x |
16.3x ถึง 17.4x |
|
อัตราเร่ง |
อ้างอิง |
656x ถึง 701x |
ประมาณ 810x |
|
อัตราเร่ง |
อ้างอิง |
65.4x ถึง 71.6x |
76.8x ถึง 78.0x |
|
หน่วยความจำสูงสุดที่ติดตาม, |
7,108 KiB |
7,822 KiB |
7,822 KiB |
|
หน่วยความจำสูงสุดที่ติดตาม, |
885 KiB |
570 KiB |
569 KiB |
long ได้กำไรมากสุด เพราะงานที่ตัดออกเติบโตตามความยาวประวัติของลูกค้า แถวหน่วยความจำเป็นจุดเดียวที่มีต้นทุน short ซึ่งมีจำนวนลูกค้ามากสุด ใช้เพิ่มขึ้นราว 10% น่าจะมาจากเซ็ต ID ต่อรายลูกค้า ส่วน long ใช้น้อยลง น่าจะเพราะหยุดคัดลอก
อย่าอ่านค่า 700x ว่าเป็นสิ่งพิเศษของ Argon การตัด ลูปกำลังสอง ออกจากข้อมูลสังเคราะห์มักให้ตัวเลขแบบนี้ ไม่ว่าใครจะเป็นผู้แก้
ระดับการคิดของ Gemini 4 Argon: Medium เทียบกับ High
กับงานนี้ high เขียนโค้ดเร็วกว่า medium เล็กน้อย แต่ทั้งสองระดับหาวิธีแก้แบบเดียวกันได้ ดังนั้นความคิดที่เพิ่มขึ้นจึงไปอยู่ที่การขัดเกลา มากกว่าการวินิจฉัย
ทำให้การเปรียบเทียบยุติธรรม
เปลี่ยนเพียงระดับการคิดและไม่เปลี่ยนอย่างอื่น ทุกความพยายามใช้โค้ด พรอมต์ เครื่องมือ ขีดจำกัด และตัวประเมินเดียวกัน และไม่มีครั้งใดเห็นงานของครั้งอื่น ระดับสลับกันระดับละ 3 ครั้ง ตั้งค่าเดียวกับที่ใช้ใน บทช่วยสอน Claude Opus 5 API
ผลลัพธ์ เวลา และต้นทุนตามระดับ
สองระดับแยกกันแบบนี้ โดยเฉลี่ยต่อความพยายาม:
|
ค่าเฉลี่ยต่อครั้ง |
Medium |
High |
|
วิธีแก้ที่ยอมรับ |
3 จาก 3 |
3 จาก 3 |
|
จำนวนเรียกใช้เครื่องมือ |
28 |
35 |
|
โทเคนความคิด |
1,877 |
14,764 |
|
จำนวนบรรทัดที่เปลี่ยน |
24 |
193 |
|
เวลา |
3.4 นาที |
5 นาที |
|
ต้นทุนที่ราคาเริ่มต้น |
$0.10 |
$0.29 |
|
ต้นทุนหลังหมดช่วงราคาเริ่มต้น |
$0.20 |
$0.58 |
high เจอวิธีแก้เดียวกันตั้งแต่แพตช์แรก แล้วเดินหน้าขัดเกลาต่อ ไปเขียนทับบางส่วนของการสรุปผล การรายงาน และการตรวจสอบความถูกต้องที่ไม่ใช่คอขวดหลักแล้ว
ความเหนือกว่านี้เปลี่ยนไปตามเครื่อง และอยู่ใกล้กับสัญญาณรบกวนของการจับเวลาในงานที่จบในมิลลิวินาทีอยู่แล้ว ดังนั้นจากมุมมองเวลาตรวจโค้ด คงยังเลือก diff ที่เล็กกว่าของระดับ medium
โทเคนความคิดของระดับ High พุ่งสูงสุดในเทิร์นที่ 4 หลังจากแพตช์แรกแก้ปัญหาไปแล้ว
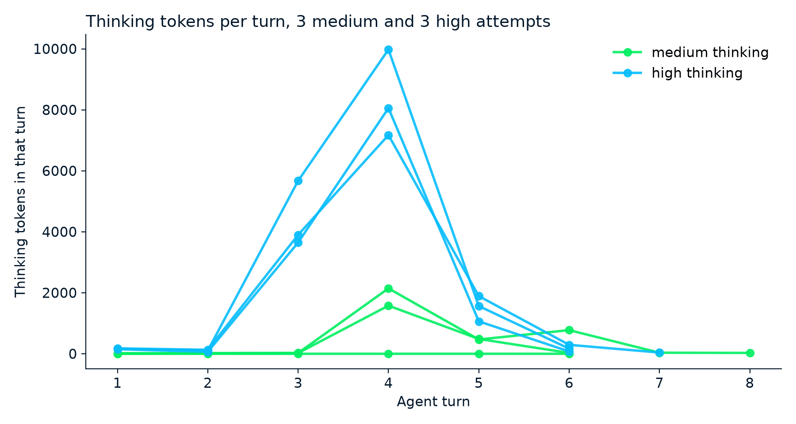
แต่ละความพยายามใช้ความคิดไปที่ไหน ภาพโดยผู้เขียน
อย่าถือเอาโทเคนความคิดเป็นสัญญาณคุณภาพ เช่นเดียวกับคำขอแรก ความพยายามระดับ medium ครั้งหนึ่งไม่ใช้เลย แต่ยังได้วิธีแก้ที่ยอมรับ เร็วและถูกที่สุดในบรรดาทุกครั้ง
การคิดราคาของเอเจนต์ ให้รวม usage ของทุกเทิร์น เพราะแต่ละเทิร์นรายงานบริบทเต็มที่ประมวลผล อินพุตส่วนใหญ่ของแต่ละเทิร์นซ้ำกับเทิร์นก่อนหน้า และแคชชุดในคิดเงินประมาณสองในสามที่อัตราแคช
ตาม คู่มือแคช แคชต้องการพรอมต์อย่างน้อย 4,096 โทเคน และเทิร์นที่เพิ่มโทเคนใหม่ไม่ถึง 2,050 จะจ่ายราคาเต็มสำหรับ 2,050 โทเคนสุดท้ายของคำขอก่อนหน้า จึงทำให้ลูปที่ผลเครื่องมือเล็กประหยัดได้น้อย ที่อัตรามาตรฐานช่วงเริ่มต้น (กล่าวถึงใน FAQs) ทั้ง 6 ครั้งรวมกันมีค่าใช้จ่าย $1.16
ข้อจำกัดของเอเจนต์เพิ่มประสิทธิภาพด้วย AI
เอเจนต์แบบนี้เหมาะกับปัญหาที่ profiler ชี้ได้ และตัวอย่างนี้ถูกสร้างให้สะอาด:
-
คอขวดถูกฝังไว้ตามที่กล่าวตั้งแต่แรก profiler ชี้ไปยังลูปกำลังสองในไฟล์เล็ก ๆ หกไฟล์ได้เกือบตรง ขณะที่ความช้าในโลกจริงมักซ่อนอยู่ใน I/O ฐานข้อมูล และโค้ดไร้เอกสาร
-
docstring ช่วยอย่างมาก Argon อ้างอิง docstring เพื่อชี้ว่าข้ามการคัดลอกใดได้บ้าง หากฐานโค้ดไร้เอกสาร ก็ไม่มีอะไรให้ยึด
-
ชุดทดสอบตรวจเฉพาะสิ่งที่มีคนคิดถึง ในกรณีศึกษา ADK ของ Google การเปลี่ยน import ครั้งหนึ่งผ่านชุดสาธารณะ แต่ยังตกในเป้าหมายทดสอบภายใน
-
การจับเวลามาจากเครื่อง Linux เล็ก ๆ เครื่องเดียวบนงานสังเคราะห์ ผลอัตราเร่งของคุณจะต่างออกไป
-
ทุกไฟล์ที่เอเจนต์อ่านจะถูกส่งไป Google ซึ่งโดยค่าเริ่มต้นเก็บปฏิสัมพันธ์แบบชำระเงินไว้ 55 วัน; ตั้งค่า
store=falseจะหยุดการเก็บ แต่ใช้previous_interaction_idไม่ได้
การ์ดโมเดล ของ Google ยังระบุถึงการจินตนาการข้อมูล (hallucination) และการหมดเวลาเป็นข้อจำกัดที่ทราบ
ข้อคิดส่งท้าย
เอเจนต์พบการสรุปซ้ำและการคัดลอกแบบลึกทั้งหกครั้ง รักษาการคัดลอกที่ผู้เรียกพึ่งพาไว้ และผ่านการตรวจที่กันออกไว้ high เพิ่มความเร็วเล็กน้อยแต่มี diff ใหญ่กว่ามาก
ไม่ขอเหมารวมผลนี้กับฐานโค้ดของคุณ เพราะคอขวดถูกฝังไว้ สิ่งที่นำไปใช้ได้คือวิธีการ: วัดก่อน ให้เครื่องมือแคบ ๆ แช่แข็งโค้ดก่อนตรวจ และให้การทดสอบที่ซ่อนไว้ตัดสินผล
ส่วนขยายแรกที่อยากสร้างคือเราต์เตอร์ที่เริ่มจาก medium และขยับไป high เฉพาะเมื่อชุดทดสอบที่มองเห็นล้มเหลว เพื่อไม่ให้กรณีที่ซ่อนย้อนกลับไปป้อนให้เอเจนต์
หากเอาต์พุต profiler ข้างบน ยังใหม่สำหรับคุณ Writing Efficient Python Code ครอบคลุมเครื่องมือการจับเวลาและโปรไฟล์แบบเดียวกับที่ใช้ก่อนให้ Argon แตะโค้ด
คำถามที่พบบ่อย
Gemini 4 Argon เร่งความเร็วโค้ด Python อัตโนมัติได้ไหม?
ไม่อัตโนมัติทั้งหมด Interactions API ยังไม่รันเครื่องมือแทนคุณ ดังนั้นโค้ดของคุณต้องทำ และในที่นี้โค้ดตรวจสอบมีขนาดเป็นสองเท่าของแอป
Gemini 4 Argon รันโค้ด Python เองได้ไหม?
ได้ ด้วยเครื่องมือรันโค้ดในตัว แต่จะหยุดหลัง 30 วินาที และติดตั้ง pytest ไม่ได้ สำหรับการทดสอบจริง ใช้เครื่องของคุณเองหรือสภาพแวดล้อมโฮสต์ใน บทช่วยสอน Managed Agents ของเรา
ควรใช้ระดับการคิดต่ำกับเอเจนต์แบบนี้ไหม?
ไม่ได้ทดสอบ และ Google ระบุว่าคุณภาพอาจลดลงในงานยาก ๆ เนื่องจากกำหนดระดับได้ทุกเทิร์น แนะนำให้ลองใช้ low สำหรับการอ่านไฟล์ และ medium สำหรับการเขียนแพตช์
Gemini 4 Argon API มีค่าใช้จ่ายเท่าไร?
จ่าย $2 ต่อหนึ่งล้านโทเคนอินพุต และ $10 ต่อหนึ่งล้านโทเคนเอาต์พุต รวมโทเคนความคิดแล้ว และราคาจะเพิ่มเป็นสองเท่าหลัง 30 พฤศจิกายน 2026 แบบ Flex มีค่าใช้จ่ายครึ่งหนึ่ง แต่แต่ละคำขออาจใช้เวลาถึง 15 นาที ซึ่งเหมาะกับการทดลองข้ามคืนมากกว่า
ใช้เอเจนต์นี้กับฐานโค้ดโปรดักชันได้ไหม?
ไม่ในรูปแบบนี้ จึงควรรันในคอนเทนเนอร์ที่ทิ้งได้ และให้คนรีวิว diff ทุกครั้ง อีกทั้งความรู้ของ Argon หยุดที่มีนาคม 2026 จึงควรให้เอกสารล่าสุดสำหรับไลบรารีใหม่ ๆ
อยากรู้ว่า Gemini 4 Argon จะทำอย่างไรกับแอป Python ที่ไม่ได้พัง แค่ช้า ชุดทดสอบทุกอันผ่าน รายงานทุกชิ้นถูกต้อง แต่บางงานใช้เวลาหลายวินาที ทั้งที่ควรใช้เวลาไม่กี่มิลลิวินาที และยิ่งลูกค้ามีประวัติมากเท่าไรยิ่งแย่ลง หลายบทเรียน AI สำหรับโค้ดเริ่มจากการทดสอบที่ล้มเหลว ทำให้โมเดลมีเป้าหมายที่ชัดเจน
แต่ที่นี่ไม่มีการทดสอบที่ล้มเหลวชี้ไปยังโค้ดที่ช้า Gemini 4 Argon เป็นโมเดลของ Google ที่เรียกใช้จาก Python ผ่าน Gemini API และจะใช้มันเพื่อสร้าง เอเจนต์ AI ซึ่งเป็นโมเดลที่ลงมือทำเพื่อบรรลุเป้าหมาย ในกรณีนี้เอเจนต์จะอ่าน วัดเวลา และแก้ไขโค้ด แต่ทำได้ผ่านเครื่องมือที่ Python ของคุณควบคุมเท่านั้น
แอปชื่อ EventFlow เป็นโปรแกรมสมมติขนาดเล็กที่แปลงกิจกรรม การซื้อ และการคืนเงินของลูกค้าให้เป็นรายงาน คำถามคือเอเจนต์จะหาจุดที่ช้าและแก้มันได้โดยไม่เปลี่ยนผลลัพธ์ที่แอปส่งคืนหรือไม่ หากคุ้นเคยกับฟังก์ชัน คลาสของ Python และการรันทดสอบ สามารถทำตามได้ และบทความนี้จะครอบคลุมวิธีการ:
บทความ ภาพรวม Gemini 4 Argon ของเราได้ครอบคลุมข้อมูลเปิดตัวและเกณฑ์ชี้วัดไว้แล้ว ดังนั้นบทช่วยสอนนี้จะเน้นที่ API สำหรับภาพรวมเชิงโมเดลที่กว้างขึ้น ดูการเปรียบเทียบ Gemini 4 Argon vs Claude Opus 5.5 และ Gemini 4 Argon vs. GPT-6 Astra ด้วย
สรุปสั้น ๆ
มอบงานเดียวกันให้เอเจนต์ 6 ครั้ง แบ่งเป็น
medium3 ครั้ง และhigh3 ครั้ง ผลที่ได้คือ:Argon แก้ปัญหาความช้าได้ทั้ง 6 ครั้ง และชุดทดสอบที่ซ่อนไว้อีกชุดยืนยันผล
งานที่ช้าลงจากประมาณ 2 วินาที เหลือราว 3 มิลลิวินาที
Argon รัน benchmark และ profiler ก่อนแก้โค้ด ดังนั้นควรให้เอเจนต์มีเครื่องมือเหล่านี้ควบคู่กับชุดทดสอบ
highมีค่าใช้จ่ายประมาณ 3 เท่าของmedium(เฉลี่ย $0.29 เทียบกับ $0.10 ต่อครั้ง) และเขียน diff ใหญ่กว่า 8 เท่าเพื่อแลกกับความเร็วที่เพิ่มขึ้นเล็กน้อย เริ่มที่mediumก่อนฝังคอขวดไว้โดยตั้งใจในแอปเล็ก ๆ เพียงตัวเดียว ดังนั้นผลลัพธ์นี้สะท้อนเพียงกรณีนี้เท่านั้น