

Gemini 4 Argon API क्या है?
Gemini 4 Argon API आपको gemini-4-argon देता है—एक Google reasoning मॉडल, जिसे जटिल कोडिंग और मल्टी-स्टेप एजेंट कार्यों के लिए बनाया गया है। यह अक्टूबर 2026 के मध्य में सामान्य उपलब्धता पर पहुँचा। the model page के अनुसार, इनपुट, थिंकिंग और आउटपुट एक ही 1,048,576-टोकन विंडो साझा करते हैं, और एक synchronous प्रतिक्रिया 65,536 आउटपुट टोकन पर रुक जाती है।
Google ने अपने ADK केस स्टडी में इसी तरह का एक प्रयोग चलाया: Python Agent Development Kit (ADK) पर /goal के साथ 11-घंटे का Antigravity रन। इसके समीक्षकों ने 6 में से 2 प्रस्ताव रखे, जिससे लंबी सेशन्स में सत्र तैयारी लगभग 40% और इम्पोर्ट्स 21% घटे। यह ट्यूटोरियल इसके बजाय एक छोटा Python लूप इस्तेमाल करता है।
आप चार API फीचर इस्तेमाल करेंगे:
-
Interactions API—नए प्रोजेक्ट्स के लिए Google का अनुशंसित इंटरफ़ेस, जो सर्वर पर वार्तालाप स्थिति रखता है
-
फ़ंक्शन कॉलिंग, जहाँ मॉडल किसी टूल का अनुरोध करता है और आपका कोड तय करता है कि उसे चलाना है या नहीं
-
thinking_level:low,medium(डिफ़ॉल्ट), याhigh -
usageऑब्जेक्ट, जो इनपुट, cached, आउटपुट और thought टोकन की रिपोर्ट करता है
Argon पूछता है, और आपका कोड काम करता है।
प्रोजेक्ट: Gemini 4 Argon के ठीक करने के लिए एक धीमा Python ऐप
एजेंट को EventFlow का कोड, 8 टूल, और सुस्ती के बारे में कोई संकेत नहीं मिलता। पूरा कोड GitHub पर है। EventFlow से शुरू करें।
EventFlow कैसे काम करता है
EventFlow छह छोटे मॉड्यूल में एक काल्पनिक इवेंट प्रोसेसर है। एक इवेंट EventFlow.ingest() में प्रवेश करता है, validate() उसे एक Event में बदलता है, और CustomerState उसे प्रत्येक ग्राहक के लिए टाइमस्टैम्प क्रम में संग्रहीत करता है। फिर summarize() प्रत्येक इतिहास को सेशन्स, रेवेन्यू, रिफंड और पेज काउंट में बदलता है, और build_report() एक CustomerReport तैयार करता है।
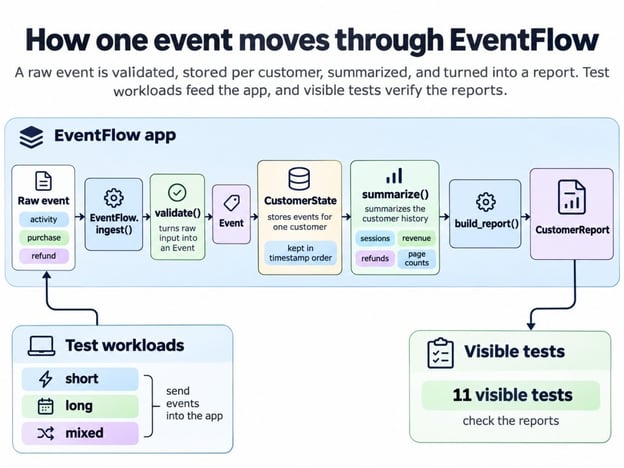
कैसे एक इवेंट रिपोर्ट बनता है। चित्र: लेखक।
EventFlow की डॉकस्ट्रिंग्स ने निम्न नियम तय किए हैं:
-
30 मिनट के गैप के बाद सेशन्स अलग हो जाते हैं
-
रिफंड्स खरीदारी में शेष राशि तक सीमित हैं
-
दोहराया गया
event_idनजरअंदाज होता है, और पहली कॉपी मान्य रहती है -
इवेंट्स टाइमस्टैम्प के अनुसार सॉर्ट होते हैं, बैच के पार भी
-
history()औरreport()ऐसे ऑब्जेक्ट लौटाते हैं जिनका स्वामित्व कॉलर के पास होता है
छिपे हुए परीक्षण इन सभी को जाँचते हैं, और आखिरी वाला आगे फिर सामने आता है।
EventFlow धीमा क्यों होता है
फिक्स्ड सीड्स से बने तीन वर्कलोड दिखाते हैं कि इतिहास की लंबाई तस्वीर कैसे बदलती है:
-
short: कई ग्राहक, प्रत्येक के 5 इवेंट -
long: कुछ ग्राहक, प्रत्येक के 160 इवेंट -
mixed: प्रति ग्राहक 1 से 30 इवेंट, डुप्लिकेट्स और ऑर्डर से बाहर आने वाले इवेंट्स सहित
long में short की तुलना में बहुत कम इवेंट हैं और फिर भी लगभग 3 गुना समय लेता है। चार्ट कुल को 1,600 इवेंट पर रखता है, जबकि प्रति ग्राहक इतिहास लंबा करता है।
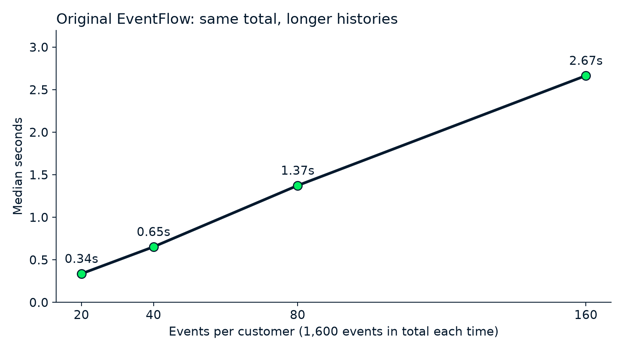
कुल समान, इतिहास लंबे, प्रोसेसिंग धीमी। चित्र: लेखक।
हर बार जब इतिहास की लंबाई दोगुनी होती है, रनटाइम भी दोगुना हो जाता है—हालाँकि कुल इवेंट्स की संख्या नहीं बदलती। यह पैटर्न अक्सर बताता है कि कोई स्टेप हर नए इवेंट पर पूरे इतिहास पर काम दोहरा रहा है। एजेंट कारण नहीं देखता, इसलिए मैं उन्हें Argon की बारी के बाद नाम दूँगा।
सफलता के मानदंड और छिपे परीक्षण
कोई सुधार तभी मानेगा जब वह पहली API कॉल से पहले सेट की गई पाँच जाँचें पास करेगा; मॉडल की खुद की रिपोर्ट का कोई महत्व नहीं। एजेंट का अंतिम कोड निम्न सभी करना चाहिए:
-
longपर कम से कम 1.5x तेज चले -
shortयाmixedपर 5% से अधिक धीमा न हो -
हर दृश्य परीक्षण पास करे
-
तीनों वर्कलोड पर मूल जैसा ही रिपोर्ट आउटपुट लौटाए
-
हर छिपे हुए स्वीकृति मामले को पास करे
ये थ्रेसहोल्ड मेरे अपने हैं, इसलिए इन्हें उदाहरण की तरह लें। एजेंट के टूल छिपे मामलों तक नहीं पहुँच सकते; वे तभी चलते हैं जब उसका कोड फ्रीज़ हो चुका होता है। वे उसके कोड की एक अलग संदर्भ इम्प्लीमेंटेशन से नई डाटा, देर से आने वाले बैच, डुप्लिकेट्स और ओनरशिप नियमों पर तुलना करते हैं।
एक छिपा सूट तभी मदद करता है जब वह गलत सुधारों को खारिज करे, इसलिए जानबूझकर कुछ फीड कराएँ। यहाँ दो आसान शॉर्टकट हर दृश्य परीक्षण पास कर लेते हैं— डीप कॉपी छोड़ना और सारांश को कैश करना लेकिन उसे कभी रिफ्रेश न करना। छिपे मामले दोनों को खारिज कर देते हैं।
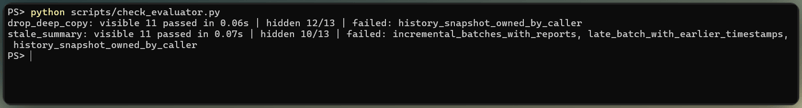
छिपे परीक्षण दो गलत सुधारों को पकड़ते हैं। चित्र: लेखक।
Python में Gemini 4 Argon API कैसे सेट करें
आपको Python 3.10 या नया, एक Gemini API कुंजी, और बिलिंग सक्षम वाला Google AI Studio प्रोजेक्ट चाहिए, क्योंकि the pricing page Argon के लिए कोई Free टियर सूचीबद्ध नहीं करता। यह प्रोजेक्ट google-genai SDK को 2.33.0 पर पिन करता है; Interactions API के लिए कम से कम 2.3.0 चाहिए।
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envmacOS या Linux पर, वर्चुअल एनवायरनमेंट को source .venv/bin/activate से सक्रिय करें और कॉपी के लिए cp का उपयोग करें, फिर GEMINI_API_KEY=... को .env में रखें। यदि GOOGLE_API_KEY भी आपके शेल में सेट है, तो SDK इसे इस्तेमाल करता है, इसलिए नीचे का कोड पहले उसे हटाता है। यदि आपने पहले Interactions API इस्तेमाल किया है, तो अगला उपखंड छोड़ दें।
अपना पहला Gemini 4 Argon API अनुरोध करें
आपका पहला अनुरोध Argon को EventFlow के प्रोफाइलर आउटपुट का शीर्ष देता है और पूछता है कि वह क्या दिखाता है। load_dotenv() .env से GEMINI_API_KEY लोड करता है, genai.Client() उसे पढ़ता है, मॉडल ID client.interactions.create() में जाती है, और generation_config सोचने का स्तर ले जाती है।
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)यह वापस आया:
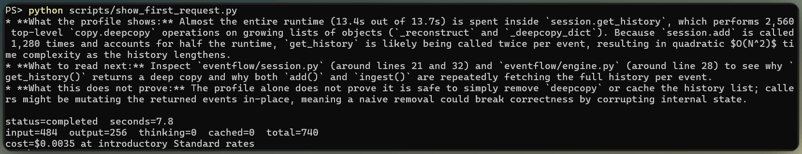
पहला Argon अनुरोध प्रोफाइल पढ़ता है। चित्र: लेखक।
Argon ने सही पकड़ा; लगभग सारा समय get_history() और copy.deepcopy के नीचे जा रहा था, शायद प्रति इवेंट दो बार कॉल हुए। उसकी तीसरी बुलेट ने चेतावनी दी कि डीप कॉपी हटाने से वे कॉलर्स टूट सकते हैं जो लौटाई गई चीज़ों को संशोधित करते हैं—जो पहले बताए गए शॉर्टकट में से पहला है। इस तरह का सवाल सस्ता है: 8 सेकंड से कम और आधे सेंट से कम, बिना किसी थिंकिंग टोकन के।
medium डिफ़ॉल्ट है, और मैंने पहले जो latest-model गाइड लिंक किया है, वह इसे "अधिकांश कार्यों के लिए, जटिल कोड और एजेंटिक उपयोग-केस सहित" सुझाव देता है। वही गाइड कहता है कि temperature, top_p और top_k Argon पर इग्नोर होते हैं, इसलिए उन्हें छोड़ दें।
Gemini 4 Argon का उपयोग करने से पहले Python कोड प्रोफाइल करें
मॉडल के छूने से पहले मूल ऐप को मापें, ताकि बाद की हर संख्या की तुलना के लिए आधार हो। तीन तरह के माप लें, प्रत्येक अपने प्रोसेस में, क्योंकि हर टूल दूसरों को स्क्यू करता है:
-
time.perf_counter()से टाइमिंग—कई नए प्रोसेसों का माध्यक, प्रत्येक में एक वार्म-अप -
cProfileसे प्रोफाइलिंग—समय कहाँ जा रहा है ढूँढने के लिए; इसने long को लगभग 6x धीमा कर दिया, इसलिए प्रोफाइलर के तहत ली गई टाइमिंग पर कभी भरोसा न करें -
tracemallocसे मेमोरी—जो कुल प्रोसेस मेमोरी के बजाय ट्रैक की गई Python अलोकेशन्स की पीक रिपोर्ट करता है
तीन वर्कलोड पर—चार्ट के फिक्स्ड 1,600 इवेंट्स के बजाय—मूल ऐप ने short पर लगभग 0.7 सेकंड, long पर 2.2, और mixed पर 1.0 लिए। इसने हर दृश्य sible pytest टेस्ट पास किया।
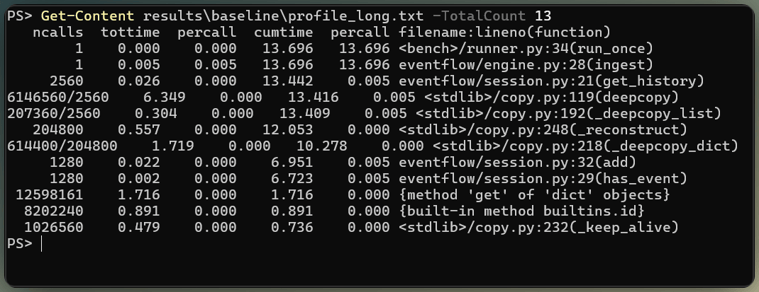
धीमे ऐप का समय कहाँ जाता है। चित्र: लेखक।
ड्रिफ्ट की अपेक्षा रखें: वही कोड बाद में लगभग 10% तेज टाइम हुआ, इसलिए हर संस्करण को एक ही सेशन में टाइम करें।
Gemini 4 Argon फ़ंक्शन कॉलिंग के साथ परफॉर्मेंस एजेंट कैसे बनाएँ
जैसा कि मैंने पहले कहा, Argon केवल टूल्स का अनुरोध करता है। उन्हें चलाने वाला Python कोड हार्नेस कहलाता है, और हमारा एजेंट हार्नेस इंजीनियरिंग गाइड समझाता है कि इसके चेक्स प्रॉम्प्ट की बजाय कोड में क्यों होने चाहिए। टूल पहले आते हैं, क्योंकि वे तय करते हैं कि Argon क्या छू सकता है।
एजेंट के टूल और अनुमतियाँ परिभाषित करें
जिन 8 टूल्स का मैंने जिक्र किया था, वे Python फ़ंक्शंस हैं जो सादे JSON स्कीमा के रूप में घोषित हैं, और उनमें से केवल दो कोड बदल सकते हैं:
-
list_filesऔरread_file, जिन्हें ऐप के Python सोर्स, टेस्ट और फ़िक्स्चर तक सीमित किया गया है -
एक नामित वर्कलोड के लिए
run_profilerऔरrun_benchmark -
apply_patch, जो ऐप के किसी सोर्स फ़ाइल में टेक्स्ट की ठीक एक घटना को बदलता है -
revert_file,run_tests, औरshow_diff
डिक्लेरेशन उसी फॉर्मेट में हैं जैसा मैंने पहले लिंक किए फ़ंक्शन-कॉलिंग गाइड में है:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},एक स्कीमा कॉल का वर्णन करता है, लेकिन कॉल को सुरक्षित नहीं बनाता। हार्नेस Python में ये जाँचें जोड़ता है:
- हर पाथ पहले resolve होता है, इसलिए कॉपी किए गए ऐप से बाहर निकलने वाला पाथ फेल होता है
- ऐप के सोर्स फोल्डर के बाहर लिखना अस्वीकार होता है
- पैच की गई फ़ाइल को अभी भी कम्पाइल होना चाहिए, नहीं तो पैच खारिज
- टेस्ट और बेंचमार्क subprocesses में टाइमआउट और बिना API कुंजी के चलते हैं
यह कंटेनर नहीं है, और पैच किया गया कोड अभी भी कॉपी के बाहर की फ़ाइलें पढ़ सकता है, इसलिए इसे न्यूनतम मानें।
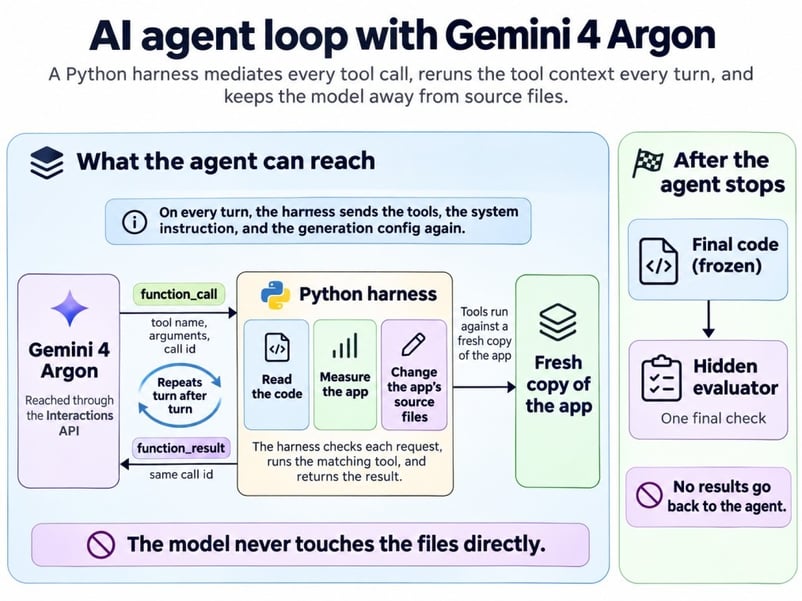
Argon पूछता है, Python तय करता है और चलाता है। चित्र: लेखक।
एजेंट को मापने योग्य प्रदर्शन लक्ष्य दें
सिस्टम निर्देश लक्ष्य और नियम बताते हैं, पर कभी नहीं कहते कि सुस्ती कहाँ है:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.एजेंट यह तय करता है कि कब रुकना है—उससे जो वह देख सकता है: दृश्य परीक्षण, प्रोफाइलर और बेंचमार्क परिणाम, और आगे लूप द्वारा सेट सीमाएँ।
Interactions API टूल लूप लागू करें
नीचे दिया स्निपेट लूप का कोर है; पूर्ण संस्करण क्लाइंट, टूल डिस्पैचर और सीमाएँ जोड़ता है। हर टर्न एक client.interactions.create() कॉल है, और Argon अक्सर एक टर्न में कई टूल्स मांगता है, इसलिए वह जो भी function_call स्टेप लौटाए, सब चलाएँ। हर नतीजा उसी call_id से मिलते function_result के रूप में वापस भेजें:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request फॉलो-अप कॉल पर वह लाइन है जो लोग छोड़ देते हैं। previous_interaction_id इतिहास ले जाता है, लेकिन tools, system_instruction और generation_config इंटरैक्शन-स्कोप्ड हैं, इसलिए इनके बिना टर्न टूल खो देता है या डिफ़ॉल्ट सोच-स्तर पर लौट आता है। मुझे यह नियम भूलना आसान लगता है, इसलिए कोड तीनों सेटिंग्स एक ही dict में रखता है।
API में टास्क बजट नहीं है, इसलिए शुरू करने से पहले अपने एप्लिकेशन में टर्न, समय और खर्च की सीमाएँ सेट करें। मैंने 40 टर्न, 10 पैच, 45 मिनट और $5 इस्तेमाल किए, और कोई प्रयास इसके करीब नहीं आया—हालाँकि खर्च की जाँच टर्न्स के बीच चलती है, इसलिए एक लंबा टर्न इसे पार कर सकता है। Google का rate-limits पेज टियर 1 खातों पर अपना कैप जोड़ता है—हर 10 मिनट की रोलिंग विंडो में $10—और इससे आगे 429 RESOURCE_EXHAUSTED देता है।
Gemini 4 Argon एजेंट चलाएँ और उसके बदलावों की पुष्टि करें
हर प्रयास ऐप की एक नई कॉपी से शुरू हुआ, लगभग 5 मिनट में खुद रुक गया, और छिपी जाँच चलने से पहले उसका कोड फ्रीज़ कर दिया गया।
सबूत से बॉटलनेक ढूँढना
Argon ने पहले मापकर बाधा ढूँढी। यहाँ पहला medium प्रयास, टर्न-बाई-टर्न:
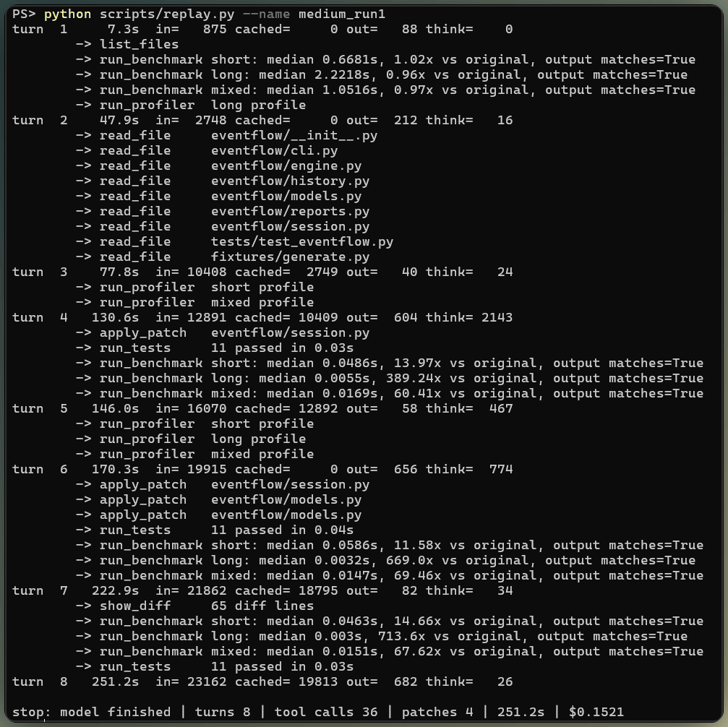
एक medium प्रयास, टर्न-दर-टर्न। चित्र: लेखक।
इसके thought summaries—हर कदम नहीं, बल्कि इसके तर्क का संक्षेप—दिखाते हैं कि यह सुधार तक कैसे पहुँचा। Argon ने नोट किया कि has_event() और add() दोनों get_history() को कॉल करते हैं। उसने पूछा कि क्या डीप कॉपी "वास्तव में यहाँ आवश्यक है, या आवश्यकता सिर्फ यह है कि कॉलर डाटा का मालिक हो," और इसे summarize() की डॉकस्ट्रिंग से सुलझाया, जो कहती है कि यह फ़ंक्शन अपने इनपुट को संशोधित नहीं करता।
हर दावा सबूत पर नहीं टिका था। वही संक्षेप कहता है कि "टेस्ट्स या छिपे उपयोगों में कोई डायरेक्ट एक्सेस नहीं है," जो Argon जान नहीं सकता था। अंदाज़ सही निकला (इस बार), लेकिन यह वह पंक्ति है जिसे समीक्षा में घेरना चाहिए।
वह सुधार जिस पर सभी छह प्रयास पहुँचे
हर प्रयास ने CustomerState में वही कोर बदलाव किया, और छह डिफ में सबसे छोटा इसे सबसे अच्छा दिखाता है:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = Noneअब वे लगाए गए कारण जिनका मैंने पहले वादा किया था: add() हर इवेंट पर पूरे इतिहास का फिर से सारांश बनाता था, हर इवेंट दो पूरी डीप कॉपी की कीमत चुकाता था, और डुप्लिकेट जाँच लिस्ट स्कैन करती थी।
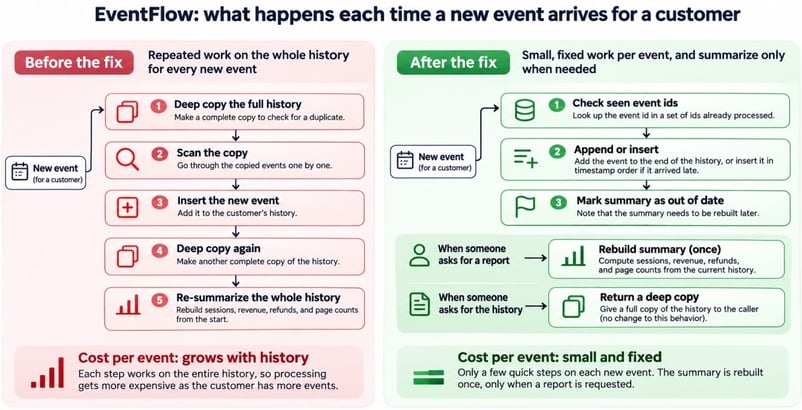
प्रति-इवेंट काम—सुधार से पहले और बाद में। चित्र: लेखक।
get_history() बाहरी कॉलर्स के लिए अपनी डीप कॉपी बनाए रखता है—यही वह डिटेल है जो डीप-कॉपी शॉर्टकट गलत कर देता है।
हर पैच राउंड ने दृश्य परीक्षण पास किए, इसलिए एजेंट को रिवर्ट नहीं करना पड़ा, पर अधिकांश प्रयासों ने एक summary सेट्टर भी जोड़ दिया जिसे कोई कॉल नहीं करता। किसी ने इसकी माँग नहीं की थी—और किसी को फिर भी इसकी समीक्षा करनी होगी।
छिपे स्वीकृति परीक्षण के परिणाम
छिपा एवाल्यूएटर प्रति प्रयास एक बार चला, और हर प्रयास हर केस पास कर गया। केस report() के बाद ingest() को कॉल करते हैं, खरीद से पहले रिफंड भेजते हैं, और लौटाए गए ऑब्जेक्ट्स को संशोधित करते हैं ताकि इंजन स्टेट जस-का-तस रहे।
क्या Gemini 4 Argon ने वाकई ऐप को तेज बनाया?
हाँ। हर नया संस्करण काफी तेज था और मूल जैसा ही आउटपुट लौटाता था। जैसा कि मैंने पहले बताया, टाइमिंग्स ड्रिफ्ट करती हैं, इसलिए मैंने मूल और सभी 6 नए संस्करणों को क्रम-बदल कर, 9 नए प्रोसेस प्रति संस्करण के साथ टाइम किया।
हर टाइमिंग में केवल ingest और रिपोर्ट्स कवर हैं—Python स्टार्टअप या इम्पोर्ट्स नहीं। कुछ मिलीसेकंड पर एक अकेली टाइमिंग माध्यक से काफी ऊपर आ सकती है, इसलिए माध्यकों की तुलना करें। चार्ट का लॉग स्केल नए संस्करणों को मूल के बगल में गायब होने से बचाता है।
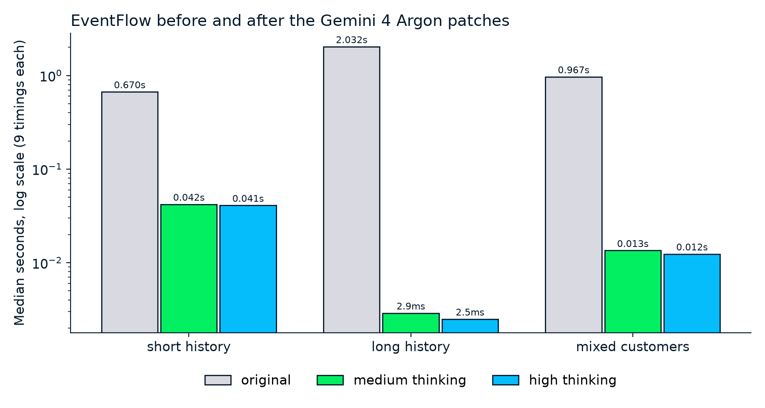
बाद में मिलीसेकंड, पहले सेकंड, आउटपुट वही। चित्र: लेखक।
चार्ट हर स्तर के पहले प्रयास को दिखाता है, और तालिका सभी 6 को कवर करती है, स्पीडअप = मूल माध्यक ÷ नए माध्यक:
|
माप |
मूल |
Medium (3 प्रयास) |
High (3 प्रयास) |
|
|
संदर्भ |
14.8x से 15.9x |
16.3x से 17.4x |
|
|
संदर्भ |
656x से 701x |
लगभग 810x |
|
|
संदर्भ |
65.4x से 71.6x |
76.8x से 78.0x |
|
पीक ट्रैक्ड मेमोरी, |
7,108 KiB |
7,822 KiB |
7,822 KiB |
|
पीक ट्रैक्ड मेमोरी, |
885 KiB |
570 KiB |
569 KiB |
long को सबसे अधिक लाभ हुआ, क्योंकि हटाया गया काम प्रत्येक ग्राहक के इतिहास के साथ बढ़ता था। मेमोरी पंक्तियाँ एकमात्र जगह हैं जहाँ सुधार की कोई कीमत है। short—सबसे अधिक ग्राहकों के साथ—लगभग 10% अधिक इस्तेमाल हुई, शायद नए प्रति-ग्राहक ID सेट की वजह से, जबकि long में कम, शायद इसलिए कि उसने कॉपी बनाना बंद कर दिया।
700x को Argon की किसी खासियत की तरह न पढ़ें। सिंथetic डाटा से quadratic लूप हटाने से ऐसे नंबर आ ही जाते हैं—किसी ने भी सुधार लिखा हो।
Gemini 4 Argon के सोचने के स्तर: Medium बनाम High
इस कार्य पर, high ने medium से थोड़ा तेज कोड लिखा, लेकिन दोनों स्तरों ने वही सुधार पाया—तो अतिरिक्त सोचने का समय निदान के बजाय पॉलिश में लगा।
तुलना को निष्पक्ष बनाए रखना
सोचने का स्तर बदलें और कुछ नहीं। हर प्रयास ने वही कोड, प्रॉम्प्ट, टूल, सीमाएँ और एवाल्यूएटर इस्तेमाल किया, और किसी ने दूसरे प्रयास का काम नहीं देखा। स्तर बारी-बारी से चले, 3 प्रयास प्रति—वही सेटअप जो मैंने अपने Claude Opus 5 API ट्यूटोरियल में इस्तेमाल किया।
परिणाम, समय, और लागत—स्तर अनुसार
दोनों स्तर इस तरह विभाजित हुए, प्रति प्रयास औसतन:
|
प्रति प्रयास औसत |
Medium |
High |
|
स्वीकृत सुधार |
3 में 3 |
3 में 3 |
|
टूल कॉल्स |
28 |
35 |
|
थिंकिंग टोकन |
1,877 |
14,764 |
|
बदली पंक्तियाँ |
24 |
193 |
|
समय |
3.4 मिनट |
5 मिनट |
|
परिचयात्मक मूल्य पर लागत |
$0.10 |
$0.29 |
|
उसके बाद की लागत |
$0.20 |
$0.58 |
high ने पहला पैच लगते ही वही सुधार हासिल कर लिया और फिर पॉलिश करता रहा। उसने समरीकरण, रिपोर्टिंग और वेलिडेशन के हिस्सों को भी फिर लिख दिया जो अब मुख्य बाधा नहीं थे।
यह बढ़त मशीन के साथ बदलती है और मिलीसेकंड में खत्म होने वाले वर्कलोड्स पर टाइमिंग नॉइज़ के करीब बैठती है, इसलिए मैं केवल समीक्षा समय के आधार पर medium का छोटा डिफ ही शिप करूँगा।
High का सोच-स्तर टर्न 4 में चरम पर था—जब उसका पहला पैच समस्या पहले ही ठीक कर चुका था।
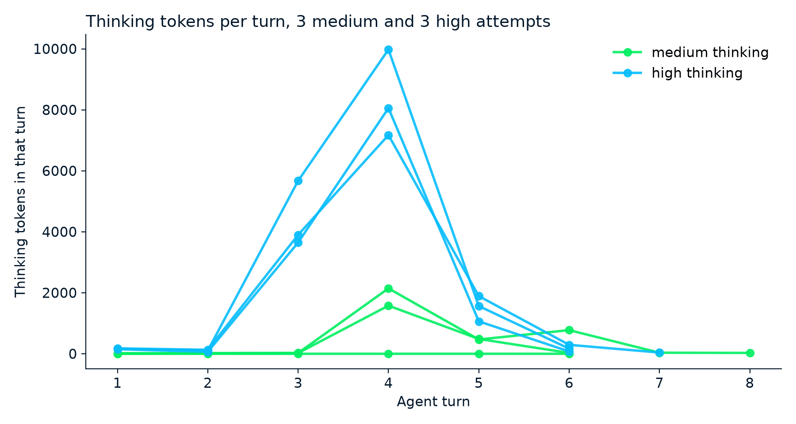
हर प्रयास ने अपना सोच-समय कहाँ खर्च किया। चित्र: लेखक।
थिंकिंग टोकन को गुणवत्ता संकेतक न मानें; पहले अनुरोध की तरह, एक medium प्रयास ने कोई थिंकिंग टोकन नहीं इस्तेमाल किया और फिर भी एक स्वीकृत सुधार पर उतरा—सबसे तेज़ और सबसे सस्ता।
किसी एजेंट की कीमत लगाने के लिए, हर टर्न के usage को जोड़ें, क्योंकि हर टर्न पूरा संदर्भ रिपोर्ट करता है जिसे उसने प्रोसेस किया। हर टर्न का अधिकतर इनपुट पिछले टर्न की पुनरावृत्ति होता है, और इम्प्लिसिट कैश ने लगभग दो-तिहाई को cached रेट पर बिल किया।
the caching guide के अनुसार, कैश के लिए कम से कम 4,096 टोकन का प्रॉम्प्ट चाहिए, और जो टर्न 2,050 से कम नए टोकन जोड़ता है, वह पिछली रिक्वेस्ट के अंतिम 2,050 पर पूरा रेट चुकाता है—तो छोटे टूल नतीजों वाले लूप्स कम बचत करते हैं। स्टैंडर्ड परिचयात्मक दरों पर, जिन्हें मैं FAQs में कवर करता हूँ, सभी 6 प्रयास मिलकर $1.16 लगे।
AI परफॉर्मेंस एजेंट की सीमाएँ
ऐसा एजेंट उन समस्याओं पर सबसे अच्छा काम करता है जिन पर प्रोफाइलर इशारा कर सकता है—और यह वाला साफ-सुथरा बनाया गया था:
-
जैसा कि मैंने शुरुआत में कहा, बाधा लगाई गई थी। प्रोफाइलर छह छोटी फ़ाइलों में एक quadratic लूप की तरफ लगभग सीधे इशारा करता है, जबकि असली सुस्तियाँ I/O, डेटाबेस और बिना-डॉक्यूमेंटेड कोड में छिपती हैं।
-
डॉकस्ट्रिंग्स ने बहुत काम किया। Argon ने यह तय करने के लिए एक पर भरोसा किया कि कौन सी कॉपी छोड़ी जा सकती है, और बिना-डॉक्यूमेंटेड कोडबेस उसे सहारा नहीं देता।
-
टेस्ट केवल वही जाँचते हैं जो किसी ने सोचा। Google की ADK केस स्टडी में, एक इम्पोर्ट बदलाव पब्लिक सूट पास कर गया और फिर भी इंटरनल टेस्ट टार्गेट्स में फेल हुआ।
-
टाइमिंग्स एक छोटे Linux मशीन और सिंथेटिक वर्कलोड्स से आती हैं, इसलिए आपकी स्पीडअप्स अलग होंगी।
-
एजेंट जो भी फ़ाइल पढ़ता है, वह Google को जाती है, जो डिफ़ॉल्ट रूप से paid-tier इंटरेक्शन्स को 55 दिनों तक स्टोर करता है;
store=falseइसे रोक देता है लेकिनprevious_interaction_idको नामुमकिन कर देता है।
Google का मॉडल कार्ड भी ज्ञात सीमाओं में hallucinations और कभी-कभी timeouts सूचीबद्ध करता है।
अंतिम बातें
एजेंट ने सभी छह प्रयासों में दोहराए गए समरी और डीप कॉपीज़ ढूँढीं, कॉलर्स पर निर्भर कॉपी को बनाए रखा, और होल्ड-आउट जाँचें पास कीं। high सोच ने थोड़ा-सा स्पीड जोड़ा और बहुत बड़ा डिफ।
मैं इसे आपके कोडबेस पर सामान्यीकृत नहीं करूँगा, क्योंकि बाधा मैंने लगाई थी। जो बात आगे भी काम आएगी, वह है तरीका: पहले मापें, टूल्स सीमित रखें, जाँचने से पहले कोड फ्रीज़ करें, और नतीजा तय करने दें छिपे परीक्षणों को।
जिस विस्तार को मैं पहले बनाऊँगा, वह है एक राउटर जो medium से शुरू करे और केवल तब high पर जाए जब दृश्य परीक्षण फेल हों—ताकि छिपे मामले कभी एजेंट में फीडबैक न बनें।
यदि ऊपर का प्रोफाइलर आउटपुट आपके लिए नया है, Writing Efficient Python Code कोर्स वही टाइमिंग और प्रोफाइलिंग टूल कवर करता है जिन्हें मैंने Argon को कोड छूने देने से पहले इस्तेमाल किया।
FAQs
क्या Gemini 4 Argon अपने-आप Python कोड तेज कर सकता है?
अपने आप नहीं। Interactions API अभी आपके लिए टूल्स नहीं चलाता, इसलिए आपका कोड यह करता है—और यहाँ जाँचने वाला कोड ऐप के दोगुने आकार का हो गया।
क्या Gemini 4 Argon खुद Python कोड चला सकता है?
हाँ, बिल्ट-इन कोड execution टूल के साथ, लेकिन यह 30 सेकंड बाद रुक जाता है और pytest इंस्टॉल नहीं कर सकता। वास्तविक परीक्षणों के लिए, अपनी मशीन का उपयोग करें या हमारे Managed Agents ट्यूटोरियल में दिए होस्टेड सेटअप का उपयोग करें।
क्या मुझे ऐसे एजेंट के लिए low सोच-स्तर उपयोग करना चाहिए?
मैंने इसे नहीं आजमाया, और Google कहता है कि कठिन कार्यों पर गुणवत्ता गिर सकती है। चूँकि आप हर टर्न पर स्तर सेट करते हैं, मैं फ़ाइलें पढ़ने के लिए low और पैच लिखने के लिए medium आज़माऊँगा।
Gemini 4 Argon API की कीमत कितनी है?
मैंने $2 प्रति मिलियन इनपुट टोकन और $10 प्रति मिलियन आउटपुट टोकन चुकाए—सोच-टोकन सहित—और ये कीमतें 30 नवंबर, 2026 के बाद दोगुनी हो जाती हैं। Flex आधी लागत का है, लेकिन हर अनुरोध 15 मिनट तक ले सकता है, जिसे मैं केवल रातभर के प्रयोगों के लिए स्वीकार करूँगा।
क्या मैं इस एजेंट को प्रोडक्शन कोडबेस पर इस्तेमाल कर सकता हूँ?
जैसा-का-तैसा नहीं, इसलिए इसे एक डिस्पोज़ेबल कंटेनर में चलाएँ और हर डिफ की किसी व्यक्ति से समीक्षा कराएँ। यह भी ध्यान रखें कि Argon का ज्ञान मार्च 2026 पर रुकता है, तो नई लाइब्रेरीज़ के लिए इसे करंट डॉक्युमेंट्स दें।

मैं एक डेटा इंजीनियर और कम्युनिटी बिल्डर हूँ, जो डेटा पाइपलाइनों, क्लाउड, और AI टूलिंग के साथ काम करता/करती हूँ, साथ ही DataCamp और उभरते डेवलपर्स के लिए व्यावहारिक, असरदार ट्यूटोरियल लिखता/लिखती हूँ।
मैं यह देखना चाहता था कि Gemini 4 Argon एक ऐसे Python ऐप के साथ क्या करता है जो टूटा नहीं है, बस धीमा है। हर परीक्षण पास होता है और हर रिपोर्ट सही होती है, लेकिन कुछ काम मिलीसेकंड में होने चाहिए जबकि सेकंड लगते हैं—और जैसे-जैसे किसी ग्राहक का इतिहास बढ़ता है, समस्या भी बढ़ती है। कई AI कोडिंग ट्यूटोरियल एक फेल होने वाले परीक्षण से शुरू होते हैं, जो मॉडल को एक सीधा लक्ष्य दे देता है।
लेकिन यहाँ, कोई फेलिng परीक्षण धीमे कोड की ओर इशारा नहीं करता। Gemini 4 Argon एक Google मॉडल है जिसे आप Gemini API के जरिए Python से कॉल करते हैं, और आप इसका उपयोग एक AI एजेंट बनाने के लिए करेंगे—एक ऐसा मॉडल जो किसी लक्ष्य की ओर क्रियाएँ करता है। इस मामले में एजेंट कोड पढ़ता, समय नापता और संपादित करता है, लेकिन केवल उन्हीं टूल्स के माध्यम से जिन्हें आपका अपना Python नियंत्रित करता है।
ऐप EventFlow है, एक छोटा काल्पनिक प्रोग्राम जो ग्राहक की गतिविधि, खरीदारी और रिफंड को रिपोर्ट में बदलता है। मेरा सवाल था कि क्या एजेंट धीमे हिस्से को ढूँढकर उसे ठीक कर सकता है—बिना इस बात को बदले कि ऐप क्या लौटाता है। यदि आप Python फ़ंक्शंस, क्लासेस और टेस्ट चलाने में सहज हैं, तो आप साथ चल सकते हैं, और मैं यह कवर करूँगा कि कैसे:
हमारा Gemini 4 Argon ओवरव्यू लॉन्च और बेंचमार्क कवर करता है, इसलिए यह ट्यूटोरियल API पर केंद्रित रहता है। व्यापक मॉडल संदर्भ के लिए, हमारे Gemini 4 Argon बनाम Claude Opus 5.5 और Gemini 4 Argon बनाम GPT-6 Astra की तुलना भी देखें।
TL;DR
मैंने एजेंट को एक ही कार्य 6 बार दिया—3 बार
mediumसोचने और 3 बारhighपर—और यह निकला:Argon ने सभी 6 प्रयासों में सुस्ती ठीक कर दी, और छिपे हुए परीक्षणों के अलग सेट ने भी सहमति जताई।
धीमा वर्कलोड लगभग 2 सेकंड से घटकर लगभग 3 मिलीसेकंड हो गया।
Argon ने कोई भी कोड बदलने से पहले बेंचमार्क और प्रोफाइलर चलाए, इसलिए अपने एजेंट को परीक्षणों के साथ वे टूल भी दें।
highकी औसत लागतmediumसे लगभग 3 गुना रही (प्रति प्रयास $0.29 बनाम $0.10), और उसने मामूली अतिरिक्त गति लाभ के लिए 8 गुना बड़े डिफ लिखे।mediumसे शुरू करें।मैंने एक छोटे ऐप में जानबूझकर बाधा डाली थी, इसलिए ये परिणाम केवल इसी मामले का वर्णन करते हैं।