

Gemini 4 Argon API là gì?
Gemini 4 Argon API cung cấp gemini-4-argon, một mô hình lập luận của Google được xây dựng cho mã hóa phức tạp và các tác vụ agent nhiều bước. Mô hình đạt trạng thái sẵn sàng chung vào giữa tháng 10 năm 2026. Theo trang mô hình, đầu vào, tư duy và đầu ra chia sẻ một cửa sổ 1.048.576 token, và phản hồi đồng bộ dừng ở 65.536 token đầu ra.
Google đã chạy một thí nghiệm tương tự trong nghiên cứu tình huống ADK: một lần chạy Antigravity 11 giờ với /goal trên Python Agent Development Kit (ADK). Người đánh giá giữ lại 2/6 đề xuất, cắt giảm thời gian chuẩn bị phiên khoảng 40% trong các phiên dài và giảm import 21%. Hướng dẫn này dùng một vòng lặp Python nhỏ thay vì vậy.
Bạn sẽ dùng bốn tính năng API:
-
Interactions API, giao diện được Google khuyến nghị cho dự án mới, giữ trạng thái hội thoại trên máy chủ
-
Function calling, nơi mô hình yêu cầu một công cụ và mã của bạn quyết định có chạy hay không
-
thinking_level:low,medium(mặc định), hoặchigh -
Đối tượng
usage, báo cáo số token đầu vào, cache, đầu ra, và tư duy
Argon hỏi, và mã của bạn thực hiện công việc.
Dự án: Một ứng dụng Python chậm để Gemini 4 Argon sửa
Agent nhận mã EventFlow, 8 công cụ, và không có gợi ý nào về chỗ chậm. Toàn bộ mã có trên GitHub. Bắt đầu với EventFlow.
EventFlow hoạt động ra sao
EventFlow là một bộ xử lý sự kiện hư cấu trong sáu mô-đun nhỏ. Một sự kiện vào EventFlow.ingest(), validate() chuyển nó thành Event, và CustomerState lưu theo thứ tự timestamp cho từng khách hàng. Sau đó summarize() chuyển mỗi lịch sử thành phiên, doanh thu, hoàn tiền, và số trang, và build_report() tạo ra một CustomerReport.
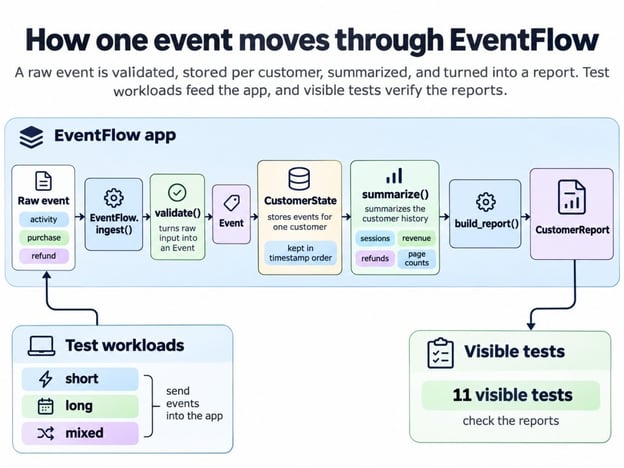
Một sự kiện trở thành báo cáo như thế nào. Ảnh của Tác giả.
Docstring của EventFlow đặt ra các quy tắc sau:
-
Phiên tách khi có khoảng dừng 30 phút
-
Hoàn tiền bị giới hạn ở phần còn lại của giao dịch mua
-
Một
event_idlặp lại bị bỏ qua, và bản đầu tiên được ưu tiên -
Sự kiện được sắp theo timestamp, kể cả qua nhiều batch
-
history()vàreport()trả về các đối tượng do caller sở hữu
Các bài test ẩn kiểm tra tất cả, và quy tắc cuối cùng sẽ quay lại sau.
Vì sao EventFlow bị chậm
Ba khối lượng công việc, dựng từ các seed cố định, cho thấy độ dài lịch sử thay đổi bức tranh thế nào:
-
short: nhiều khách hàng với 5 sự kiện mỗi người -
long: một vài khách hàng với 160 sự kiện mỗi người -
mixed: 1 đến 30 sự kiện mỗi khách, có trùng lặp và đến không theo thứ tự
long có ít sự kiện hơn nhiều so với short nhưng vẫn mất khoảng 3 lần thời gian. Biểu đồ giữ tổng ở mức 1.600 sự kiện nhưng tăng độ dài lịch sử của mỗi khách hàng.
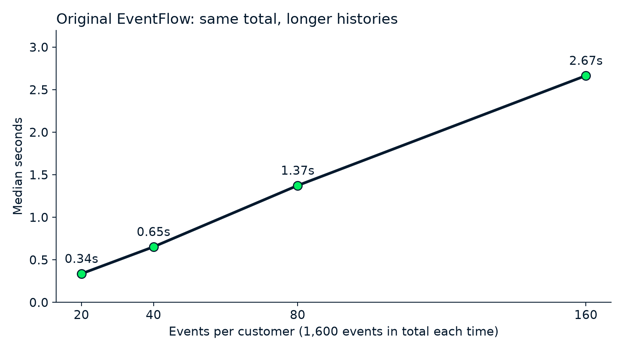
Tổng bằng nhau, lịch sử dài hơn, xử lý chậm hơn. Ảnh của Tác giả.
Mỗi lần độ dài lịch sử tăng gấp đôi, thời gian chạy cũng tăng gấp đôi, dù tổng số sự kiện không đổi. Mẫu hình này thường có nghĩa là đâu đó đang lặp lại công việc trên toàn bộ lịch sử cho mỗi sự kiện mới. Agent không nhìn thấy nguyên nhân, nên tôi sẽ nêu tên chúng sau khi Argon chạy xong.
Tiêu chí thành công và bài test ẩn
Một bản sửa chỉ được tính nếu nó vượt qua năm kiểm tra được đặt ra trước cuộc gọi API đầu tiên; báo cáo của chính mô hình không được tính điểm. Mã cuối cùng của agent phải đáp ứng tất cả điều sau:
-
Chạy nhanh hơn ít nhất 1,5 lần trên
long -
Không chậm quá 5% trên
shorthoặcmixed -
Pass mọi bài test hiển thị
-
Trả về cùng đầu ra báo cáo như bản gốc trên cả ba khối lượng công việc
-
Pass mọi ca chấp nhận ẩn
Ngưỡng này là do tôi đặt, hãy xem như ví dụ. Công cụ của agent không chạm tới các ca ẩn; chúng chỉ chạy sau khi mã của agent đã bị “đóng băng”. Chúng so sánh mã đó với một triển khai tham chiếu riêng trên dữ liệu mới, batch muộn, bản trùng lặp, và các quy tắc sở hữu.
Bộ kiểm thử ẩn chỉ hữu ích nếu nó loại được các bản sửa sai, nên hãy cố tình đưa vào vài bản. Hai đường tắt dễ dàng pass mọi test hiển thị ở đây là bỏ deep copy và cache phần tóm tắt mà không bao giờ làm mới. Các ca ẩn loại cả hai.
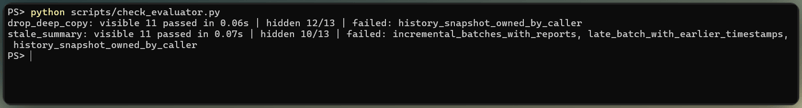
Bài test ẩn bắt được hai bản sửa sai. Ảnh của Tác giả.
Cách thiết lập Gemini 4 Argon API trong Python
Bạn cần Python 3.10 trở lên, một khóa API Gemini, và một dự án Google AI Studio có bật thanh toán, vì trang giá không liệt kê gói Miễn phí cho Argon. Dự án này gắn phiên bản SDK google-genai ở 2.33.0; Interactions API cần tối thiểu 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envTrên macOS hoặc Linux, kích hoạt môi trường ảo bằng source .venv/bin/activate và copy bằng cp, rồi đặt GEMINI_API_KEY=... vào .env. Nếu GOOGLE_API_KEY cũng được đặt trong shell, SDK sẽ dùng nó thay thế, nên đoạn mã dưới đây gỡ nó trước. Bỏ qua phần tiếp theo nếu bạn đã dùng Interactions API trước đây.
Gửi request Gemini 4 Argon API đầu tiên
Request đầu tiên đưa cho Argon phần đầu của kết quả profiler của EventFlow và hỏi nó cho thấy điều gì. load_dotenv() nạp GEMINI_API_KEY từ .env, genai.Client() đọc nó, ID mô hình được đưa vào client.interactions.create(), và generation_config mang theo mức tư duy.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Kết quả trả về như sau:
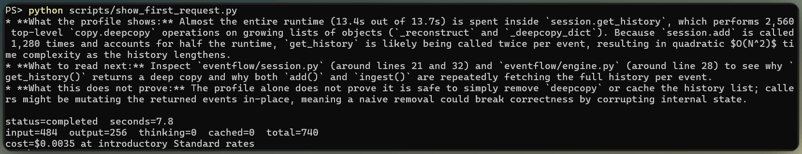
Request Argon đầu tiên đọc profile. Ảnh của Tác giả.
Argon đã hiểu đúng; gần như toàn bộ thời gian nằm dưới get_history() và copy.deepcopy, có lẽ được gọi hai lần mỗi sự kiện. Gạch đầu dòng thứ ba cảnh báo rằng bỏ deep copy có thể làm hỏng các caller chỉnh sửa dữ liệu trả về, chính là đường tắt đầu tiên tôi đã nhắc. Một câu hỏi như vậy rẻ: dưới 8 giây và ít hơn nửa xu, không dùng token tư duy.
medium là mặc định, và hướng dẫn latest-model mà tôi liên kết ở trên khuyến nghị dùng nó "cho hầu hết tác vụ, bao gồm mã phức tạp và các ca agentic." Cùng hướng dẫn nói temperature, top_p, và top_k bị bỏ qua trên Argon, nên đừng đưa vào.
Profile mã Python trước khi dùng Gemini 4 Argon
Hãy đo ứng dụng gốc trước khi mô hình chạm vào, để mọi con số về sau có cái đối chiếu. Lấy ba loại phép đo, mỗi loại trong một tiến trình riêng, vì mỗi công cụ sẽ làm sai lệch công cụ khác:
-
Đo thời gian bằng
time.perf_counter(), lấy trung vị của nhiều tiến trình mới, mỗi tiến trình có một lần làm ấm -
Gắn profiler bằng
cProfileđể tìm thời gian đi đâu; nó làmlongchậm hơn khoảng 6 lần, nên đừng tin số đo thời gian lấy dưới profiler -
Bộ nhớ bằng
tracemalloc, báo cáo đỉnh cấp phát Python được theo dõi thay vì tổng bộ nhớ tiến trình
Trên ba khối lượng công việc, thay vì tổng cố định 1.600 sự kiện của biểu đồ, bản gốc mất khoảng 0,7 giây với short, 2,2 với long, và 1,0 với mixed. Nó cũng pass mọi bài pytest hiển thị pytest test.
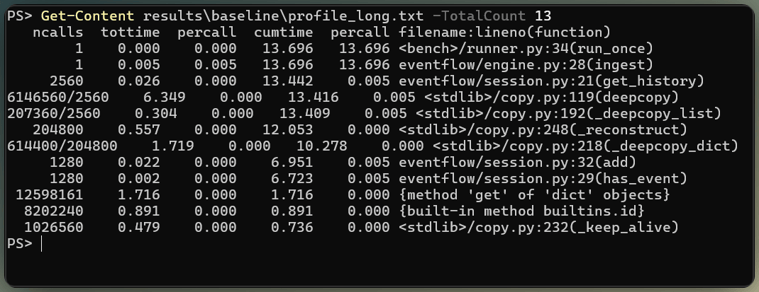
Ứng dụng chậm dành thời gian ở đâu. Ảnh của Tác giả.
Hãy kỳ vọng có độ trôi: cùng đoạn mã sau này đo nhanh hơn khoảng 10%, vì vậy hãy đo mọi phiên bản trong cùng một phiên làm việc.
Cách xây dựng một performance agent với Function Calling của Gemini 4 Argon
Như tôi đã nói, Argon chỉ yêu cầu công cụ. Đoạn mã Python chạy các công cụ được gọi là harness, và hướng dẫn kỹ thuật agent harness của chúng tôi giải thích vì sao các kiểm tra nên nằm trong mã thay vì prompt. Các công cụ là phần đầu, vì chúng quyết định Argon có thể chạm vào gì.
Định nghĩa công cụ và quyền của agent
8 công cụ tôi đã nhắc là các hàm Python được khai báo bằng schema JSON thuần, và chỉ có hai trong số đó có thể thay đổi mã:
-
list_filesvàread_file, giới hạn ở mã nguồn Python của ứng dụng, test, và fixture -
run_profilervàrun_benchmarkcho một khối lượng công việc được đặt tên -
apply_patch, thay thế đúng một lần xuất hiện của đoạn văn bản trong một tệp mã nguồn ứng dụng hiện có -
revert_file,run_tests, vàshow_diff
Khai báo theo định dạng trong hướng dẫn function calling mà tôi đã liên kết ở trên:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Schema mô tả lời gọi, nhưng không làm cho lời gọi an toàn. Harness bổ sung các kiểm tra sau trong Python:
- Mọi đường dẫn được chuẩn hóa trước, nên đường dẫn thoát khỏi bản sao ứng dụng sẽ thất bại
- Từ chối ghi ngoài thư mục mã nguồn của ứng dụng
- Tệp đã patch phải vẫn biên dịch được, nếu không patch bị từ chối
- Test và benchmark chạy trong subprocess có timeout và không có khóa API
Đó không phải là container, và mã đã patch vẫn có thể đọc tệp ngoài bản sao, nên coi đây là mức tối thiểu.
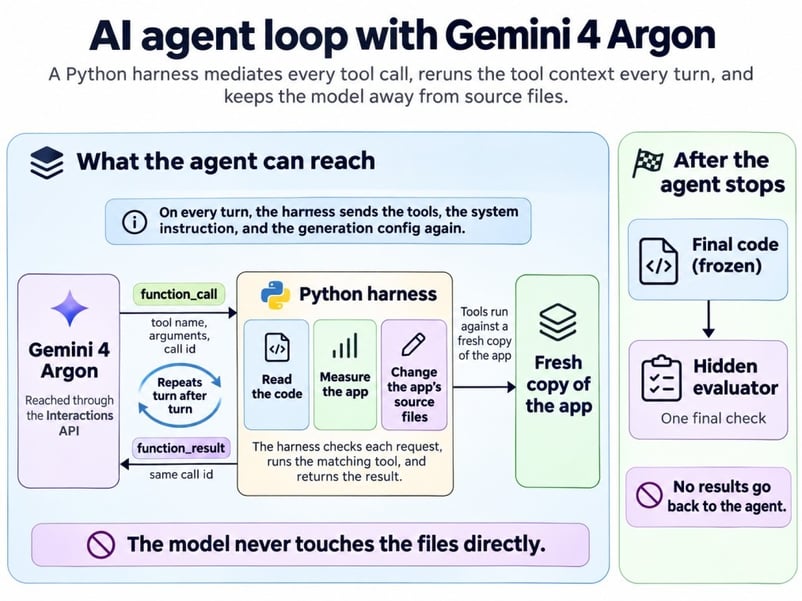
Argon yêu cầu, Python quyết định và chạy. Ảnh của Tác giả.
Đặt mục tiêu hiệu năng có thể đo lường cho agent
System instruction nêu mục tiêu và quy tắc nhưng không nói chỗ nào chậm:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Agent tự quyết định khi nào dừng dựa trên những gì nó nhìn thấy: test hiển thị, kết quả profiler và benchmark, và các giới hạn mà vòng lặp đặt tiếp theo.
Triển khai vòng lặp công cụ Interactions API
Đoạn trích dưới đây là lõi của vòng lặp; phiên bản đầy đủ bổ sung client, bộ phân phối công cụ, và giới hạn. Mỗi lượt là một lần gọi client.interactions.create(), và Argon thường yêu cầu nhiều công cụ trong một lượt, nên hãy chạy mọi bước function_call mà nó trả về. Gửi từng kết quả lại dưới dạng function_result với call_id khớp tương ứng:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)Dòng **request trong lần gọi tiếp theo là thứ mọi người hay bỏ sót. previous_interaction_id mang lịch sử, nhưng tools, system_instruction, và generation_config chỉ nằm trong phạm vi tương tác, nên một lượt thiếu chúng sẽ mất công cụ hoặc rơi về mức tư duy mặc định. Tôi thấy quy tắc này dễ quên, nên mã giữ cả ba thiết lập trong một dict.
API không có ngân sách nhiệm vụ, nên hãy đặt giới hạn lượt, thời gian, và chi tiêu trong ứng dụng của bạn trước khi bắt đầu. Tôi dùng 40 lượt, 10 patch, 45 phút, và $5, và không lần thử nào đến gần, dù kiểm tra chi tiêu chạy giữa các lượt, nên một lượt dài có thể vượt quá. Trang rate limits của Google cũng áp trần riêng cho tài khoản Tier 1, $10 mỗi 10 phút cuốn chiếu, và trả về 429 RESOURCE_EXHAUSTED khi vượt.
Chạy agent Gemini 4 Argon và xác minh thay đổi
Mỗi lần thử bắt đầu từ một bản sao mới của ứng dụng, tự dừng trong khoảng 5 phút, và mã được đóng băng trước khi bất kỳ kiểm tra ẩn nào chạy.
Tìm nút thắt cổ chai từ bằng chứng
Argon tìm nút thắt bằng cách đo trước. Đây là lần thử mức medium đầu tiên, theo từng lượt.
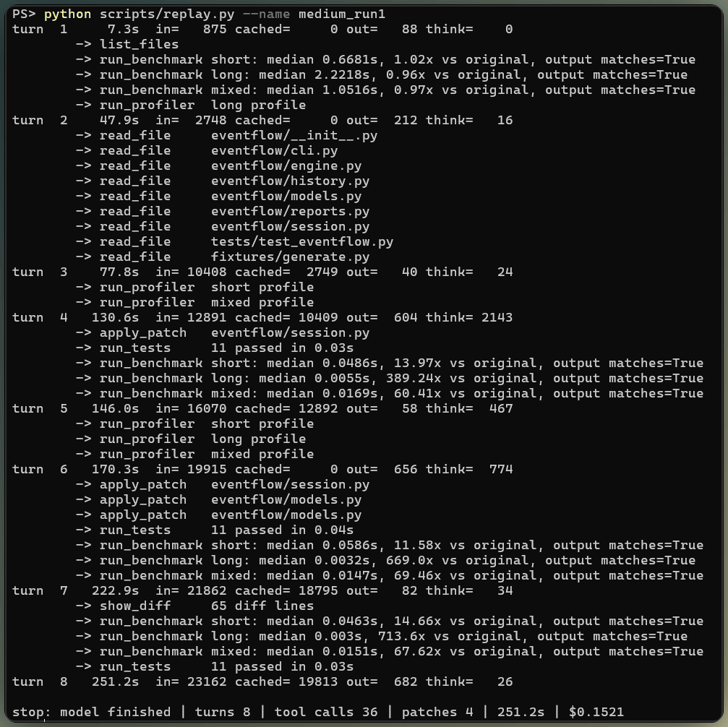
Một lần thử medium, theo từng lượt. Ảnh của Tác giả.
Các bản tóm tắt suy nghĩ của nó, phiên bản cô đọng của quá trình lập luận thay vì mọi bước, cho thấy cách nó đi đến bản sửa. Argon nhận ra has_event() và add() đều gọi get_history(). Nó hỏi liệu deep copy có "thực sự cần thiết ở đây, hay chỉ cần caller sở hữu dữ liệu," và giải quyết bằng docstring của summarize(), trong đó nói hàm không chỉnh sửa đầu vào.
Không phải mọi nhận định đều dựa trên bằng chứng. Cùng bản tóm tắt nói rằng "không có truy cập trực tiếp trong test hoặc sử dụng ẩn," điều mà Argon không thể biết. Phỏng đoán này đúng (lần này), nhưng đó là kiểu câu cần khoanh tròn khi review.
Bản sửa mà cả sáu lần thử đều đi tới
Mỗi lần thử đều thực hiện cùng thay đổi cốt lõi với CustomerState, và diff nhỏ nhất trong sáu diff cho thấy rõ nhất:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneGiờ tới các nguyên nhân tôi đã hứa: add() tóm tắt lại toàn bộ lịch sử cho mỗi sự kiện, mỗi sự kiện phải trả giá cho hai lần deep copy đầy đủ, và kiểm tra trùng lặp quét toàn bộ danh sách.
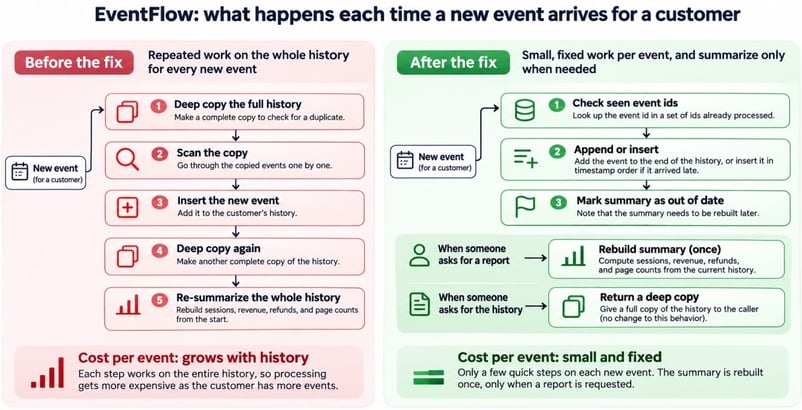
Khối lượng công việc mỗi sự kiện trước và sau bản sửa. Ảnh của Tác giả.
get_history() vẫn giữ deep copy cho caller bên ngoài, chi tiết mà đường tắt bỏ deep copy ở trên làm sai.
Mỗi lượt patch đều pass các test hiển thị, nên agent không phải revert, nhưng hầu hết lần thử cũng thêm một setter summary mà không ai gọi. Không ai yêu cầu, và vẫn cần người review.
Kết quả bài test chấp nhận ẩn
Bộ đánh giá ẩn chạy một lần cho mỗi lần thử, và mọi lần thử đều pass mọi ca. Các ca gọi ingest() sau report(), gửi hoàn tiền trước khi mua hàng, và chỉnh sửa đối tượng trả về để xác nhận trạng thái engine không đổi.
Gemini 4 Argon có thực sự làm ứng dụng nhanh hơn không?
Có. Mọi phiên bản mới đều nhanh hơn nhiều và trả về cùng đầu ra như bản gốc. Như tôi đã nói, thời gian đo có độ trôi, nên tôi đo xen kẽ bản gốc và cả 6 phiên bản mới, mỗi cái 9 tiến trình mới.
Mỗi phép đo chỉ bao gồm ingest và tạo báo cáo, không tính khởi động Python hay import. Ở mức vài mili giây, một lần đo đơn lẻ có thể nằm cao hơn trung vị, nên hãy so sánh trung vị. Thang log của biểu đồ giúp các phiên bản mới không bị “biến mất” bên cạnh bản gốc.
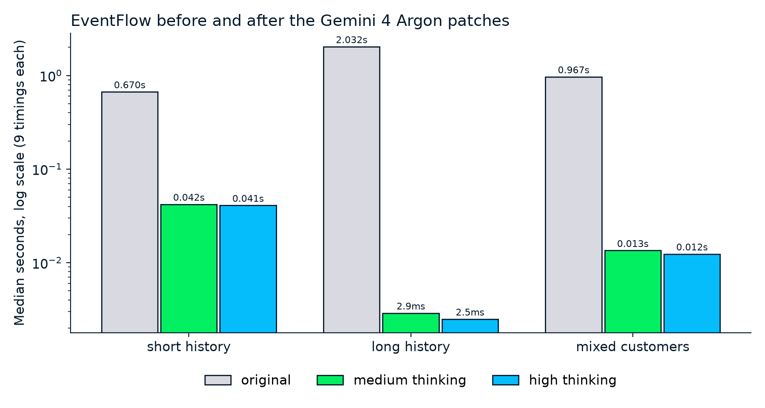
Sau sửa còn mili giây, trước sửa là giây, đầu ra như nhau. Ảnh của Tác giả.
Biểu đồ hiển thị lần thử đầu tiên ở mỗi mức, và bảng bao phủ cả 6, với hệ số tăng tốc là trung vị bản gốc chia cho trung vị bản mới:
|
Chỉ số |
Bản gốc |
Medium (3 lần thử) |
High (3 lần thử) |
|
Tăng tốc |
Tham chiếu |
14,8x đến 15,9x |
16,3x đến 17,4x |
|
Tăng tốc |
Tham chiếu |
656x đến 701x |
khoảng 810x |
|
Tăng tốc |
Tham chiếu |
65,4x đến 71,6x |
76,8x đến 78,0x |
|
Đỉnh bộ nhớ được theo dõi, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Đỉnh bộ nhớ được theo dõi, |
885 KiB |
570 KiB |
569 KiB |
long hưởng lợi nhiều nhất, vì phần công việc bị loại bỏ tăng theo độ dài lịch sử của mỗi khách. Hai hàng bộ nhớ là nơi duy nhất bản sửa phải trả giá. short, có nhiều khách nhất, dùng nhiều hơn khoảng 10%, có lẽ do set ID theo khách mới, trong khi long dùng ít hơn, có thể vì ngừng tạo bản sao.
Đừng hiểu 700x là điều gì đặc biệt về Argon. Bỏ một vòng lặp bậc hai khỏi dữ liệu tổng hợp thường tạo ra những con số như thế này, bất kể ai viết bản sửa.
Mức độ tư duy của Gemini 4 Argon: Medium vs. High
Với tác vụ này, high viết mã nhanh hơn một chút so với medium, nhưng cả hai cùng tìm ra bản sửa, nên phần tư duy thêm đi vào việc “đánh bóng” hơn là chẩn đoán.
Giữ so sánh công bằng
Chỉ thay mức tư duy và không thay gì khác. Mỗi lần thử dùng cùng đoạn mã, prompt, công cụ, giới hạn, và bộ đánh giá, và không lần nào thấy công việc của lần khác. Các mức luân phiên, 3 lần mỗi mức, cùng thiết lập như tôi dùng trong hướng dẫn API Claude Opus 5.
Kết quả, thời gian, và chi phí theo mức
Hai mức tách ra như sau, trung bình mỗi lần thử:
|
Trung bình mỗi lần thử |
Medium |
High |
|
Bản sửa được chấp nhận |
3/3 |
3/3 |
|
Lần gọi công cụ |
28 |
35 |
|
Token tư duy |
1.877 |
14.764 |
|
Số dòng thay đổi |
24 |
193 |
|
Thời gian |
3,4 phút |
5 phút |
|
Chi phí ở mức giá mở đầu |
$0,10 |
$0,29 |
|
Chi phí sau khi giá đó kết thúc |
$0,20 |
$0,58 |
high đạt cùng bản sửa ngay ở patch đầu tiên rồi tiếp tục đánh bóng. Nó viết lại một phần của tóm tắt, báo cáo, và xác thực vốn không còn là nút thắt chính.
Khoảng cách này thay đổi theo máy và nằm gần nhiễu đo thời gian trên các khối lượng vốn đã hoàn thành trong vài mili giây, nên tôi vẫn sẽ chọn bản diff nhỏ của medium chỉ riêng vì thời gian review.
Token tư duy của High đạt đỉnh ở lượt 4, sau khi patch đầu tiên đã sửa xong vấn đề.
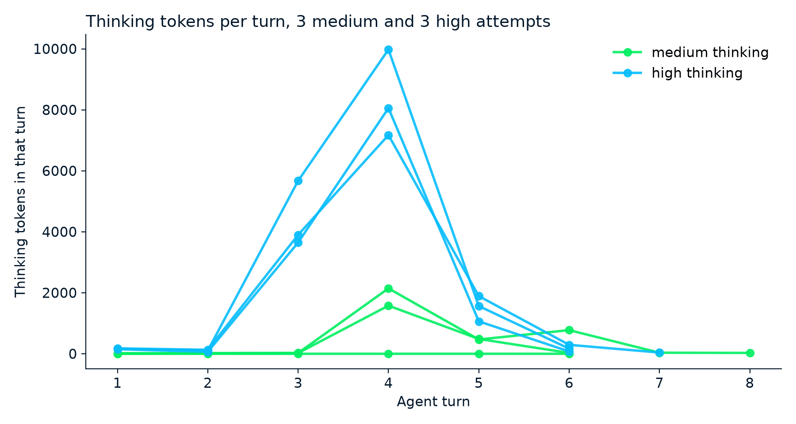
Mỗi lần thử dùng tư duy vào đâu. Ảnh của Tác giả.
Đừng coi token tư duy là tín hiệu chất lượng; giống request đầu tiên, một lần thử medium không dùng token tư duy nào vẫn đưa ra bản sửa được chấp nhận, nhanh và rẻ hơn bất kỳ lần thử nào khác.
Để tính giá một agent, hãy cộng usage của mọi lượt, vì mỗi lượt báo cáo toàn bộ ngữ cảnh nó đã xử lý. Phần lớn đầu vào của mỗi lượt lặp lại lượt trước, và cache ngầm tính khoảng hai phần ba ở mức giá cache.
Theo hướng dẫn cache, cache cần prompt ít nhất 4.096 token, và một lượt thêm ít hơn 2.050 token mới sẽ trả mức giá đầy đủ cho 2.050 token cuối của request trước, nên các vòng lặp có kết quả công cụ rất nhỏ sẽ tiết kiệm ít. Ở mức giá Standard mở đầu, mà tôi đề cập trong FAQs, tổng chi phí cho cả 6 lần thử là $1,16.
Hạn chế của một AI performance agent
Một agent như thế này hoạt động tốt nhất với vấn đề mà profiler có thể chỉ ra, và trường hợp này được xây dựng để sạch:
-
Nút thắt được cài đặt sẵn, như tôi đã nói từ đầu. Profiler gần như chỉ thẳng vào một vòng lặp bậc hai trong sáu tệp nhỏ, trong khi chậm thực tế ẩn trong I/O, cơ sở dữ liệu, và mã không có tài liệu.
-
Docstring làm rất nhiều việc. Argon dựa vào một docstring để quyết định bỏ bản copy nào, và một codebase không có tài liệu sẽ không có chỗ dựa.
-
Test chỉ kiểm tra những gì ai đó đã nghĩ tới. Trong nghiên cứu ADK của Google, một thay đổi import pass bộ test công khai nhưng vẫn fail các mục tiêu test nội bộ.
-
Thời gian đo đến từ một máy Linux nhỏ trên dữ liệu tổng hợp, nên mức tăng tốc của bạn sẽ khác.
-
Mọi tệp agent đọc đều được gửi tới Google, nơi lưu trữ tương tác gói trả phí trong 55 ngày theo mặc định;
store=falsedừng điều đó nhưng loại trừprevious_interaction_id.
Thẻ mô hình của Google model card cũng liệt kê ảo giác và đôi khi timeout là các hạn chế đã biết.
Kết luận
Agent tìm ra việc tóm tắt lặp lại và deep copy trong cả sáu lần thử, giữ lại bản copy mà caller cần, và pass các kiểm tra giữ lại. high thêm một chút tốc độ và một diff lớn hơn nhiều.
Tôi sẽ không khái quát điều đó cho codebase của bạn, vì nút thắt là do tôi cài đặt. Điều có thể mang theo là phương pháp: đo trước, giữ công cụ hẹp, đóng băng mã trước khi kiểm tra, và để các bài test ẩn quyết định kết quả.
Phần mở rộng tôi sẽ xây đầu tiên là một bộ định tuyến bắt đầu ở mức medium và chỉ chuyển sang high khi test hiển thị thất bại, để các ca ẩn không bao giờ phản hồi ngược vào agent.
Nếu đầu ra profiler ở trên còn mới với bạn, Writing Efficient Python Code bao qu quát các công cụ đo thời gian và profiler mà tôi dùng trước khi để Argon chạm vào mã.
Câu hỏi thường gặp (FAQs)
Gemini 4 Argon có thể tự động tăng tốc mã Python không?
Không tự động. Interactions API hiện chưa chạy công cụ giúp bạn, nên mã của bạn phải làm việc đó, và ở đây phần mã kiểm tra còn lớn gấp đôi ứng dụng.
Gemini 4 Argon có thể tự chạy mã Python không?
Có, với công cụ thực thi mã tích hợp, nhưng nó dừng sau 30 giây và không thể cài pytest. Để chạy test thật, hãy dùng máy của bạn hoặc môi trường host trong hướng dẫn Managed Agents của chúng tôi.
Tôi có nên dùng mức tư duy low cho một agent như thế này không?
Tôi chưa thử, và Google nói chất lượng có thể giảm trên tác vụ khó. Vì bạn đặt mức cho mỗi lượt, tôi sẽ thử low khi đọc tệp và medium khi viết patch.
Gemini 4 Argon API tốn bao nhiêu?
Tôi trả $2 mỗi triệu token đầu vào và $10 mỗi triệu token đầu ra, bao gồm tư duy, và các mức giá đó sẽ tăng gấp đôi sau ngày 30/11/2026. Gói Flex rẻ bằng một nửa, nhưng mỗi request có thể mất tới 15 phút, điều tôi chỉ chấp nhận cho các thí nghiệm qua đêm.
Tôi có thể dùng agent này trên codebase production không?
Không như viết ở đây, nên hãy chạy trong container dùng một lần và để người thật review mọi diff. Cũng lưu ý rằng kiến thức của Argon dừng ở tháng 3/2026, nên hãy cung cấp tài liệu hiện tại cho các thư viện mới hơn.

Tôi là một kỹ sư dữ liệu và người xây dựng cộng đồng, làm việc với pipeline dữ liệu, đám mây và công cụ AI, đồng thời viết các hướng dẫn thực hành, tác động cao cho DataCamp và các nhà phát triển mới nổi.


Tôi muốn xem Gemini 4 Argon xử lý thế nào với một ứng dụng Python không hỏng, chỉ là chậm. Mọi bài kiểm thử đều pass và mọi báo cáo đều đúng, nhưng một số tác vụ mất hàng giây trong khi lẽ ra chỉ vài mili giây, và càng tệ hơn khi khách hàng có nhiều lịch sử hơn. Nhiều hướng dẫn mã hóa bằng AI bắt đầu từ một bài test thất bại, như vậy mô hình có ngay mục tiêu rõ ràng.
Nhưng ở đây, không có bài kiểm thử thất bại nào chỉ ra đoạn mã chậm. Gemini 4 Argon là một mô hình của Google bạn gọi từ Python qua Gemini API, và bạn sẽ dùng nó để xây dựng một agent AI, tức là một mô hình thực hiện hành động hướng tới mục tiêu. Trong trường hợp này agent đọc, đo thời gian, và chỉnh sửa mã, nhưng chỉ thông qua các công cụ do chính Python của bạn kiểm soát.
Ứng dụng là EventFlow, một chương trình nhỏ hư cấu chuyển hoạt động, mua hàng, và hoàn tiền của khách thành báo cáo. Câu hỏi của tôi là liệu agent có thể tìm ra phần chậm và sửa nó mà không làm thay đổi kết quả ứng dụng trả về hay không. Nếu bạn quen với hàm, lớp trong Python và chạy test, bạn có thể làm theo, và tôi sẽ trình bày cách:
Bài tổng quan về Gemini 4 Argon của chúng tôi đề cập tới ra mắt và điểm chuẩn, nên hướng dẫn này chỉ tập trung vào API. Để có cái nhìn rộng hơn về mô hình, hãy xem thêm so sánh Gemini 4 Argon vs Claude Opus 5.5 và Gemini 4 Argon vs. GPT-6 Astra.
Tóm tắt
Tôi giao cho agent cùng một nhiệm vụ 6 lần, 3 lần ở mức
mediumvà 3 lần ở mứchigh, và kết quả như sau:Argon sửa được chỗ chậm trong cả 6 lần thử, và một bộ test ẩn riêng biệt đồng ý với kết quả.
Khối lượng công việc chậm giảm từ khoảng 2 giây xuống khoảng 3 mili giây.
Argon chạy benchmark và profiler trước khi thay đổi bất kỳ dòng mã nào, vì vậy hãy cung cấp cho agent của bạn các công cụ đó cũng như test.
hightốn khoảng gấp 3 lầnmedium(trung bình $0.29 so với $0.10 mỗi lần thử) và tạo diff lớn gấp 8 lần để đổi lấy mức tăng tốc vừa phải. Hãy bắt đầu vớimedium.Tôi cố tình cài đặt nút thắt cổ chai trong một ứng dụng nhỏ, nên các kết quả này chỉ mô tả riêng trường hợp này.