

¿Qué es la API Gemini 4 Argon?
La API Gemini 4 Argon te da acceso a gemini-4-argon, un modelo de razonamiento de Google creado para programación compleja y tareas multi-paso de agentes. Alcanzó disponibilidad general a mediados de octubre de 2026. Según la página del modelo, entrada, razonamiento y salida comparten una ventana de 1.048.576 tokens, y una respuesta síncrona se corta a 65.536 tokens de salida.
Google hizo un experimento similar en su caso de estudio ADK: una ejecución de Antigravity de 11 horas con /goal en el Python Agent Development Kit (ADK). Sus revisores aceptaron 2 de 6 propuestas, reduciendo la preparación de sesión alrededor de un 40% en sesiones largas y las importaciones en un 21%. Este tutorial usa en su lugar un bucle pequeño en Python.
Usarás cuatro funcionalidades de la API:
-
La Interactions API, la interfaz recomendada por Google para proyectos nuevos, que mantiene el estado de la conversación en el servidor
-
Llamadas a funciones, donde el modelo pide una herramienta y tu código decide si ejecutarla
-
thinking_level:low,medium(por defecto) ohigh -
El objeto
usage, que informa de tokens de entrada, en caché, de salida y de razonamiento
Argon pide y tu código hace el trabajo.
El proyecto: una app de Python lenta para que Gemini 4 Argon la optimice
El agente recibe el código de EventFlow, 8 herramientas y ninguna pista sobre la ralentización. El código completo está en GitHub. Empieza con EventFlow.
Cómo funciona EventFlow
EventFlow es un procesador de eventos ficticio en seis módulos pequeños. Un evento entra por EventFlow.ingest(), validate() lo convierte en un Event, y CustomerState lo guarda, por cliente, en orden temporal. Luego summarize() convierte cada historial en sesiones, ingresos, reembolsos y recuentos de páginas, y build_report() produce un CustomerReport.
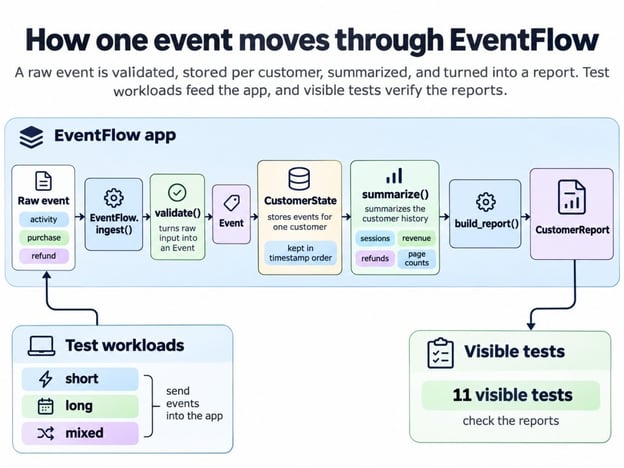
Cómo un evento se convierte en informe. Imagen del autor.
Las docstrings de EventFlow establecen estas reglas:
-
Las sesiones se separan tras 30 minutos de inactividad
-
Los reembolsos se limitan a lo que queda de la compra
-
Un
event_idrepetido se ignora; gana la primera copia -
Los eventos se ordenan por timestamp, incluso entre lotes
-
history()yreport()devuelven objetos que pertenecen al llamador
Los tests ocultos comprueban todo esto, y la última regla volverá a salir más adelante.
Por qué EventFlow se vuelve lenta
Tres cargas, construidas con semillas fijas, muestran cómo cambia el panorama según la longitud del historial:
-
short: muchos clientes con 5 eventos cada uno -
long: pocos clientes con 160 eventos cada uno -
mixed: de 1 a 30 eventos por cliente, con duplicados y eventos que llegan desordenados
long tiene muchos menos eventos que short y aun así tarda unas 3 veces más. El gráfico mantiene el total en 1.600 eventos mientras alarga el historial de cada cliente.
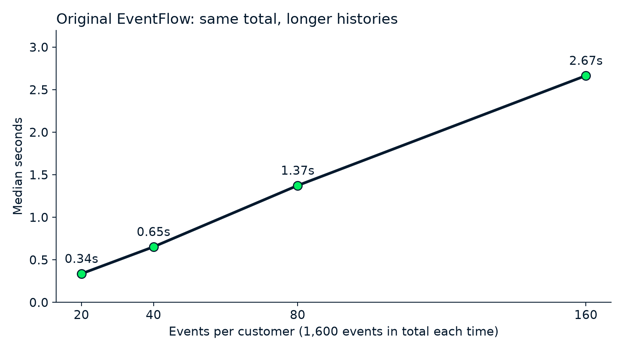
Mismo total, historiales más largos, procesamiento más lento. Imagen del autor.
Cada vez que se duplica la longitud del historial, también se duplica el tiempo de ejecución, aunque el número total de eventos no cambie. Ese patrón suele indicar que algún paso repite trabajo sobre todo el historial con cada evento nuevo. El agente nunca ve las causas, así que las nombraré después de que Argon haya hecho su parte.
Criterios de éxito y tests ocultos
Un arreglo solo cuenta si pasa cinco comprobaciones fijadas antes de la primera llamada a la API; el informe del propio modelo no puntúa. El código final del agente debe lograr todo esto:
-
Correr al menos 1,5 veces más rápido en
long -
No ir más de un 5% más lento en
shortomixed -
Pasar todos los tests visibles
-
Devolver exactamente el mismo informe que el original en las tres cargas
-
Pasar todos los casos de aceptación ocultos
Estos umbrales son míos, tómales como ejemplo. Las herramientas del agente no pueden alcanzar los casos ocultos; se ejecutan solo cuando su código ya está congelado. Comparan su código con una implementación de referencia separada con datos nuevos, lotes tardíos, duplicados y las reglas de propiedad.
Una batería oculta solo ayuda si rechaza arreglos incorrectos, así que aliméntala con un par a propósito. Aquí, dos atajos fáciles pasan todos los tests visibles: eliminar la copia profunda y cachear el resumen sin actualizarlo jamás. Los casos ocultos rechazan ambos.
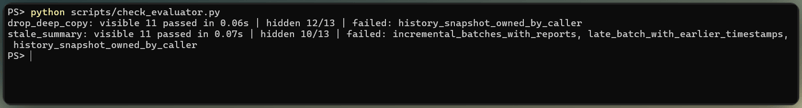
Los tests ocultos cazan dos arreglos erróneos. Imagen del autor.
Cómo configurar la API Gemini 4 Argon en Python
Necesitas Python 3.10 o superior, una clave de la API de Gemini y un proyecto en Google AI Studio con facturación activada, porque la página de precios no lista un plan Free para Argon. Este proyecto fija el SDK google-genai en la versión 2.33.0; la Interactions API requiere al menos la 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envEn macOS o Linux, activa el entorno virtual con source .venv/bin/activate y copia con cp; luego pon GEMINI_API_KEY=... en .env. Si GOOGLE_API_KEY también está definido en tu shell, el SDK lo usará en su lugar, así que el código de abajo lo elimina primero. Sáltate la siguiente subsección si ya has usado Interactions API.
Haz tu primera petición a la API de Gemini 4 Argon
Tu primera petición entrega a Argon la cabecera de la salida del profiler de EventFlow y le pregunta qué ve. load_dotenv() carga GEMINI_API_KEY desde .env, genai.Client() lo lee, el ID del modelo va en client.interactions.create() y generation_config lleva el nivel de razonamiento.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Esto fue lo que volvió:
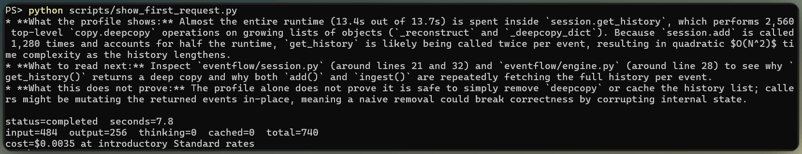
Primera petición a Argon leyendo el perfil. Imagen del autor.
Argon acertó; casi todo el tiempo estaba bajo get_history() y copy.deepcopy, probablemente llamadas dos veces por evento. Su tercer punto avisó de que eliminar la copia profunda podría romper a los llamadores que modifican lo que reciben, que es el primer atajo que mencioné antes. Una pregunta así es barata: menos de 8 segundos y menos de medio céntimo, sin tokens de razonamiento.
medium es el valor por defecto, y la guía del "latest model" que enlacé antes lo recomienda "para la mayoría de tareas, incluido código complejo y casos de uso de agentes". La misma guía dice que temperature, top_p y top_k se ignoran en Argon, así que déjalos fuera.
Perfila código Python antes de usar Gemini 4 Argon
Mide la app original antes de que el modelo la toque, para que cada número posterior tenga con qué compararse. Toma tres tipos de medida, cada una en su propio proceso, porque cada herramienta sesga a las otras:
-
Tiempo con
time.perf_counter(), como la mediana de varios procesos nuevos con un calentamiento cada uno -
Perfilado con
cProfilepara ver dónde se va el tiempo; hizo que long fuese ~6 veces más lento, así que nunca te fíes de un tiempo tomado bajo un profiler -
Memoria con
tracemalloc, que informa del pico de asignaciones de Python rastreadas, no de la memoria total del proceso
En las tres cargas, en lugar de los 1.600 eventos fijos del gráfico, la app original tardó ~0,7 s en short, 2,2 en long y 1,0 en mixed. También pasó todos los tests visibles con pytest.
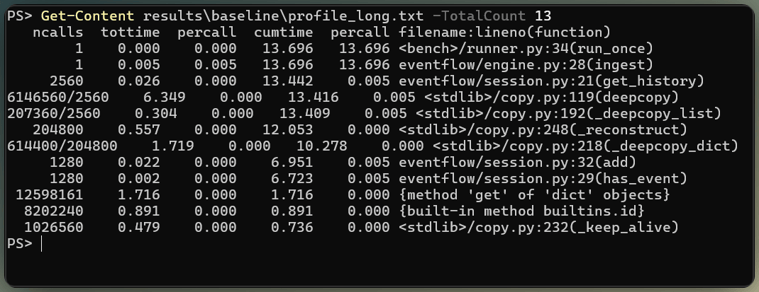
Dónde gasta tiempo la app lenta. Imagen del autor.
Espera deriva: el mismo código más tarde midió ~10% más rápido, así que cronometra cada versión en la misma sesión.
Cómo construir un agente de rendimiento con llamadas a funciones de Gemini 4 Argon
Como dije antes, Argon solo pide herramientas. El código de Python que las ejecuta es el harness, y nuestra guía de ingeniería de agent harness explica por qué sus comprobaciones deben estar en el código y no en el prompt. Las herramientas van primero, porque determinan qué puede tocar Argon.
Define las herramientas y permisos del agente
Las 8 herramientas que mencioné son funciones de Python declaradas como esquemas JSON simples, y solo dos pueden cambiar código:
-
list_filesyread_file, limitadas al código fuente Python de la app, tests y fixtures -
run_profileryrun_benchmarkpara una carga concreta -
apply_patch, que reemplaza una ocurrencia exacta de texto en un archivo de código de la app -
revert_file,run_testsyshow_diff
Las declaraciones siguen el formato de la guía de llamadas a funciones que enlacé antes:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Un esquema describe la llamada, pero no la hace segura. El harness añade estas comprobaciones en Python:
- Cada ruta se resuelve primero; si intenta salir de la copia de la app, falla
- Se rechazan escrituras fuera de la carpeta de código fuente de la app
- Un archivo parcheado debe seguir compilando o se rechaza el parche
- Tests y benchmarks se ejecutan en subprocesos con timeouts y sin clave de API
No es un contenedor, y el código parcheado aún podría leer archivos fuera de la copia, así que trátalo como el mínimo.
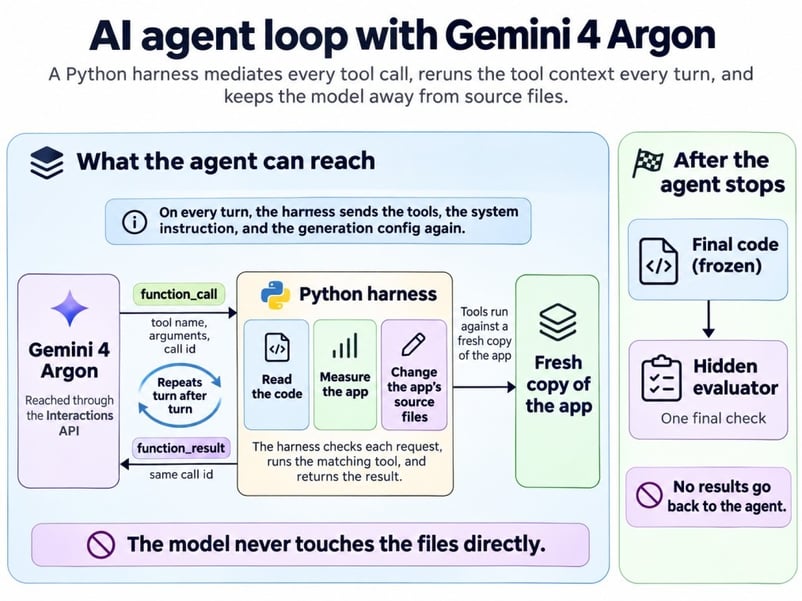
Argon pide, Python decide y ejecuta. Imagen del autor.
Dale al agente un objetivo de rendimiento medible
La instrucción del sistema define el objetivo y las reglas, pero nunca dice dónde está la ralentización:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.El agente decide cuándo parar con lo que puede ver: tests visibles, resultados de profiler y benchmarks, y los límites que marca el bucle.
Implementa el bucle de herramientas con Interactions API
El fragmento siguiente es el núcleo del bucle; la versión completa añade el cliente, el despachador de herramientas y los límites. Cada turno es una llamada a client.interactions.create(), y Argon suele pedir varias herramientas en un mismo turno, así que ejecuta cada paso function_call que devuelva. Envía cada resultado de vuelta como function_result con el call_id correspondiente:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)El **request en la llamada de seguimiento es la línea que mucha gente omite. previous_interaction_id lleva el historial, pero tools, system_instruction y generation_config están delimitados al ámbito de la interacción, así que un turno sin ellos pierde herramientas o vuelve al nivel de razonamiento por defecto. Es fácil olvidarlo, así que el código guarda los tres ajustes en un diccionario.
La API no tiene presupuesto de tarea, así que establece límites de turnos, tiempo y gasto en tu aplicación antes de empezar. Usé 40 turnos, 10 parches, 45 minutos y 5 $, y ningún intento se acercó, aunque el control de gasto se ejecuta entre turnos, así que un turno largo puede sobrepasarlo. La página de límites de Google añade su propio tope en cuentas de Nivel 1: 10 $ por cada 10 minutos móviles, devolviendo 429 RESOURCE_EXHAUSTED si lo excedes.
Ejecuta el agente de Gemini 4 Argon y verifica sus cambios
Cada intento partió de una copia limpia de la app, se detuvo solo en unos 5 minutos y se congeló su código antes de cualquier comprobación oculta.
Encontrar el cuello de botella con evidencias
Argon encontró el cuello de botella midiendo primero. Aquí tienes el primer intento en medium, turno a turno.
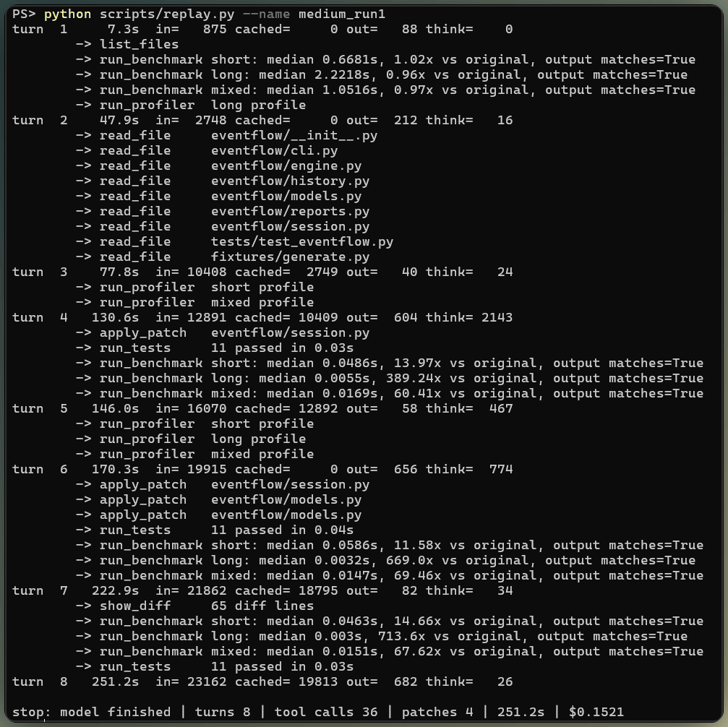
Un intento en medium, turno a turno. Imagen del autor.
Sus resúmenes de pensamiento, una versión condensada del razonamiento y no cada paso, muestran cómo llegó al arreglo. Argon se dio cuenta de que has_event() y add() llaman ambas a get_history(). Se preguntó si la copia profunda era "realmente necesaria aquí, o si el requisito es solo que el llamador sea dueño de los datos", y lo zanjó con la docstring de summarize(), que dice que la función no modifica su entrada.
No todas las afirmaciones descansaron en evidencias. El mismo resumen dice que no hay "acceso directo en tests o usos ocultos", cosa que Argon no podía saber. La suposición se sostuvo (esta vez), pero es la clase de frase a subrayar en una revisión.
El arreglo al que llegaron los seis intentos
Todos hicieron el mismo cambio central en CustomerState, y el más pequeño de los seis diffs lo ilustra mejor:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneAhora, las causas plantadas que prometí: add() re-resumía todo el historial con cada evento, cada evento pagaba dos copias profundas completas, y las comprobaciones de duplicados recorrían la lista.
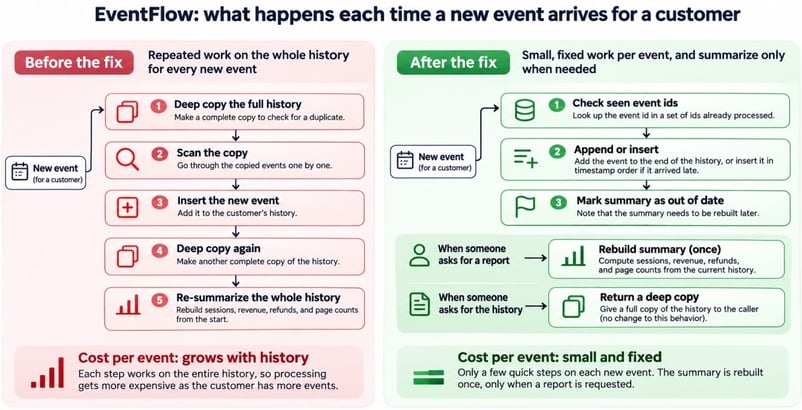
Trabajo por evento antes y después del arreglo. Imagen del autor.
get_history() mantiene su copia profunda para quien llama desde fuera, que es el detalle que el atajo de la copia profunda dejaba mal.
Cada ronda de parches pasó los tests visibles, así que el agente no tuvo que revertir, pero la mayoría de intentos también añadieron un setter de summary que nadie llama. Nadie lo pidió, y alguien tendrá que revisarlo.
Resultados de los tests de aceptación ocultos
El evaluador oculto se ejecutó una vez por intento, y todos los intentos pasaron todos los casos. Los casos llaman a ingest() después de report(), envían reembolsos antes que sus compras y modifican objetos devueltos para confirmar que el estado del motor no cambia.
¿Gemini 4 Argon realmente hizo la app más rápida?
Sí. Todas las versiones nuevas fueron mucho más rápidas y devolvieron la misma salida que la original. Como dije antes, los tiempos derivan, así que medí la original y las 6 nuevas en orden alterno, 9 procesos limpios cada una.
Cada medición cubre solo ingest y reports, no el arranque de Python ni importaciones. A unos pocos milisegundos, una sola medición puede salir muy por encima de la mediana, así que compara medianas. La escala log del gráfico evita que las nuevas desaparezcan al lado de la original.
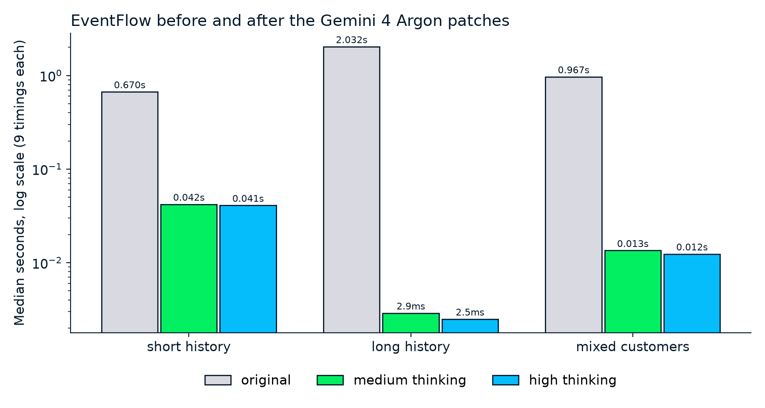
Milisegundos después, segundos antes, mismas salidas. Imagen del autor.
El gráfico muestra el primer intento de cada nivel y la tabla cubre los 6, con el speedup como la mediana original dividida por la mediana:
|
Medida |
Original |
Medium (3 intentos) |
High (3 intentos) |
|
|
Referencia |
14,8x a 15,9x |
16,3x a 17,4x |
|
|
Referencia |
656x a 701x |
sobre 810x |
|
|
Referencia |
65,4x a 71,6x |
76,8x a 78,0x |
|
Pico de memoria rastreada, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Pico de memoria rastreada, |
885 KiB |
570 KiB |
569 KiB |
long ganó más, porque el trabajo eliminado crecía con el historial de cada cliente. Las filas de memoria son el único lugar donde el arreglo cuesta algo. short, con más clientes, usó ~10% más, probablemente por el nuevo conjunto de IDs por cliente, mientras que long usó menos, seguramente por dejar de crear copias.
No leas 700x como algo especial de Argon. Quitar un bucle cuadrático de datos sintéticos suele dar números así, lo escriba quien lo escriba.
Niveles de razonamiento de Gemini 4 Argon: medium vs. high
En esta tarea, high escribió código ligeramente más rápido que medium, pero ambos niveles dieron con el mismo arreglo, así que el extra de razonamiento fue a pulir, no a diagnosticar.
Mantener la comparación justa
Cambia el nivel de razonamiento y nada más. Cada intento usó el mismo código, prompt, herramientas, límites y evaluador, y ninguno vio el trabajo de otro intento. Los niveles alternaron, 3 intentos cada uno, el mismo montaje que usé en mi tutorial de la API de Claude Opus 5.
Resultados, tiempo y coste por nivel
Los dos niveles se repartieron así, de media por intento:
|
Media por intento |
Medium |
High |
|
Arreglos aceptados |
3 de 3 |
3 de 3 |
|
Llamadas a herramientas |
28 |
35 |
|
Tokens de razonamiento |
1.877 |
14.764 |
|
Líneas cambiadas |
24 |
193 |
|
Tiempo |
3,4 minutos |
5 minutos |
|
Coste al precio introductorio |
0,10 $ |
0,29 $ |
|
Coste tras finalizar ese precio |
0,20 $ |
0,58 $ |
high dio con el arreglo en su primer parche y después siguió puliendo. Reescribió partes de la agregación, los informes y la validación que ya no eran el cuello de botella principal.
Esa ventaja cambia según la máquina y está cerca del ruido de timing en cargas que ya terminan en milisegundos, así que igualmente enviaría a revisión el diff más pequeño de medium solo por tiempo de revisión.
El pico de razonamiento de high llegó en el turno 4, cuando su primer parche ya había arreglado el problema.
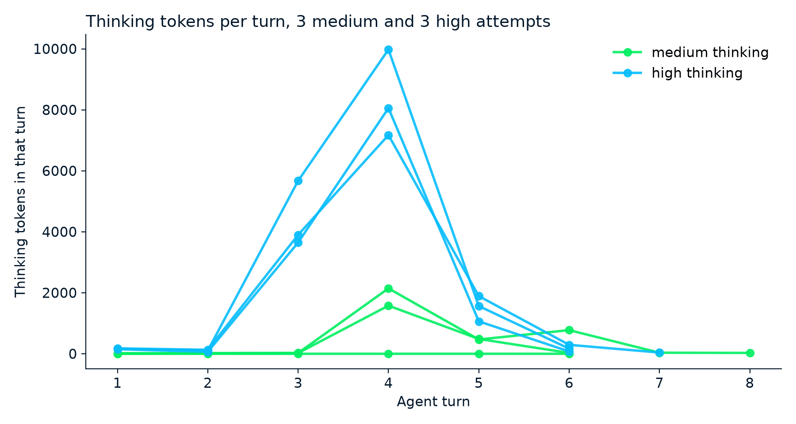
Dónde gastó el razonamiento cada intento. Imagen del autor.
Tampoco tomes los tokens de razonamiento como señal de calidad; como en la primera petición, un intento en medium no usó ninguno y aun así logró un arreglo aceptado, más rápido y barato que cualquier otro intento.
Para calcular el precio de un agente, suma el usage de cada turno, porque cada turno informa del contexto completo que ha procesado. La mayor parte de la entrada de cada turno repite la del anterior, y la caché implícita facturó alrededor de dos tercios a tarifa de caché.
Según la guía de caché, la caché necesita un prompt de al menos 4.096 tokens, y un turno que añade menos de 2.050 tokens nuevos paga la tarifa completa por los últimos 2.050 de la petición anterior, así que los bucles con resultados de herramientas muy pequeños ahorran menos. A las tarifas Standard de introducción, que detallo en los FAQs, los 6 intentos juntos costaron 1,16 $.
Limitaciones de un agente de rendimiento con IA
Un agente así funciona mejor en problemas a los que un profiler puede apuntar, y este estaba hecho para ser limpio:
-
El cuello de botella estaba plantado, como dije al principio. Un profiler apunta casi directo a un bucle cuadrático en seis archivos pequeños, mientras que las ralentizaciones reales se esconden en E/S, bases de datos y código sin documentación.
-
Las docstrings hicieron gran parte del trabajo. Argon se apoyó en una para decidir qué copia podía saltarse, y un código sin documentación no le da nada donde apoyarse.
-
Los tests solo comprueban lo que a alguien se le ocurrió. En el caso de estudio de ADK de Google, un cambio de import pasó la suite pública y aun así falló targets internos.
-
Los tiempos vienen de una máquina Linux pequeña con cargas sintéticas; tus aceleraciones variarán.
-
Cada archivo que el agente lee va a Google, que almacena interacciones de la capa de pago durante 55 días por defecto;
store=falselo evita pero impide usarprevious_interaction_id.
La model card de Google también lista alucinaciones y timeouts ocasionales entre las limitaciones conocidas.
Conclusiones
El agente detectó los resúmenes repetidos y las copias profundas en los seis intentos, mantuvo la copia de la que dependen los llamadores y pasó las comprobaciones reservadas. high añadió algo de velocidad y un diff mucho mayor.
No lo generalizaría a tu código, porque yo planté el cuello de botella. Lo que sí se mantiene es el método: mide primero, mantén las herramientas acotadas, congela el código antes de comprobarlo y deja que los tests ocultos decidan el resultado.
La primera ampliación que haría es un router que empiece en medium y suba a high solo cuando fallen los tests visibles, de modo que los casos ocultos nunca retroalimenten al agente.
Si la salida del profiler de arriba te resulta nueva, Writing Efficient Python Code cubre las mismas herramientas de timing y profiling que usé antes de dejar que Argon tocase el código.
FAQs
¿Puede Gemini 4 Argon acelerar código de Python automáticamente?
No por sí sola. La Interactions API todavía no ejecuta herramientas por ti, así que tu código hace ese trabajo, y aquí el código de comprobación acabó siendo el doble de grande que la app.
¿Puede Gemini 4 Argon ejecutar código Python por sí mismo?
Sí, con la herramienta integrada de ejecución de código, pero se corta a los 30 segundos y no puede instalar pytest. Para tests reales, usa tu propia máquina o el entorno hospedado de nuestro tutorial de Managed Agents.
¿Debería usar razonamiento low para un agente como este?
No lo probé, y Google dice que la calidad puede caer en tareas difíciles. Como defines el nivel en cada turno, probaría low para leer archivos y medium para escribir parches.
¿Cuánto cuesta la API de Gemini 4 Argon?
Pagué 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, razonamiento incluido, y esos precios se duplican después del 30 de noviembre de 2026. Flex cuesta la mitad, pero cada petición puede tardar hasta 15 minutos; yo solo lo aceptaría para experimentos nocturnos.
¿Puedo usar este agente en un código de producción?
No tal cual, así que ejecútalo en un contenedor desechable y haz que una persona revise cada diff. Ten en cuenta también que el conocimiento de Argon se detiene en marzo de 2026, así que dale documentación actual para librerías nuevas.

Soy ingeniero de datos y creador de comunidades. Trabajo con canalizaciones de datos, nube y herramientas de IA, al tiempo que escribo tutoriales prácticos y de gran impacto para DataCamp y programadores emergentes.


Quería ver qué hace Gemini 4 Argon con una app de Python que no está rota, solo es lenta. Todas las pruebas pasan y todos los informes son correctos, pero parte del trabajo tarda segundos cuando debería tardar milisegundos, y empeora cuanto más historial tiene un cliente. Muchos tutoriales de IA para programar empiezan con un test fallando, que le da al modelo un objetivo evidente.
Pero aquí, ningún test fallido señala el código lento. Gemini 4 Argon es un modelo de Google al que llamas desde Python a través de la API de Gemini, y lo usarás para construir un agente de IA, es decir, un modelo que ejecuta acciones para lograr un objetivo. En este caso, el agente lee, cronometra y edita código, pero solo a través de herramientas que controlas desde tu propio Python.
La app es EventFlow, un pequeño programa ficticio que convierte la actividad de clientes, compras y reembolsos en informes. Mi duda era si el agente podría encontrar la parte lenta y arreglarla sin cambiar lo que devuelve la app. Si te manejas con funciones y clases de Python y ejecutar tests, puedes seguir el proceso. Verás cómo:
Nuestro resumen de Gemini 4 Argon cubre el lanzamiento y los benchmarks, así que este tutorial se centra en la API. Para una visión más amplia, mira también las comparativas Gemini 4 Argon vs Claude Opus 5.5 y Gemini 4 Argon vs. GPT-6 Astra.
Resumen
Puse al agente la misma tarea 6 veces, 3 con
mediumy 3 conhigh, y esto es lo que pasó:Argon arregló el cuello de botella en los 6 intentos, y otro conjunto de tests ocultos lo confirmó.
La carga lenta pasó de unos 2 segundos a unos 3 milisegundos.
Argon ejecutó benchmarks y un profiler antes de cambiar nada, así que dale a tu agente esas herramientas además de tests.
highcostó aproximadamente 3 veces más quemedium(0,29 $ frente a 0,10 $ por intento, de media) y generó diffs 8 veces mayores para una ganancia extra de velocidad modesta. Empieza conmedium.Planté el cuello de botella a propósito en una app pequeña, así que estos resultados describen solo este caso.