

Vad är Gemini 4 Argon API?
Gemini 4 Argon API ger dig gemini-4-argon, en Google-resoneringsmodell byggd för komplex kodning och flerstegsagentuppgifter. Den blev allmänt tillgänglig i mitten av oktober 2026. Enligt modellsidan delar indata, tänk och utdata ett fönster på 1 048 576 token, och ett synkront svar stannar vid 65 536 utdatatoken.
Google körde ett liknande experiment i sin ADK-fallstudie: en 11 timmar lång Antigravity-körning med /goal i Python Agent Development Kit (ADK). Deras granskare behöll 2 av 6 förslag, vilket kapade sessionförberedelserna med cirka 40 % i långa sessioner och importerna med 21 %. Den här handledningen använder i stället en liten Python-loop.
Du kommer att använda fyra API-funktioner:
-
Interactions API, Googles rekommenderade gränssnitt för nya projekt, som behåller samtalshistorik på servern
-
Funktionsanrop, där modellen ber om ett verktyg och din kod avgör om det ska köras
-
thinking_level:low,medium(standard), ellerhigh -
Objektet
usage, som rapporterar indata-, cache-, utdata- och tänktoken
Argon frågar, och din kod gör jobbet.
Projektet: En långsam Python-app för Gemini 4 Argon att fixa
Agenten får EventFlow-koden, 8 verktyg och ingen ledtråd om var flaskhalsen finns. Komplett kod finns på GitHub. Börja med EventFlow.
Så fungerar EventFlow
EventFlow är en fiktiv händelseprocessor i sex små moduler. En händelse kommer in i EventFlow.ingest(), validate() gör den till ett Event, och CustomerState lagrar den i tidsstämpelordning per kund. Sedan summarize() omvandlar varje historik till sessioner, intäkter, återköp och sidantal, och build_report() producerar en CustomerReport.
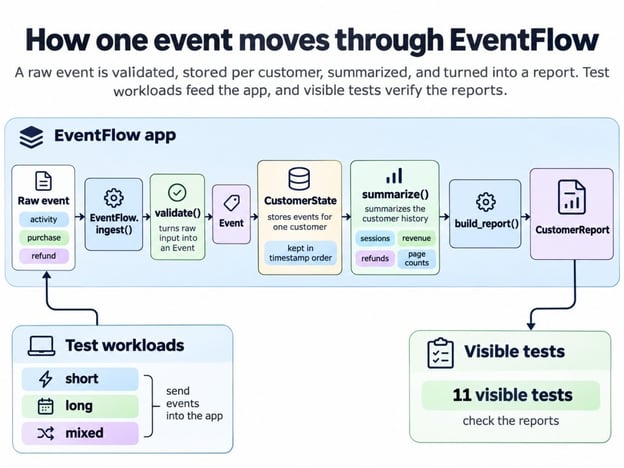
Hur en händelse blir en rapport. Bild: författaren.
EventFlows docstrings sätter följande regler:
-
Sessioner delas efter ett avbrott på 30 minuter
-
Återköp begränsas till vad som återstår av köpet
-
Ett upprepat
event_idignoreras och den första kopian gäller -
Händelser sorteras efter tidsstämpel, även över batcher
-
history()ochreport()returnerar objekt som anroparen äger
De dolda testerna kollar alla dessa, och den sista punkten dyker upp igen senare.
Varför EventFlow blir långsam
Tre arbetslaster, byggda från fasta frön, visar hur historiklängd ändrar bilden:
-
short: många kunder med 5 händelser var -
long: några kunder med 160 händelser var -
mixed: 1 till 30 händelser per kund, med dubbletter och händelser som anländer i fel ordning
long har betydligt färre händelser än short och tar ändå cirka 3x så lång tid. Diagrammet håller totalen på 1 600 händelser samtidigt som varje kund får längre historik.
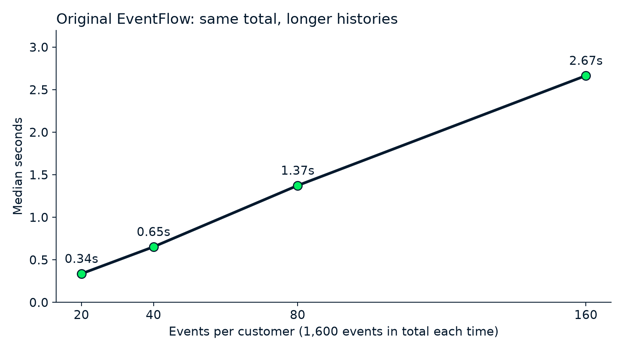
Samma total, längre historiker, långsammare bearbetning. Bild: författaren.
Varje gång historiklängden fördubblas fördubblas även körtiden, trots att totala antalet händelser aldrig ändras. Det mönstret brukar betyda att något steg upprepar arbete över hela historiken vid varje ny händelse. Agenten ser aldrig orsakerna, så jag namnger dem efter att Argon fått sin chans.
Kriterier för framgång och dolda tester
En fix räknas bara om den passerar fem kontroller som sattes innan första API-anropet; modellens egen rapport väger inte. Agentens slutliga kod måste göra allt följande:
-
Gå minst 1,5x snabbare på
long -
Inte bli mer än 5 % långsammare på
shortellermixed -
Klara alla synliga tester
-
Returnera samma rapportutdata som originalet på alla tre arbetslaster
-
Klara alla dolda acceptansfall
Trösklarna är mina egna, så se dem som exempel. Agentens verktyg kan inte nå dolda fall; de körs först efter att dess kod frysts. De jämför dess kod med en separat referensimplementation på ny data, sena batcher, dubbletter och ägarreglerna.
En dold svit hjälper bara om den förkastar felaktiga fixar, så mata den med några avsiktligt. Två enkla genvägar klarar alla synliga tester här, att ta bort deep copy och cacha sammanfattningen utan att någonsin uppdatera den. De dolda fallen förkastar båda.
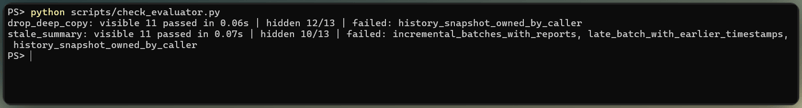
Dolda tester fångar två felaktiga fixar. Bild: författaren.
Så sätter du upp Gemini 4 Argon API i Python
Du behöver Python 3.10 eller nyare, en Gemini API-nyckel och ett Google AI Studio-projekt med fakturering aktiverad, eftersom prissidan listar ingen gratisnivå för Argon. Det här projektet låser google-genai-SDK:n till 2.33.0; Interactions API kräver minst 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envPå macOS eller Linux, aktivera den virtuella miljön med source .venv/bin/activate och kopiera med cp, lägg sedan GEMINI_API_KEY=... i .env. Om GOOGLE_API_KEY också är satt i ditt skal använder SDK:n den i stället, så koden nedan tar bort den först. Hoppa över nästa avsnitt om du redan använt Interactions API.
Gör din första förfrågan till Gemini 4 Argon API
Din första förfrågan ger Argon toppen av EventFlows profilerarutdata och frågar vad den visar. load_dotenv() laddar GEMINI_API_KEY från .env, genai.Client() läser den, modell-ID:t går in i client.interactions.create(), och generation_config bär tänkenivån.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Det här kom tillbaka:
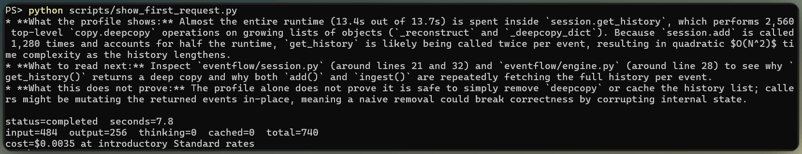
Första Argon-förfrågan läser profilen. Bild: författaren.
Argon hade rätt; nästan all tid låg under get_history() och copy.deepcopy, troligen anropade två gånger per händelse. Dess tredje punkt varnade för att borttagning av deep copy kan bryta anropare som modifierar det de får tillbaka, vilket är den första genvägen jag nämnde tidigare. En sådan fråga är billig: under 8 sekunder och mindre än ett halvt öre, utan tänketoken.
medium är standard, och guiden för den senaste modellen som jag länkade till tidigare rekommenderar den "för de flesta uppgifter, inklusive komplex kod och agentiska användningsfall." Samma guide säger att temperature, top_p och top_k ignoreras på Argon, så låt dem vara.
Profilera Python-kod innan du använder Gemini 4 Argon
Mät originalappen innan modellen rör den, så att varje senare siffra har något att jämföra med. Ta tre typer av mätning, var och en i sin egen process, eftersom varje verktyg snedvrider de andra:
-
Tidtagning med
time.perf_counter(), som medianen av flera färska processer med en uppvärmning var -
Profilering med
cProfileför att hitta var tiden går; det gjorde long cirka 6x långsammare, så lita aldrig på en tidtagning under en profilerare -
Minne med
tracemalloc, som rapporterar högsta spårade Python-allokeringar i stället för total processminnesanvändning
På de tre arbetslasterna, snarare än diagrammets fasta 1 600 händelser, tog originalappen cirka 0,7 sekunder på short, 2,2 på long och 1,0 på mixed. Den klarade också alla synliga pytest-tester.
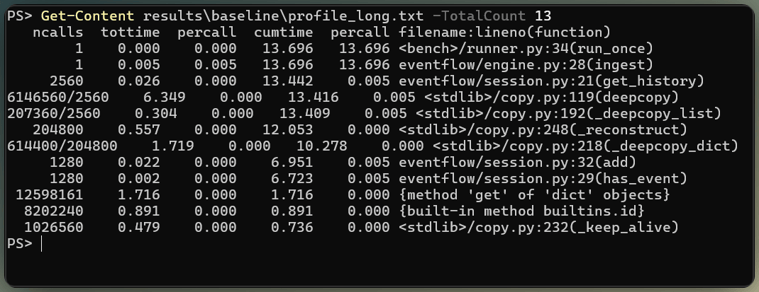
Var den långsamma appen spenderar tiden. Bild: författaren.
Förvänta dig drift: samma kod mättes senare cirka 10 % snabbare, så tidtag alla versioner i en och samma session.
Bygg en prestandaagent med funktionsanrop i Gemini 4 Argon
Som jag nämnde tidigare, Argon ber bara om verktyg. Pythonkoden som kör dem kallas harness, och vår guide till agent-harness förklarar varför dess kontroller hör hemma i kod i stället för i prompten. Verktygen kommer först, eftersom de avgör vad Argon kan röra.
Definiera agentens verktyg och behörigheter
De 8 verktygen jag nämnde tidigare är Python-funktioner deklarerade som rena JSON-scheman, och bara två av dem kan ändra kod:
-
list_filesochread_file, begränsade till appens Python-källkod, tester och fixtures -
run_profilerochrun_benchmarkför en namngiven arbetslast -
apply_patch, som ersätter en exakt förekomst av text i en befintlig källfil i appen -
revert_file,run_testsochshow_diff
Deklarationerna följer formatet i guiden för funktionsanrop som jag länkade till tidigare:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Ett schema beskriver anropet men gör det inte säkert. Harnessen lägger till följande kontroller i Python:
- Varje sökväg löses först, så en sökväg som lämnar den kopierade appen fallerar
- Skrivningar utanför appens källmapp nekas
- En patchad fil måste fortfarande kompilera, annars nekas patchen
- Tester och benchmark körs i underprocesser med tidsgränser och utan API-nyckel
Det är inte en container, och patchad kod kan fortfarande läsa filer utanför kopian, så se det som miniminivån.
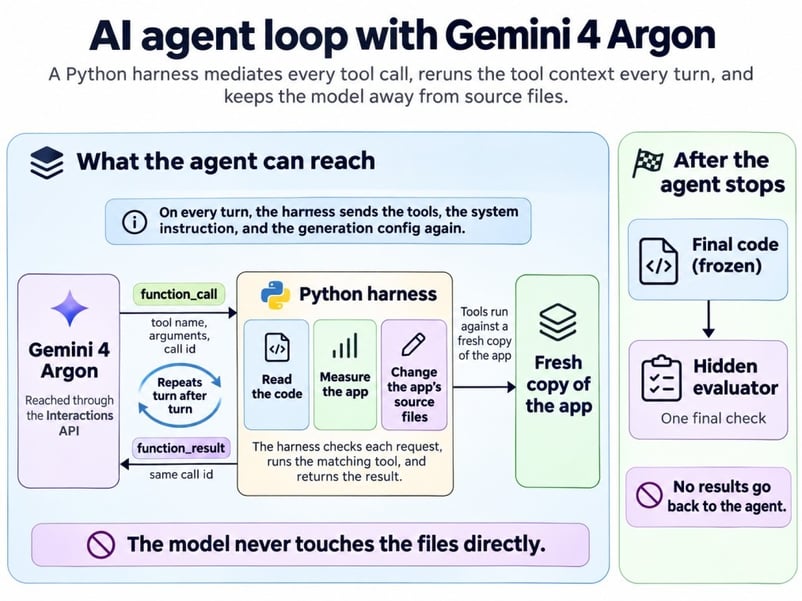
Argon frågar, Python avgör och kör. Bild: författaren.
Ge agenten ett mätbart prestandamål
Systeminstruktionen anger målet och reglerna men säger aldrig var flaskhalsen finns:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Agenten avgör när den ska sluta utifrån vad den kan se: synliga tester, profilerar- och benchmarkresultat samt gränserna som loopen sätter härnäst.
Implementera verktygsloopen för Interactions API
Kodsnutten nedan är kärnan i loopen; den kompletta versionen lägger till klient, verktygsdistributör och gränser. Varje varv är ett client.interactions.create()-anrop, och Argon ber ofta om flera verktyg i ett varv, så kör varje function_call-steg den returnerar. Skicka tillbaka varje resultat som ett function_result med matchande call_id:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request på uppföljningsanropet är raden som många tappar bort. previous_interaction_id bär historiken, men tools, system_instruction och generation_config är interaktionsbundna, så ett varv utan dem tappar verktygen eller faller tillbaka till standardtänkenivån. Jag tycker den här regeln är lätt att glömma, så koden behåller alla tre inställningarna i en dict.
API:et har ingen uppgiftsbudget, så sätt varv-, tids- och kostnadsbegränsningar i din applikation innan du startar. Jag använde 40 varv, 10 patchar, 45 minuter och $5, och inget försök var i närheten, även om kostnadskontrollen körs mellan varven, så ett långt varv kan överskjuta. Googles sida om räknebegränsningar lägger också ett tak på Tier 1-konton, $10 per rullande 10 minuter, och returnerar 429 RESOURCE_EXHAUSTED efter det.
Kör Gemini 4 Argon-agenten och verifiera ändringarna
Varje försök startade från en färsk kopia av appen, stannade av sig själv inom cirka 5 minuter och fick koden fryst innan någon dold kontroll kördes.
Att hitta flaskhalsen från bevis
Argon hittade flaskhalsen genom att mäta först. Här är det första medium-försöket, varv för varv.
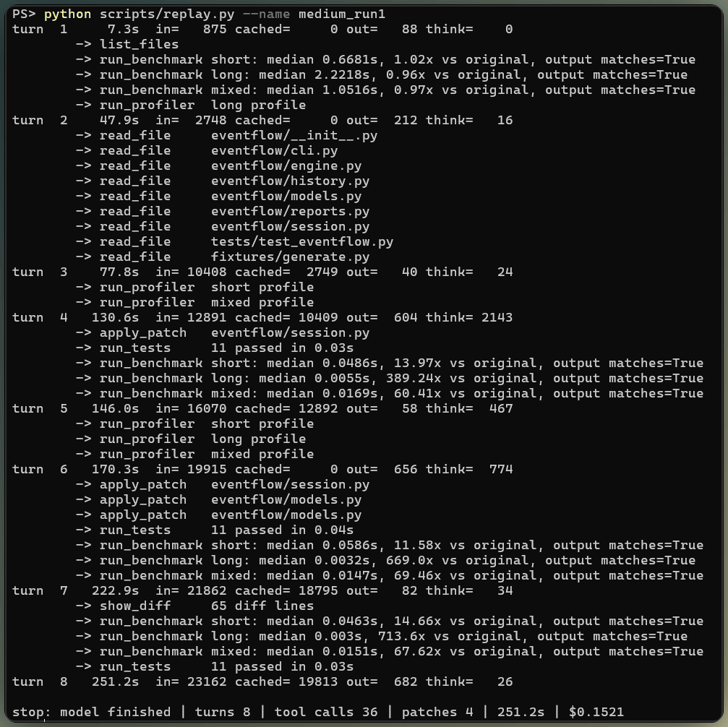
Ett medium-försök, varv för varv. Bild: författaren.
Dess tänkesammanfattningar, en kondenserad version av resonemanget snarare än varje steg, visar hur den kom fram till fixen. Argon noterade att has_event() och add() båda anropar get_history(). Den frågade om deep copy "verkligen är nödvändigt här, eller om kravet bara är att anroparen äger datan," och avgjorde det med docstringen för summarize(), som säger att funktionen inte modifierar sitt indata.
Inte varje påstående vilade på bevis. Samma sammanfattning säger att det saknas "direkt åtkomst i tester eller dolda användningar," vilket Argon inte kunde veta. Gissningen höll (den här gången), men det är den sortens rad att ringa in i en granskning.
Fixen som alla sex försöken landade på
Varje försök gjorde samma kärnändring i CustomerState, och den minsta av de sex diffarna visar det bäst:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneNu till de planterade orsakerna jag lovade tidigare: add() sammanfattade om hela historiken vid varje händelse, varje händelse betalade för två fulla deep copies, och dubblettkontroller skannade listan.
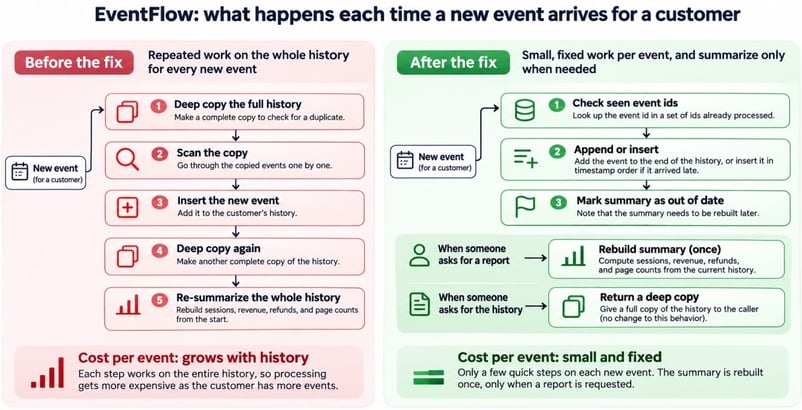
Arbete per händelse före och efter fix. Bild: författaren.
get_history() behåller sin deep copy för externa anropare, vilket är detaljen som genvägen med borttagen deep copy missar.
Varje patchomgång klarade de synliga testerna, så agenten behövde aldrig återställa, men de flesta försök lade också till en summary-setter som ingenting anropar. Ingen bad om den, och någon måste fortfarande granska den.
Resultat från dolda acceptanstester
Den dolda utvärderaren kördes en gång per försök, och varje försök klarade varje fall. Fallen anropar ingest() efter report(), skickar återköp före sina köp och ändrar returnerade objekt för att bekräfta att motorns tillstånd förblir oförändrat.
Gjorde Gemini 4 Argon faktiskt appen snabbare?
Ja. Varje ny version var mycket snabbare och returnerade samma utdata som originalet. Som jag nämnde tidigare driver tidtagningar, så jag tidtog originalet och alla 6 nya versioner i alternerande ordning, 9 färska processer vardera.
Varje tidtagning täcker bara ingest och rapporter, inte Python-start eller importer. På några millisekunder kan en enskild mätning hamna klart över medianen, så jämför medianer. Diagrammets loggskala hindrar de nya versionerna från att försvinna bredvid originalet.
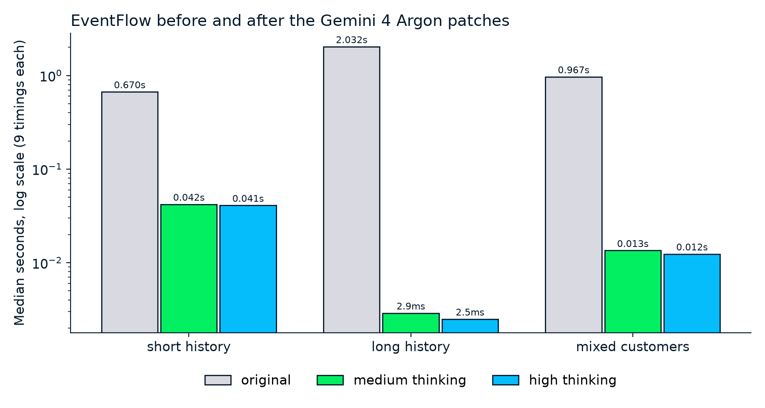
Millisekunder efter, sekunder före, samma utdata. Bild: författaren.
Diagrammet visar första försöket på varje nivå, och tabellen täcker alla 6, med hastighetsökning som originalmedian delat med ny median:
|
Mätning |
Original |
Medium (3 försök) |
High (3 försök) |
|
|
Referens |
14,8x till 15,9x |
16,3x till 17,4x |
|
|
Referens |
656x till 701x |
cirka 810x |
|
|
Referens |
65,4x till 71,6x |
76,8x till 78,0x |
|
Högsta spårade minne, |
7 108 KiB |
7 822 KiB |
7 822 KiB |
|
Högsta spårade minne, |
885 KiB |
570 KiB |
569 KiB |
long vann mest, eftersom det borttagna arbetet växte med varje kunds historik. Minnesraderna är det enda stället där fixen kostar något. short, med flest kunder, använde cirka 10 % mer, sannolikt för den nya ID-mängden per kund, medan long använde mindre, troligen för att den slutade bygga kopior.
Läs inte 700x som något specifikt för Argon. Att ta bort en kvadratisk loop från syntetisk data tenderar att ge sådana siffror, oavsett vem som skriver fixen.
Gemini 4 Argon tänkenivåer: Medium vs. High
I den här uppgiften skrev high något snabbare kod än medium, men båda nivåerna hittade samma fix, så det extra tänket gick till puts snarare än diagnos.
Hålla jämförelsen rättvis
Ändra tänkenivå och inget annat. Varje försök använde samma kod, prompt, verktyg, gränser och utvärderare, och inget såg ett annat försöks arbete. Nivåerna alternerade, 3 försök vardera, samma upplägg som jag använde i min Claude Opus 5 API-handledning.
Resultat, tid och kostnad per nivå
De två nivåerna fördelade sig så här, i snitt per försök:
|
Snitt per försök |
Medium |
High |
|
Accepterade fixar |
3 av 3 |
3 av 3 |
|
Verktygsanrop |
28 |
35 |
|
Tänketoken |
1 877 |
14 764 |
|
Rader ändrade |
24 |
193 |
|
Tid |
3,4 minuter |
5 minuter |
|
Kostnad till introduktionspris |
$0,10 |
$0,29 |
|
Kostnad efter att priset upphör |
$0,20 |
$0,58 |
high landade samma fix i sin första patch och fortsatte sedan att putsa. Den gick vidare och skrev om delar av sammanfattning, rapportering och validering som inte längre var den största flaskhalsen.
Det försprånget skiftar med maskinen och ligger nära mätbruset på arbetslaster som redan blir klara på millisekunder, så jag skulle ändå släppa mediums mindre diff enbart av granskningsskäl.
Highs tänk toppade i varv 4, efter att dess första patch redan hade fixat problemet.
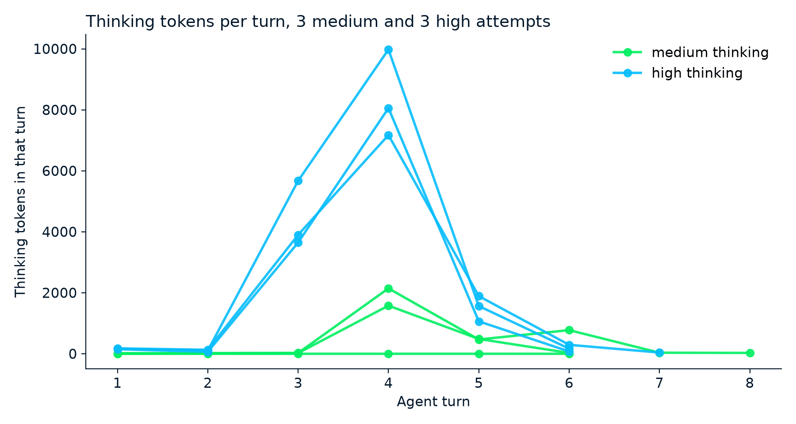
Var varje försök lade sitt tänk. Bild: författaren.
Ta inte tänketoken som en kvalitetssignal heller; likt första förfrågan använde ett medium-försök inga och landade ändå en accepterad fix, snabbare och billigare än något annat försök.
För att prissätta en agent, summera usage för varje varv, eftersom varje varv rapporterar hela kontexten den bearbetade. Det mesta av varje varvs indata upprepar föregående varv, och den implicita cachen debiterade cirka två tredjedelar av det till cachepriset.
Enligt guiden om caching kräver cachen en prompt på minst 4 096 token, och ett varv som tillför färre än 2 050 nya token betalar full taxa på de sista 2 050 av föregående förfrågan, så loopar med små verktygsresultat sparar mindre. Till Standard-introduktionspriserna, som jag tar upp i vanliga frågor, kostade alla 6 försöken tillsammans $1,16.
Begränsningar för en AI-prestandaagent
En agent som denna fungerar bäst på problem som en profilerare kan peka på, och den här byggdes för att vara ren:
-
Flaskhalsen var planterad, som jag nämnde i början. En profilerare pekar nästan rakt på en kvadratisk loop i sex små filer, medan verkliga flaskhalsar gömmer sig i I/O, databaser och odokumenterad kod.
-
Docstrings gjorde mycket av jobbet. Argon lutade sig mot en för att avgöra vilken kopia den kunde hoppa över, och en odokumenterad kodbas ger inget att luta sig mot.
-
Tester kollar bara det någon tänkte på. I Googles ADK-fallstudie klarade en importändring den offentliga sviten och misslyckades ändå på interna testmål.
-
Tiderna kommer från en liten Linux-maskin på syntetiska arbetslaster, så dina hastighetsvinster kommer att skilja sig.
-
Varje fil agenten läser går till Google, som lagrar interaktioner på betalnivå i 55 dagar som standard;
store=falsestoppar det men utesluterprevious_interaction_id.
Googles modellkort listar också hallucinationer och tillfälliga timeoutar bland kända begränsningar.
Avslutande tankar
Agenten hittade de upprepade sammanfattningarna och deep copies i alla sex försök, behöll kopian som anropare förlitar sig på och klarade de undanhållna kontrollerna. high-tänk gav lite extra fart och en mycket större diff.
Jag skulle inte generalisera det till din kodbas, eftersom jag planterade flaskhalsen. Det som överförs är metoden: mät först, håll verktygen smala, frys koden innan du kontrollerar den och låt dolda tester avgöra resultatet.
Den första utbyggnaden jag skulle bygga är en router som börjar på medium och går till high bara när de synliga testen misslyckas, så att de dolda fallen aldrig matar tillbaka in i agenten.
Om profilerarutdata ovan är nya för dig, Writing Efficient Python Code täcker samma tids- och profileringsverktyg som jag använde innan jag lät Argon röra koden.
Vanliga frågor
Kan Gemini 4 Argon snabba upp Python-kod automatiskt?
Inte på egen hand. Interactions API kör inte verktyg åt dig ännu, så din kod gör det, och här blev kontrollkoden dubbelt så stor som appen.
Kan Gemini 4 Argon köra Python-kod själv?
Ja, med det inbyggda verktyget för kodkörning, men det stoppar efter 30 sekunder och kan inte installera pytest. För riktiga tester, använd din egen maskin eller den hostade uppsättningen i vår handledning om Managed Agents.
Bör jag använda låg tänkenivå för en sådan här agent?
Jag testade det inte, och Google säger att kvaliteten kan sjunka på svåra uppgifter. Eftersom du sätter nivån vid varje varv skulle jag prova low för att läsa filer och medium för att skriva patchar.
Hur mycket kostar Gemini 4 Argon API?
Jag betalade $2 per miljon indatatoken och $10 per miljon utdatatoken, tänk inkluderat, och de priserna fördubblas efter 30 november 2026. Flex kostar hälften, men varje förfrågan kan ta upp till 15 minuter, vilket jag bara skulle acceptera för övernattningsexperiment.
Kan jag använda den här agenten på en produktionskodbas?
Inte som skrivet, så kör det i en förbrukningscontainer och låt en person granska varje diff. Tänk också på att Argons kunskap stannar i mars 2026, så ge den aktuella dokument för nyare bibliotek.
Jag ville se vad Gemini 4 Argon gör med en Python-app som inte är trasig, bara långsam. Alla tester går igenom och alla rapporter stämmer, men vissa delar tar sekunder i stället för millisekunder, och det blir värre ju mer historik en kund har. Många AI-kodhandledningar börjar från ett fallerande test, vilket ger modellen ett uppenbart mål.
Men här pekar inga fallande tester ut den långsamma koden. Gemini 4 Argon är en Google-modell som du anropar från Python via Gemini API, och du kommer att använda den för att bygga en AI-agent, alltså en modell som vidtar åtgärder mot ett mål. I det här fallet läser, tidtar och redigerar agenten kod, men endast via verktyg som din egen Python-kod kontrollerar.
Appen heter EventFlow, ett litet fiktivt program som omvandlar kundaktivitet, köp och återköp till rapporter. Min fråga var om agenten kunde hitta den långsamma delen och fixa den utan att ändra vad appen returnerar. Om du är bekväm med Python-funktioner, klasser och att köra tester kan du följa med. Jag går igenom hur du:
Vår översikt av Gemini 4 Argon tar upp lansering och benchmark, så den här handledningen fokuserar på API:et. För en bredare modellbild, se också våra jämförelser Gemini 4 Argon vs Claude Opus 5.5 och Gemini 4 Argon vs. GPT-6 Astra.
Sammanfattning
Jag gav agenten samma uppgift 6 gånger, 3 på
mediumoch 3 påhigh, och det här blev resultatet:Argon fixade prestandaproblemet i alla 6 försök, och en separat uppsättning dolda tester höll med.
Den långsamma arbetslasten gick från cirka 2 sekunder till cirka 3 millisekunder.
Argon körde benchmark och profilerare innan den ändrade någon kod, så ge din agent de verktygen samt tester.
highkostade cirka 3x mer änmedium($0,29 mot $0,10 per försök i snitt) och skrev 8x större diffar för en modest extra hastighetsvinst. Börja påmedium.Jag planterade flaskhalsen avsiktligt i en liten app, så resultaten beskriver bara just det här fallet.