

Cos'è la Gemini 4 Argon API?
La Gemini 4 Argon API ti dà gemini-4-argon, un modello di reasoning di Google pensato per coding complesso e task agentici multi-step. Ha raggiunto la disponibilità generale a metà ottobre 2026. Secondo la pagina del modello, input, thinking e output condividono una finestra da 1.048.576 token, e una risposta sincrona si ferma a 65.536 token di output.
Google ha condotto un esperimento simile nel suo case study ADK: un'esecuzione di Antigravity di 11 ore con /goal su Python Agent Development Kit (ADK). I revisori hanno tenuto 2 proposte su 6, riducendo la preparazione della sessione di circa il 40% nelle sessioni lunghe e gli import del 21%. Questo tutorial usa invece un piccolo loop Python.
Userai quattro funzionalità dell'API:
-
L'Interactions API, l'interfaccia consigliata da Google per i nuovi progetti, che mantiene lo stato della conversazione sul server
-
Function calling, dove il modello chiede uno strumento e il tuo codice decide se eseguirlo
-
thinking_level:low,medium(predefinito) ohigh -
L'oggetto
usage, che riporta token di input, cached, output e thought
Argon chiede, e il tuo codice fa il lavoro.
Il progetto: un'app Python lenta da far correggere a Gemini 4 Argon
L'agente riceve il codice di EventFlow, 8 strumenti e nessun indizio sul rallentamento. Il codice completo è su GitHub. Inizia con EventFlow.
Come funziona EventFlow
EventFlow è un processore di eventi fittizio in sei piccoli moduli. Un evento entra in EventFlow.ingest(), validate() lo trasforma in un Event, e CustomerState lo archivia in ordine di timestamp per cliente. Poi summarize() trasforma ogni storia in sessioni, ricavi, rimborsi e conteggi di pagine, e build_report() produce un CustomerReport.
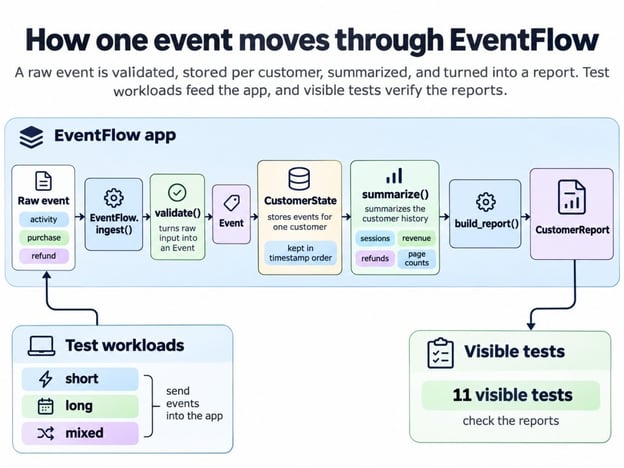
Come un evento diventa un report. Immagine dell'autore.
Le docstring di EventFlow impostano le seguenti regole:
-
Le sessioni si dividono dopo un gap di 30 minuti
-
I rimborsi sono limitati a quanto resta dell'acquisto
-
Un
event_idripetuto viene ignorato, e vince la prima copia -
Gli eventi vengono ordinati per timestamp, anche tra batch
-
history()ereport()restituiscono oggetti di cui il chiamante è proprietario
I test nascosti controllano tutte queste regole, e l'ultima tornerà più avanti.
Perché EventFlow diventa lento
Tre carichi di lavoro, costruiti da seed fissi, mostrano come la lunghezza della storia cambi il quadro:
-
short: molti clienti con 5 eventi ciascuno -
long: pochi clienti con 160 eventi ciascuno -
mixed: da 1 a 30 eventi per cliente, con duplicati ed eventi che arrivano fuori ordine
long ha molti meno eventi di short e impiega comunque circa 3 volte tanto. Il grafico mantiene il totale a 1.600 eventi aumentando la lunghezza della storia per cliente.
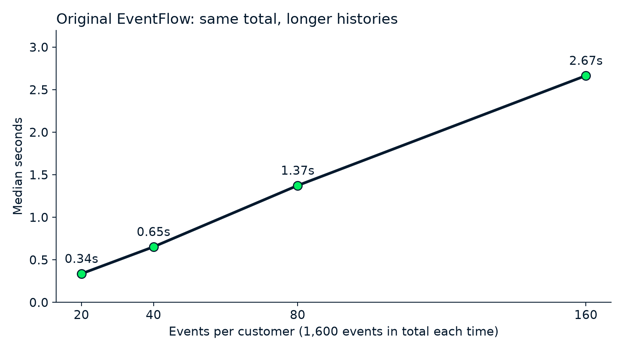
Stesso totale, storie più lunghe, elaborazione più lenta. Immagine dell'autore.
Ogni volta che la lunghezza della storia raddoppia, raddoppia anche il runtime, anche se il numero totale di eventi non cambia. Questo schema in genere indica che qualche passaggio ripete il lavoro sull'intera storia a ogni nuovo evento. L'agente non vede mai le cause, quindi le nominerò dopo che Argon avrà fatto la sua parte.
Criteri di successo e test nascosti
Una correzione vale solo se supera cinque verifiche stabilite prima della prima chiamata all'API; il report del modello non conta. Il codice finale dell'agente deve fare tutto quanto segue:
-
Andare almeno 1,5 volte più veloce su
long -
Non andare oltre il 5% più lento su
shortomixed -
Superare ogni test visibile
-
Restituire lo stesso output del report dell'originale su tutti e tre i carichi di lavoro
-
Superare ogni caso di accettazione nascosto
Queste soglie sono mie, quindi trattale come esempio. Gli strumenti dell'agente non possono raggiungere i casi nascosti; vengono eseguiti solo dopo che il suo codice è congelato. Confrontano il suo codice con un'implementazione di riferimento separata su nuovi dati, batch tardivi, duplicati e regole di proprietà.
Una suite nascosta aiuta solo se rifiuta correzioni sbagliate, quindi alimentala apposta con un paio di esse. Due scorciatoie facili qui passano ogni test visibile, eliminando la deep copy e memorizzando il riepilogo in cache senza mai aggiornarlo. I casi nascosti rifiutano entrambe.
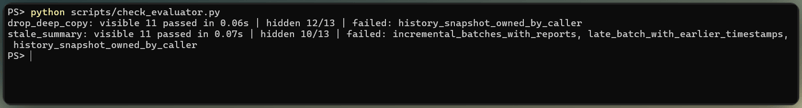
I test nascosti beccano due correzioni sbagliate. Immagine dell'autore.
Come configurare la Gemini 4 Argon API in Python
Ti serve Python 3.10 o superiore, una chiave API Gemini e un progetto Google AI Studio con billing attivo, perché la pagina prezzi non elenca un piano Free per Argon. Questo progetto blocca l'SDK google-genai alla versione 2.33.0; l'Interactions API richiede almeno la 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envSu macOS o Linux, attiva l'ambiente virtuale con source .venv/bin/activate e copia con cp, poi inserisci GEMINI_API_KEY=... in .env. Se GOOGLE_API_KEY è impostata anche nella tua shell, l'SDK usa quella invece, quindi il codice sotto la rimuove prima. Salta la prossima sottosezione se hai già usato l'Interactions API.
Fai la tua prima richiesta alla Gemini 4 Argon API
La tua prima richiesta consegna ad Argon la parte alta dell'output del profiler di EventFlow e chiede cosa mostra. load_dotenv() carica GEMINI_API_KEY da .env, genai.Client() la legge, l'ID del modello va in client.interactions.create(), e generation_config porta il livello di thinking.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Ecco cosa è tornato:
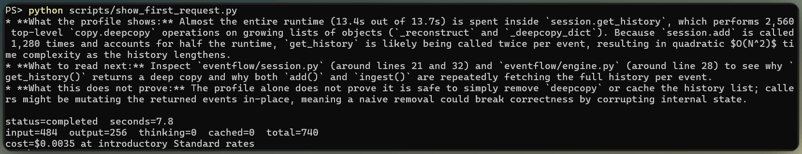
La prima richiesta ad Argon legge il profilo. Immagine dell'autore.
Argon ci ha preso; quasi tutto il tempo stava sotto get_history() e copy.deepcopy, probabilmente chiamate due volte per evento. Il suo terzo punto avvertiva che rimuovere la deep copy poteva rompere i chiamanti che modificano ciò che ricevono, che è la prima scorciatoia citata prima. Una domanda così costa poco: meno di 8 secondi e meno di mezzo centesimo, senza token di thinking.
medium è il predefinito, e la guida latest-model che ho linkato prima lo raccomanda "per la maggior parte dei task, inclusi codice complesso e casi d'uso agentici". La stessa guida dice che temperature, top_p e top_k sono ignorati su Argon, quindi lasciali fuori.
Profila il codice Python prima di usare Gemini 4 Argon
Misura l'app originale prima che il modello la tocchi, così ogni numero successivo ha qualcosa con cui confrontarsi. Prendi tre tipi di misurazione, ognuna nel proprio processo, perché ogni strumento altera gli altri:
-
Timing con
time.perf_counter(), come mediana di diversi processi freschi con un warm-up ciascuno -
Profilazione con
cProfileper trovare dove va il tempo; ha reso long circa 6 volte più lento, quindi non fidarti mai di un timing preso sotto un profiler -
Memoria con
tracemalloc, che riporta i picchi di allocazioni Python tracciate invece della memoria totale del processo
Sui tre carichi di lavoro, invece dei 1.600 eventi fissi del grafico, l'app originale ha impiegato circa 0,7 secondi su short, 2,2 su long e 1,0 su mixed. Ha anche superato ogni test pytest visibile.
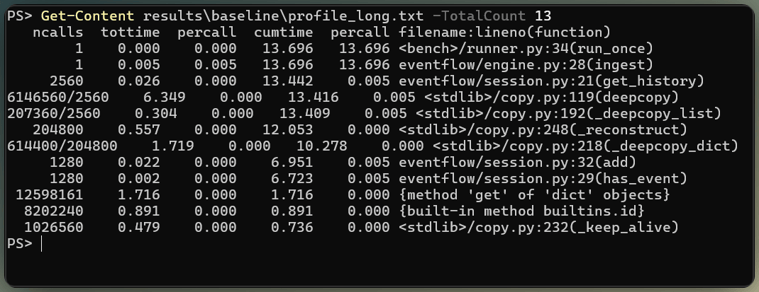
Dove l'app lenta spende tempo. Immagine dell'autore.
Aspettati drift: lo stesso codice più tardi ha impiegato circa il 10% in meno, quindi misura ogni versione in un'unica sessione.
Come costruire un agente di performance con il Function Calling di Gemini 4 Argon
Come accennato prima, Argon chiede solo gli strumenti. Il codice Python che li esegue si chiama harness, e la nostra guida all'engineering dell'harness dell'agente spiega perché i suoi controlli appartengono al codice invece che al prompt. Gli strumenti vengono prima, perché decidono cosa può toccare Argon.
Definisci gli strumenti e i permessi dell'agente
Gli 8 strumenti citati prima sono funzioni Python dichiarate come semplici schemi JSON, e solo due possono cambiare codice:
-
list_fileseread_file, limitati al sorgente Python dell'app, test e fixture -
run_profilererun_benchmarkper un carico di lavoro nominato -
apply_patch, che sostituisce un'esatta occorrenza di testo in un file sorgente esistente dell'app -
revert_file,run_testseshow_diff
Le dichiarazioni seguono il formato della guida al function calling che ho linkato prima:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Uno schema descrive la chiamata, ma non la rende sicura. L'harness aggiunge i seguenti controlli in Python:
- Ogni path viene risolto prima, così un path che esce dalla copia dell'app fallisce
- Scritture fuori dalla cartella sorgente dell'app vengono rifiutate
- Un file patchato deve ancora compilare, altrimenti la patch viene respinta
- Test e benchmark girano in sottoprocessi con timeout e senza chiave API
Non è un container, e il codice patchato potrebbe ancora leggere file fuori dalla copia, quindi trattalo come il minimo.
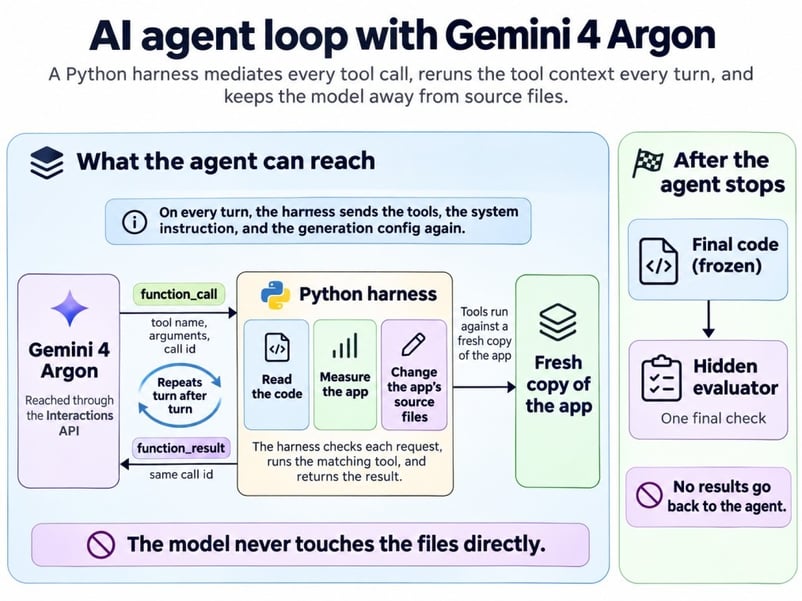
Argon chiede, Python decide ed esegue. Immagine dell'autore.
Dai all'agente un obiettivo di performance misurabile
L'istruzione di sistema stabilisce l'obiettivo e le regole ma non dice mai dove sia il rallentamento:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.L'agente decide quando fermarsi in base a ciò che può vedere: test visibili, risultati di profiler e benchmark, e i limiti impostati dal loop qui sotto.
Implementa il loop degli strumenti dell'Interactions API
Lo snippet sotto è il cuore del loop; la versione completa aggiunge il client, il dispatcher degli strumenti e i limiti. Ogni turno è una chiamata a client.interactions.create(), e Argon chiede spesso diversi strumenti in un turno, quindi esegui ogni step di function_call che restituisce. Invia ogni risultato come function_result con il call_id corrispondente:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)Il **request nella chiamata successiva è la riga che spesso si dimentica. previous_interaction_id porta la cronologia, ma tools, system_instruction e generation_config sono a livello di interazione, quindi un turno senza di essi perde gli strumenti o torna al livello di thinking predefinito. Trovo facile dimenticare questa regola, quindi il codice mantiene tutte e tre le impostazioni in un unico dict.
L'API non ha un budget per il task, quindi imposta limiti di turni, tempo e spesa nella tua applicazione prima di iniziare. Ho usato 40 turni, 10 patch, 45 minuti e 5 $, e nessun tentativo ci si è avvicinato, anche se il controllo della spesa gira tra i turni, quindi un turno lungo può superarlo. La pagina sui rate limit di Google aggiunge il proprio tetto sugli account Tier 1, 10 $ ogni 10 minuti rolling, e restituisce 429 RESOURCE_EXHAUSTED oltre tale soglia.
Esegui l'agente Gemini 4 Argon e verifica le sue modifiche
Ogni tentativo partiva da una copia fresca dell'app, si fermava da solo in circa 5 minuti e il suo codice veniva congelato prima che partisse qualsiasi controllo nascosto.
Trovare il collo di bottiglia dalle evidenze
Argon ha trovato il collo di bottiglia misurando per primo. Ecco il primo tentativo a livello medium, turno per turno.
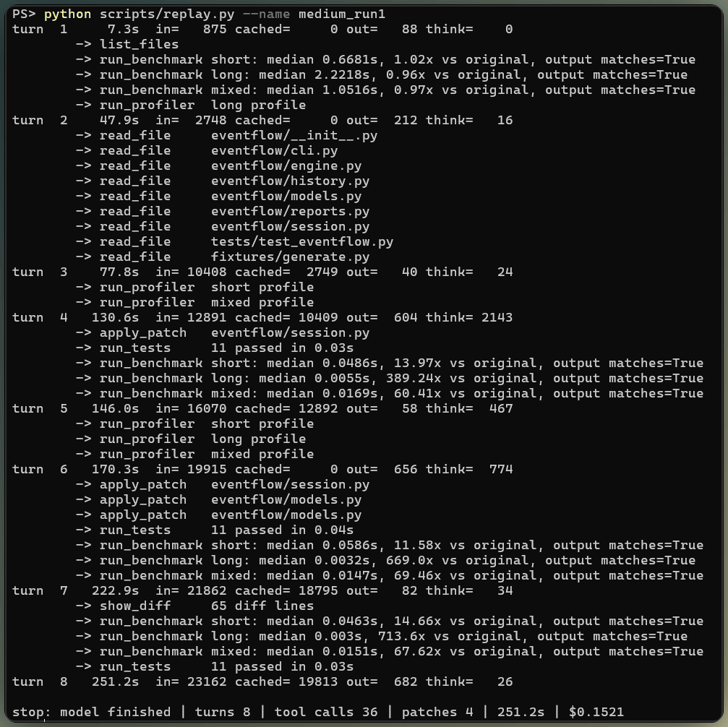
Un tentativo medium, turno per turno. Immagine dell'autore.
I suoi riassunti del pensiero, una versione condensata del ragionamento piuttosto che ogni passo, mostrano come sia arrivato alla correzione. Argon ha notato che has_event() e add() chiamano entrambi get_history(). Si è chiesto se la deep copy fosse "davvero necessaria qui, o se il requisito fosse solo che il chiamante possieda i dati", e lo ha risolto con la docstring di summarize(), che dice che la funzione non modifica il suo input.
Non ogni affermazione poggiava su evidenze. Lo stesso riassunto dice che non c'è "accesso diretto nei test o negli usi nascosti", cosa che Argon non poteva sapere. L'ipotesi ha retto (stavolta), ma è il tipo di riga da cerchiare in una review.
La correzione su cui sono arrivati tutti e sei i tentativi
Ogni tentativo ha apportato lo stesso cambiamento di base a CustomerState, e il più piccolo dei sei diff lo mostra meglio:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneOra le cause inserite che avevo promesso: add() ri-riepilogava l'intera storia a ogni evento, ogni evento pagava per due deep copy complete, e i controlli dei duplicati scandivano la lista.
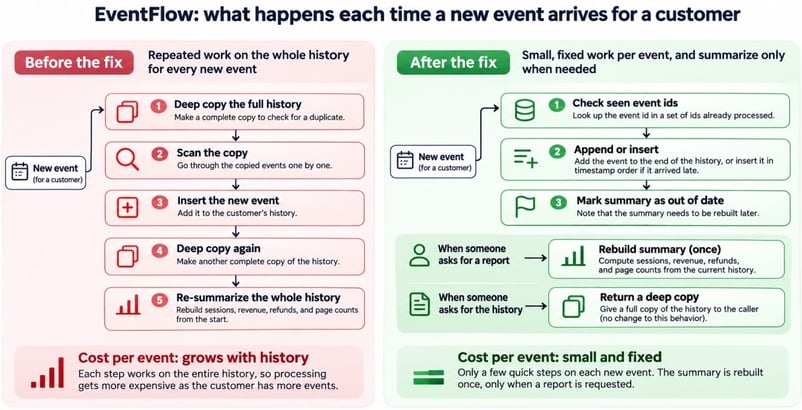
Lavoro per evento prima e dopo la correzione. Immagine dell'autore.
get_history() mantiene la sua deep copy per i chiamanti esterni, dettaglio che la scorciatoia della deep copy di prima sbaglia.
Ogni giro di patch ha passato i test visibili, quindi l'agente non ha mai dovuto fare revert, ma la maggior parte dei tentativi ha anche aggiunto un setter di summary che nessuno chiama. Nessuno lo ha chiesto, e qualcuno dovrà comunque revisionarlo.
Risultati dei test di accettazione nascosti
Il valutatore nascosto è stato eseguito una volta per tentativo, e ogni tentativo ha passato ogni caso. I casi chiamano ingest() dopo report(), inviano rimborsi prima dei loro acquisti e modificano oggetti restituiti per confermare che lo stato del motore resti intatto.
Gemini 4 Argon ha davvero reso l'app più veloce?
Sì. Ogni nuova versione è stata molto più veloce e ha restituito lo stesso output dell'originale. Come accennato prima, i tempi variano, quindi ho cronometrato l'originale e tutte e 6 le nuove versioni in ordine alternato, 9 processi freschi ciascuna.
Ogni timing copre solo ingest e report, non l'avvio di Python o gli import. A pochi millisecondi un singolo timing può risultare ben sopra la mediana, quindi confronta le mediane. La scala log del grafico evita che le nuove versioni scompaiano accanto all'originale.
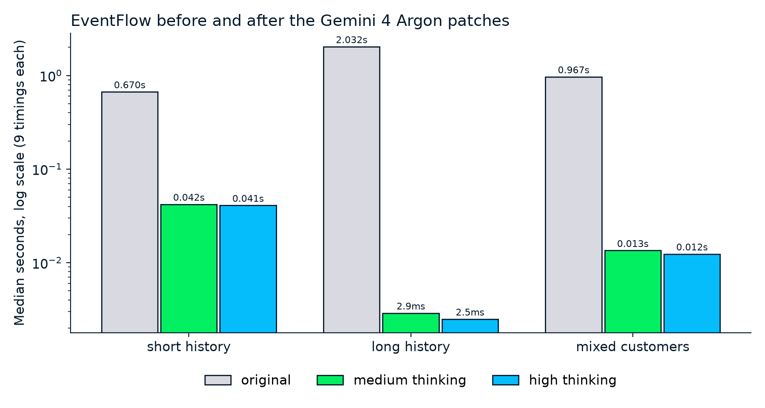
Millisecondi dopo, secondi prima, stessi output. Immagine dell'autore.
Il grafico mostra il primo tentativo a ciascun livello, e la tabella copre tutti e 6, con speedup come mediana dell'originale divisa per mediana:
|
Misura |
Originale |
Medium (3 tentativi) |
High (3 tentativi) |
|
Speedup |
Riferimento |
da 14,8x a 15,9x |
da 16,3x a 17,4x |
|
Speedup |
Riferimento |
da 656x a 701x |
circa 810x |
|
Speedup |
Riferimento |
da 65,4x a 71,6x |
da 76,8x a 78,0x |
|
Memoria tracciata di picco, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Memoria tracciata di picco, |
885 KiB |
570 KiB |
569 KiB |
long ha guadagnato di più, perché il lavoro rimosso cresceva con la storia di ciascun cliente. Le righe sulla memoria sono l'unico punto in cui la correzione costa qualcosa. short, con più clienti, ha usato circa il 10% in più, probabilmente per il nuovo set di ID per cliente, mentre long ha usato meno, probabilmente perché ha smesso di creare copie.
Non leggere 700x come qualcosa di speciale su Argon. Rimuovere un loop quadratico da dati sintetici tende a produrre numeri così, chiunque scriva la correzione.
Livelli di thinking di Gemini 4 Argon: Medium vs. High
Su questo task, high ha scritto codice leggermente più veloce di medium, ma entrambi i livelli hanno trovato la stessa correzione, quindi il thinking extra è andato nella rifinitura più che nella diagnosi.
Mantenere il confronto equo
Cambia il livello di thinking e nient'altro. Ogni tentativo ha usato lo stesso codice, prompt, strumenti, limiti e valutatore, e nessuno ha visto il lavoro di un altro tentativo. I livelli si sono alternati, 3 tentativi ciascuno, lo stesso setup che ho usato nel mio tutorial sull'API di Claude Opus 5.
Risultati, tempo e costo per livello
I due livelli si sono divisi così, medi per tentativo:
|
Media per tentativo |
Medium |
High |
|
Correzioni accettate |
3 su 3 |
3 su 3 |
|
Chiamate agli strumenti |
28 |
35 |
|
Thinking token |
1.877 |
14.764 |
|
Linee cambiate |
24 |
193 |
|
Tempo |
3,4 minuti |
5 minuti |
|
Costo al prezzo introduttivo |
0,10 $ |
0,29 $ |
|
Costo dopo la fine del prezzo |
0,20 $ |
0,58 $ |
high è arrivato alla stessa correzione nella sua prima patch e poi ha continuato a rifinire. Ha proseguito riscrivendo parti di riepilogo, reporting e validazione che non erano più il collo di bottiglia principale.
Quel vantaggio cambia con la macchina e si avvicina al rumore di misura su carichi che già finiscono in millisecondi, quindi spedirei comunque il diff più piccolo di medium solo per il tempo di review.
Il thinking di High ha raggiunto il picco al turno 4, dopo che la sua prima patch aveva già risolto il problema.
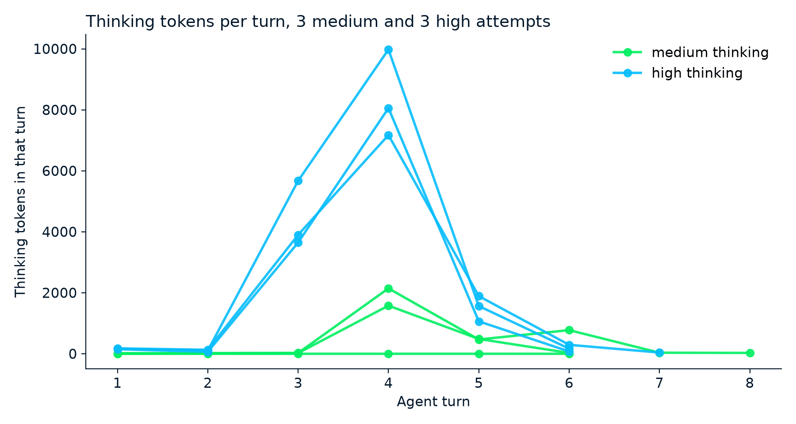
Dove ciascun tentativo ha speso il suo thinking. Immagine dell'autore.
Non prendere i thinking token come segnale di qualità, nemmeno; come la prima richiesta, un tentativo medium non ne ha usati e ha comunque prodotto una correzione accettata, più veloce ed economica di qualsiasi altro tentativo.
Per prezzare un agente, somma l'usage di ogni turno, perché ogni turno riporta l'intero contesto che ha elaborato. La maggior parte dell'input di ciascun turno ripete il turno precedente, e la cache implicita ha fatturato circa due terzi di esso a tariffa cached.
Secondo la guida al caching, la cache richiede un prompt di almeno 4.096 token, e un turno che aggiunge meno di 2.050 token nuovi paga la tariffa piena sugli ultimi 2.050 della richiesta precedente, quindi i loop con risultati degli strumenti minuscoli risparmiano meno. Alle tariffe Standard introduttive, che copro nelle FAQ, tutti e 6 i tentativi insieme sono costati 1,16 $.
Limitazioni di un agente AI per le performance
Un agente come questo funziona al meglio su problemi che un profiler può indicare, e questo è stato costruito per essere pulito:
-
Il collo di bottiglia era inserito, come ho detto all'inizio. Un profiler punta quasi dritto a un loop quadratico in sei piccoli file, mentre i rallentamenti reali si nascondono in I/O, database e codice non documentato.
-
Le docstring hanno fatto molta parte del lavoro. Argon si è appoggiato a una per decidere quale copia potesse saltare, e un codebase non documentato non gli dà nulla su cui appoggiarsi.
-
I test verificano solo ciò a cui qualcuno ha pensato. Nel case study ADK di Google, una modifica agli import ha passato la suite pubblica ma è fallita su target di test interni.
-
I timing provengono da una piccola macchina Linux su carichi sintetici, quindi i tuoi speedup saranno diversi.
-
Ogni file che l'agente legge va a Google, che conserva le interazioni a pagamento per 55 giorni per impostazione predefinita;
store=falselo impedisce ma escludeprevious_interaction_id.
La model card di Google elenca anche allucinazioni e occasionali timeout tra le limitazioni note.
Considerazioni finali
L'agente ha trovato i riepiloghi ripetuti e le deep copy in tutti e sei i tentativi, ha mantenuto la copia su cui i chiamanti fanno affidamento e ha passato i controlli trattenuti. Il thinking high ha aggiunto un po' di velocità e un diff molto più grande.
Non generalizzerei questo alla tua codebase, dato che ho inserito io il collo di bottiglia. Ciò che si trasferisce è il metodo: misura prima, tieni gli strumenti stretti, congela il codice prima di verificarlo e lascia che siano i test nascosti a decidere il risultato.
L'estensione che costruirei per prima è un router che parte da medium e passa a high solo quando i test visibili falliscono, così i casi nascosti non alimentano mai l'agente.
Se l'output del profiler sopra è nuovo per te, Writing Efficient Python Code copre gli stessi strumenti di timing e profilazione che ho usato prima di lasciare che Argon toccasse il codice.
FAQ
Gemini 4 Argon può velocizzare automaticamente il codice Python?
Non da solo. L'Interactions API non esegue ancora gli strumenti per te, quindi è il tuo codice a farlo, e qui il codice di verifica è finito per essere il doppio dell'app.
Gemini 4 Argon può eseguire codice Python da solo?
Sì, con lo strumento integrato di esecuzione del codice, ma si ferma dopo 30 secondi e non può installare pytest. Per test reali, usa la tua macchina o il setup hosted nel nostro tutorial sui Managed Agents.
Dovrei usare il thinking low per un agente come questo?
Non l'ho testato, e Google dice che la qualità può calare su task difficili. Dato che imposti il livello a ogni turno, proverei low per leggere file e medium per scrivere patch.
Quanto costa la Gemini 4 Argon API?
Ho pagato 2 $ per milione di token in input e 10 $ per milione di token in output, thinking incluso, e questi prezzi raddoppiano dopo il 30 novembre 2026. Flex costa la metà, ma ogni richiesta può richiedere fino a 15 minuti, cosa che accetterei solo per esperimenti notturni.
Posso usare questo agente su una codebase di produzione?
Non così com'è, quindi eseguila in un container usa e getta e fai revisionare ogni diff da una persona. Tieni anche presente che la conoscenza di Argon si ferma a marzo 2026, quindi forniscigli documentazione aggiornata per le librerie più nuove.

Sono un data engineer e community builder: lavoro su pipeline dati, cloud e strumenti di AI, e scrivo tutorial pratici e ad alto impatto per DataCamp e per sviluppatori alle prime armi.





Volevo vedere cosa fa Gemini 4 Argon con un'app Python che non è rotta, solo lenta. Ogni test passa e ogni report è corretto, ma parte del lavoro richiede secondi quando dovrebbe richiedere millisecondi, e peggiora più storia ha un cliente. Molti tutorial di coding AI partono da un test fallito, che offre al modello un bersaglio ovvio.
Ma qui nessun test fallito punta al codice lento. Gemini 4 Argon è un modello Google che chiami da Python tramite la Gemini API, e lo userai per costruire un agente AI, cioè un modello che compie azioni verso un obiettivo. In questo caso l'agente legge, misura e modifica il codice, ma solo tramite strumenti controllati dal tuo Python.
L'app è EventFlow, un piccolo programma fittizio che trasforma attività, acquisti e rimborsi dei clienti in report. La mia domanda era se l'agente potesse trovare la parte lenta e sistemarla senza cambiare ciò che l'app restituisce. Se ti senti a tuo agio con funzioni e classi Python e con l'esecuzione dei test, puoi seguire, e vedremo come:
La nostra panoramica di Gemini 4 Argon copre il lancio e i benchmark, quindi questo tutorial resta sull'API. Per un quadro più ampio, vedi anche i nostri confronti Gemini 4 Argon vs Claude Opus 5.5 e Gemini 4 Argon vs. GPT-6 Astra.
TL;DR
Ho dato all'agente lo stesso compito 6 volte, 3 a
mediumthinking e 3 ahigh, e questo è ciò che ne è uscito:Argon ha risolto il rallentamento in tutti e 6 i tentativi, e un set separato di test nascosti ha confermato.
Il carico di lavoro lento è passato da circa 2 secondi a circa 3 millisecondi.
Argon ha eseguito benchmark e profiler prima di cambiare qualsiasi codice, quindi dai al tuo agente quegli strumenti oltre ai test.
highè costato circa 3 volte più dimedium(0,29 $ contro 0,10 $ per tentativo, in media) e ha scritto diff 8 volte più grandi per un modesto guadagno extra in velocità. Parti damedium.Ho inserito apposta il collo di bottiglia in una piccola app, quindi questi risultati descrivono solo questo caso.