

Qu’est-ce que l’API Gemini 4 Argon ?
L’API Gemini 4 Argon vous donne gemini-4-argon, un modèle de raisonnement Google conçu pour le code complexe et les tâches multi‑étapes d’agent. Il est en disponibilité générale depuis la mi‑octobre 2026. D’après la page du modèle, l’entrée, la réflexion et la sortie partagent une fenêtre de 1 048 576 tokens, et une réponse synchrone s’arrête à 65 536 tokens de sortie.
Google a mené une expérience similaire dans son étude de cas ADK : une exécution de 11 heures d’Antigravity avec /goal sur le Python Agent Development Kit (ADK). Ses relecteurs ont conservé 2 propositions sur 6, réduisant la préparation des sessions d’environ 40 % sur les longues sessions et les imports de 21 %. Ce tutoriel utilise plutôt une petite boucle Python.
Vous utiliserez quatre fonctionnalités de l’API :
-
L’Interactions API, l’interface recommandée par Google pour les nouveaux projets, qui conserve l’état de conversation côté serveur
-
Les appels de fonctions, où le modèle demande un outil et votre code décide de l’exécuter ou non
-
thinking_level:low,medium(par défaut) ouhigh -
L’objet
usage, qui reporte les tokens d’entrée, mis en cache, de sortie et de réflexion
Argon demande, et votre code fait le travail.
Le projet : une app Python lente à accélérer avec Gemini 4 Argon
L’agent reçoit le code d’EventFlow, 8 outils, et aucun indice sur le ralentissement. Le code complet est sur GitHub. Commencez avec EventFlow.
Fonctionnement d’EventFlow
EventFlow est un processeur d’événements fictif en six petits modules. Un événement entre dans EventFlow.ingest(), validate() le transforme en Event, et CustomerState le stocke par client dans l’ordre temporel. Puis summarize() convertit chaque historique en sessions, chiffre d’affaires, remboursements et compte de pages, et build_report() produit un CustomerReport.
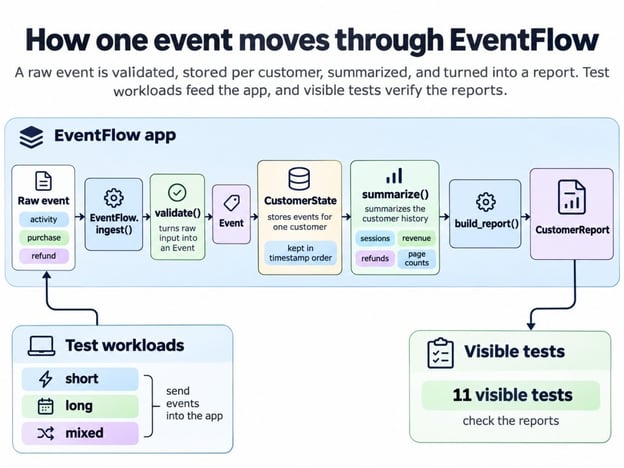
Comment un événement devient un rapport. Image de l’auteur.
Les docstrings d’EventFlow fixent les règles suivantes :
-
Les sessions se séparent après 30 minutes d’inactivité
-
Les remboursements sont plafonnés au reste de l’achat
-
Un
event_idrépété est ignoré, et la première occurrence fait foi -
Les événements sont triés par horodatage, y compris entre lots
-
history()etreport()renvoient des objets dont l’appelant est propriétaire
Les tests cachés vérifient tout cela, et le dernier point reviendra plus loin.
Pourquoi EventFlow ralentit
Trois charges, construites à partir de graines fixes, montrent comment la longueur de l’historique change la donne :
-
short: de nombreux clients avec 5 événements chacun -
long: quelques clients avec 160 événements chacun -
mixed: de 1 à 30 événements par client, avec doublons et arrivées hors ordre
long contient bien moins d’événements que short et prend pourtant environ 3× plus de temps. Le graphique garde le total à 1 600 événements en allongeant l’historique par client.
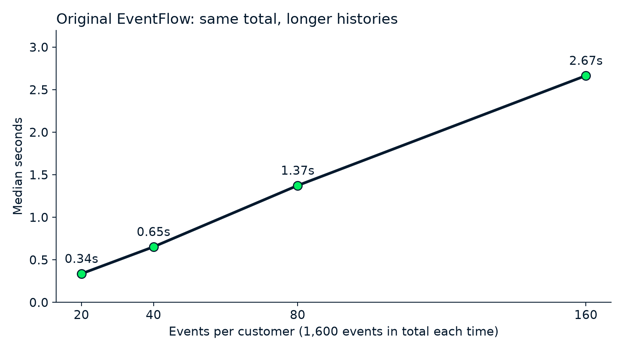
Même total, historiques plus longs, traitement plus lent. Image de l’auteur.
Chaque doublement de la longueur d’historique double le temps d’exécution, alors que le nombre total d’événements ne change pas. Ce motif suggère qu’une étape repasse tout l’historique à chaque nouvel événement. L’agent ne voit jamais les causes, je les nommerai après le passage d’Argon.
Critères de réussite et tests cachés
Une correction ne compte que si elle passe cinq contrôles définis avant la première requête API ; le rapport du modèle ne pèse pas. Le code final de l’agent doit :
-
Tourner au moins 1,5× plus vite sur
long -
Ne pas être plus lent de plus de 5 % sur
shortoumixed -
Réussir tous les tests visibles
-
Renvoyer le même rapport que l’original sur les trois charges
-
Réussir tous les cas d’acceptation cachés
Ces seuils sont les miens, à prendre en exemple. Les outils de l’agent ne peuvent pas atteindre les cas cachés ; ils tournent seulement après gel du code. Ils comparent son code à une implémentation de référence distincte sur de nouvelles données, des lots tardifs, des doublons et les règles de propriété.
Une suite cachée n’aide que si elle rejette les mauvaises corrections, donc nourrissez-la de quelques fausses pistes. Deux raccourcis évidents font passer tous les tests visibles ici : supprimer la copie profonde et mettre en cache le résumé sans jamais le rafraîchir. Les cas cachés rejettent les deux.
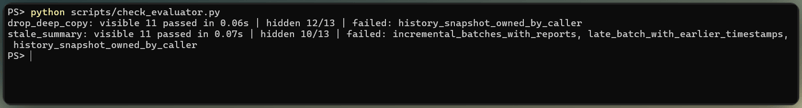
Les tests cachés attrapent deux mauvaises corrections. Image de l’auteur.
Comment configurer l’API Gemini 4 Argon en Python
Il vous faut Python 3.10 ou plus récent, une clé d’API Gemini et un projet Google AI Studio avec facturation activée, car la page tarifs n’indique pas de formule gratuite pour Argon. Ce projet fige le SDK google-genai en 2.33.0 ; l’Interactions API nécessite au moins 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envSur macOS ou Linux, activez l’environnement virtuel avec source .venv/bin/activate et copiez avec cp, puis placez GEMINI_API_KEY=... dans .env. Si GOOGLE_API_KEY est aussi défini dans votre shell, le SDK l’utilise à la place, donc le code ci‑dessous le supprime d’abord. Ignorez la sous‑section suivante si vous avez déjà utilisé l’Interactions API.
Envoyez votre première requête à l’API Gemini 4 Argon
Votre première requête donne à Argon le haut de la sortie du profileur d’EventFlow et lui demande ce qu’elle montre. load_dotenv() charge GEMINI_API_KEY depuis .env, genai.Client() la lit, l’ID du modèle va dans client.interactions.create(), et generation_config porte le niveau de réflexion.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Voici la réponse obtenue :
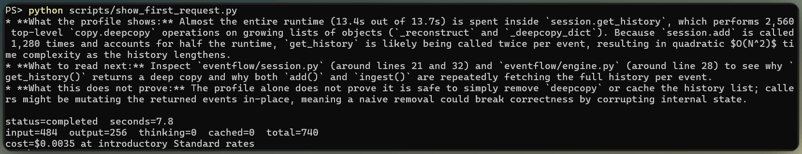
Première requête Argon lisant le profil. Image de l’auteur.
Argon a vu juste : presque tout le temps s’accumule sous get_history() et copy.deepcopy, probablement appelés deux fois par événement. Son troisième point avertit que supprimer la copie profonde pourrait casser des appelants qui modifient ce qu’ils reçoivent, ce qui est le premier raccourci évoqué plus haut. Une question de ce type coûte peu : moins de 8 secondes et moins d’un demi‑centime, sans tokens de réflexion.
medium est la valeur par défaut, et le guide « latest‑model » que j’ai lié plus haut le recommande « pour la plupart des tâches, y compris le code complexe et les cas d’usage agentiques ». Le même guide indique que temperature, top_p et top_k sont ignorés sur Argon, donc laissez‑les de côté.
Profilez votre code Python avant d’utiliser Gemini 4 Argon
Mesurez l’app originale avant que le modèle n’y touche, afin que chaque chiffre ultérieur ait une base de comparaison. Prenez trois mesures, chacune dans son propre processus, car chaque outil influence les autres :
-
Chronométrage avec
time.perf_counter(), médiane de plusieurs processus frais avec un échauffement -
Profilage avec
cProfilepour localiser où part le temps ; il a rendu la charge long environ 6× plus lente, donc ne faites jamais confiance à un temps pris sous profileur -
Mémoire avec
tracemalloc, qui reporte le pic des allocations Python suivies, pas la mémoire totale du processus
Sur les trois charges, plutôt que le total fixe de 1 600 événements du graphique, l’app d’origine a mis environ 0,7 s sur short, 2,2 s sur long et 1,0 s sur mixed. Elle a aussi réussi tous les tests pytest visibles.
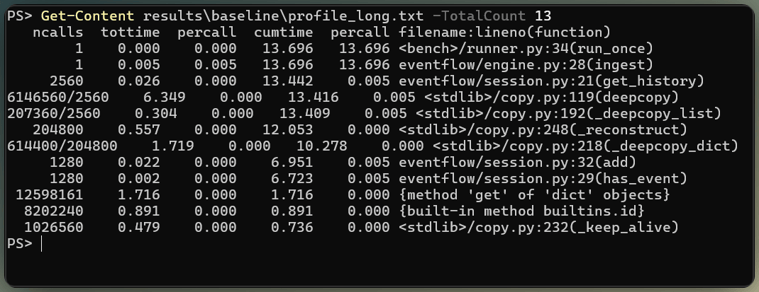
Où l’app lente passe son temps. Image de l’auteur.
Attendez‑vous à de la dérive : le même code a ensuite chronométré environ 10 % plus vite, donc mesurez chaque version dans une même session.
Construire un agent de performance avec les appels de fonctions Gemini 4 Argon
Comme mentionné plus haut, Argon se contente de demander des outils. Le code Python qui les exécute s’appelle le harnais, et notre guide d’ingénierie du harnais d’agent explique pourquoi les contrôles doivent être dans le code plutôt que dans le prompt. On commence par les outils, car ils délimitent ce qu’Argon peut toucher.
Définir les outils et permissions de l’agent
Les 8 outils évoqués sont des fonctions Python déclarées en schémas JSON simples, et seuls deux peuvent modifier le code :
-
list_filesetread_file, limités au code source Python de l’app, aux tests et aux fixtures -
run_profileretrun_benchmarkpour une charge nommée -
apply_patch, qui remplace une occurrence exacte de texte dans un fichier source existant de l’app -
revert_file,run_testsetshow_diff
Les déclarations suivent le format du guide d’appels de fonctions lié plus haut :
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Un schéma décrit l’appel, mais ne le rend pas sûr. Le harnais ajoute les contrôles suivants en Python :
- Tous les chemins sont résolus d’abord, donc un chemin qui sortirait de la copie de l’app échoue
- Les écritures hors du dossier source de l’app sont refusées
- Un fichier patché doit encore compiler, sinon le patch est rejeté
- Tests et benchmarks tournent en sous‑processus avec timeouts et sans clé d’API
Ce n’est pas un conteneur, et du code patché pourrait encore lire des fichiers hors de la copie, donc considérez‑le comme un minimum.
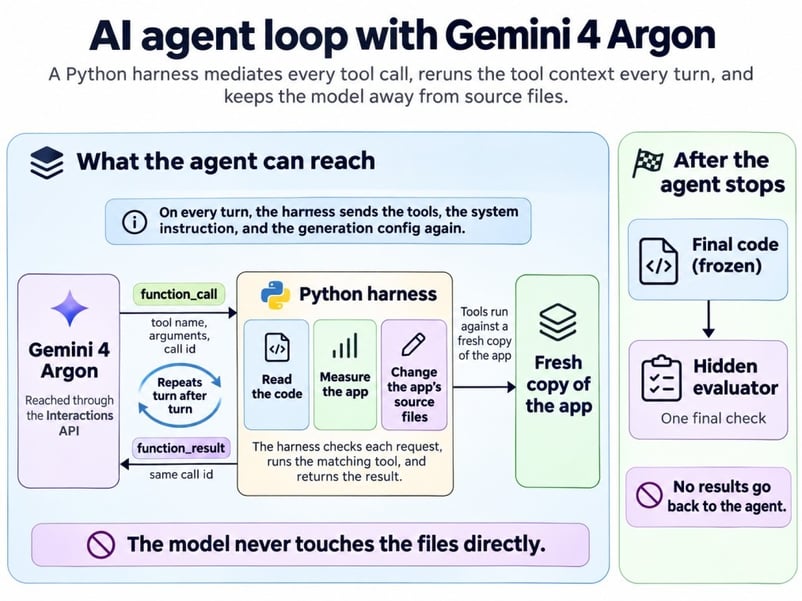
Argon demande, Python décide et exécute. Image de l’auteur.
Donnez à l’agent un objectif de performance mesurable
L’instruction système énonce l’objectif et les règles sans jamais dire où se situe le ralentissement :
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.L’agent décide quand s’arrêter selon ce qu’il peut voir : tests visibles, résultats de profilage et benchmarks, et limites que la boucle définit ensuite.
Implémentez la boucle d’outils de l’Interactions API
L’extrait ci‑dessous est le cœur de la boucle ; la version complète ajoute le client, le répartiteur d’outils et les limites. Chaque tour est un appel à client.interactions.create(), et Argon demande souvent plusieurs outils en un tour, donc exécutez chaque étape function_call qu’il renvoie. Renvoyez chaque résultat comme function_result avec le call_id correspondant :
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request sur l’appel de suivi est la ligne qu’on oublie facilement. previous_interaction_id transporte l’historique, mais tools, system_instruction et generation_config sont portés par l’interaction ; un tour sans eux perd les outils ou retombe sur le niveau de réflexion par défaut. Pour éviter l’oubli, le code garde ces trois réglages dans un même dict.
L’API n’a pas de budget de tâche, donc définissez des limites de tours, temps et dépense dans votre application avant de démarrer. J’ai utilisé 40 tours, 10 patches, 45 minutes et 5 $, et aucune tentative ne s’en est approchée, bien que le contrôle de dépense tourne entre les tours, donc un tour long peut la dépasser. La page des limites de débit de Google ajoute un plafond propre aux comptes Tier 1, 10 $ par tranche roulante de 10 minutes, et renvoie 429 RESOURCE_EXHAUSTED au‑delà.
Exécuter l’agent Gemini 4 Argon et vérifier ses changements
Chaque tentative partait d’une copie neuve de l’app, s’arrêtait d’elle‑même en environ 5 minutes, et son code était figé avant tout contrôle caché.
Trouver le goulot d’après l’évidence
Argon a trouvé le goulet en mesurant d’abord. Voici la première tentative en medium, tour par tour.
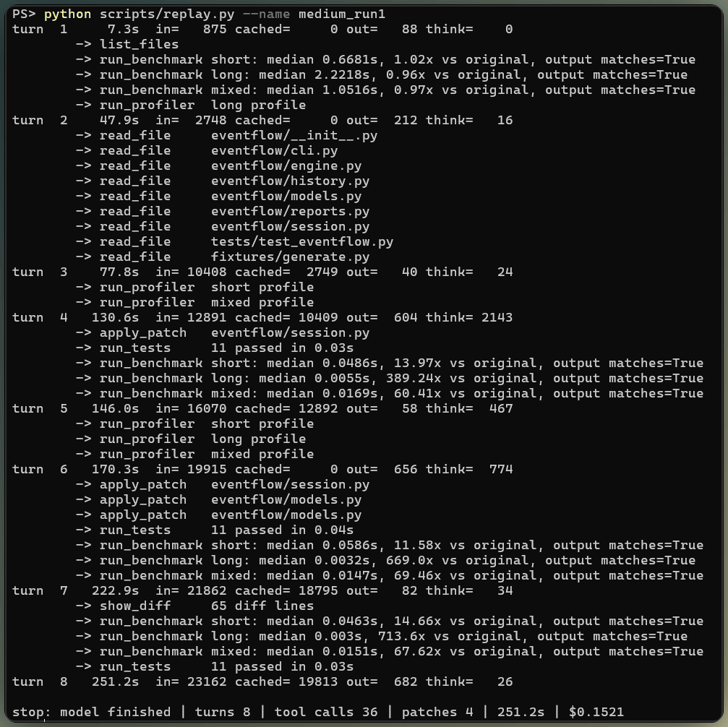
Une tentative medium, tour par tour. Image de l’auteur.
Ses résumés de réflexion, condensés de son raisonnement plutôt que chaque pas, montrent comment il est arrivé à la correction. Argon a remarqué que has_event() et add() appellent tous deux get_history(). Il s’est demandé si la copie profonde était « vraiment nécessaire ici, ou si l’exigence était simplement que l’appelant soit propriétaire des données », et a tranché avec la docstring de summarize(), qui précise que la fonction ne modifie pas son entrée.
Toute affirmation ne reposait pas sur une preuve. Le même résumé avance qu’il n’y a « aucun accès direct dans les tests ou usages cachés », ce qu’Argon ne pouvait pas savoir. L’hypothèse tenait (cette fois), mais c’est le genre de ligne à surligner en revue.
La correction retenue par les six tentatives
Chaque tentative a apporté le même changement central à CustomerState, et le plus petit des six diffs le montre le mieux :
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneVoici les causes plantées promises plus tôt : add() re‑résumait tout l’historique à chaque événement, chaque événement payait deux copies profondes complètes, et les vérifications de doublons parcouraient la liste.
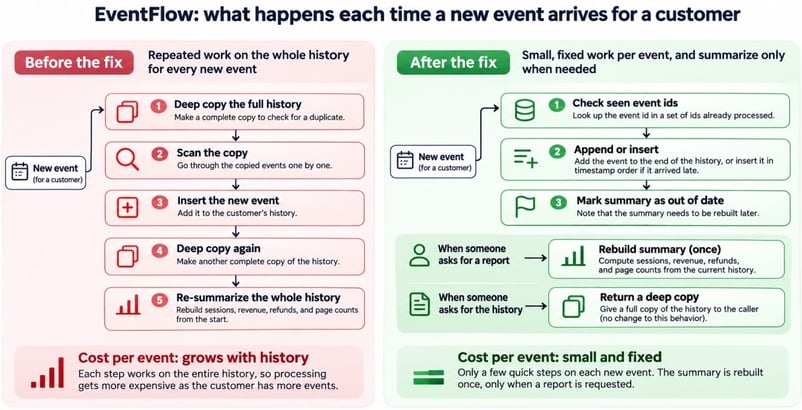
Travail par événement avant et après la correction. Image de l’auteur.
get_history() conserve sa copie profonde pour les appelants externes, détail que le raccourci « suppression de deep copy » rate.
Chaque salve de patchs a passé les tests visibles, donc l’agent n’a jamais dû annuler, mais la plupart des tentatives ont aussi ajouté un setter summary qu’aucun appelant n’utilise. Personne ne l’a demandé, et quelqu’un devra quand même le relire.
Résultats des tests d’acceptation cachés
L’évaluateur caché a tourné une fois par tentative, et toutes les tentatives ont passé tous les cas. Les cas appellent ingest() après report(), envoient des remboursements avant leurs achats, et modifient des objets retournés pour confirmer que l’état du moteur reste intact.
Gemini 4 Argon a‑t‑il vraiment accéléré l’app ?
Oui. Chaque nouvelle version était bien plus rapide et renvoyait la même sortie que l’originale. Comme indiqué, les temps dérivent, donc j’ai alterné l’original et les 6 nouvelles versions, 9 processus frais chacun.
Chaque mesure couvre seulement l’ingest et la génération des rapports, pas le démarrage Python ni les imports. À quelques millisecondes, une mesure peut être bien au‑dessus de la médiane, donc comparez les médianes. L’échelle log du graphique évite que les nouvelles versions ne disparaissent à côté de l’originale.
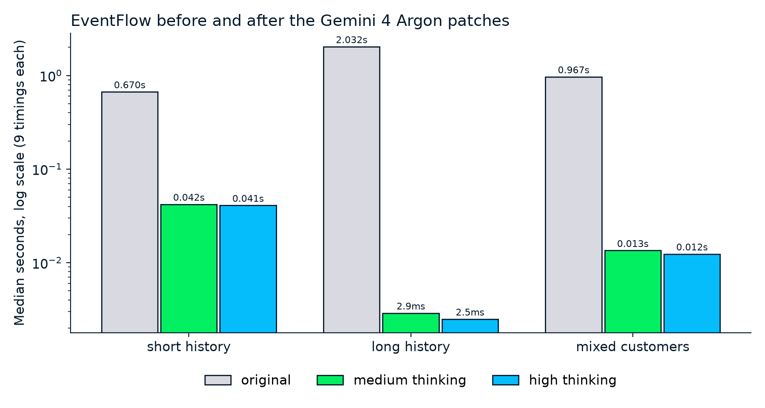
Millisecondes après, secondes avant, mêmes sorties. Image de l’auteur.
Le graphique montre la première tentative à chaque niveau, et le tableau couvre les 6, avec l’accélération comme médiane d’origine divisée par médiane nouvelle :
|
Mesure |
Original |
Medium (3 tentatives) |
High (3 tentatives) |
|
Accélération |
Référence |
14,8× à 15,9× |
16,3× à 17,4× |
|
Accélération |
Référence |
656× à 701× |
environ 810× |
|
Accélération |
Référence |
65,4× à 71,6× |
76,8× à 78,0× |
|
Mémoire suivie au pic, |
7 108 KiB |
7 822 KiB |
7 822 KiB |
|
Mémoire suivie au pic, |
885 KiB |
570 KiB |
569 KiB |
long a le plus gagné, puisque le travail supprimé croissait avec l’historique de chaque client. Les lignes mémoire sont le seul endroit où la correction coûte quelque chose. short, avec le plus de clients, a utilisé environ 10 % de plus, probablement pour l’ensemble d’IDs par client ajouté, tandis que long a consommé moins, sans doute parce qu’il a cessé de construire des copies.
Ne lisez pas 700× comme propre à Argon. Supprimer une boucle quadratique sur des données synthétiques produit souvent ce genre de chiffres, quel que soit l’auteur de la correction.
Niveaux de réflexion Gemini 4 Argon : medium vs high
Sur cette tâche, high a produit un code légèrement plus rapide que medium, mais les deux niveaux ont trouvé la même correction, donc l’effort supplémentaire s’est concentré sur la finition plus que sur le diagnostic.
Garder la comparaison équitable
Changez le niveau de réflexion et rien d’autre. Chaque tentative a utilisé le même code, prompt, outils, limites et évaluateur, et aucune n’a vu le travail des autres. Les niveaux ont alterné, 3 tentatives chacun, le même protocole que dans mon tutoriel API Claude Opus 5.
Résultats, temps et coût par niveau
La répartition des deux niveaux, en moyenne par tentative :
|
Moyenne par tentative |
Medium |
High |
|
Corrections acceptées |
3 sur 3 |
3 sur 3 |
|
Appels d’outil |
28 |
35 |
|
Tokens de réflexion |
1 877 |
14 764 |
|
Lignes modifiées |
24 |
193 |
|
Temps |
3,4 minutes |
5 minutes |
|
Coût au prix de lancement |
0,10 $ |
0,29 $ |
|
Coût après la fin de l’offre |
0,20 $ |
0,58 $ |
high a atterri sur la même correction dès son premier patch, puis a continué à polir. Il a réécrit des parties de la synthèse, du reporting et de la validation qui n’étaient plus le principal goulot.
Cet avantage varie selon la machine et se situe près du bruit de mesure sur des charges qui finissent déjà en millisecondes, donc je livrerais quand même le plus petit diff de medium, rien que pour le temps de revue.
Le pic de réflexion de high survient au tour 4, après que son premier patch a déjà corrigé le problème.
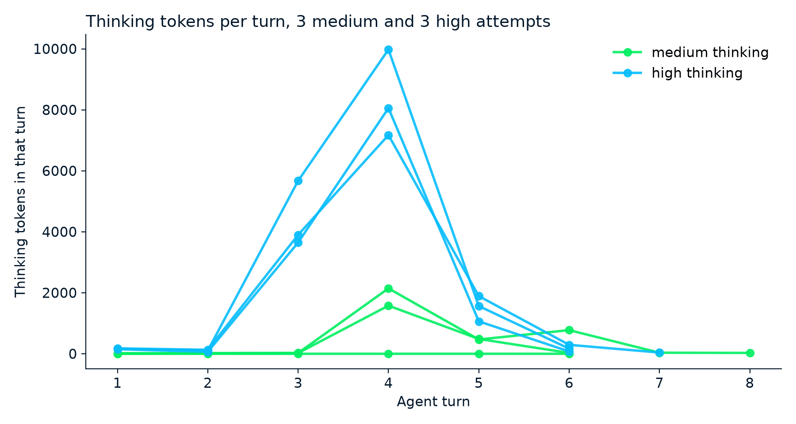
Où chaque tentative a investi sa réflexion. Image de l’auteur.
Ne prenez pas non plus les tokens de réflexion comme un signal de qualité : comme la première requête, une tentative medium n’en a utilisé aucun et a quand même produit une correction acceptée, plus vite et moins cher que toutes les autres.
Pour estimer le coût d’un agent, additionnez l’usage de chaque tour, car chaque tour reporte tout le contexte traité. La plupart de l’entrée répète le tour précédent, et le cache implicite a facturé environ les deux tiers à tarif « mis en cache ».
Selon le guide de cache, le cache requiert un prompt d’au moins 4 096 tokens, et un tour qui ajoute moins de 2 050 tokens paie le plein tarif sur les 2 050 derniers du tour précédent, donc des boucles avec de tout petits retours d’outil économisent moins. Aux tarifs Standard de lancement, détaillés dans la FAQ, les 6 tentatives ont coûté 1,16 $ au total.
Limites d’un agent IA de performance
Un agent comme celui‑ci fonctionne mieux sur des problèmes qu’un profileur peut cibler, et notre exemple est volontairement propre :
-
Le goulot a été planté, comme indiqué au début. Un profileur pointe presque directement vers une boucle quadratique dans six petits fichiers, alors que les vrais ralentissements se cachent dans l’I/O, les bases de données et le code non documenté.
-
Les docstrings ont beaucoup aidé. Argon s’est appuyé sur l’une d’elles pour décider quelle copie il pouvait éviter, et une base de code non documentée ne lui offre rien pour s’appuyer.
-
Les tests ne couvrent que ce à quoi quelqu’un a pensé. Dans l’étude de cas ADK de Google, un changement d’import passait la suite publique mais échouait sur des cibles de test internes.
-
Les mesures viennent d’une petite machine Linux sur des charges synthétiques, vos accélérations varieront donc.
-
Chaque fichier lu par l’agent part chez Google, qui stocke les interactions payantes 55 jours par défaut ;
store=falseévite cela mais interditprevious_interaction_id.
La fiche du modèle de Google liste aussi des hallucinations et des timeouts occasionnels parmi les limites connues.
Conclusion
L’agent a identifié les résumés répétés et les copies profondes lors des six tentatives, a conservé la copie dont dépendent les appelants et a passé les vérifications en aveugle. La réflexion high a ajouté un peu de vitesse pour un diff nettement plus large.
Je n’en ferais pas une généralité pour votre code, puisque j’ai semé le goulot. Ce qui se transpose, c’est la méthode : mesurer d’abord, garder des outils étroits, geler le code avant l’évaluation, et laisser les tests cachés trancher.
L’extension que je construirais en premier est un routeur qui démarre en medium et ne passe en high que lorsque les tests visibles échouent, afin que les cas cachés ne rétro‑agissent jamais dans l’agent.
Si la sortie du profileur ci‑dessus est nouvelle pour vous, Writing Efficient Python Code traite les mêmes outils de timing et de profilage utilisés avant de laisser Argon toucher au code.
FAQs
Gemini 4 Argon peut‑il accélérer du code Python automatiquement ?
Pas tout seul. L’Interactions API n’exécute pas encore les outils pour vous, donc c’est votre code qui le fait, et ici le code de vérification a fini deux fois plus gros que l’app.
Gemini 4 Argon peut‑il exécuter du code Python lui‑même ?
Oui, avec l’outil d’exécution de code intégré, mais il s’arrête au bout de 30 secondes et ne peut pas installer pytest. Pour de vrais tests, utilisez votre propre machine ou l’environnement hébergé de notre tutoriel Managed Agents.
Dois‑je utiliser un faible niveau de réflexion pour un agent comme celui‑ci ?
Je ne l’ai pas testé, et Google indique que la qualité peut baisser sur des tâches difficiles. Comme vous réglez le niveau à chaque tour, j’essaierais low pour lire des fichiers et medium pour écrire des patchs.
Combien coûte l’API Gemini 4 Argon ?
J’ai payé 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie, réflexion comprise, et ces tarifs doublent après le 30 novembre 2026. Flex coûte moitié moins, mais chaque requête peut prendre jusqu’à 15 minutes, que je n’accepterais que pour des expériences nocturnes.
Puis‑je utiliser cet agent sur un code en production ?
Pas telle quelle, donc exécutez‑la dans un conteneur jetable et faites relire chaque diff par une personne. Gardez aussi en tête que la connaissance d’Argon s’arrête en mars 2026, donc fournissez‑lui la doc à jour pour les bibliothèques récentes.

Je suis ingénieur de données et créateur de communautés. Je travaille sur les pipelines de données, le cloud et les outils d'IA, tout en rédigeant des tutoriels pratiques et percutants pour DataCamp et les développeurs émergents.







Je voulais voir ce que Gemini 4 Argon fait avec une application Python qui n’est pas cassée, juste lente. Tous les tests passent et tous les rapports sont corrects, mais certaines opérations prennent des secondes alors qu’elles devraient prendre des millisecondes, et cela empire avec l’historique des clients. De nombreux tutoriels d’IA pour le code partent d’un test en échec, qui offre une cible évidente au modèle.
Ici, aucun test en échec n’indique le code lent. Gemini 4 Argon est un modèle Google que vous appelez depuis Python via l’API Gemini, et vous l’utiliserez pour créer un agent IA, c’est‑à‑dire un modèle qui exécute des actions vers un objectif. Dans notre cas, l’agent lit, chronomètre et modifie du code, mais uniquement via des outils pilotés par votre propre Python.
L’app s’appelle EventFlow, un petit programme fictif qui transforme l’activité, les achats et les remboursements des clients en rapports. Ma question était de savoir si l’agent pouvait trouver la partie lente et la corriger sans changer le résultat de l’app. Si vous êtes à l’aise avec les fonctions et classes Python et l’exécution de tests, vous pouvez suivre. Nous verrons comment :
Notre aperçu de Gemini 4 Argon couvre le lancement et les benchmarks, donc ce tutoriel se concentre sur l’API. Pour une vue d’ensemble, consultez aussi nos comparatifs Gemini 4 Argon vs Claude Opus 5.5 et Gemini 4 Argon vs GPT-6 Astra.
Résumé
J’ai donné à l’agent la même tâche 6 fois, 3 en réflexion
mediumet 3 enhigh, voici les résultats :Argon a corrigé le ralentissement lors des 6 tentatives, et un jeu séparé de tests cachés a confirmé.
La charge lente est passée d’environ 2 secondes à environ 3 millisecondes.
Argon a lancé des benchmarks et un profileur avant de modifier du code, donc donnez à votre agent ces outils ainsi que des tests.
higha coûté environ 3× plus quemedium(0,29 $ contre 0,10 $ par tentative, en moyenne) et a produit des diffs 8× plus gros pour un gain de vitesse modeste. Commencez enmedium.J’ai installé le goulot d’étranglement volontairement dans une petite app, ces résultats décrivent donc ce cas précis.