

Czym jest Gemini 4 Argon API?
Gemini 4 Argon API daje ci gemini-4-argon — model rozumowania Google zbudowany do złożonego kodowania i wieloetapowych zadań agentów. Uzyskał ogólną dostępność w połowie października 2026. Zgodnie ze stroną modelu wejście, myślenie i wyjście współdzielą jedno okno 1 048 576 tokenów, a synchroniczna odpowiedź zatrzymuje się przy 65 536 tokenach wyjścia.
Google przeprowadziło podobny eksperyment w swoim studium przypadku ADK: 11-godzinny bieg Antigravity z /goal na Python Agent Development Kit (ADK). Recenzenci zachowali 2 z 6 propozycji, skracając przygotowanie sesji o około 40% w długich sesjach i importy o 21%. Ten samouczek zamiast tego używa małej pętli w Pythonie.
Użyjesz czterech funkcji API:
-
Interactions API — zalecanego przez Google interfejsu dla nowych projektów, który trzyma stan rozmowy po stronie serwera
-
Wywoływania funkcji, gdzie model prosi o narzędzie, a twój kod decyduje, czy je uruchomić
-
thinking_level:low,medium(domyślny) lubhigh -
Obiektu
usage, który raportuje tokeny wejściowe, z cache’a, wyjściowe i myślenia
Argon prosi, a twój kod wykonuje pracę.
Projekt: wolna aplikacja w Pythonie do naprawy przez Gemini 4 Argon
Agent dostaje kod EventFlow, 8 narzędzi i żadnej wskazówki o spowolnieniu. Pełny kod jest na GitHubie. Zacznij od EventFlow.
Jak działa EventFlow
EventFlow to fikcyjny procesor zdarzeń w sześciu małych modułach. Zdarzenie trafia do EventFlow.ingest(), validate() zamienia je w Event, a CustomerState przechowuje je w kolejności znaczników czasu na klienta. Potem summarize() zamienia każdą historię w sesje, przychody, zwroty i liczniki stron, a build_report() tworzy CustomerReport.
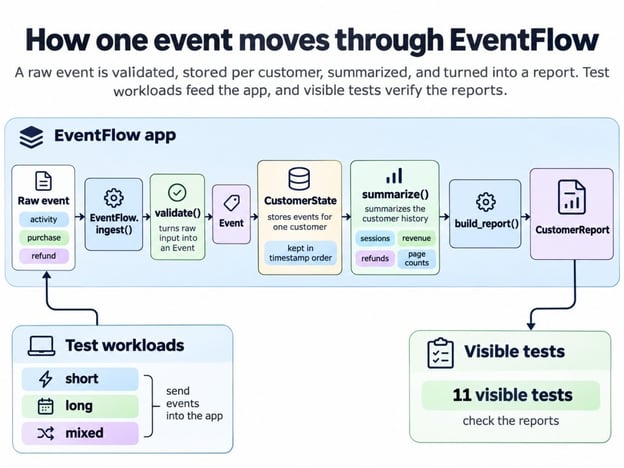
Jak jedno zdarzenie staje się raportem. Obraz: autor.
Docstringi EventFlow określają następujące zasady:
-
Sesje dzielą się po 30 minutach przerwy
-
Zwroty są ograniczone do tego, co pozostało z zakupu
-
Powtórzony
event_idjest ignorowany, a wygrywa pierwsza kopia -
Zdarzenia sortują się po znaczniku czasu, także między partiami
-
history()ireport()zwracają obiekty, których właścicielem jest wywołujący
Ukryte testy sprawdzają wszystkie, a ostatnia zasada wróci później.
Dlaczego EventFlow zwalnia
Trzy obciążenia, zbudowane ze stałych seedów, pokazują, jak długość historii zmienia obraz:
-
short: wielu klientów z 5 zdarzeniami każdy -
long: kilku klientów ze 160 zdarzeniami każdy -
mixed: od 1 do 30 zdarzeń na klienta, z duplikatami i zdarzeniami przychodzącymi poza kolejnością
long ma znacznie mniej zdarzeń niż short, a mimo to trwa około 3x dłużej. Wykres trzyma łącznie 1 600 zdarzeń, jednocześnie wydłużając historię pojedynczego klienta.
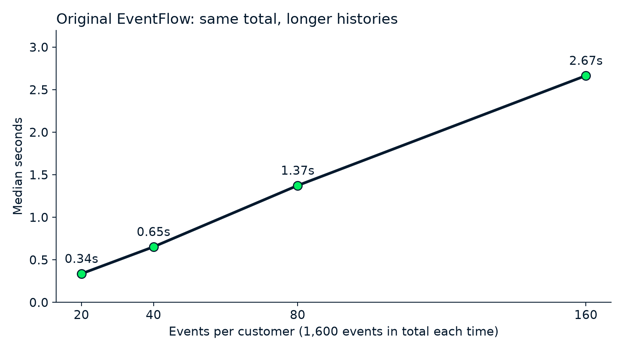
Ta sama łączna liczba, dłuższe historie, wolniejsze przetwarzanie. Obraz: autor.
Za każdym podwojeniem długości historii czas wykonania też się podwaja, mimo że całkowita liczba zdarzeń się nie zmienia. Taki wzorzec zwykle oznacza, że jakiś krok powtarza pracę nad całą historią przy każdym nowym zdarzeniu. Agent nigdy nie widzi przyczyn, więc nazwę je po tym, jak Argon zrobi swoje.
Kryteria sukcesu i ukryte testy
Poprawka liczy się tylko wtedy, gdy przejdzie pięć sprawdzeń ustalonych przed pierwszym wywołaniem API; własny raport modelu nie ma znaczenia. Końcowy kod agenta musi:
-
Działać co najmniej 1,5x szybciej na
long -
Nie być wolniejszy niż o 5% na
shortlubmixed -
Przejść wszystkie widoczne testy
-
Zwracać taki sam raport jak oryginał na wszystkich trzech obciążeniach
-
Przejść wszystkie ukryte przypadki akceptacyjne
Te progi są moje, więc potraktuj je jako przykład. Narzędzia agenta nie mogą dotrzeć do ukrytych przypadków; uruchamiają się dopiero po zamrożeniu jego kodu. Porównują jego kod z oddzielną implementacją referencyjną na nowych danych, późnych partiach, duplikatach i zasadach własności.
Ukryty zestaw pomaga tylko, jeśli odrzuca błędne poprawki, więc podrzuć mu na próbę kilka. Dwa proste skróty przechodzą tu wszystkie widoczne testy: porzucenie głębokiej kopii i cache’owanie podsumowania bez jego odświeżania. Ukryte przypadki odrzucają oba.
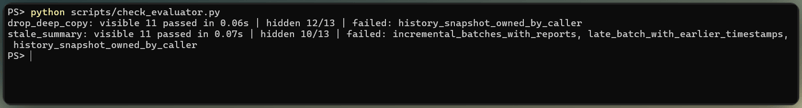
Ukryte testy wyłapują dwie błędne poprawki. Obraz: autor.
Jak skonfigurować Gemini 4 Argon API w Pythonie
Potrzebujesz Pythona 3.10 lub nowszego, klucza Gemini API i projektu w Google AI Studio z włączonym rozliczaniem, ponieważ strona cen nie wymienia darmowej taryfy dla Argon. Ten projekt przypina SDK google-genai w wersji 2.33.0; Interactions API wymaga co najmniej 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envNa macOS lub Linuksie aktywuj wirtualne środowisko komendą source .venv/bin/activate i kopiuj poleceniem cp, a następnie umieść GEMINI_API_KEY=... w .env. Jeśli GOOGLE_API_KEY jest też ustawiony w twojej powłoce, SDK użyje jego zamiast, więc poniższy kod najpierw go usuwa. Pomiń następną sekcję, jeśli używałeś wcześniej Interactions API.
Zrób swoje pierwsze żądanie do Gemini 4 Argon API
Twoje pierwsze żądanie podaje Argonowi górę wyjścia profilera EventFlow i pyta, co z niego wynika. load_dotenv() ładuje GEMINI_API_KEY z .env, genai.Client() go czyta, ID modelu trafia do client.interactions.create(), a generation_config niesie poziom myślenia.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Oto, co wróciło:
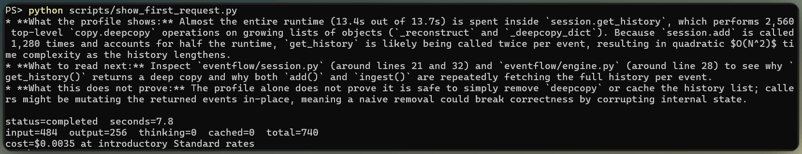
Pierwsze żądanie do Argona czyta profil. Obraz: autor.
Argon trafił; niemal cały czas siedział pod get_history() i copy.deepcopy, prawdopodobnie wołanych dwa razy na zdarzenie. Trzeci punktor ostrzegł, że usunięcie głębokiej kopii może złamać wywołujących, którzy modyfikują to, co dostają — to pierwszy skrót, o którym wspomniałem. Takie pytanie jest tanie: poniżej 8 sekund i mniej niż pół centa, bez tokenów myślenia.
medium jest domyślne, a przewodnik latest-model, który podlinkowałem, zaleca je „do większości zadań, w tym złożonego kodu i przypadków agentowych”. Ten sam przewodnik mówi, że temperature, top_p i top_k są ignorowane na Argonie, więc je pomiń.
Profiluj kod Pythona przed użyciem Gemini 4 Argon
Zmierz oryginalną aplikację, zanim model jej dotknie, żeby każde późniejsze liczby miały punkt odniesienia. Zrób trzy rodzaje pomiarów, każdy w osobnym procesie, bo każde narzędzie zaburza pozostałe:
-
Pomiar czasu przez
time.perf_counter()jako medianę kilku świeżych procesów z jednym rozgrzewkowym -
Profilowanie przez
cProfile, by znaleźć, gdzie ucieka czas; spowolniło long około 6x, więc nigdy nie ufaj czasom mierzonym pod profilerem -
Pamięć przez
tracemalloc, który raportuje szczyt śledzonych alokacji Pythona, a nie całkowitą pamięć procesu
Na trzech obciążeniach, zamiast stałych 1 600 zdarzeń z wykresu, oryginalna aplikacja zajęła około 0,7 s na short, 2,2 na long i 1,0 na mixed. Przeszła też wszystkie widoczne testy pytest.
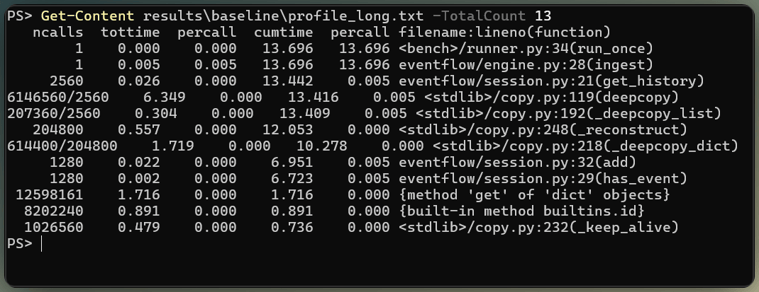
Gdzie wolna aplikacja spędza czas. Obraz: autor.
Spodziewaj się dryfu: ten sam kod później był o ok. 10% szybszy, więc mierz każdą wersję w jednej sesji.
Jak zbudować agenta wydajności z funkcją wywołań w Gemini 4 Argon
Jak wspomniałem, Argon tylko prosi o narzędzia. Pytonowy kod, który je uruchamia, to harness, a nasz przewodnik po inżynierii harnessu agenta wyjaśnia, dlaczego sprawdzenia powinny być w kodzie, a nie w promptcie. Najpierw narzędzia, bo to one decydują, czego Argon może dotknąć.
Zdefiniuj narzędzia i uprawnienia agenta
Wspomniane 8 narzędzi to funkcje Pythona zadeklarowane jako proste schematy JSON, a tylko dwa mogą zmieniać kod:
-
list_filesiread_file, ograniczone do źródeł Pythona aplikacji, testów i fixtures -
run_profilerirun_benchmarkdla jednego nazwanego obciążenia -
apply_patch, które zastępuje jedno dokładne wystąpienie tekstu w istniejącym pliku źródłowym aplikacji -
revert_file,run_testsishow_diff
Deklaracje podążają za formatem z przewodnika o wywoływaniu funkcji, który podlinkowałem:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Schemat opisuje wywołanie, ale nie czyni go bezpiecznym. Harness dodaje następujące sprawdzenia w Pythonie:
- Każda ścieżka jest najpierw rozwijana, więc ścieżka uciekająca poza skopiowaną aplikację kończy się błędem
- Zapisy poza folderem źródeł aplikacji są odrzucane
- Załatany plik musi się nadal kompilować, inaczej łatka jest odrzucana
- Testy i benchmarki działają w podprocesach z limitami czasu i bez klucza API
To nie jest kontener i załatany kod wciąż może czytać pliki poza kopią, więc traktuj to jako minimum.
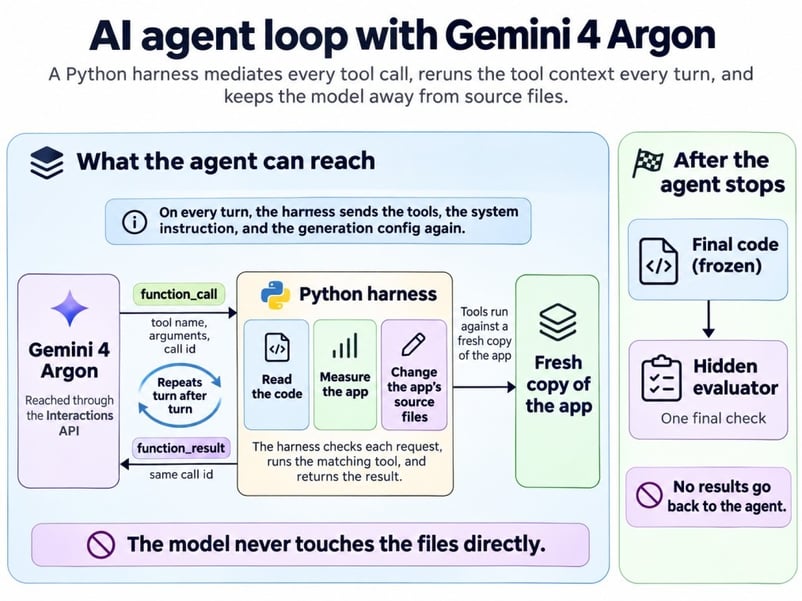
Argon prosi, Python decyduje i uruchamia. Obraz: autor.
Daj agentowi mierzalny cel wydajności
Instrukcja systemowa podaje cel i zasady, ale nigdy nie mówi, gdzie jest spowolnienie:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.Agent sam decyduje, kiedy skończyć, na podstawie tego, co widzi: widocznych testów, wyników profilera i benchmarków oraz limitów ustawionych przez pętlę dalej.
Zaimplementuj pętlę narzędzi Interactions API
Fragment poniżej to rdzeń pętli; pełna wersja dodaje klienta, dyspozytora narzędzi i limity. Każda tura to jedno wywołanie client.interactions.create(), a Argon często prosi o kilka narzędzi w jednej turze, więc uruchamiaj każdy krok function_call, który zwróci. Każdy wynik odeślij jako function_result ze zgodnym call_id:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)**request przy wywołaniu follow-up to linijka, którą łatwo zgubić. previous_interaction_id niesie historię, ale tools, system_instruction i generation_config są w zakresie interakcji, więc tura bez nich traci narzędzia albo wraca do domyślnego poziomu myślenia. Łatwo o tym zapomnieć, więc kod trzyma te trzy ustawienia w jednym dict.
API nie ma budżetu zadania, więc ustaw limity tur, czasu i wydatków w aplikacji, zanim zaczniesz. Użyłem 40 tur, 10 łatek, 45 minut i 5 USD i żadna próba się nie zbliżyła, choć sprawdzanie wydatków działa między turami, więc jedna długa tura może to przekroczyć. Strona limitów Google dodaje własny pułap na kontach Tier 1 — 10 USD na 10-minutowe okno — i zwraca 429 RESOURCE_EXHAUSTED po jego przekroczeniu.
Uruchom agenta Gemini 4 Argon i zweryfikuj jego zmiany
Każda próba startowała ze świeżej kopii aplikacji, sama się zatrzymywała w ok. 5 minut i miała zamrożony kod, zanim ruszył jakikolwiek ukryty test.
Znajdowanie wąskiego gardła na podstawie dowodów
Argon znalazł wąskie gardło, zaczynając od pomiarów. Oto pierwsza próba przy medium, tura po turze.
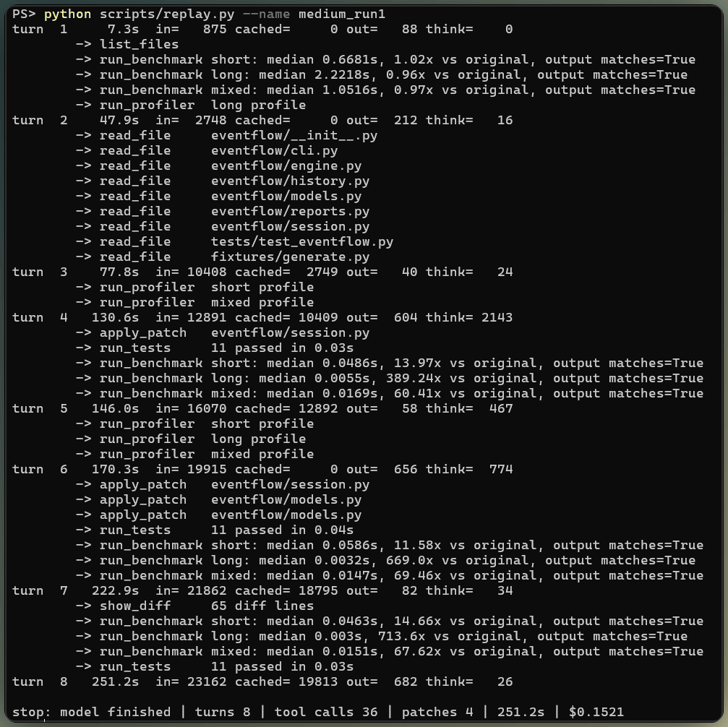
Jedna próba medium, tura po turze. Obraz: autor.
Podsumowania myśli — skondensowana wersja rozumowania, a nie każdy krok — pokazują drogę do poprawki. Argon zauważył, że has_event() i add() oba wołają get_history(). Zapytał, czy głęboka kopia jest „tu rzeczywiście konieczna, czy wymagane jest jedynie, by wywołujący był właścicielem danych”, i rozstrzygnął to docstringiem summarize(), który mówi, że funkcja nie modyfikuje wejścia.
Nie każda teza miała oparcie w dowodach. To samo podsumowanie mówi o „braku bezpośredniego dostępu w testach lub ukrytych użyciach”, czego Argon nie mógł wiedzieć. Trafił (tym razem), ale to linia do zakreślenia w review.
Poprawka, na którą trafiło wszystkich sześć prób
Każda próba zrobiła tę samą kluczową zmianę w CustomerState, a najmniejszy z diffów pokazuje to najlepiej:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneTeraz obiecane zasiane przyczyny: add() podsumowywało całą historię przy każdym zdarzeniu, każde zdarzenie płaciło za dwie pełne głębokie kopie, a sprawdzanie duplikatów skanowało listę.
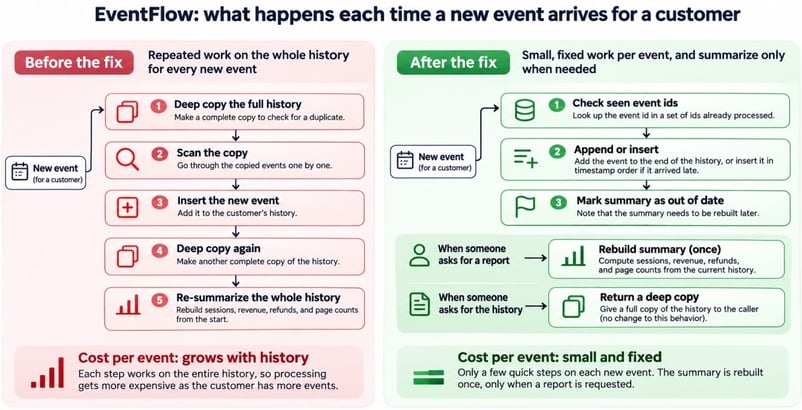
Praca na zdarzenie: przed i po poprawce. Obraz: autor.
get_history() zachowuje głęboką kopię dla wywołujących z zewnątrz, co odróżnia to od skrótu bez głębokiej kopii, o którym wcześniej wspomniałem.
Każda runda łatek przechodziła widoczne testy, więc agent nie musiał nic cofać, ale większość prób dodała też setter summary, którego nikt nie woła. Nikt o to nie prosił i ktoś nadal musi to zreviewować.
Wyniki ukrytych testów akceptacyjnych
Ukryty ewaluator uruchamiał się raz na próbę i każda przeszła wszystkie przypadki. Przypadki wołają ingest() po report(), wysyłają zwroty przed ich zakupami i modyfikują zwracane obiekty, by potwierdzić, że stan silnika pozostaje nienaruszony.
Czy Gemini 4 Argon faktycznie przyspieszył aplikację?
Tak. Każda nowa wersja była dużo szybsza i zwracała ten sam wynik co oryginał. Jak wspomniałem, czasy dryfują, więc mierzyłem oryginał i wszystkie 6 nowych wersji w naprzemiennej kolejności, po 9 świeżych procesów.
Każdy pomiar obejmuje tylko ingest i raporty, nie start Pythona ani importy. Przy kilku milisekundach pojedynczy pomiar może wyjść sporo ponad medianę, więc porównuj mediany. Skala logarytmiczna na wykresie zapobiega znikaniu nowych wersji przy oryginale.
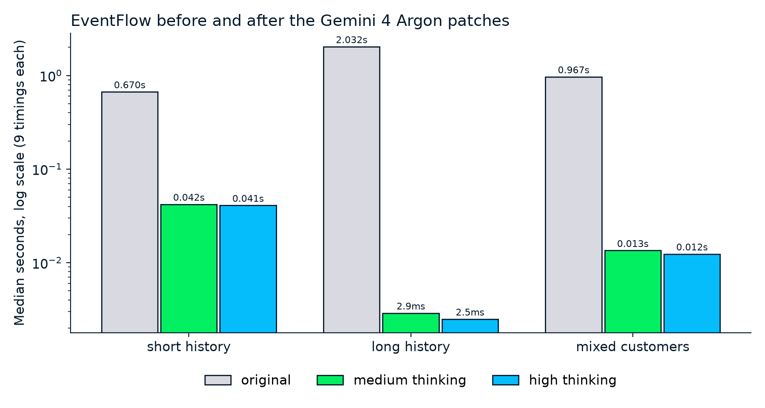
Milisekundy po, sekundy przed, te same wyniki. Obraz: autor.
Wykres pokazuje pierwszą próbę na każdym poziomie, a tabela obejmuje wszystkie 6, z przyspieszeniem jako oryginalna mediana podzielona przez nową medianę:
|
Miara |
Oryginał |
Medium (3 próby) |
High (3 próby) |
|
Przyspieszenie |
Odniesienie |
14,8x do 15,9x |
16,3x do 17,4x |
|
Przyspieszenie |
Odniesienie |
656x do 701x |
około 810x |
|
Przyspieszenie |
Odniesienie |
65,4x do 71,6x |
76,8x do 78,0x |
|
Szczyt śledzonej pamięci, |
7 108 KiB |
7 822 KiB |
7 822 KiB |
|
Szczyt śledzonej pamięci, |
885 KiB |
570 KiB |
569 KiB |
long zyskał najwięcej, bo usunięta praca rosła wraz z historią klienta. Wiersze pamięci to jedyne miejsce, gdzie poprawka coś kosztuje. short, z największą liczbą klientów, użył ok. 10% więcej — zapewne przez nowy zbiór ID per klient — podczas gdy long mniej, bo przestał budować kopie.
Nie czytaj 700x jako czegoś wyjątkowego dla Argona. Usunięcie pętli kwadratowej z syntetycznych danych zwykle daje takie liczby, bez względu na to, kto pisze poprawkę.
Poziomy myślenia Gemini 4 Argon: Medium vs High
W tym zadaniu high napisał kod nieco szybszy niż medium, ale oba poziomy znalazły tę samą poprawkę, więc dodatkowe myślenie poszło w polerowanie, nie diagnozę.
Utrzymanie uczciwego porównania
Zmień poziom myślenia i nic więcej. Każda próba używała tego samego kodu, promptu, narzędzi, limitów i ewaluatora, i żadna nie widziała pracy innej próby. Poziomy się przeplatały, po 3 próby każde — ten samy setup, co w moim samouczku Claude Opus 5 API.
Wyniki, czas i koszt według poziomu
Poziomy rozkładają się tak, średnio na próbę:
|
Średnio na próbę |
Medium |
High |
|
Przyjęte poprawki |
3 z 3 |
3 z 3 |
|
Wywołania narzędzi |
28 |
35 |
|
Tokeny myślenia |
1 877 |
14 764 |
|
Zmiany linii |
24 |
193 |
|
Czas |
3,4 min |
5 min |
|
Koszt w cenie wprowadzającej |
0,10 USD |
0,29 USD |
|
Koszt po zakończeniu tej ceny |
0,20 USD |
0,58 USD |
high trafił w tę samą poprawkę w pierwszej łatce, a potem dalej polerował. Przepisał części podsumowywania, raportowania i walidacji, które nie były już głównym wąskim gardłem.
Ta przewaga zmienia się z maszyną i leży blisko szumu pomiarowego przy obciążeniach kończących się w milisekundach, więc i tak wysłałbym mniejszego diffa z medium choćby ze względu na czas review.
Myślenie na high szczytowało w turze 4, po tym, jak pierwsza łatka już rozwiązała problem.
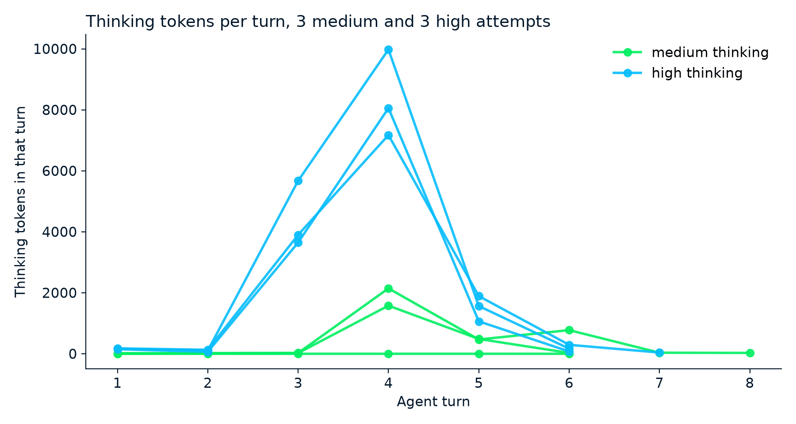
Gdzie każda próba wydała swoje myślenie. Obraz: autor.
Nie traktuj też tokenów myślenia jako sygnału jakości; jak w pierwszym żądaniu, jedna próba medium nie użyła ich wcale i mimo to dostarczyła przyjętą poprawkę — najszybszą i najtańszą ze wszystkich prób.
Żeby wycenić agenta, zsumuj usage każdej tury, bo każda raportuje pełen kontekst, który przetworzyła. Większość wejścia każdej tury powtarza poprzednią, a niejawny cache naliczał około dwóch trzecich w stawce cache’owanej.
Zgodnie z przewodnikiem o cache’u cache wymaga promptu co najmniej 4 096 tokenów, a tura dodająca mniej niż 2 050 nowych tokenów płaci pełną stawkę za ostatnie 2 050 z poprzedniego żądania, więc pętle z malutkimi wynikami narzędzi oszczędzają mniej. W standardowych cenach wprowadzających, które omawiam w FAQ, wszystkie 6 prób razem kosztowało 1,16 USD.
Ograniczenia agenta wydajności AI
Taki agent działa najlepiej na problemach, które profiler potrafi wskazać, a ten został zbudowany na czysto:
-
Wąskie gardło było zasiane, jak wspomniałem na początku. Profiler wskazuje prawie wprost pętlę kwadratową w sześciu małych plikach, podczas gdy prawdziwe spowolnienia kryją się w I/O, bazach i nieudokumentowanym kodzie.
-
Docstringi zrobiły sporą robotę. Argon oparł się na jednym, by zdecydować, którą kopię może pominąć, a nieudokumentowana baza nie daje mu się na czym oprzeć.
-
Testy sprawdzają tylko to, co ktoś wymyślił. W studium przypadku ADK Google jedna zmiana importów przeszła publiczny zestaw, a mimo to zawiodła wewnętrzne cele testowe.
-
Pomiary pochodzą z małej maszyny z Linuksem i syntetycznych obciążeń, więc twoje przyspieszenia będą inne.
-
Każdy plik, który agent czyta, trafia do Google, które domyślnie przechowuje interakcje z płatnej warstwy przez 55 dni;
store=falseto zatrzymuje, ale wykluczaprevious_interaction_id.
Karta modelu Google model card także wymienia halucynacje i sporadyczne timeouty wśród znanych ograniczeń.
Na koniec
Agent znalazł powtarzające się podsumowania i głębokie kopie we wszystkich sześciu próbach, zachował kopię, na której polegają wywołujący, i przeszedł odseparowane sprawdzenia. high dodał trochę szybkości i znacznie większego diff-a.
Nie uogólniałbym tego na twoją bazę kodu, bo wąskie gardło zasadziłem. To, co się przenosi, to metoda: najpierw mierz, trzymaj narzędzia wąskie, zamrażaj kod przed sprawdzaniem i pozwól ukrytym testom decydować o wyniku.
Pierwsze rozszerzenie, które bym zbudował, to router zaczynający od medium i przechodzący na high tylko wtedy, gdy widoczne testy padają — tak, by ukryte przypadki nigdy nie wracały do agenta.
Jeśli wyjście profilera powyżej jest dla ciebie nowe, Writing Efficient Python Code pokrywa te same narzędzia do pomiarów czasu i profilowania, których użyłem, zanim Argon dotknął kodu.
FAQs
Czy Gemini 4 Argon potrafi automatycznie przyspieszyć kod Pythona?
Nie samo z siebie. Interactions API nie uruchamia ci narzędzi, więc robi to twój kod, i tutaj kod sprawdzający urósł do dwukrotności rozmiaru aplikacji.
Czy Gemini 4 Argon może sam uruchamiać kod Pythona?
Tak, z wbudowanym narzędziem wykonywania kodu, ale zatrzymuje się po 30 sekundach i nie może zainstalować pytest. Do prawdziwych testów użyj własnej maszyny albo środowiska hostowanego z naszego samouczka o Managed Agents.
Czy używać niskiego poziomu myślenia dla takiego agenta?
Nie testowałem, a Google mówi, że jakość może spadać przy trudnych zadaniach. Ponieważ ustawiasz poziom w każdej turze, spróbowałbym low do czytania plików i medium do pisania łatek.
Ile kosztuje Gemini 4 Argon API?
Płaciłem 2 USD za milion tokenów wejścia i 10 USD za milion tokenów wyjścia, w tym myślenie, a te ceny podwajają się po 30 listopada 2026. Flex kosztuje połowę, ale każde żądanie może trwać do 15 minut, co zaakceptowałbym tylko do nocnych eksperymentów.
Czy mogę użyć tego agenta na produkcyjnej bazie kodu?
Nie w tej postaci, więc uruchamiaj go w jednorazowym kontenerze i niech człowiek przejrzy każdy diff. Pamiętaj też, że wiedza Argona kończy się w marcu 2026, więc dawaj mu aktualną dokumentację nowszych bibliotek.
Chciałem sprawdzić, co Gemini 4 Argon zrobi z aplikacją w Pythonie, która nie jest zepsuta — tylko wolna. Wszystkie testy przechodzą i każdy raport jest poprawny, ale część pracy zajmuje sekundy, choć powinna milisekundy, i pogarsza się to wraz z długością historii klienta. Wiele samouczków AI o kodowaniu zaczyna od nieudanego testu, który daje modelowi oczywisty cel.
Ale tutaj żaden padający test nie wskazuje wolnego fragmentu. Gemini 4 Argon to model Google, który wywołujesz z Pythona przez Gemini API, i użyjesz go do zbudowania agenta AI, czyli modelu, który podejmuje działania w kierunku celu. W tym przypadku agent czyta, mierzy i edytuje kod, ale wyłącznie za pomocą narzędzi kontrolowanych przez twojego Pythona.
Aplikacja to EventFlow, mały fikcyjny program, który zamienia aktywność klientów, zakupy i zwroty w raporty. Pytanie brzmiało, czy agent potrafi znaleźć wąskie gardło i naprawić je bez zmiany zwracanego wyniku. Jeśli czujesz się swobodnie z funkcjami i klasami w Pythonie oraz uruchamianiem testów, możesz iść krok w krok. Pokażę, jak:
Nasz przegląd Gemini 4 Argon omawia premierę i benchmarki, więc ten samouczek skupia się na API. Szerszy obraz modelu znajdziesz także w porównaniach Gemini 4 Argon vs Claude Opus 5.5 oraz Gemini 4 Argon vs. GPT-6 Astra.
TL;DR
Dałem agentowi to samo zadanie 6 razy — 3 przy
mediumi 3 przyhigh— i to z tego wyszło:Argon naprawił spowolnienie we wszystkich 6 próbach, co potwierdził oddzielny zestaw ukrytych testów.
Wolne zadanie zeszło z około 2 sekund do około 3 milisekund.
Argon uruchomił benchmarki i profiler, zanim zmienił jakikolwiek kod, więc daj swojemu agentowi te narzędzia oraz testy.
highkosztował około 3x więcej niżmedium(średnio 0,29 USD vs 0,10 USD za próbę) i pisał diffy 8x większe, dając skromny dodatkowy zysk w szybkości. Zacznij odmedium.Wąskie gardło zasadziłem celowo w małej aplikacji, więc te wyniki opisują wyłącznie ten przypadek.