

O que é a API Gemini 4 Argon?
A API Gemini 4 Argon disponibiliza o gemini-4-argon, um modelo de raciocínio do Google criado para código complexo e tarefas agenticas em múltiplas etapas. Chegou à disponibilidade geral em meados de outubro de 2026. De acordo com a página do modelo, entrada, raciocínio e saída compartilham uma janela única de 1.048.576 tokens, e uma resposta síncrona para em 65.536 tokens de saída.
O Google conduziu um experimento parecido no estudo de caso do ADK: uma execução de 11 horas do Antigravity com /goal no Python Agent Development Kit (ADK). Seus revisores aprovaram 2 de 6 propostas, cortando o preparo de sessão em cerca de 40% em sessões longas e as importações em 21%. Este tutorial usa um pequeno loop em Python no lugar.
Você vai usar quatro recursos da API:
-
A Interactions API, interface recomendada pelo Google para novos projetos, que mantém o estado da conversa no servidor
-
Function calling, em que o modelo pede uma ferramenta e seu código decide se a executa
-
thinking_level:low,medium(padrão) ouhigh -
O objeto
usage, que reporta tokens de entrada, em cache, de saída e de raciocínio
O Argon pede, e seu código faz o trabalho.
O projeto: um app Python lento para o Gemini 4 Argon corrigir
O agente recebe o código do EventFlow, 8 ferramentas e nenhuma dica sobre a lentidão. O código completo está no GitHub. Comece pelo EventFlow.
Como o EventFlow funciona
EventFlow é um processador de eventos fictício em seis módulos pequenos. Um evento entra em EventFlow.ingest(), validate() o transforma em um Event, e CustomerState o guarda em ordem de timestamp por cliente. Depois, summarize() transforma cada histórico em sessões, receita, reembolsos e contagem de páginas, e build_report() produz um CustomerReport.
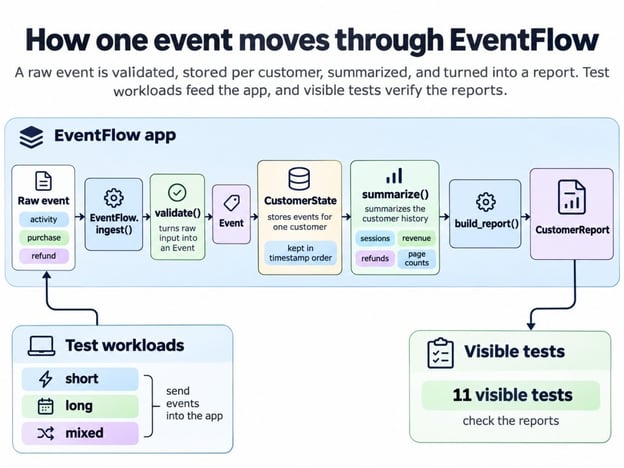
Como um evento vira um relatório. Imagem do autor.
Os docstrings do EventFlow definem as seguintes regras:
-
As sessões se separam após uma lacuna de 30 minutos
-
Reembolsos são limitados ao que resta da compra
-
Um
event_idrepetido é ignorado, e a primeira cópia prevalece -
Eventos são ordenados por timestamp, mesmo entre lotes
-
history()ereport()retornam objetos que pertencem ao chamador
Os testes ocultos verificam todos esses pontos — e o último volta a aparecer mais tarde.
Por que o EventFlow fica lento
Três cargas de trabalho, construídas com seeds fixas, mostram como o tamanho do histórico muda o cenário:
-
short: muitos clientes com 5 eventos cada -
long: poucos clientes com 160 eventos cada -
mixed: de 1 a 30 eventos por cliente, com duplicatas e eventos fora de ordem
long tem bem menos eventos que short e ainda assim leva cerca de 3x mais tempo. O gráfico mantém o total em 1.600 eventos, aumentando o histórico por cliente.
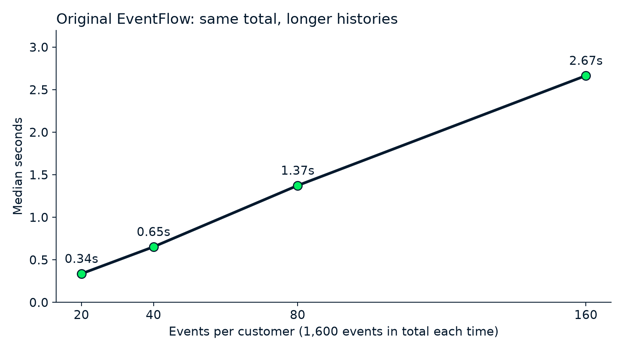
Mesmo total, históricos maiores, processamento mais lento. Imagem do autor.
Cada vez que o histórico dobra, o tempo de execução dobra também, embora o número total de eventos não mude. Esse padrão costuma indicar que algum passo repete trabalho sobre todo o histórico a cada novo evento. O agente nunca vê as causas, então vou nomeá-las depois de o Argon cumprir seu papel.
Critérios de sucesso e testes ocultos
Uma correção só conta se passar em cinco verificações definidas antes da primeira chamada à API; o relatório do próprio modelo não pesa nada. O código final do agente precisa:
-
Rodar pelo menos 1,5x mais rápido em
long -
Rodar no máximo 5% mais lento em
shortoumixed -
Passar em todos os testes visíveis
-
Retornar a mesma saída de relatório que o original nas três cargas
-
Passar em todos os casos ocultos de aceitação
Esses limites são meus — use como exemplo. As ferramentas do agente não alcançam os casos ocultos; eles rodam só depois que o código é congelado. Eles comparam o código do agente com uma implementação de referência separada em dados novos, lotes tardios, duplicatas e as regras de propriedade.
Uma suíte oculta só ajuda se rejeitar soluções erradas, então alimente-a com algumas de propósito. Dois atalhos simples passam em todos os testes visíveis aqui: remover o deep copy e fazer cache do resumo sem nunca atualizá-lo. Os casos ocultos reprovam ambos.
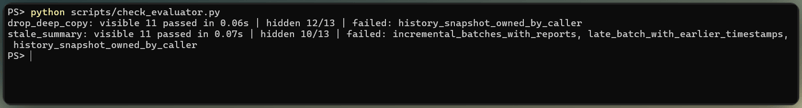
Testes ocultos capturam duas correções erradas. Imagem do autor.
Como configurar a API Gemini 4 Argon em Python
Você precisa do Python 3.10 ou mais recente, de uma chave da API do Gemini e de um projeto no Google AI Studio com cobrança ativada, porque a página de preços não lista camada gratuita para o Argon. Este projeto fixa o SDK google-genai na versão 2.33.0; a Interactions API requer pelo menos a 2.3.0.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envNo macOS ou Linux, ative o ambiente virtual com source .venv/bin/activate e copie com cp. Depois, coloque GEMINI_API_KEY=... em .env. Se GOOGLE_API_KEY também estiver definido no seu shell, o SDK usa ele no lugar — então o código abaixo o remove antes. Pule a próxima subseção se você já usou a Interactions API.
Faça sua primeira requisição à API Gemini 4 Argon
Sua primeira requisição entrega ao Argon o topo da saída do profiler do EventFlow e pergunta o que ela mostra. load_dotenv() carrega GEMINI_API_KEY do .env, genai.Client() lê, o ID do modelo vai em client.interactions.create(), e generation_config define o nível de raciocínio.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Aqui está o que voltou:
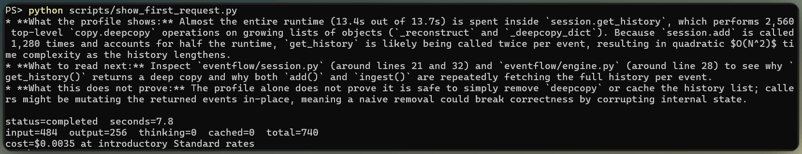
Primeira requisição: Argon lê o profile. Imagem do autor.
O Argon acertou: quase todo o tempo ficou em get_history() e copy.deepcopy, provavelmente chamados duas vezes por evento. O terceiro bullet alertou que remover o deep copy pode quebrar chamadores que modificam o que recebem — que é justamente o primeiro atalho que citei. Uma pergunta como essa é barata: menos de 8 segundos e menos de meio centavo, sem tokens de raciocínio.
medium é o padrão, e o guia de latest-model que linkei recomenda esse nível "para a maioria das tarefas, incluindo código complexo e casos agenticos". O mesmo guia diz que temperature, top_p e top_k são ignorados no Argon — pode deixar de fora.
Faça profile do código Python antes de usar o Gemini 4 Argon
Meça o app original antes de o modelo tocar nele, para que cada número posterior tenha base de comparação. Faça três tipos de medição, cada uma em seu próprio processo, porque cada ferramenta distorce as outras:
-
Tempo com
time.perf_counter(), como a mediana de vários processos novos, com um aquecimento cada -
Profile com
cProfilepara descobrir onde o tempo vai; ele deixoulongcerca de 6x mais lento, então nunca confie em tempos medidos sob profiler -
Memória com
tracemalloc, que reporta picos de alocações Python rastreadas em vez da memória total do processo
Nas três cargas (não no gráfico com 1.600 eventos fixos), o app original levou cerca de 0,7 s em short, 2,2 s em long e 1,0 s em mixed. Ele também passou em todos os testes visíveis do pytest.
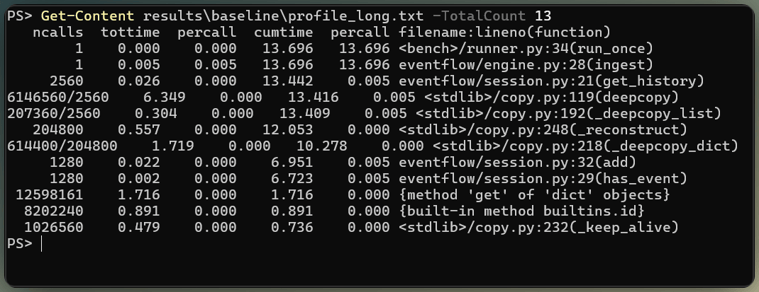
Onde o app lento gasta tempo. Imagem do autor.
Espere variação: o mesmo código depois mediu cerca de 10% mais rápido — meça todas as versões na mesma sessão.
Como construir um agente de performance com function calling do Gemini 4 Argon
Como mencionei, o Argon só pede ferramentas. O código Python que as executa é o harness, e nosso guia de engenharia de harness para agentes explica por que as verificações devem ficar no código, não só no prompt. As ferramentas vêm primeiro, porque elas definem o que o Argon pode tocar.
Defina as ferramentas e permissões do agente
As 8 ferramentas citadas são funções Python declaradas como schemas JSON simples — e só duas podem alterar código:
-
list_fileseread_file, limitadas ao código-fonte Python do app, testes e fixtures -
run_profilererun_benchmarkpara uma carga nomeada -
apply_patch, que substitui uma ocorrência exata de um texto em um arquivo-fonte do app -
revert_file,run_testseshow_diff
As declarações seguem o formato do guia de function calling que linkei:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Um schema descreve a chamada, mas não a torna segura. O harness adiciona estas checagens em Python:
- Toda path é resolvida antes, então um caminho que escape da cópia do app falha
- Gravações fora da pasta de código-fonte do app são recusadas
- O arquivo modificado ainda precisa compilar, ou o patch é rejeitado
- Testes e benchmarks rodam em subprocessos com timeouts e sem chave de API
Isso não é um container, e código alterado ainda pode ler arquivos fora da cópia — trate como o mínimo aceitável.
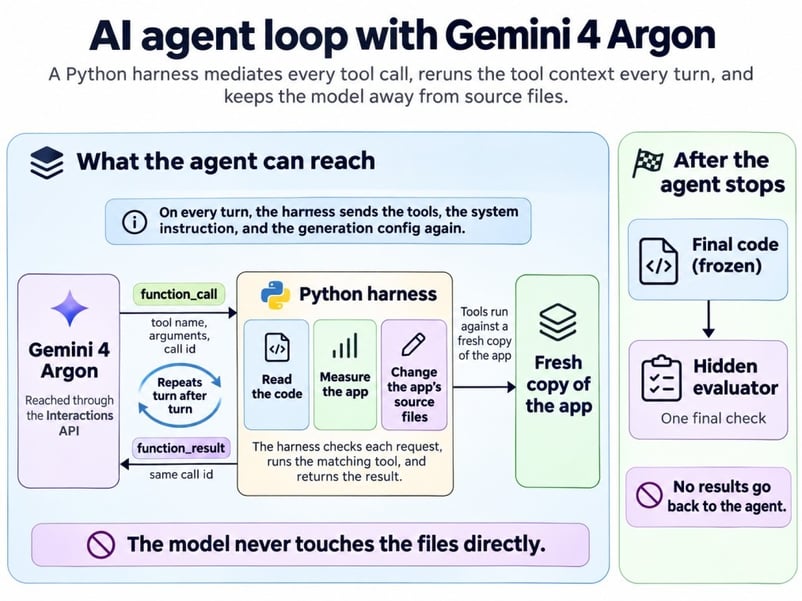
O Argon pede, o Python decide e executa. Imagem do autor.
Dê ao agente uma meta de performance mensurável
A instrução de sistema define a meta e as regras, mas nunca diz onde está a lentidão:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.O agente decide quando parar pelo que consegue ver: testes visíveis, resultados do profiler e do benchmark, e os limites definidos pelo loop a seguir.
Implemente o loop de ferramentas da Interactions API
O trecho abaixo é o núcleo do loop; a versão completa adiciona o client, o despachante de ferramentas e limites. Cada turno é uma chamada a client.interactions.create(), e o Argon costuma pedir várias ferramentas em um turno, então execute cada etapa de function_call que ele retornar. Envie cada resultado de volta como function_result com o call_id correspondente:
# requires_action significa "rode minhas ferramentas"; incomplete quer dizer que o limite de saída cortou o turno
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # a meta mostrada acima
tools=DECLARATIONS, # os 8 schemas, como o apply_patch acima
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # falhou, foi cortado ou concluiu
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validado, roda localmente
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# limites da aplicação aqui: 40 turnos, 45 minutos, US$ 5
# **request novamente: tools, instruction e config não carregam entre turnos
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)O **request na chamada seguinte é a linha que muita gente esquece. previous_interaction_id carrega o histórico, mas tools, system_instruction e generation_config têm escopo da interação, então um turno sem eles perde as ferramentas ou volta ao nível de raciocínio padrão. Para não esquecer, o código mantém as três configurações em um único dict.
A API não tem orçamento de tarefa, então defina limites de turnos, tempo e gasto na sua aplicação antes de começar. Usei 40 turnos, 10 patches, 45 minutos e US$ 5 — nenhuma tentativa chegou perto. Só atenção que o gasto é checado entre turnos, então um turno longo pode estourá-lo. A página de limites do Google adiciona um teto para contas Tier 1: US$ 10 por 10 minutos contínuos, retornando 429 RESOURCE_EXHAUSTED após isso.
Rode o agente Gemini 4 Argon e verifique as mudanças
Cada tentativa começou de uma cópia nova do app, parou sozinha em cerca de 5 minutos e teve o código congelado antes de rodar qualquer checagem oculta.
Encontrando o gargalo com evidências
O Argon encontrou o gargalo medindo primeiro. Aqui está a primeira tentativa em nível médio, turno a turno.
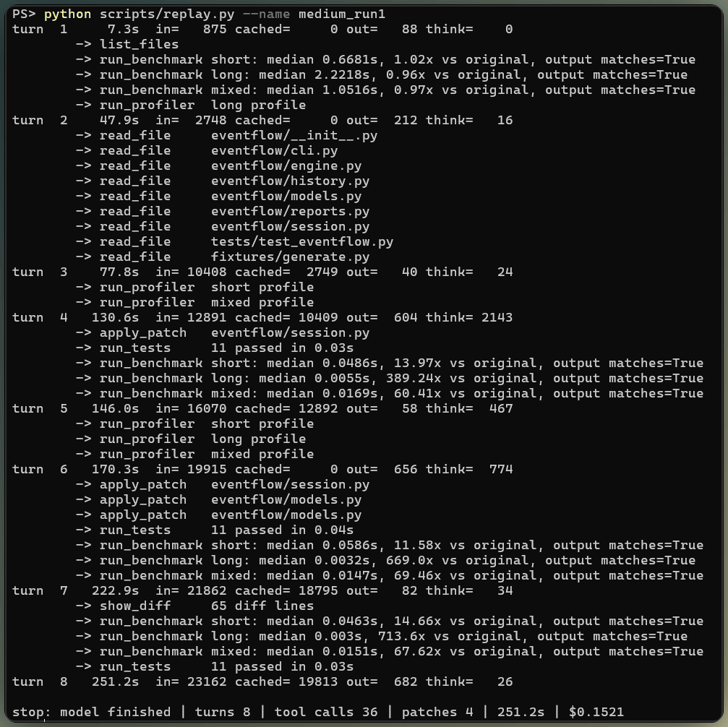
Uma tentativa em medium, turno a turno. Imagem do autor.
Os resumos de pensamento — uma versão condensada do raciocínio, não cada passo — mostram como chegou à correção. O Argon percebeu que has_event() e add() chamavam ambos get_history(). Perguntou se o deep copy era "realmente necessário aqui ou se a exigência é só que o chamador seja dono dos dados", e resolveu com o docstring de summarize(), que diz que a função não modifica a entrada.
Nem toda afirmação se apoiou em evidências. O mesmo resumo diz que "não há acesso direto em testes ou usos ocultos", algo que o Argon não teria como saber. O palpite se sustentou (desta vez), mas é o tipo de linha para circular na revisão.
A correção em que as seis tentativas chegaram
Toda tentativa fez a mesma mudança central em CustomerState, e o menor dos seis diffs mostra melhor:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneAgora, as causas plantadas que prometi: add() re-sumarizava o histórico inteiro a cada evento, cada evento pagava por duas cópias profundas, e a checagem de duplicidade varria a lista.
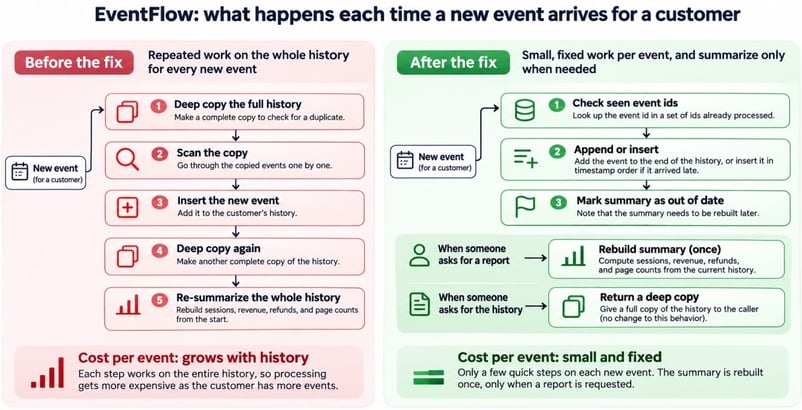
Trabalho por evento: antes e depois da correção. Imagem do autor.
get_history() mantém o deep copy para chamadores externos — exatamente o detalhe que o atalho do deep copy ignora.
Cada rodada de patches passou nos testes visíveis, então o agente não precisou reverter — mas a maioria das tentativas também adicionou um setter de summary que ninguém chama. Ninguém pediu, e ainda vai precisar de revisão humana.
Resultados dos testes ocultos de aceitação
O avaliador oculto rodou uma vez por tentativa, e todas passaram em todos os casos. Os casos chamam ingest() depois de report(), enviam reembolsos antes de suas compras e modificam objetos retornados para confirmar que o estado do engine permanece intacto.
O Gemini 4 Argon realmente deixou o app mais rápido?
Sim. Todas as versões novas ficaram muito mais rápidas e retornaram a mesma saída do original. Como comentei, os tempos variam, então medi o original e as 6 versões novas em ordem alternada, 9 processos novos cada.
Cada medição cobre ingestão e relatórios, não a inicialização do Python ou importações. Em milissegundos, uma única medição pode sair bem acima da mediana — compare as medianas. A escala log do gráfico evita que as versões novas "sumam" ao lado do original.
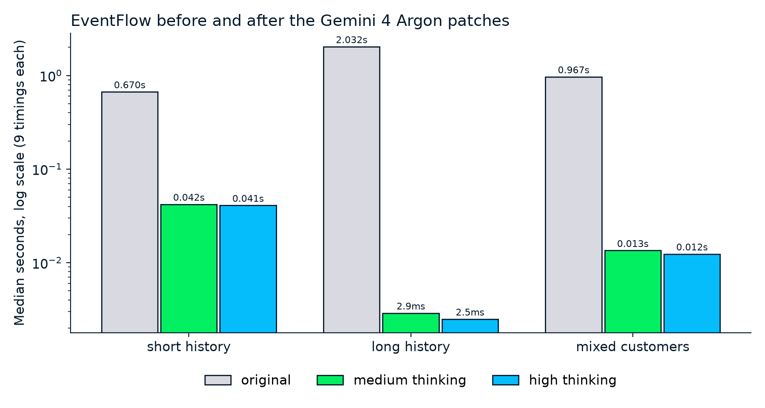
Milissegundos depois, segundos antes — mesma saída. Imagem do autor.
O gráfico mostra a primeira tentativa em cada nível, e a tabela cobre as 6, com ganho calculado como mediana do original dividida pela mediana da nova versão:
|
Métrica |
Original |
Medium (3 tentativas) |
High (3 tentativas) |
|
Ganho em |
Referência |
14,8x a 15,9x |
16,3x a 17,4x |
|
Ganho em |
Referência |
656x a 701x |
cerca de 810x |
|
Ganho em |
Referência |
65,4x a 71,6x |
76,8x a 78,0x |
|
Pico de memória rastreada, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Pico de memória rastreada, |
885 KiB |
570 KiB |
569 KiB |
long ganhou mais, já que o trabalho removido crescia com o histórico de cada cliente. As linhas de memória são o único lugar onde a correção custa algo. short, com mais clientes, usou cerca de 10% a mais — provavelmente pelo novo set de IDs por cliente. Já long usou menos, possivelmente porque parou de construir cópias.
Não leia 700x como algo especial do Argon. Remover um laço quadrático em dados sintéticos tende a produzir números assim, seja lá quem fizer a correção.
Níveis de raciocínio do Gemini 4 Argon: medium vs. high
Nesta tarefa, high escreveu código um pouco mais rápido que medium, mas ambos encontraram a mesma correção — o pensamento extra foi para polimento, não para diagnóstico.
Mantendo a comparação justa
Altere o nível de raciocínio e nada mais. Toda tentativa usou o mesmo código, prompt, ferramentas, limites e avaliador — e nenhuma viu o trabalho das outras. Os níveis alternaram, 3 tentativas cada — o mesmo setup que usei no meu tutorial da API Claude Opus 5.
Resultados, tempo e custo por nível
A divisão entre os níveis ficou assim, em média por tentativa:
|
Média por tentativa |
Medium |
High |
|
Correções aceitas |
3 de 3 |
3 de 3 |
|
Chamadas de ferramenta |
28 |
35 |
|
Tokens de raciocínio |
1.877 |
14.764 |
|
Linhas alteradas |
24 |
193 |
|
Tempo |
3,4 minutos |
5 minutos |
|
Custo no preço promocional |
US$ 0,10 |
US$ 0,29 |
|
Custo após o fim da promoção |
US$ 0,20 |
US$ 0,58 |
high chegou à mesma correção no primeiro patch e depois ficou polindo. Reescreveu partes de sumarização, relatórios e validação que já não eram o gargalo principal.
Essa vantagem muda conforme a máquina e fica próxima do ruído de medição em cargas que já terminam em milissegundos — eu ainda enviaria o diff menor do medium só pelo tempo de revisão.
O pico de raciocínio do high veio no turno 4, depois que o primeiro patch já tinha resolvido o problema.
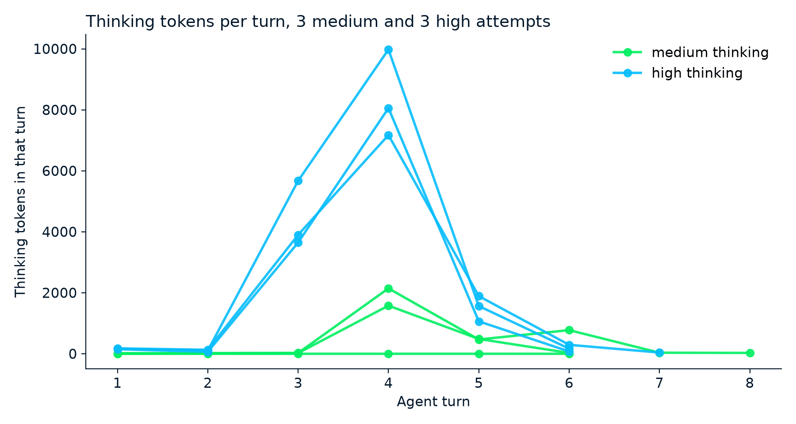
Onde cada tentativa gastou o raciocínio. Imagem do autor.
Também não tome tokens de raciocínio como sinal de qualidade; como na primeira requisição, uma tentativa em medium não usou nenhum e ainda assim entregou uma correção aceita — mais rápido e mais barato que qualquer outra tentativa.
Para precificar um agente, some o usage de cada turno, porque cada turno reporta todo o contexto processado. A maior parte da entrada de cada turno repete o turno anterior, e o cache implícito cobrou cerca de dois terços disso à tarifa de cache.
Segundo o guia de cache, o cache precisa de um prompt com pelo menos 4.096 tokens, e um turno que adiciona menos de 2.050 tokens novos paga a tarifa cheia nos últimos 2.050 da requisição anterior — então loops com resultados minúsculos de ferramentas economizam menos. Nas tarifas Standard promocionais, que explico nas FAQs, as 6 tentativas somadas custaram US$ 1,16.
Limitações de um agente de performance com IA
Um agente assim funciona melhor em problemas que um profiler consegue apontar — e este foi construído para ser limpo:
-
O gargalo foi plantado, como disse no início. Um profiler aponta quase direto para um laço quadrático em seis arquivos pequenos; já gargalos reais se escondem em I/O, bancos de dados e código sem documentação.
-
Os docstrings fizeram muita diferença. O Argon se apoiou em um para decidir qual cópia podia dispensar — em um código sem documentação, não há onde se apoiar.
-
Testes só validam o que alguém pensou. No estudo de caso do ADK, uma mudança de import passou na suíte pública e ainda falhou em alvos internos.
-
Tempos vêm de uma máquina Linux pequena com dados sintéticos — seus ganhos vão variar.
-
Todo arquivo lido pelo agente vai para o Google, que armazena interações pagas por 55 dias por padrão;
store=falseevita isso, mas invalidaprevious_interaction_id.
O model card do Google também lista alucinações e eventuais timeouts entre as limitações conhecidas.
Considerações finais
O agente encontrou as sumarizações repetidas e os deep copies nas seis tentativas, manteve a cópia de que os chamadores dependem e passou nas verificações reservadas. O nível high trouxe um pouco mais de velocidade e um diff bem maior.
Eu não generalizaria isso para o seu código — o gargalo foi plantado. O que vale é o método: meça primeiro, mantenha as ferramentas enxutas, congele o código antes de avaliá-lo e deixe os testes ocultos decidirem o resultado.
A extensão que eu faria primeiro é um roteador que começa em medium e só sobe para high quando os testes visíveis falham — assim os casos ocultos nunca retroalimentam o agente.
Se a saída de profiler acima é novidade para você, o curso Writing Efficient Python Code cobre as mesmas ferramentas de medição e profile que usei antes de deixar o Argon tocar no código.
FAQs
O Gemini 4 Argon consegue acelerar código Python automaticamente?
Não sozinho. A Interactions API ainda não executa ferramentas por você — seu código faz isso — e, aqui, o código de verificação acabou com o dobro do tamanho do app.
O Gemini 4 Argon consegue rodar código Python por conta própria?
Sim, com a ferramenta de execução de código integrada, mas ela para após 30 segundos e não consegue instalar o pytest. Para testes de verdade, use sua própria máquina ou a configuração hospedada no nosso tutorial de Managed Agents.
Devo usar raciocínio baixo (low) em um agente como este?
Eu não testei, e o Google diz que a qualidade pode cair em tarefas difíceis. Como você define o nível a cada turno, eu tentaria low para leitura de arquivos e medium para escrever patches.
Quanto custa a API Gemini 4 Argon?
Paguei US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, incluindo raciocínio, e esses preços dobram após 30 de novembro de 2026. O plano Flex custa metade, mas cada requisição pode levar até 15 minutos — eu só aceitaria para experimentos overnight.
Posso usar este agente em um código de produção?
Não do jeito que está — rode em um container descartável e faça uma pessoa revisar cada diff. Lembre também que o conhecimento do Argon vai até março de 2026, então forneça docs atuais para bibliotecas mais novas.

Sou engenheiro de dados e criador de comunidades que trabalha com pipelines de dados, nuvem e ferramentas de IA, além de escrever tutoriais práticos e de alto impacto para o DataCamp e desenvolvedores iniciantes.




Eu queria ver o que o Gemini 4 Argon faz com um app em Python que não está quebrado — só é lento. Todos os testes passam e todos os relatórios estão corretos, mas parte do trabalho leva segundos quando deveria levar milissegundos, e piora conforme o histórico do cliente cresce. Muitos tutoriais de IA para código começam com um teste falhando, o que dá ao modelo um alvo óbvio.
Mas aqui, nenhum teste com falha aponta para o código lento. Gemini 4 Argon é um modelo do Google que você chama a partir de Python via a API do Gemini, e você vai usá-lo para construir um agente de IA, que é um modelo que toma ações rumo a um objetivo. Neste caso, o agente lê, mede e edita código — mas apenas por meio de ferramentas controladas pelo seu próprio Python.
O app é o EventFlow, um pequeno programa fictício que transforma atividade, compras e reembolsos de clientes em relatórios. Minha pergunta era se o agente conseguiria encontrar a parte lenta e corrigi-la sem mudar o que o app retorna. Se você domina funções e classes em Python e sabe rodar testes, dá para acompanhar. Eu vou mostrar como:
Nosso resumo do Gemini 4 Argon cobre o lançamento e os benchmarks, então este tutorial foca na API. Para um panorama mais amplo, veja também as comparações Gemini 4 Argon vs Claude Opus 5.5 e Gemini 4 Argon vs. GPT-6 Astra.
Resumo
Dei a mesma tarefa ao agente 6 vezes, 3 com raciocínio
mediume 3 comhigh. Eis o que aconteceu:O Argon corrigiu o gargalo nas 6 tentativas, e um conjunto separado de testes ocultos confirmou.
A carga lenta caiu de cerca de 2 segundos para cerca de 3 milissegundos.
O Argon rodou benchmarks e um profiler antes de mudar qualquer código — então dê essas ferramentas ao seu agente, além dos testes.
highcustou cerca de 3x mais quemedium(US$ 0,29 contra US$ 0,10 por tentativa, em média) e gerou diffs 8x maiores por um ganho modesto extra de velocidade. Comece commedium.Eu plantei o gargalo de propósito em um app pequeno, então esses resultados descrevem só este caso.