

Wat is de Gemini 4 Argon API?
De Gemini 4 Argon API geeft je gemini-4-argon, een Google-reasoningmodel gebouwd voor complexe code en meerstaps agent-taken. Het werd algemeen beschikbaar medio oktober 2026. Volgens de modelpagina delen input, denken en output één venster van 1.048.576 tokens, en een synchrone respons stopt bij 65.536 outputtokens.
Google deed een soortgelijk experiment in de ADK-case study: een run van 11 uur met Antigravity en /goal op de Python Agent Development Kit (ADK). De reviewers hielden 2 van de 6 voorstellen over, waarmee de sessievoorbereiding bij lange sessies met ongeveer 40% daalde en imports met 21%. Deze tutorial gebruikt in plaats daarvan een kleine Python-lus.
Je gebruikt vier API-functies:
-
De Interactions API, Google’s aanbevolen interface voor nieuwe projecten, die gespreksstatus op de server bewaart
-
Function calling, waarbij het model om een tool vraagt en jouw code beslist of die wordt uitgevoerd
-
thinking_level:low,medium(de standaard) ofhigh -
Het
usage-object, dat input-, cache-, output- en denk-tokens rapporteert
Argon vraagt, en jouw code doet het werk.
Het project: een trage Python-app die Gemini 4 Argon moet fixen
De agent krijgt de EventFlow-code, 8 tools en geen hint over de vertraging. De complete code staat op GitHub. Begin met EventFlow.
Hoe EventFlow werkt
EventFlow is een fictieve eventprocessor in zes kleine modules. Een event komt binnen via EventFlow.ingest(), validate() zet het om in een Event, en CustomerState slaat het per klant in tijdvolgorde op. Daarna zet summarize() elke geschiedenis om in sessies, omzet, terugbetalingen en pagina-aantallen, en build_report() produceert een CustomerReport.
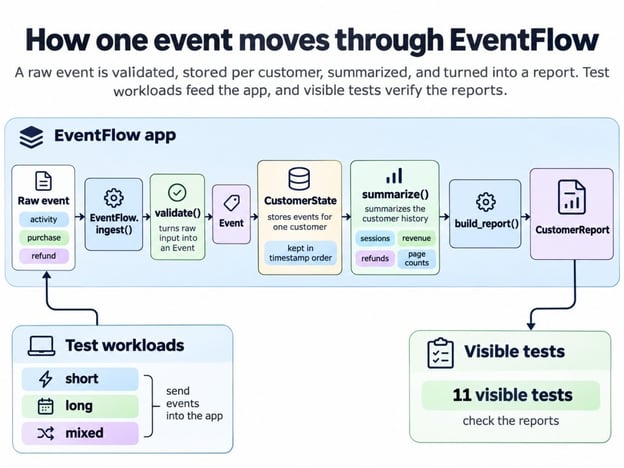
Hoe één event een rapport wordt. Afbeelding door auteur.
De docstrings van EventFlow stellen de volgende regels vast:
-
Sessies splitsen na een onderbreking van 30 minuten
-
Terugbetalingen zijn beperkt tot wat er van de aankoop overblijft
-
Een herhaalde
event_idwordt genegeerd en de eerste kopie wint -
Events sorteren op timestamp, ook over batches heen
-
history()enreport()geven objecten terug die de aanroeper bezit
De verborgen tests controleren dit allemaal, en de laatste regel komt later terug.
Waarom EventFlow traag wordt
Drie workloads, opgebouwd uit vaste seeds, laten zien hoe de lengte van de geschiedenis het beeld verandert:
-
short: veel klanten met elk 5 events -
long: een paar klanten met elk 160 events -
mixed: 1 tot 30 events per klant, met duplicaten en events die buiten volgorde binnenkomen
long heeft veel minder events dan short en duurt toch ongeveer 3x zo lang. De grafiek houdt het totaal op 1.600 events, terwijl elke klant een langere geschiedenis krijgt.
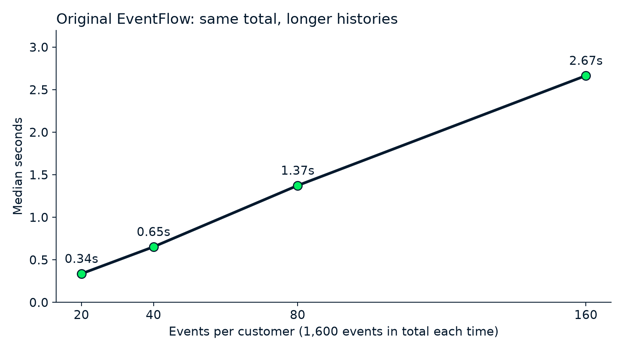
Zelfde totaal, langere geschiedenissen, tragere verwerking. Afbeelding door auteur.
Elke keer dat de geschiedenis verdubbelt, verdubbelt ook de runtime, hoewel het totale aantal events niet verandert. Dat patroon wijst er meestal op dat een stap bij elk nieuw event werk over de hele geschiedenis herhaalt. De agent ziet de oorzaken nooit, dus ik noem ze pas nadat Argon zijn beurt heeft gehad.
Succeskriteria en verborgen tests
Een fix telt alleen als die vijf vooraf ingestelde checks doorstaat; het eigen rapport van het model telt niet mee. De uiteindelijke code van de agent moet het volgende doen:
-
Minstens 1,5x sneller draaien op
long -
Niet meer dan 5% trager draaien op
shortofmixed -
Alle zichtbare tests doorstaan
-
Dezelfde rapportoutput teruggeven als het origineel op alle drie workloads
-
Alle verborgen acceptatiecases doorstaan
Deze drempels zijn van mijzelf, dus zie ze als voorbeeld. De tools van de agent kunnen verborgen cases niet bereiken; die draaien pas nadat de code is bevroren. Ze vergelijken de code met een aparte referentie-implementatie op nieuwe data, late batches, duplicaten en de eigendomsregels.
Een verborgen suite helpt alleen als die verkeerde fixes afwijst, dus voed er bewust een paar. Twee makkelijke shortcuts slagen hier voor alle zichtbare tests: de deep copy weglaten en de samenvatting cachen zonder die ooit te verversen. De verborgen cases wijzen beide af.
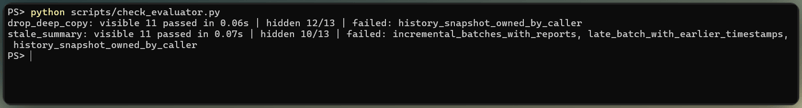
Verborgen tests betrappen twee verkeerde fixes. Afbeelding door auteur.
Hoe je de Gemini 4 Argon API instelt in Python
Je hebt Python 3.10 of nieuwer nodig, een Gemini API-sleutel en een Google AI Studio-project met facturatie aan, want op de prijspagina staat geen Free-tier voor Argon. Dit project pint de google-genai SDK vast op 2.33.0; de Interactions API heeft minimaal 2.3.0 nodig.
git clone https://github.com/KhalidAbdelaty/Gemini-4-Argon-API-Tutorial-.git eventflow-argon
cd eventflow-argon
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envOp macOS of Linux activeer je de virtuele omgeving met source .venv/bin/activate en kopieer je met cp, zet daarna GEMINI_API_KEY=... in .env. Als GOOGLE_API_KEY ook in je shell staat, gebruikt de SDK die in plaats daarvan, dus de code hieronder verwijdert hem eerst. Sla de volgende subsectie over als je de Interactions API al eerder hebt gebruikt.
Doe je eerste verzoek naar de Gemini 4 Argon API
Je eerste verzoek geeft Argon de bovenkant van de profileruitvoer van EventFlow en vraagt wat die laat zien. load_dotenv() laadt GEMINI_API_KEY uit .env, genai.Client() leest hem, het model-ID gaat in client.interactions.create(), en generation_config draagt het denkniveau mee.
import os
from dotenv import load_dotenv
from google import genai
load_dotenv()
os.environ.pop("GOOGLE_API_KEY", None)
client = genai.Client() # reads GEMINI_API_KEY from the environment
profile_excerpt = """paste the top rows of your cProfile output here"""
prompt = (
"This cProfile excerpt comes from a Python app that turns customer events into "
"reports. It is correct but slow on long customer histories.\n\n"
f"{profile_excerpt}\n\n"
"In three short bullets: what the profile shows, what you would read next in the "
"code, and what this evidence alone does not prove."
)
interaction = client.interactions.create(
model="gemini-4-argon",
input=prompt,
generation_config={"thinking_level": "medium"},
timeout=900, # seconds; Google recommends at least 15 minutes
)
print(interaction.output_text)
usage = interaction.usage
print(usage.total_input_tokens, usage.total_output_tokens, usage.total_thought_tokens)Dit kwam terug:
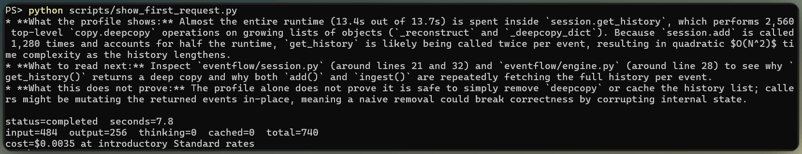
Eerste Argon-verzoek leest het profiel. Afbeelding door auteur.
Argon had het goed; bijna alle tijd zat onder get_history() en copy.deepcopy, waarschijnlijk twee keer per event aangeroepen. De derde bullet waarschuwde dat het verwijderen van de deep copy aanroepers kan breken die aanpassen wat ze terugkrijgen, wat de eerste shortcut is die ik eerder noemde. Een vraag als deze is goedkoop: minder dan 8 seconden en minder dan een halve cent, zonder denktokens.
medium is de standaard, en de latest-model-gids die ik eerder linkte raadt het aan "voor de meeste taken, inclusief complexe code en agentic use-cases." Diezelfde gids zegt dat temperature, top_p en top_k op Argon genegeerd worden, dus laat ze weg.
Profileer Python-code vóór je Gemini 4 Argon gebruikt
Meet de originele app voordat het model hem aanraakt, zodat elk later getal iets heeft om mee te vergelijken. Neem drie soorten metingen, elk in een eigen proces, omdat elk gereedschap de andere vertekent:
-
Timen met
time.perf_counter(), als de mediaan van meerdere verse processen met elk één warm-up -
Profilen met
cProfileom te vinden waar de tijd naartoe gaat; het maakte long ongeveer 6x trager, dus vertrouw nooit op een tijdmeting onder een profiler -
Geheugen met
tracemalloc, dat piek getraceerde Python-allocaties meldt in plaats van totaal procesgeheugen
Op de drie workloads, in plaats van de vaste 1.600 events uit de grafiek, deed de originele app er ongeveer 0,7 seconden over op short, 2,2 op long en 1,0 op mixed. Ook slaagde hij voor elke zichtbare pytest-test.
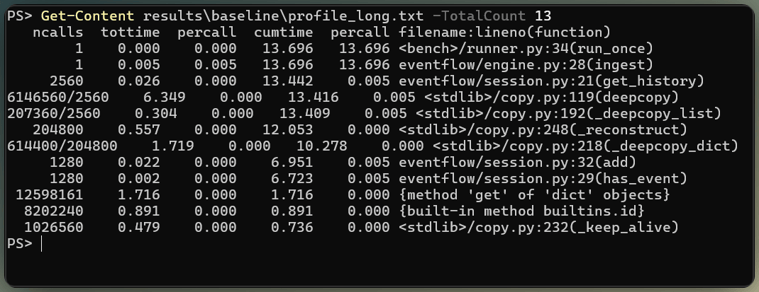
Waar de trage app tijd doorbrengt. Afbeelding door auteur.
Reken op drift: dezelfde code was later ongeveer 10% sneller, dus meet elke versie in één sessie.
Bouw een performance-agent met Gemini 4 Argon function calling
Zoals ik eerder noemde, vraagt Argon alleen om tools. De Python-code die ze draait heet de harness, en onze gids voor agent-harness-engineering legt uit waarom de checks in code thuishoren in plaats van in de prompt. De tools komen eerst, want zij bepalen wat Argon mag aanraken.
Definieer de tools en rechten van de agent
De 8 tools die ik eerder noemde zijn Python-functies gedeclareerd als platte JSON-schema’s, en slechts twee daarvan kunnen code wijzigen:
-
list_filesenread_file, beperkt tot de Python-bron van de app, tests en fixtures -
run_profilerenrun_benchmarkvoor één benoemde workload -
apply_patch, die precies één voorkomen van tekst in een bestaande broncodefile van de app vervangt -
revert_file,run_testsenshow_diff
Declaraties volgen het formaat uit de function-calling-gids die ik eerder linkte:
{"type": "function", "name": "apply_patch",
"description": ("Replace exactly one occurrence of old_text with new_text in a file under eventflow/. "
"The file must still compile afterwards."),
"parameters": {"type": "object", "properties": {
"path": {"type": "string"},
"old_text": {"type": "string", "description": "Exact text to replace; must occur once."},
"new_text": {"type": "string"}},
"required": ["path", "old_text", "new_text"]}},Een schema beschrijft de call, maar maakt hem niet veilig. De harness voegt de volgende checks toe in Python:
- Elk pad wordt eerst geresolved, dus een pad dat uit de gekopieerde app ontsnapt faalt
- Schrijfsels buiten de bronmap van de app worden geweigerd
- Een gepatcht bestand moet nog steeds compileren, anders wordt de patch afgewezen
- Tests en benchmarks draaien in subprocessen met timeouts en zonder API-sleutel
Dat is geen container, en gepatchte code kan nog steeds bestanden buiten de kopie lezen, dus zie het als het minimum.
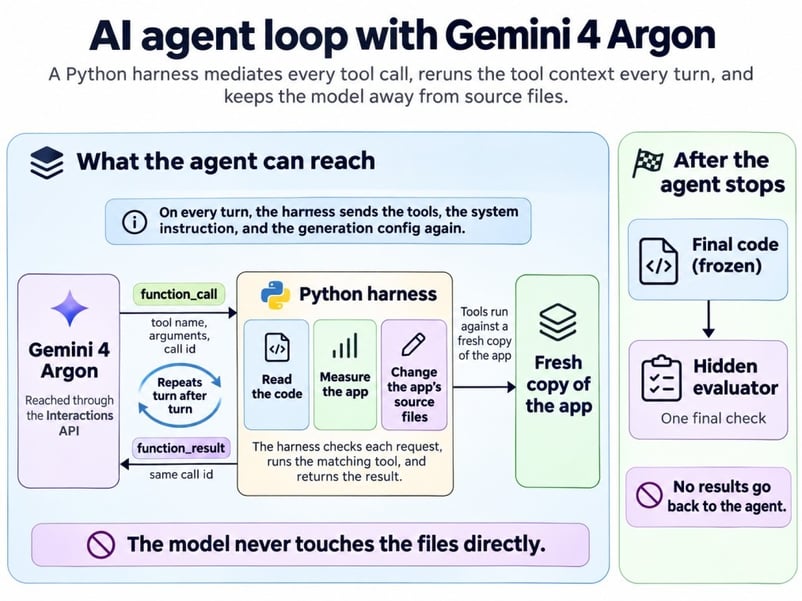
Argon vraagt, Python beslist en draait. Afbeelding door auteur.
Geef de agent een meetbaar prestatiedoel
De systeeminstructie stelt het doel en de regels, maar zegt nooit waar de vertraging zit:
Objective: make EventFlow faster on the supplied workloads without changing its
observable outputs or its public interfaces.
- Measure before you edit. Use run_benchmark and run_profiler to find where the
time goes, then read the code the evidence points to.
- Behavior must follow the public contract documented in the docstrings, not
only the visible tests.
- After every change, run run_tests and run_benchmark. If a test fails or
output_matches_original is false, repair or revert the change.
- Acceptance target: at least 1.5x faster on the long workload, no more than 5%
slower on short and mixed, all visible tests passing, and
output_matches_original true on all three workloads.De agent beslist wanneer te stoppen op basis van wat die kan zien: zichtbare tests, profiler- en benchmarkresultaten, en de limieten die de lus zo instelt.
Implementeer de Interactions API-toollus
Onderstaande snippet is de kern van de lus; de complete versie voegt de client, tooldispatcher en limieten toe. Elke beurt is één client.interactions.create()-aanroep, en Argon vraagt vaak om meerdere tools in één beurt, dus voer elke function_call-stap uit die het terugstuurt. Stuur elk resultaat terug als een function_result met de bijbehorende call_id:
# requires_action means "run my tools"; incomplete means the output cap cut the turn off
TERMINAL = {"failed", "cancelled", "incomplete"}
request = dict(
model="gemini-4-argon",
system_instruction=SYSTEM_INSTRUCTION, # the goal shown above
tools=DECLARATIONS, # the 8 schemas, like apply_patch above
generation_config={"thinking_level": level, "max_output_tokens": 65_536,
"thinking_summaries": "auto"},
)
interaction = client.interactions.create(input=task, timeout=900, **request)
while True:
calls = [s for s in interaction.steps if s.type == "function_call"]
if interaction.status in TERMINAL or not calls: # failed, cut off, or completed
break
results = []
for call in calls:
output, is_error, _ = tools.call(call.name, call.arguments) # validated, run locally
results.append({"type": "function_result", "name": call.name, "call_id": call.id,
"is_error": is_error,
"result": [{"type": "text", "text": json.dumps(output)}]})
# application limits checked here: 40 turns, 45 minutes, $5
# **request again: tools, instruction, and config don't carry over between turns
interaction = client.interactions.create(
input=results, previous_interaction_id=interaction.id, timeout=900, **request)De **request in de vervolgaanroep is de regel die mensen laten vallen. previous_interaction_id draagt de geschiedenis, maar tools, system_instruction en generation_config zijn per interactie, dus een beurt zonder die instellingen verliest de tools of valt terug op het standaard denkniveau. Ik vind deze regel makkelijk te vergeten, dus de code bewaart alle drie instellingen in één dict.
De API heeft geen taakbudget, dus stel beurt-, tijd- en bestedingslimieten in je applicatie in voordat je start. Ik gebruikte 40 beurten, 10 patches, 45 minuten en $5, en geen poging kwam in de buurt, hoewel de bestedingscheck tussen beurten draait, dus één lange beurt kan eroverheen gaan. Google’s rate-limits-pagina voegt zijn eigen limiet toe op Tier 1-accounts, $10 per 10 minuten rolling, en geeft 429 RESOURCE_EXHAUSTED terug als je daaroverheen gaat.
Draai de Gemini 4 Argon-agent en verifieer de wijzigingen
Elke poging startte vanaf een verse kopie van de app, stopte uit zichzelf binnen ongeveer 5 minuten en had zijn code bevroren voordat een verborgen check draaide.
De bottleneck vinden op basis van bewijs
Argon vond de bottleneck door eerst te meten. Hier is de eerste medium-poging, beurt voor beurt.
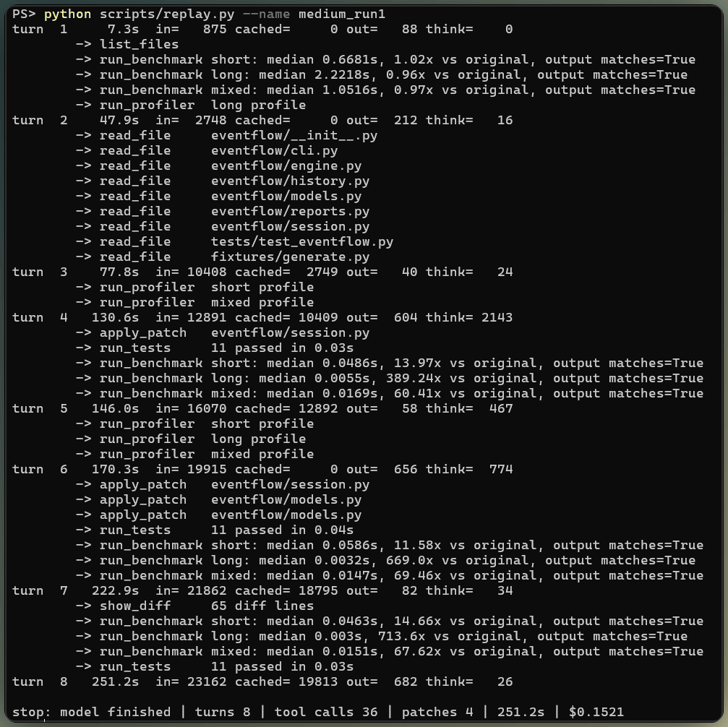
Eén medium-poging, beurt voor beurt. Afbeelding door auteur.
De denksamenvattingen, een verkorte versie van het redeneren in plaats van elke stap, laten zien hoe het tot de fix kwam. Argon merkte op dat has_event() en add() allebei get_history() aanroepen. Het vroeg zich af of de deep copy "hier echt nodig is, of dat de eis alleen is dat de aanroeper de data bezit," en loste het op met de summarize()-docstring, die zegt dat de functie haar input niet wijzigt.
Niet elke bewering rustte op bewijs. Dezelfde samenvatting zegt dat er "geen directe toegang in tests of verborgen gebruik" is, wat Argon niet kon weten. De gok hield stand (dit keer), maar het is het soort regel om in een review te omcirkelen.
De fix waar alle zes pogingen op uitkwamen
Elke poging maakte dezelfde kernwijziging aan CustomerState, en de kleinste van de zes diffs laat het het best zien:
def __init__(self, customer_id: str):
self.customer_id = customer_id
self._events = []
- self.summary = summarize([])
+ self._event_ids = set()
+ self._summary = None
+
+ @property
+ def summary(self):
+ if self._summary is None:
+ self._summary = summarize(self._events)
+ return self._summary
def get_history(self):
@@
return copy.deepcopy(self._events)
def has_event(self, event_id: str) -> bool:
- return any(e.event_id == event_id for e in self.get_history())
+ return event_id in self._event_ids
def add(self, event) -> None:
- bisect.insort(self._events, event, key=_order_key)
- self.summary = summarize(self.get_history())
+ self._event_ids.add(event.event_id)
+ if not self._events or (self._events[-1].ts, self._events[-1].seq) <= (event.ts, event.seq):
+ self._events.append(event)
+ else:
+ bisect.insort(self._events, event, key=_order_key)
+ self._summary = NoneNu de geplante oorzaken die ik eerder beloofde: add() resummerizeerde de hele geschiedenis bij elk event, elk event betaalde voor twee volledige deep copies, en duplicaatcontroles scanden de lijst.
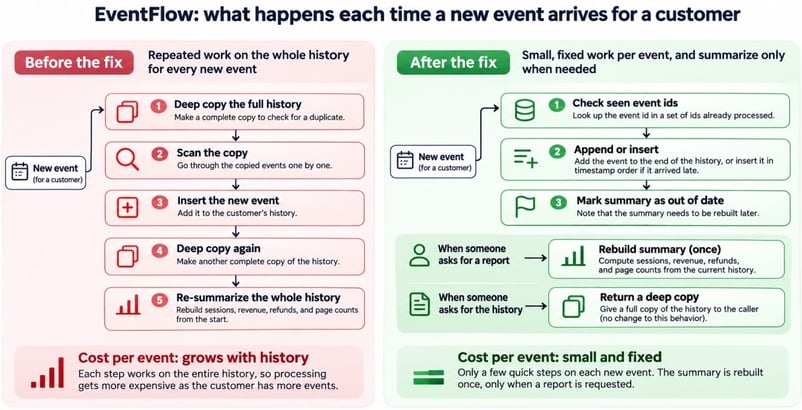
Werk per event voor en na de fix. Afbeelding door auteur.
get_history() behoudt zijn deep copy voor externe aanroepers, wat het detail is dat de deep-copy-shortcut van eerder fout doet.
Elke patchronde slaagde voor de zichtbare tests, dus de agent hoefde nooit terug te draaien, maar de meeste pogingen voegden ook een summary-setter toe die niets aanroept. Niemand vroeg erom, en iemand moet het nog reviewen.
Resultaten van verborgen acceptatietests
De verborgen evaluator draaide één keer per poging, en elke poging slaagde voor elk geval. De cases roepen ingest() aan na report(), sturen terugbetalingen vóór hun aankopen en wijzigen geretourneerde objecten om te bevestigen dat de engine-state gelijk blijft.
Maakte Gemini 4 Argon de app daadwerkelijk sneller?
Ja. Elke nieuwe versie was veel sneller en gaf dezelfde output als het origineel. Zoals ik eerder noemde, driften tijden, dus ik mat het origineel en alle 6 nieuwe versies in afwisselende volgorde, elk 9 verse processen.
Elke meting dekt alleen ingest en reports, niet Python-start of imports. Bij enkele milliseconden kan één meting ver boven de mediaan uitkomen, dus vergelijk medianen. De log-schaal van de grafiek voorkomt dat de nieuwe versies verdwijnen naast het origineel.
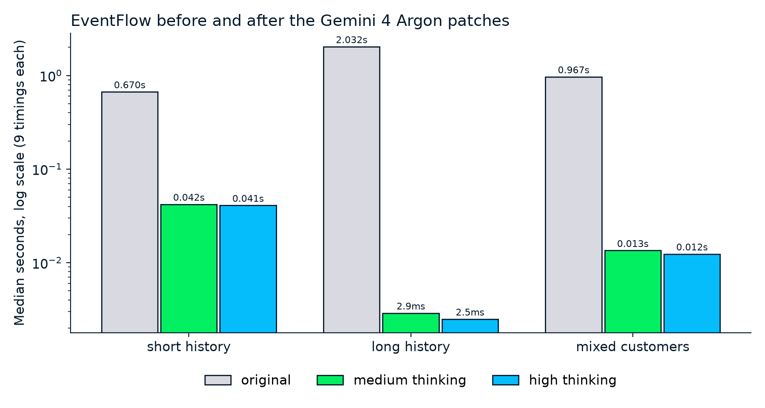
Milliseconden erna, seconden ervoor, dezelfde outputs. Afbeelding door auteur.
De grafiek toont de eerste poging op elk niveau, en de tabel dekt alle 6, met speedup als originele mediaan gedeeld door nieuwe mediaan:
|
Meting |
Origineel |
Medium (3 pogingen) |
High (3 pogingen) |
|
|
Referentie |
14,8x tot 15,9x |
16,3x tot 17,4x |
|
|
Referentie |
656x tot 701x |
ongeveer 810x |
|
|
Referentie |
65,4x tot 71,6x |
76,8x tot 78,0x |
|
Piek getraceerd geheugen, |
7.108 KiB |
7.822 KiB |
7.822 KiB |
|
Piek getraceerd geheugen, |
885 KiB |
570 KiB |
569 KiB |
long won het meest, omdat het verwijderde werk mee groeide met de klantgeschiedenis. De geheugenrijen zijn de enige plek waar de fix iets kost. short, met de meeste klanten, gebruikte ongeveer 10% meer, waarschijnlijk voor de nieuwe ID-set per klant, terwijl long minder gebruikte, vermoedelijk omdat het stopte met het bouwen van kopieën.
Lees 700x niet als iets bijzonders van Argon. Het verwijderen van een kwadratische lus uit synthetische data levert vaak dit soort getallen op, wie de fix ook schrijft.
Gemini 4 Argon-denkniveaus: Medium vs. High
Bij deze taak schreef high net iets snellere code dan medium, maar beide niveaus vonden dezelfde fix, dus de extra denkkracht ging in polish in plaats van diagnose.
De vergelijking eerlijk houden
Verander het denkniveau en niets anders. Elke poging gebruikte dezelfde code, prompt, tools, limieten en evaluator, en geen enkele zag het werk van een andere poging. De niveaus wisselden af, 3 pogingen elk, hetzelfde setup als in mijn Claude Opus 5 API-tutorial.
Resultaten, tijd en kosten per niveau
De twee niveaus splitsten zo, gemiddeld per poging:
|
Gemiddeld per poging |
Medium |
High |
|
Geaccepteerde fixes |
3 van 3 |
3 van 3 |
|
Toolaanroepen |
28 |
35 |
|
Denktokens |
1.877 |
14.764 |
|
Regels gewijzigd |
24 |
193 |
|
Tijd |
3,4 minuten |
5 minuten |
|
Kosten tegen de introductieprijs |
$0,10 |
$0,29 |
|
Kosten na einde van die prijs |
$0,20 |
$0,58 |
high landde dezelfde fix in zijn eerste patch en bleef daarna polijsten. Het herschreef delen van samenvatting, rapportage en validatie die niet langer de grootste bottleneck waren.
Dat voordeel verschuift met de machine en zit dicht bij de meetruis op workloads die al in milliseconden klaar zijn, dus ik zou nog steeds de kleinere diff van medium shippen, alleen al om reviewtijd.
High’s denken piekte in beurt 4, nadat de eerste patch het probleem al had opgelost.
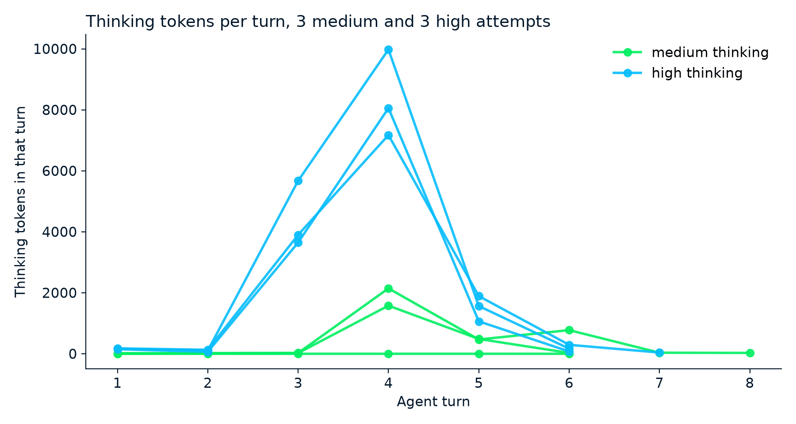
Waar elke poging zijn denken besteedde. Afbeelding door auteur.
Neem denktokens ook niet als kwaliteitssignaal; zoals bij het eerste verzoek gebruikte één medium-poging er geen en landde toch een geaccepteerde fix, sneller en goedkoper dan elke andere poging.
Om een agent te prijzen, tel je de usage van elke beurt op, omdat elke beurt de volledige context rapporteert die hij verwerkt heeft. Het grootste deel van de input per beurt herhaalt de vorige, en de impliciete cache rekende ongeveer twee derde af tegen het cachetarief.
Volgens de caching-gids heeft de cache een prompt van minstens 4.096 tokens nodig, en een beurt die minder dan 2.050 nieuwe tokens toevoegt, betaalt het volledige tarief over de laatste 2.050 van het vorige verzoek. Lussen met piepkleine toolresultaten besparen dus minder. Tegen de Standard-introductietarieven, die ik behandel in de FAQ, kostten alle 6 pogingen samen $1,16.
Beperkingen van een AI-performance-agent
Een agent als deze werkt het best bij problemen waar een profiler op kan wijzen, en deze was gebouwd om ‘clean’ te zijn:
-
De bottleneck was geplant, zoals ik aan het begin zei. Een profiler wijst bijna rechtstreeks naar een kwadratische lus in zes kleine bestanden, terwijl echte vertragingen zich verbergen in I/O, databases en ongedocumenteerde code.
-
De docstrings deden veel werk. Argon leunde op er één om te beslissen welke kopie het kon overslaan, en een ongedocumenteerde codebase geeft niets om op te leunen.
-
Tests checken alleen wat iemand bedacht heeft. In Google’s ADK-case study slaagde één importwijziging voor de publieke suite en faalde toch op interne testtargets.
-
Tijden komen van één kleine Linux-machine op synthetische workloads, dus jouw speedups verschillen.
-
Elk bestand dat de agent leest gaat naar Google, dat betaalde interacties standaard 55 dagen bewaart;
store=falsestopt dat, maar sluitprevious_interaction_iduit.
Google’s modelkaart noemt ook hallucinaties en af en toe time-outs als bekende beperkingen.
Slotgedachten
De agent vond de herhaalde samenvattingen en deep copies in alle zes pogingen, behield de kopie waarop aanroepers vertrouwen en slaagde voor de achtergehouden checks. high denken voegde een beetje snelheid en een veel grotere diff toe.
Ik zou dat niet generaliseren naar jouw codebase, omdat ik de bottleneck heb geplant. Wat wel overdraagbaar is, is de methode: meet eerst, houd de tools smal, vries de code in voordat je hem controleert en laat verborgen tests over de uitkomst beslissen.
De eerste uitbreiding die ik zou bouwen, is een router die op medium begint en pas naar high gaat als de zichtbare tests falen, zodat de verborgen cases nooit terugvoeden in de agent.
Als de profileruitvoer hierboven nieuw voor je is, Writing Efficient Python Code beslaat dezelfde tijd- en profilingtools die ik gebruikte voordat ik Argon de code liet aanraken.
FAQs
Kan Gemini 4 Argon Python-code automatisch versnellen?
Niet uit zichzelf. De Interactions API draait je tools nog niet voor je, dus jouw code doet dat, en hier bleek de controlerende code twee keer zo groot als de app.
Kan Gemini 4 Argon zelf Python-code draaien?
Ja, met de ingebouwde code-executiontool, maar die stopt na 30 seconden en kan geen pytest installeren. Voor echte tests gebruik je je eigen machine of de gehoste setup in onze Managed Agents-tutorial.
Moet ik low denken gebruiken voor zo’n agent?
Ik heb het niet getest, en Google zegt dat de kwaliteit op moeilijke taken kan dalen. Omdat je het niveau per beurt instelt, zou ik low proberen voor bestanden lezen en medium voor patches schrijven.
Wat kost de Gemini 4 Argon API?
Ik betaalde $2 per miljoen inputtokens en $10 per miljoen outputtokens, inclusief denken, en die prijzen verdubbelen na 30 november 2026. Flex kost de helft, maar elk verzoek kan tot 15 minuten duren, wat ik alleen voor nachtelijke experimenten zou accepteren.
Kan ik deze agent op een productiecodebase gebruiken?
Niet zoals hier beschreven, dus draai hem in een wegwerpcontainer en laat een persoon elke diff reviewen. Houd ook in gedachten dat Argons kennis stopt in maart 2026, dus geef het actuele docs voor nieuwere libraries.

Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.


Ik was benieuwd wat Gemini 4 Argon zou doen met een Python-app die niet kapot is, maar wel traag. Alle tests slagen en alle rapporten kloppen, maar sommige stappen kosten seconden waar milliseconden genoeg zouden zijn, en het wordt erger naarmate een klant meer geschiedenis heeft. Veel AI-codetutorials beginnen bij een falende test, wat het model een duidelijk doelwit geeft.
Maar hier wijst geen falende test de trage code aan. Gemini 4 Argon is een Google-model dat je vanuit Python aanroept via de Gemini API, en je gebruikt het om een AI-agent te bouwen: een model dat acties onderneemt richting een doel. In dit geval leest, timet en bewerkt de agent code, maar alleen via tools die je eigen Python aanstuurt.
De app is EventFlow, een kleine fictieve toepassing die klantactiviteit, aankopen en terugbetalingen omzet in rapporten. Mijn vraag was of de agent het trage deel kon vinden en oplossen zonder te veranderen wat de app teruggeeft. Als je je prettig voelt bij Python-functies, -klassen en het draaien van tests, kun je meedoen. Ik laat je zien hoe je:
Onze overzichtspagina van Gemini 4 Argon behandelt de lancering en benchmarks, dus deze tutorial blijft bij de API. Voor het bredere modeloverzicht, zie ook onze vergelijkingen Gemini 4 Argon vs Claude Opus 5.5 en Gemini 4 Argon vs. GPT-6 Astra.
TL;DR
Ik gaf de agent dezelfde taak 6 keer, 3 op
mediumen 3 ophighdenkniveau, en dit kwam eruit:Argon loste de vertraging in alle 6 pogingen op, en een aparte set verborgen tests bevestigde dat.
De trage werklast ging van ongeveer 2 seconden naar ongeveer 3 milliseconden.
Argon draaide benchmarks en een profiler voordat er code werd gewijzigd, dus geef je agent naast tests ook die tools.
highkostte ongeveer 3x meer danmedium($0,29 versus $0,10 per poging, gemiddeld) en schreef 8x grotere diffs voor een bescheiden extra snelheidswinst. Begin opmedium.Ik heb de bottleneck bewust in één kleine app geplant, dus deze resultaten beschrijven alleen dit geval.